使用vivado,verilog,vivado/timing报告/报红/该如何处理的,老师,还请指点的,谢谢您啦
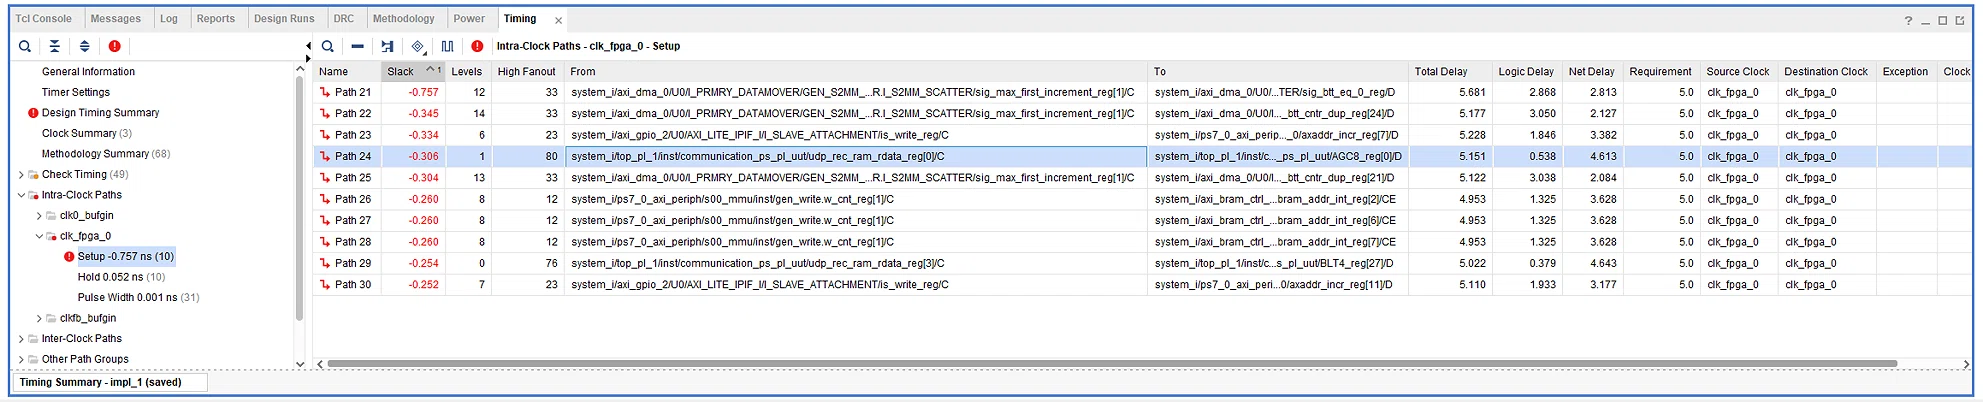
从时序报告看,主要问题是建立时间(Setup)违例 ,裕量(Slack)为负值,比如最差的一条路径是 -0.757ns,意味着数据到达终点寄存器的时间比时钟要求晚了约 0.76ns。
🔍 第一步:精准定位瓶颈
处理时序问题,关键是找到"罪魁祸首"。报告中的 Path 21 是重点分析对象:
-
查看逻辑级数(Logic Levels) :
Path 21的逻辑级数高达 12 级。通常,逻辑级数超过 8 级就说明组合逻辑路径过长,是典型的建立时间违例原因。 -
分析延迟构成:该路径总延迟 5.681ns,其中布线延迟(Net Delay)为 2.813ns,逻辑延迟(Logic Delay)为 2.868ns。布线延迟占比较高,提示可能存在布局拥塞或高扇出问题。
-
定位起点与终点 :路径从
PRMRY_DATAMOVER模块的sig_max_first_increment_reg出发,到达TER/sig_btt_eq_0_reg。双击该路径,在 "View Path Report" 中查看详细的逻辑层级,找到耗时最长的环节。
🛠️ 第二步:代码级优化(最直接的方法)
针对 Path 21 这类长组合逻辑,最有效的优化是插入流水线寄存器(Pipelining)。
优化原理 :将一段很长的组合逻辑(如 A+B+C+D)拆分到两个时钟周期完成,中间插入寄存器缓存中间结果。
verilog
// 优化前:多级加法在一个时钟周期内完成,逻辑延迟高
always @(posedge clk) begin
    result <= A + B + C + D;
end

// 优化后:插入一级流水线,将长路径打断
reg [31:0] pipe_reg;
always @(posedge clk) begin
    pipe_reg <= A + B; // 第一级逻辑
    result   <= pipe_reg + C + D; // 第二级逻辑
end优化建议:
-
检查
sig_max_first_increment_reg相关的计算逻辑,尝试将其分解为多级流水。 -
同时检查
Path 24和Path 30,它们分别来自udp_rec_ram_rdata和SLAVE_ATTACHMENT模块,同样是长逻辑路径的体现,可考虑采用相似的流水线策略。
⚙️ 第三步:综合与实现选项优化
如果代码修改受限,可以通过调整 Vivado 工具设置来优化。
-
开启重定时(Retiming) :综合时,Vivado 的 Retiming 功能可以自动在组合逻辑中移动寄存器位置,以平衡延迟。在综合设置中,将
-retiming选项勾选上。 -
调整实现策略(Implementation Strategy) :在
Implementation设置中,选择Performance_Explore或Performance_ExtraTimingOpt等策略,让工具在布局布线时更侧重时序优化。 -
物理优化指令 :在
opt_design或phys_opt_design阶段,可以尝试使用以下指令自动优化关键路径:tcl
phys_opt_design -retime -directive AddRetime
🚀 第四步:进阶技巧
-
路径分组与优先级 :将关键的数据路径(如
Path 21)与控制路径分组,并为关键路径组设置更高的优化优先级,让工具集中资源解决主要矛盾。 -
布局约束 :对于布线延迟(Net Delay)占比高的情况,可以尝试使用
Pblock约束,将相关联的模块(如PRMRY_DATAMOVER和TER)布局在相邻区域,缩短布线长度。 -
检查约束完整性 :确认
.xdc文件中是否已正确约束了所有时钟。对于 Zynq 平台,PS 侧时钟(如clk_fpga_0)通常已自动约束,但 PL 侧的自定义时钟需要手动添加。
💡 针对你当前路径的专项建议
根据你的报告,Path 21 和 Path 24 的布线延迟(Net Delay)都超过了 2.8ns,这提示问题可能不仅在于逻辑级数,也在于物理布局。建议先尝试开启综合的 Retiming 选项 ,然后检查 PRMRY_DATAMOVER 和 TER 模块之间的物理位置 。如果它们距离较远,可以尝试通过 Pblock 或区域约束(Area Constraints)将它们拉近,这往往是解决布线延迟过高问题的关键一步。
Path 24和Path 29,high fanout 减小有效嘛,如何减少呢,还请老师指点,谢谢您
针对 Path 24 和 Path 29 的高扇出(High Fanout)问题,减小扇出非常有效,尤其是当路径的布线延迟(Net Delay)占主导时。
🎯 为什么减小扇出对这两条路径有效?
你的时序报告显示,Path 24 的布线延迟为 4.613ns ,Path 29 也高达 4.643ns。高扇出信号会导致驱动源与负载之间物理距离拉远,从而显著增加布线延迟。
关键点在于 :FPGA的布线是高度重缓冲的,单纯减小扇出值本身意义不大,真正的优化在于通过寄存器复制(Replication),让复制后的驱动源能更靠近各自的负载,从而缩短布线距离。当路径的布线延迟占比较大时,这种物理位置的优化对改善时序效果显著。
🛠️ 如何有效减少高扇出
你可以按以下优先级,从工具自动优化到手动干预逐步尝试。
1. 使用综合属性 MAX_FANOUT(首选)
这是最直接的方法。在RTL代码中为高扇出信号添加该属性,Vivado会在综合阶段强制执行寄存器复制。
verilog
(* MAX_FANOUT = 50 *) reg high_fanout_signal;该属性会强制工具将扇出限制在指定数值内,但设置过低可能导致过度复制,反而增加布线拥塞。建议先观察综合后的扇出报告,再设定一个合理值。
2. 物理优化指令 phys_opt_design(针对布线后)
如果综合后仍有时序违例,可在 place_design 之后运行物理优化。它会基于布局信息,自动复制高扇出网络的关键驱动源。
tcl
phys_opt_design -directive AggressiveFanoutOptAggressiveFanoutOpt 指令会采用更激进的算法来处理高扇出网络,通常能带来更明显的改善。
3. 手动代码重构(终极方案)
对于工具自动优化效果不佳的关键路径,手动重构代码是最可靠的方式。
对于控制信号(如复位、使能):在子模块内部复制本地控制信号,避免单个全局信号驱动所有寄存器。
verilog
// 在模块内部生成多个本地复位副本
reg rst_core_r, rst_data_r;
always @(posedge clk) begin
    rst_core_r <= global_rst;
    rst_data_r <= global_rst;
end对于数据路径:在长组合逻辑中插入流水线寄存器,手动将高扇出的驱动源复制到更靠近其负载的位置。
💡 针对 Path 24 和 Path 29 的专项建议
-
确认驱动源 :在Vivado中选中
Path 24的起点udp_rec_ram_rdata_reg[0]/C,查看其驱动的负载数量。如果该寄存器驱动了数十个以上的负载,则高扇出问题确认。 -
应用
MAX_FANOUT:在该寄存器的RTL代码或XDC约束中添加set_property MAX_FANOUT 20 [get_nets udp_rec_ram_rdata_reg*],观察综合后时序是否改善。 -
如果改善不明显 :说明工具自动复制后,副本寄存器仍被放置在原位置附近。此时需要手动在代码中复制该寄存器,并在RTL中将其分配给不同的负载组,让工具在布局时能将其放置到各自负载附近。
总而言之,对于布线延迟主导的高扇出违例,减小扇出是对症下药 。建议优先尝试 MAX_FANOUT 属性和 AggressiveFanoutOpt 指令,若效果不佳再考虑手动重构。