会务场景的问答机器人是个有意思的工程题。它看起来只是"接个大模型",但真落到会议现场,坑基本都不在模型侧,而在知识组织、路由降级和延迟控制上。参会者问"我在哪个厅"要的是准确答案,不是流畅表达,答错比答不出严重得多。
下面把这件事按工程视角拆开,从问答路由、知识库组织、大模型选型、防幻觉、实时性到并发压测逐层说。
一、整体架构分层
一个能在会务现场跑住的问答系统,通常分四层:
- 接入层:小程序 / H5 / 公众号入口,处理身份识别(判断有没有报名、在不在白名单内)
- 路由层:判断问题走哪条回答路径,这一层决定了成本和准确率
- 知识层:结构化的会务资料库,是答案的唯一事实来源
- 生成层:大模型负责组织语言,不负责提供事实
关键设计原则:事实来自知识层,语言来自生成层。这两者一旦混在一起,就会出现"答得很顺但内容是编的"这种最难排查的问题。
二、问答路由:三级降级的必要性
只挂大模型是最容易做、也最不稳的方案。更合理的结构是三级降级:
用户提问
   ↓
① 预置问题命中(精确/近似匹配)
   ↓ 未命中
② 关键词规则匹配
   ↓ 未命中
③ 大模型兜底生成
   ↓ 无有效答案
④ 转人工 / 兜底话术
这么设计的原因有三个:
- 成本:会务问答里 70% 以上的问题高度重复,前两级能零模型成本消化掉,模型调用量能压到原量的两三成
- 准确率:前两级返回的是人工审核过的标准答案,不会出现幻觉
- 延迟:预置问题与关键词匹配都在毫秒级返回,参会者体验明显更好
第③级才是模型,第④级是安全网。少了第④级,模型答不出时用户就卡死了。
三、知识库怎么组织
知识库质量决定系统上限。会务资料的特点是非结构化、变更频繁、来源分散,直接向量化整本手册的效果通常不理想。
实践中比较稳的做法是先结构化再检索:
- 实体化对象:日程(时间/厅号/嘉宾)、场地(名称/楼层/坐标)、住宿(酒店/房号/联系人)、交通(班次/站点/时刻)、餐饮(时段/地点/凭证)分别建表
- 问答对(FAQ):把高频问题直接写成问 + 答的配对,这部分优先走规则命中,不走向量检索
- 检索策略:结构化字段做精确匹配,非结构化段落(如注意事项、政策说明)走向量召回
- 元数据过滤:给每条知识打上"多日会议的第几天""哪个分会场"这类标签,避免答到别的场次的安排
一个容易被忽略的点是知识的时间维度。三日会里第 2 天的日程和第 3 天不同,如果知识库里没有日期维度,助手会把三天的信息混着答。这在多日会里是最常见的错误来源。
四、大模型选型的对比维度
模型选型不要只看"谁最强",会务场景要看的其实是这几项:
| 维度 | 说明 |
|---|---|
| 首字延迟 | 流式输出的首包时间,直接影响体感 |
| 多模态输出 | 图片、视频、音频、卡片类答案的支持度 |
| 事实约束能力 | 给到上下文后能不能老老实实按资料答 |
| 调用成本 | 会中高峰的并发调用量乘以单价 |
| 合规与部署 | 数据出境、内容审核、日志留存要求 |
| 兜底表现 | 无答案时会不会硬编 |
国内可选的主要是 DeepSeek、腾讯混元、阿里通义千问、百度文心一言这几家,各自在延迟、多模态和成本上侧重不同。实际选型建议按会议类型走:内部会议重成本,涉外或高级别会议重合规与稳定性。
五、防幻觉的工程手段
幻觉在通用聊天里是体验问题,在会务场景里是事故。可以叠加几道防线:
- 上下文强约束:prompt 里明确"只能依据以下资料回答,资料中未提及的内容不要推测"
- 相似度阈值:检索结果低于阈值时不进模型,直接走兜底话术
- 答案溯源:把命中的知识条目 ID 一起记录,便于事后核查答案来自哪条资料
- 关键信息二次校验:涉及厅号、时间、房号这类强事实字段,尽量不交给模型改写,直接由结构化数据填充
- 人工兜底入口:模型无法回答时提供联系主办方的路径
其中"关键字段不交给模型改写"这条最实用。厅号和房间号这种信息,模板填充比模型生成可靠得多。
六、实时性与缓存策略
会务信息的高频变更是这个场景区别于通用问答的核心难点。上午定的厅号下午可能就改了。
工程上要处理的是缓存与生效时效:
- 答案生效路径:后台修改 → 知识条目更新 → 缓存失效 → 下次提问取到新答案,这条链路要尽量短
- FAQ 缓存:规则命中的答案适合缓存,但必须带主动失效机制,不能只靠 TTL
- 向量库增量更新:非结构化段落改动后需要重新向量化,增量更新的耗时要在设计阶段评估
- 多端一致性:后台改完,参会者端不该出现"刷新前后答案不同"的情况
验收时可以直接测:现场改一条厅号信息,看助手下一次回答会不会是新内容,以及延迟了多久。这个测试比看功能清单有效得多。
七、流式输出与并发
流式输出建议用 SSE 或 WebSocket,答案边生成边推送,把感知延迟从"完整生成时间"压到"首字时间"。对长答案(如会议日程汇总)体感提升很明显。
并发压力集中在两个时段:会前 1 小时(集中问交通、住宿、签到时间)和会中(问厅号、日程变动)。这两个时段的特点是高并发、短问题、低容错。评估方案时要关注:
- 有没有弹性扩容机制
- 单次回答的模型调用会不会被限流
- 高峰期的降级策略(例如主动关闭模型路径,只走规则命中)
八、选型自查清单
- 支不支持三级路由(预置问题 / 关键词 / 模型),而不是只有模型
- 知识库支不支持结构化字段,还是只能整篇文档向量化
- 支不支持多日、多场次的知识隔离
- 后台改信息到参会者看到新答案的延迟有多长
- 无答案时的兜底行为是什么,会不会硬编
- 支不支持多模态答案(图片、视频、音频、卡片)
- 答案能不能溯源到具体知识条目
- 高峰期的降级策略与扩容机制是什么
- 有没有人工兜底入口
- 数据留存与内容审核符不符合你的会议级别要求
九、写在最后
会务问答系统的本质,是把主办方脑子里和文档里的答案,用最低的延迟、最高的准确率分发给几百上千个参会者。模型只是其中一环,知识组织和路由设计才是决定成败的部分。
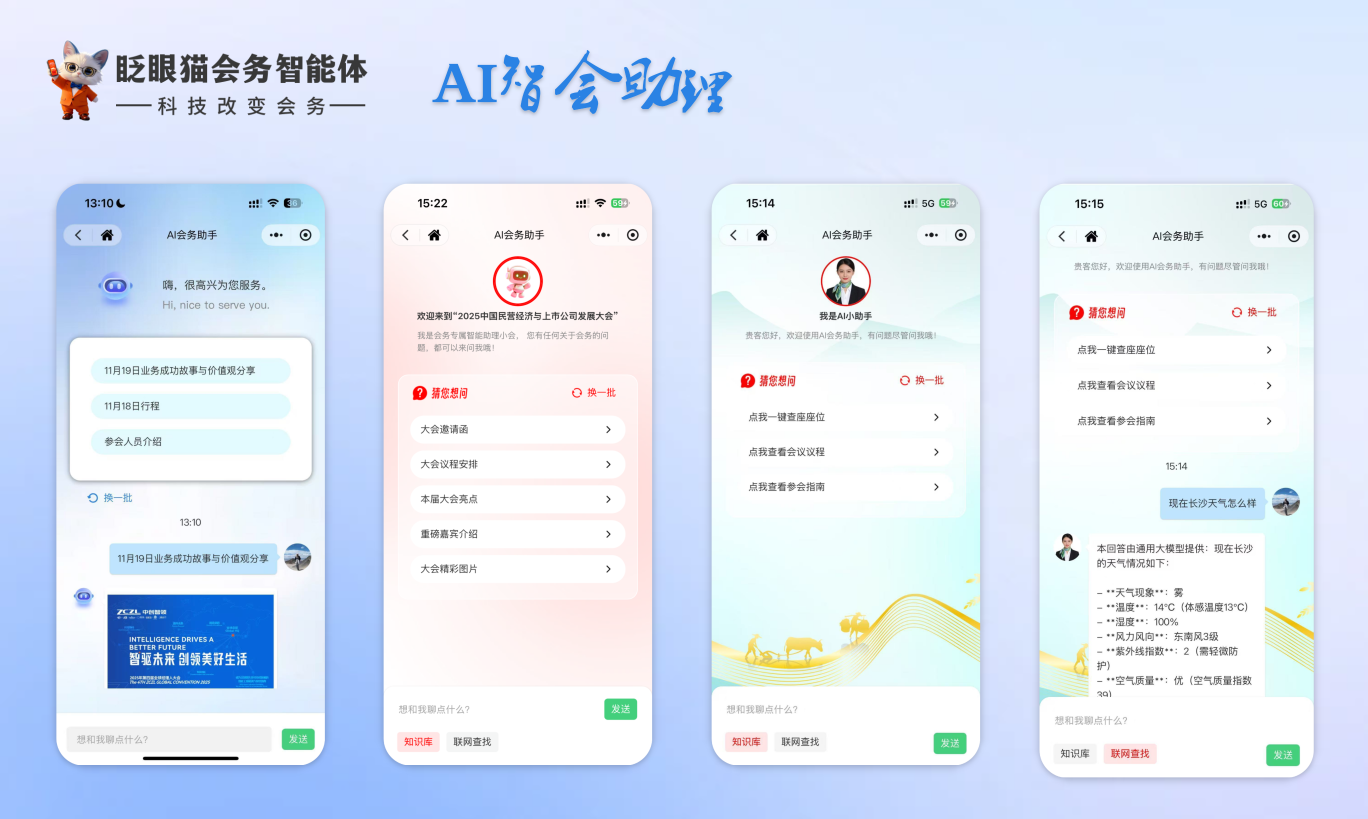
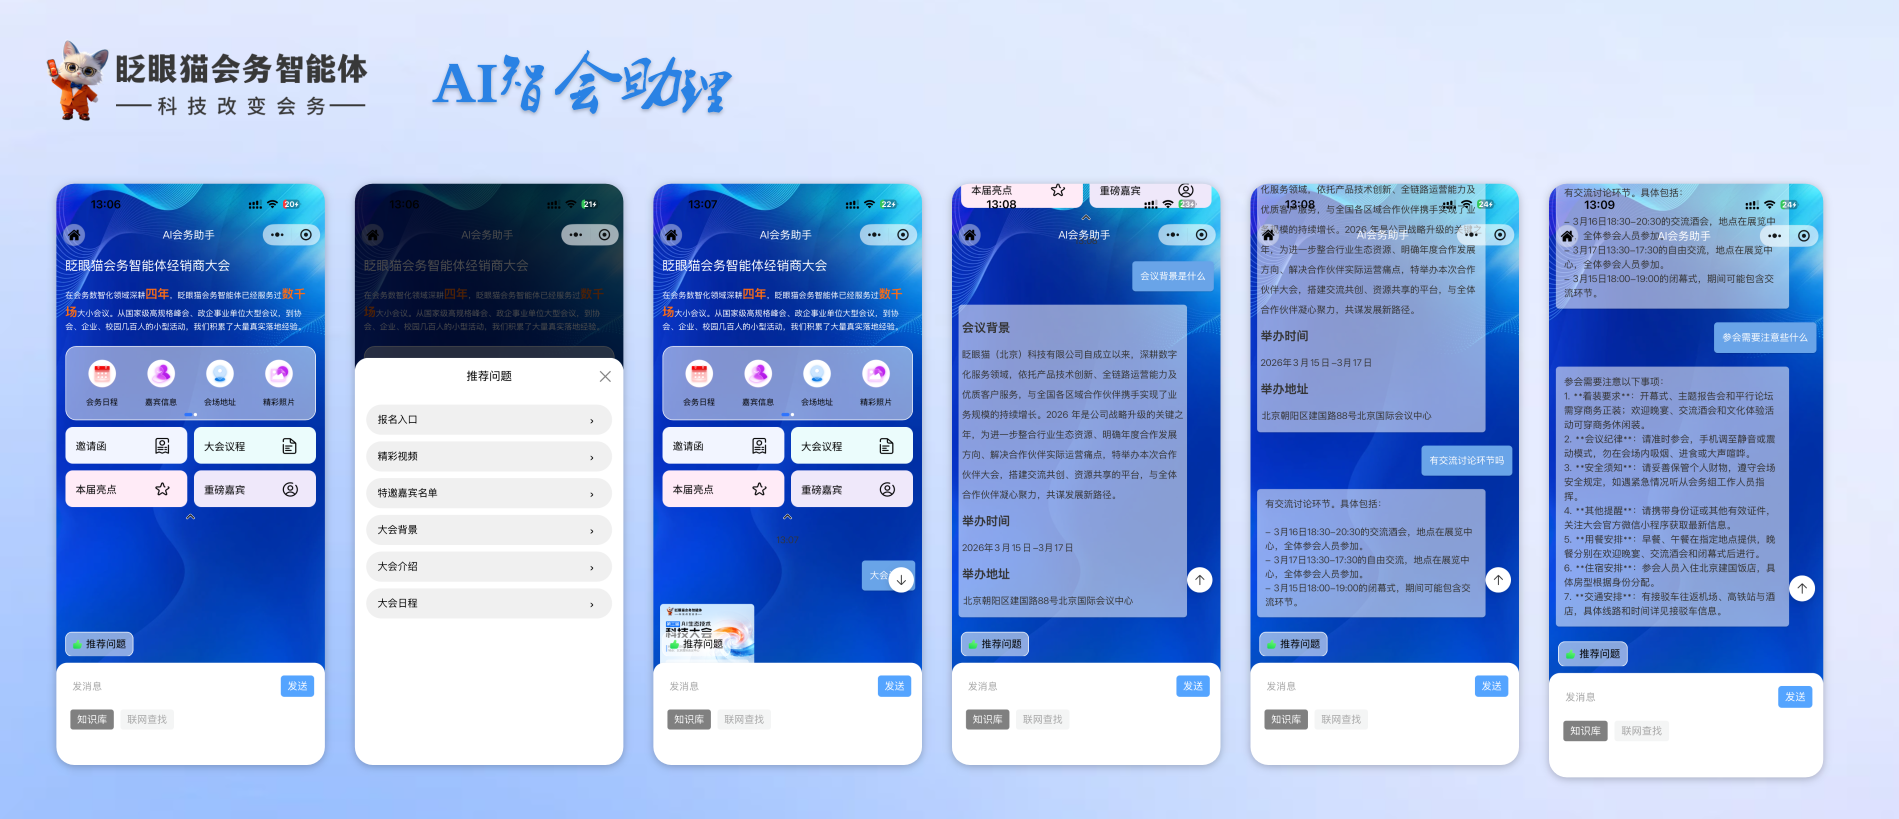
附:一款产品可作为架构对照样本。眨眼猫会务智能体的 AI 会务助理采用"自有知识库 + 大模型"结构,支持预置问题、关键词回复与模型兜底三条路径,大模型可在 DeepSeek、腾讯混元、阿里通义千问、百度文心一言中选配,答案支持文字、图片、视频、音频与小程序卡片,后台修改即时生效。本文无实测数据背书,不构成采购建议。