今天是2026年国家网络安全宣传周的电信日。今年宣传周的主题是"网络安全为人民 网络安全靠人民------智能时代 网安护航",电信日聚焦的正是反电信网络诈骗。
公安部在今年上半年的新闻发布会上提到,全国电诈犯罪案件立案数同比下降15.6%,见面劝阻群众292.6万人次。江苏公安的数据更具体:1至8月全省电诈案件立案数、损失数同比分别下降36.1%和47.8%。
成绩是实打实的。但另一个数据不能忽略------AI合成诈骗一季度的案发率同比涨了300%。传统诈骗的空间被压缩,新手法在加速冒出来。
于是问题变得很实际:当"对面是谁"不再可信,业务系统还能靠什么做判断?
多数人的第一反应是做一次IP地址查询,看看这个请求从哪儿来。查询当然是必要的,但只查归属地远远不够------归属地只回答了"在哪",没回答"可不可疑"。
账号会伪造,请求的来源不会凭空消失
过去几年反欺诈的思路基本围绕账号做,实名认证、人脸核身、短信验证码层层叠加,这套体系在很长时间里是有效的。
但它的前提在松动。AI换脸能通过活体检测,虚拟号码能收验证码,伪造的营业执照和收入流水几分钟就能生成。当身份材料本身可以批量制造,只盯"这个人是谁"就不够用了。
每一次欺诈行为,无论前端伪装得多好,最终都要落到一次真实的网络请求上。这个请求从哪里发起、走了什么路径、用了什么样的网络环境,伪造成本远高于伪造一张照片。IP风险识别处理的正是这部分判断:它不查"你是谁",而是看"这次访问像不像一个真实用户发起的"。
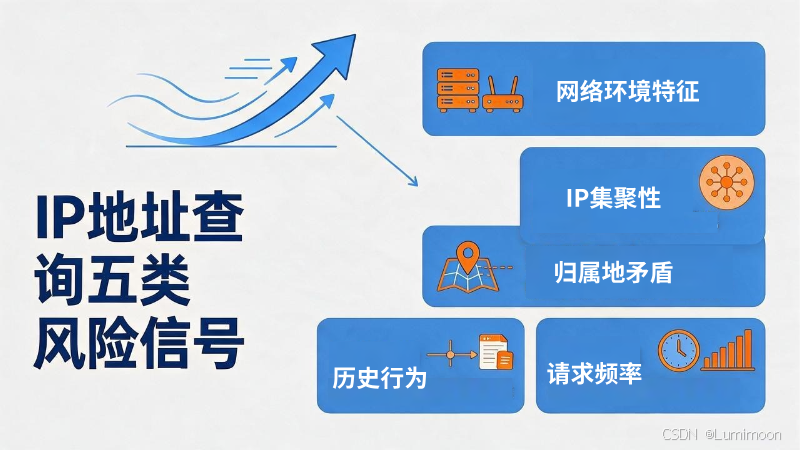
IP地址查询可提取的五类风险信号信息图
一次IP地址查询里,能提取哪些风险信号
**网络环境的伪装特征。**机房IP、秒拨IP、公共出口,都属于非住宅网络环境。真实用户的家庭宽带和企业专线有明显的网络特征,批量作案的请求则集中在数据中心段或高度聚集的IP段里。
**IP的集聚性。**单个IP可能看不出问题,但把同一批请求的IP摊开看,如果几百个账号的登录IP高度重合,或者集中在少数几个C段内,这就不是巧合。团伙作案受限于成本,很难做到IP完全分散。
**归属地与行为的矛盾。**这是IP地址定位最能发挥作用的地方。账号注册地在国内,登录IP长期在境外;GPS定位在上海,网络出口在另一个城市;设备时区、货币设置和IP归属地对不上。把归属地与设备、行为做一个交叉比对,矛盾点是强信号,同时伪造所有维度很难。
**IP的历史行为记录。**某个IP段过去是否被用于注册垃圾账号、是否出现过撞库、是否被多个已确认的欺诈账号共用过,这些历史决定了它当前的风险等级。这部分依赖数据积累,单一企业很难自建。
**请求频率与时间分布。**同一IP在凌晨集中发起大量注册,短期内反复调用验证类接口,这类模式需要和历史基线对比才能看出异常。
接入方式
以IP数据云的接口为例,接入的核心是一次查询加一个决策分支。
python
import requests

# IP 地址查询接口,一次调用同时拿到归属地与风险标签
IPRISK_API = "https://api.ipdatacloud.com/v1/risk/profile"

def risk_gate(ip: str, token: str) -> str:
    """查询 IP 风险识别结果并给出处置动作"""
    try:
        resp = requests.get(
            IPRISK_API,
            params={"ip": ip},
            headers={"Authorization": f"Bearer {token}"},
            timeout=1.5,      # 风控链路对延迟敏感,务必设超时
        )
        resp.raise_for_status()
        profile = resp.json()
    except requests.RequestException:
        return "pass"         # 查询失败走降级,别让风控成为单点故障

    # 接口返回的数据类型不可全信,做一次防御性转换
    try:
        score = float(profile.get("risk_score") or 0)   # 0-100,越高越可疑
    except (TypeError, ValueError):
        score = 0
    tags = set(profile.get("tags") or [])       # datacenter / abuse / history
    isp_type = profile.get("isp_type") or ""    # residential / hosting / mobile

    if score >= 80 or {"datacenter", "abuse"} & tags:
        return "block"
    if score >= 50 or isp_type == "hosting":
        return "challenge"
    return "pass"
有两个实践中的坑值得提。一是超时设置,风控环节每多一次外部调用就多一份延迟,把超时压在1秒左右,超时后走降级,不要让风控接口拖垮主链路。二是标签的用法,0到100的分数好看但不好用,真正有价值的是命中标签------是机房段、是历史滥用段、还是异常集聚段,不同标签对应不同处置动作,比卡一条分数线精准得多。
识别结果怎么用
全量拦截高风险IP会误伤。移动网络环境下运营商出口IP被大量用户共享,一刀切会挡住正常用户。
比较稳妥的是分层处置:高风险IP直接拦截,或强制走短信加人脸的双重验证;中风险IP正常放行但提高验证频率,同时监控后续行为;低风险保持原流程。真正需要重点盯的是那些分数不高但标签异常的请求,它们往往伪装得很好。
另一个容易被忽略的用法是把IP风险和账号、设备、手机号放在一起做关联分析。单个IP看不出问题,但几十个账号共享同一IP段、设备指纹又重叠,团伙就藏不住了。在这张关联网络里,IP是一个关键节点。
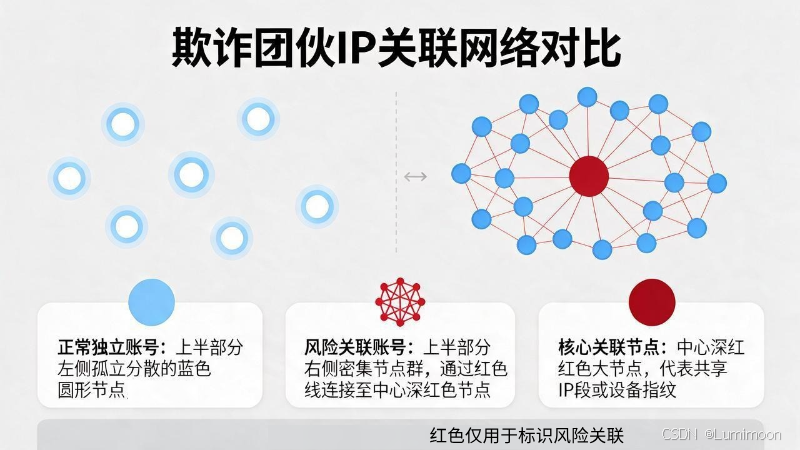
欺诈团伙IP关联网络示意图
顺带说下合规边界
今天是电信日,明天就是法治日,这里必须多说一句。
IP风险识别涉及个人信息处理,要在《个人信息保护法》框架内做。三条原则:目的正当(用于安全防护,不做无差别画像)、范围最小(只采集决策必需的特征)、结果可解释(拒绝决策能追溯到具体依据)。
操作上,建议只保留风险等级和标签,不长期留存完整行为轨迹;内部调用要有权限控制和审计日志;涉及个人权益的自动化决策,需要提供申诉渠道。这不是给业务加负担,而是让这套能力能稳定用下去。
写在最后
反诈的前端宣传和事后追赃当然重要,但效率最高的位置在中间------在欺诈发生的那个瞬间把它挡下来。
IP风险识别处理的就是这个环节,它替代不了实名认证和活体检测,但能在这些手段被绕过之后,补上一层基于网络行为的判断依据。对电商、金融、社交这类高风险场景来说,这层判断的价值,往往就体现在那些"看起来很正常"的请求里。
顺带说一句,做全球业务的话,一次IP地址查询拿到的归属地信息还能顺带解决时区适配、货币展示、内容合规这类问题。查询和风控共用同一份数据,是性价比比较高的做法。
明天法治日,聊聊IP数据和《个人信息保护法》之间的边界,以及几个常见的合规误区。