论文:Qwen2-Audio Technical Report(Chu et al., Alibaba 2024) · arxiv:2407.10759
一句话 :Qwen2-Audio 是通用音频语言模型(LALM · Large Audio-Language Model) ------输入音频(语音 / 声音 / 音乐 / 混合)+ 可选文本 prompt · 输出文本回复 · 一个模型同时做 ASR / 翻译 / 声音分类 / 情感识别 / 音乐分析 / voice chat。
展开一点 :架构极简------Whisper-Large-V3 encoder 权重初始化 + stride-2 pooling 压帧率 + Qwen-7B LLM decoder AR 生成文本 · 总参数 8.2 B · 非流式 (整套流水线继承 Whisper encoder 的 30 秒 padded window · 双向 attention · 全局输入)。跟 Qwen-Audio v1 相比:去掉层次化 special token (<|asr|><|zh|> 那种)· 改用自然语言 prompt ("Recognize the speech" / "Translate to English")· 训练形式跟后训一致 · 减少 pre-training / post-training 的形式 gap。三阶段训练 :Pre-training(40+ 任务音频-文本对 · encoder + LLM 都可训)→ SFT(增强指令跟随)→ DPO (对齐人类偏好 / 减幻觉)。两种交互模式 :Audio Analysis (音频 + 文本指令 → 分析)· Voice Chat (只音频 → 模型自动识别指令性内容并回答)------无需 system prompt 切换 · 模型自主判断 。开源 :github.com/QwenLM/Qwen2-Audio
一、问题与动机
audio-LLM / LALM 是什么 · 本文里的 LALM (L arge A udio-L anguage M odel)主要指音频(可加文本)输入 → 文本输出 的大音频语言模型 ------ 跟传统 ASR(音→文本)不同 · 它让 LLM 对音频做分析、问答、翻译、对话 等多种任务 · 而不只是转录。speech-in speech-out (GPT-4o 那种端到端语音对话)是另一支 · 输出是语音而不是文本 · 本篇不覆盖。2024 年这个方向分化出四种做法:
| 路线 | 代表 | 短板 |
|---|---|---|
| 专用 ASR · 传统 encoder-decoder | Whisper · Paraformer | ASR 精度和部署生态成熟 · 但只做 ASR · 换任务要换模型 |
| 专用 ASR · LLM-based | Seed-ASR | 在 ASR 评测上强化上下文与多语种识别 · 但依然只出转录文本 · 不做 audio understanding / voice chat |
| 通用 LALM · hierarchical tags | Qwen-Audio v1 · SALMONN | 一模型覆盖多类音频任务 · 但用层次化 special token 表达任务(类比 <task><lang> 控制符)· 训练/后训形式不一致 · 指令跟随能力弱 |
| 端到端 speech-in speech-out | GPT-4o | 端到端语音回复延迟低 · 但只有 system card / 产品说明 · 没有公开权重、训练数据和可复现的架构配方 · 学术复现困难 |
Qwen2-Audio 补的正是这块 :开源、通用、文本输出的 LALM · 用自然语言 prompt 统一 ASR、翻译、音频理解、voice chat(而不是为每个任务换模型或换 special token)。核心不是堆模块 · 是把 Whisper-Large-V3 encoder + stride-2 pooling + Qwen-7B decoder 拼成最短路径 ;真正的变化在任务表达和训练:用自然语言 prompt 替代 v1 的 hierarchical tags · 并用 Pre-training → SFT → DPO 三阶段覆盖 40+ 语音 / 声音 / 音乐任务。
流式 caveat (另一个容易误读的边界):Qwen2-Audio 论文口径是离线整段处理 · 官方没有原生 streaming policy · encoder 全局 attention、chunk 策略和外挂切片细节见 §2.1。
二、Qwen2-Audio 的构成
2.1 系统位置:通用音频语言模型(离线整段处理)
Qwen2-Audio 不是 ASR 模型 · 是 LALM ------输入音频(语音 / 声音 / 音乐 / 混合)+ 可选文本 prompt → 输出文本。可以类比为 音频版的 GPT-4 :一个 API 接所有音频任务、任务用自然语言 prompt 指定、模型自主判断该分析还是该对话。
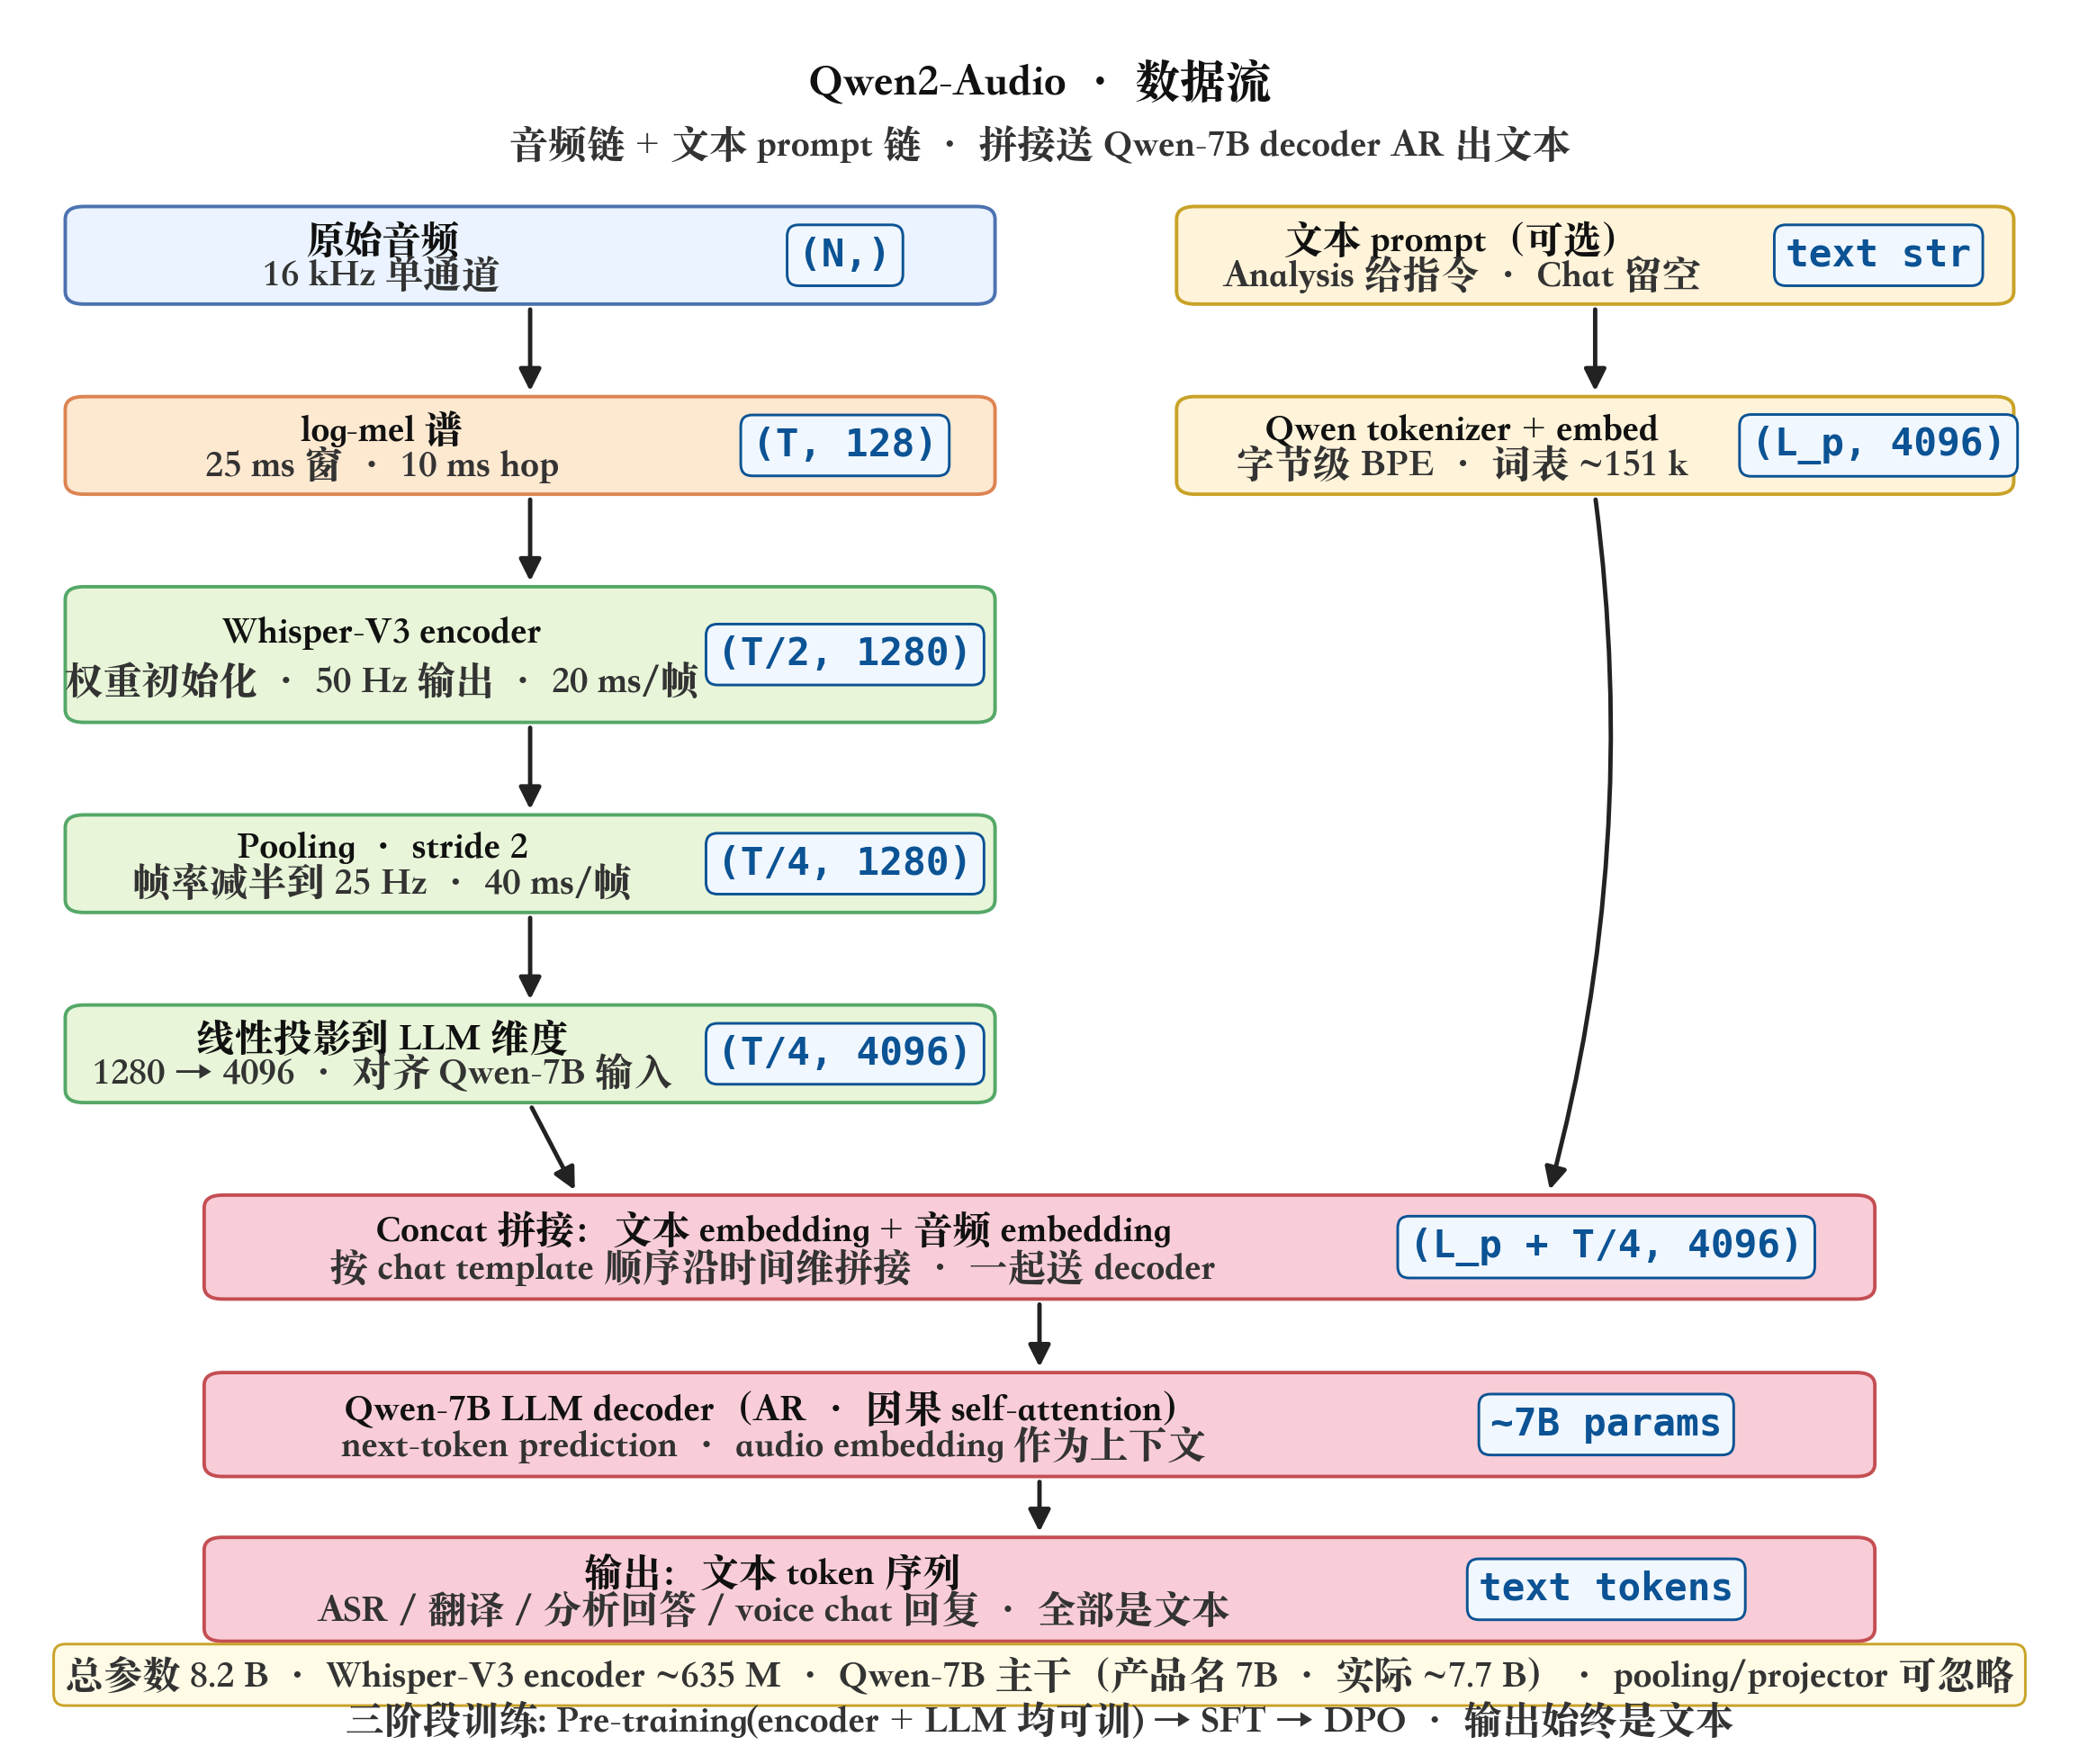
图 1:Qwen2-Audio 完整数据流 · audio encoder 用 Whisper-Large-V3 权重初始化 (不从零训 · 站在 Whisper 68 万 h 的先验上)· 加一层 stride-2 pooling 把帧率从 50 Hz 减到 25 Hz · text prompt 走 Qwen tokenizer embed · 两侧统一到 4096 维后拼接送 Qwen-7B decoder · 输出始终是文本。 无 special task token · 完全用自然语言 prompt 描述任务 。
shape 一目了然 :原始音频 (N,) · 16 kHz → 128 通道 log-mel spectrogram (T, 128)(25 ms 窗 · 10 ms hop · 100 帧/秒 )→ Whisper-Large-V3 encoder (T/2, 1280)(encoder 内部 conv 下采到 50 Hz · 20 ms/帧)→ stride-2 pooling (T/4, 1280)(25 Hz · 每帧对应 40 ms 音频)→ 线性投影到 LLM 输入维度 (T/4, 4096) → 跟文本 prompt embedding (L_p, 4096) 沿时间维拼接 → 送 Qwen-7B decoder · AR 输出 (seq_len, |V|)(V ≈ 151 k · Qwen 词表)。
"沿时间维拼接" 具体怎么拼(Mac 上跑 Qwen2 tokenizer 实测 · 完整 chat template 展开):
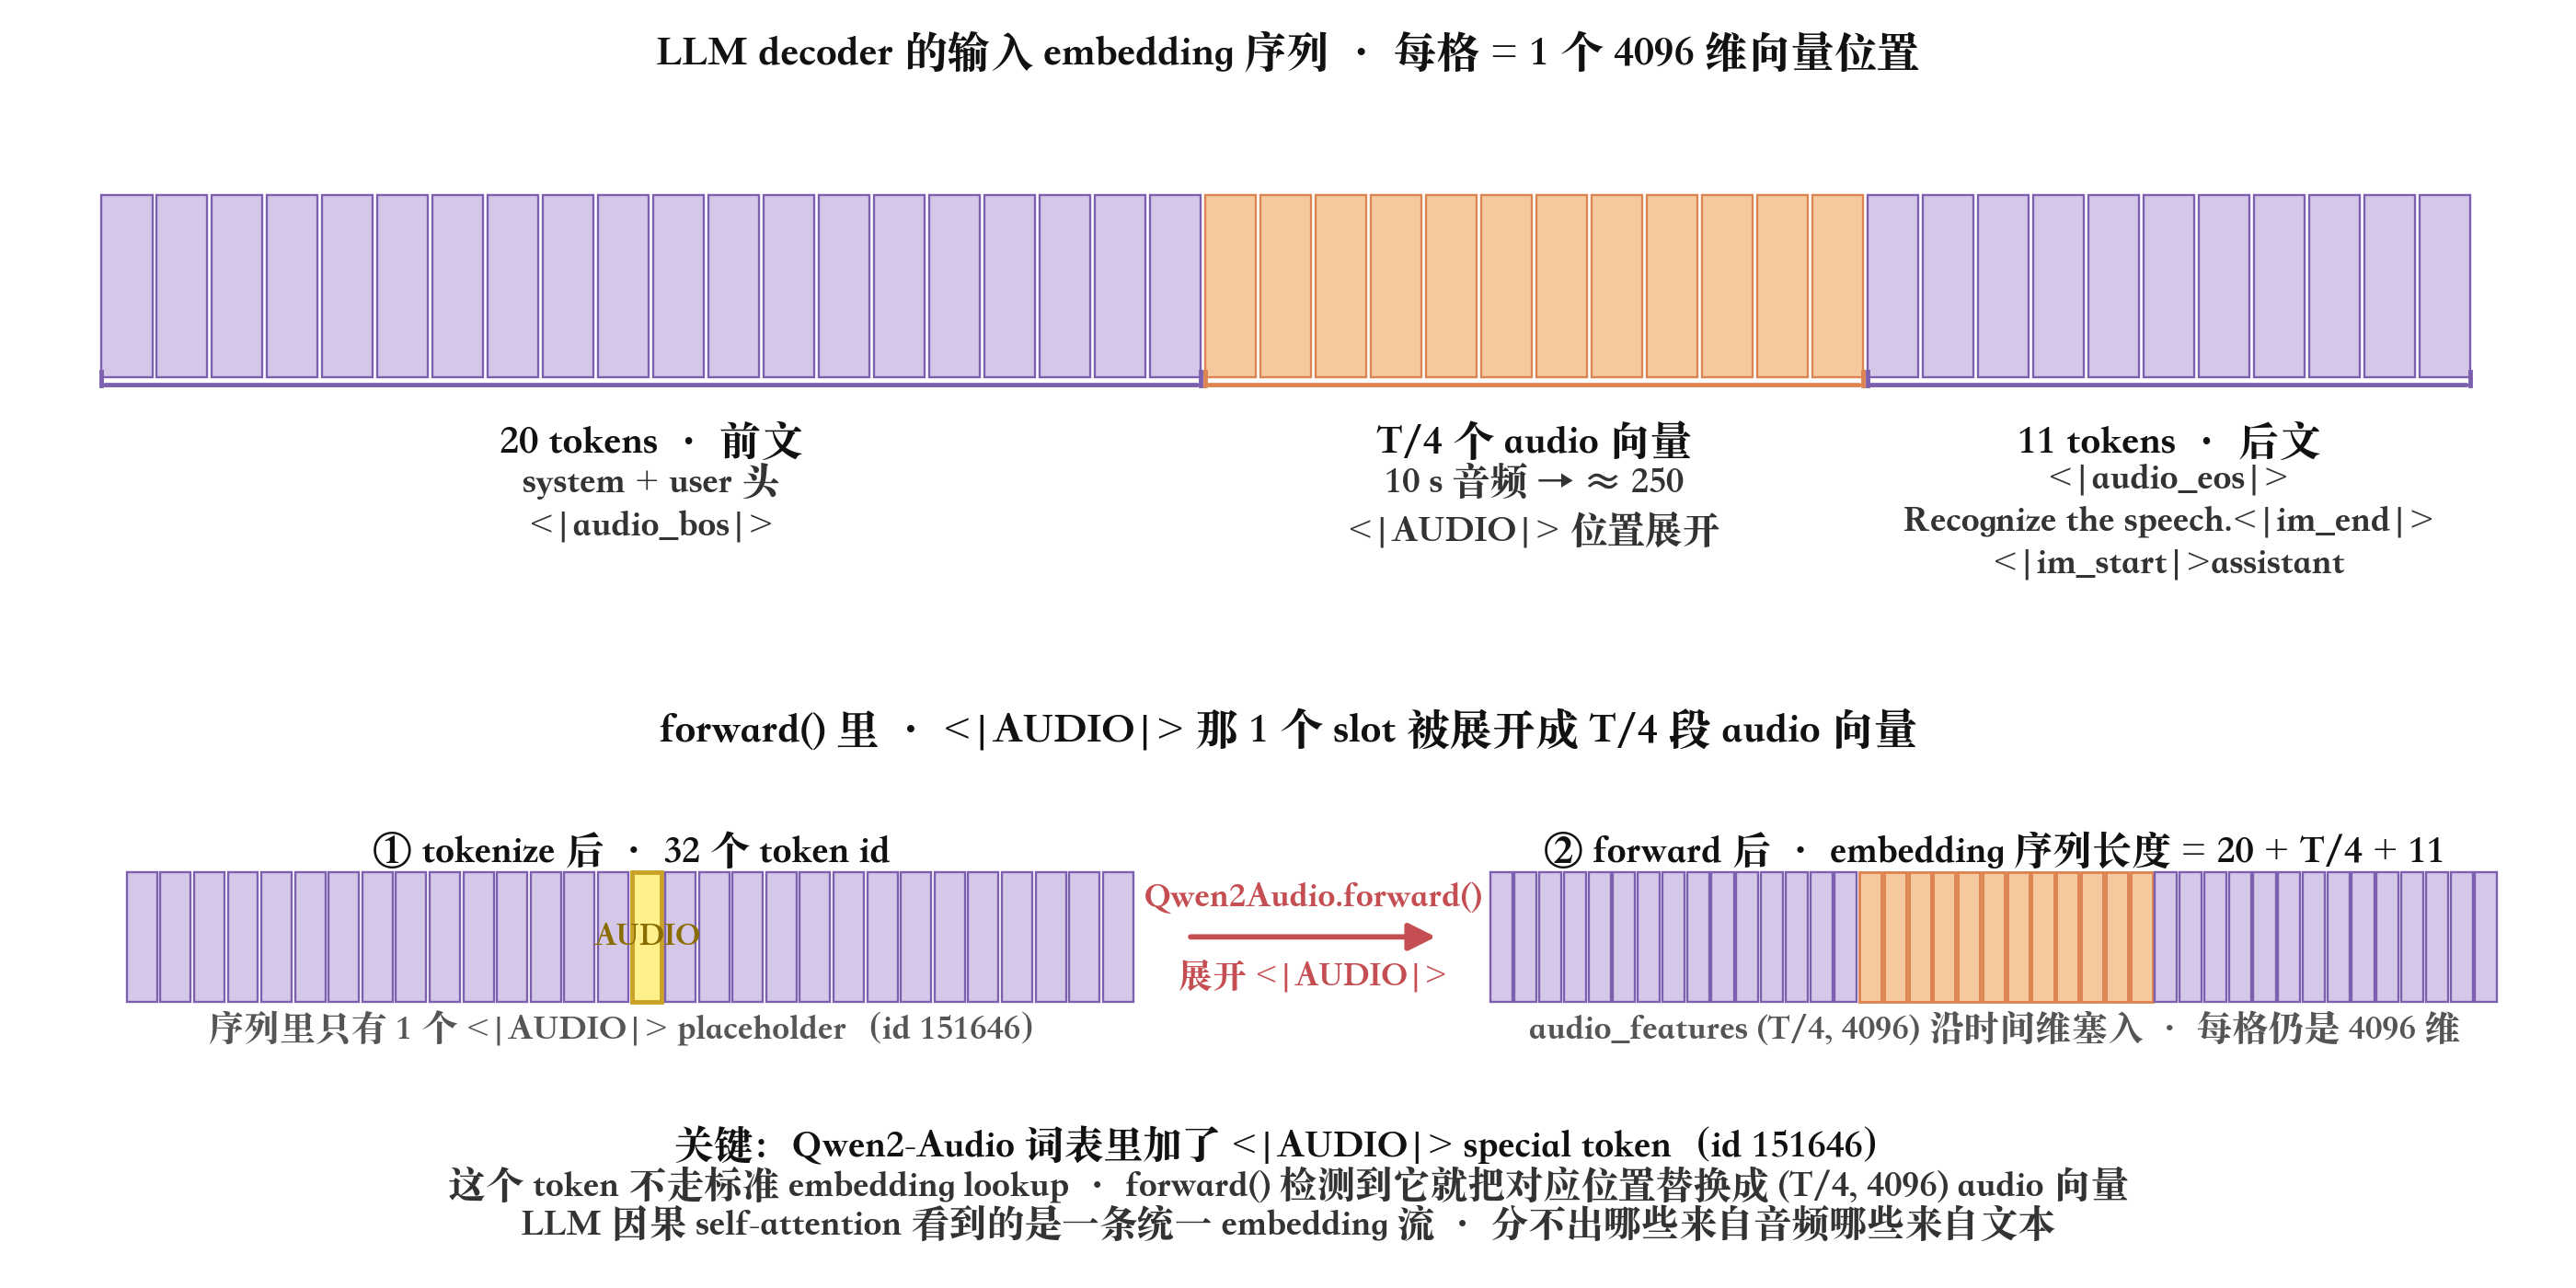
图 2: 上半 是 LLM 最终看到的 embedding 序列 · 每格 = 1 个 4096 维向量位置: 20 个前文 token (system + user 头 + <|audio_bos|>)+ T/4 个 audio 向量 (10 秒音频 ≈ 250)+ 11 个后文 token (<|audio_eos|>Recognize the speech.<|im_end|>...<|im_start|>assistant)。 下半 是"tokenize → forward 展开"两步:tokenize 后序列里只有 1 个 <|AUDIO|> placeholder (id 151646 · Qwen2-Audio 词表专加的 special token)· 走 Qwen2Audio.forward() 时这个 slot 被展开成 (T/4, 4096) 的 audio 向量 、原 placeholder 被替换掉。LLM 因果 self-attention 看到的是 一条统一的 embedding 流 · 分不出哪部分来自"音频"、哪部分来自"文本"。所以后文 §2.3 示例里的 [audio_tokens] 就是这个 T/4 段 audio 向量 · 语义上代表了整段音频。
总参 8.2 B = Whisper-Large-V3 encoder ~635 M + Qwen-7B ~7.7 B(+ pooling/projector 可忽略)。FP16 实测峰值 ~15.9 GB · int8 可压到 ~9.3 GB(详见 §2.3 实测段)· 4090 单卡宽松 · 端侧仍不友好。
2.2 整体结构:Whisper encoder + Qwen-7B decoder
极简两段 + 一个连接层:
| 组件 | why · 设计动机 | how · 关键机制 | shape · 输入 → 输出 |
|---|---|---|---|
| Log-mel 前端 | 沿用 Whisper 前端约定 · 保证 encoder 权重初始化后特征分布一致 | 重采样到 16 kHz · 25 ms 窗、10 ms hop · 128 通道 log-mel(比 Whisper 原版的 80 通道升级 · 因为 Whisper-Large-V3 就是 128 通道) | (N,) 波形 → (T, 128) 特征图(T ≈ 音频秒数 × 100) |
| Audio Encoder = Whisper-Large-V3 | 用现成 encoder 权重、不从零训 SSL------把 Whisper 68 万小时弱监督预训的表征直接搬过来 · 训练成本大幅降低 | 直接加载 Whisper-Large-V3 权重(32 层 encoder · 宽 1280 · sinusoidal PE · 2 层 Conv stem 2× 下采) · encoder 参与后续训练(不冻结) | (T, 128) → (T/2, 1280)(内部 conv 下采 · 20 ms/帧) |
| Stride-2 Pooling | 压帧率减少 LLM 需要吸收的 audio token 数------原生 50 Hz 拼上文本 prompt 后 context 长度爆炸 · pool 到 25 Hz 后 30 秒音频只有 750 个 audio token | 时间维 stride-2 pooling · 论文只说明 "a pooling layer with a stride of two" · 未细化 pooling 形式(mean / max / conv1d 都可能 · 需查开源实现进一步确认) | (T/2, 1280) → (T/4, 1280)(25 Hz · 40 ms/帧) |
| 线性投影 · projector | encoder 输出 1280 维 · LLM 输入是 4096 维 · 需要维度对齐 | 线性层(论文没细讲结构 · 从开源实现看是一层 Linear) | (T/4, 1280) → (T/4, 4096) |
| LLM Decoder = Qwen-7B | 直接用预训好的 Qwen-7B · 拿到它的文本生成 / 常识 / 推理 / 指令跟随基础能力 · 只需教它"听懂"音频输入这一模态 | 标准 decoder-only Transformer · 因果 self-attention · LLM 参数也参与训练(不冻结)· hidden 4096 · 词表 ~151 k | 文本 prompt (L_p, 4096) + audio (T/4, 4096) 拼接 → 输出 logits `(seq_len, |
总参数账 :Whisper-Large-V3 encoder ~635 M + Qwen-7B 主干(产品名 "7B" · 严格 ~7.7 B)+ pooling 参数量可忽略 + projector 少量参数 ≈ 8.2 B(论文口径)。
跟 Seed-ASR 的关键区别(同期"用 LLM 做 ASR"路线):
| 维度 | Seed-ASR | Qwen2-Audio |
|---|---|---|
| Audio encoder | 自训 LUISE(~2 B · 从零 SSL 预训) | 用 Whisper-Large-V3 权重初始化 |
| LLM decoder | 冻结 · 保留 LLM 常识不动 · 只 train encoder 侧的 audio adapter | 参与训练 · 让 LLM 学"听懂"音频这一模态 |
| 训练目标覆盖 | 专注 ASR | 40+ 音频相关任务(ASR + 声音分类 + 音乐分析 + voice chat + ...) |
| Prompt 表达 | ASR 单任务 · 无需 prompt 切换 | 自然语言 prompt · 任务用一句话描述 |
| 总参 | ~13 B(LUISE 2 B + LLM ~11 B 冻结) | 8.2 B(encoder ~635 M + Qwen-7B 主干 · 主干实际约 7.7 B · encoder / LLM 均可训) |
2.3 任务表达与两种交互模式
Qwen-Audio v1 的层次化标签(承袭 Whisper 的 special token 思路):
<|asr|><|zh|><|notimestamps|>今天天气不错<|endoftext|>Qwen2-Audio 改自然语言 prompt(下面 §"两种交互模式"给具体 chat 样例):
User:      [audio_tokens] Recognize the speech.
Assistant: 今天天气不错为什么这么改------三条理由:
- Pre-training 用自然语言、post-training(SFT / DPO)也用自然语言 · 两阶段形式一致 · 减少 pre-training / post-training 的表达 gap(论文 Abstract 强调的核心动机之一)
- 指令跟随能力天然强------LLM 已经在自然语言指令上 fine-tune 过 · 直接迁移过来 · 不用重新学一套 special token 语义
- 多任务无需扩词表 · 无需 special task token------所有任务共用一套 LM head · 加新任务只是加新 prompt · 训练管线不变
代价:prompt 表达力更宽泛、但也更"松"------同一个任务不同 prompt 措辞可能出微妙不同的结果(LLM 常见现象)。论文选择这条路是判断"指令跟随 gap 缩小"的收益 > "prompt 变量增加"的代价。
两种交互模式:Audio Analysis 与 Voice Chat
Qwen2-Audio 支持两种交互模式 · 不需要 system prompt 切换 · 模型自主判断。
Audio Analysis 模式:音频作为分析对象 · 指令通过文本或音频
用户给一段音频(任意类型:语音 / 声音 / 音乐 / 混合)+ 文本 prompt · 模型分析音频并回答文本 prompt 的问题。
例 1 · ASR + 翻译混合任务:
[audio: "今天天气不错"]
User: Recognize the speech and translate it to English.
Assistant: 今天天气不错 · The weather is nice today.
例 2 · 音频情感识别:
[audio: 一段悲伤语气的英文对话]
User: What's the mood of the speaker?
Assistant: She is sad.
(论文 Figure 2 · SFT 阶段样例)
例 3 · 声音事件分类:
[audio: 键盘敲击 3 秒]
User: What is this sound?
Assistant: This is the sound of a keyboard.
例 4 · 音乐描述:
[audio: 一段吉他独奏]
User: Describe this piece of music.
Assistant: This piece of guitar music, with its soothing folk style, conveys a sense of calmness and nostalgia.
(论文 Figure 2 · DPO 阶段"好回复"样例)
指令也可从音频里给------比如音频里用户说"识别一下这段话" · 模型自主辨别音频里哪部分是"要分析的内容"、哪部分是"指令"。
典型场景:离线音频分析 · 音频问答系统 · 音频转写 + 结构化解析。
Voice Chat 模式:用户只给音频 · 模型自动识别指令性内容并直接回答
用户只输入音频(没有文本 prompt)· 音频里可能是用户口述的问题 / 命令 / 混合背景 · 模型直接从音频里理解意图、给出文本回复。
例 5 · 混合背景 + 用户问题(论文 Introduction 原例):
[audio: 前半 = 键盘敲击声 · 后半 = 用户问 "What is this sound?"]
Assistant: This is the sound of a keyboard.模型自主分辨了"键盘声"是分析对象 、"What is this sound?"是用户指令。
例 6 · 情感对话(论文 Figure 2 · SFT Voice Chat 样例):
[audio: 用户说 "I lost my phone today..."]
Assistant: I'm sorry to hear that! Losing your phone can be frustrating.
模型识别语音内容 → 触发共情式回复(不是转录、不是分析、是 chat)。
注意 :voice chat 模式下模型只能基于自身权重内的常识回答 · 无实时工具调用 · 无联网查询 · 用户问"明天天气"这类需要实时信息的问题 · 模型只能给出通用回复模板 / 建议查询工具 · 无法直接给出真实天气数据。
典型场景:voice assistant 型交互 · 无需打字。
怎么用:读法表 + 模式切换 + 代码 API
同一个模型 · 同一次前向 · 靠"有没有 text prompt"和"prompt 内容是什么"来切模式:
| 想要的行为 | 输入配置 | 模型行为 |
|---|---|---|
| ASR 转写 | audio + "Recognize the speech." |
出转录文本 |
| 翻译到英文 | audio + "Translate the audio to English." |
出英译文本 |
| 声音分类 | audio + "What is this sound?" |
出声音事件描述 |
| 情感识别 | audio + "What emotion is the speaker showing?" |
出情感标签 |
| Voice Chat(自由对话) | audio · 无 text prompt | 从音频识别用户意图 · 直接给文本回复 |
关键 :模式切换不是靠 special token / 也不是靠 system prompt · 就是靠 text prompt 是否为空 + prompt 的自然语言语义。模型在 SFT 阶段学会了如何辨别音频里哪部分是"要分析的对象"、哪部分是"用户指令" ------SFT 数据是把两种模式混合训的(论文明确 "both interaction modes were jointly trained")· 使用时无需人工切换。
代码 API 示例(HuggingFace transformers · 基于 Qwen2AudioForConditionalGeneration):
from transformers import Qwen2AudioForConditionalGeneration, AutoProcessor
import librosa

model = Qwen2AudioForConditionalGeneration.from_pretrained(
    "Qwen/Qwen2-Audio-7B-Instruct", device_map="auto")
processor = AutoProcessor.from_pretrained("Qwen/Qwen2-Audio-7B-Instruct")

# ── 模式 A · Audio Analysis:音频 + 文本指令 ──
audio_analysis, _ = librosa.load("input.wav", sr=16000)
conversation = [{
    "role": "user",
    "content": [
        {"type": "audio", "audio_url": "input.wav"},
        {"type": "text",  "text": "Recognize the speech and translate to English."},
    ],
}]
text = processor.apply_chat_template(conversation, add_generation_prompt=True)
inputs = processor(text=text, audio=[audio_analysis],  # transformers ≥ 5.0:参数名从 audios 改成 audio
                   sampling_rate=16000, return_tensors="pt")
out_a = model.generate(**inputs, max_new_tokens=256)
print(processor.batch_decode(out_a, skip_special_tokens=True))

# ── 模式 B · Voice Chat:只有音频 · 无 text prompt ──
audio_chat, _ = librosa.load("voice_query.wav", sr=16000)
conversation_chat = [{
    "role": "user",
    "content": [
        {"type": "audio", "audio_url": "voice_query.wav"},
    ],
}]
text_chat = processor.apply_chat_template(conversation_chat, add_generation_prompt=True)
inputs_chat = processor(text=text_chat, audio=[audio_chat],  # 同上
                        sampling_rate=16000, return_tensors="pt")
out_b = model.generate(**inputs_chat, max_new_tokens=256)
print(processor.batch_decode(out_b, skip_special_tokens=True))
这套 API 的关键 :调用方不用显式指定模式 · SFT 已经把模式判断学进模型里。想要哪种行为、就写对应的自然语言 prompt(或不写 prompt 走 chat 模式)。
实测(RTX 4090 · transformers 5.14 · bf16 / fp16 / int8 三档) :加载 fp16 / bf16 权重后 resident 显存约 15.6 GB · 单条 10 s 音频前向峰值约 15.9 GB · Mode A(ASR + 英译)单次耗时约 0.75 s / 37 tokens (≈ 20 ms/token)------ 比常见"约 20 GB"的估算低一档 · 4090 单卡有 8 GB 富余 。int8(bitsandbytes)能把峰值压到约 9.3 GB · 代价是每 token 延迟从 20 ms 涨到 50 ms · 但换来消费级 12 GB 卡也能跑。用 demo_en.wav(10 s 英文 TTS)跑 Mode A 得到:"The speech in the audio translates to: 'Good morning everyone, welcome to today's speech recognition tech share. Today's focus is on the five-generation evolution of automatic speech recognition.'" ------转写 + 翻译一次前向出 ;同一段音频去掉 text prompt 走 Mode B · 模型自动把音频当成用户问句、给出对话式回复(有时是简短转述、有时展开成一段延展说明)------ 这就是"同一次前向 · 靠 prompt 是否为空切模式"的实际行为。
能力边界 (这套架构做不到的事):
- 输出始终是文本 ------不是 speech-in speech-out · voice chat 想要"语音回答"必须外挂 TTS · 跟 GPT-4o 那种真端到端语音对话差一档
- 非流式------继承 Whisper encoder 的 30 秒 padded window + 全局双向 attention · 输入侧不能边听边解码 · 低延迟场景需要外挂 chunk 切分 · 或换其它流式模型
- 单次前向 30 秒窗口------Whisper encoder 训练时输入固定 30 s · 超长音频要外挂切片 + 上下文拼接(跟 Whisper 一样的 buffered transcription 思路)· 论文没给出长音频原生处理方案
- 8.2 B 部署门槛高------FP16/BF16 实测峰值约 15.9 GB · 端侧 / 移动端不友好 · 主要走云端 API 或服务器 GPU
- 多轮长音频对话未充分展示 ------论文主结果集中在单轮 audio-prompt-response 场景 · 跨轮 audio context 保持能力(比如"我再放一段音频")没深入评估
- 训练数据不完全公开 ------Table 1 数据表在 LaTeX 源码里被
comment掉了 · 精确任务列表和小时数没在正式表格里公布 · 完全独立复现难
2.4 训练数据:40+ 任务 · 覆盖语音 / 声音 / 音乐
论文正文没有完整放出数据表(Table 1 被 \begin{comment} 注释掉了 · 只在 LaTeX 源码里能看到)· 但注释块里的部分任务级清单可以还原核心口径(注意 :注释块给的是分任务小时数清单 · 跟下面 Figure 3 的三大类总量口径不同 · 不应直接相加核对):
| 类型 | 任务 · 描述 | 小时数 |
|---|---|---|
| Speech · 语音 | ASR(多语种) | 30 k |
| S2TT(语音到文本翻译) | 3.7 k | |
| OSR(重叠语音识别) | <1 k | |
| Dialect ASR(方言 ASR) | 2 k | |
| SRWT(word-level 时间戳 ASR · 英语) | 10 k | |
| SRWT(word-level 时间戳 ASR · 中文) | 11 k | |
| DID(方言识别) | 2 k | |
| LID(语种识别) | 11.7 k | |
| SGC(说话人性别) | 4.8 k | |
| SAP(说话人年龄) | 4.8 k | |
| SER(Speech Entity Recognition · 语音实体 识别 · 跟 Meld 的 speech emotion recognition 不是同一任务) · SV · SD · KS · IC · SF · VSC · ER(Emotion Recognition · Meld 用的这个) | 各 <1 k · 或 1-1.2 k | |
| Sound · 声音 | AAC(音频描述) | 8.4 k |
| SEC(声音事件分类) | 5.4 k | |
| ASC(声学场景分类) · SED · AQA | 各 <1 k | |
| Music · 音乐 | MC(音乐描述) | 25 k |
| MGR(音乐流派) | 9.5 k | |
| SID · SMER · MIC · MNA · MR · MQA | 各 <1 k |
总规模 ------论文的 pretrain_hours.png 汇总图给出三大类总量:Speech 约 370 k h · Sound 约 10 k h · Music 约 140 k h · 合计约 520 k h (跟 Whisper 68 万小时同量级)· 显著大于 Qwen-Audio v1 的规模。关键 :同一个模型训 40+ 音频相关任务 · 每个任务用自然语言 prompt 描述、模型自主分辨。
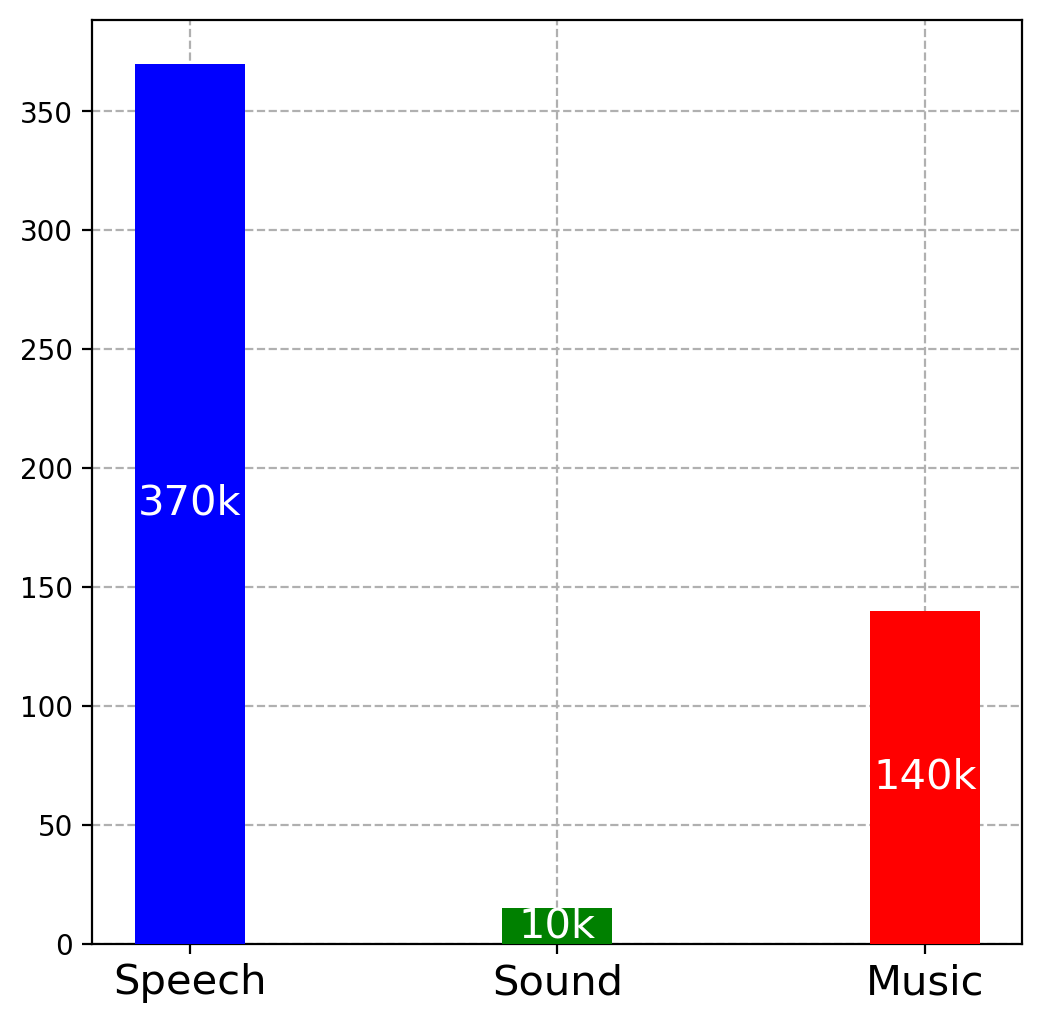
图 2:Qwen2-Audio 预训数据总量(论文 Figure 3)------Speech / Sound / Music 三大类各自的小时数柱状图 · 图内标注 370 k / 10 k / 140 k · Speech 占绝对主导 。这是 总量口径 · 分任务口径论文只在 LaTeX 源码注释里给出(见上表)。
数据不完全公开 ------LaTeX 源码里 Table 1 被 \begin{comment} ... \end{comment} 包起来 · 正文只留了一张 pretrain_hours.png 汇总图 · 分任务清单和精确小时数没在正式表格里公布。注释块提供的是任务级清单 、Figure 3 提供的是三大类(Speech/Sound/Music)总量 · 两者口径不同、不应互相加和核对。这是模型能力可复现性的一个 caveat。
2.5 三阶段训练:Pre-training → SFT → DPO
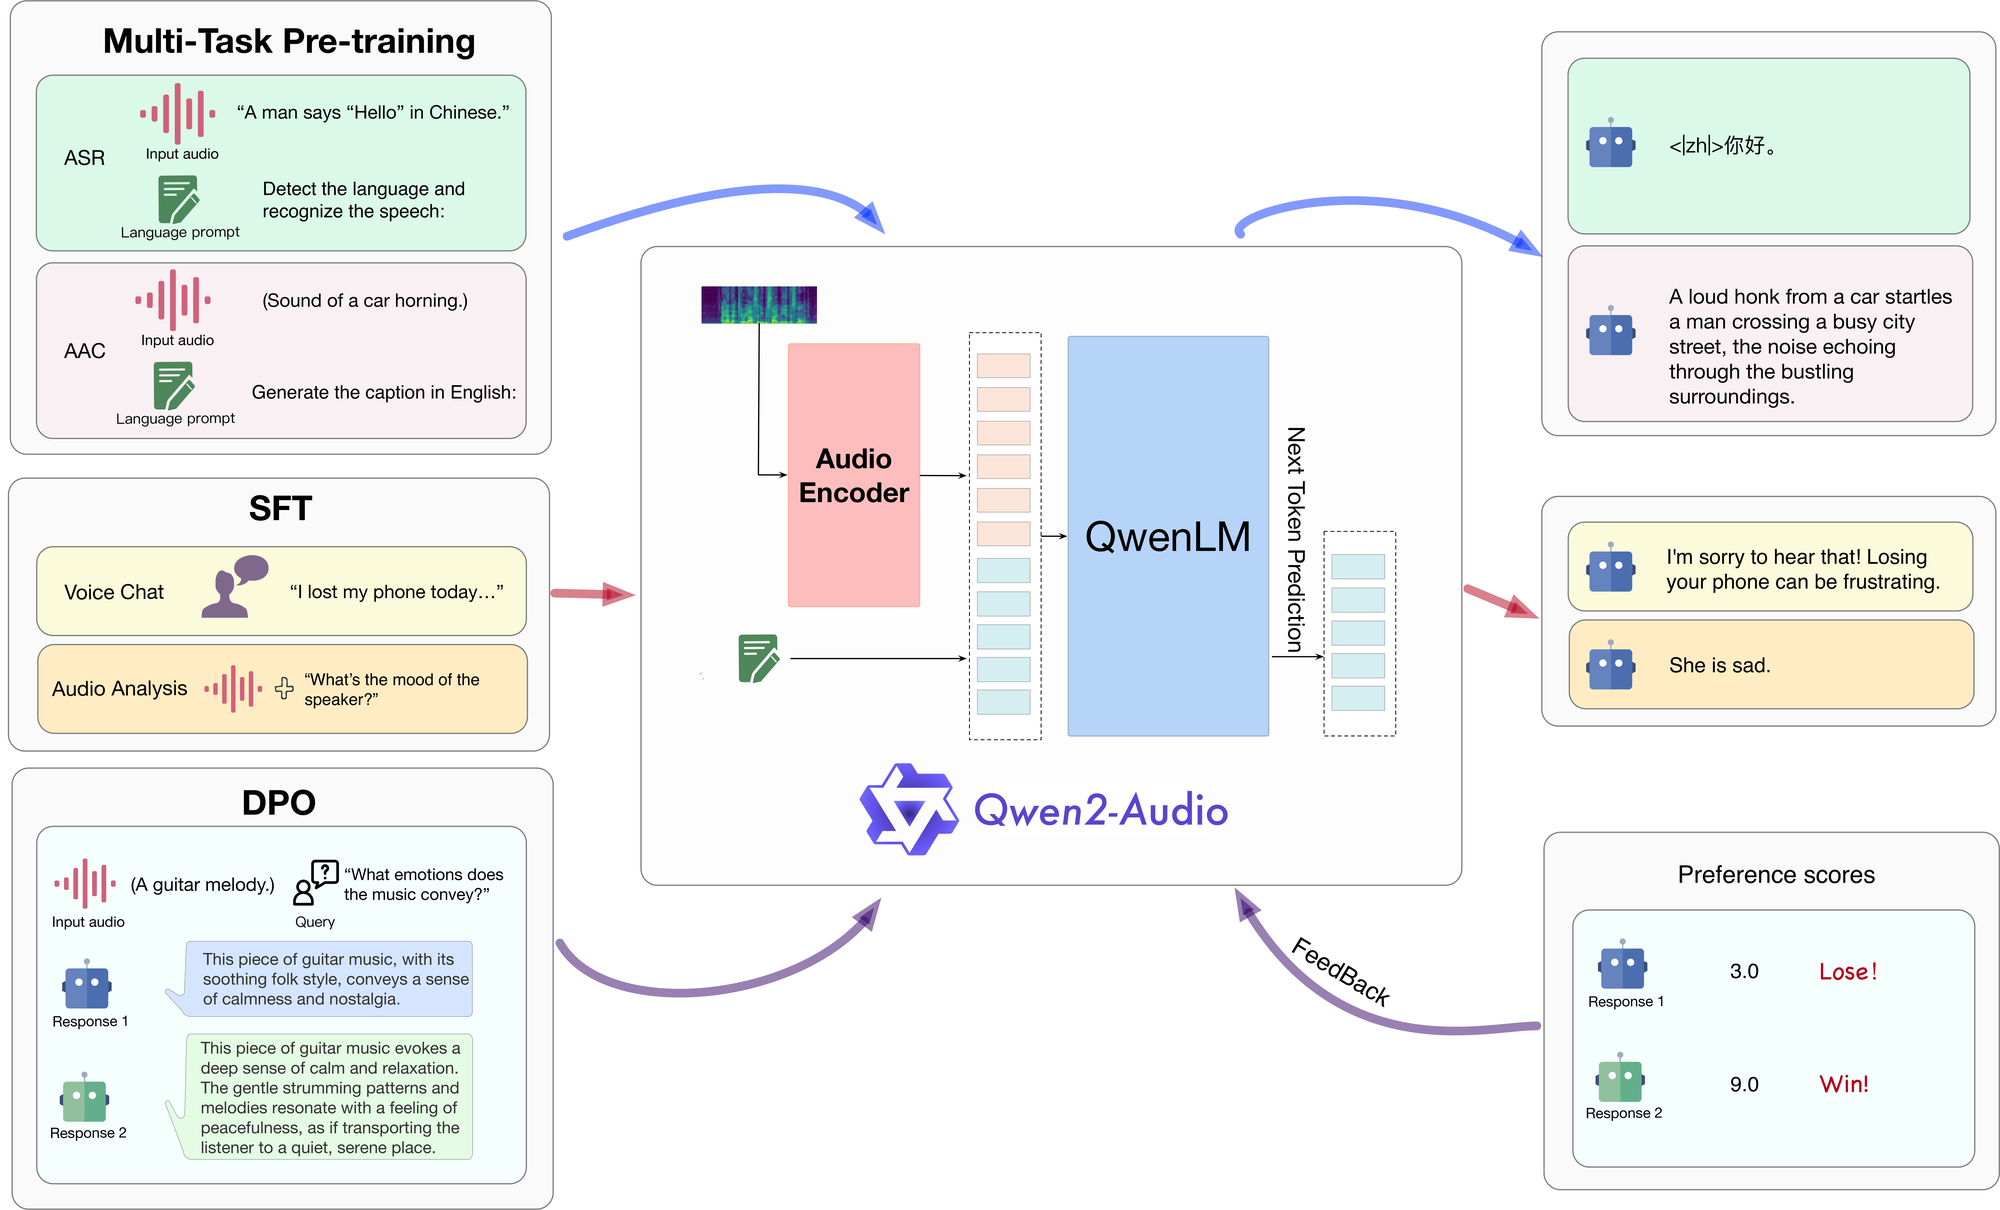
图 3:Qwen2-Audio 三阶段训练总览(论文 Figure 2)· 左路 是三阶段各自的 数据形态 :Pre-training 覆盖 ASR / AAC 等 40+ 任务的"音频 + 自然语言 prompt"对 · SFT 用 Voice Chat(只音频输入)+ Audio Analysis(音频 + 文本指令)两种模式的高质量指令数据 · DPO 是"音频 + query · 两条 response · 偏好评分"三元组。 中路 是 共享的模型主干 (Audio Encoder + QwenLM · Next Token Prediction · 三阶段共用)· 右路 是 每阶段的输出示例 。三阶段用同一套主干、同一种 next-token 生成 objective · 只是 训练数据的形态和监督信号不同 。
Stage 1 · Pre-training ------大规模弱标监督:
- 数据:上述 40+ 任务的音频-文本对 · 每条样本是
(audio, text_prompt, text_target)三元组 · 有些任务 text_prompt 是空(比如纯 ASR) - 训练目标:next token prediction · 目标函数
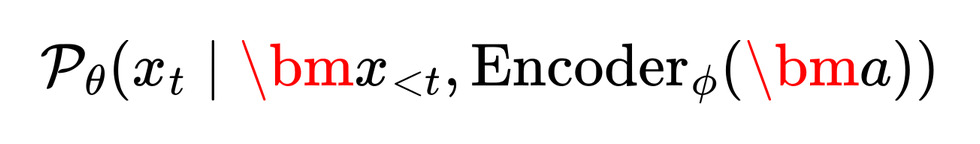
其中 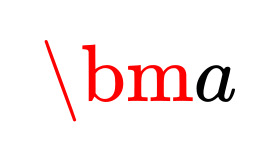 是音频 ·
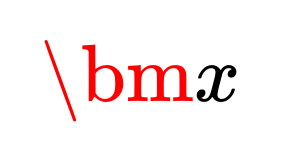 是文本 ·
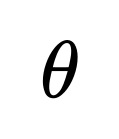 /
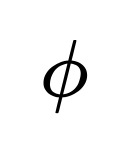 分别是 LLM / audio encoder 的可训参数 - 可训参数 :encoder 和 LLM 都参与训练(不冻结)· 这是跟 Seed-ASR "LLM 冻结" 路线的关键区别
Stage 2 · SFT(Supervised Fine-Tuning · 指令微调):
- 数据:精心 curate 的高质量指令-音频-回复三元组 · 论文强调"质量与复杂度对模型性能有关键影响"
- 目标:增强指令跟随 · 让模型学会"这段音频里哪部分是要分析的对象、哪部分是用户在给指令"
- 输出:Qwen2-Audio-Instruct 模型 · 支持两种交互模式(见 §2.3)
Stage 3 · DPO(Direct Preference Optimization · 直接偏好优化):
- 数据:三元组
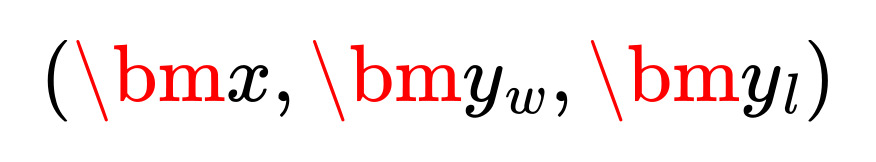 ·
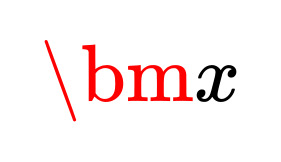 是输入(含音频)·
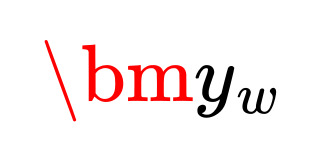 是人类标注的"好回复"·
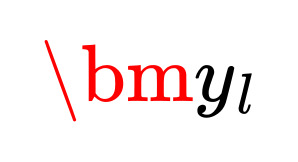 是"差回复"
- 损失函数:
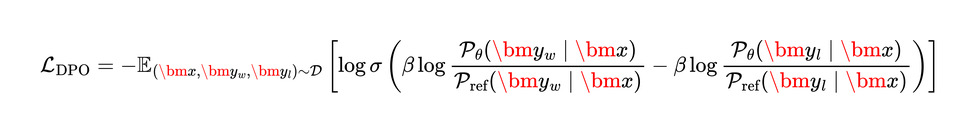
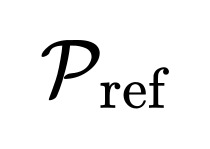 是参考模型(用 SFT 后的
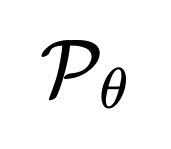 初始化并冻结)·
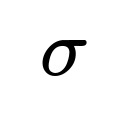 是 sigmoid ·
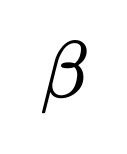 是温度参数 - 目标:提升 factuality · 减少幻觉 · 对齐人类偏好 · 论文明确 DPO 用于 factuality 和期望行为遵循两方面;AIR-Bench 报告的是最终模型(含 DPO)结果 · 论文没给"去 DPO"的 ablation · DPO 单独增益无法从公开数据量化
为什么 DPO 而不是 RLHF------DPO 不需要单独训 reward model、直接从偏好对里优化 policy · 训练稳定性 / 工程成本都优于 RLHF · Qwen 系列大模型 post-training 也走这条路线。
三、实验(要点)
Qwen2-Audio 在 13 个测试集 上评估 · 覆盖 ASR / S2TT / SER / VSC / AIR-Bench Chat。先说口径 :Common Voice 15 不是 zero-shot------论文明确 Qwen2-Audio 在该数据集上有监督评估、Whisper-Large-V3 是零样本 · 这组数字不能当同口径横比。
AIR-Bench Chat(音频指令跟随 · GPT-4 自动评审 · 0-10 · 越高越好):
| 模型 | Speech | Sound | Music | Mixed-Audio |
|---|---|---|---|---|
| SALMONN | 6.16 | 6.28 | 5.95 | 6.08 |
| BLSP | 6.17 | 5.55 | 5.08 | 5.33 |
| Pandagpt | 3.58 | 5.46 | 5.06 | 4.25 |
| Macaw-LLM | 0.97 | 1.01 | 0.91 | 1.01 |
| SpeechGPT | 1.57 | 0.95 | 0.95 | 4.13 |
| Next-gpt | 3.86 | 4.76 | 4.18 | 4.13 |
| Qwen-Audio v1 | 6.47 | 6.95 | 5.52 | 6.08 |
| Gemini-1.5-pro | 6.97 | 5.49 | 5.06 | 5.27 |
| Qwen2-Audio | 7.18 | 6.99 | 6.79 | 6.77 |
在论文 AIR-Bench 口径下 · Qwen2-Audio 四个维度均高于 Gemini-1.5-pro · 其中 Music(+1.73)和 Mixed-Audio(+1.50)差距最大。双 caveat 一起看:AIR-Bench 用 GPT-4 自动评审 · 代表论文口径下的相对趋势 · 不等同人工偏好或线上体验;Gemini-1.5-pro 因 SAFETY 限制测试样本减少约 1/5 · 样本缺失会影响直接横比口径。
ASR ------ LibriSpeech test-clean / test-other WER 1.6 / 3.6 ;Aishell2 Mic / iOS / Android WER 3.0 / 3.0 / 2.9 (iOS 分项 Qwen2-Audio 3.0、Paraformer-large 2.9 才是表内最优 );FLEURS-zh WER 7.5 略低于 Whisper-Large-V3 的 7.7。Common Voice 15 en / zh / yue / fr 8.6 / 6.9 / 5.9 / 9.6 · 但如上口径说明这组不是 zero-shot 横比 · 不能读作"明显打过 Whisper"。更稳的说法:Qwen2-Audio 在多个 ASR benchmark 上接近或略优强基线 · 同时保留通用音频任务能力。
S2TT · CoVoST2(BLEU · 越高越好):
| 方向 | Qwen2-Audio | Qwen-Audio v1 | Baselines |
|---|---|---|---|
| en-de | 29.9 | 25.1 | SALMONN 18.6 · BLSP 14.1 |
| de-en | 35.2 | 33.9 | SpeechLLaMA 27.1 |
| en-zh | 45.2 | 41.5 | SALMONN 33.1 |
| zh-en | 24.4 | 15.7 | SpeechLLaMA 12.3 |
| es-en | 40.0 | 39.7 | SpeechLLaMA 27.9 |
| fr-en | 38.5 | 38.5 | SpeechLLaMA 25.2 |
| it-en | 36.3 | 36.0 | SpeechLLaMA 25.9 |
7 个方向里 6 个严格优于 v1 · fr-en 持平;zh-en 从 15.7 到 24.4 是最大增量(+8.7 BLEU);双向翻译都能做(Whisper 只做 X→en)。
SER + VSC ------ VocalSound test ACC 0.9392 (高于 CLAP 0.4945 / Pengi 0.6035 / Qwen-Audio v1 0.9289)。Meld SER ACC 0.553 · 略低于 Qwen-Audio v1 的 0.557 · 差异很小 · 可能与小样本细分类任务的多任务训练权衡有关 · 论文未做消融、不能定因。
总结 :论文 §1 明确主张的零样本 SOTA 只限定在 Aishell2 / FLEURS-zh / VocalSound / AIR-Bench Chat 四个 benchmark (Common Voice 15 不属于 zero-shot 口径)。更大的贡献不是某个单项指标碾压 · 而是一个模型同时覆盖 ASR / 翻译 / 声音分类 / 情感识别 / 音频指令跟随。
四、局限与分析
-
Whisper encoder 带来的非流式与长音频成本 ------ Qwen2-Audio 输入侧继承 Whisper encoder · 官方论文与架构没有原生 streaming policy;Whisper encoder 用 30 秒 padded window + 双向 self-attention · stride-2 pooling 后约 40 ms / audio token · 30 秒音频约 750 audio tokens · 长音频需要外挂切片 + 上下文拼接。多轮长音频对话 再叠加文本 prompt 后 · 显存 / 延迟 / context 管理一起变成工程问题。LLM decoder AR 天然半流式友好 · 但 encoder 侧的 audio embedding 必须整段过完才可用 ------ decoder AR 不等于系统流式。
-
交互闭环不是端到端 speech-in speech-out ------ 论文里的 "voice chat" 指"用户可以用语音输入让模型理解指令"· 不是模型端到端语音回复。Qwen2-Audio 的输出始终是文本;想要"语音回答"必须外挂 TTS · 跟 GPT-4o 那种真端到端语音对话差一档。
-
8.2 B 部署门槛 ------ 总参数约 8.2 B(Whisper-Large-V3 encoder ~635 M + Qwen-7B 主干 ~7.7 B)。FP16/BF16 实测峰值约 15.9 GB(详见 §2.3 实测段)· int8 可压到 ~9.3 GB · 主要走服务器 GPU 或云端 API;端侧 / 移动端 / 低成本实时服务门槛仍明显。
-
公开信息与评测覆盖不足 ------ 论文只公开较粗的 Speech / Sound / Music 小时数汇总图(
pretrain_hours.png)· Table 1 pre-training 数据表在 LaTeX 源码里被\begin{comment}注释掉 · 完整任务列表和精确小时数没在正式表格里公开 · 独立复现难度高。实验主要集中在单轮 audio-prompt-response 场景;跨轮 audio context 保持("我再放一段" / "刚才那段音频里第二个说话人是谁")没有系统评估。 -
SER benchmark 略输 v1 ------ Meld ACC 0.553 vs Qwen-Audio v1 的 0.557 · 差异不大但违背"v2 各方面都优于 v1"的直觉 · 可能与小样本细分类任务的多任务训练权衡有关 · 论文未做消融、不能定因。
架构意义(论文发表后的生态观察 · 非 Chu et al. 实验结论):
Qwen2-Audio 给出了一种清晰的 LALM 组装范式:现成 audio encoder + 现成 LLM + 自然语言 prompt + 多阶段对齐 (Pre-training → SFT → DPO)------ 不必自训 SSL encoder 也能做通用音频模型 · 训练成本门槛显著低于 Seed-ASR 那种从头训 LUISE 的方案。同期后续多个 speech-LLM(GLM-4-Voice / Kimi-Audio / Ming-Audio / MinMo)也沿类似路径演进 · 但各家 recipe / 数据规模 / encoder 选型和对齐方式各不相同。核心洞察 :LLM 已经是很强的推理器 · 只需要教它"听懂"音频这一模态 · 不必为音频造新架构。