在初学提示词的时候,很容易对"工程"这个词感到困惑,会觉得我和AI对话不就是输入一堆自然语言么,怎么能和工程扯上关系。
工程是什么意思?
工程讲究的是有明确目标、可重复验证、可量化比较、能沉淀为文档和规范。
提示词恰好符合了这些特性,下文就展开提示词工程的具体讲解。
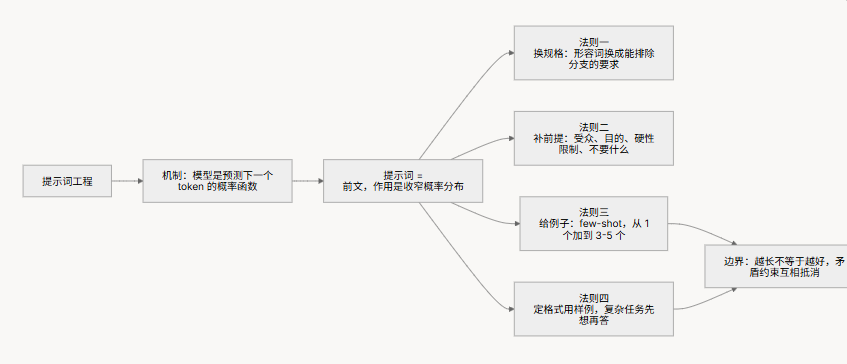
在学习提示词工程之前,必须先掌握几个概念。
|-----------------------|----------------------------------------------------|
| 术语 | 解释 |
| token | 模型处理文本的最小单位,可以粗略理解成词或词的一部分;模型是逐个token生成输出的。 |
| 概率分布 | 模型每一步对"下一个token是什么"给出的各种可能性及其大小;提示词的作用就是把这片可能性收窄。 |
| few-shot(少样本提示) | 在提示词里放几个"输入→输出"的示范,让模型从中归纳规律,适合格式或风格难以用文字描述的任务。 |
| 思维链(chain of thought) | 要求模型先写出推理过程、再给结论,让推理变成参与后续生成的文字,避免一上来写下的结论绑住后面的推导。 |
AI四大关键技术里提示词工程排第一,不是因为最简单。
它是唯一在不训练模型、不接数据、不加工具的前提下,就能改变模型输出的手段------改一次提示词,几分钟就能看到结果。
另外三项技术,Agent、RAG、微调最后也都要靠提示词把要求表达出来。
**大模型本质是一个预测下一个token的函数。**token是它处理文本的最小单位,可以粗略地理解为词或词的一部分。
它的工作方式是:给定前面已有的文字,算一遍下一个位置出现各种词的概率,挑一个拼上去,再算下一个。
它默认带有概率性,所以同一句话跑两次,结果可能不同。
提示词的各种技巧,做的都是同一件事:把这片概率分布收窄到你想要的地方。
下面四种法则是常见的一套归纳,不同文章的分法略有不同,抓住上述的机制比记条数更重要。
法则一:把形容词换成规格
"写一篇好的产品介绍"------"好"几乎不提供信息。
模型估的是P(输出|提示词),提示词里的信息越少,这片分布越平,他就越是在随便挑。
改成"写一段150字的产品介绍,面向30岁上下的上班族,重点讲不能注册就能用",每多一条约束,符合条件的分支就少一批。
一个自检方法:你写下的每个词,模型能不能据此排除掉一部分输出?
不能排出的就是废话。
这也是为什么清晰的提示词不一定短------长但每句都在收窄范围,有用;长但全是"请认真思考、务必专业",没用。
法则二:把你脑子里的默认前提写出来
模型不知道你的用户是谁、数据长什么样、这次交付给谁看。
你那些"这还用说吗"的前提,对它完全不可见。
要补的通常有四样:受众是谁、目的是什么、有什么硬性限制(字数、格式、禁忌)、不要什么。
但约束不是越多越好。互相打架的要求会让模型自行牺牲一条。同时要求"极其详细"和"控制在100字以内",它只能猜你更在乎哪个,结果往往两个都不满意。
法则三:说不清楚的,直接给例子
有些要求你描述半天也说不准,给两个例子对方立刻就懂。
这就是few-shot:在提示词里放几个"输入→输出"的示范,让模型自己归纳规律。
比如把客服对话整理成固定格式的工单,用文字描述格式很费劲还容易漏项,给两三个例子,模型马上就抓住了。
给例子要遵循三个要点:
**例子要贴近真实场景、覆盖不同情况。**别三个都长一个样,否则模型会以为只有这一种情况。
**例子的格式必须完全一致,**包括标点、空格、换行、字段顺序。模型会把你例子里的一切都当规律来学,包括你不小心打错的地方。
不要一上来给一堆。 先从1个试,不够再加,Anthropic的建议是3到5个效果最好。例子过多的代价是双重的:模型可能过度套用例子里的具体说法,显得生硬;提示词也变长,每次都多花钱、多花时间**。**
法则四:规定输出格式,复杂任务先想再答。
模型的默认习惯是"说一段话"。如果下游要用程序接着处理,这种输出就没法用。
指定格式最可靠的办法是给一个真实样例,而不是描述格式:
只输出 JSON,不要任何解释文字。格式如下:
{"name": "...", "category": "...", "priority": "high|medium|low"}
如果只写"请按JSON格式输出",模型知道你要JSON,但字段叫什么、能不能有多余文字,全靠猜。
另一件事跟格式无关,但同样重要:**需要多步推理的人,让它先想再答。**这个做法叫思维链。
原因是模型逐个token线性生成,先写出来的字会成为后面生成的前提。
它一上来就写结论,这个结论就会绑住后面的推理,容易一路为这个结论找理由。
让它先写分析、再写结论,等于把"思考"变成参与后续生成的文字。
做法很简单:明确要求"先分析,再给结论",或者把推理步骤一条条写清楚。
不过现在不少模型自带"思考"功能,对这类模型写死每一步反而可能限制它------自带思考的就用自带的,没有的再手动要求分步。
一个对照:
模糊版:帮我看看这段代码有没有问题。
明确版:
下面这段 Node.js 代码要处理用户上传的 CSV。请按严重程度从高到低列出问题,每条包含:问题描述、可能触发的场景、修改建议。重点关注错误处理、大文件的内存占用、并发情况下的竞态。如果某类问题不存在,直接说没有,不要为了凑数硬找。
第二版每句话都在做同一件事:把输出压在"一份结构化的代码审查清单"这个区域里。
三个必须知道的边界
**提示词不是越长越好。**核心没写清楚时,堆再多高级技巧都没用。先保证清晰具体,再谈技巧。
**提示词补不了知识缺口。**你公司的内部规定、产品的接口文档,模型就是不知道,换种问法也问不出来。这类知识要么检索出来喂给它,这就是RAG;要么训进模型里,这就是微调。这也是四大技术按提示词→Agent→RAG→微调排序的原因:能力不够时,按代价从小到大往上加。
**老技巧的收益在下降:**早期流行堆夸张的角色扮演("你是世界顶尖专家")和大量XML标签,对现在的模型来说额外收益已经明显变小。角色仍然有用,但重点应该放在约束它的知识范围和输出风格上,而不是堆头衔。
最后补一句:第一版提示词几乎不可能一次到位,改一版、再跑一遍、比较哪次更好,这是常态。