(一)图
1.图的存储方式
1)邻接表
邻接表存储无向无权图如图所示:
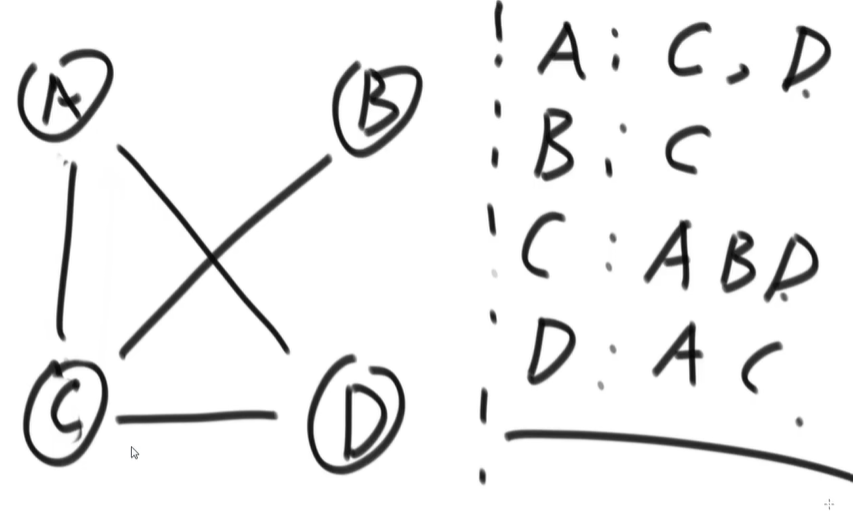
邻接表存储无向带权图如图所示:
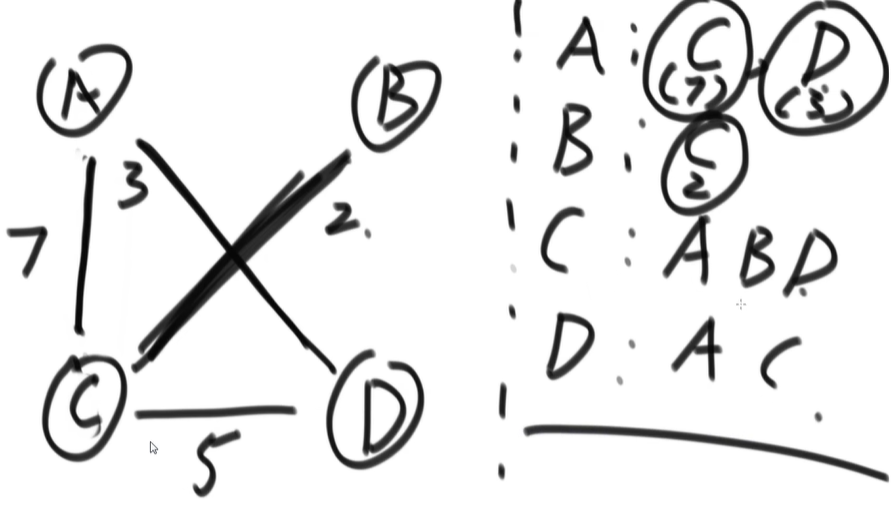
2)邻接矩阵
邻接矩阵表示无向带权图。
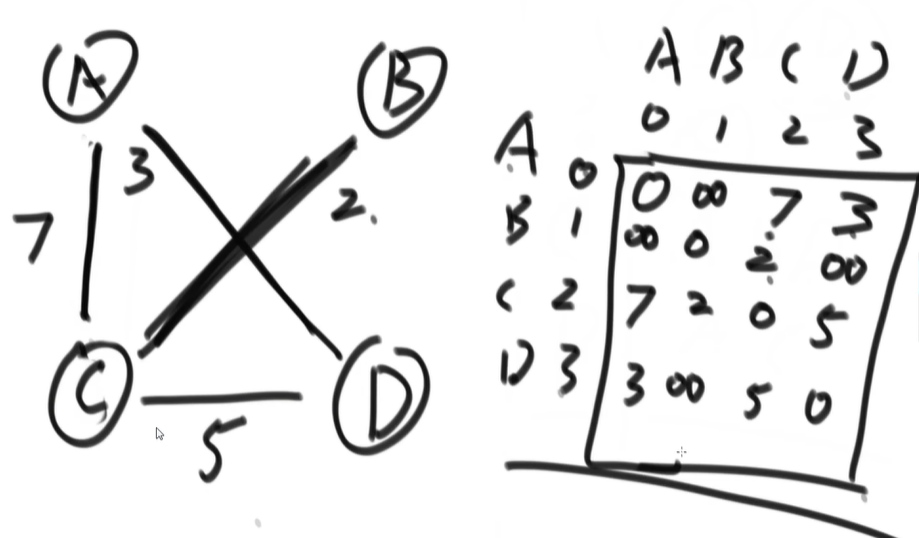
如何表达图?生成图?
另,数组也可以表示图,如定义以下的序列关系,对于数组arr5,2,2,4,2,1,对应序列{0,1,2,3,4,5},我们规定,序列号指向数组的值,比如0-\>5,1-\>2,2-\>2,也可以组成图。这种方式是面试中喜欢考的题目,超出日常使用的邻接矩阵和邻接表法。应对策略:将日常能够用到的图的表示方法将图实现一遍,形成一个模板,在面对其它格式构造的图的题目时,写一个接口将这两种结构进行转化,就不用再实现一遍图是算法。
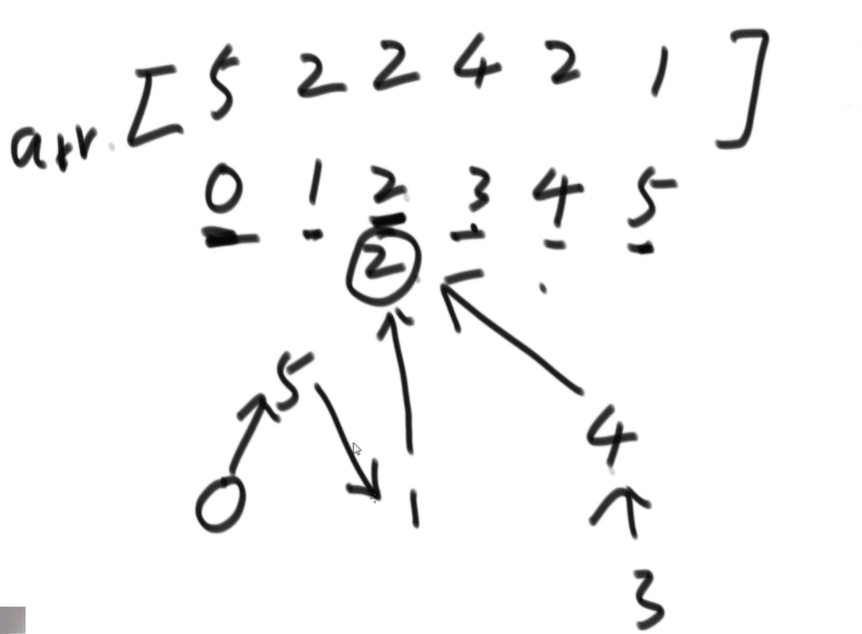
举例:python图像处理里面经常出现的三元组\[3,0,2,7,1,2,2,1,0]也可以表示<0->2,权3><2->1,权7><1->0,权2>的图。
具体细节见王道的数据结构课程以及离散数学课程。
2.图的结构与接口
(1)图。图包括点集合和边集合两个部分组成。代码实现如下:
java
package class006;

import java.util.HashMap;
import java.util.HashSet;

public class Graph {
    //点集
    public HashMap<Integer,Node>nodes;
    //边集
    public HashSet<Edge>edges;
    public Graph(){
        nodes=new HashMap<>();
        edges=new HashSet<>();
    }
}
(2)边。边包括权值,起始点和终点三个部分组成。代码实现如下:
java
package class006;

public class Edge {
    //权值
    public int weight;
    //起始点
    public Node from;
    //终点
    public Node to;
    public Edge(int weight,Node from,Node to){
        this.weight=weight;
        this.from=from;
        this.to=to;
    }
}
(3)点。点包括值,入度,出度,从当前节点发散出去的能够直接相连的点,从当前节点发散出去的能够直接相连的边。代码实现如下:
java
package class006;

import java.util.ArrayList;

public class Node {
    //值
    public int value;
    //入度
    public int in;
    //出度
    public int out;
    //从当前节点发散出去的能够直接相连的点
    public ArrayList<Node>nexts;
    //从当前节点发散出去的能够直接相连的边
    public ArrayList<Edge>edges;

    public Node(int value){
        this.value=value;
        in=0;
        out=0;
        nexts=new ArrayList<>();
        edges=new ArrayList<>();
    }
}
(4)图的接口。为了将《图论》中的正常图转接到企业测试的千奇百怪的图,我们需要写一个转化的接口。代码和测试结果如下:
java
package class006;
public class GraphGenerator {
    //matrix 所有的边
    //N*3的矩阵
    //[weight,from节点上的值,to节点上面的值]
    public static Graph createGraph(Integer[][] matrix){
        //matrix[0][0],matrix[0][1],martrix[0][2],一起被抓取到函数中作为参数
        Graph graph=new Graph();
        for (int i=0;i<matrix.length;i++){
            Integer weight=matrix[i][0];
            Integer from=matrix[i][1];
            Integer to=matrix[i][2];
            //如果from没有在点集中出现过
            if (!graph.nodes.containsKey(from)){
                //把这个点新建造出来,将编号及其记录加入图里面去
                graph.nodes.put(from,new Node(from));
            }
            //如果to没有在点集中出现过
            if (!graph.nodes.containsKey(to)){
                //把这个点新建造出来,将编号及其记录加入图里面去
                graph.nodes.put(to,new Node(to));
            }
            //把已经创建的from这个点拿出来
            Node fromNode=graph.nodes.get(from);
            //把已经创建的to这个点拿出来
            Node toNode=graph.nodes.get(to);
            //用from和to,把新的边建造出来
            Edge newEdge=new Edge(weight,fromNode,toNode);
            //在from的邻居里把to加上
            fromNode.nexts.add(toNode);
            fromNode.out++;
            toNode.in++;
            fromNode.edges.add(newEdge);
            graph.edges.add(newEdge);
        }
        return graph;
    }

    public static void main(String[] args) {
        /*
         * 矩阵:
         *
         * [ weight, from, to ]
         *
         *      5  0  1
         *      3  1  2
         *      7  0  2
         *
         * 表示:
         *
         * 0 --5--> 1
         * 1 --3--> 2
         * 0 --7--> 2
         */
        Integer[][] matrix = {
                {5, 0, 1},
                {3, 1, 2},
                {7, 0, 2}
        };
        // 根据矩阵生成图
        Graph graph = GraphGenerator.createGraph(matrix);
        // =========================
        // 打印所有节点的信息
        // =========================
        System.out.println("====== 节点信息 ======");
        for (Node node : graph.nodes.values()) {
            System.out.println(
                    "节点:" + node.value
                            + ",入度:" + node.in
                            + ",出度:" + node.out
            );
        }
        // =========================
        // 打印所有边
        // =========================
        System.out.println();
        System.out.println("====== 边信息 ======");
        for (Edge edge : graph.edges) {
            System.out.println(
                    edge.from.value
                            + " --"
                            + edge.weight
                            + "--> "
                            + edge.to.value
            );
        }
        // =========================
        // 单独查看节点0
        // =========================
        System.out.println();
        System.out.println("====== 节点0的邻接点 ======");
        Node node0 = graph.nodes.get(0);
        for (Node next : node0.nexts) {
            System.out.println("0 -> " + next.value);
        }
    }
}
运行结果:
java
====== 节点信息 ======
节点:0,入度:0,出度:2
节点:1,入度:1,出度:1
节点:2,入度:2,出度:0

====== 边信息 ======
1 --3--> 2
0 --7--> 2
0 --5--> 1

====== 节点0的邻接点 ======
0 -> 1
0 -> 2
例如:
可以转为图:
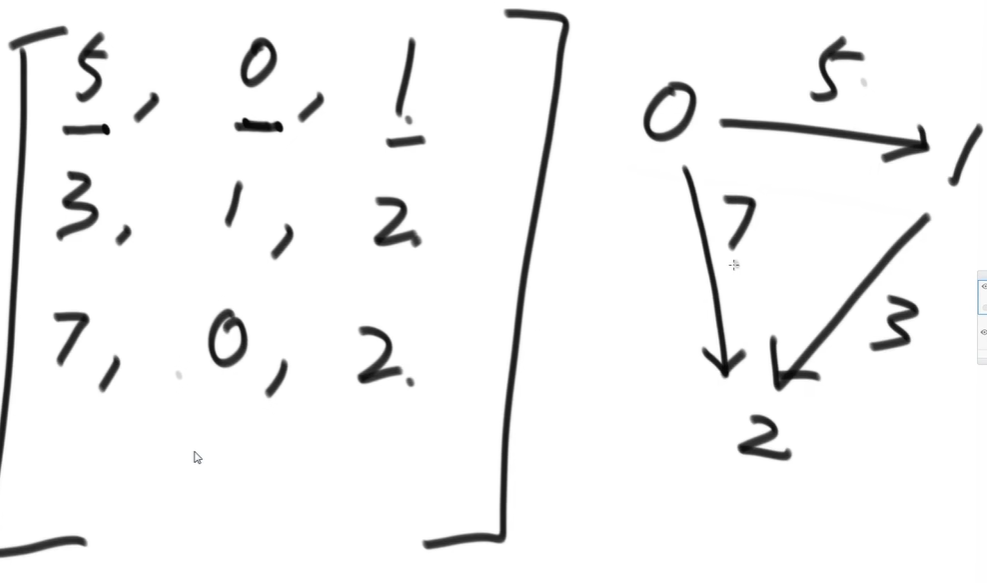
3.图的宽度优先遍历
注意:二叉树的宽度优先遍历和图的宽度优先遍历区别在于二叉树无环,图有环。
1,利用队列实现
2,从源节点开始依次按照宽度进队列,然后弹出
3,每弹出一个点,把该节点所有没有进过队列的邻接点放入队列
4,直到队列变空
宽度优先遍历举例说明:
对于图:
java
    A    B    C    D    E
A   0    1    1    0    1

B   1    0    1    1    1

C   1    1    0    1    0

D   0    1    1    0    1

E   1    1    0    1    0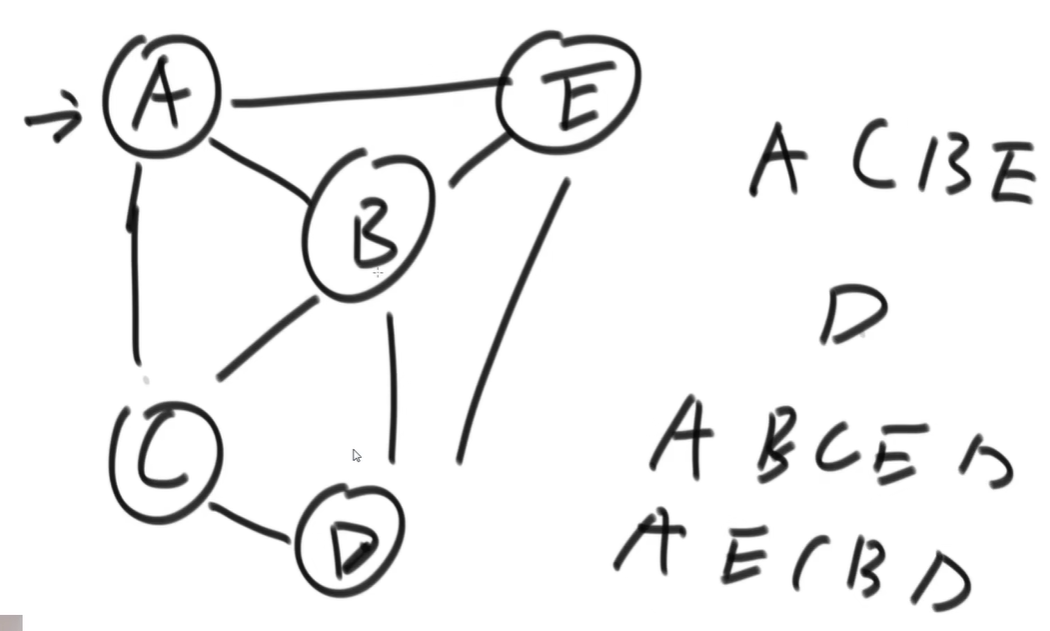
从节点A出发,宽度优先遍历结果有3个ACBED,ABCED,AECBD。我们先创建一个队列以及一个set。其中,set用于检查是否重复。
|----|--------------|---------|-------------|--------|------------|-----------|
| 轮次 | queue!=null? | queue | set | 队列弹出节点 | 弹出节点的新next | 宽度优先遍历打印 |
| 0 | | {} | {} | | | |
| 1 | | {A} | {A} | | | |
| 2 | yes | {} | {A} | A | C,B,E | A |
| 3 | | {C,B,E} | {A,C,B,E} | | | |
| 4 | yes | {B,E} | {A,C,B,E} | C | D | A,C |
| 5 | | {B,E,D} | {A,C,B,E,D} | | | |
| 6 | yes | {E,D} | {A,C,B,E,D} | B | | A,C,B |
| 7 | | {E,D} | {A,C,B,E,D} | | | |
| 8 | yes | {D} | {A,C,B,E,D} | E | | A,C,B,E |
| 9 | | {E,D} | {A,C,B,E,D} | | | |
| 10 | no | {} | {A,C,B,E,D} | D | | A,C,B,E,D |
代码:
java
package class006;

import java.util.HashSet;
import java.util.LinkedList;
import java.util.Queue;

public class Code_BFS {
    //从node出发,进行宽度优先遍历
    public static void bfs(Node node){
        if(node==null){
            return;
        }
        Queue<Node>queue=new LinkedList<>();
        //保证一个点不重复进队列
        HashSet<Node>set=new HashSet<>();
        //把出发点放到set里去
        queue.add(node);
        set.add(node);
        while (!queue.isEmpty()){
            //Q弹出一个
            Node cur=queue.poll();
            System.out.println(cur.value);
            //判断当前节点的next值
            for (Node next:cur.nexts){
                //没有进入过队列
                if (!set.contains(next)){
                    //先登记
                    set.add(next);
                    //再入队
                    queue.add(next);
                }
            }
        }
    }
    public static void main(String[] args) {

        /*
         * 节点对应:
         *
         * 1 = A
         * 2 = B
         * 3 = C
         * 4 = D
         * 5 = E
         *
         *
         * 邻接矩阵:
         *
         *      A B C D E
         *
         * A    0 1 1 0 1
         * B    1 0 1 1 1
         * C    1 1 0 1 0
         * D    0 1 1 0 1
         * E    1 1 0 1 0
         *
         *
         * 图:
         *
         * A连接:B、C、E
         * B连接:A、C、D、E
         * C连接:A、B、D
         * D连接:B、C、E
         * E连接:A、B、D
         */

        Node A = new Node(1);
        Node B = new Node(2);
        Node C = new Node(3);
        Node D = new Node(4);
        Node E = new Node(5);


        // =====================================
        // A的邻接点
        //
        // 特意按照:
        // C -> B -> E
        //
        // 的顺序加入
        // 这样BFS结果就是:
        // A C B E D
        // =====================================

        A.nexts.add(C);
        A.nexts.add(B);
        A.nexts.add(E);


        // B的邻接点
        B.nexts.add(A);
        B.nexts.add(C);
        B.nexts.add(D);
        B.nexts.add(E);


        // C的邻接点
        C.nexts.add(A);
        C.nexts.add(B);
        C.nexts.add(D);


        // D的邻接点
        D.nexts.add(B);
        D.nexts.add(C);
        D.nexts.add(E);


        // E的邻接点
        E.nexts.add(A);
        E.nexts.add(B);
        E.nexts.add(D);


        // =====================================
        // 从A开始宽度优先遍历
        // =====================================

        System.out.println("从A开始BFS:");

        bfs(A);

        System.out.println("期望:1 3 2 5 4");
        System.out.println("对应:A C B E D");
    }
}
运行结果:
java
从A开始BFS:
1
3
2
5
4
期望:1 3 2 5 4
对应:A C B E D
4.图的广度优先遍历
图的广度优先遍历即深度优先遍历
1,利用栈实现
2,从源节点开始把节点按照深度放入栈,然后弹出
3,每弹出一个点,把该节点下一个没有进过栈的邻接点放入栈
4,直到栈变空
深度优先遍历举例说明:
对于图:
java
    A    B    C    D    E
A   0    1    1    0    1

B   1    0    1    0    0

C   1    1    0    1    0

D   0    0    1    0    1

E 1 0 0 1 0宽度优先遍历的结果一般是{A,BCE,D},深度优先遍历的结果一般是{A->B->C->D->E}
|----|------------------------|-------------|-------------|-------|---------|----------------------|----------|
| 轮次 | stack!=null?(一轮循环判断一次) | stack | set | 栈弹出节点 | 重新压入的节点 | 弹出节点的新next | 深度优先遍历打印 |
| 0 | | {} | {} | | | | |
| 1 | | {A} | {A} | | | | |
| 2 | yes | {} | {A} | A | | B(new),C(new),E(new) | A |
| 3 | | {} | {A} | | A | | A |
| 4 | | {A,B} | {A,B} | | | | A |
| 5 | yes | {A} | {A,B} | B | | A,C(new) | A,B |
| 6 | | {A} | {A,B| | | B | | A,B |
| 7 | | {A,B,C} | {A,B,C} | | | | A,B |
| 8 | yes | {A,B} | {A,B,C} | C | | A,B,D(new),E(new) | A,B,C |
| 9 | | {A,B,C} | {A,B,C} | | C | | A,B,C |
| 10 | | {A,B,C,D} | {A,B,C,D} | | | | A,B,C |
| 11 | yes | {A,B,C} | {A,B,C,D} | D | | C,E(new) | A,B,C,D |
| 12 | | {A,B,C} | {A,B,C,D} | | D | | A,B,C,D |
| 13 | | {A,B,C,D,E} | {A,B,C,D,E} | | | | A,B,C,D |
| 14 | | | | | | | |
| 15 | E进入循环的时候,发现没有新的next节点了,没有路了,于是循环结束,接着继续弹出节点E,得到{A,B,C,D,E}这个结果 |||||||
代码:
java
package class006;

import java.util.HashSet;
import java.util.Stack;

public class Code_DFS {
    public static void dfs(Node node){
        if(node==null){
            return;
        }
        Stack<Node>stack=new Stack<>();
        HashSet<Node>set=new HashSet<>();
        //把出发点加到栈中
        stack.add(node);
        //把出发点加到set中
        set.add(node);
        System.out.println(node.value);
        while (!stack.isEmpty()){
            Node cur=stack.pop();
            for(Node next:cur.nexts){
                //set中不含有当前节点的下一个节点
                if(!set.contains(next)){
                    //重新把当前节点压入栈中
                    stack.push(cur);
                    //再压入当前节点的下一个节点
                    stack.push(next);
                    //在set中把邻居节点注册上
                    set.add(next);
                    System.out.println(next.value);
                    break;
                }
            }
        }
    }
    public static void main(String[] args) {
        /*
         * 节点:
         *
         * A = 1
         * B = 2
         * C = 3
         * D = 4
         * E = 5
         *
         *
         * 图:
         *
         *        B
         *       / \
         *      A---C
         *      |   |
         *      E---D
         *
         *
         * 邻接关系:
         *
         * A:B、C、E
         * B:A、C
         * C:A、B、D
         * D:C、E
         * E:A、D
         */
        Node A = new Node(1);
        Node B = new Node(2);
        Node C = new Node(3);
        Node D = new Node(4);
        Node E = new Node(5);
        // =====================================
        // A的邻接点
        //
        // 顺序很重要:
        // B -> C -> E
        // =====================================
        A.nexts.add(B);
        A.nexts.add(C);
        A.nexts.add(E);

        // B的邻接点
        B.nexts.add(A);
        B.nexts.add(C);

        // C的邻接点
        C.nexts.add(A);
        C.nexts.add(B);
        C.nexts.add(D);

        // D的邻接点
        D.nexts.add(C);
        D.nexts.add(E);

        // E的邻接点
        E.nexts.add(A);
        E.nexts.add(D);

        // =====================================
        // DFS测试
        // =====================================
        System.out.println("从A开始深度优先遍历:");
        dfs(A);
        System.out.println("期望:1 2 3 4 5");
        System.out.println("对应:A B C D E");
    }
}
运行结果:
java
从A开始深度优先遍历:
1
2
3
4
5
期望:1 2 3 4 5
对应:A B C D E
5.拓扑排序算法
适用范围:要求有向图,且有入度为0的节点,且没有环。如图所示的编译依赖过程,不能出现循环依赖过程。
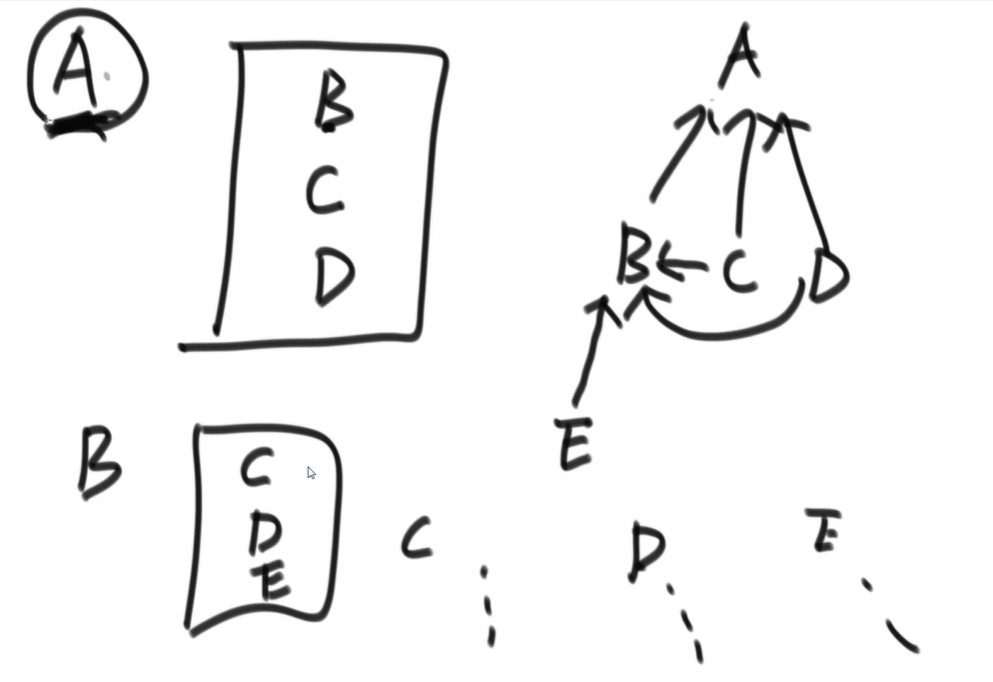
举例:
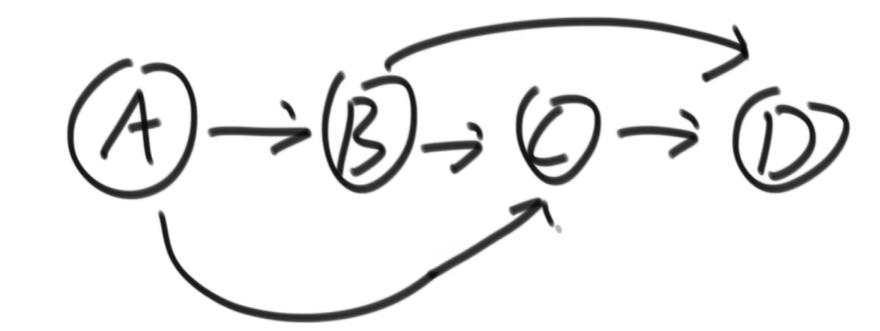
A->B->C->D,且A->C,B->D。先找入度为0的节点,然后把这个节点和它的出边擦掉。对于这个拓扑排序,A的入度为0,把这个节点和它的出边擦掉;B节点如此,C节点如此,D节点如此。最后得到拓扑排序{A,B,C,D}。
代码:
java
package class006;
import java.util.*;

public class Code_TopologySort {
    //directed graph and no loop
    public static List<Node> sortedTopology(Graph graph){
        //key:某一个node
        //value:剩余的入度
        HashMap<Node,Integer> inMap=new HashMap<>();
        Queue<Node> zeroInQueue=new LinkedList<>();
        //整张图的每个点
        for (Node node:graph.nodes.values()){
            //每张图剩余的点的入度记录到inMap里去
            inMap.put(node,node.in);
            //发现入度为0的点
            if(node.in==0) {
                //放入入度为0的点的队列里去
                zeroInQueue.add(node);
            }
        }
        //拓扑排序的结果,依次加入result
        List<Node> result=new ArrayList<>();
        while (!zeroInQueue.isEmpty()){
            //已经入度为0的点
            Node cur=zeroInQueue.poll();
            //加入到拓扑排序的结果里去
            result.add(cur);
            //擦除去掉入度为0的点造成的影响
            for (Node next:cur.nexts){
                //下一个入度为0的点的后续节点的入度减一
                inMap.put(next,inMap.get(next)-1);
                //如果发现减为零
                if (inMap.get(next)==0){
                    //将这个点加入到入度为0的点的队列里去
                    zeroInQueue.add(next);
                }
            }
        }
        return result;
    }


    public static void main(String[] args) {
        /*
         * 图:
         *
         * A -> B -> C -> D
         * |    |         ^
         * |    └-------->|
         * └-------> C
         *
         * 实际边:
         *
         * A -> B
         * A -> C
         * B -> C
         * B -> D
         * C -> D
         *
         *
         * A = 1
         * B = 2
         * C = 3
         * D = 4
         */
        Graph graph = new Graph();
        Node A = new Node(1);
        Node B = new Node(2);
        Node C = new Node(3);
        Node D = new Node(4);
        // =========================
        // 把节点加入Graph
        // =========================
        graph.nodes.put(1, A);
        graph.nodes.put(2, B);
        graph.nodes.put(3, C);
        graph.nodes.put(4, D);
        // =========================
        // A -> B
        // =========================
        A.nexts.add(B);
        A.out++;
        B.in++;
        // =========================
        // A -> C
        // =========================
        A.nexts.add(C);
        A.out++;
        C.in++;
        // =========================
        // B -> C
        // =========================
        B.nexts.add(C);
        B.out++;
        C.in++;
        // =========================
        // B -> D
        // =========================
        B.nexts.add(D);
        B.out++;
        D.in++;
        // =========================
        // C -> D
        // =========================
        C.nexts.add(D);
        C.out++;
        D.in++;
        // =========================
        // 查看每个节点的入度
        // =========================
        System.out.println("各节点入度:");
        System.out.println("A:" + A.in);
        System.out.println("B:" + B.in);
        System.out.println("C:" + C.in);
        System.out.println("D:" + D.in);
        // =========================
        // 拓扑排序
        // =========================
        List<Node> result = sortedTopology(graph);
        System.out.println();
        System.out.println("拓扑排序结果:");
        for (Node node : result) {
            if (node.value == 1) {
                System.out.print("A ");
            } else if (node.value == 2) {
                System.out.print("B ");
            } else if (node.value == 3) {
                System.out.print("C ");
            } else if (node.value == 4) {
                System.out.print("D ");
            }
        }
        System.out.println();
    }
}
运行结果:
java
各节点入度:
A:0
B:1
C:2
D:2

拓扑排序结果:
A B C D
6.kruskal算法(最小生成树)
主要用于最小生成树的实现(边最少,且权值累加和最小),从边的角度考虑。
适用范围:要求无向图
示例:
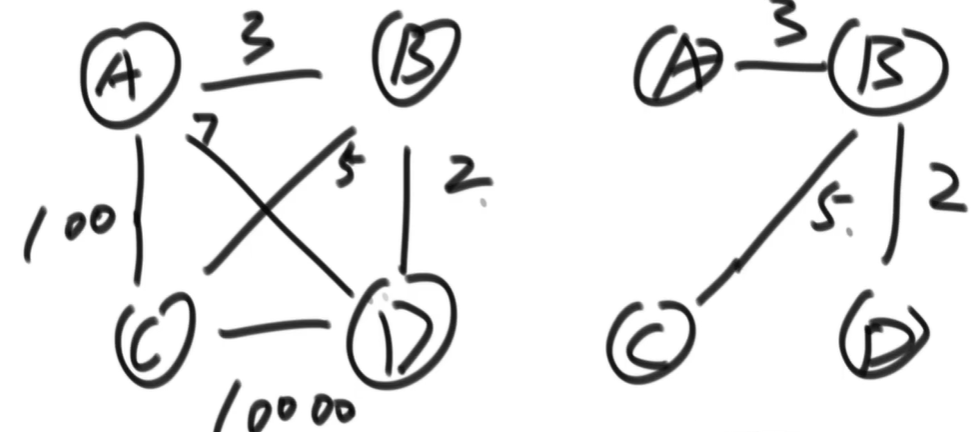
算法:按权值升序加边,看看会不会形成环,形成则不加。最关键的是在代码中判断加边的时候会不会形成环,复现在手写推导中集合查询和集合合并的方法。
总体流程:
java
所有边按权值从小到大
        ↓
取最小边
        ↓
两端点是否同集合?
     /           \
   是             否
   ↓              ↓
 跳过           加入结果
                  ↓
               union
                  ↓
             继续下一条
(1)常规思路实现
java
package class006;
import java.util.*;
public class Code_Kruskal01 {
    public static class MySets {
        public HashMap<Node, List<Node>> setMap;

        public MySets(List<Node> nodes) {
            //初始化
            setMap = new HashMap<>();
            for (Node cur : nodes) {
                List<Node> set = new ArrayList<Node>();
                set.add(cur);
                setMap.put(cur, set);
            }
        }

        //判断两个节点是否属于同一个集合
        public boolean isSameSet(Node from, Node to) {
            List<Node> fromSet = setMap.get(from);
            List<Node> toSet = setMap.get(to);
            return fromSet == toSet;
        }

        //将From和to的内存地址放到一起
        public void union(Node from, Node to) {
            List<Node> fromSet = setMap.get(from);
            List<Node> toSet = setMap.get(to);
            // 已经属于同一个集合
            if (fromSet == toSet) {
                return;
            }
            //把toSet中的所有节点 加入fromSet
            for (Node toNode : toSet) {
                fromSet.add(toNode);
                //让toSet中的所有节点 都重新指向fromSet
                setMap.put(toNode, fromSet);
            }
        }

        //边值比较器,按照权值从小到大排序
        public static class EdgeComparator implements Comparator<Edge> {
            @Override
            public int compare(Edge o1, Edge o2) {

                return Integer.compare(
                        o1.weight,
                        o2.weight
                );
            }
        }

        public  static Set<Edge>kruskalMST(Graph graph){
            //获取所有节点
            List<Node>nodes=new ArrayList<>(graph.nodes.values());
            //初始化集合
            MySets mySets=new MySets(nodes);
            //小根堆,按照权值从小到大弹出
            PriorityQueue<Edge>priorityQueue=new PriorityQueue<>(new EdgeComparator());
            //所有边进入小根堆
            priorityQueue.addAll(graph.edges);
            //保存最小生成树
            Set<Edge>result=new HashSet<>();
            //kruskal
            while (!priorityQueue.isEmpty()){
                //当前权值最小的边
                Edge edge=priorityQueue.poll();
                //如果from和to不属于同一个集合,说明加入这条边不会形成环
                if(!mySets.isSameSet(edge.from,edge.to)){
                    //加入最小生成树
                    result.add(edge);
                    //合并两个集合
                    mySets.union(edge.from,edge.to);
                }
            }
            return result;
        }

        //测试时把1,2,3,4转换成A,B,C,D
        public static String getName(Node node){
            if(node.value==1){return "A";}
            if(node.value==2){return "B";}
            if(node.value==3){return "C";}
            if(node.value==4){return "D";}
            return String.valueOf(node.value);
        }
        public static void main(String[] args) {
            /*
             * 测试图:
             *
             *          1
             *      A ------- B
             *      |      /  |
             *     4|    2/   |5
             *      |    /    |
             *      C ------- D
             *          3
             *
             *
             * 无向边:
             *
             * A --1-- B
             * A --4-- C
             * B --2-- C
             * B --5-- D
             * C --3-- D
             *
             * 规定:
             *
             * A = 1
             * B = 2
             * C = 3
             * D = 4
             */
            // =========================
            // 1. 创建图
            // =========================
            Graph graph = new Graph();
            // =========================
            // 2. 创建节点
            // =========================
            Node A = new Node(1);
            Node B = new Node(2);
            Node C = new Node(3);
            Node D = new Node(4);
            // =========================
            // 3. 节点加入图
            // =========================
            graph.nodes.put(1, A);
            graph.nodes.put(2, B);
            graph.nodes.put(3, C);
            graph.nodes.put(4, D);
            // =========================
            // 4. 创建无向边
            //
            // Kruskal只关心:
            //
            // edge.from
            // edge.to
            // edge.weight
            //
            // 所以每条无向边记录一次即可
            // =========================
            Edge edgeAB = new Edge(1, A, B);
            Edge edgeAC = new Edge(4, A, C);
            Edge edgeBC = new Edge(2, B, C);
            Edge edgeBD = new Edge(5, B, D);
            Edge edgeCD = new Edge(3, C, D);
            // =========================
            // 5. 边加入图
            // =========================
            graph.edges.add(edgeAB);
            graph.edges.add(edgeAC);
            graph.edges.add(edgeBC);
            graph.edges.add(edgeBD);
            graph.edges.add(edgeCD);
            // =========================
            // 6. 执行Kruskal
            // =========================
            Set<Edge> result = kruskalMST(graph);
            // =========================
            // 7. 为了方便观察结果
            // 按权值重新排序
            // =========================
            List<Edge> edges = new ArrayList<>(result);
            edges.sort(new Code_Kruskal.EdgeComparator());
            // =========================
            // 8. 打印最小生成树
            // =========================
            System.out.println("====== Kruskal最小生成树 ======");
            int totalWeight = 0;
            for (Edge edge : edges) {
                System.out.println(getName(edge.from) + " --" + edge.weight + "-- " + getName(edge.to));
                totalWeight += edge.weight;
            }
            // =========================
            // 9. 打印总权值
            // =========================
            System.out.println();
            System.out.println("最小生成树总权值:" + totalWeight);
        }

    }

}
运行结果:
java
====== Kruskal最小生成树 ======
A --1-- B
B --2-- C
C --3-- D

最小生成树总权值:6
(2)并查集实现
java
package class006;

import java.util.*;

//undirected graph only
public class Code_Kruskal {
    //Union-Find Set
    public static class UnionFind{
        //key 某一个节点,value key节点往上的节点
        private HashMap<Node,Node>fatherMap;
        //key 某一个集合的代表节点,value key所在集合的节点个数
        private HashMap<Node,Integer>sizeMap;
        public UnionFind(){
            fatherMap=new HashMap<Node,Node>();
            sizeMap=new HashMap<Node,Integer>();
        }
        /**
         * 初始化并查集:
         * 每个节点单独组成一个集合,
         * 自己作为自己的父节点。
         */
        public void makeSets(Collection<Node>nodes){
            fatherMap.clear();
            sizeMap.clear();
            for (Node node:nodes){
                fatherMap.put(node,node);
                sizeMap.put(node,1);
            }
        }
        /**
         * 查找节点所在集合的代表节点。
         * 查找过程中使用路径压缩,
         * 使经过的节点直接指向代表节点。
         */
        private Node findFather(Node n) {
            Stack<Node> path = new Stack<>();
            // 一直向上查找,直到找到代表节点
            while (n != fatherMap.get(n)) {
                path.add(n);
                n = fatherMap.get(n);
            }
            // 路径压缩
            while (!path.isEmpty()) {
                fatherMap.put(path.pop(), n);
            }
            return n;
        }
        /**
         * 判断两个节点是否属于同一个集合。
         */
        public boolean isSameSet(Node a,Node b){
            return findFather(a)==findFather(b);
        }
        /**
         * 合并两个节点所在的集合。
         * 小集合挂到大集合上,降低并查集的树高。
         */
        public void union(Node a,Node b){
            if(a==null||b==null){
                return;
            }
            // 找到两个集合的代表节点
            Node aDai=findFather(a);
            Node bDai=findFather(b);
            // 已经属于同一个集合,无需合并
            if(aDai!=bDai){
                // 获取两个集合的大小
                int aSetSize=sizeMap.get(aDai);
                int bSetSize=sizeMap.get(bDai);
                // 小集合挂到大集合
                if(aSetSize<=bSetSize){
                    fatherMap.put(aDai,bDai);
                    sizeMap.put(bDai,aSetSize+bSetSize);
                    // aFather不再是代表节点
                    sizeMap.remove(aDai);
                }else {
                    fatherMap.put(bDai,aDai);
                    sizeMap.put(aDai,aSetSize+bSetSize);
                    // bFather不再是代表节点
                    sizeMap.remove(bDai);
                }
            }
        }
    }

    public static class EdgeComparator implements Comparator<Edge>{
        @Override
        public int compare(Edge o1,Edge o2){
            return o1.weight-o2.weight;
        }
    }
    public static Set<Edge> kruskalMST(Graph graph){
        //生成一个并查集结构
        UnionFind unionFind=new UnionFind();
        unionFind.makeSets(graph.nodes.values());
        //设置一个堆,使得边能够按照权值从小到大弹出
        PriorityQueue<Edge>priorityQueue=new PriorityQueue<>(new EdgeComparator());
        for (Edge edge: graph.edges){//M条边
            priorityQueue.add(edge);//O(logM)
        }
        Set<Edge>result=new HashSet<>();
        while (!priorityQueue.isEmpty()){//M条边
            //当边弹出的时候
            Edge edge=priorityQueue.poll();//O(logM)
            //判断这条边是不是这个集合里的,不是就加入,是就不加入
            if(!unionFind.isSameSet(edge.from,edge.to)){//O(1)
                result.add(edge);
                //加入后,将集合合并在一起
                unionFind.union(edge.from,edge.to);
            }
            }
        return result;
    }

    // 将节点值转换成A、B、C、D
    public static String getName(Node node) {
        if (node.value == 1) {
            return "A";
        }

        if (node.value == 2) {
            return "B";
        }

        if (node.value == 3) {
            return "C";
        }

        if (node.value == 4) {
            return "D";
        }

        return String.valueOf(node.value);
    }
    public static void main(String[] args) {
        /*
         * 测试图:
         *
         *          1
         *      A ------- B
         *      |      /  |
         *     4|    2/   |5
         *      |    /    |
         *      C ------- D
         *          3
         *
         *
         * 无向边:
         *
         * A --1-- B
         * A --4-- C
         * B --2-- C
         * B --5-- D
         * C --3-- D
         *
         * 规定:
         *
         * A = 1
         * B = 2
         * C = 3
         * D = 4
         */
        // =========================
        // 1. 创建图
        // =========================
        Graph graph = new Graph();
        // =========================
        // 2. 创建节点
        // =========================
        Node A = new Node(1);
        Node B = new Node(2);
        Node C = new Node(3);
        Node D = new Node(4);
        // =========================
        // 3. 节点加入图
        // =========================
        graph.nodes.put(1, A);
        graph.nodes.put(2, B);
        graph.nodes.put(3, C);
        graph.nodes.put(4, D);
        // =========================
        // 4. 创建无向边
        //
        // Kruskal只关心:
        //
        // edge.from
        // edge.to
        // edge.weight
        //
        // 所以每条无向边记录一次即可
        // =========================
        Edge edgeAB = new Edge(1, A, B);
        Edge edgeAC = new Edge(4, A, C);
        Edge edgeBC = new Edge(2, B, C);
        Edge edgeBD = new Edge(5, B, D);
        Edge edgeCD = new Edge(3, C, D);
        // =========================
        // 5. 边加入图
        // =========================
        graph.edges.add(edgeAB);
        graph.edges.add(edgeAC);
        graph.edges.add(edgeBC);
        graph.edges.add(edgeBD);
        graph.edges.add(edgeCD);
        // =========================
        // 6. 执行Kruskal
        // =========================
        Set<Edge> result = kruskalMST(graph);
        // =========================
        // 7. 为了方便观察结果
        // 按权值重新排序
        // =========================
        List<Edge> edges = new ArrayList<>(result);
        edges.sort(new EdgeComparator());
        // =========================
        // 8. 打印最小生成树
        // =========================
        System.out.println("====== Kruskal最小生成树 ======");
        int totalWeight = 0;
        for (Edge edge : edges) {
            System.out.println(getName(edge.from) + " --" + edge.weight + "-- " + getName(edge.to));
            totalWeight += edge.weight;
        }
        // =========================
        // 9. 打印总权值
        // =========================
        System.out.println();
        System.out.println("最小生成树总权值:" + totalWeight);
    }
}
运行结果:
java
====== Kruskal最小生成树 ======
A --1-- B
B --2-- C
C --3-- D

最小生成树总权值:6
流程图:
java
开始
  │
  ▼
传入 Graph
  │
  ▼
创建并查集 UnionFind
  │
  ▼
makeSets(graph.nodes.values())
  │
  ├── 每个节点单独成集合
  │
  └── fatherMap[node] = node
      sizeMap[node]   = 1
  │
  ▼
创建小根堆 PriorityQueue<Edge>
  │
  ▼
把 graph.edges 中所有边加入小根堆
  │
  ▼
按照权值从小到大弹出边
  │
  ▼
┌──────────────────────────────┐
│ priorityQueue 是否为空?      │
└──────────────────────────────┘
          │
     ┌────┴────┐
     │         │
    是         否
     │         │
     ▼         ▼
   返回       poll()
   result      取出当前最小边 edge
     │         │
     │         ▼
     │   edge.from 和 edge.to
     │   是否属于同一个集合?
     │
     │      isSameSet(from,to)
     │         │
     │    ┌────┴────┐
     │    │         │
     │   是         否
     │    │         │
     │    ▼         ▼
     │  跳过该边   result.add(edge)
     │              │
     │              ▼
     │        union(from,to)
     │              │
     │              ▼
     │        合并两个集合
     │
     └──────────────┐
                    │
                    ▼
             继续取下一条边
                    │
                    └───────────────┐
                                    │
                                    ▼
                      priorityQueue 是否为空?
7.prim算法(最小生成树)
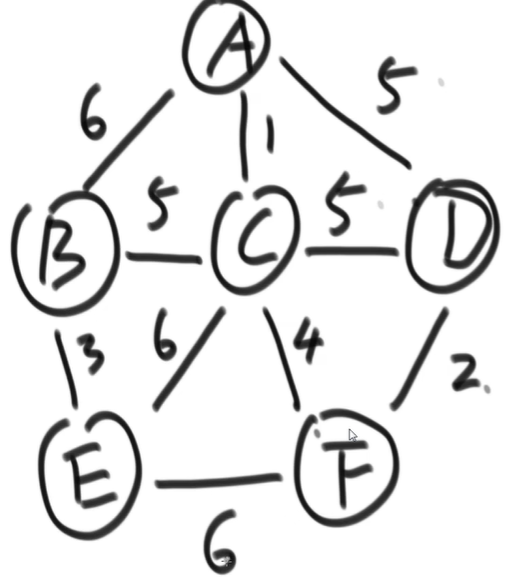
主要用于实现最小生成树,从点的角度出发。参考王道的图相关的视频。
适用范围:要求无向图。
例子:
代码:
java
package class006;

import java.util.*;

//undirected graph only
public class Code_Prim {
    public static class EdgeComparator implements Comparator<Edge>{
        @Override
        public int compare(Edge o1,Edge o2){
            return o1.weight-o2.weight;
        }
    }
    public static Set<Edge>primMST(Graph graph){
        //解锁的边进入小根堆(优先级队列)
        PriorityQueue<Edge>priorityQueue=new PriorityQueue<>(new EdgeComparator());
        //考察过的点放入set里
        HashSet<Node>set=new HashSet<>();
        Set<Edge>result=new HashSet<>();//依次挑选的边在result里
        //for循环主要用于处理森林的问题,将各自的最小生成树合并起来
        for(Node node:graph.nodes.values()){//随便挑了一个点
            //if是最小生成树的主要代码
            //node 是开始点
            if(!set.contains(node)){
                //将起始点加入node中去
                set.add(node);
                for (Edge edge:node.edges){//由一个点,解锁所有相连的边
                    //放入优先级队列中
                    priorityQueue.add(edge);
                }
                while (!priorityQueue.isEmpty()){
                    Edge edge=priorityQueue.poll();//弹出解锁的边中,最小的边
                    Node toNode=edge.to;//可能的新的一个点
                    if(!set.contains(toNode)){//不含有的时候,就是新的点
                        set.add(toNode);
                        result.add(edge);
                        //将to点发散出来的所有边,放到优先级队列里去
                        for(Edge nextEdge:toNode.edges){
                            priorityQueue.add(nextEdge);
                        }
                    }
                }
            }
            //break
        }
        return result;
    }
    //请保证graph是连通图
    //graph[i][j]表示点i到点j的距离,如果是系统最大值代表无路
    public static int prim(int[][] graph){
        int size=graph.length;
        if (size==0){
            return 0;
        }
        //当前已经进入最小生成树的节点集合到节点i的最短边权
        int[]distances=new int[size];
        //判断节点i是否进入最小生成树
        boolean[]visit=new boolean[size];
        //从0号节点开始
        visit[0]=true;
        //0号节点到其它节点的距离
        for (int i=0;i<size;i++){
            distances[i]=graph[0][i];
        }
        //最小生成树总权值
        int sum=0;
        for(int i=1;i<size;i++){
            int minPath= Integer.MAX_VALUE;
            int minIndex=-1;
            //找到距离集合最近的新节点
            for(int j=0;j<size;j++){
                if(!visit[j]&&distances[j]<minPath){
                    minPath=distances[j];
                    minIndex=j;
                }
            }
            //没有找到新的节点,说明图不连通
            if(minIndex==-1){
                return -1;
            }
            //新节点加入最小生成树
            visit[minIndex]=true;
            sum+=minPath;
            //用新节点更新distances
            for (int j=0;j<size;j++){
                if(!visit[j]&&graph[minIndex][j]<distances[j]){
                    distances[j]=graph[minIndex][j];
                }
            }
        }
        return sum;
    }
    //我们创建两条Edge:表示无向边
    public static void addUndirectedEdge(Graph graph,Node from,Node to,int weight){
        //from to
        Edge edge1=new Edge(weight,from,to);
        //to from
        Edge edge2=new Edge(weight,to,from);
        //两个节点分别记录自己的出边
        from.edges.add(edge1);
        to.edges.add(edge2);
        //邻接点
        from.nexts.add(to);
        to.nexts.add(from);
        //整张图记录边
        graph.edges.add(edge1);
        graph.edges.add(edge2);
    }
    //测试时把1,2,3,4转换成A,B,C,D
    public static String getName(Node node){
        if(node.value==1){return "A";}
        if(node.value==2){return "B";}
        if(node.value==3){return "C";}
        if(node.value==4){return "D";}
        return String.valueOf(node.value);
    }
    public static void main(String[] args) {
        /*
         * 测试图:
         *
         *          1
         *      A ------- B
         *      |       / |
         *     4|     2/  |5
         *      |     /   |
         *      C ------- D
         *          3
         *
         *
         * 无向边:
         *
         * A --1-- B
         * B --2-- C
         * C --3-- D
         * A --4-- C
         * B --5-- D
         *
         *
         * 最小生成树:
         *
         * A --1-- B --2-- C --3-- D
         *
         * 总权值:
         *
         * 1 + 2 + 3 = 6
         */
        // ==================================================
        // 测试一:Graph版本Prim
        // ==================================================
        Graph graph = new Graph();
        Node A = new Node(1);
        Node B = new Node(2);
        Node C = new Node(3);
        Node D = new Node(4);
        graph.nodes.put(1, A);
        graph.nodes.put(2, B);
        graph.nodes.put(3, C);
        graph.nodes.put(4, D);
        // 添加无向边
        addUndirectedEdge(graph, A, B, 1);
        addUndirectedEdge(graph, B, C, 2);
        addUndirectedEdge(graph, C, D, 3);
        addUndirectedEdge(graph, A, C, 4);
        addUndirectedEdge(graph, B, D, 5);
        // 执行Prim
        Set<Edge> result = primMST(graph);
        // HashSet无序,转换成List按权值排序
        List<Edge> resultEdges = new ArrayList<>(result);
        resultEdges.sort(new EdgeComparator());
        System.out.println("====== Prim最小生成树 ======");
        int totalWeight = 0;
        for (Edge edge : resultEdges) {
            System.out.println(
                    getName(edge.from)
                            + " --"
                            + edge.weight
                            + "-- "
                            + getName(edge.to)
            );
            totalWeight += edge.weight;
        }
        System.out.println("总权值:" + totalWeight);
        // ==================================================
        // 测试二:邻接矩阵版本Prim
        // ==================================================
        System.out.println();
        System.out.println("====== 邻接矩阵Prim ======");
        int MAX = Integer.MAX_VALUE;
        /*
         *       A  B  C  D
         *
         * A     0  1  4  ∞
         * B     1  0  2  5
         * C     4  2  0  3
         * D     ∞  5  3  0
         */
        int[][] matrix = {
                {0,   1,   4, MAX},
                {1,   0,   2,   5},
                {4,   2,   0,   3},
                {MAX, 5,   3,   0}
        };
        int minWeight = prim(matrix);
        System.out.println("最小生成树总权值:" + minWeight);
    }
}
运行结果:
java
====== Prim最小生成树 ======
A --1-- B
B --2-- C
C --3-- D
总权值:6

====== 邻接矩阵Prim ======
最小生成树总权值:6
kruskal算法和prim算法的代码区别在于,kruskal算法需要集合查询和集合合并的过程,因为存在局部连通之后整个整体的连通问题;而prim算法不需要集合查询和集合合并的过程,因为每次选的边会把新的点加入集合中,只需要检查这个点左右两侧的边是否在这个集合中,只需要一个hashmap就行了。
另,对于无向图来说,第一次放入队列里的边,接下来的循环中某一条边可能会被两次放到队列里去,但是prim算法的核心是是判断新的点才能被集合接受,只是增加了处理时间,这些边会被跳过,并不会影响最终的结论。
kruskal算法和prim算法区别:
| 区别 | Kruskal | Prim |
|---|---|---|
| 出发角度 | 从边出发 | 从点出发 |
| 核心思想 | 边按权值从小到大选,成环就跳过 | 从起点不断选能连接到新点的最小边 |
| 主要结构 | 小根堆 + 并查集 | 小根堆 + HashSet |
| 防止成环 | 判断两端点是否同集合 | 判断新节点是否已访问 |
| 关键操作 | isSameSet()、union() |
set.contains() |
| 是否需要起点 | 不需要 | 需要 |
| 适用范围 | 带权无向图 | 带权无向图 |
| 记忆口诀 | 边小就试,成环不要 | 从点扩散,最小边带新点 |
8.Dijkstra算法(单源点最短路径)
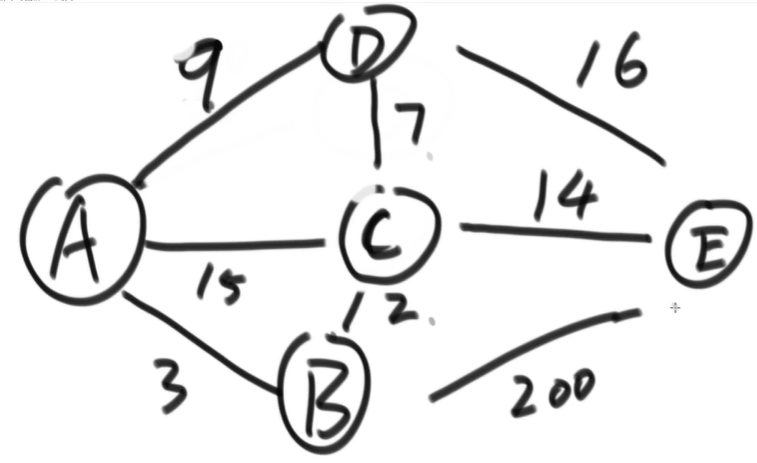
适用范围:没有权值为负数的边(不能有累加和为负数的环)。
主要思想是"广度优先遍历",细节见王道的数据结构的图的部分。见leetcode743
如图:
代码:
package class006;

import java.util.*;

/**
 * Dijkstra算法
 *
 * 从head出发,
 * 求head到所有能够到达节点的最短距离。
 *
 * 要求:
 * 图中不能存在负权边。
 */
public class Code_Dijkstra {
    public static HashMap<Node,Integer>dijkstral(Node head){
        //从head出发到所有点的最小距离
        //key:从head出发到达key
        //value:从head出发到达key的最小距离
        //如果在表中,没有T的记录,含义是从head出发到T这个点的距离为正无穷
        HashMap<Node,Integer>distanceMap=new HashMap<>();
        distanceMap.put(head,0);
        //已经求过距离的节点,存在selectedNodes中,以后再也不碰
        HashSet<Node>selectedNodes=new HashSet<>();
        //在distanceMap中找一个最小距离的记录,但这个记录不是被选过的
        Node minNode=getMinDistanceAndUnselectedNode(distanceMap,selectedNodes);
        while (minNode!=null){
            //获取源节点到这个节点的最小距离
            int distance=distanceMap.get(minNode);
            //考察这个节点的所有边
            for (Edge edge:minNode.edges){
                Node toNode=edge.to;
                //如果这个点distance是正无穷(原先没有记录)
                if(!distanceMap.containsKey(toNode)){
                    //更新距离为边的权值
                    distanceMap.put(toNode,distance+edge.weight);
                }
                //tonode的点之前的距离,和现在的+distance的距离,哪个小,就选谁
                distanceMap.put(edge.to,Math.min(distanceMap.get(toNode),
                        distance+edge.weight));
            }
            //将节点锁住
            selectedNodes.add(minNode);
            //选一个没选过的最小距离
            minNode=getMinDistanceAndUnselectedNode(distanceMap,selectedNodes);
        }
        return distanceMap;
    }

   public static Node getMinDistanceAndUnselectedNode(
           HashMap<Node,Integer>distanceMap,
           HashSet<Node>touchedNodes){
        Node minNode=null;
        //最小的距离初始化为最大值
        int minDistance=Integer.MAX_VALUE;
        for (Map.Entry<Node,Integer> entry:distanceMap.entrySet()){
            //拿出记录中的距离
            Node node=entry.getKey();
            int distance=entry.getValue();
            //如果这个距离最小,那么就把最小的距离变成它,但要保证这个点是没被锁的
            if(!touchedNodes.contains(node)&&distance<minDistance){
                minNode=node;
                minDistance=distance;
            }
        }
        return minNode;
   }
   //添加一条有向边
   public static void addDirectedEdge(Graph graph,Node from,Node to,int weight){
        Edge edge=new Edge(weight,from,to);
        //from可以直接到达to
       from.nexts.add(to);
       //from记录这条出边
       from.edges.add(edge);
       //更新入度和出度
       from.out++;
       to.in++;
       //整张图记录这条边
       graph.edges.add(edge);
   }
    public static String getName(Node node) {
        if (node.value == 1) {return "A";}
        if (node.value == 2) {return "B";}
        if (node.value == 3) {return "C";}
        if (node.value == 4) {return "D";}
        if (node.value == 5) {return "E";}
        return String.valueOf(node.value);
    }

    public static void main(String[] args) {
        /*
         * 测试图:
         *
         *             5
         *        A --------> C
         *        |           |↑
         *       2|          1| \
         *        |           |  \3
         *        ↓           ↓   \
         *        B --------> C    D
         *        |     1      ↑   |
         *       2|            1\  |2
         *        ↓              \ ↓
         *        D ------------> E
         *
         *
         * 实际边:
         *
         * A -> B   2
         * A -> C   5
         *
         * B -> C   1
         * B -> D   2
         *
         * C -> D   3
         * C -> E   1
         *
         * D -> E   2
         *
         *
         * 从A出发:
         *
         * A = 0
         *
         * B = 2
         *
         * C = A->B->C
         *   = 2 + 1
         *   = 3
         *
         * D = A->B->D
         *   = 2 + 2
         *   = 4
         *
         * E = A->B->C->E
         *   = 2 + 1 + 1
         *   = 4
         */
        // =========================
        // 1. 创建图
        // =========================
        Graph graph = new Graph();
        // =========================
        // 2. 创建节点
        // =========================
        Node A = new Node(1);
        Node B = new Node(2);
        Node C = new Node(3);
        Node D = new Node(4);
        Node E = new Node(5);
        // =========================
        // 3. 节点加入Graph
        // =========================
        graph.nodes.put(1, A);
        graph.nodes.put(2, B);
        graph.nodes.put(3, C);
        graph.nodes.put(4, D);
        graph.nodes.put(5, E);
        // =========================
        // 4. 添加有向边
        // =========================
        addDirectedEdge(graph, A, B, 2);
        addDirectedEdge(graph, A, C, 5);
        addDirectedEdge(graph, B, C, 1);
        addDirectedEdge(graph, B, D, 2);
        addDirectedEdge(graph, C, D, 3);
        addDirectedEdge(graph, C, E, 1);
        addDirectedEdge(graph, D, E, 2);
        // =========================
        // 5. 从A开始执行Dijkstra
        // =========================
        HashMap<Node, Integer> distanceMap = dijkstral(A);
        // =========================
        // 6. 为方便观察,
        // 按节点value排序
        // =========================
        List<Node> nodes = new ArrayList<>(distanceMap.keySet());
        nodes.sort(Comparator.comparingInt(node -> node.value));
        // =========================
        // 7. 打印结果
        // =========================
        System.out.println("====== 从A出发的最短距离 ======");
        for (Node node : nodes) {
            System.out.println("A -> " + getName(node) + " = " + distanceMap.get(node));
        }
    }
}
运行结果:
java
====== 从A出发的最短距离 ======
A -> A = 0
A -> B = 2
A -> C = 3
A -> D = 4
A -> E = 4
执行过程:
java
初始:
A = 0
B = ∞
C = ∞
D = ∞
E = ∞
        ↓
选A(0),锁定A
通过A更新:
B = 2
C = 5
        ↓
选B(2),锁定B
通过B更新:
C = min(5, 2+1) = 3
D = 2+2 = 4
        ↓
选C(3),锁定C
通过C更新:
D = min(4, 3+3) = 4
E = 3+1 = 4
        ↓
选D(4),锁定D
通过D更新:
E = min(4, 4+2) = 4
        ↓
选E(4),锁定E
        ↓
结束
另:dijkstra可用堆实现。
java
package class006;

import java.util.HashMap;

public class Code_DijkstralHeap {
    //堆中弹出的记录:
    //node:节点
    //distance:源点到该节点的最短距离
    public static class NodeRecord{
        public Node node;
        public int distance;
        public NodeRecord(Node node,int distance){
            this.node=node;
            this.distance=distance;
        }
    }
    //Dijkstral的小根堆
    public static class NodeHeap{
        //堆结构
        private Node[]nodes;
        private HashMap<Node,Integer>heapIndexMap;
        private HashMap<Node,Integer>distanceMap;
        //当前堆大小
        private int size;
        public NodeHeap(int size){
            nodes=new Node[size];
            heapIndexMap=new HashMap<>();
            distanceMap=new HashMap<>();
            this.size=0;
        }
        //判断堆是否为空
        public boolean isEmpty(){
            return size==0;
        }
        //节点是否已经进过堆
        private boolean isEntered(Node node){
            return heapIndexMap.containsKey(node);
        }
        //节点当前是否还在堆中
        private boolean inHeap(Node node){
            return isEntered(node)&&heapIndexMap.get(node)!=-1;
        }

        /**
         * 添加、更新或者忽略
         *
         * 1. 节点还在堆中:
         *    更新更小距离
         *
         * 2. 节点从来没有进入过堆:
         *    新加入
         *
         * 3. 节点已经弹出过:
         *    忽略
         */
        public void addOrUpdateOrIgnore(Node node,int distance){
            //情况1,节点还在堆中
            if(inHeap(node)){
                distanceMap.put(node,Math.min(distanceMap.get(node),distance));
                //距离可能变小,需要向上调整
                insertHeapify(heapIndexMap.get(node));
            }
            //情况2:节点从来没有进过堆
            if(!isEntered(node)){
                nodes[size]=node;
                heapIndexMap.put(node,size);
                distanceMap.put(node,distance);
                insertHeapify(size);
                size++;
            }
            //情况3:node进过堆,但heapIndexMap.get(node)==-1
            //说明已经被弹出并锁定
            //什么都不做
        }
        //弹出当前距离最小的节点
        public NodeRecord pop(){
            //堆顶一定是最小距离节点
            NodeRecord nodeRecord=new NodeRecord(nodes[0],distanceMap.get(nodes[0]));
            //堆顶和最后一个节点交换
            swap(0,size-1);
            //原堆顶节点已经弹出:下标设为-1,表示以后不在进入节点
            heapIndexMap.put(nodes[size-1],-1);
            //从distanceMap删除
            distanceMap.remove(nodes[size-1]);
            //删除数组中的节点
            nodes[size-1]=null;
            //堆大小减一
            size--;
            //新堆顶向下调整
            heapify(0,size);
            return nodeRecord;
        }
        //向上调整,用于:新节点进入堆,节点距离变小
        private void insertHeapify(int index){
            while (index>0&&distanceMap.get(nodes[index])<distanceMap.get(nodes[(index-1)/2])){
                swap(index,(index-1)/2);
                index=(index-1)/2;
            }
        }
        //向下调整,用于弹出堆顶以后重新整理小根堆
        private void heapify(int index,int size){
            int left=index*2+1;
            while (left<size){
                //找左右孩子中距离更小的那个
                int smallest=left+1<size&&distanceMap.get(nodes[left+1])<distanceMap.get(nodes[left])?left+1:left;
            //和当前节点比较
                smallest= distanceMap.get(nodes[smallest])<distanceMap.get(nodes[index])?smallest:index;
            //当前节点已经最小
                if(smallest==index){
                    break;
                }
                swap(smallest,index);
                index=smallest;
                left=index*2+1;
            }
        }
        //交换堆中的两个节点,同时更新heapIndexMap
        private void swap(int index1,int index2){
            heapIndexMap.put(nodes[index1],index2);
            heapIndexMap.put(nodes[index2],index1);
            Node temp=nodes[index1];
            nodes[index1]=nodes[index2];
            nodes[index2]=temp;
        }

        //堆优化版Dijkstra
        public static HashMap<Node,Integer>dijkstra(
                Node head,int size
        ){
            //创建小根堆
            NodeHeap nodeHeap=new NodeHeap(size);
            //源点入堆,head->head=0
            nodeHeap.addOrUpdateOrIgnore(head,0);
            //最终最短距离
            HashMap<Node,Integer>result=new HashMap<>();
            while (!nodeHeap.isEmpty()){
                //弹出当前距离最小的节点
                //一旦弹出,它的最短距离即确定
                NodeRecord record=nodeHeap.pop();
                Node cur=record.node;
                int distance=record.distance;
                //遍历cur所有出边
                //尝试更新邻接节点距离
                for (Edge edge:cur.edges){
                    nodeHeap.addOrUpdateOrIgnore(edge.to,distance+edge.weight);
                };
                //cur最短距离已经确定
                result.put(cur,distance);
            }
            return result;
        }
        //添加有向边
        public static void addEdge(
                Graph graph,
                Node from,
                Node to,
                int weight
        ){
            Edge edge=new Edge(weight,from,to);
            from.edges.add(edge);
            from.nexts.add(to);
            from.out++;
            to.in++;
            graph.edges.add(edge);
        }
        public static String getName(Node node) {
            if (node.value == 1) {return "A";}
            if (node.value == 2) {return "B";}
            if (node.value == 3) {return "C";}
            if (node.value == 4) {return "D";}
            if (node.value == 5) {return "E";}
            return String.valueOf(node.value);
        }
        public static void main(String[] args) {
            /*
             * 有向图:
             *
             * A --2--> B
             * A --5--> C
             *
             * B --1--> C
             * B --2--> D
             *
             * C --3--> D
             * C --1--> E
             *
             * D --2--> E
             *
             *
             * 从A出发:
             *
             * A = 0
             * B = 2
             * C = 3
             * D = 4
             * E = 4
             */
            Graph graph = new Graph();
            Node A = new Node(1);
            Node B = new Node(2);
            Node C = new Node(3);
            Node D = new Node(4);
            Node E = new Node(5);

            graph.nodes.put(1, A);
            graph.nodes.put(2, B);
            graph.nodes.put(3, C);
            graph.nodes.put(4, D);
            graph.nodes.put(5, E);

            addEdge(graph, A, B, 2);
            addEdge(graph, A, C, 5);
            addEdge(graph, B, C, 1);
            addEdge(graph, B, D, 2);
            addEdge(graph, C, D, 3);
            addEdge(graph, C, E, 1);
            addEdge(graph, D, E, 2);
            // 从A开始执行Dijkstra
            HashMap<Node, Integer> result = dijkstra(A, graph.nodes.size());
            System.out.println("====== 堆实现Dijkstra ======");
            for (int i = 1; i <= 5; i++) {
                Node node = graph.nodes.get(i);
                System.out.println("A -> " + getName(node) + " = " + result.get(node));
            }
        }
    }

}
运行结果:
java
====== 堆实现Dijkstra ======
A -> A = 0
A -> B = 2
A -> C = 3
A -> D = 4
A -> E = 4
普通 Dijkstra和堆优化 Dijkstra的异同:
| 对比 | 普通 Dijkstra | 堆优化 Dijkstra |
|---|---|---|
| 核心思想 | 每次遍历未确定节点,找距离最小的点 | 用小根堆维护当前距离最小的点 |
| 找最小节点 | 线性扫描 distanceMap |
直接弹出堆顶 |
| 距离更新 | 更新 distanceMap |
更新堆中节点距离并调整堆 |
| 主要结构 | HashMap + HashSet |
自定义小根堆 + HashMap |
| 是否需要堆 | 不需要 | 需要 |
| 实现难度 | 简单 | 较复杂 |
| 时间复杂度 | O(V²) |
O((V+E)logV),常写 O(ElogV) |
| 适合场景 | 节点较少、教学理解 | 节点和边较多、实际高效实现 |
| 核心操作 | getMinDistanceAndUnselectedNode() |
addOrUpdateOrIgnore() + pop() |
| 记忆方式 | 自己找最小点 | 堆帮你找最小点 |