为什么 Agent 需要 Memory?Memory 和 RAG 到底有什么区别?
 作 者:吴佳浩(Alben)
系列专栏:《企业级 Agent Memory 实战指南》· 第 01 篇
导读
知识库保存的是"世界上有什么",Memory 保存的是"这个 Agent、这个用户和这个组织已经经历了什么,以及接下来应该如何行动"。
Knowledge 是公司的制度规范,Memory 是老员工的实战经验;MCP 负责连接外部世界,Memory Runtime 负责连接过去与未来。
模型决定 Agent 能思考什么,Memory 决定 Agent 会成为谁。没有 Memory,Agent 每一天都是入职第一天。
在企业落地 LLM Agent 的过程中,团队常遇到以下典型场景: 为一个客服 Agent、研发助理 Agent 或销售 Copilot 接入了长达 1M Token 的上下文窗口,同时挂载了包含数万份内部知识库文档的企业级 RAG(检索增强生成)系统。但在多轮交互后,用户只要说一句"按我昨天确认的技术栈重新生成配置",Agent 就会回复"对不起,我不记得昨天的约定",或者检索出几篇看似相关、实则完全不符合用户个性化约定的通用文档;当用户明确纠正"生产环境禁用 Docker,只用 Podman"之后,三轮对话过后,Agent 在生成部署脚本时依然自顾自地写出 docker-compose.yml。
很多人把这种现象简单归结为"模型注意力衰减"或"检索 Top-K 召回率低"。但从系统架构演进的角度来看,这暴露了一个基础性的认知缺失:把只读的知识检索(RAG)当成了认知的动态记忆(Memory),把瞬时的计算上下文(Context Window)当成了系统的状态机(State Persistence)。
要构建工业级、可演进的 Agent 系统,必须厘清: 为什么长上下文(Long-Context)和 RAG 无法解决 Agent 的"失忆"问题? 为什么业界正在从单纯的"数据存储"转向"Memory Runtime"这一核心概念? 六大核心机制(Knowledge、Memory、Context、Cache、Profile、Summary)的本质分水岭在哪里? 为什么在已有 MCP(Model Context Protocol)生态下,MCP 依然无法替代 Agent 自身的 Memory Runtime?
一、真实项目中的三个典型翻车现场(Anti-Patterns)
在深入架构之前,先看三个企业实际落地中最常踩的坑:
| 典型场景 | 翻车表现 | 架构根因 |
|---|---|---|
| 1. 偏好覆写失效 (Preference Drift) | 用户纠正"生产环境只用 Podman",3 轮后 Agent 依然生成 Dockerfile。 | 纯拼接历史导致新旧事实并存,缺乏状态覆写(State Overwrite)与冲突消解(Conflict Resolution)机制。 |
| 2. 跨 Session 失忆 (Cross-Session Loss) | 昨天调试完成的模块路径与设计决策,今天新开窗口后全部丢失。 | 状态生命周期绑定单个 Session,会话销毁即物理清空,缺乏跨会话状态持久化(Persistent Memory)。 |
| 3. 错误经验重复踩坑 (Repeated Mistakes) | 上周排查出的端口占用、依赖冲突,今天接管新任务时再次完整踩一遍。 | 缺乏事后因果反思(Reflection)与经验提炼(Learning),程序性记忆(Procedural Memory)无法沉淀。 |
一句话总结这一章的核心观点:
Memory 的判断标准不是"存储了文字",而是:如果删除它,Agent 在未来的行为决策上是否会发生可观察的改变?
二、大模型应用演进史:从无状态 ChatBot 到 Memory OS 的必然路径
很多人以为 ChatGPT 能连续聊天,所以模型本身具有记忆能力。实际上,真正"记住"历史的从来不是模型,而是 ChatGPT 产品在应用层做的会话管理。
纵观大模型落地架构的演进脉络,整个行业经历了一条清晰的收敛路径:
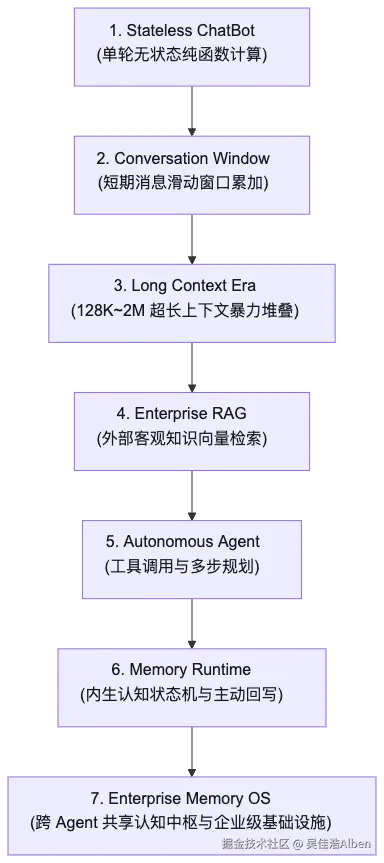
每个阶段解决的核心矛盾完全不同:
- 🔸 Stateless ChatBot:单轮 Prompt 输入输出,无内部持久化状态修改;
- 🔸 Conversation Window:内存累加消息历史,遇到长对话直接被滑动窗口截断;
- 🔸 Long Context Era:暴力扩大上下文窗口,但带来了注意力稀释与算力成本雪崩;
- 🔸 Enterprise RAG:解决了客观外部知识的检索,但数据外生且单向只读,无法维护用户主观状态;
- 🔸 Autonomous Agent:引入工具调用与多步规划,但缺乏因果反思,频繁在相同环境错误中反复踩坑;
- 🔸 Memory Runtime:确立了内生认知状态机,实现主动抽取、冲突消解与状态回写;
- 🔸 Enterprise Memory OS:跨 Agent 共享的企业级认知中枢,构筑多租户安全与协同基础设施。
一句话总结这一章的核心观点:
Memory 不是一个凭空出现的新技术,而是 Agent 演化到一定阶段的必然结果。未来企业真正管理的,不仅是 Agent,更是 Agent 共同依赖与演化的 Enterprise Memory。
三、为什么 Agent 会失忆?为什么 Context 不够?
LLM 本质上是一个无状态(Stateless)的纯函数计算引擎 :给定输入序列 X,通过 Transformer 前向传播计算条件概率分布 P(Y∣X) 并自回归生成输出序列 Y。模型内部的权重在推理阶段是完全冻结的,它本身不具备持久化修改内部状态的能力。
业界曾寄希望于不断延长的上下文窗口(Long-Context Window,从 32k、128k 到 1M、2M Token),试图把所有历史对话无脑塞入 Prompt。但在生产环境中,这种做法会迅速遭遇四个现实瓶颈:
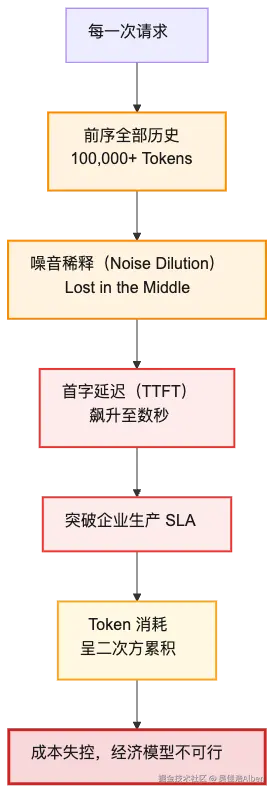
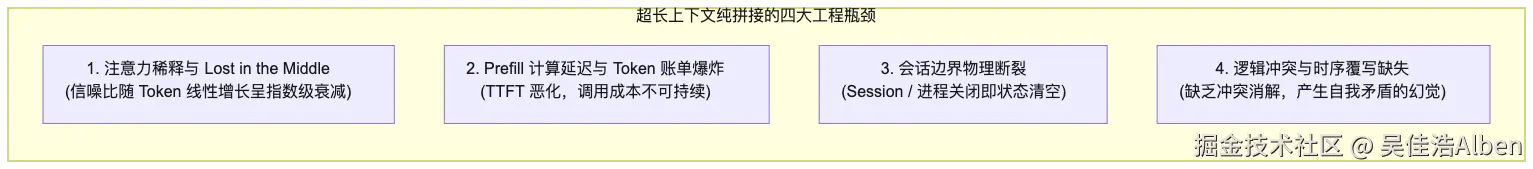
- 🔸 注意力稀释与 Lost in the Middle:Self-Attention 权重分布存在首尾偏置,海量历史工具 stdout 与废话会严重稀释模型注意力,中间的关键决策被彻底淹没;
- 🔸 Prefill 延迟与成本恶化:超长上下文导致首字生成时间(TTFT)从 200ms 恶化至 5s 以上,Token 账单二次方爆炸;
- 🔸 会话物理边界断裂:Context 生命周期绑定在单次 HTTP 请求或单个 Session,窗口关闭状态即物理销毁;
- 🔸 缺乏事实覆写机制:第 2 轮的旧假设与第 20 轮的新结论并存,模型缺乏显式寄存器进行冲突消解,极易引发幻觉。
一句话总结这一章的核心观点:
Context 是显存里的瞬时工作台面,不是持久化的状态存储器。把计算上下文当存储用,是典型的架构反模式。
四、为什么 RAG 不能替代 Memory?
在实际选型中,经常有人问:"为什么不把对话历史切片存进向量库做 RAG 检索?"
Knowledge 像图书馆,Memory 像工作笔记;Knowledge 是公司的制度规范,Memory 是老员工的实战经验。
Knowledge 可以共享给所有人,而 Memory 天生属于某个主体。
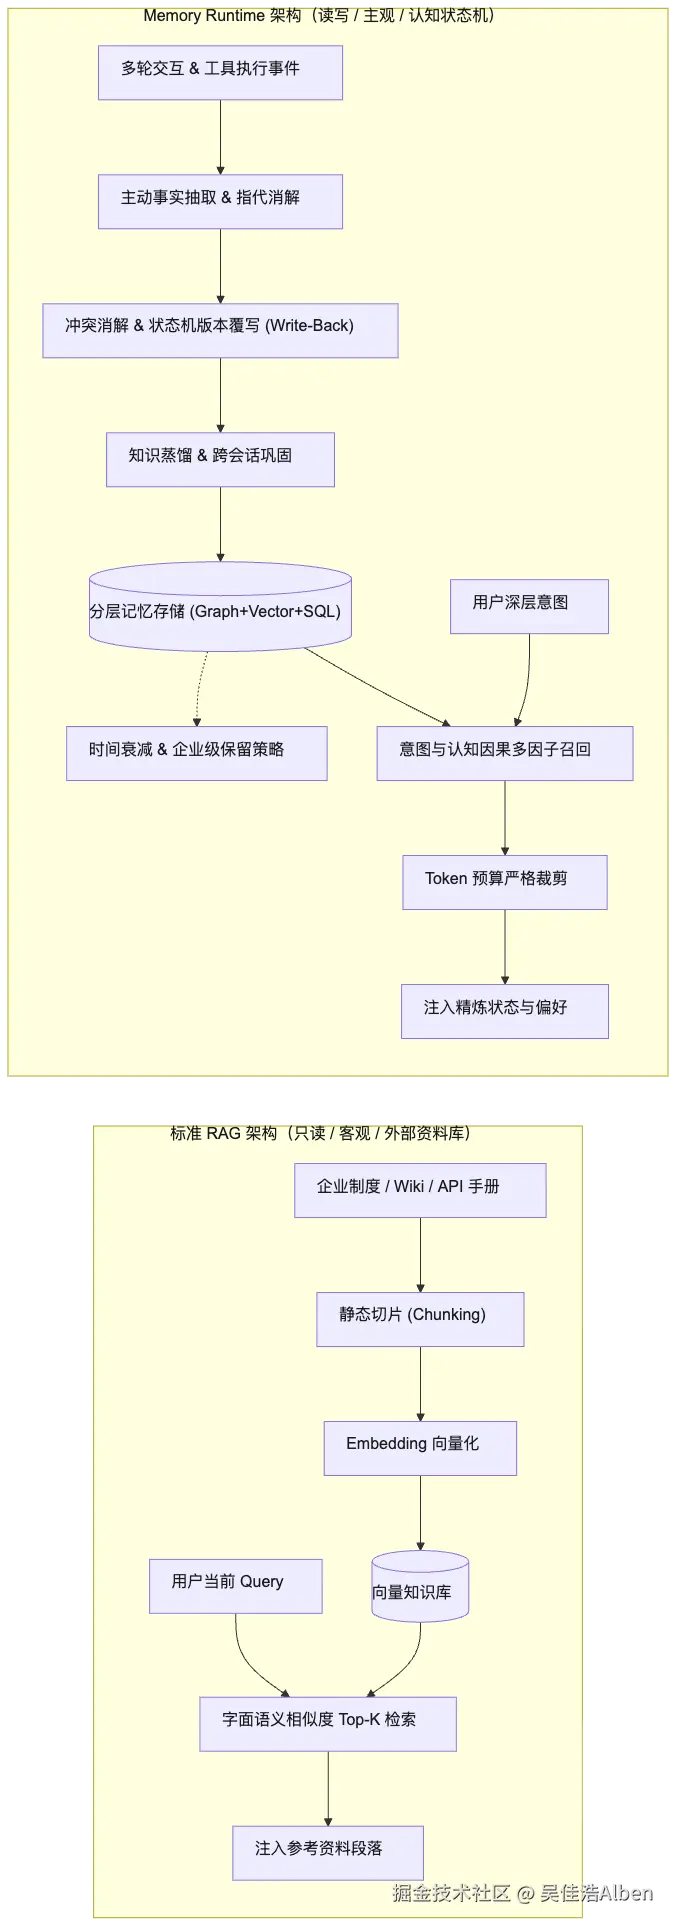
- 🔸 读写方向不同:RAG 单向只读、离线同步;Memory 必须具备动态状态回写(Write-Back)与实时 CRUD 能力;
- 🔸 检索空间不同:RAG 匹配字面语义贴近度;Memory 召回具有因果关联与环境约束的决策事实;
- 🔸 数据粒度不同:RAG 存储未加工的粗粒度 Raw Chunk;Memory 存储高度提炼的原子断言(Atomic Assertions)与实体关系网。
一句话总结这一章的核心观点:
RAG 解决的是"知识准不准",Memory 解决的是"状态对不对"。
五、为什么 MCP(Model Context Protocol)不负责 Memory?
随着 MCP 协议的普及,很多人产生疑问:既然 MCP 可以提供 Tools 和 Resources,为什么不能把 Memory 作为一个 MCP Tool?
MCP 连接外部世界,Memory 连接过去与未来。
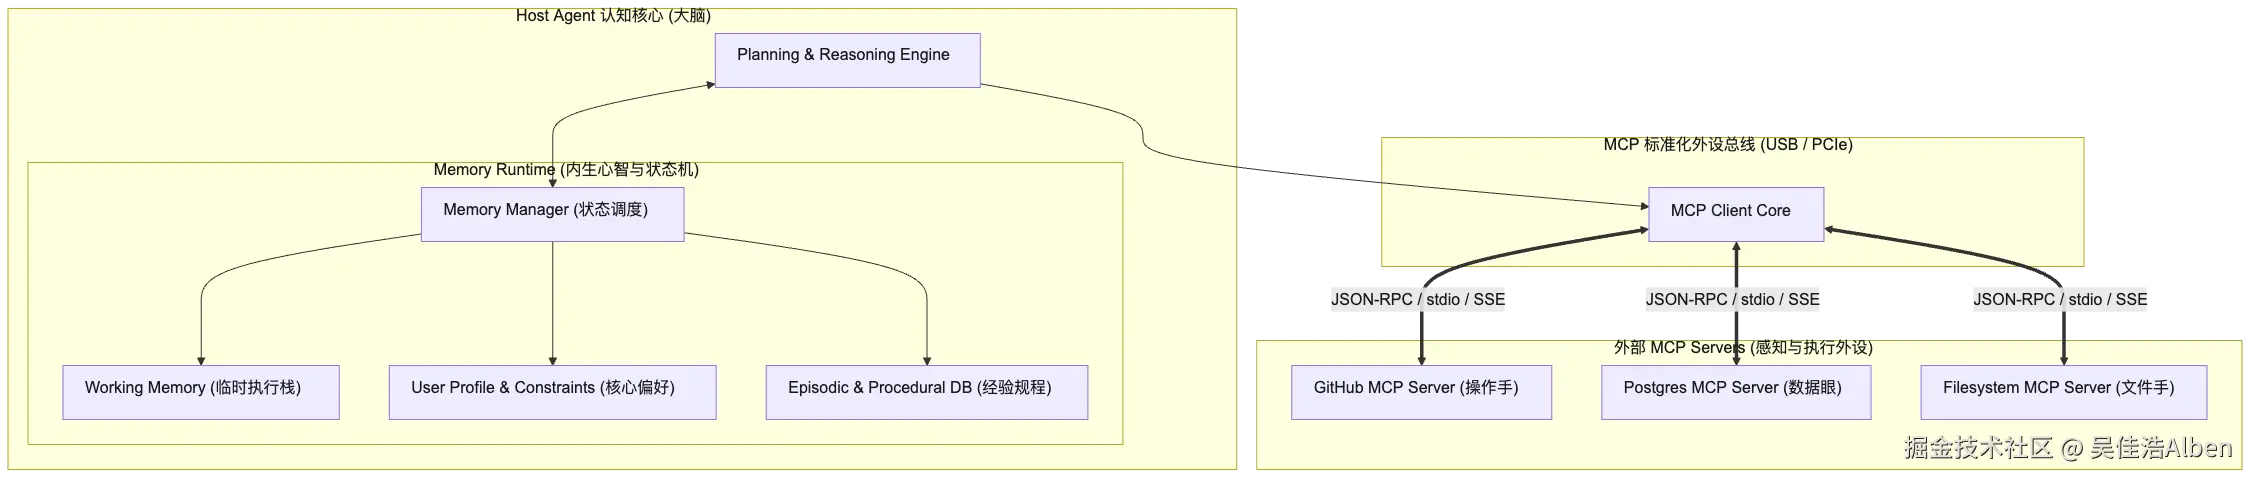
- 🔸 外设总线 vs 大脑中枢:MCP 是 Agent 的 USB 接口,负责连接 GitHub、数据库与文件系统;Memory Runtime 是海马体,负责跨周期的反思与认知状态维护;
- 🔸 被动响应 vs 主动代谢:MCP 遵循请求-响应模型,而 Memory 包含脱离单次交互的后台异步代谢、时间衰减与巩固。将 Memory 降级为 MCP Tool 会导致 Agent 频繁遗忘调用并造成延迟翻倍。
一句话总结这一章的核心观点:
MCP 给了 Agent 操作世界的双手,Memory Runtime 给了 Agent 积累经验的大脑。
六、核心机制的本质区别:认知全景拓扑
在系统设计中,各机制的定位与所属主体完全不同:
scss
世界 (客观资料) ────────► Knowledge (RAG) ──────► 企业公共制度与文档
                               │
用户 (主体属性) ────────► Profile / Preference ─► 核心画像与刚性约束
                               │
关系与经验 (主观轨迹) ──► Memory Runtime ───────► 动态演进的认知事实与因果反思
                               │
计算 (瞬时装载) ────────► Context & Summary ────► 当前工作台面与会话压缩骨架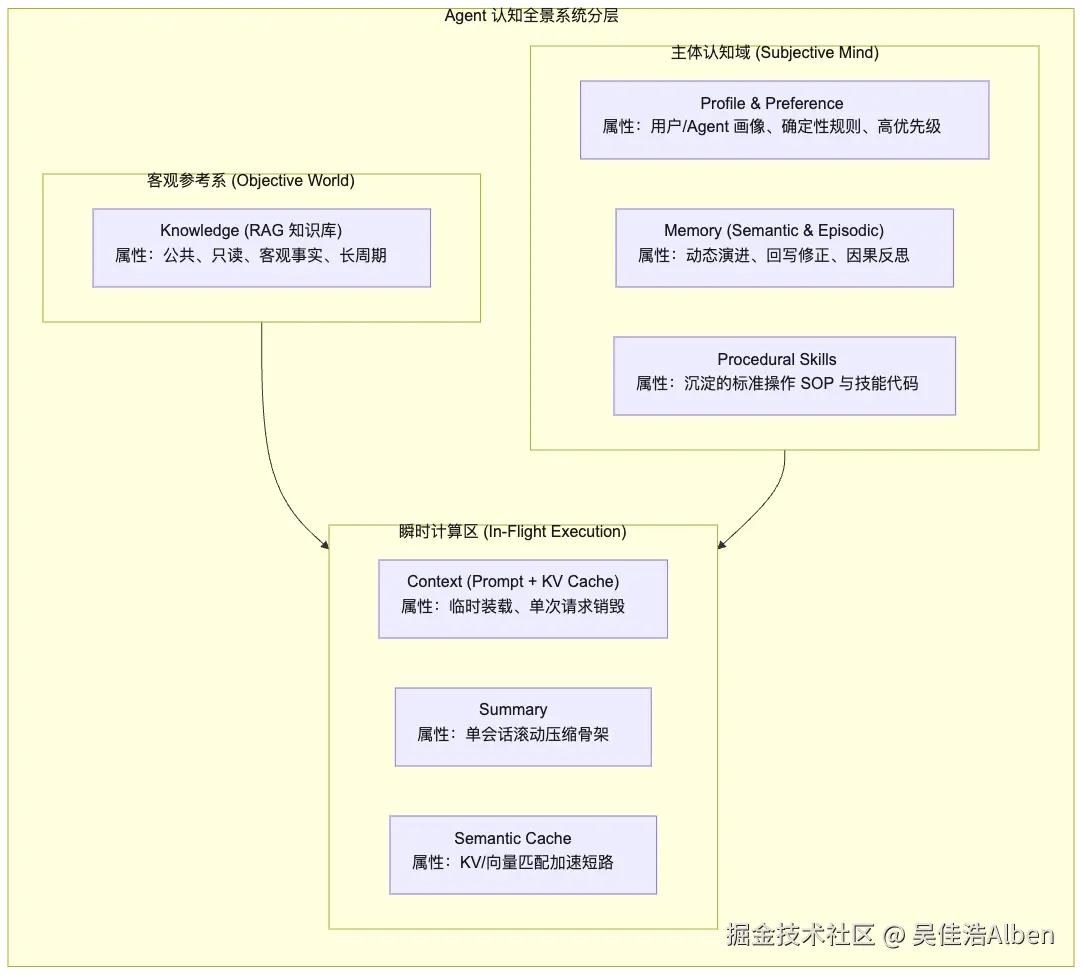
一句话总结这一章的核心观点:
清晰界定 Knowledge、Profile、Memory 与 Context 的生命周期,是架构解耦的第一步。
七、生产级系统架构与核心数据契约
在工业级代码库中,Memory 必须通过严密的类型系统、状态机与补丁协议进行定义。
以下为基于 Python 3.11+ 与 Pydantic v2 构建的生产级 Memory 核心领域模型与状态回写接口契约:
python
"""
agent_memory_core_contracts.py
生产级 Agent Memory 核心领域实体与状态机契约
"""

from __future__ import annotations

import enum
from datetime import datetime
from typing import Any, Dict, List, Optional
from pydantic import BaseModel, Field, ConfigDict


class MemoryScope(str, enum.Enum):
    """记忆作用域隔离"""
    SYSTEM = "system"          # 系统全局规范与硬约束
    USER = "user"              # 用户级偏好与画像 (跨会话共享)
    SESSION = "session"        # 会话级临时记忆 (绑定单个会话)
    AGENT = "agent"            # Agent 自身程序性技能与反思


class MemoryType(str, enum.Enum):
    """记忆认知类型分类"""
    PROFILE = "profile"        # 稳定属性与偏好 (如:使用的操作系统、编程语言)
    EPISODIC = "episodic"      # 情景事件与经验 (如:某次排错尝试、某个项目重构历史)
    SEMANTIC = "semantic"      # 概念与事实陈述 (如:项目 A 的数据库地址是 10.0.1.2)
    PROCEDURAL = "procedural"  # 执行工作流与规程 (如:发布上线必须先跑迁移脚本)


class MemoryStatus(str, enum.Enum):
    """记忆生命周期状态"""
    ACTIVE = "active"          # 活跃可用
    STALE = "stale"            # 待重新巩固/置信度衰减
    DEPRECATED = "deprecated"  # 已被新事实覆写废弃
    ARCHIVED = "archived"      # 已冷存归档


class MemoryItem(BaseModel):
    """标准原子记忆实体单元"""
    model_config = ConfigDict(frozen=False, extra="forbid")

    id: str = Field(description="记忆唯一标识符 (UUID 或基于内容的 Hash)")
    tenant_id: str = Field(description="企业多租户隔离标识")
    user_id: str = Field(index=True, description="用户唯一标识")
    session_id: Optional[str] = Field(default=None, index=True, description="所属会话标识")
    scope: MemoryScope = Field(default=MemoryScope.USER, description="作用域")
    type: MemoryType = Field(default=MemoryType.SEMANTIC, description="认知类型")
    status: MemoryStatus = Field(default=MemoryStatus.ACTIVE, description="生命周期状态")

    # 核心事实载荷 (必须是去除了主观情绪、代词指代的自包含原子陈述)
    content: str = Field(min_length=1, description="原子事实陈述")

    # 认知与调度元数据
    confidence: float = Field(default=1.0, ge=0.0, le=1.0, description="置信度")
    importance_score: float = Field(default=0.5, ge=0.0, le=1.0, description="固有重要性")
    access_count: int = Field(default=0, ge=0, description="累计召回命中次数")

    # 生命周期追踪
    created_at: datetime = Field(default_factory=datetime.utcnow)
    updated_at: datetime = Field(default_factory=datetime.utcnow)
    last_accessed_at: Optional[datetime] = None
    ttl_seconds: Optional[int] = Field(default=None, description="生存时长,None 为永久")

    # 溯源与冲突链
    version: int = Field(default=1, ge=1, description="版本号,用于乐观并发控制")
    source_message_id: Optional[str] = Field(default=None, description="来源消息 ID")
    superseded_by: Optional[str] = Field(default=None, description="被替代的新记忆 ID")
    metadata: Dict[str, Any] = Field(default_factory=dict, description="业务扩展数据")


class MemoryPatchOperation(str, enum.Enum):
    """状态机回写操作动作"""
    ADD = "add"                # 新增一条事实
    REPLACE = "replace"        # 覆写或修正已有事实 (版本递增)
    REMOVE = "remove"          # 逻辑废弃事实
    MERGE = "merge"            # 归并多条相似或上下位事实


class MemoryStatePatch(BaseModel):
    """
    状态回写补丁协议 (State Mutation Patch)
    用于 Extraction 模块向持久层提交严格的变更声明
    """
    model_config = ConfigDict(extra="forbid")

    operation: MemoryPatchOperation = Field(description="变更动作")
    target_scope: MemoryScope = Field(default=MemoryScope.USER)
    memory_type: MemoryType = Field(default=MemoryType.SEMANTIC)
    content: Optional[str] = Field(default=None, description="新增或更新后的内容")
    target_id: Optional[str] = Field(default=None, description="目标记忆 ID")
    old_content_anchor: Optional[str] = Field(default=None, description="用于模糊定位的旧内容锚点")
    confidence: float = Field(default=1.0, ge=0.0, le=1.0)
    reasoning: Optional[str] = Field(default=None, description="状态变更的逻辑推导依据")
    metadata: Dict[str, Any] = Field(default_factory=dict)
八、企业落地架构:Memory Runtime 双轨交互流
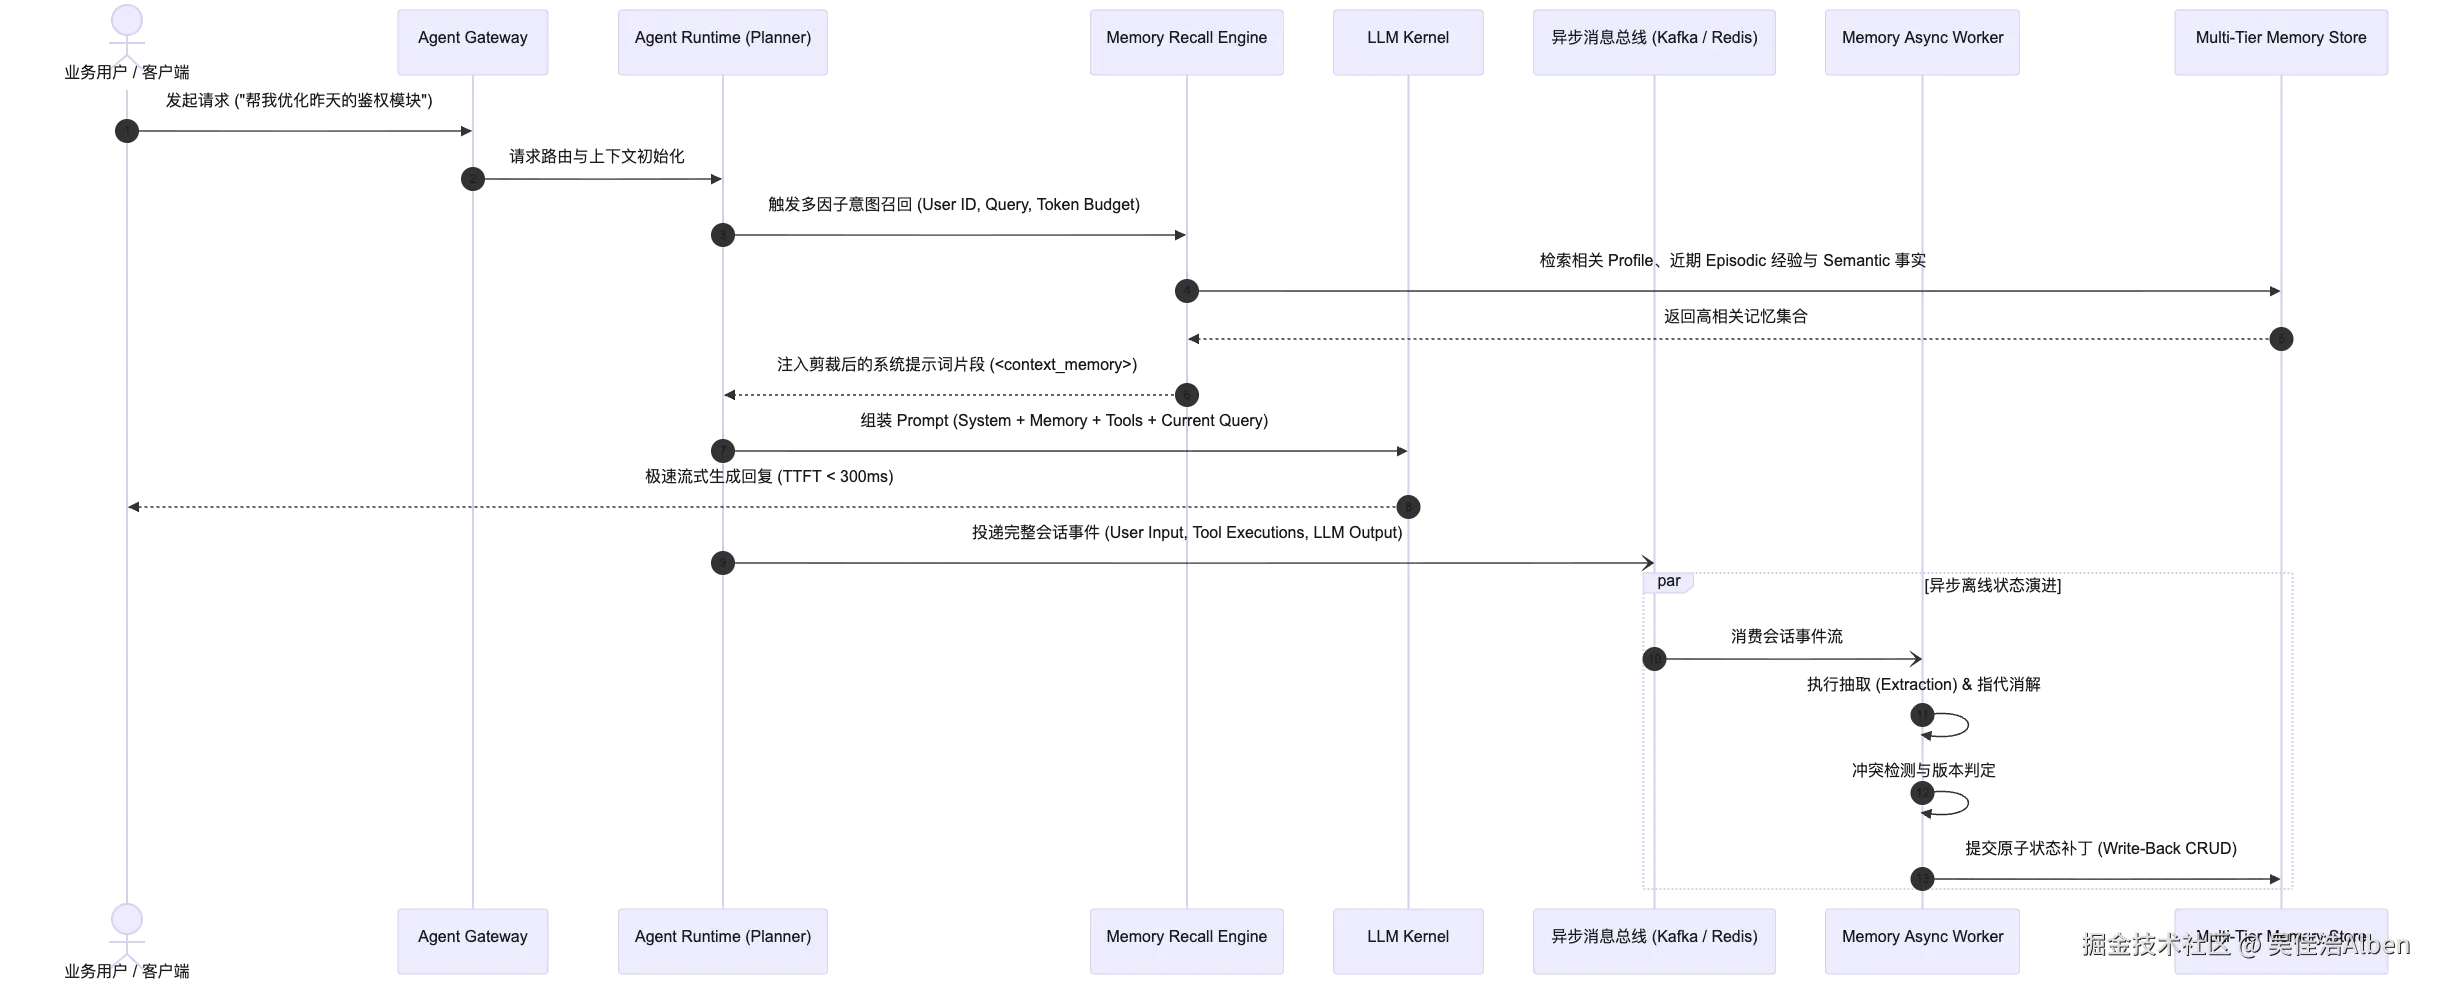
在企业级架构中,Memory 的抽取与反思绝不能阻塞在用户主交互链路上。必须采用在线极速召回与离线异步回写解耦的双轨运行时(Dual-Track Runtime):
本篇总结
- 🔸 从 ChatBot 到 Agent,Memory Runtime 是系统演化的必然阶梯;
- 🔸 Knowledge 像图书馆,Memory 像工作笔记;Knowledge 是公司的制度,Memory 是老员工的经验;
- 🔸 MCP 连接世界,Memory 连接过去与未来;
- 🔸 模型决定 Agent 能思考什么,Memory 决定 Agent 会成为谁。没有 Memory,Agent 每一天都是入职第一天。
在下一篇中,我们将深入剖析:《Agent Memory 架构设计:短时记忆、长期记忆与 Memory 生命周期》,全面拆解人脑认知与 Agent Memory 的精准映射、分层模型以及工业级量化评估(Evaluation)体系。
筒子们本篇为《企业级 Agent 实战指南》· 第一章的第 01 篇,后续续会更新完整的agent的开发的全部过程,如果你对Agent开发感兴趣不妨关注一下本合集。