作者:一个正在啃 AI Agent 的技术人
写在前面:如果你也好奇为什么 Claude Code、Cursor、Manus 这些 Agent 产品"长得差不多",如果你也想用几行代码就搭出一个能搜索、能规划、能写报告的研究助手------这篇笔记就是为你写的。
一、为什么需要 Deep Agents?
先问一个问题:市面上那些能真正完成复杂任务的 Agent 产品,它们有什么共同点?
看看 Claude Code、Manus、Cursor------虽然各有特色,但核心能力惊人地相似:
- 都能读写文件:能操作文件系统
- 都能拆解任务:把大任务拆成小步骤,一步步追踪
- 都能委派子任务:把部分工作交给专门的子 Agent
- 都有上下文管理策略:防止对话太长导致 LLM "失忆"
这些共性不是巧合。当一个 Agent 面对足够复杂的任务时,这些能力就是必需的。
但问题在于:如果你用 LangChain 从零开始搭建,你会发现自己在重复造轮子------手写文件读写工具、手写任务追踪逻辑、手写子 Agent 调度机制......
Deep Agents 的价值就在于一个朴素的洞察:既然所有认真做 Agent 的产品都需要这些能力,为什么不把它们固化成开箱即用的组件?
就像你不需要每次装修都自己铺水管、拉电线------Agent Harness(工具套件层)直接给你一个"精装工具间",常用工具挂在墙上,工作流程贴在白板上,你来了就能干活。
二、DeepAgents 的技术定位:三层架构全景图
理解 Deep Agents 之前,必须先搞清楚它在 LangChain 技术栈中的位置。
在 LangChain 生态中,Agent 开发被分为三个层次:
2.1 底层:Agent Runtime(运行时层)------ LangGraph
解决的问题:Agent 怎么可靠地运行?
| 能力 | 说明 |
|---|---|
| 持久化执行 | Agent 中途崩溃了,能从断点恢复 |
| 流式输出 | 让用户实时看到 Agent 的思考和操作过程 |
| 人机协作 | 在关键操作前暂停,等待人工审批 |
| 状态管理 | 跨对话保存上下文 |
LangGraph 就是 Agent 世界的**"操作系统"**------所有上层应用都运行在它之上。同一层的选手还有 Temporal、Inngest 等。
2.2 中间层:Agent Framework(框架层)------ LangChain
解决的问题:如何让 Agent 开发更标准化、更易上手?
LangChain 构建在 LangGraph 之上,提供了更简洁的 API:
python
from langchain.agents import create_agent

agent = create_agent(
    model="gpt-4.1",
    tools=[web_search, calculator],
    system_prompt="You are a helpful assistant."
)
你不需要关心底层的执行引擎、状态持久化逻辑------框架帮你处理好了。同一层的选手包括:Vercel AI SDK、CrewAI、OpenAI Agents SDK、Google ADK、LlamaIndex 等。
2.3 上层:Agent Harness(工具层)------ Deep Agents
解决的问题:如何让 Agent 开箱即用,直接处理复杂任务?
Deep Agents 在 Runtime 和 Framework 之上,预置了一整套经过验证的工具接口和中间件框架:
| 能力 | 说明 |
|---|---|
| 虚拟文件系统 | read_file、write_file、edit_file、delete、ls、glob、grep 七个文件操作工具 |
| 任务规划 | 启用 TodoListMiddleware 后获得 write_todos,把复杂任务拆解为可追踪的步骤 |
| 子 Agent 委派 | task 工具,让 Agent 能将子任务派发给专门的 Agent |
| 长期记忆 | 基于 LangGraph Memory Store,支持跨对话的持久化记忆 |
同一层的选手包括:Anthropic 的 Claude Agent SDK、Codex SDK、Manus 等。
2.4 三层关系一览
| 层次 | 代表 | 核心价值 | 适用场景 |
|---|---|---|---|
| Runtime(底层) | LangGraph | 持久化执行、流式输出、人机协作、状态管理 | 需要精细控制的长期运行 Agent |
| Framework(中间层) | LangChain | 模型抽象、工具接口、Agent 循环、中间件 | 快速上手、标准化 Agent 应用 |
| Harness(上层) | Deep Agents | 预置工具、中间件框架、子 Agent、长期记忆 | 复杂多步骤任务、高自主性 Agent |
三者不是互相替代的关系,而是自底向上层层构建:
┌─────────────────────────────────────────┐
│   Deep Agents (Harness)                 │  ← 开箱即用
│   虚拟文件系统 + 任务规划 + 子Agent + 记忆 │
├─────────────────────────────────────────┤
│   LangChain (Framework)                 │  ← 标准化开发
│   模型抽象 + 工具接口 + Agent循环 + 中间件  │
├─────────────────────────────────────────┤
│   LangGraph (Runtime)                   │  ← 可靠运行
│   持久化执行 + 流式输出 + 人机协作 + 状态管理 │
└─────────────────────────────────────────┘
         ↕ LangSmith (可观测性贯穿全程)
三、核心设计理念:Context Engineering(上下文工程)
这是 Deep Agents 最核心的技术理念。
3.1 传统做法:Prompt Stuffing(提示词塞入)
传统的 Agent 开发,所有信息都塞在 prompt 里:
System: 你是一个编程助手。
User: 请帮我重构 src/ 下的代码。
[附带: 20 个文件的完整内容,共 50000 tokens]
这有几个致命问题:
- 上下文窗口溢出:LLM 有 token 上限,文件一多就装不下
- 注意力稀释:信息越多,LLM 对关键信息的关注度越低(就像把一本书塞给一个人让他"全记住")
- 不可扩展:无法处理任意规模的项目
3.2 Deep Agents 的做法:Context Engineering
Deep Agents 的解决方案是引入一个虚拟文件系统 ,让 Agent 像人类一样工作:
-
需要读文件时,调用
read_file按需读取 -
需要记录中间结果时,调用
write_file写到文件里 -
需要搜索时,调用
grep或glob查找 -
大文件只读取需要的部分(
offset/limit参数)┌──────────────────────────────────────────────┐
│ 传统做法 (Prompt Stuffing) │
│ │
│ LLM 一次性接收所有信息 → 上下文溢出 → 注意力稀释 │
└──────────────────────────────────────────────┘┌──────────────────────────────────────────────┐
│ Deep Agents (Context Engineering) │
│ │
│ LLM ←→ 虚拟文件系统(按需读取/写入) │
│ 上下文只保留当前步骤需要的信息 │
│ 其余信息存储在文件系统中,随时可取 │
└──────────────────────────────────────────────┘
更妙的是,这个"文件系统"是虚拟的、可插拔的:
- 可以是内存中的临时存储(开发调试用)
- 可以是本地磁盘(处理真实文件)
- 可以是持久化数据库(跨会话保持记忆)
- 可以是远程沙箱(安全执行代码)
- 甚至可以混合使用(不同路径路由到不同后端)
一句话总结 Context Engineering:不是把所有信息都喂给 LLM,而是为 LLM 构建一个高效获取和管理信息的基础设施。
四、实战:构建第一个 DeepAgent
下面我们通过一个完整的案例来理解 Deep Agents 的实际使用。这个案例是一个研究助手------能搜索互联网、规划任务、撰写研究报告。
5.1 环境准备
bash
# 安装依赖(Python 3.11+)
pip install deepagents langchain-openai tavily-python

# 配置 API Key
export OPENAI_API_KEY="your-api-key"
export OPENAI_BASE_URL="https://dashscope.aliyuncs.com/compatible-mode/v1"
export TAVILY_API_KEY="your-tavily-key"
5.2 完整代码
python
import os
from langchain_openai import ChatOpenAI
from deepagents import create_deep_agent
from typing import Literal
from tavily import TavilyClient
from langchain.agents.middleware import TodoListMiddleware

# 1. 配置模型
model = ChatOpenAI(
    model=os.environ.get("MODEL_NAME", "qwen3.6-plus"),
    api_key=os.environ["OPENAI_API_KEY"],
    base_url=os.environ["OPENAI_BASE_URL"],
)

# 2. 初始化搜索客户端
tavily_client = TavilyClient(api_key=os.environ["TAVILY_API_KEY"])

# 3. 定义搜索工具
def internet_search(
    query: str,
    max_results: int = 5,
    topic: Literal["general", "news", "finance"] = "general",
    include_raw_content: bool = False,
):
    """Run a web search for the given query.

    Args:
        query: The search query string.
        max_results: Maximum number of results to return.
        topic: The topic category for the search.
        include_raw_content: Whether to include raw page content.
    """
    return tavily_client.search(
        query,
        max_results=max_results,
        include_raw_content=include_raw_content,
        topic=topic,
    )

# 4. 定义系统提示词
research_instructions = """你是一位专业的研究员,擅长撰写深度、全面、通俗易懂的研究报告。

你的工作流程如下:

1. **搜索与收集信息**:使用 internet_search 工具广泛搜索,确保信息来源可靠、多样。

2. **撰写研究报告**,必须包含以下核心模块:

   - **定义与概念**:用通俗语言解释"这是什么"
   - **解决什么问题**:说明它诞生的背景和痛点
   - **行业使用情况与典型案例**:举出真实、具体的落地案例
   - **竞品横向对比与选型参考**:从功能、性能、成本等维度对比,给出选型建议

3. **语言风格要求**:
   - 生动有趣,避免枯燥的学术腔
   - 多用比喻和类比
   - 像一位热情的导游,带领读者探索新知识
"""

# 5. 创建 Agent
agent = create_deep_agent(
    model=model,
    tools=[internet_search],
    system_prompt=research_instructions,
    middleware=[TodoListMiddleware()],
)

# 6. 运行
result = agent.invoke(
    {"messages": [{"role": "user", "content": "什么是 LangGraph?"}]}
)

print(result["messages"][-1].content)
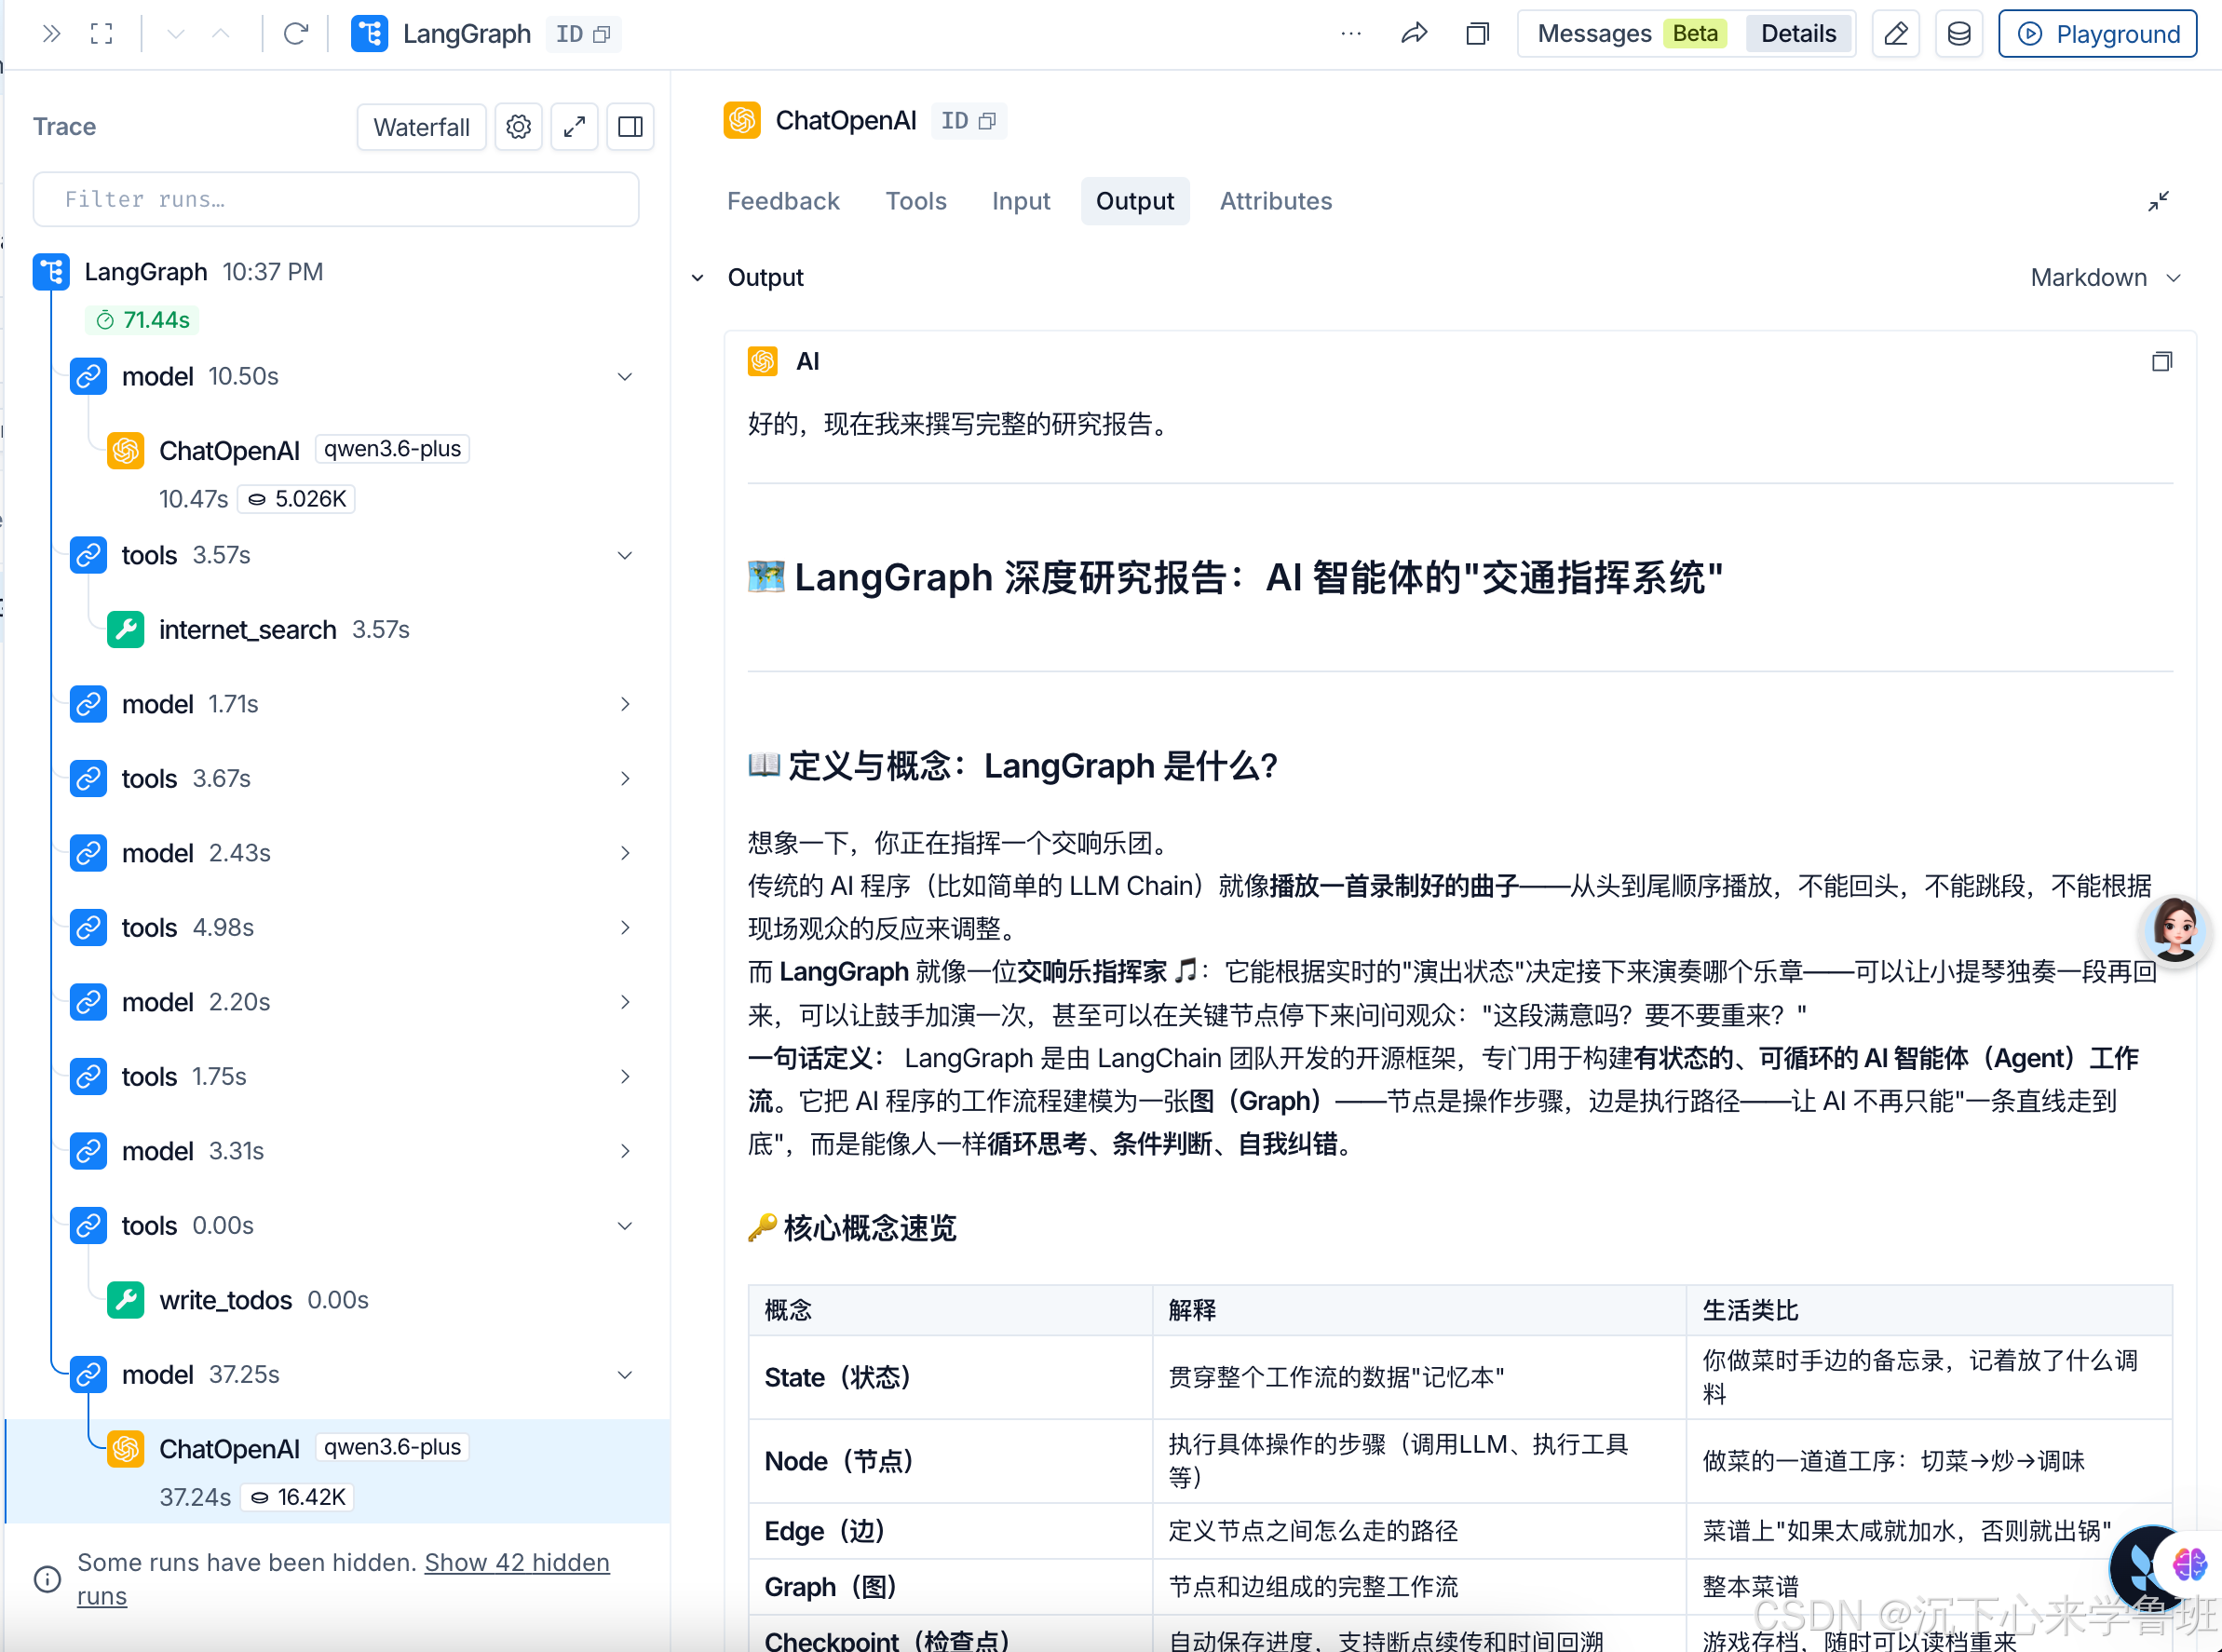
运行结果 :
5.3 重点知识点解析
(1)自定义工具编写方法
Deep Agents 的工具定义极其简单------一个普通的 Python 函数就是一个工具。
Agent 通过函数的签名 (参数名和类型标注)和docstring 来理解这个工具能做什么。工具定义有三要素:
| 要素 | 作用 | 对 Agent 的影响 |
|---|---|---|
| 参数类型标注 | 告诉 Agent 每个参数该传什么类型 | 没有类型标注,Agent 可能传入错误类型 |
| Docstring | 告诉 Agent 这个工具的用途 | 没有 docstring,Agent 不知道何时该调用 |
| 默认值 | 标记哪些参数是可选的 | Agent 只需填必需参数,减少出错概率 |
以案例中的 internet_search 为例:
python
def internet_search(
    query: str,                              # 要素1:参数名 + 类型标注
    max_results: int = 5,                    # 要素3:默认值(可选参数)
    topic: Literal["general", "news", "finance"] = "general",  # Literal 限制取值范围
    include_raw_content: bool = False,       # 要素3:默认值
):
    """Run a web search for the given query.  # 要素2:Docstring(用途说明)

    Args:
        query: The search query string.       # 每个参数的详细说明
        max_results: Maximum number of results to return.
        topic: The topic category for the search.
        include_raw_content: Whether to include raw page content.
    """
    return tavily_client.search(
        query,
        max_results=max_results,
        include_raw_content=include_raw_content,
        topic=topic,
    )
把 docstring 想象成给 Agent 看的"使用说明书"------写得越清晰,Agent 用得越准确。
(2)TodoListMiddleware 的功能原理
TodoListMiddleware 是 Deep Agents 提供的一个中间件,它让 Agent 具备了任务规划和追踪的能力。
它做了什么?
当 Agent 接收到一个复杂任务(比如"研究 LangGraph 并写一份报告")时,TodoListMiddleware 会自动给 Agent 注入一个 write_todos 工具。Agent 可以调用这个工具,把任务拆解为可追踪的步骤:
python
# Agent 内部自动调用的伪代码
write_todos([
    {"content": "搜索 LangGraph 的基本概念", "status": "pending"},
    {"content": "收集 LangGraph 与 LangChain 的关系资料", "status": "pending"},
    {"content": "整理 LangGraph 的核心架构图", "status": "pending"},
    {"content": "撰写研究报告", "status": "pending"},
])
工作原理:
- 注入工具 :Middleware 在 Agent 初始化时,向工具列表注入
write_todos - 状态维护:维护一个 TodoList 状态,记录每个步骤的内容和完成情况
- 进度追踪:Agent 每完成一步,可以更新对应步骤的状态
- 提示词增强:在每次模型调用时,把当前 TodoList 状态注入到系统提示词中
为什么要用它?
- 短任务(简单问答)不需要任务规划,可以不传 TodoListMiddleware
- 长任务(研究报告、代码重构)启用后,Agent 能主动拆解、分步执行、自我追踪进度
在案例代码中,middleware=[TodoListMiddleware()] 就是显式启用了这个能力。
(3)背后上下文管理做了哪些事情?
这是 Deep Agents 最精妙的部分------Context Engineering 的实际落地。
当你调用 agent.invoke() 时,Deep Agents 在背后自动完成了一系列操作:
用户输入: "什么是 LangGraph?"
         │
         ▼
┌─────────────────────────────────────────────────┐
│ Step 1: 规划任务                                  │
│ Agent 调用 write_todos,拆解任务为多个子步骤         │
└────────────────────┬────────────────────────────┘
                     ▼
┌─────────────────────────────────────────────────┐
│ Step 2: 搜索信息                                  │
│ 调用 internet_search 工具,执行多次网络搜索          │
│ 获取大量搜索结果(可能上万 token)                   │
└────────────────────┬────────────────────────────┘
                     ▼
┌─────────────────────────────────────────────────┐
│ Step 3: 管理上下文(核心!)                       │
│ 调用内置的 write_file 将搜索结果写入虚拟文件系统     │
│ 避免一次性塞入 prompt 导致上下文溢出                 │
│ 需要时再调用 read_file 按需读取                     │
└────────────────────┬────────────────────────────┘
                     ▼
┌─────────────────────────────────────────────────┐
│ Step 4: 委派子任务(如需要)                       │
│ 调用内置的 task 工具,将复杂子任务派发给专门的子Agent │
└────────────────────┬────────────────────────────┘
                     ▼
┌─────────────────────────────────────────────────┐
│ Step 5: 综合报告                                  │
│ 从文件系统中读取整理好的信息,撰写最终报告            │
└─────────────────────────────────────────────────┘
具体来说,上下文管理做了这些事:
-
虚拟文件系统管理 :Agent 通过
write_file将大量搜索结果存储到虚拟文件系统中(不是塞入 prompt),通过read_file按需读取需要的信息。这解决了上下文窗口溢出的问题。 -
信息按需加载 :Agent 不会被一次性喂入所有信息,而是像人类程序员一样------需要看哪个文件就
read_file,需要搜索就用grep。这解决了注意力稀释的问题。 -
中间结果持久化:Agent 可以把中间分析结果写入文件,后续步骤再读取。这避免了信息在对话历史中丢失。
-
无限扩展性:因为信息存储在文件系统而非 prompt 中,Agent 理论上可以处理任意规模的项目------不管项目有 10 个文件还是 10000 个文件。
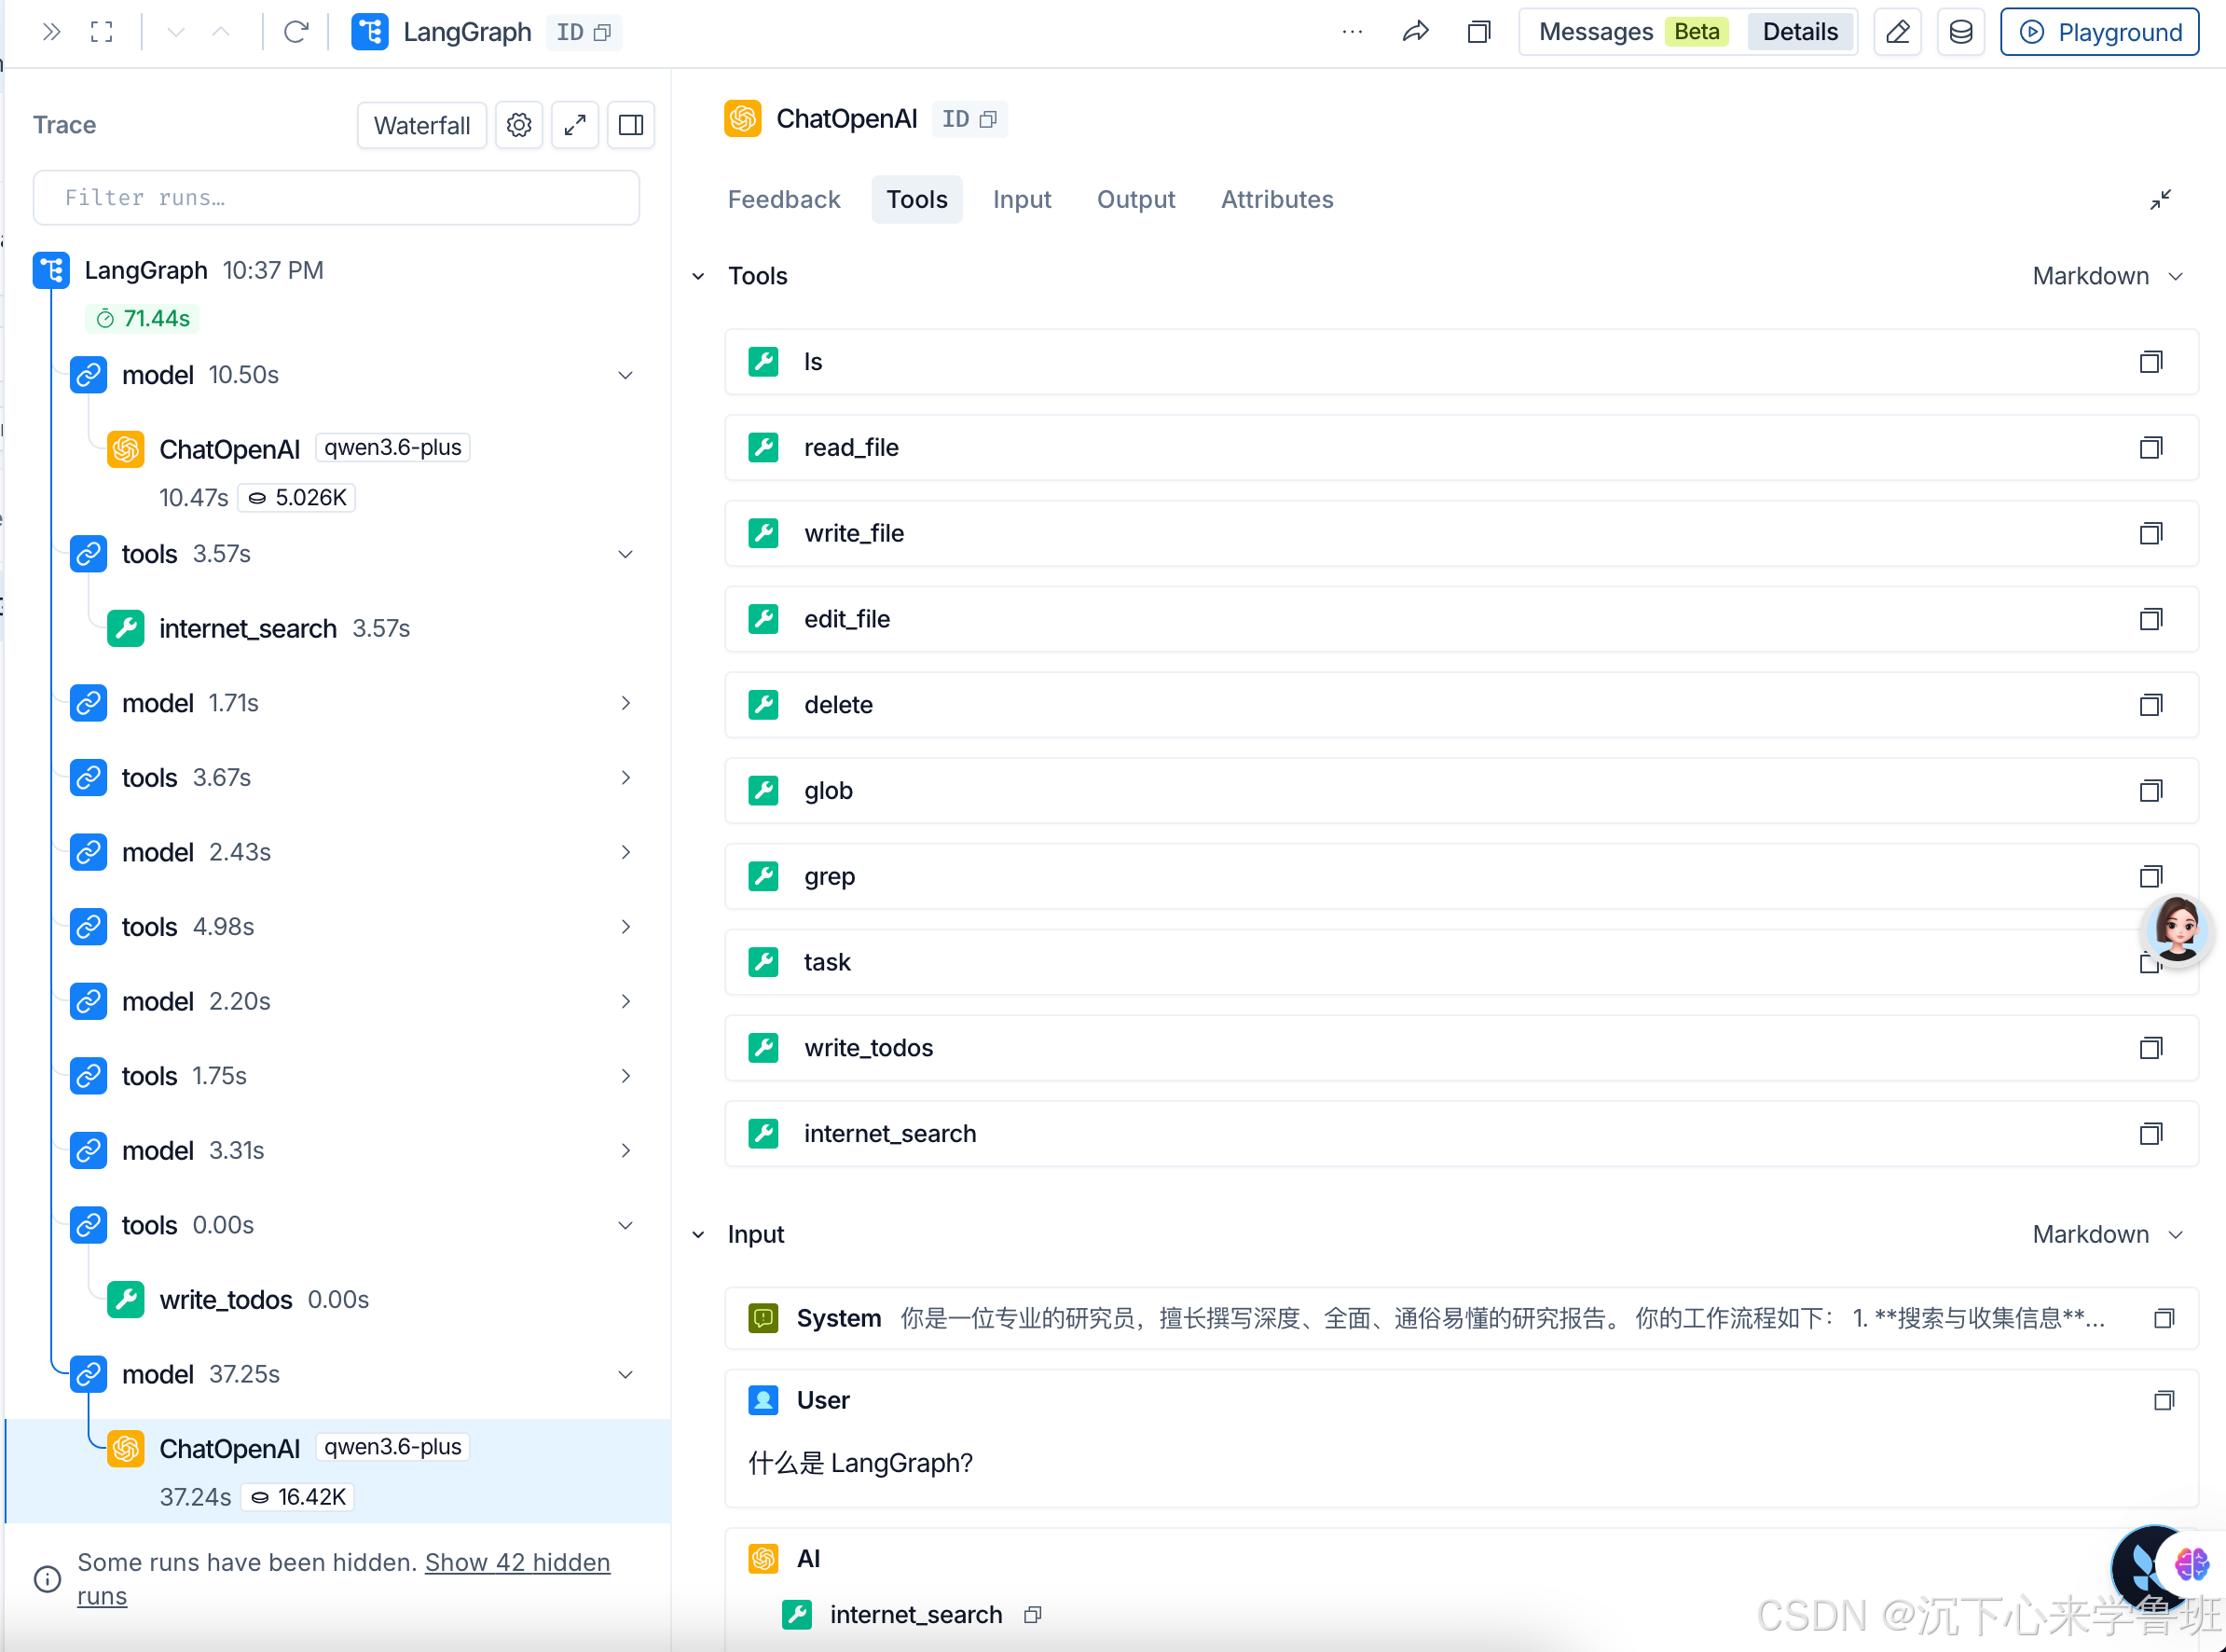
你只写了一次 agent.invoke(),但 Agent 背后可能调用了 10+ 次工具(如下图所示)。 这就是 Harness 层的价值------把复杂的工作流封装成一行调用。
六、技术全景图
最后,用一张全景图来总结 Deep Agents 在整个 LangChain 生态中的位置:
┌─────────────────────────────────────────────────────┐
│                Deep Agents (Harness)                 │
│  ┌───────────┐ ┌──────────┐ ┌──────────┐ ┌────────┐ │
│  │ 虚拟文件系统 │ │ 任务规划  │ │ 子Agent  │ │ 长期记忆 │ │
│  │ 7个文件工具 │ │TodoList  │ │ task委派  │ │Memory  │ │
│  └───────────┘ └──────────┘ └──────────┘ └────────┘ │
│         可插拔存储后端(内存/磁盘/DB/沙箱)             │
├─────────────────────────────────────────────────────┤
│              LangChain (Framework)                   │
│        模型抽象 + 工具接口 + Agent循环 + 中间件          │
├─────────────────────────────────────────────────────┤
│              LangGraph (Runtime)                     │
│     持久化执行 + 流式输出 + 人机协作 + 状态管理          │
├─────────────────────────────────────────────────────┤
│              LangSmith (可观测性)                      │
│        模型调用追踪 + 工具调用日志 + Token统计          │
└─────────────────────────────────────────────────────┘
七、总结
这篇笔记我们覆盖了 Deep Agents 的核心内容:
- 为什么需要 Deep Agents? → 因为所有成功的 Agent 产品都有相似的核心能力(文件系统、任务规划、子Agent、上下文管理),Deep Agents 把这些能力固化为开箱即用的组件
- 技术定位 → 三层架构:LangGraph(Runtime)→ LangChain(Framework)→ Deep Agents(Harness),自底向上层层构建
- 核心理念 Context Engineering → 用虚拟文件系统按需管理上下文,而非把所有信息塞进 prompt
- 实战案例 → 自定义工具三要素(类型标注 + docstring + 默认值)、TodoListMiddleware 的任务规划原理、背后上下文管理的五个步骤
希望这篇笔记能帮你快速理解 Deep Agents 的设计思想和使用方法。如果你也有 AI Agent 相关的探索,欢迎在评论区交流!
参考来源:
- Datawhale《Deep Agents 实战》开源课程:https://github.com/datawhalechina/deepagents-in-action
- LangChain 官方文档:https://python.langchain.com/