OpenCV 之外的另一半工具箱:Supervision 视觉工程实战
- [介绍:认识 supervision](#介绍:认识 supervision)
-
- [0.1 核心对象一:`sv.Detections` ------ 统一的检测结果容器](#0.1 核心对象一:
sv.Detections—— 统一的检测结果容器) - [0.2 核心对象二:Annotator 家族 ------ 按需选择的标注器](#0.2 核心对象二:Annotator 家族 —— 按需选择的标注器)
- [0.3 环境与素材(本机已就绪)](#0.3 环境与素材(本机已就绪))
- [0.4 素材准备:OpenCV 截视频、抽帧与中文路径安全读写](#0.4 素材准备:OpenCV 截视频、抽帧与中文路径安全读写)
-
- [用到的 OpenCV 方法速查](#用到的 OpenCV 方法速查)
- [0.1 核心对象一:`sv.Detections` ------ 统一的检测结果容器](#0.1 核心对象一:
- [第一章 检测与标注(Detect and Annotate)](#第一章 检测与标注(Detect and Annotate))
-
- [1.1 例 1(入门推荐先跑):YOLO11 + supervision 检测框](#1.1 例 1(入门推荐先跑):YOLO11 + supervision 检测框)
- [1.2 例 2(进阶):RF-DETR 检测框标注](#1.2 例 2(进阶):RF-DETR 检测框标注)
- [1.3 例 3(分割):RF-DETR Seg + 掩码标注](#1.3 例 3(分割):RF-DETR Seg + 掩码标注)
- [1.4 三个模型实测对比(dog.jpeg,RTX 5060 GPU)](#1.4 三个模型实测对比(dog.jpeg,RTX 5060 GPU))
- [1.5 本章方法速查](#1.5 本章方法速查)
- [第二章 存档检测(Save Detections)](#第二章 存档检测(Save Detections))
-
- [2.1 Sink 家族:两个"存档器"](#2.1 Sink 家族:两个"存档器")
- [2.2 基础用法:把单图推理改成"视频流 + 存档"](#2.2 基础用法:把单图推理改成"视频流 + 存档")
- [2.3 Custom Fields:自定义字段(本章核心)](#2.3 Custom Fields:自定义字段(本章核心))
- [2.4 实测记录:完整存档](#2.4 实测记录:完整存档)
-
- [实测 A:RF-DETR Medium × 行人广场视频 → CSV](#实测 A:RF-DETR Medium × 行人广场视频 → CSV)
- [实测 B:RF-DETR Seg Small × dog.jpeg → JSON](#实测 B:RF-DETR Seg Small × dog.jpeg → JSON)
- [2.5 进阶技巧:过滤后再存档](#2.5 进阶技巧:过滤后再存档)
- [2.6 注意事项(官方 FAQ 要点 + 实测补充)](#2.6 注意事项(官方 FAQ 要点 + 实测补充))
- [2.7 本章方法速查](#2.7 本章方法速查)
- [第三章 滤波器检测(Filter Detections)](#第三章 滤波器检测(Filter Detections))
-
- [3.1 统一语法:布尔掩码索引](#3.1 统一语法:布尔掩码索引)
- [3.2 按类别过滤](#3.2 按类别过滤)
- [3.3 按置信度过滤](#3.3 按置信度过滤)
- [3.4 按面积过滤(三种口径)](#3.4 按面积过滤(三种口径))
- [3.5 按区域过滤(PolygonZone 电子围栏)](#3.5 按区域过滤(PolygonZone 电子围栏))
- [3.6 混合条件:`&` 与 `|` 组合](#3.6 混合条件:
&与|组合) - [3.7 NMS 去重(官方 FAQ 补充)](#3.7 NMS 去重(官方 FAQ 补充))
- [3.8 七种过滤实测汇总](#3.8 七种过滤实测汇总)
- [3.9 本章方法速查](#3.9 本章方法速查)
- [第四章 探测小物体(Detect Small Objects)](#第四章 探测小物体(Detect Small Objects))
-
- [4.1 为什么小目标难检:输入缩放是罪魁祸首](#4.1 为什么小目标难检:输入缩放是罪魁祸首)
- [4.2 第一步永远是跑基线:整图推理](#4.2 第一步永远是跑基线:整图推理)
- [4.3 切片推理:`sv.InferenceSlicer` 三步走](#4.3 切片推理:
sv.InferenceSlicer三步走) - [4.4 RF-DETR 接入 Slicer:一个必然踩的坑](#4.4 RF-DETR 接入 Slicer:一个必然踩的坑)
- [4.5 实测汇总(1920×1080 行人广场图,RTX 5060 GPU)](#4.5 实测汇总(1920×1080 行人广场图,RTX 5060 GPU))
- [4.6 调参指南](#4.6 调参指南)
- [4.7 本章方法速查](#4.7 本章方法速查)
- [第五章 视频追踪(Track Objects)](#第五章 视频追踪(Track Objects))
-
- [5.1 ByteTrack:一行接入的追踪器](#5.1 ByteTrack:一行接入的追踪器)
- [5.2 例 1:检测 + 追踪 + 轨迹三件套](#5.2 例 1:检测 + 追踪 + 轨迹三件套)
- [5.3 例 1 实测结果](#5.3 例 1 实测结果)
- [5.4 关键点追踪(官方 Keypoints 章节)](#5.4 关键点追踪(官方 Keypoints 章节))
- [5.5 例 2 实测结果](#5.5 例 2 实测结果)
- [5.6 注意事项(官方 FAQ 要点 + 实测补充)](#5.6 注意事项(官方 FAQ 要点 + 实测补充))
- [5.7 本章方法速查](#5.7 本章方法速查)
- [第六章 处理数据集(Process Datasets)](#第六章 处理数据集(Process Datasets))
-
- [6.1 一个类管所有格式](#6.1 一个类管所有格式)
- [6.2 两种来源:加载现成标注 / 直接构造](#6.2 两种来源:加载现成标注 / 直接构造)
- [6.3 格式转换实测:导出 → 回读 → 一致性核对](#6.3 格式转换实测:导出 → 回读 → 一致性核对)
- [6.4 两个实测发现(教程重点)](#6.4 两个实测发现(教程重点))
- [6.5 切分与合并](#6.5 切分与合并)
- [6.6 可视化与增强](#6.6 可视化与增强)
- [6.7 本章方法速查](#6.7 本章方法速查)
- [第七章 模型基准测试(Benchmark a Model)](#第七章 模型基准测试(Benchmark a Model))
-
- [7.1 API 变了:`sv.CocoMetric` 已被移除](#7.1 API 变了:
sv.CocoMetric已被移除) - [7.2 评测四步走](#7.2 评测四步走)
- [7.3 实测结果:YOLO11n vs RF-DETR Medium](#7.3 实测结果:YOLO11n vs RF-DETR Medium)
- [7.4 实测抓到的大坑:类别 id 体系不一致(本章最有价值的一节)](#7.4 实测抓到的大坑:类别 id 体系不一致(本章最有价值的一节))
- [7.5 混淆矩阵:数字之外的"眼睛"](#7.5 混淆矩阵:数字之外的"眼睛")
- [7.6 本章方法速查](#7.6 本章方法速查)
- [7.1 API 变了:`sv.CocoMetric` 已被移除](#7.1 API 变了:
- [第八章 区内计数(Count in Zone)](#第八章 区内计数(Count in Zone))
-
- [8.1 官方主流程:双区域实时计数](#8.1 官方主流程:双区域实时计数)
- [8.2 实测:行人广场视频双区域计数](#8.2 实测:行人广场视频双区域计数)
- [8.3 计数时序存档:把"每帧的数"变成数据](#8.3 计数时序存档:把"每帧的数"变成数据)
- [8.4 瞬时计数 vs 累计进入:工业场景最容易踩的语义坑](#8.4 瞬时计数 vs 累计进入:工业场景最容易踩的语义坑)
- [8.5 FAQ 进阶:线穿越计数(LineZone)](#8.5 FAQ 进阶:线穿越计数(LineZone))
- [8.6 实测注意事项](#8.6 实测注意事项)
- [8.7 本章方法速查](#8.7 本章方法速查)
- [第九章 注意事项](#第九章 注意事项)
- 参考链接
介绍:认识 supervision
supervision 是 Roboflow 开源的计算机视觉工具库(MIT 协议,可商用),它解决一个核心问题:把"模型输出"变成"可用的结果"------无论背后是 YOLO、RF-DETR 还是分割模型,检测结果都统一成同一个数据结构,再用同一套标注器画框、画掩码、贴标签、计数、画轨迹。
一句话理解分层:模型(ultralytics / rfdetr)负责"检测出是什么、在哪",supervision 负责"把结果画出来、用起来"。换模型不用改标注代码,这是它最大的价值。
整个流程固定为三步,本教程所有示例都是这个骨架:
python
# ① 模型推理 → 得到统一的检测结果对象
detections = model.predict(image)

# ② 选择标注器,把结果画到图上(或用 Sink 存档)
annotated = annotator.annotate(scene=image, detections=detections)

# ③ 显示、保存或存档
sv.plot_image(annotated)   # 或 cv2.imwrite(...)
0.1 核心对象一:sv.Detections ------ 统一的检测结果容器
不管来自哪个模型,检测结果都被装进 sv.Detections:
xyxy:框坐标(N×4 数组)confidence:置信度class_id:类别编号- 模型附加信息(如类别名)放在
detections.data字典里,可用detections["class_name"]直接取(supervision 0.30 已实测支持)
0.2 核心对象二:Annotator 家族 ------ 按需选择的标注器
| 标注器 | 作用 | 典型场景 |
|---|---|---|
sv.BoxAnnotator |
画矩形检测框 | 目标检测(第一章例 1、例 2) |
sv.LabelAnnotator |
在框上贴文字标签 | 几乎所有场景,与上面配合使用 |
sv.MaskAnnotator |
填充分割掩码(半透明色块) | 实例分割(第一章例 3) |
sv.BoxCornerAnnotator |
只画四角,画面更简洁 | 监控画面、报表截图 |
sv.TraceAnnotator |
画目标运动轨迹 | 测速轨迹 |
标注器可以链式叠加:先画掩码,再在掩码上贴标签------第一章例 3 就是这么做的。
0.3 环境与素材(本机已就绪)
| 项目 | 内容 |
|---|---|
| 运行环境 | 本地 conda 环境(Python 3.10,torch 2.11.0+cu128,GPU 可用) |
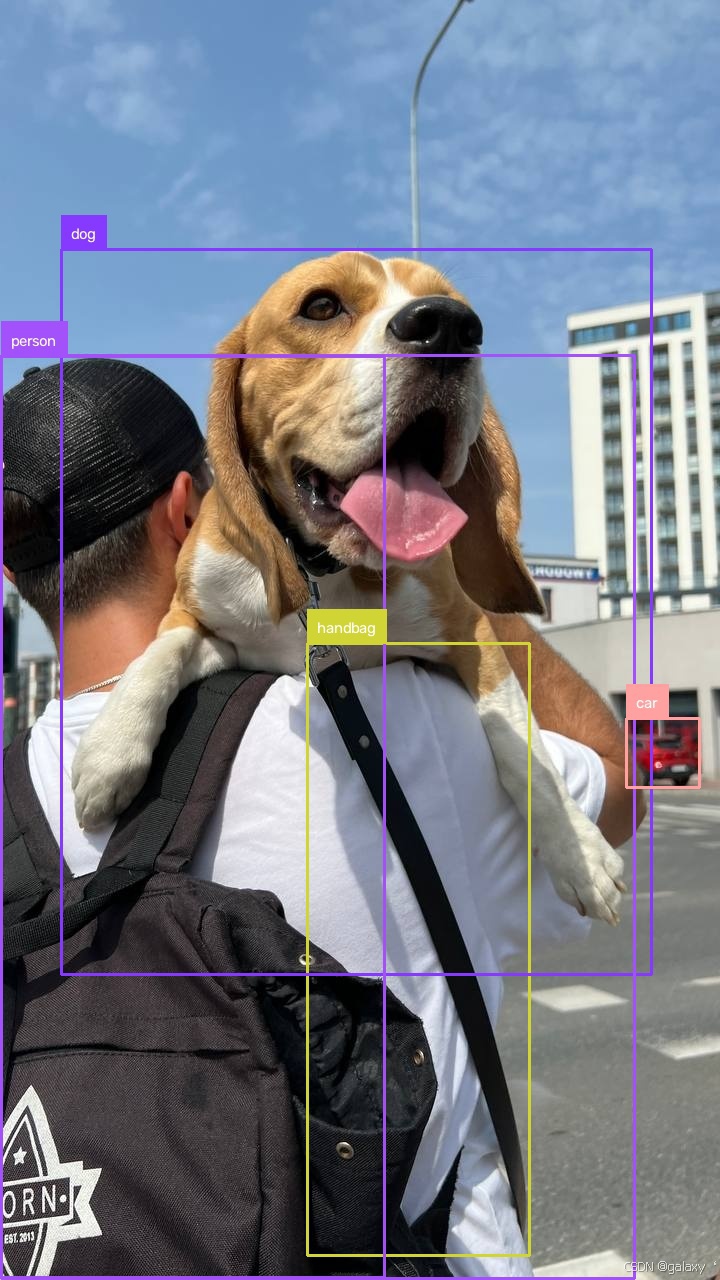
| 测试图片 | 公开测试图 dog.jpeg(街景:人 + 比格犬 + 背包 + 远处车辆) |
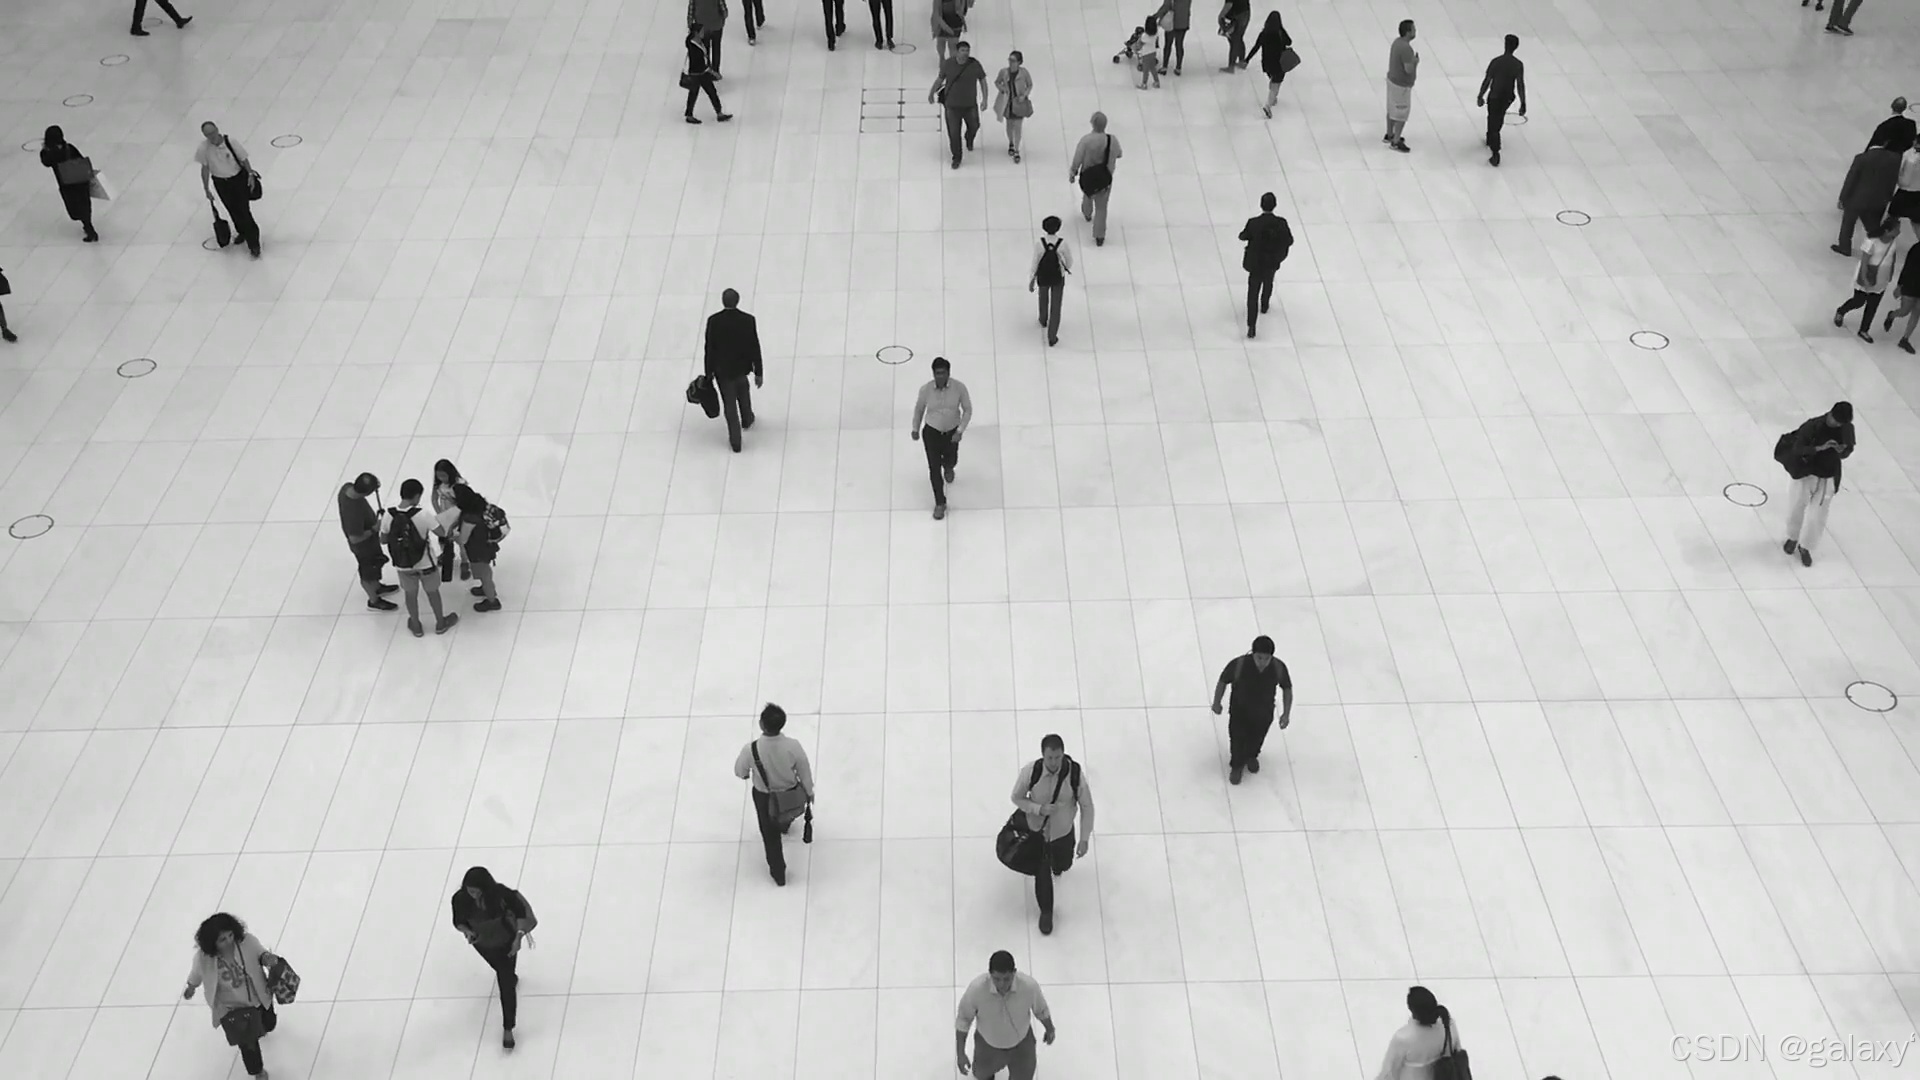
| 测试视频 | 公开行人广场视频 people-walking.mp4(1920×1080,25fps,341 帧) |
| 检测模型 | YOLO11n 目标检测(5.6MB) |
| 检测模型 | RF-DETR Medium(405MB) |
| 分割模型 | RF-DETR Seg Small(135MB) |
python
from supervision.assets import download_assets, VideoAssets

download_assets(VideoAssets.PEOPLE_WALKING)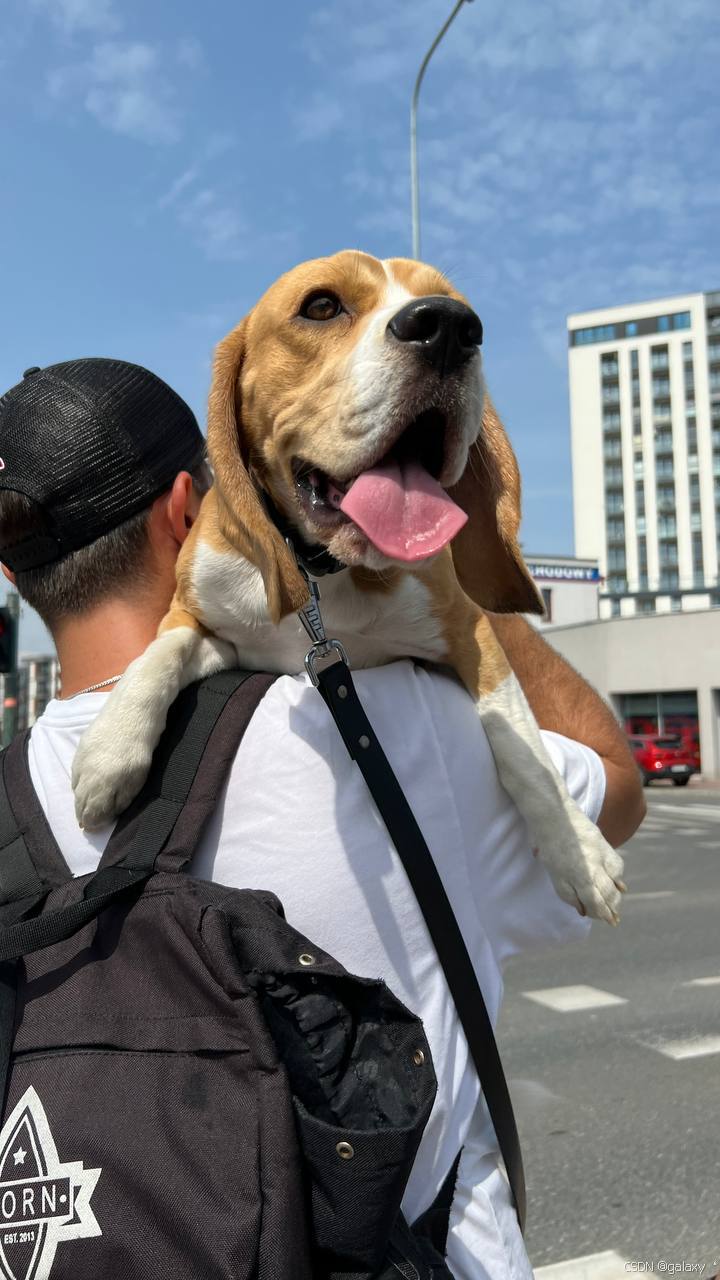
0.4 素材准备:OpenCV 截视频、抽帧与中文路径安全读写
所有实验的素材都从视频里来:截取前 N 秒做轻量测试片段、在指定秒数抽一帧当测试图片。这段 OpenCV 的"看家活"是所有视频分析项目的第一步,值得单独立一节(本教程的素材准备脚本就是按这个写的,全部实测):
python
import cv2
import numpy as np

# ① 读视频属性(部分监控视频帧率读不到,务必做兜底)
cap = cv2.VideoCapture("people-walking.mp4")
fps = cap.get(cv2.CAP_PROP_FPS)
w, h = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH)), int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
total = int(cap.get(cv2.CAP_PROP_FRAME_COUNT))
if fps <= 0 or fps != fps:            # 0 或 NaN 时兜底
    fps = 25.0
duration = total / fps
cap.release()

# ② 截取前 N 秒:逐帧读 + VideoWriter 重编码(视频不足 N 秒则取整段)
fourcc = cv2.VideoWriter_fourcc(*"XVID")
end_frame = int(min(60, duration) * fps)
cap = cv2.VideoCapture("people-walking.mp4")
out = cv2.VideoWriter("前60秒.avi", fourcc, fps, (w, h))
for _ in range(end_frame):
    ret, frame = cap.read()
    if not ret:
        break
    out.write(frame)
cap.release()
out.release()

# ③ 抽取指定秒的一帧:直接 seek 定位,无需逐帧解码
cap = cv2.VideoCapture("people-walking.mp4")
cap.set(cv2.CAP_PROP_POS_FRAMES, int(10 * fps))   # 第 10 秒
ret, frame = cap.read()
cap.release()

# ④ 中文路径安全写盘:OpenCV 5 在 Windows 上 imwrite 对非 ASCII 路径
#    会"静默失败"(不报错但文件没写出来)------编码交给 cv2,写盘交给 Python
ok, buf = cv2.imencode(".jpg", frame)
if ok:
    buf.tofile("素材_第10秒.jpg")

# ⑤ 中文路径安全读图(与 ④ 配套)
img = cv2.imdecode(np.fromfile("素材_第10秒.jpg", dtype=np.uint8), cv2.IMREAD_COLOR)
实测踩坑(贯穿全书) :OpenCV 5.0 在 Windows 上
cv2.imread/cv2.imwrite对中文路径静默失败 ------不抛异常,但读出来是None、写出去的文件不存在。本教程所有读写盘操作统一用 ④⑤ 的imencode + tofile/imdecode + fromfile组合;批量处理就是把 ②③ 套进文件列表循环。这个坑在第六章数据集读写里还会再撞一次。
用到的 OpenCV 方法速查
上面五个片段涉及的方法逐个说明------每个都标了返回值和容易踩的点,可以当速查表用:
| 方法 | 干什么 | 返回值 / 要点 |
|---|---|---|
cv2.VideoCapture(path) |
打开视频文件(或摄像头编号),后续所有读取操作的入口 | 返回捕获对象;用完必须 release(),否则文件句柄一直占着 |
cap.get(propId) |
读视频元数据,propId 用 cv2.CAP_PROP_* 常量指定 |
返回 float。常用四个:CAP_PROP_FPS(帧率)、CAP_PROP_FRAME_WIDTH/HEIGHT(宽高,返回 float 要自己转 int)、CAP_PROP_FRAME_COUNT(总帧数) |
cap.read() |
顺序读下一帧,是逐帧处理视频的基本单位 | 返回 (ret, frame) 元组------ret 是布尔值表示是否成功,frame 是图像数组。必须先判 ret 再用 frame ,读到结尾 ret=False 时 frame 无效 |
cap.set(cv2.CAP_PROP_POS_FRAMES, n) |
跳转到第 n 帧(从 0 起),实现"直接抽第 N 秒" | 比 CAP_PROP_POS_MSEC(按毫秒定位)更精确;seek 后第一次 read() 拿到的就是目标帧 |
cap.release() |
关闭视频、释放解码资源 | 无返回值。VideoCapture 和 VideoWriter 都要调 |
cv2.VideoWriter(path, fourcc, fps, size) |
创建写视频对象,逐帧 write() 拼出新视频 |
size 是 (宽, 高) 元组,必须和写入帧的实际尺寸完全一致,不一致会静默写不出文件;fps 用源视频的值,不然时长会错 |
cv2.VideoWriter_fourcc(*"XVID") |
指定视频编码格式(四个字符的编码代号) | 常用:XVID(通用 avi)、mp4v(mp4)、MJPG。某些编码在某些机器上不可用,写不出文件时优先换编码试 |
cv2.imencode(ext, img) |
把图像数组压缩编码成指定格式的字节流 | 返回 (ok, buf):ok 是否成功,buf 是 uint8 数组(不是图片对象)。ext 带点,如 ".jpg"、".png" |
buf.tofile(path) |
把 imencode 的字节数组写进磁盘文件 |
Python/numpy 层的写盘,路径编码由 Python 处理,中文路径不会静默失败------这就是它存在的意义 |
np.fromfile(path, dtype=np.uint8) |
把整个文件读成一个字节数组(Python 层读盘,同样不吃中文路径的亏) | 返回 uint8 数组,交给 imdecode 解码 |
cv2.imdecode(buf, flag) |
把字节数组解码回图像数组 | flag 用 cv2.IMREAD_COLOR(强制 3 通道 BGR);与 imencode 一对,合起来实现"中文路径安全读图" |
cv2.imread(path) / cv2.imwrite(path, img) |
常规读图/写图(路径纯英文时随便用) | OpenCV 5 + Windows + 非 ASCII 路径会静默失败,全书统一避开,用上面两行组合代替 |
再补两个不在上表里、但理解这段代码必须知道的事:
frame的真身是 numpy 数组 :形状(高, 宽, 3),uint8 类型,通道顺序是 BGR 不是 RGB (OpenCV 的历史惯例)。直接把它喂给模型没问题(各家推理库都按 BGR 收),但想自己plt.imshow预览就会偏色,要先frame[:, :, ::-1]转成 RGB------注意负步长数组不能直接给某些库用,加个.copy()就行(第五章实测踩过)。- "截取前 N 秒"没有现成的一步到位函数 :OpenCV 不提供
cut(start, end),标准做法就是 ② 里那样"算出N × fps帧 → 逐帧read→ 逐帧write"。帧数 = 秒数 × 帧率,这个换算是视频处理里最常用的算术。
第一章 检测与标注(Detect and Annotate)
1.1 例 1(入门推荐先跑):YOLO11 + supervision 检测框
python
import cv2
import supervision as sv
from ultralytics import YOLO

model_path = r"models/yolo11n.pt"
model = YOLO(model_path)                          # ① 加载模型
image = cv2.imread("dog.jpeg")
results = model(image)[0]                         # ② 推理(ultralytics 自己的结果格式)
detections = sv.Detections.from_ultralytics(results)  # ③ 转成 supervision 统一格式 ← 关键一步

box_annotator = sv.BoxAnnotator()
label_annotator = sv.LabelAnnotator()

labels = [
    f"{class_name} {confidence:.2f}"
    for class_name, confidence
    in zip(detections["class_name"], detections.confidence)   # ④ 拼标签文字
]

annotated_image = box_annotator.annotate(scene=image, detections=detections)
annotated_image = label_annotator.annotate(
    scene=annotated_image, detections=detections, labels=labels)  # ⑤ 先画框再贴标签
sv.plot_image(annotated_image)实测结果:
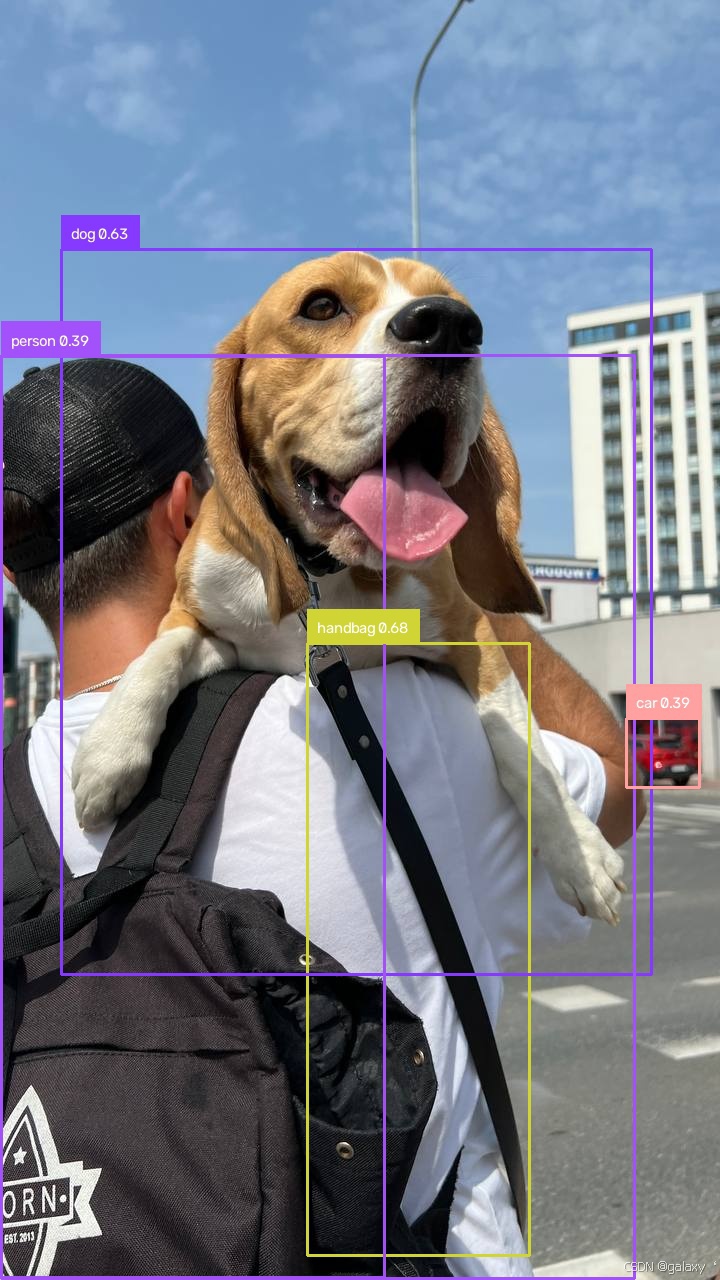
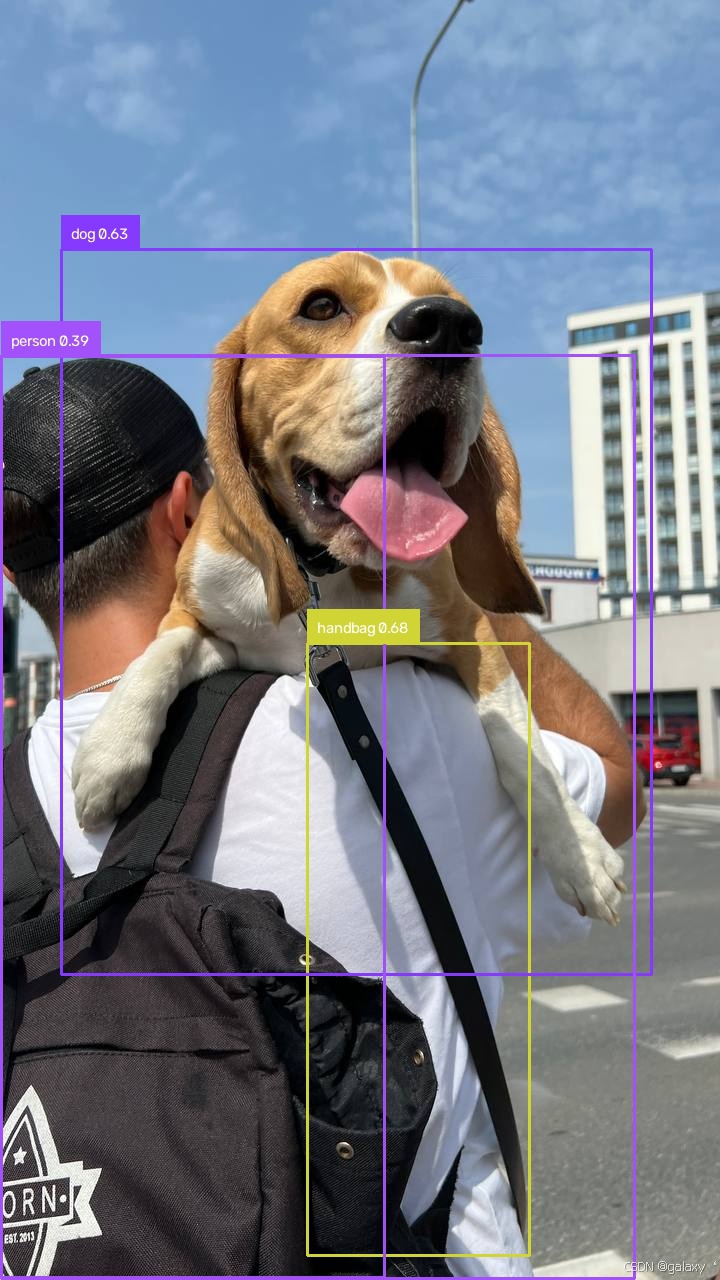
- 检出 5 个目标(dog 0.63 / handbag 0.68 / person / car...),GPU 推理 7ms
- 要点 :③ 是模型无关设计的体现------
from_ultralytics把 ultralytics 的结果翻译成sv.Detections。换成 RF-DETR 时这一步由 rfdetr 内部完成,标注代码完全不变。
1.2 例 2(进阶):RF-DETR 检测框标注
换成精度更高的 RF-DETR Medium。注意两处与 YOLO 的差异:
python
import cv2
import supervision as sv
from rfdetr import RFDETRMedium

model_path = r"models/rf-detr-medium.pth"
model = RFDETRMedium(pretrain_weights=model_path)   # ① 本地权重直接加载

image = cv2.imread("dog.jpeg")
image_rgb = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)  # ② RF-DETR 要求 RGB 输入(关键!)
detections = model.predict(image_rgb)               # ③ 返回的直接就是 sv.Detections

labels = [
    f"{class_name} {confidence:.2f}"
    for class_name, confidence
    in zip(detections["class_name"], detections.confidence)
]

annotated_image = sv.BoxAnnotator().annotate(scene=image, detections=detections)
annotated_image = sv.LabelAnnotator().annotate(
    scene=annotated_image, detections=detections, labels=labels)

cv2.imshow("Result", annotated_image)   # 弹窗显示(交互运行用)
cv2.waitKey(0)
cv2.destroyAllWindows()
# cv2.imwrite("output_dog.jpg", annotated_image) # 或保存文件(服务器/无人值守用)实测结果:
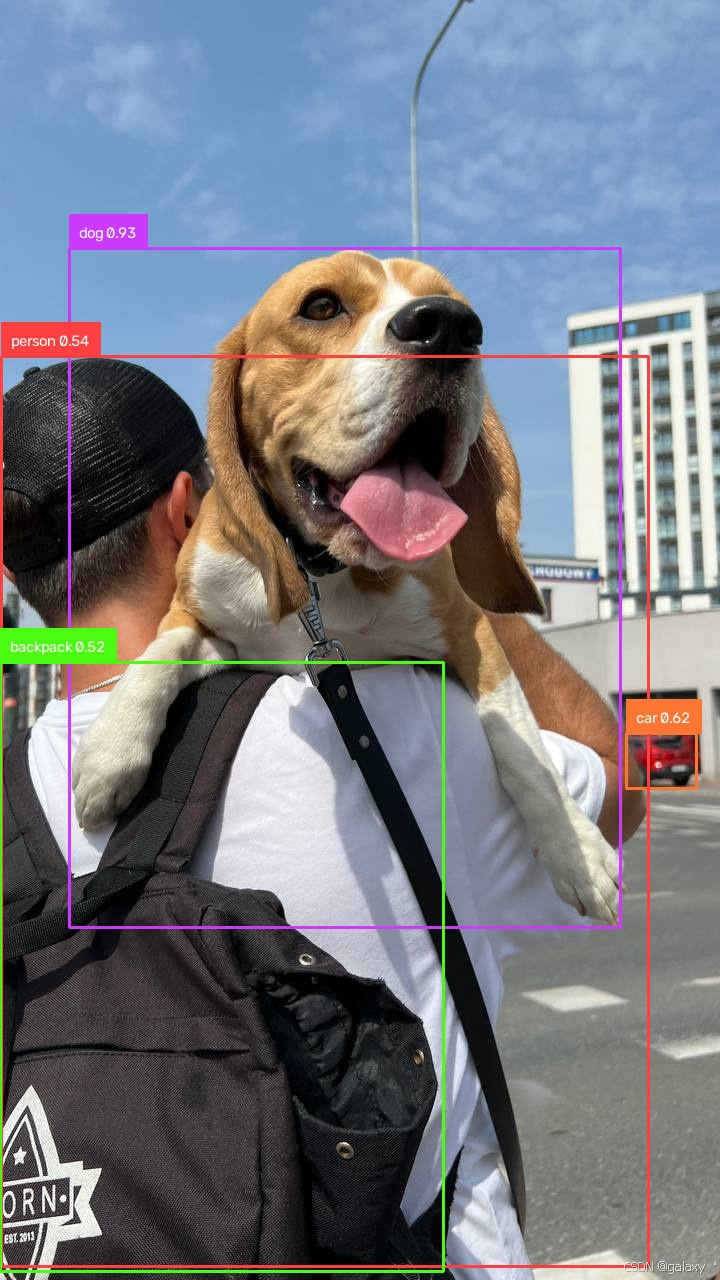
- 检出 4 个目标,框贴合度高于 YOLO11n,误检更少
踩坑提示 ① :OpenCV 读图是 BGR 通道顺序,RF-DETR 内部按 RGB 处理,必须先
cv2.cvtColor(image, cv2.COLOR_BGR2RGB),否则类别混乱、置信度异常。YOLO 无此问题(ultralytics 内部自行处理)。踩坑提示 ② :显示方式的取舍------
cv2.imshow弹窗(本机调试用,服务器无图形界面会报错);cv2.imwrite存文件(无人值守/报警抓拍用);sv.plot_image在 Notebook 中内嵌显示。
1.3 例 3(分割):RF-DETR Seg + 掩码标注
分割模型除检测框外还输出像素级掩码,标注器从 BoxAnnotator 换成 MaskAnnotator,标签位置改到"质心"更贴合掩码形状:
python
import cv2
import supervision as sv
from rfdetr.detr import RFDETRSegSmall

model_path = r"models/rf-detr-seg-small.pt"
model = RFDETRSegSmall(pretrain_weights=model_path)

image = cv2.imread("dog.jpeg")
image_rgb = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
detections = model.predict(image_rgb)

mask_annotator = sv.MaskAnnotator()                          # 掩码填充标注器
label_annotator = sv.LabelAnnotator(
    text_position=sv.Position.CENTER_OF_MASS)                # 标签贴在掩码质心

annotated_image = mask_annotator.annotate(scene=image, detections=detections)
annotated_image = label_annotator.annotate(
    scene=annotated_image, detections=detections)            # 分割任务通常无需手拼 labels
sv.plot_image(annotated_image)实测结果:
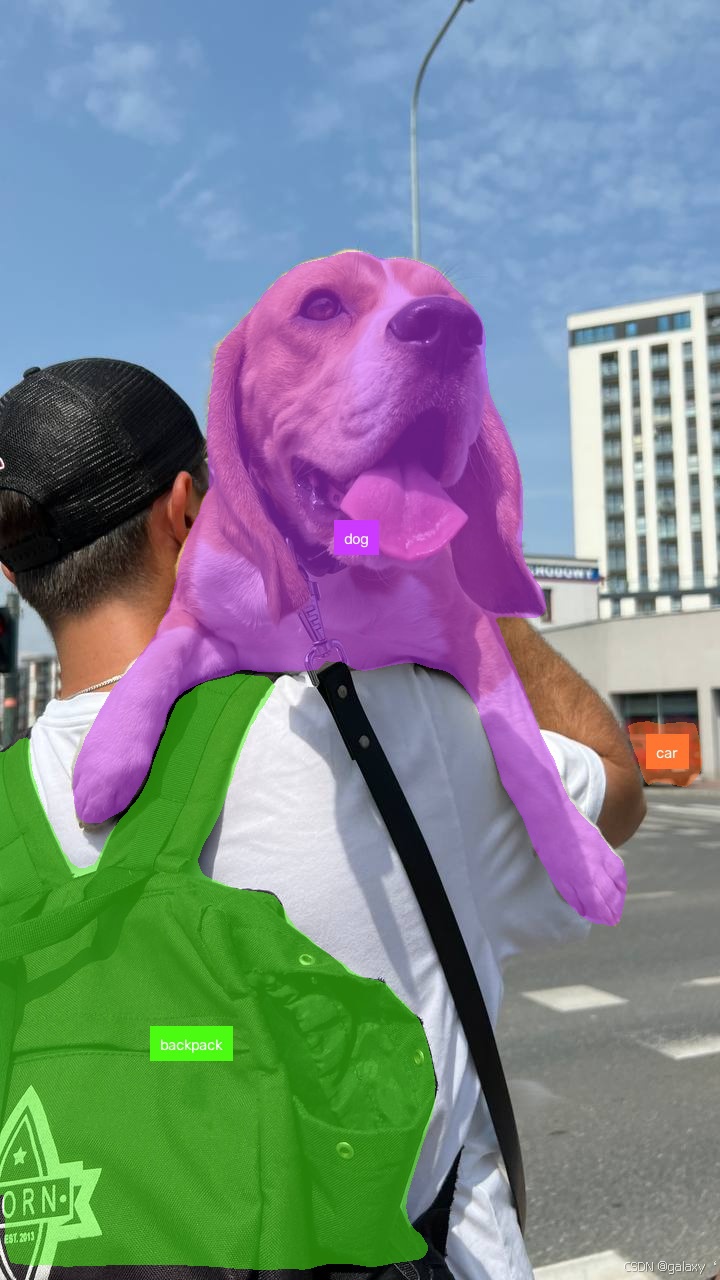
- 检出 3 个目标,掩码沿物体轮廓填充,标签位于质心
检测 vs 分割怎么选:检测框(框住"哪里有东西")计算快、够用于绝大多数报警场景;分割(描出"物体的精确轮廓")适合面积占比统计、贴合度要求高的场景------如泄漏液面积、固废堆放占地面积。
1.4 三个模型实测对比(dog.jpeg,RTX 5060 GPU)
| 模型 | 任务 | 检出目标 | 推理耗时 | 权重体积 |
|---|---|---|---|---|
| YOLO11n | 检测框 | 5 个(dog / person×2 / handbag / car) | 约 7 ms | 5.6 MB |
| RF-DETR Medium | 检测框 | 4 个 | 数十 ms | 405 MB |
| RF-DETR Seg Small | 分割掩码 | 3 个 | 数十 ms | 135 MB |
规律与官方基准一致:YOLO11n 最快最轻,适合边缘盒子大批量视频流;RF-DETR 精度上限更高,适合关键点位或作为精度对比基线。工程上建议用同一套 supervision 标注代码跑双模型对比,这正是模型无关设计的用武之地。
1.5 本章方法速查
本章涉及的模型接口与标注器,逐个说明(supervision 0.30 实测签名):
| 方法 | 干什么 | 关键参数(默认值) | 返回值 / 要点 |
|---|---|---|---|
YOLO(weights) |
加载 ultralytics 检测/姿态模型 | weights:权重路径,本地没有会自动下载 |
model(image) 返回结果列表 ,取 [0] 才是本图的 Results |
sv.Detections.from_ultralytics(results) |
ultralytics 结果 → supervision 统一格式 | results:ultralytics 的 Results 对象 |
模型无关设计的关键转换器;生态里还有 from_inference、from_transformers 等一整套 |
RFDETRMedium / RFDETRSegSmall(pretrain_weights=...) |
加载 RF-DETR 检测/分割模型 | pretrain_weights:权重路径 |
predict 返回的直接就是 sv.Detections,省掉转换一步 |
model.predict(image, threshold=0.5) |
RF-DETR 推理 | threshold:置信度阈值;入参还支持图片路径 / PIL / 批量列表 |
必须喂 RGB :cv2 读图是 BGR,先 cv2.cvtColor(踩坑提示①);YOLO 内部自理,无需转 |
cv2.cvtColor(image, cv2.COLOR_BGR2RGB) |
BGR→RGB 通道转换 | 第二参数传转换代码 cv2.COLOR_BGR2RGB |
OpenCV 的历史惯例是 BGR;给模型喂数据前先确认它要哪种顺序 |
sv.BoxAnnotator() |
画检测框 | thickness(线宽,默认 2)、color(默认调色板按类别自动配色)、color_lookup(上色依据,默认按 class) |
.annotate(scene, detections) 返回画好框的图像;scene 接力传入即可叠加多个标注器 |
sv.LabelAnnotator() |
贴文字标签 | text_position(标签位置,默认 TOP_LEFT)、text_scale(字号,默认 0.5)、text_padding(内边距,默认 10)、smart_position(防标签重叠,默认关) |
.annotate(scene, detections, labels) 的 labels 是与检测数等长的字符串列表 |
sv.MaskAnnotator() |
分割掩码半透明填充 | opacity(填充不透明度,默认 0.5) |
用法与 BoxAnnotator 完全一致,只是画的是色块不是框 |
sv.plot_image(img) |
Notebook 内嵌显示 | size(显示尺寸,默认 (12, 12)) |
展示三选一:plot_image(Notebook)/ cv2.imshow(弹窗,服务器不可用)/ cv2.imwrite(存盘) |
detections["class_name"] / detections.confidence |
字段访问 | --- | .confidence / .class_id / .xyxy 是固定字段;detections["key"] 方括号取的是 data 附加字段(模型自定义信息) |
第二章 存档检测(Save Detections)
解决"存下来给机器用 "------把每一帧的检测结果落成 CSV / JSON 文件,供离线分析与证据留存。
第一章解决"画出来给人看",本章解决"存下来给机器用"------这是工业报警证据链与数据回流的基础。
2.1 Sink 家族:两个"存档器"
| Sink | 输出格式 | 写入时机 | 适用场景 |
|---|---|---|---|
sv.CSVSink |
CSV 表格(每行一个检测目标) | 逐行实时写入磁盘 | 事后统计分析、Excel 打开、喂给报表 |
sv.JSONSink |
JSON 数组(退出时整体落盘) | with 块退出时一次性写入 |
程序间数据交换、结构化证据链 |
两个 Sink 用法完全一致,只是类名不同,核心是三件套:
python
with sv.CSVSink("存档路径.csv") as sink:   # ① with 进入 = 打开存档器
    for ...:
        sink.append(detections, {})        # ② 逐帧追加检测结果
# ③ with 退出 = 自动关闭并保存(JSON 在此刻才写文件)
要点 :
append接收两个参数------第一个是sv.Detections(第一章的统一检测结果),第二个是自定义字段字典 (2.3 节的主角)。不要用open/write/close手工管理文件,上下文管理器会处理一切。
2.2 基础用法:把单图推理改成"视频流 + 存档"
第一章的三段示例都是单张图片 推理;官方文档的标准形态是视频流逐帧 + Sink 存档。把两者接起来只需三处改动:
python
import supervision as sv
from rfdetr import RFDETRMedium

model = RFDETRMedium()                                   # 同第一章例 2
frames_generator = sv.get_video_frames_generator("视频路径.mp4")  # 改动①:图片 → 视频帧生成器

with sv.CSVSink("检测结果.csv") as sink:                  # 改动②:打开存档器
    for frame in frames_generator:
        detections = model.predict(frame[:, :, ::-1])    # 同第一章例 2 的推理
        sink.append(detections, {})                      # 改动③:追加写入存档
其他模型(ultralytics / inference / transformers)同理,只有"得到 detections"那一行不同,存档代码零改动------这就是模型无关设计在存档层的延续。
2.3 Custom Fields:自定义字段(本章核心)
只存"框坐标 + 类别 + 置信度"往往不够------这条记录来自哪个摄像头、第几帧、什么时间 ?append 的第二个字典参数就是干这个的:字典的每个键会成为 CSV 的额外列 / JSON 的额外字段。
python
with sv.CSVSink("检测结果.csv") as sink:
    for frame_index, frame in enumerate(frames_generator):   # enumerate 拿到帧号
        detections = model.predict(frame[:, :, ::-1].copy())
        sink.append(detections, {
            "frame_index": frame_index,      # 帧号
            "second": frame_index / 25,      # 秒级时间戳(帧率 25)
            "camera": "行人广场",           # 业务场景:摄像头点位
        })
自定义字段的内容不限于常量------时间戳、点位名、报警等级、天气......任何每帧可得的业务信息都能挂进去,跟着检测结果一起落盘。
2.4 实测记录:完整存档
本章做了两个实验:
实测 A:RF-DETR Medium × 行人广场视频 → CSV
用行人广场视频(341 帧),stride=10 每 10 帧取 1 帧,RF-DETR Medium 逐帧推理后存 CSV:
python
model = RFDETRMedium(pretrain_weights=r"models/rf-detr-medium.pth")
frames_generator = sv.get_video_frames_generator(VIDEO_PATH, stride=10)  # 隔 10 帧取 1 帧

with sv.CSVSink("第二章例A_视频CSV存档.csv") as sink:
    for frame_index, frame in enumerate(frames_generator):
        frame_rgb = frame[:, :, ::-1].copy()          # ← 踩坑点,见下
        detections = model.predict(frame_rgb, threshold=0.5)
        sink.append(detections, {
            "frame_index": frame_index * 10,               # 原视频真实帧号
            "second": round(frame_index * 10 / 25, 1),     # 在视频中的秒位置
            "camera": "行人广场",
})真实产出(共 480 条检测记录):
csv
x_min,y_min,x_max,y_max,class_id,confidence,tracker_id,camera,class_name,frame_index,second,source_shape
1140.88,949.67,1244.92,1079.78,1,0.880,,行人广场,person,0,0.0,[1080 1920]
749.30,452.60,824.65,624.41,1,0.749,,行人广场,person,0,0.0,[1080 1920]
666.28,649.62,744.53,853.51,1,0.743,,行人广场,person,10,0.4,[1080 1920]
列的来源一目了然:前 7 列是 sv.Detections 自带字段,camera / frame_index / second 是我们传入的自定义字段,class_name / source_shape 是 rfdetr 写进 detections.data 的附加信息------三层字段自动合流成一张表。
⚠️ 实测踩坑 :官方文档示例的 RGB 转换写法
frame[:, :, ::-1],在新版 rfdetr 下会报
ValueError: At least one stride in the given numpy array is negative------切片视图不拷贝内存,负步长数组无法直接转 torch 张量。加
.copy()生成连续内存拷贝即可 :
frame_rgb = frame[:, :, ::-1].copy()(等价写法:
cv2.cvtColor(frame, cv2.COLOR_BGR2RGB))
实测 B:RF-DETR Seg Small × dog.jpeg → JSON
单张图片同样走 Sink 存档(第一章例 3 的分割模型),换 JSONSink:
python
seg_model = RFDETRSegSmall(pretrain_weights=r"models\rf-detr-seg-small.pt")
image_rgb = cv2.cvtColor(cv2.imread("dog.jpeg"), cv2.COLOR_BGR2RGB)
detections = seg_model.predict(image_rgb, threshold=0.5)

with sv.JSONSink("第二章例B_图片JSON存档.json") as sink:
sink.append(detections, {"source": "dog.jpeg", "scene": "通用测试图"})真实产出:
json
[
    {
        "x_min": 69.54, "y_min": 248.45, "x_max": 640.79, "y_max": 933.67,
        "class_id": 18, "confidence": 0.8396,
        "class_name": "dog",
        "source": "dog.jpeg",
        "scene": "通用测试图"
    },
    ...
]
2.5 进阶技巧:过滤后再存档
原始检测结果全存会很"吵"------低置信度的误检没价值。在 append 前先过滤,Sink 只收干净数据:
python
# 只存高置信度目标
sink.append(detections[detections.confidence > 0.7], custom)

# 只存指定类别(例如只关注 person,class_id=1)
sink.append(detections[detections.class_id == 1], custom)

# 组合:高置信度 + 指定类别
mask = (detections.confidence > 0.7) & (detections.class_id == 1)
sink.append(detections[mask], custom)
注意 detections 支持布尔掩码索引,语法与 numpy 一致------过滤发生在内存里,不影响模型推理。
2.6 注意事项(官方 FAQ 要点 + 实测补充)
- JSON 是"退出时整体落盘" :
with块结束那一刻才写文件------程序中途被强杀,JSON 会是空的;CSV 则是逐行实时写,中途退出已有数据安全。 detections.data里的字段自动进表 :模型附加信息(如class_name、source_shape)无需手动传,会自动出现在 CSV 列 / JSON 字段里。- 每帧 append 一次:一帧有多个目标时,CSV 会写多行(每目标一行),共享同一组自定义字段。
- 视频帧率自己记录 :supervision 不自动存时间戳,秒级时间需要自己算(帧号 ÷ 帧率)并作为自定义字段传入------
sv.VideoInfo可读视频帧率。 - 空 detections 也可以 append:某帧无目标时 append 空结果只写自定义字段行(CSV)或不产生记录,不会报错。
2.7 本章方法速查
| 方法 | 干什么 | 关键参数(默认值) | 返回值 / 要点 |
|---|---|---|---|
sv.get_video_frames_generator(source_path, stride=1, start=0, end=None) |
把视频变成"帧的生成器" | stride(每 n 帧取 1 帧)、start / end(起止帧号------截取指定片段不用手写循环,直接传这两个参数) |
逐帧产出 np.ndarray,配合 for frame in ... 使用 |
sv.CSVSink(file_name) |
CSV 存档器 | file_name:输出路径(默认 output.csv) |
配 with 使用;逐行实时落盘,中途退出已有数据安全。⚠️ 实测默认 UTF-8 无 BOM,Excel 直接打开中文乱码,需转 utf-8-sig |
sink.append(detections, custom_data=None) |
追加一条检测记录 | custom_data:自定义字段字典(默认 None) |
第一参数 sv.Detections------字典的每个键自动成为额外列/字段;一帧多目标写多行、共享同一组自定义字段 |
sv.JSONSink(file_name) |
JSON 存档器 | file_name:输出路径 |
with 退出那一刻才整体写盘,程序被强杀会得到空文件(2.7 注意①) |
detections.data |
模型附加信息容器 | --- | rfdetr 写入的 class_name / source_shape 等无需手动传,自动合流进 CSV 列 / JSON 字段 |
detections[mask] |
存档前先过滤 | --- | 与第三章同一套布尔掩码语法,append 前滤掉低置信度/无关类别,Sink 只收干净数据 |
sv.VideoInfo.from_video_path(video_path) |
读视频元信息 | video_path:视频路径 |
返回含 fps / width / height / total_frames 的对象;supervision 不自动存时间戳,秒级时间自己算(帧号 ÷ 帧率)作为自定义字段传入 |
第三章 滤波器检测(Filter Detections)
解决"检测结果太吵"的问题------模型给出的框并非都有价值:低置信度的误检、无关类别、画面边缘的小目标、区域外的无关目标。本章把"该看的留下,不该看的滤掉"。本章实测基于 YOLO11n × dog.jpeg,全部跑通。
3.1 统一语法:布尔掩码索引
本章所有过滤方式共用同一个语法------detections[布尔掩码],与 numpy 完全一致:
python
detections = sv.Detections(...)
mask = ...                                       # 任意方式构造的 True/False 数组
detections = detections[mask] # True 的保留,False 的滤掉confidence、class_id、area、zone.trigger() 的返回值都是掩码,且可以用 &(与)、|(或)自由组合------这是 sv.Detections 设计上最大的优点:过滤发生在内存里,语法统一,模型无关。
3.2 按类别过滤
python
# 单个类别:只保留 person(YOLO 的 class_id=0)
persons = detections[detections.class_id == 0]

# 一组类别:保留 person + dog(class_id 0 和 16)
selected_classes = [0, 16]
subset = detections[np.isin(detections.class_id, selected_classes)]实测(5 个目标:person×2 / dog / handbag / car):单类过滤 5 → 2,类集合过滤 5 → 3。
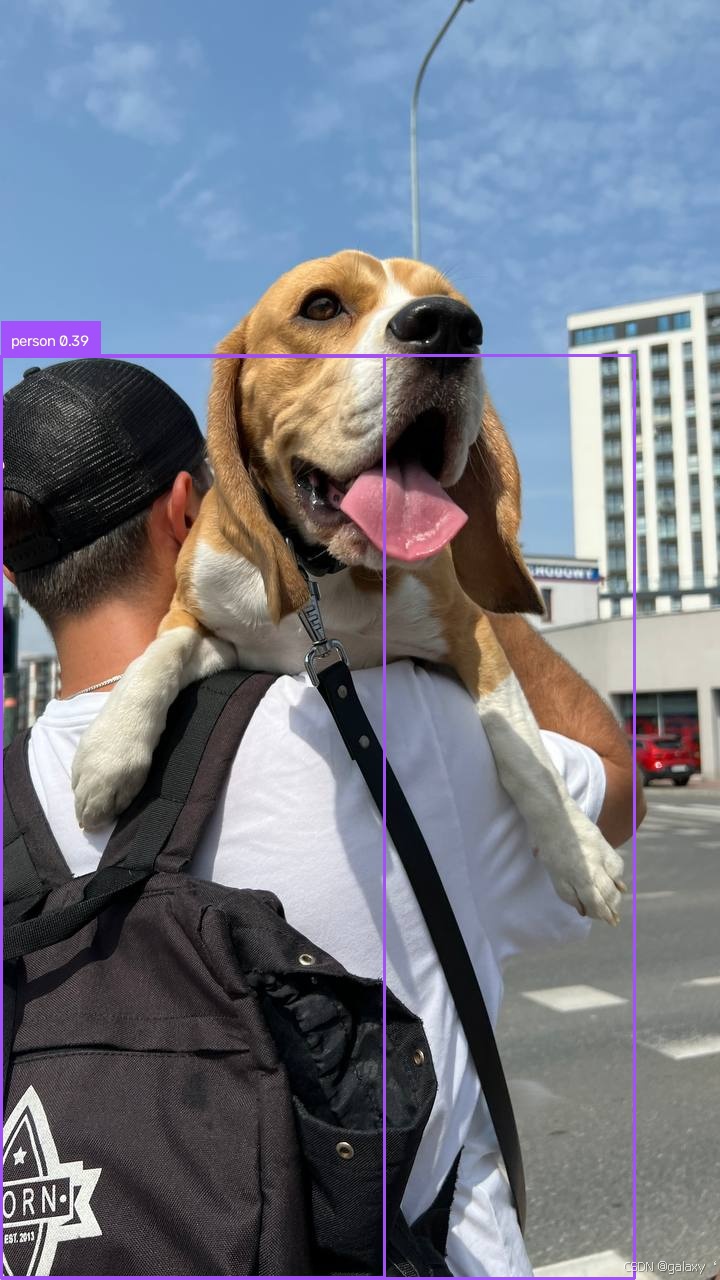
3.3 按置信度过滤
python
confident = detections[detections.confidence > 0.5]实测 :5 → 3(person 0.39、car 0.39 被滤掉)。注意置信度阈值与模型推理参数 conf 的区别:推理阈值决定"模型报多少",过滤掩码决定"业务用多少"------两者可以不同,业务侧的阈值可以随时调整而不必重新推理。
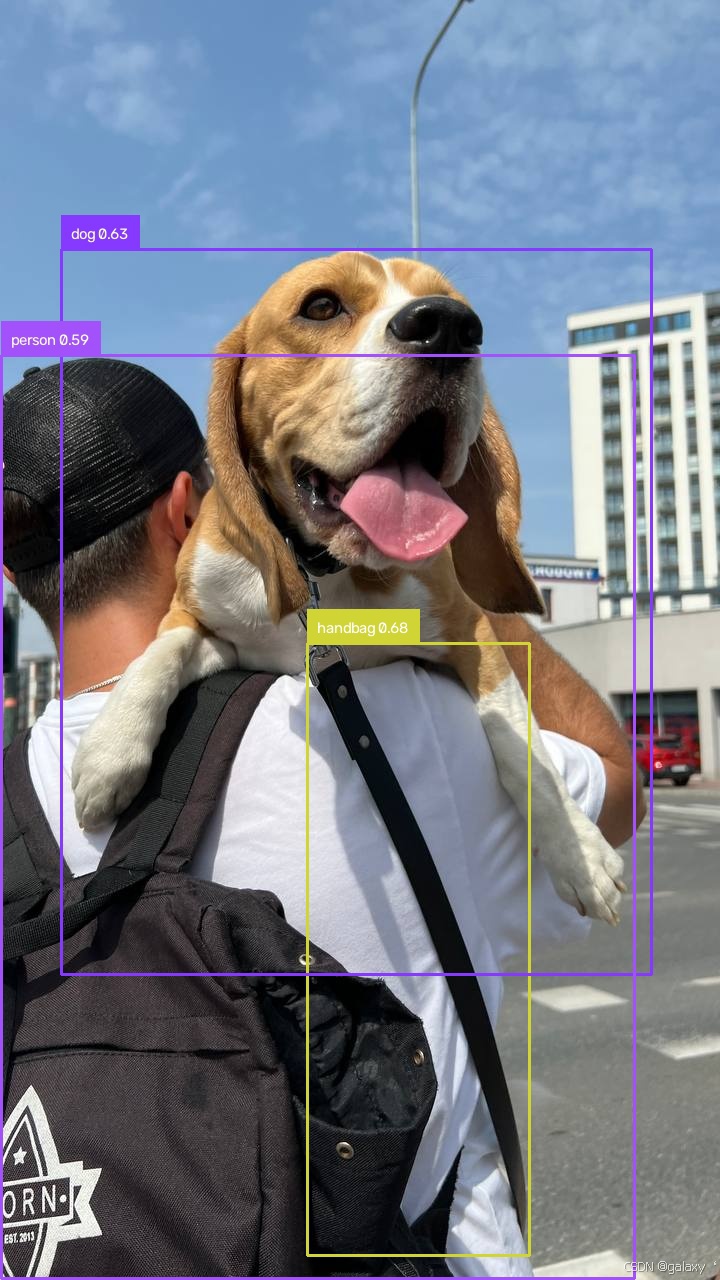
3.4 按面积过滤(三种口径)
python
# ① 像素面积:剔除过小的目标
big_only = detections[detections.area > 20000]

# ② 相对面积:按占全图比例过滤(适配不同分辨率------同一像素面积在
#    1280×720 与 3840×2160 画面里意义完全不同)
not_huge = detections[(detections.area / image_area) < 0.8]

# ③ 框尺寸:宽高分别设卡(需要从 xyxy 自算宽高)
box_w = detections.xyxy[:, 2] - detections.xyxy[:, 0]
box_h = detections.xyxy[:, 3] - detections.xyxy[:, 1]
sized = detections[(box_w > 100) & (box_h > 100)]实测(图片 720×1280):① 5 → 4(滤掉远处 car,仅 5106 px²);② 5 → 5(无目标超过 80% 画面);③ 5 → 4(滤掉 car:宽 74px 不达标)。
工业现场体会:监控画面里"远处的行人/车辆"既小又常误检,用面积过滤一刀切掉是最廉价有效的误报抑制手段------比换大模型划算得多。
3.5 按区域过滤(PolygonZone 电子围栏)
用多边形圈定"关注区域",只保留锚点落在区内的目标:
python
import numpy as np
import supervision as sv

# 多边形:图片右下象限(模拟"只关注通道出口区域")
zone_polygon = np.array([[w//2, h//2], [w, h//2], [w, h], [w//2, h]])
zone = sv.PolygonZone(zone_polygon, triggering_anchors=[sv.Position.CENTER])

in_zone = zone.trigger(detections=detections)    # 返回布尔掩码
zone_hits = detections[in_zone] # 语法与前面完全一致实测:5 → 2(handbag + car 落在右下象限)。区域可视化(黄色半透明多边形,右下角数字"2"是区内目标计数):
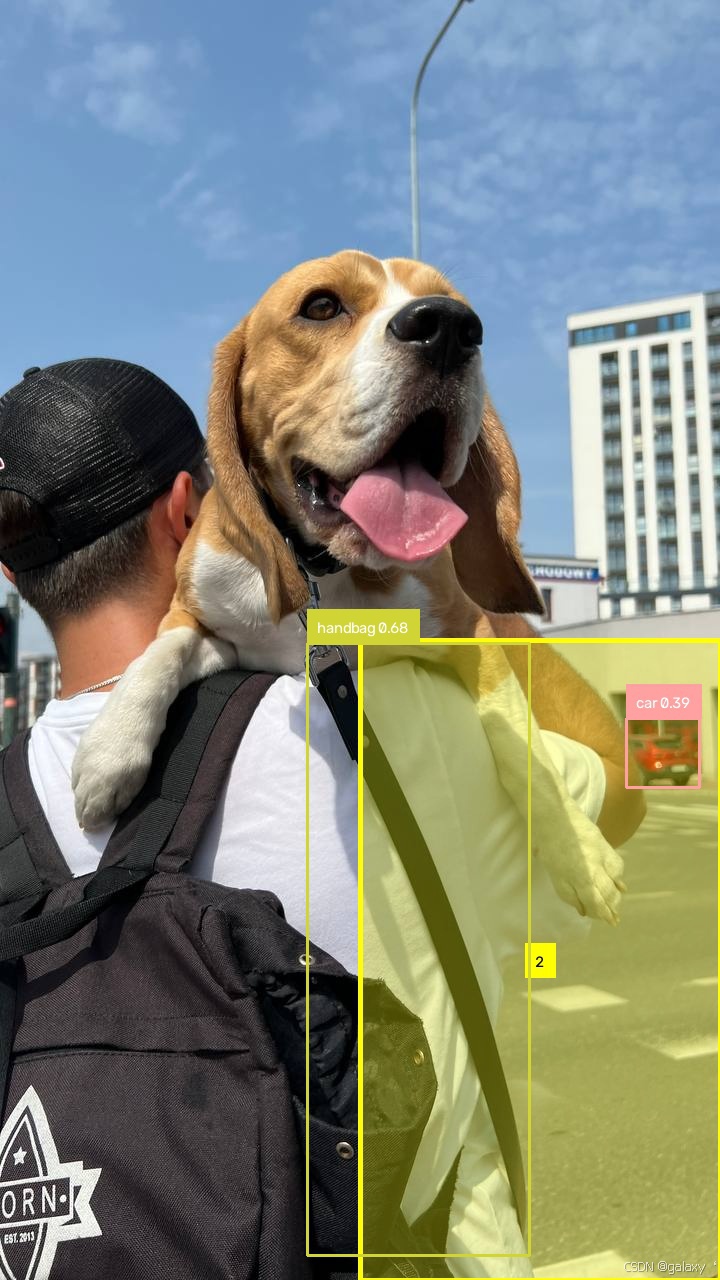
⚠️ 实测踩坑(0.30 版 API):
PolygonZone的默认锚点是 BOTTOM_CENTER(框底边中点) ,不是直觉上的中心------本脚本首跑"下半区域"过滤时 5→5 毫无变化,就是因为所有框的底边都在区域内。判断"目标是否在区域内"到底看框的哪个部位,必须显式指定:triggering_anchors=[sv.Position.CENTER]。PolygonZoneAnnotator新签名必须先构造 zone 对象再传入 :sv.PolygonZoneAnnotator(zone=zone, color=..., opacity=...),然后.annotate(scene=image)------不再接收 polygon 参数。- 多边形顶点按顺时针或逆时针给出均可(4 个以上顶点就是任意形状围栏)。
3.6 混合条件:& 与 | 组合
各路掩码可以直接做逻辑运算,构造任意复杂的业务规则:
python
# 高置信度 且 在区域内
combo = detections[(detections.confidence > 0.5) & in_zone]

# 或:person 或 dog
is_target = np.isin(detections.class_id, [0, 16])
subset = detections[is_target]
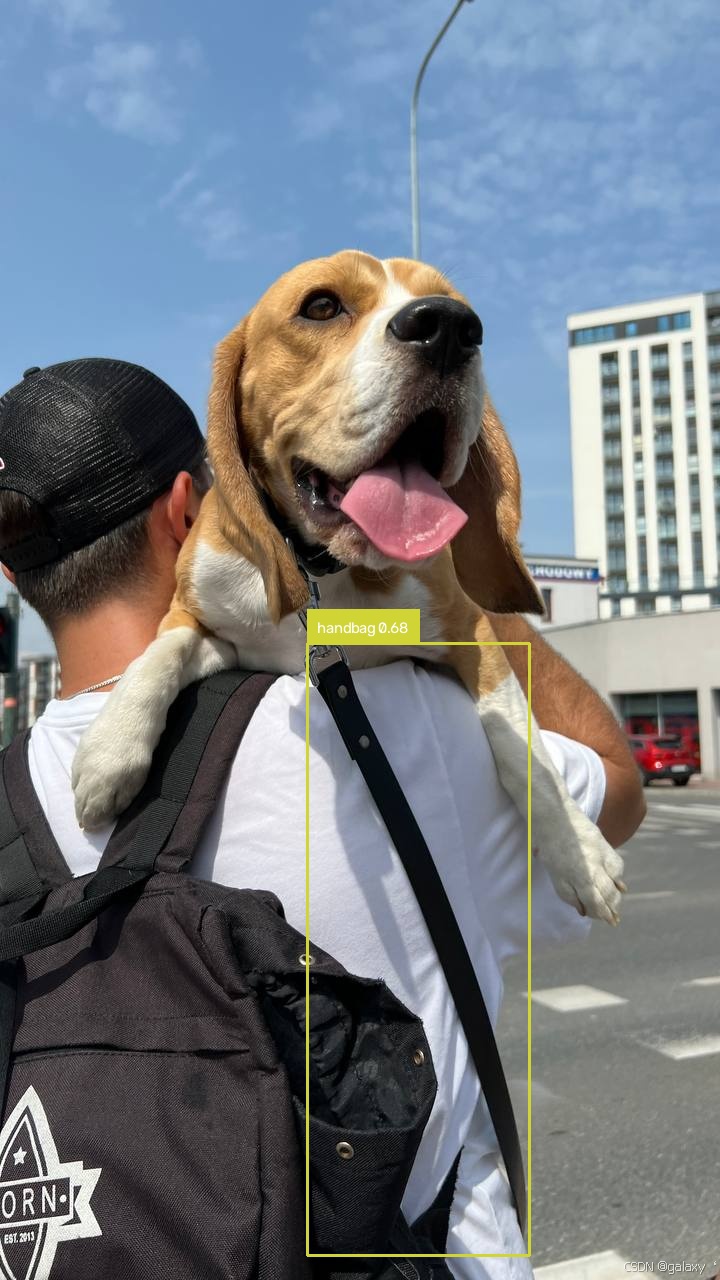
实测 :confidence>0.5 且 在右下区域 → 5 → 1(只剩 handbag 0.68)。
3.7 NMS 去重(官方 FAQ 补充)
同一目标出现重叠框时,用内置 NMS(非极大值抑制)去重:
python
deduped = detections.with_nms(threshold=0.5) # IoU 超过 0.5 的重叠框只留最高分实测:5 → 4(重叠的两个 person 框合并为一个)。
3.8 七种过滤实测汇总
| 过滤方式 | 写法 | 实测(5 目标基线) |
|---|---|---|
| 单类别 | detections[detections.class_id == 0] |
5 → 2 |
| 类别集合 | detections[np.isin(detections.class_id, [0, 16])] |
5 → 3 |
| 置信度 | detections[detections.confidence > 0.5] |
5 → 3 |
| 像素面积 | detections[detections.area > 20000] |
5 → 4 |
| 相对面积 | detections[(detections.area / image_area) < 0.8] |
5 → 5 |
| 框尺寸 | detections[(w > 100) & (h > 100)] |
5 → 4 |
| 区域围栏 | detections[zone.trigger(detections=detections)] |
5 → 2 |
| 混合条件 | (conf > 0.5) & in_zone |
5 → 1 |
| NMS 去重 | detections.with_nms(threshold=0.5) |
5 → 4 |
3.9 本章方法速查
| 方法 | 干什么 | 关键参数(默认值) | 返回值 / 要点 |
|---|---|---|---|
detections[mask] |
布尔掩码索引------本章一切过滤的语法基座 | mask:任意方式构造的布尔数组 |
与 numpy 完全一致;True 保留 False 滤掉,掩码之间可 &(与)` |
detections.confidence / class_id / area / xyxy |
四个最常用字段 | --- | area 是框像素面积(自动算好);xyxy 是 (N,4) 数组,宽高要自算 x2-x1 / y2-y1(3.4 口径③) |
np.isin(detections.class_id, [0, 16]) |
类别集合判断 | 第二参数:类别 id 列表 | 返回布尔数组,用于"保留一组类别";单类别用 == 即可 |
sv.PolygonZone(polygon, triggering_anchors=(BOTTOM_CENTER,), require_all_anchors=True) |
电子围栏(多边形区域) | triggering_anchors(⚠️ 默认框底边中点 不是中心,口径必须显式指定);require_all_anchors(默认 True:所有锚点都落区内才算目标在区内,设 False 是"任一锚点落入即算") |
.trigger(detections) 返回布尔掩码,直接接 detections[mask];视频里每帧调一次就是第八章的实时计数 |
sv.PolygonZoneAnnotator(zone, color=白, thickness=2, text_scale=0.5, display_in_zone_count=True, opacity=0) |
区域可视化 | zone:先构造好的 PolygonZone 对象(⚠️ 0.30 新签名,不再收 polygon);display_in_zone_count(角落计数数字开关,默认开);opacity(多边形填充不透明度,默认 0 即只画轮廓不填充) |
.annotate(scene=image) 返回画好区域轮廓与计数的图 |
detections.with_nms(threshold=0.5, class_agnostic=False) |
重叠框去重(NMS) | threshold(IoU 阈值,默认 0.5);class_agnostic(默认 False 按类别分桶去重------两个模型合并去重同一目标时要设 True 跨类别比较) |
返回去重后的新 sv.Detections,IoU 超阈值的重叠框只留置信度最高的一个 |
第四章 探测小物体(Detect Small Objects)
解决"远处的小目标检不出来 "------监控画面里远处的行人、叉车、小件物料,整图推理时只有几百个像素,模型很容易漏检。
素材:行人广场视频第 10 秒截图(1920×1080,远处行人即典型小目标),全部实测。
4.1 为什么小目标难检:输入缩放是罪魁祸首
检测模型(YOLO / RF-DETR)把输入图缩放到固定尺寸再推理(如 YOLO 的 640×384)。1920×1080 的监控图缩到 640 宽后,一个 30×30 像素的远处行人只剩 10×10 像素------特征几乎被抹平,漏检是必然。
官方给出两条路:
- 提高输入分辨率:简单有效,但推理变慢、显存翻倍,对 4K 超清图收效有限;
- 切片推理(Sliced Inference) :把大图切成带重叠的小图块,逐块推理后合并结果------小目标在图块里的相对尺寸变大,检出率显著提升。本章主角
sv.InferenceSlicer就是这个思想的官方实现(即经典 SAHI 库的思路)。
4.2 第一步永远是跑基线:整图推理
官方教程的方法论:先跑一次原生分辨率基线,看清模型到底漏了多少,再上切片。
python
yolo = YOLO("models/yolo11n.pt")
result = yolo(image, conf=0.25)[0]
detections = sv.Detections.from_ultralytics(result)     # YOLO 路径

rfdetr = RFDETRMedium(pretrain_weights="models/rf-detr-medium.pth")
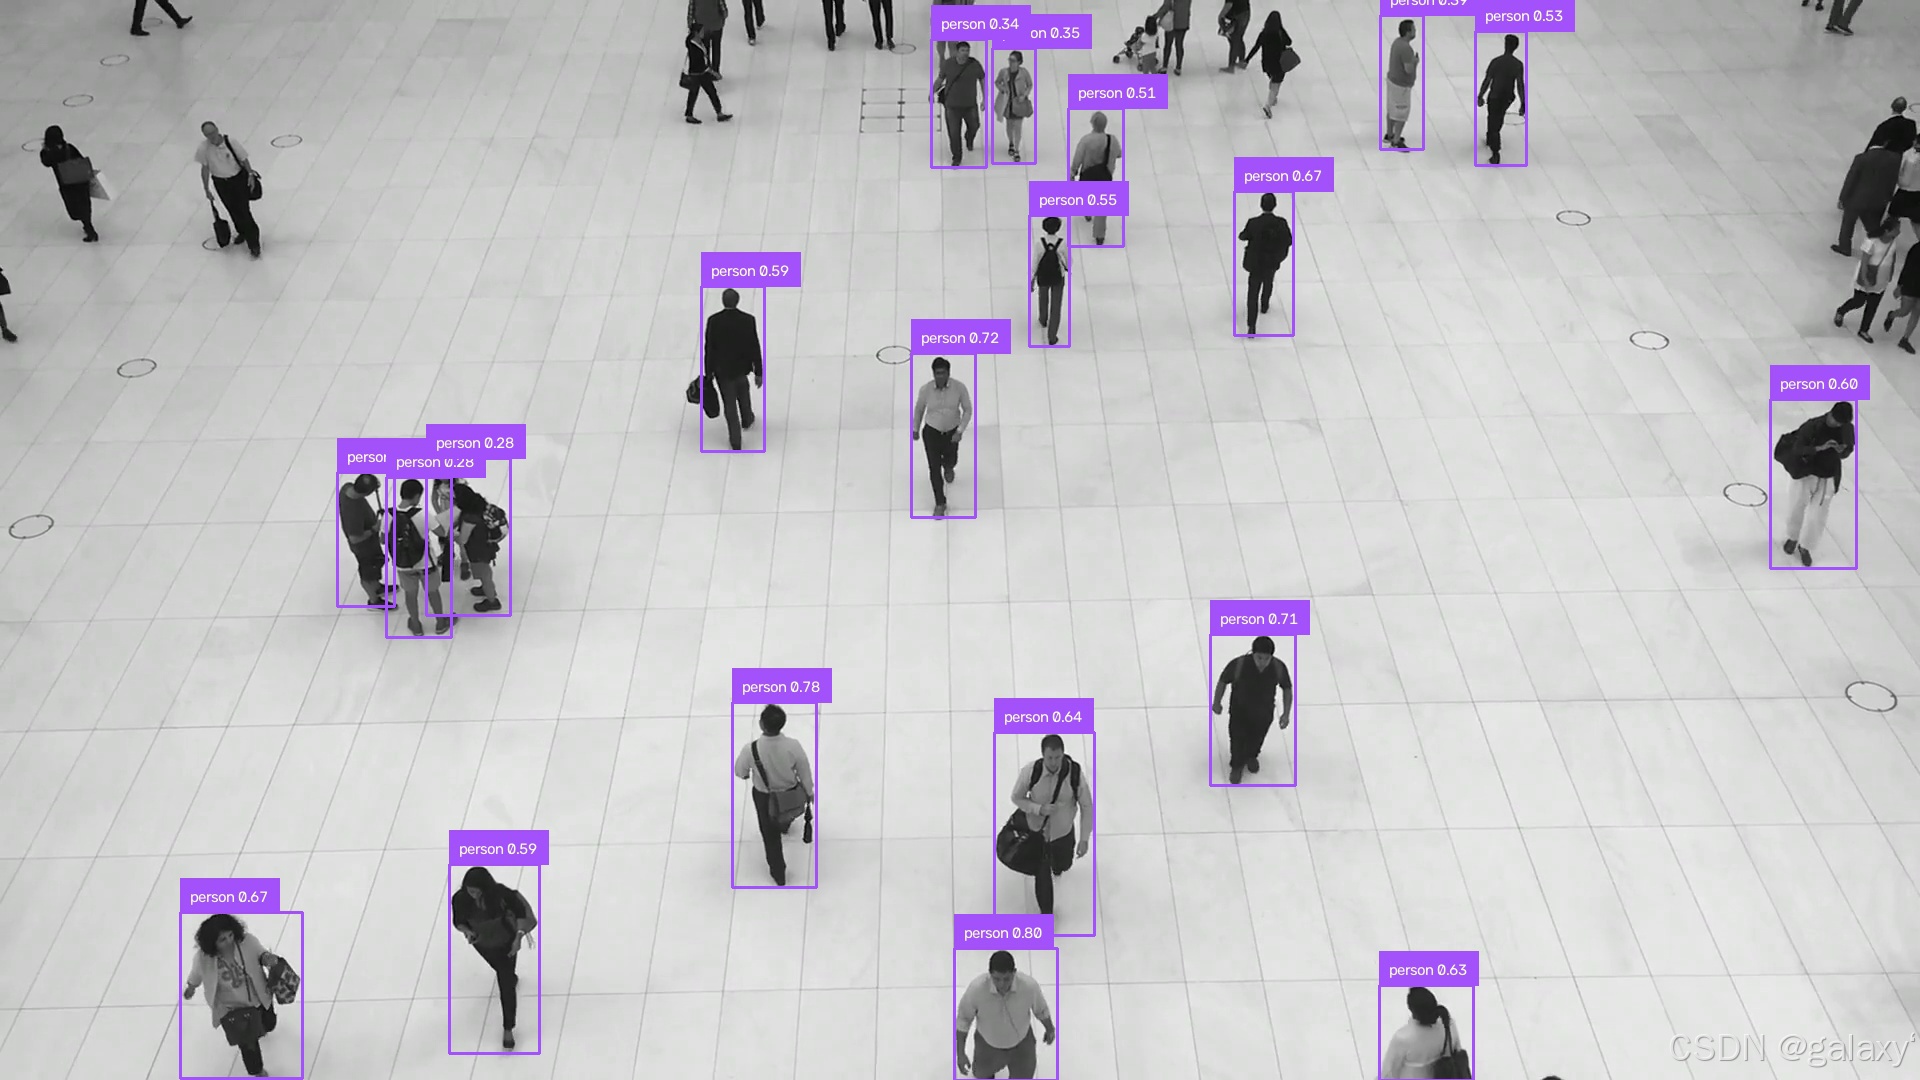
detections = rfdetr.predict(cv2.cvtColor(image, cv2.COLOR_BGR2RGB), threshold=0.5) # RF-DETR 路径实测(1920×1080 行人广场图):YOLO11n 检出 20 个(最小 4936 px²);RF-DETR 检出 16 个(最小 2609 px²)------画面上半部远处的行人成片漏检。
4.3 切片推理:sv.InferenceSlicer 三步走
python
import numpy as np
import supervision as sv

def callback(image_slice: np.ndarray) -> sv.Detections:
    result = yolo(image_slice, conf=0.25, verbose=False)[0]
    return sv.Detections.from_ultralytics(result)       # 任意模型,只要返回 sv.Detections

slicer = sv.InferenceSlicer(callback=callback, slice_wh=640, overlap_wh=150)
detections = slicer(image)                              # 切片 → 逐块推理 → 合并,一步到位
工作原理与关键参数(supervision 0.30 实测签名):
| 参数 | 默认值 | 说明 |
|---|---|---|
callback |
必填 | 接收一个图块(np.ndarray),返回 sv.Detections |
slice_wh |
640 | 图块尺寸(像素),也可写 (640, 640) |
overlap_wh |
100 | 图块重叠像素(非百分比)。目标常被切在边界时调大,追求速度时调小 |
overlap_filter |
NON_MAX_SUPPRESSION |
跨块重复框的合并策略(⚠️ 旧文档写的 overlap_filter_strategy 已更名) |
iou_threshold |
0.5 | NMS 合并的 IoU 阈值 |
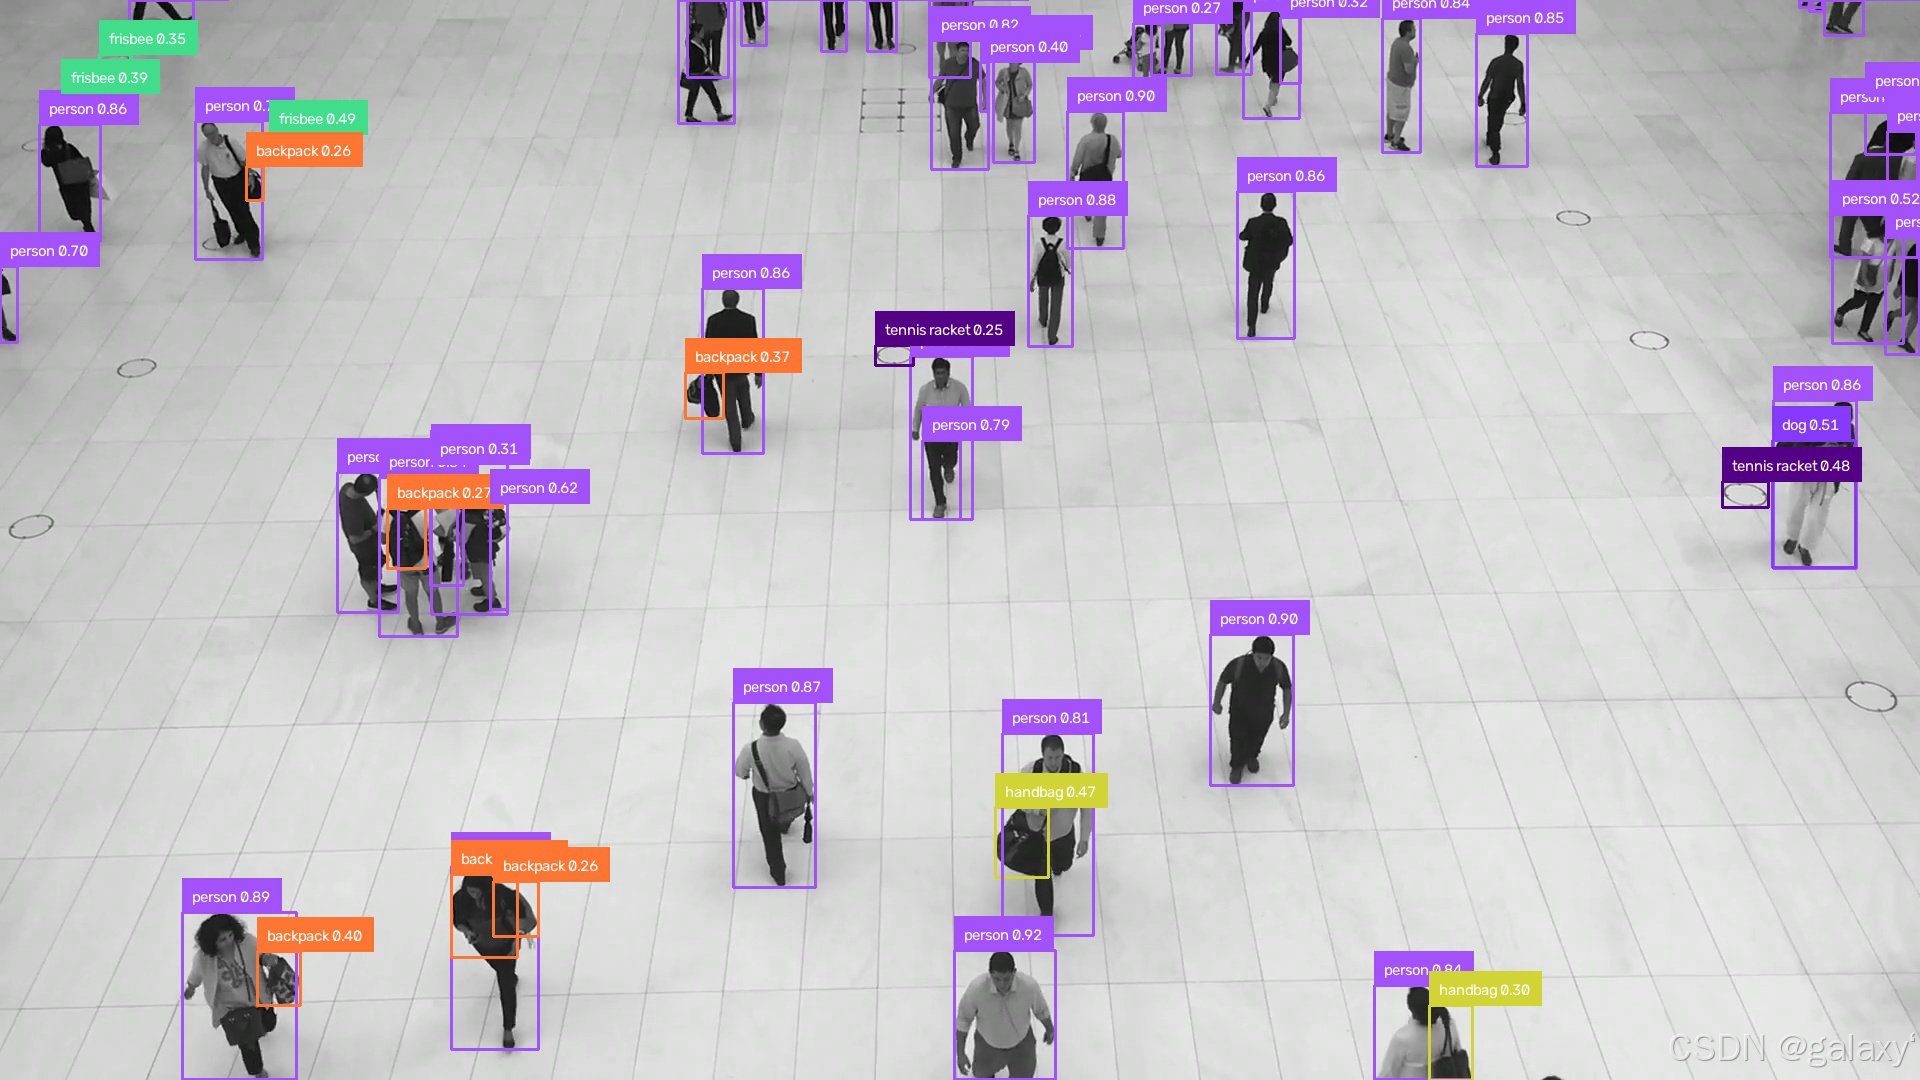
实测 (YOLO11n):检出 20 → 61 个 ,最小检出面积 4936 → 164 px²------面积缩小 30 倍的远处行人都能稳定检出。
4.4 RF-DETR 接入 Slicer:一个必然踩的坑
RF-DETR 的 callback 不能照抄官方文档示例------直接 return model.predict(...) 会崩溃:
python
def rfdetr_callback(image_slice: np.ndarray) -> sv.Detections:
    dets = rfdetr.predict(image_slice[:, :, ::-1].copy(), threshold=0.5)
    # ⚠️ 必须只保留核心三件套(原因见下)
    return sv.Detections(
        xyxy=dets.xyxy, confidence=dets.confidence, class_id=dets.class_id)

slicer = sv.InferenceSlicer(callback=rfdetr_callback, slice_wh=640, overlap_wh=150)
detections = slicer(image)
labels = [f"{names[c]} {cf:.2f}" for c, cf in
          zip(detections.class_id, detections.confidence)]   # COCO 类别名后拼
⚠️ 实测踩坑:
Conflicting metadata for key: 'source_image'rfdetr 会把切片原图(
source_image)、类别名(class_name)等塞进detections.data,而InferenceSlicer合并各切片时要求所有切片的 data 键值完全一致 ------每片的原图和类别名必然不同,直接返回必崩。解决:callback 里只保留
xyxy / confidence / class_id,类别名在切片完成后用 COCO 表拼(RF-DETR 与 YOLO 同为 COCO 80 类,names表可复用)。顺带复习第二章踩坑点:
image_slice[:, :, ::-1]是负步长视图,需要.copy()。
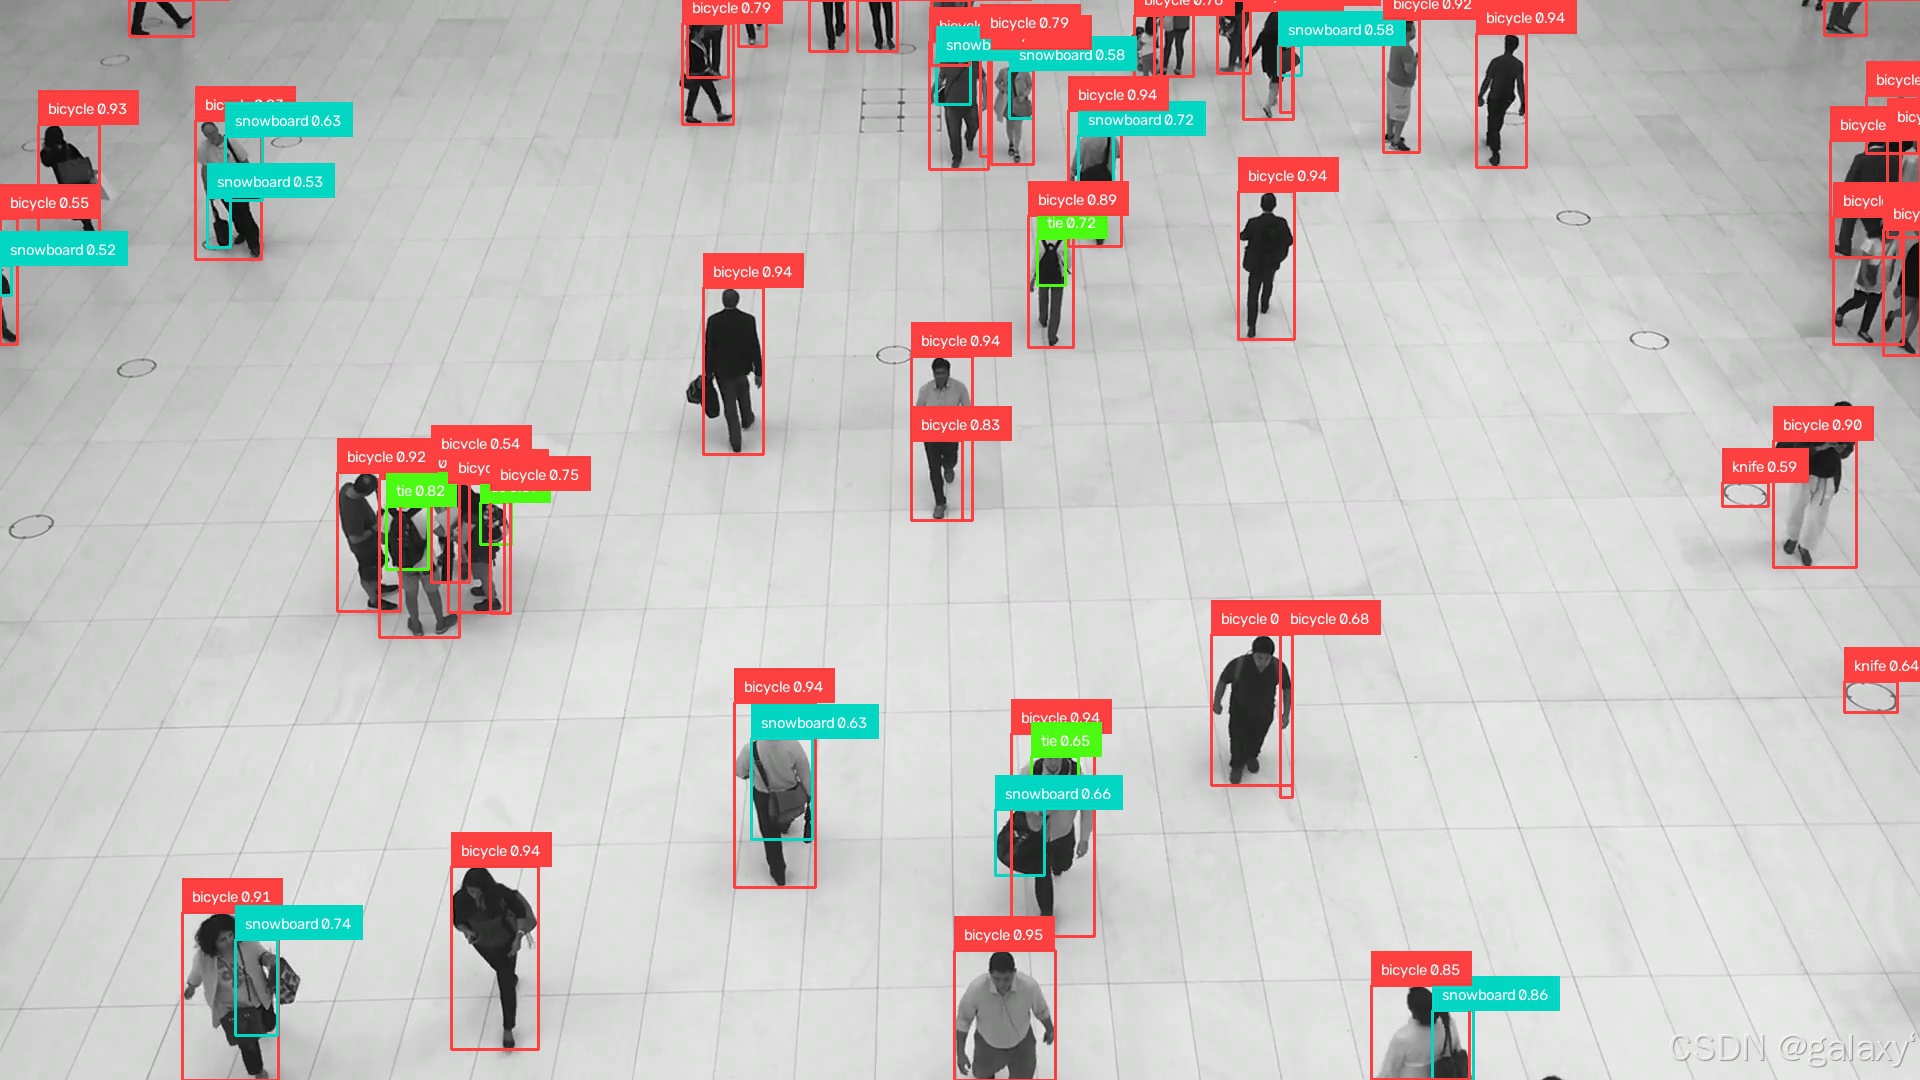
实测:RF-DETR 检出 16 → 63 个。
4.5 实测汇总(1920×1080 行人广场图,RTX 5060 GPU)
| 配置 | 检出数 | 小目标(<1% 画面) | 最小面积 | 耗时 |
|---|---|---|---|---|
| YOLO11n 整图 | 20 | 20 | 4936 px² | 0.14s |
| YOLO11n 切片 | 61 | 61 | 164 px² | 0.11s |
| RF-DETR 整图 | 16 | 16 | 2609 px² | 0.03s |
| RF-DETR 切片 | 63 | 63 | 351 px² | 0.38s |
切片的代价也要看清 (实测中就有现成案例):切片版多检出一批 0.25~0.35 置信度的 frisbee / tennis racket / tie 误检框------切片提升小目标召回的同时,也会放进更多低分误检。所以第四章必须和第三章连用:切片推理(提召回)→ 置信度/面积过滤(压误报),一开一收才是完整链路。
4.6 调参指南
| 场景 | 调整 |
|---|---|
| 目标还是漏 | 调小 slice_wh(如 480);或提高重叠 overlap_wh(目标常在边界被切断时) |
| 太慢 | 调大 slice_wh、调小 overlap_wh;切片推理耗时 ≈ 图块数 × 单块推理时间 |
| 跨块重复框 | 调低 iou_threshold;密集目标场景可试 overlap_filter=sv.OverlapFilter.NON_MAX_MERGING |
| 误检变多 | callback 里提高推理阈值,或切片完成后按第三章语法过滤 |
4.7 本章方法速查
| 方法 | 干什么 | 关键参数(默认值) | 返回值 / 要点 |
|---|---|---|---|
sv.InferenceSlicer(callback=..., slice_wh=640, overlap_wh=100, overlap_filter=NON_MAX_SUPPRESSION, iou_threshold=0.5, thread_workers=1, batch_size=1) |
切片推理主类 | callback(必填,单块推理函数);slice_wh(图块尺寸);overlap_wh(重叠像素);overlap_filter(跨块合并策略);iou_threshold(合并 IoU 阈值);batch_size(逐块批量推理,默认 1------想榨 GPU 可调大);thread_workers(切片并行数) |
slicer(image) 直接当函数调用(__call__),大图切块 → 逐块推理 → 跨块合并去重一步到位;参数调法见 4.3/4.6 |
callback(image_slice) -> sv.Detections |
用户自定义的单块推理函数 | 入参:一个图块 ndarray | 出参必须是 sv.Detections------YOLO / RF-DETR 哪家模型都能接 |
sv.OverlapFilter.NON_MAX_SUPPRESSION / NON_MAX_MERGING |
跨块重复框合并策略 | --- | 前者去重(默认)、后者合并;⚠️ 旧文档写的参数名 overlap_filter_strategy 已更名为 overlap_filter |
sv.Detections(xyxy=..., confidence=..., class_id=...) |
手工构造统一检测结果 | 三个核心字段:xyxy / confidence / class_id |
4.4 的大坑:RF-DETR 的 callback 必须只保留这三件套 ------rfdetr 塞进 data 的切片原图等键值会导致合并时报 Conflicting metadata for key |
第五章 视频追踪(Track Objects)
素材:行人广场视频(341 帧,25fps,1920×1080)
前四章的一切都发生在单张图片 里。一旦放进视频,一个新问题立刻出现:检测器是逐帧独立工作的,这一帧的"car"和下一帧的"car"在它眼里毫无关系------同一辆车驶过镜头,ID 会不停地换人。追踪器(Tracker)的职责就是跨帧关联同一目标 :给每个目标分配一个稳定的 tracker_id,让它从进画面到出画面始终是"同一个人/同一辆车"。这是叉车测速、人员轨迹、行为分析的地基。
5.1 ByteTrack:一行接入的追踪器
supervision 内置 sv.ByteTrack,它的核心思想是"不浪费任何一次检测":高置信度检测先做第一轮匹配;没匹配上的低置信度检测不丢弃,再拿去做第二轮关联------所以目标被短暂遮挡、漏检一两帧时,ID 依然能续上。
python
tracker = sv.ByteTrack()

# 每一帧:
detections = sv.Detections.from_ultralytics(result)   # 常规检测
detections = tracker.update_with_detections(detections)  # 返回值带 tracker_id 字段
追踪后的 detections 多了一个 tracker_id 字段,标签拼接时用它生成 #1、#2 这样的编号即可。常用参数:
| 参数 | 作用 | 默认 |
|---|---|---|
track_activation_threshold |
高于此置信度才可能"激活"新轨迹 | 0.25 |
lost_track_buffer |
目标消失后保留轨迹的帧数(续 ID 的容错窗口) | 30 |
minimum_matching_threshold |
匹配阈值,调高更严格 | 0.8 |
frame_rate |
帧率(影响 buffer 等参数的换算) | 30 |
⚠️ 弃用提示 :
sv.ByteTrack已被官方标记弃用,新项目推荐外部trackers包的ByteTrackTracker(方法名从update_with_detections改为update)。内置版本目前仍可正常使用,教程以它为准是为了与官方文档保持一致。
5.2 例 1:检测 + 追踪 + 轨迹三件套
完整流程只有四步:检测 → 追踪 → 标注 → 逐帧循环。标注用了三个标注器组合:
python
tracker = sv.ByteTrack()
box_annotator = sv.BoxAnnotator()        # 画框
label_annotator = sv.LabelAnnotator()    # 贴 "#ID 类别 置信度" 标签
trace_annotator = sv.TraceAnnotator()    # 画运动轨迹(叉车测速的视觉基础)

model = YOLO(r"models/yolo11n.pt")

VIDEO_PATH = "people-walking.mp4"
seen_ids = set()

def callback(frame, frame_index):
    result = model(frame, conf=0.25, verbose=False)[0]
    detections = sv.Detections.from_ultralytics(result)
    detections = tracker.update_with_detections(detections)   # ← 追踪就这一行

    if len(detections):
        seen_ids.update(detections.tracker_id.tolist())

    names = result.names
    labels = [
        f"#{tid} {names[cid]} {conf:.2f}"
        for tid, cid, conf in zip(
            detections.tracker_id, detections.class_id, detections.confidence)
    ]

    annotated = box_annotator.annotate(scene=frame.copy(), detections=detections)
    annotated = label_annotator.annotate(scene=annotated, detections=detections, labels=labels)
    return trace_annotator.annotate(scene=annotated, detections=detections)

sv.process_video(source_path=VIDEO_PATH, target_path=OUT_VIDEO, callback=callback)
sv.process_video 负责解码、逐帧调用 callback、编码输出,我们只写 callback 里的逻辑。
5.3 例 1 实测结果
341 帧处理耗时 7.3 秒 (RTX 5060),全程累计追踪 60 个 ID,ID 随目标进出画面单调增长,无重复分配。
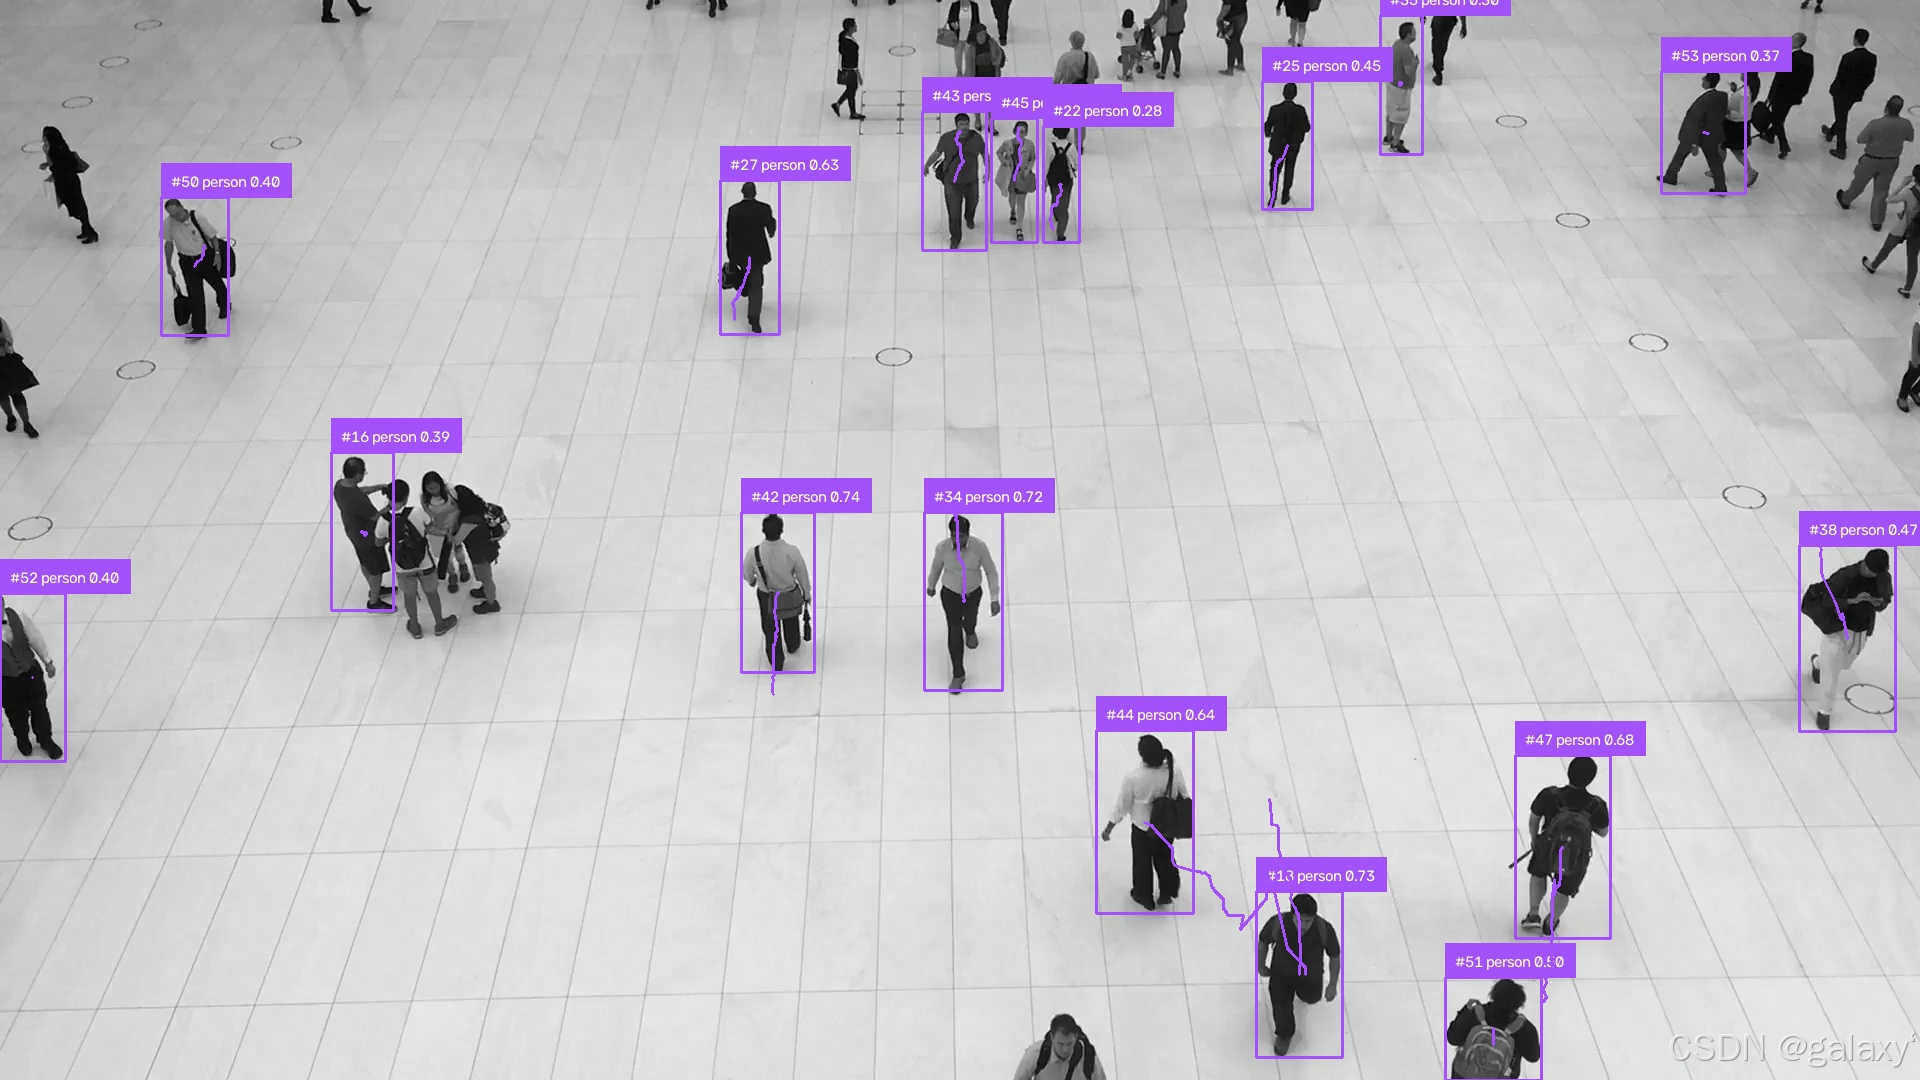
示例帧(第 300 帧):密集人流中每个行人都拿到独立 ID(#16 / #27 / #42 / #44......),紫色运动轨迹跟在框后。
一个非常有价值的实测观察------COCO 类别的局限 :行人广场画面里目标几乎全是 person,但 COCO 80 类里只有"人"这个笼统类别------没有工种、没有劳保穿戴、没有行为语义;行人拎的包被顺手标成 backpack / handbag(第四章切片图里就有),远处行人更是干脆漏检。这正是工业安全项目必须自定义训练检测模型的实证(对应算法选型里的结论:公开预训练模型只是起点,现场模型要微调)。
5.4 关键点追踪(官方 Keypoints 章节)
官方这篇教程其实有两大节:Object Detection & Segmentation 和 Keypoints 。后者回答另一个层次的问题:模型不只输出"框",还能输出人体 17 个骨骼关键点(姿态估计),关键点同样可以追踪。
流程比例 1 多两步,但每步仍然是一行:
python
tracker = sv.ByteTrack()
smoother = sv.DetectionsSmoother()       # 平滑框坐标,减少逐帧抖动
edge_annotator = sv.EdgeAnnotator()      # 画骨骼连线
vertex_annotator = sv.VertexAnnotator()  # 画关节点

model = YOLO(r"models/yolo11n-pose.pt")  # 姿态模型

def callback(frame, frame_index):
    result = model(frame, conf=0.25, verbose=False)[0]
    key_points = sv.KeyPoints.from_ultralytics(result)          # ① 关键点检测

    detections = key_points.as_detections()                     # ② 关键点 → 检测框
    detections = tracker.update_with_detections(detections)     # ③ ByteTrack 追踪
    detections = smoother.update_with_detections(detections)    # ④ 跨帧平滑

    annotated = edge_annotator.annotate(scene=frame.copy(), key_points=key_points)
    annotated = vertex_annotator.annotate(annotated, key_points=key_points)
    annotated = box_annotator.annotate(scene=annotated, detections=detections)
    return trace_annotator.annotate(scene=annotated, detections=detections)
为什么要"转框"再追踪? 因为 ByteTrack 只认带边界框的 Detections。KeyPoints.as_detections() 会用关键点的包围盒生成一个可追踪的目标------官方称之为目前关键点追踪的实现方式。两个实用细节:
as_detections(selected_keypoint_indices=...)可以只取部分关节生成框,应对肘部等关键点被躯干遮挡的场景;sv.DetectionsSmoother是官方 Bonus 环节:对追踪后的框坐标做跨帧滑动平滑,画面明显更稳。
💡 这里的姿态模型用的是 yolo11n-pose。如果只需要推理(不训练),还有一条免重型依赖的轻量路线:rtmlib 封装的 RTMPose,装 numpy + opencv + onnxruntime 就能跑,输出同样是骨骼关键点,下游的追踪与标注逻辑不变------详见参考链接里的 rtmlib 条目。
5.5 例 2 实测结果
行人广场这个画面里人员密集、目标全是行人,姿态模型几乎全程都有输出。示例帧取自片尾附近:"最近一帧检测到人"的画面:
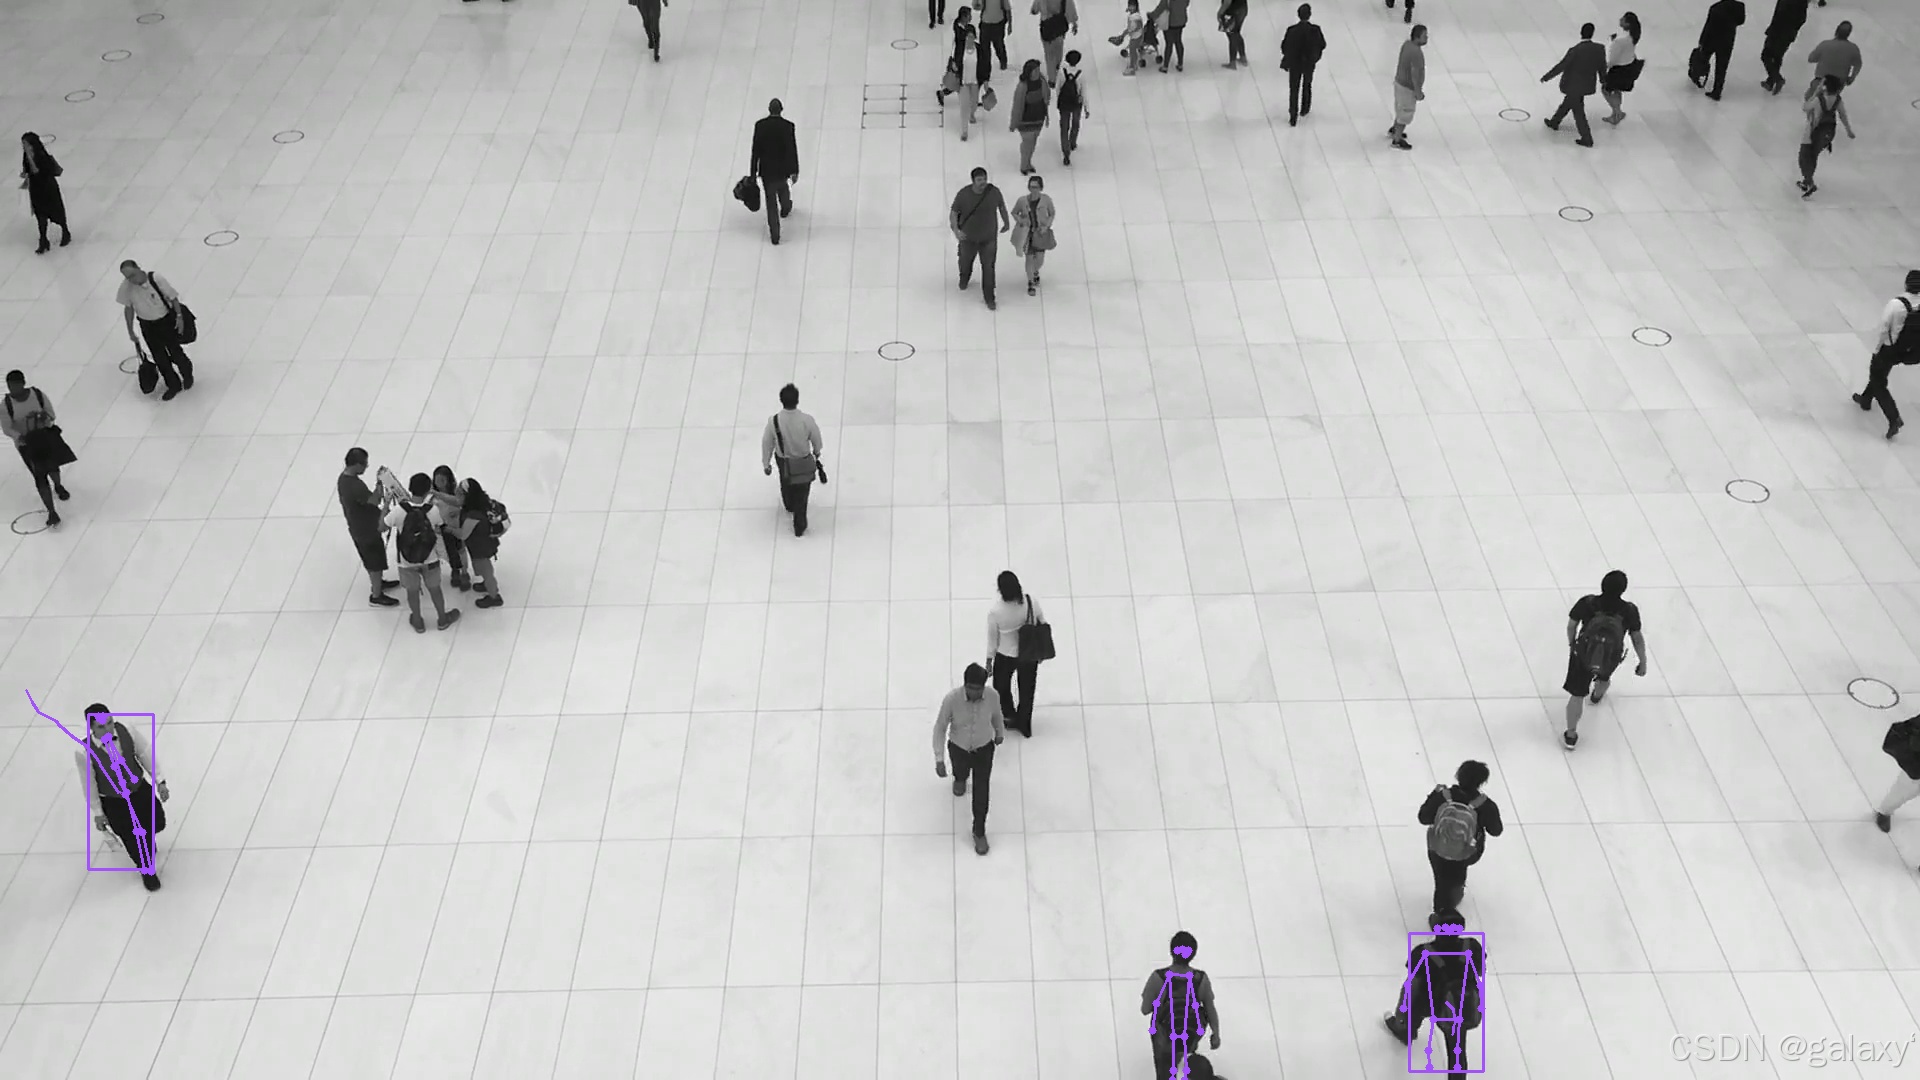
画面下方的几位行人被标出完整的紫色骨骼连线(17 关节点)+ 追踪框。完整标注视频已实测生成。
💡 想看骨骼追踪的"满屏效果",官方教程用的滑雪示例视频更合适(全片都是人物):
pythonfrom supervision.assets import download_assets, VideoAssets download_assets(VideoAssets.SKIING)
5.6 注意事项(官方 FAQ 要点 + 实测补充)
- ByteTrack 不挑模型 :任何能输出
sv.Detections的检测/分割模型都能接(官方 FAQ 明确说明),这也是第五章能与第一~四章无缝组合的原因。 - 姿态模型首次运行需下载
yolo11n-pose.pt(约 6MB)。实测国内网络直连 GitHub 走代理可能 502------手动下载放进models/目录即可(https://github.com/ultralytics/assets/releases/download/v8.4.0/yolo11n-pose.pt,或 hf-mirror 镜像)。 - 中文路径写图 照旧用
imencode().tofile()(0.5 节的坑,贯穿全书,视频流程里抽帧存图同样适用)。 - 追踪 ID 是"进出画面"语义:目标离开再进来会分配新 ID,ID 数单调增长是正常现象,不是 bug。需要"人再来还是同一个 ID"属于 ReID 范畴,超出 ByteTrack 的能力。
sv.ByteTrack弃用迁移 :换trackers包时方法名update_with_detections→update,其余逻辑不变。
5.7 本章方法速查
| 方法 | 干什么 | 关键参数(默认值) | 返回值 / 要点 |
|---|---|---|---|
sv.ByteTrack(...) |
内置追踪器(已标记弃用,仍可用) | 四个常用参数见 5.1 的表 | 核心思想:低置信度检测二轮匹配,短暂遮挡漏检 ID 也能续上 |
tracker.update_with_detections(detections) |
逐帧更新追踪 | detections:本帧检测结果 |
返回带 tracker_id 字段的新 sv.Detections;必须在每帧循环内调用,顺序不能乱(先检测后追踪) |
sv.process_video(source_path, target_path, callback, max_frames=None, show_progress=False) |
视频处理框架 | callback(frame, frame_index)(必填);max_frames(只处理前 N 帧,调试利器);show_progress(进度条,默认关) |
解码 → 逐帧调 callback → 编码输出全程代管;我们只写 callback 里的业务逻辑 |
sv.TraceAnnotator(position=CENTER, trace_length=30, thickness=2) |
运动轨迹标注 | trace_length(轨迹保留帧数,默认 30------想画长轨迹就调大);position(轨迹锚点,默认框中心) |
沿每个 tracker_id 画近期运动轨迹;叉车测速、轨迹回放的视觉基础 |
sv.KeyPoints.from_ultralytics(result) |
姿态结果 → 关键点对象 | result:ultralytics 姿态模型的 Results |
人体 17 骨骼关键点;追踪 ID 逻辑与检测完全同构 |
key_points.as_detections(selected_keypoint_indices=None) |
关键点 → 可追踪检测框 | selected_keypoint_indices:只取指定关节生成框(默认全部 17 点) |
ByteTrack 只认带框的 Detections,这是官方指定的关键点追踪方式;肘部等被遮挡时可选躯干点 |
sv.DetectionsSmoother(length=5).update_with_detections(detections) |
跨帧坐标平滑 | length:平滑窗口帧数(默认 5) |
接在追踪之后,框的逐帧抖动明显减小;官方 Bonus 环节 |
sv.EdgeAnnotator(thickness=2) / sv.VertexAnnotator(radius=4) |
骨骼连线 / 关节点标注 | edges(Edge 专属:自定义连线表,默认用标准人体骨架);radius(关节点半径) |
annotate 时传 key_points= 参数;与框标注器可叠加 |
download_assets(asset_name, directory=None) |
下载官方示例素材 | directory:保存目录(默认当前目录) |
from supervision.assets import download_assets, VideoAssets;官方滑雪视频骨骼追踪效果最满屏 |
第六章 处理数据集(Process Datasets)
前五章都在"用模型",这一章转向"喂模型"------训练自定义检测模型前的数据准备环节 。工业安全项目,注定绕不开:标注数据怎么组织、COCO/YOLO/Labelme 等格式怎么互转、train/val 怎么切分。supervision 用一个 sv.DetectionDataset 把这些全部统一了。
6.1 一个类管所有格式
sv.DetectionDataset 支持五种格式 的加载与导出,方法名高度规律------from_X 加载、as_X 导出:
| 格式 | 加载 | 导出 | 标注文件形态 |
|---|---|---|---|
| COCO | from_coco() |
as_coco() |
一个总 JSON(_annotations.coco.json) |
| YOLO | from_yolo() |
as_yolo() |
每图一个 txt(归一化中心坐标)+ data.yaml |
| Pascal VOC | from_pascal_voc() |
as_pascal_voc() |
每图一个 XML |
| CreateML | from_createml() |
as_createml() |
一个 JSON |
| Labelme | from_labelme() |
as_labelme() |
每图一个 JSON |
数据集还有两个通用操作:split() 切分、merge() 合并(类别自动整合)。
6.2 两种来源:加载现成标注 / 直接构造
来源一(最常见):手头已有标注,直接加载:
python
import supervision as sv

ds = sv.DetectionDataset.from_coco(
    images_directory_path="<图片目录>",
    annotations_path="<_annotations.coco.json 路径>",
)
print(ds.classes)   # 类别表
print(len(ds))      # 图片数
来源二 :从检测结果直接构造(本教程实测用的方式)------images 传路径列表,annotations 传 {图片路径: sv.Detections} 字典:
python
ds = sv.DetectionDataset(
    classes=model.names 的值列表,
    images=[图片路径列表],
    annotations={图片路径: 对应的 Detections},
)
实测脚本用 YOLO11n 对 dog.jpeg 及其 3 个变体(翻转/提亮/裁剪)各推理一次,构造出 4 张图、17 个目标的迷你数据集------这也是"用预训练模型预标注、人工只做修正"的半自动标注思路。
6.3 格式转换实测:导出 → 回读 → 一致性核对
实测三种最常用格式的完整往返(COCO → 内存 → YOLO → 内存 → Labelme):
| 格式 | 导出结构 | 回读 | 目标数 |
|---|---|---|---|
| COCO | _annotations.coco.json + images/ |
4 图 17 目标,80 类 | 5 ✓ |
| YOLO | images/ + labels/*.txt + data.yaml |
4 图 17 目标,80 类 | 5 ✓ |
| Labelme | images/ + annotations/*.json |
4 图 17 目标 | 5 ✓ |
三格式往返后,原图 5 个目标无一丢失,回读标注可视化与原始推理完全一致:
YOLO 标注文件的真容(每行 类别id x中心 y中心 宽 高,全部归一化到 0~1):
26 0.58071 0.74189 0.30854 0.47847    ← 26=handbag
16 0.49515 0.47819 0.81986 0.56584    ← 16=dog
0  0.44155 ...                         ← 0=person
6.4 两个实测发现(教程重点)
- Labelme 回读的类别数是 5,不是 80 。COCO/YOLO 格式带全局类别表(原样保留 80 类),而 Labelme 每个标注文件只记录实际出现的标签名,回读时类别表 = 全数据集实际用到的标签并集。做格式转换时如果要严格保持类别 id 一致,优先选 COCO/YOLO。
- 数据集目录必须用英文路径 。supervision 数据集读写内部调用
cv2.imread,中文路径会静默失败 (第六章之前踩过的 OpenCV 5 老坑,这次在 from_coco/from_yolo 里同样成立)。实测脚本全部用ch6_英文前缀命名目录------自己组织训练数据时,路径里不要出现中文。
6.5 切分与合并
python
ds_train, ds_test = ds.split(split_ratio=0.75, random_state=42)  # 3 张 + 1 张
ds_merged = sv.DetectionDataset.merge([ds_train, ds_test]) # 合并回 4 张 ✓注意:split 只返回两个数据集 (train + 剩余),官方 FAQ 明确说明------需要 train/val/test 三份时,对剩余部分再 split 一次。random_state 固定随机种子保证可复现;merge 可合并不同来源的数据集,类别表自动取并集。
6.6 可视化与增强
数据集对象可直接下标迭代 ds[i] 返回 (索引, 图像, 标注),配合第一章的标注器即可抽样检查标注质量(教程惯例:训练前先肉眼过一遍标注 )。数据增强 supervision 本身不做,官方推荐配合 Albumentations------注意它的 bbox 格式参数要设 pascal_voc(对应 supervision 的 xyxy 坐标)。
6.7 本章方法速查
| 方法 | 干什么 | 关键参数(默认值) | 返回值 / 要点 |
|---|---|---|---|
sv.DetectionDataset.from_coco / from_yolo / from_pascal_voc / from_createml / from_labelme |
五种格式加载(方法名规律 from_X) |
from_coco(images_directory_path, annotations_path);from_yolo(images_directory_path, annotations_directory_path, data_yaml_path)------YOLO 三个路径参数缺一不可 |
COCO/YOLO 带全局类别表;Labelme 回读类别 = 全数据集实际出现标签的并集(6.4 发现①)------要严格保持类别 id 优先选 COCO/YOLO |
ds.as_coco / as_yolo / as_pascal_voc / ... |
对应格式导出(as_X) |
as_yolo(images_directory_path, annotations_directory_path, data_yaml_path):三个路径都传才会完整落盘 |
与 from_X 一一对应;导出 YOLO 时自动生成 data.yaml + 每图一个归一化 txt |
sv.DetectionDataset(classes, images, annotations) |
直接构造数据集 | classes:类别名列表;images:图片路径列表;annotations:{图片路径: sv.Detections} 字典 |
"预训练模型预标注 + 人工修正"的接口 |
ds.split(split_ratio=0.8, random_state=None, shuffle=True) |
切分数据集 | split_ratio(默认 0.8 ,教程用了 0.75);random_state(固定种子保证可复现);shuffle(默认打乱) |
只返回两份(train + 剩余);要三份就对剩余再切一次 |
sv.DetectionDataset.merge([ds1, ds2]) |
合并数据集 | 传数据集列表 | 类别表自动取并集;不同来源的数据集可以拼 |
ds.classes / len(ds) / ds[i] |
属性与迭代 | --- | ds[i] 返回 (索引, 图像, 标注);配第一章标注器逐张可视化,训练前肉眼过一遍标注 |
| ⚠️ 数据集目录必须英文路径 | 数据集读写内部调 cv2.imread |
--- | 中文路径静默失败(OpenCV 5 老坑,6.4 发现②);目录命名用英文前缀 |
第七章 模型基准测试(Benchmark a Model)
模型训完(或选型时),怎么用数字 回答"它到底行不行"?这一章给出标准答案:在独立的 test 集上算 mAP 和 F1,用混淆矩阵定位错在哪里。supervision 把整套评测 API 化了,三行核心代码跑完。
⚠️ 先说结论性提醒 :本章实测用的是第六章迷你数据集------它的真值就是 YOLO11n 自己的标注("自己考自己"),所以 YOLO 的 mAP=1.0000 是必然的上限演示,不代表模型真实水平。数字只用于学习指标读法;真实评测必须用与训练无关的独立 test 集(官方 Benchmarking Basics 反复强调:训练集评测虚假地好,验证集间接影响训练,都不合格)。
7.1 API 变了:sv.CocoMetric 已被移除
实测确认(supervision 0.30):老教程/老博客里的 sv.CocoMetric 已经不存在 ,新 API 在 supervision.metrics 模块下,且统一为"update 累积 → compute 计算"两段式:
| 指标 | 用法 |
|---|---|
| mAP(平均精度均值) | MeanAveragePrecision(metric_target=MetricTarget.BOXES) |
| F1 | F1Score(metric_target=MetricTarget.BOXES) |
| 混淆矩阵 | sv.ConfusionMatrix.from_detections(...) / .benchmark(...) |
MetricTarget 可选 BOXES / MASKS / ORIENTED_BOXES,对应检测/分割/旋转框。
7.2 评测四步走
python
from supervision.metrics import MeanAveragePrecision, MetricTarget

# ① 加载独立 test 集(第六章的 from_yolo 在这里直接复用)
test_set = sv.DetectionDataset.from_yolo(...)

# ② 逐图推理,收集预测与真值
predictions_list, targets_list = [], []
for _, image, label in test_set:
    predictions_list.append(model_predict(image))
    targets_list.append(label)

# ③ 累积 + 计算
map_result = MeanAveragePrecision(
    metric_target=MetricTarget.BOXES
).update(predictions_list, targets_list).compute()

# ④ 读数
print(map_result.map50_95, map_result.map50, map_result.map75)
F1 同理,换 F1Score 类即可,update/compute 接口完全一致。
7.3 实测结果:YOLO11n vs RF-DETR Medium
| 模型 | mAP@50:95 | mAP@50 | mAP@75 | F1@50 |
|---|---|---|---|---|
| YOLO11n(真值同源,上限演示) | 1.0000 | 1.0000 | 1.0000 | 1.0000 |
| RF-DETR Medium(threshold=0.25) | 0.4557 | 0.6762 | 0.5036 | 0.7164 |
怎么读这些数:
mAP@50:95是综合排名指标:IoU 阈值从 0.5 到 0.95 步长 0.05 取 10 档,对 AP 求平均------框得越贴合分越高,所以它比 mAP@50 严格得多mAP@50只要求 IoU>0.5 算命中,宽松,看"找没找到";mAP@75严格,看"框得准不准"。RF-DETR 的 0.68 vs 0.50 说明它能找到目标但框的贴合度被严格口径拉低result.small_objects / medium_objects / large_objects还能按目标大小分解(<32²、32²~96²、>96² 像素)。实测 RF-DETR:中目标 0.53、大目标 0.44;小目标是 -1.0000------这不是算错,-1 是"该尺寸段没有真值样本"的哨兵值,本迷你数据集里恰好没有小目标
7.4 实测抓到的大坑:类别 id 体系不一致(本章最有价值的一节)
第一版脚本 RF-DETR 的 mAP 直接算出 0.0000------但画面里 dog 0.84 明明检出了。排查结果:
真值 class_id:     [26, 16,  0,  0,  2]        ← COCO/YOLO 体系
rfdetr class_id:   [18,  3,  1, 27, 31, ...]   ← RF-DETR 自己的体系
rfdetr class_name: [dog, car, person, backpack, handbag, ...]
RF-DETR 的 class_id 编号顺序与 COCO/YOLO 完全不同 (它的 dog=18,COCO 的 dog=16)。两个模型直接比,所有类别错配,mAP 归零。修法就是官方教程 remap_classes 一节的思路------按类名重映射:
python
COCO_ID = {name: idx for idx, name in yolo_model.names.items()}   # 类名 → COCO id

def rfdetr_predict(image_rgb):
    dets = rfdetr_model.predict(image_rgb[:, :, ::-1].copy(), threshold=0.25)
    mapped = np.array([COCO_ID.get(n, -1) for n in dets.data["class_name"]])
    dets = dets[mapped >= 0]          # 丢弃不在类别表里的预测
    dets.class_id = mapped[mapped >= 0]
return dets教训:跨模型评测,先核对类别 id 体系再算指标。自定义训练的模型尤其如此------类别表顺序取决于你的 data.yaml,评测前必须对齐。
7.5 混淆矩阵:数字之外的"眼睛"
mAP 只给总分,混淆矩阵告诉你错成了什么。两种用法:
python
# ① 总矩阵:from_detections + plot 热力图
confusion = sv.ConfusionMatrix.from_detections(
    predictions=predictions_list, targets=targets_list,
    classes=classes, conf_threshold=0.25, iou_threshold=0.5)
fig = confusion.plot(save_path="ch7_confusion_matrix.png")   # 返回 matplotlib Figure

# ② 逐图四象限(官方 benchmark 方法):每张图存 TP/FP/FN/Ground Truth 网格图
sv.ConfusionMatrix.benchmark(
    dataset=test_set, callback=model_predict,
    conf_threshold=0.25, iou_threshold=0.5,
    save_directory_path="./results")
实测用 benchmark 对 YOLO11n 生成了 4 张图的 2x2 网格(逐图网格已实测生成)------每张图能直接看到哪些检出是 TP、哪些是 FP、哪些真值被漏了(FN),是调阈值、查误报最直观的工具 。类别太多时总矩阵不可读,from_detections 前先把无关类过滤掉,或聚焦单类分析。
7.6 本章方法速查
| 方法 | 干什么 | 关键参数(默认值) | 返回值 / 要点 |
|---|---|---|---|
MeanAveragePrecision(metric_target=BOXES, class_agnostic=False, class_mapping=None) |
mAP 评测器 | metric_target(BOXES / MASKS / ORIENTED_BOXES);class_agnostic(跨类合并评测);class_mapping(类别 id 映射表------7.4 的跨模型对齐也可以走它) |
在 supervision.metrics 模块下;⚠️ 老教程里的 sv.CocoMetric 已被移除,别再抄 |
.update(predictions, targets) → .compute() |
两段式累积计算 | 支持单个 Detections 或 list[Detections] 混传 |
先逐批 update 累积、再 compute 一次性出数------所有新指标类统一此接口 |
map_result.map50_95 / map50 / map75 |
三档 IoU 口径读数 | --- | 50:95 综合排名最严(10 档平均);50 宽松看"找没找到"、75 严格看"框得准不准" |
result.small_objects / medium_objects / large_objects |
按目标大小分解指标 | 尺寸段:<32²、32²~96²、>96² 像素 | -1.0000 是"该尺寸段无真值样本"的哨兵值,不是算错 |
F1Score(metric_target=BOXES, averaging_method=WEIGHTED) |
F1 评测器 | averaging_method:多类别平均方式(宏/微/加权) |
update / compute 接口与 mAP 完全一致;用于找 F1 峰值对应的置信度阈值 |
sv.ConfusionMatrix.from_detections(predictions, targets, classes, conf_threshold=0.3, iou_threshold=0.5) |
总混淆矩阵 | classes:类别名列表(必填);conf_threshold(默认 0.3 ,与 mAP 的习惯阈值不同,留意);iou_threshold(默认 0.5) |
.plot(save_path=..., normalize=False, fig_size=(12,10)) 出热力图(返回 matplotlib Figure);类别多时先过滤无关类再算 |
sv.ConfusionMatrix.benchmark(dataset, callback, conf_threshold=0.3, iou_threshold=0.5, save_directory_path=None) |
逐图四象限评测 | dataset:DetectionDataset;callback:单图推理函数;save_directory_path:网格图输出目录 |
每张图存 TP/FP/FN/GT 网格图------调阈值、查误报最直观的工具 |
| 类名重映射(7.4 自定义代码) | 跨模型评测的前置步骤 | --- | RF-DETR 的 class_id 与 COCO 不同序 ,按 class_name 对齐类别表再算指标,否则 mAP 归零(也可用上面 class_mapping 参数承接) |
第八章 区内计数(Count in Zone)
素材:行人广场视频(341 帧,25fps,1920×1080)
第三章 3.5 节已经用过 PolygonZone 做单张图 的区域过滤,这一章把它放进视频流:每一帧都问一次"区域内现在有几个目标",就有了实时区内计数------这是危险区域人员监控、作业区占用的直接实现。官方教程以交通视频双区域车辆计数为例,我们用行人广场视频等效复现。
8.1 官方主流程:双区域实时计数
三个组件各司其职:
python
zones = [sv.PolygonZone(polygon=polygon) for polygon in polygons]          # 逻辑:谁在区内
zone_annotators = [sv.PolygonZoneAnnotator(zone=z, ...)]                   # 视觉:多边形+计数数字
box_annotators = [sv.BoxAnnotator(...)]                                    # 视觉:区内目标的框

def process_frame(frame, i):
    detections = model.predict(frame[:, :, ::-1])       # RF-DETR 直接返回 Detections
    for zone, zone_annotator, box_annotator in zip(zones, zone_annotators, box_annotators):
        mask = zone.trigger(detections=detections)      # 布尔掩码:锚点落在多边形内
        frame = box_annotator.annotate(scene=frame, detections=detections[mask])
        frame = zone_annotator.annotate(scene=frame)    # 区域轮廓 + 角落自动显示区内计数
    return frame

sv.process_video(source_path=VIDEO, target_path="result.mp4", callback=process_frame)
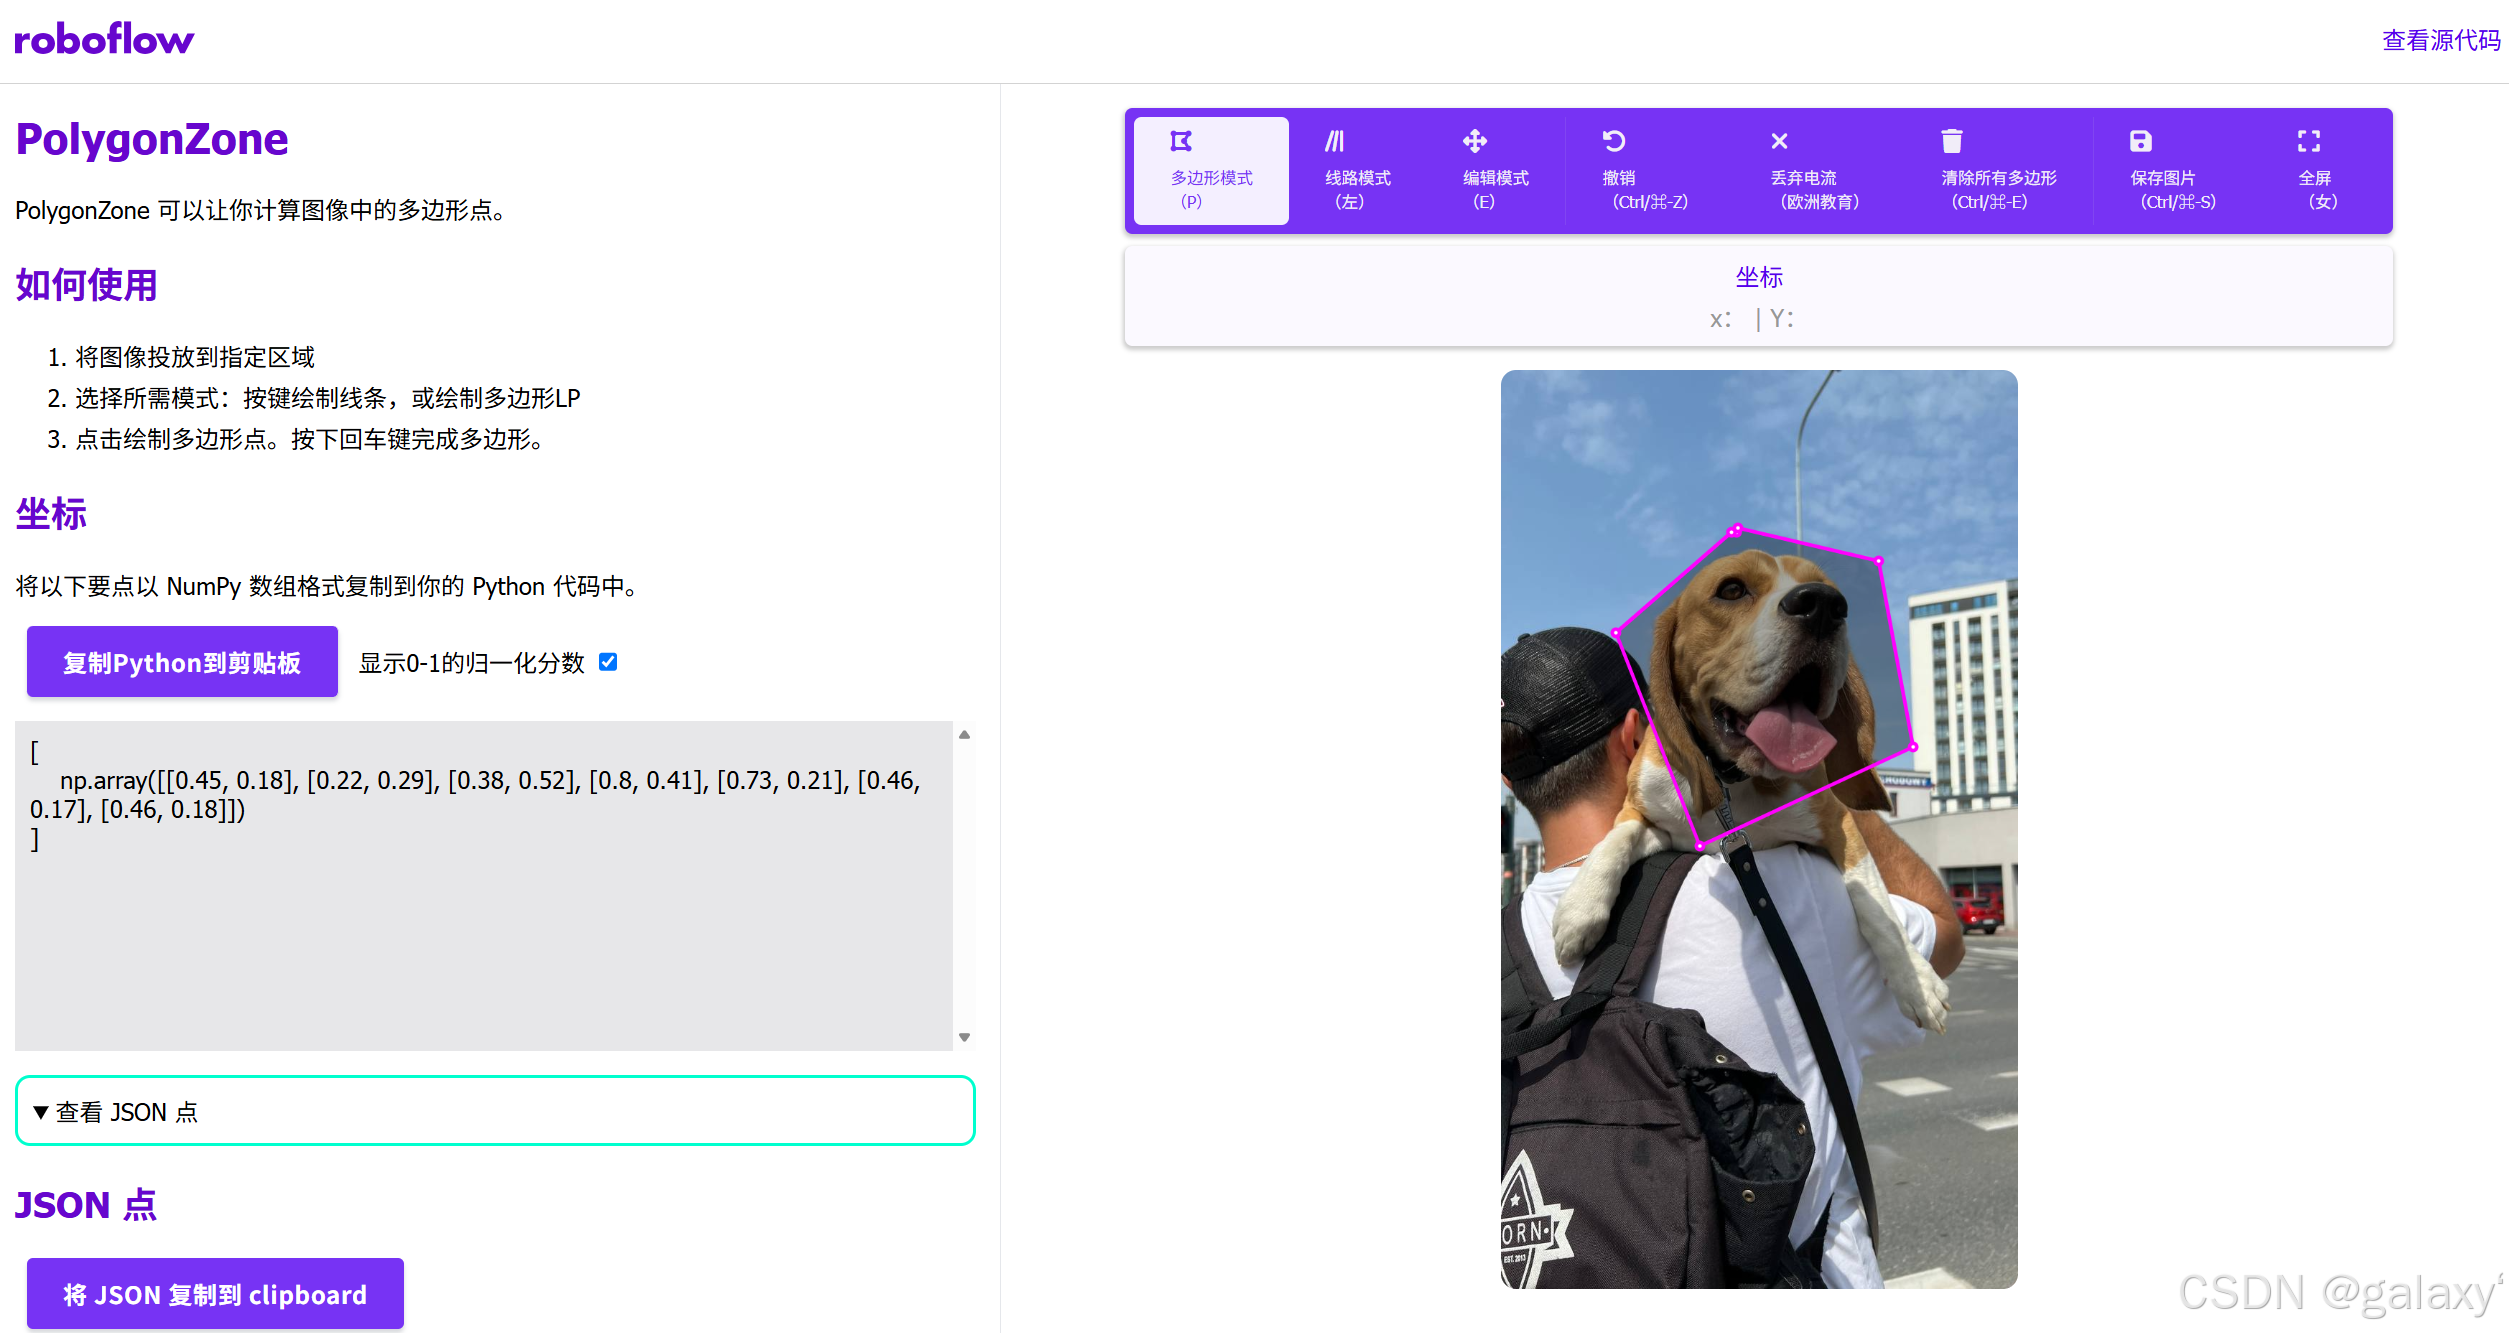
区域坐标不用手猜------官方提供 PolygonZone 网页工具,上传一帧画面鼠标框选,直接导出 numpy 坐标数组。
8.2 实测:行人广场视频双区域计数
两个区域(中部广场区梯形 + 底部通道横条),YOLO11n + ByteTrack 逐帧分析 341 帧(8.8 秒跑完):
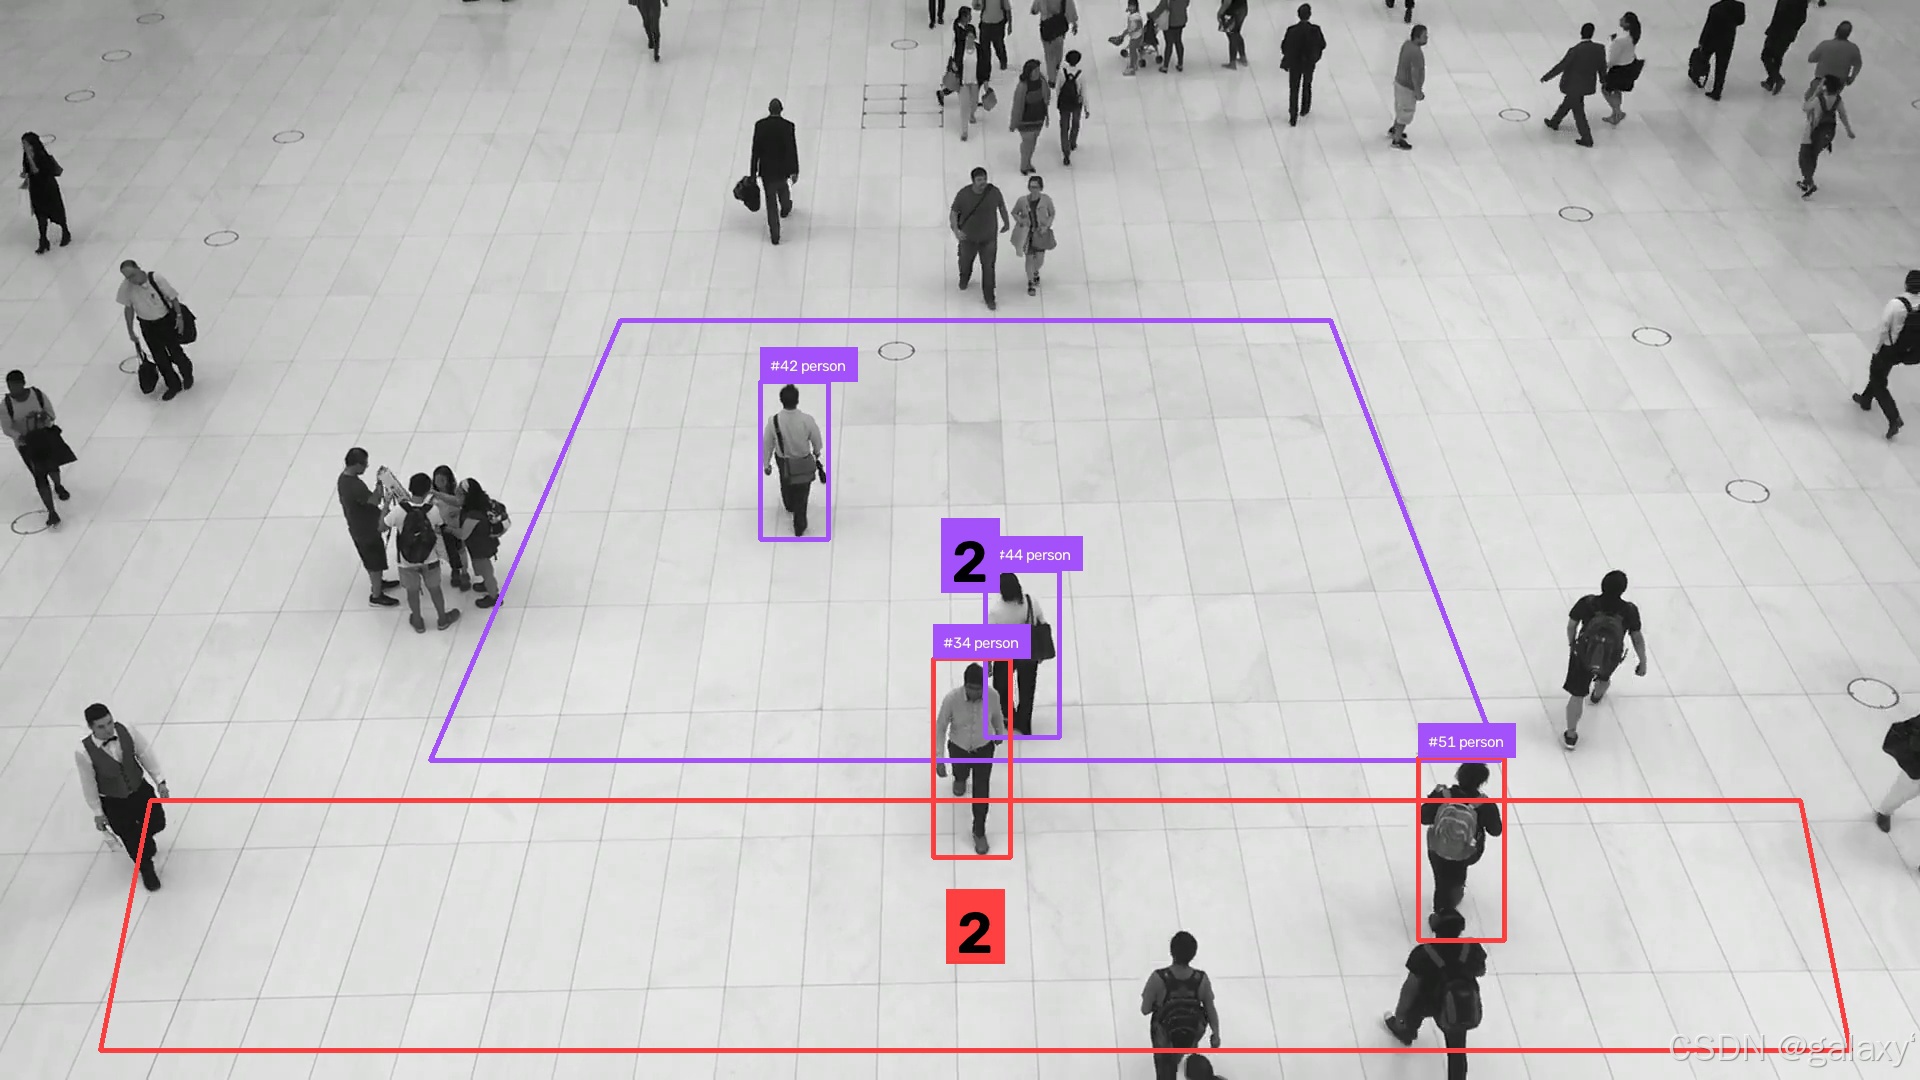
示例帧:紫色"中部广场区"角落显示计数 2 (#42 / #44 在区内),红色"底部通道"计数 2。完整标注视频已实测生成。
8.3 计数时序存档:把"每帧的数"变成数据
计数只显示在画面上没法分析。实测把每秒的区内计数写入 CSV(衔接第二章的存档思想,UTF-8 BOM 保证 Excel 不乱码):
csv
秒,中部广场区_当前区内,底部通道_当前区内,中部广场区_累计进入,底部通道_累计进入
1.0,5,3,6,4
4.0,7,3,9,10
10.0,4,2,14,18
13.0,1,2,15,23
14 行时序数据可以直接画曲线、算占用率、设阈值告警------"区内计数 + 时序存档"就是区域监控类需求的完整数据链。
8.4 瞬时计数 vs 累计进入:工业场景最容易踩的语义坑
实测发现一个必须分清的语义:第 13 秒采样时中部广场区"当前区内"只有 1 人,累计进入却有 15 个目标;底部通道当前 2 人、累计 23 个------因为行人快速穿过区域,恰好采样瞬间不在区内。两种计数的用途完全不同:
| 语义 | 实现 | 现场用途 |
|---|---|---|
| 当前区内(瞬时) | len(detections[zone.trigger(detections)]) |
危险区域实时人数、超员报警 |
| 累计进入(去重) | 区内目标的 tracker_id 存入 set(),重复进出只记一次 |
闯入事件"只报一次"、进出统计 |
python
entered_ids = set()                                  # 每个区域一个集合
mask = zone.trigger(detections=detections)
in_zone = detections[mask]
if len(in_zone):
    entered_ids.update(in_zone.tracker_id.tolist())  # 同一目标反复进出只计一次
实测全程:中部广场区累计进入 16 个目标、底部通道 24 个(去重后)。没有 tracker_id 的"纯视觉计数"做不到这一点------区域内计数一旦要"按事件报",就必须先过第五章的追踪器。
8.5 FAQ 进阶:线穿越计数(LineZone)
官方 FAQ 指出两条路之外还有第三种计数形态------越线计数 sv.LineZone:定义一条起止线,trigger 返回 (crossed_in, crossed_out) 两个方向的布尔数组。与区域计数的三点区别:
- 需要
detections.tracker_id(必须先跑追踪器) - 统计的是"穿越事件"而不是"区域内存在"------每个目标每穿过一次计一次
- 天然带方向性------进/出分开统计
工业现场选型:区域占用 用 PolygonZone,单向闸口/通道流量/测速断面用 LineZone。
8.6 实测注意事项
zone.current_count已被移除 (0.30 实测):老版本 PolygonZone 有这个属性,现在计数要自己len()数------标注器角落显示的数字是它内部算的,代码里拿不到PolygonZone.trigger默认锚点仍是 BOTTOM_CENTER (第三章 3.5 的坑,区域计数同样适用),目标"脚在区内"才算,可按需改triggering_anchors- 快速穿过目标:瞬时计数漏、去重计数准------需要流量数据时别只看瞬时值
8.7 本章方法速查
| 方法 | 干什么 | 关键参数(默认值) | 返回值 / 要点 |
|---|---|---|---|
sv.PolygonZone(polygon, triggering_anchors=(BOTTOM_CENTER,), require_all_anchors=True) |
区域逻辑(第三章 3.5 同款) | ⚠️ 默认锚点仍是框底边中点 ("脚在区内"才算);require_all_anchors 默认 True |
视频里每帧 trigger 一次,就得到"当前区内有哪些目标"的实时掩码 |
zone.trigger(detections) |
区内判断 | detections:本帧检测结果 |
返回布尔掩码;口径不对就在 triggering_anchors 里改(8.6 注意②) |
sv.PolygonZoneAnnotator(zone, display_in_zone_count=True, opacity=0) |
区域轮廓 + 角落计数显示 | display_in_zone_count(角落数字就是这个参数控制的 ,默认开);opacity(多边形填充度,默认 0 只画轮廓) |
⚠️ zone.current_count 已被移除,代码里要计数得自己 len()(8.6 注意①) |
len(detections[mask]) |
瞬时计数(当前区内) | --- | "超员/有人即报警"用这个语义;行人快速穿过时采样瞬间会漏 |
entered_ids.update(in_zone.tracker_id.tolist()) |
累计进入(set 去重) | --- | "闯入事件只报一次"的语义;前提是先过追踪器拿到 tracker_id,纯视觉计数做不到按事件去重 |
sv.LineZone(start, end, triggering_anchors=(框四角,), minimum_crossing_threshold=1) |
线穿越计数 | start / end:线的两端点(sv.Point(x, y));默认锚点是框四角全部落线另一侧才算穿越 (与 PolygonZone 的默认值不同);minimum_crossing_threshold(触发穿越所需锚点数) |
trigger 返回 (crossed_in, crossed_out) 两个方向的布尔数组;要求 detections 带 tracker_id。选型:区域占用用 PolygonZone,闸口/通道流量用 LineZone(8.5) |
第九章 注意事项
第一件事:OpenCV 后端。 supervision 0.30 起不再自动安装 OpenCV,标准安装自带一套 NumPy/Pillow 的 fallback 后端,没有 cv2 的环境也能照常工作------但部署时要心里有数:服务器装 opencv-python-headless、桌面装 opencv-python,两者绝不能同时装 ,环境里已有 cv2 的就不要再装第二个 wheel;用 from supervision import _cv2; print(_cv2.BACKEND_NAME) 可以诊断当前后端(本机实测输出 opencv,若输出 fallback 说明走的是内置实现,绘图像素与读写行为都会不同,做图像级对比时要保持同一后端)。第六章那个"中文路径静默失败"的坑正是依赖真 cv2 的行为,fallback 后端下表现还不一样------结论:显式安装 opencv-python,并在部署脚本开头加一行 BACKEND_NAME 诊断。
第二件事:分割掩码的内存。 分割结果的 detections.mask 默认是全帧布尔数组,2560×1440 画面检出 10 个目标就约 35MB,逐帧存档或多路场景内存迅速爆炸;官方给出的方案是 CompactMask ------把每个掩码存成边界框内有效像素的游程编码(RLE),from_dense(稠密转紧凑)、from_coco_rle(COCO RLE 直接摄取)、det.to_compact_masks()(就地转换)三个入口,配合 annotator.requires_mask 标志,不画掩码的标注器可以直接剥掉 mask 字段省掉解码开销。两个注意点:from_inference(result, compact_masks=True) 会把框外像素静默丢弃,烟雾这类常溢出检测框的目标要评估是否可接受;官方给的提速(RLE 摄取 25--60%、MaskAnnotator 10--35%)适用前提是 ≥1080p、几十到上百个实例,且模型推理通常仍是大头,这些优化不等于端到端 FPS。
参考链接
- Roboflow 平台文档(数据标注 / 云端训练 / 部署 / Workflows):https://docs.roboflow.com/
关于 Roboflow 平台:supervision、RF-DETR 背后公司的商业平台文档,覆盖从数据到部署的全流程------网页版数据集管理与在线标注(Datasets)、云端一键训练自定义模型(Models)、云 API 或边缘 Docker 部署(Deployments)、拖拽式多阶段视觉流水线编排(Workflows),以及用 AI Agent 开发视觉应用(Agents)。有免费档可白嫖标注工具与少量额度;与本文的开源路线互补------开源组合(supervision + RF-DETR + Maestro)全程免费本地跑,平台则是"数据上云、训练托管"的付费选项,按需选择即可。
- Supervision 官方文档:https://supervision.roboflow.com/latest/
- Maestro 官方文档(VLM 微调框架,Florence-2 / PaliGemma 2 / Qwen2.5-VL,Apache-2.0):https://maestro.roboflow.com/develop/
关于 Maestro:Roboflow 开源的视觉语言模型(VLM)微调框架,把 Florence-2、PaliGemma 2、Qwen2.5-VL 这类多模态大模型的微调封装成一行命令(CLI 或 Python API),内置 LoRA/QLoRA 低秩微调,消费级显卡即可训练,Apache-2.0 协议免费商用。与 supervision(结果后处理)、RF-DETR(检测模型)同属一个开源家族。适合"描述式查找"等传统检测模型不好覆盖的开放场景,但推理开销比 YOLO 大一个量级,更适合离线分析而非实时报警。
- Trackers(多目标追踪库,sv.ByteTrack 的官方继任者):https://github.com/roboflow/trackers
关于 Trackers :Roboflow 开源的多目标追踪(MOT)库,Apache-2.0 免费商用,用于接替 supervision 内置已弃用的
sv.ByteTrack。内置 SORT、ByteTrack、OC-SORT、BoT-SORT、C-BIoU、McByte 六种追踪器,接口统一为tracker.update(detections);其中 BoT-SORT 与 McByte 带相机运动补偿,移动摄像头场景也能稳住轨迹。与 supervision 配合时,一帧的检测结果交给update即可拿到带 ID 的追踪结果,第五章教程的迁移只需把update_with_detections换成update,其余逻辑不变。
- Inference 官方文档(开源推理引擎 / Workflows 执行端):https://inference.roboflow.com/
关于 Inference :Roboflow 开源的推理引擎,
pip install inference即可把自己的机器(CPU/GPU/边缘设备)变成模型推理服务,也是 Workflows 可视化流水线的执行端。内置 100+ 预置积木:多模型串联、Florence-2/CLIP/SAM2 等基础模型调用、OCR、模板匹配、条码识别、事件报警、尺寸测量,Apache-2.0 免费商用(云端托管部署为付费选项)。与本文教程的关系:教程走的是"rfdetr/ultralytics + supervision"直接调库的极简路线,不需要它;当你需要服务化部署(多路摄像头、HTTP API、Web 后端调用)或想编排多模型流水线时再上。
- RF-DETR 官方文档(开源 Transformer 检测器,教程第四章/第七章用的模型):https://rfdetr.roboflow.com/latest/
关于 RF-DETR 文档 :教程中已大量使用的 RF-DETR 检测模型的官方文档,对应
pip install rfdetr的那个包。Quickstart 几行代码加载预训练模型跑推理;核心价值在训练/微调章节------用自己的数据集微调 COCO 预训练权重、自定义类别数、断点续训,是接自有数据集(烟火、PPE 等)训练自定义模型的主要参考;另有 Nano/Small/Medium/Base 多档规格的精度-速度对比、ONNX 导出与服务化部署说明。Apache-2.0 免费商用。
- MMDetection(OpenMMLab 目标检测工具箱):https://github.com/open-mmlab/mmdetection | 文档:https://mmdetection.readthedocs.io/en/latest/
关于 MMDetection :OpenMMLab 家族的检测训练工具箱,Apache-2.0 免费商用,把检测任务拆成 Backbone/Neck/Head 可插拔组件、配置文件驱动,内置数百种算法的官方实现与预训练权重(Faster R-CNN、RTMDet、DINO、CO-DETR、MM-Grounding-DINO 等),多年是学界复现论文的事实标准。现状要泼冷水:最后版本 v3.3.0 于 2024 年 1 月发布后官方实质停更(issues 基本无人回应);依赖钉死 mmcv,预编译轮子跟不上新 PyTorch/CUDA,新环境安装常需整体降级;目前由社区以 OneDL fork(onedl-mmdetection,重打包适配新环境)续命。与本文的关系:supervision 管"检测结果之后"的工程活(过滤、标注、追踪、计数),mmdetection 管"模型训练"的训练侧------但它与本文教程重叠度低(检测微调用 RF-DETR 那套已够),老项目维护或复现论文时才值得上手,新项目建议选活跃维护的现代检测器。
- rtmlib(超轻量姿态估计推理库):https://github.com/Tau-J/rtmlib
关于 rtmlib :RTMPose / ViTPose 系姿态模型的纯推理封装,Apache-2.0 免费商用。与上面 MMDetection 条目正好是一组对照:同是 OpenMMLab 血统的模型,rtmlib 的路线是彻底绕开 mmcv/mmpose ------只依赖 numpy + opencv + onnxruntime 三样,
pip install rtmlib完就能跑,权重走 ONNX 格式,支持 onnxruntime / OpenVINO / TensorRT 多后端与 CPU / CUDA / MPS。分工一句话说清:要训练 姿态模型去 OpenMMLab,只想部署推理 (骨骼关键点 → 摔倒判定、作业姿势分析这类下游应用),rtmlib 这条免重型依赖的路线省心得多;配套的 PoseTracker 还内置了视频流场景的降频检测(det_frequency参数------每 N 帧才跑一次人体检测器,中间帧只推姿态模型),边缘设备上跑视频流的算力账就是这么省出来的。与本文 5.4 节的关键点追踪直接衔接:把那里的 yolo11n-pose 换成 rtmlib 的 RTMPose,下游的KeyPoints/ 追踪 / 标注逻辑不变。
- Albumentations(图像增强库):https://github.com/albumentations-team/albumentations | 官网/文档:https://albumentations.ai/ | 下一代版本 AlbumentationsX:https://github.com/albumentations-team/AlbumentationsX
关于 Albumentations :最流行的图像增强库------70+ 种像素级/空间级增强,一套 API 同时变换图像、掩码、检测框和关键点(增强时框坐标跟着动,这正是检测任务数据增强的刚需),长期是各类深度学习工作流里的事实标准。协议与现状要分两条看 :主库 albumentations 为 MIT 永久免费商用,但官方已宣布停止维护 (只保证现状可用,不再修 bug、不跟进新版本 Python/PyTorch);所有开发已转移到重写的继任版 AlbumentationsX (
pip install albumentationsx,API 完全兼容,import albumentations as A不用改代码),但它改为 AGPL-3.0 / 商业双协议 ------AGPL 与 MIT/Apache/BSD 项目不兼容,闭源或宽松协议项目需购买商业授权(仅内部/生产使用本身不强制购买,详见仓库 Licensing 说明)。选型建议:老项目继续用 MIT 版没问题;新项目若愿意接受 AGPL 或付费则上 X,否则可评估 torchvision transforms 等替代。与本文的关系:第六章手工造的翻转/提亮/裁剪三个变体,就是 Albumentations 一行A.Compose的工业级版本------真要训自定义模型时,数据增强环节的直接候选。