Haplotype-resolved chromosome-level genome assembly of an autohexaploid oil camellia tree Camellia osmantha
六倍体茶Camellia osmantha多倍体油茶(Camellia osmantha)分型染色体水平基因组组装
摘要
山茶属植物是全球主要木本油料资源之一。油茶类大多为多倍体,给基因组组装带来诸多技术难题,尤其在单倍型解析层面 。本研究利用 PacBio HiFi 长读长序列与 Hi-C 数据,对重要同源六倍体油茶品种 ------六倍体茶Camellia osmantha '宜丹'( Camellia osmantha 'Yidan') 开展单倍型解析的染色体水平基因组组装。组装得到基因组大小为 14.38 Gb,其中 11.08 Gb(占 77.05%)挂载至 90 条染色体水平假分子,对应 6 套可区分等位基因的单倍型。最大单倍型基因组大小达 2.73 Gb;其组装质量优异,contig N50 为 1.69 Mb,scaffold N50 为 166.34 Mb,通用单拷贝直系同源基因完整度(BUSCO)达 95.79%,长末端重复序列组装指数(LAI)为 14.19。本研究共预测得到 60212 个蛋白编码基因,包含 3269 个转录因子、2655 个抗病类似基因、80 个油脂合成相关基因以及 497 个开花相关基因。本研究获得的数据可为解析油茶经济性状变异的遗传基础、助力油茶育种研究提供宝贵资源。
背景与概述
山茶属(山茶科)包含多个具有重要经济价值的物种,可用于生产茶叶、油脂、药材等多种产品。其中,山茶籽榨取的油脂可食用,因其化学组成与橄榄油高度相似,被誉为 "东方橄榄油"。山茶是全球四大木本油料作物之一(另外三种为油棕、椰子、油橄榄)。此外,山茶油含有多种生物活性物质,具备抗氧化、抗炎、护肝以及预防心血管疾病等有益于人体健康的功效。在中国,普通油茶(油茶组)是栽培面积最大的油用山茶物种,2020 年种植总面积达 439 万公顷。六倍体茶Camellia osmantha(拟山茶组)是新定名的油用山茶物种,具备耐热、耐寒、耐旱以及产油量高等多项经济优势。例如,六倍体茶Camellia osmantha品种'宜丹'栽种第 5 年的年均产油量可达 1590 千克 / 公顷,显著高于普通油茶优良品种(750 千克 / 公顷)。因此,六倍体茶Camellia osmantha在提升山茶油产量、扩大栽培区域方面潜力巨大。
油用山茶大多为多倍体:普通油茶除二倍体(2n = 2x = 30)外,还存在四倍体、六倍体;越南油茶则有七倍体、八倍体。六倍体茶Camellia osmantha基因组大小介于 5.12~9.31 Gb 之间;结合普通油茶二倍体基因组大小 2.95 Gb 估算,六倍体茶Camellia osmantha对应四倍体至六倍体水平。在基因组测序层面,多倍体会给基因组片段组装带来诸多技术难点,包括巨大的计算量、全基因组复制事件与高杂合度的处理,以及合适组装算法的选择。这类难题在同源多倍体中尤为突出,六倍体茶Camellia osmantha等多数油用山茶很可能属于同源多倍体。目前已有 5 个油用山茶物种完成基因组测序:普通油茶、狭叶油茶、浙江红花油茶、博白大果油茶、小果油茶。出于组装难度考量,这些研究大多采用二倍体材料,仅普通油茶与小果油茶为多倍体。而在油用山茶中,仅四倍体普通油茶和小果油茶获得了单倍型解析(分型)基因组。单倍型信息能够构建更精准的参考基因组,有助于解析等位基因特异性功能,例如等位基因表达与杂种优势。近年来,测序技术与组装算法的长足进步极大推动了多倍体植物单倍型解析基因组的组装,柿、马铃薯等物种均已有相关报道。
本研究整合 PacBio HiFi 高精度长读长、高通量染色体构象捕获(HiC)以及转录组测序(RNAseq)数据,完成了首个六倍体油用山茶的单倍型解析、染色体水平基因组组装与注释工作。本研究选取同源六倍体油用山茶品种六倍体茶Camellia osmantha'宜丹'开展基因组测序。基因组组装总大小 14.38 Gb,其中 11.08 Gb(77.05%)挂载到 90 条染色体水平假分子,对应 6 套可区分等位基因的单倍型。最大单倍型基因组大小 2.73 Gb;其组装质量优异:contig N50 为 1.69 Mb,scaffold N50 为 166.34 Mb,BUSCO 完整度 95.79%,长末端重复序列组装指数(LAI)为 14.19。同时基于该最大单倍型注释得到蛋白编码基因。本研究获得的基因组数据将有助于深入解析油份品质、产量等经济性状的变异规律,推动栽培油用山茶的遗传改良。
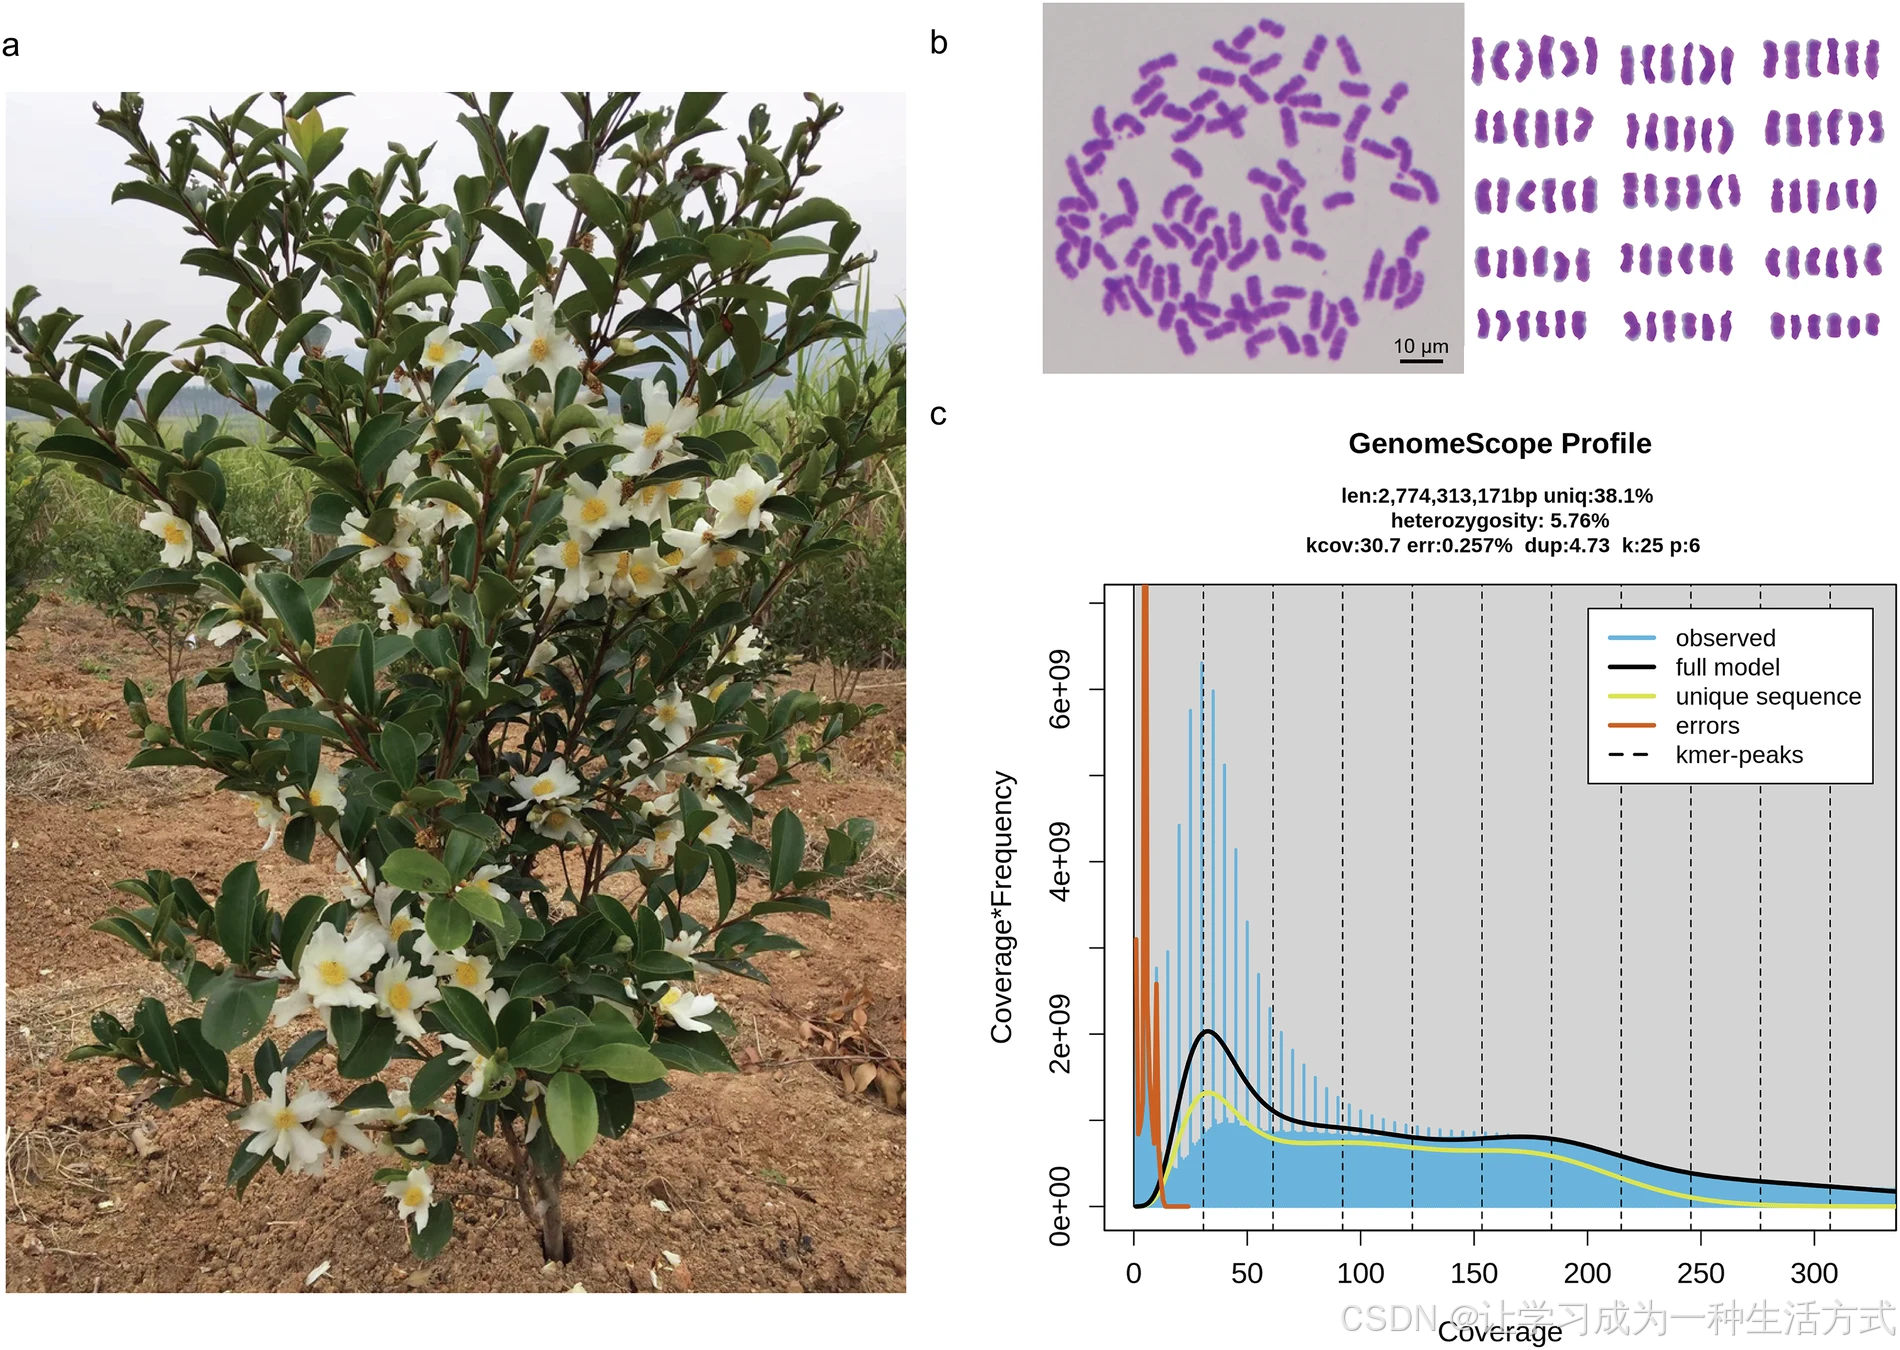
六倍体茶Camellia osmantha'宜丹'及其基因组特征。(a) 用于基因组测序的六倍体茶Camellia osmantha'宜丹'根插无性系植株。(b) 六倍体茶Camellia osmantha'宜丹'核型图。(c) 基于 K-mer(K=25)分析估算六倍体茶Camellia osmantha'宜丹'基因组大小。
|--------------------------------------|-------------------------|
| Assembly statistics | Value estimated |
| Total size (Mb) | 2725.26 |
| Number of chromosome-scale scaffolds | 15 |
| N50 of scaffolds (Mb) | 166.34 |
| Chromosome-scale scaffolds (Mb) | 2403.10 |
| GC content | 37.70% |
| Number of protein-coding genes | 60,212 |
| Percentage of repetitive sequences | 60.25% |
| Percentage of genome BUSCOs | 95.79% |
| Short read mapping rate | 97.44% |
| Genome coverage | 99.40% |
| LTR assembly index | 14.19 |
| Quality value | 40.04 |
方法
样品采集与测序
选取六倍体茶Camellia osmantha'宜丹'的一株根插无性分株植株用于基因组从头测序(附图 1)。该植株保存于广西林业科学研究院试验苗圃(北纬 22°55′51″,东经 108°20′03″)。采集新鲜叶片,经液氮快速冷冻后运回实验室,于−80 ℃条件下保存。
采用 DNeasy Plant Maxi 试剂盒(德国凯杰,希尔德)从叶片中提取基因组 DNA。构建插入片段约 350 bp 的短片段文库,利用 Illumina NovaSeq 6000 平台进行测序,得到 150 bp 双端读段。 按照试剂盒说明书构建插入片段约 20 kb 的 PacBio 长片段文库,在 PacBio Revio 平台开展环形一致性测序。使用 SMRTLink(v11.1.0)处理子读段,参数设置为 -minPasses 3 -minPredictedAccuracy 0.99 -minLength 500。
HiC 文库参照已有文献方法,采用 DpnII 限制性内切酶酶切进行构建,并使用 Illumina NovaSeq 6000 平台测序。 为辅助基因注释,提取六倍体茶Camellia osmantha'宜丹'新鲜叶片的总 RNA;按照试剂盒说明书,使用 NEBNext® Ultra™ RNA Library Prep Kit for Illumina®(美国 NEB,伊普斯维奇)构建 cDNA 文库,同样在 Illumina NovaSeq 6000 平台测序,产出 150 bp 双端读段。
使用 fastp(v0.23.0)默认参数对测序读段进行质量质控。六倍体茶Camellia osmantha'宜丹'DNA 测序共获得 110.50 Gb 高质量短读段、570.86 Gb HiFi 读段(N50 长度 14479 bp)以及 119.79 Gb HiC 高质量读段(表 2);转录组测序得到 15.11 Gb 高质量 RNAseq 读段(表 2)。所有高质量读段用于后续分析。
|------------------------------|-------------------------|---------------------------|----------------------------------|
| Type of reads | Number of reads | Total length (Gb) | N50 length of reads (bp) |
| Short sequencing raw reads | 740,669,172 | 111.10 | 150 |
| Short sequencing clean reads | 739,914,440 | 110.50 | 150 |
| PacBio HiFi reads | 40,375,397 | 570.86 | 14,479 |
| Hi-C raw reads | 818,307,538 | 122.75 | 150 |
| Hi-C clean reads | 810,979,528 | 119.79 | 150 |
| RNA-seq raw reads | 101,656,570 | 15.25 | 150 |
| RNA-seq clean reads | 101,656,570 | 15.11 | 150 |
核型分析与基因组特征评估
取健康根插幼苗的根尖,冰水条件下清洗;参照已发表文献方法进行预处理、固定、酶解和制片。使用奥林巴斯 BX61 显微镜(日本奥林巴斯公司,东京)完成镜检与拍照。挑选 30 套染色体形态完整的中期分裂相细胞,开展染色体计数与配对分析。核型分析结果表明,六倍体茶Camellia osmantha'宜丹'为六倍体,单个体细胞染色体数目为 90 条(附图 1)。
基于 PacBio HiFi 读段开展 K-mer(K=25)频率分析,评估基因组大小、重复序列占比以及杂合率等基因组特征。使用 Jellyfish 2.1.3 软件统计 K-mer 数目,再利用 GenomeScope2(v2.0)估算基因组参数。K-mer 分析结果显示,六倍体茶Camellia osmantha单倍型基因组大小为 2.77 Gb,杂合率 5.76%(附图 1)。
基因组组装与染色体挂载
使用 Hifiasm(v0.19.6)对 PacBio HiFi 读段进行组装,得到 contig 序列。初步组装基因组总大小 12.35 Gb,contig N50 为 272 839 bp。
为区分等位 contig,本研究采用 Purge Haplotigs 流程进行迭代处理。简要流程:将初始组装结果输入 Purge Haplotigs,输出两组序列文件,即代表单倍型 1 的校正组装文件(curated.fasta),以及重新分配得到的 contig 文件(first_round.curated.haplotigs.fasta)。将上一步输出的重分配 contig 再次导入 Purge Haplotigs 处理,得到代表单倍型 2 的校正文件和新一轮迭代重分配 contig 文件(second_round.curated.haplotigs.fasta)。共计完成 5 轮迭代重分配,最终获得 6 套单倍型序列。
利用 Bowtie2(v2.2.9)将 Hi-C 高质量读段比对至各套单倍型序列;通过 HiCPro 流程过滤低质量读段;有效交互读段用于 contig 挂载,结合 Juicer(v1.6)与 3DDNA(v180419)构建染色体水平组装。依据染色质交互信号人工校正组装错误,使用 Juicebox(v2.13.07)可视化 HiC 交互热图。 随后分别使用 GapCloser(v1.10.1)基于 Illumina 短读段、LR_Gapcloser 基于 PacBio HiFi 读段对组装结果进行缺口填补。
最终组装基因组总大小 14.38 Gb;其中 11.08 Gb(占 77.05%)序列挂载至 90 条染色体水平假分子,对应 6 套可区分等位基因的单倍型(Haplotype16,表 3)。6 套单倍型最终长度介于 1.612.75 Gb(表 3)。不同单倍型之间染色体具有共保守性(附图 2),提示六倍体茶Camellia osmantha'宜丹'大概率为同源六倍体品种。 其中 1 号单倍型基因组大小 2.73 Gb,与 Kmer 预估的 2.77 Gb 十分接近,contig N50 为 1.69 Mb,scaffold N50 为 166.34 Mb(表 3,附图 3)。因此,若无特殊说明,后续分析均采用 1 号单倍型。
|-----------------------------|---------------------|---------------------|---------------------|---------------------|---------------------|---------------------|
| Chromosome or index | Haplotype 1 | Haplotype 2 | Haplotype 3 | Haplotype 4 | Haplotype 5 | Haplotype 6 |
| Chr1 | 202,129,280 | 200,835,756 | 173,719,330 | 151,810,447 | 120,788,037 | 34,951,169 |
| Chr2 | 188,939,760 | 184,612,937 | 164,409,342 | 155,357,065 | 123,915,767 | 58,254,187 |
| Chr3 | 185,799,836 | 164,672,538 | 170,362,315 | 154,225,774 | 135,788,895 | 57,767,525 |
| Chr4 | 182,152,355 | 167,401,091 | 182,480,219 | 163,479,351 | 134,205,736 | 37,099,588 |
| Chr5 | 177,769,640 | 167,384,034 | 170,195,044 | 160,222,872 | 136,187,135 | 54,993,873 |
| Chr6 | 177,619,073 | 164,492,368 | 162,137,738 | 158,311,626 | 133,047,936 | 66,360,661 |
| Chr7 | 173,096,607 | 157,029,161 | 149,088,083 | 145,816,677 | 109,778,458 | 46,567,803 |
| Chr8 | 166,339,888 | 155,024,449 | 129,335,523 | 132,008,795 | 102,559,917 | 44,864,744 |
| Chr9 | 160,755,191 | 143,717,321 | 154,397,254 | 136,027,817 | 117,672,906 | 54,528,463 |
| Chr10 | 151,114,349 | 141,286,958 | 147,361,729 | 122,937,440 | 109,460,814 | 34,350,899 |
| Chr11 | 137,626,397 | 118,931,804 | 114,325,070 | 115,310,276 | 81,807,884 | 43,737,912 |
| Chr12 | 134,291,341 | 127,883,038 | 117,735,807 | 98,070,773 | 74,937,465 | 34,738,436 |
| Chr13 | 132,813,485 | 126,125,974 | 117,181,857 | 112,311,457 | 90,441,874 | 41,413,405 |
| Chr14 | 126,573,778 | 120,042,340 | 105,973,092 | 111,413,192 | 75,710,351 | 31,727,185 |
| Chr15 | 106,082,296 | 94,057,038 | 95,027,809 | 86,991,341 | 70,146,605 | 24,643,402 |
| Total size (bp) | 2,725,260,600 | 2,747,734,782 | 2,505,081,209 | 2,424,724,921 | 2,359,613,995 | 1,613,292,350 |
| Contig N50 (bp) | 1,691,905 | 485,342 | 744,695 | 512,242 | 361,285 | 135,318 |
| Scaffold N50 (bp) | 166,339,888 | 143,717,321 | 149,088,083 | 136,027,817 | 102,559,917 | 453,176 |
| LTR assembly index (LAI) | 14.19 | 13.00 | 11.93 | 11.43 | 8.32 | 5.18 |
| Percentage of genome BUSCOs | 95.79% | 92.69% | 85.32% | 72.99% | 74.66% | 67.04 |
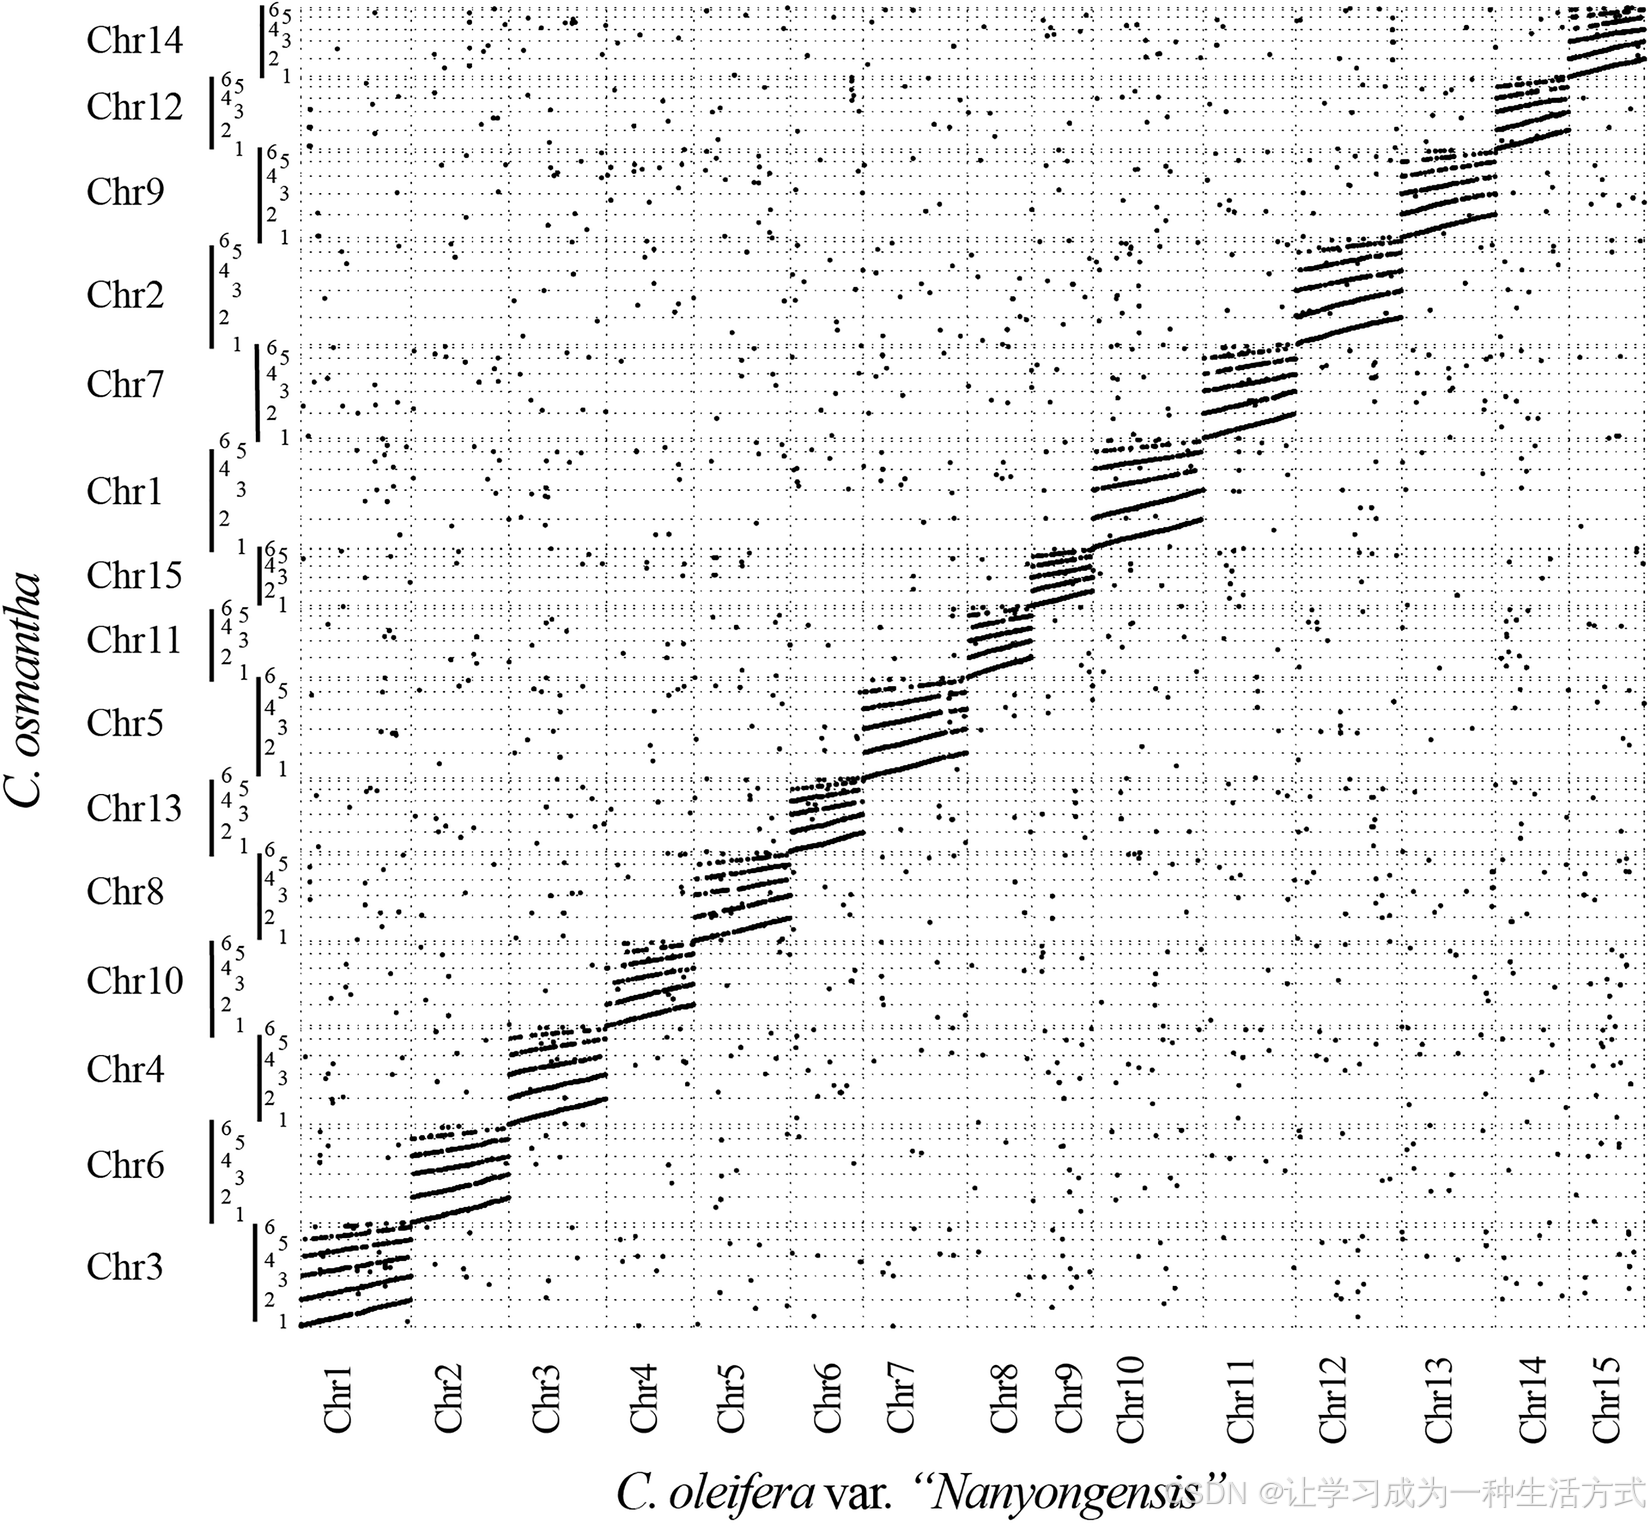
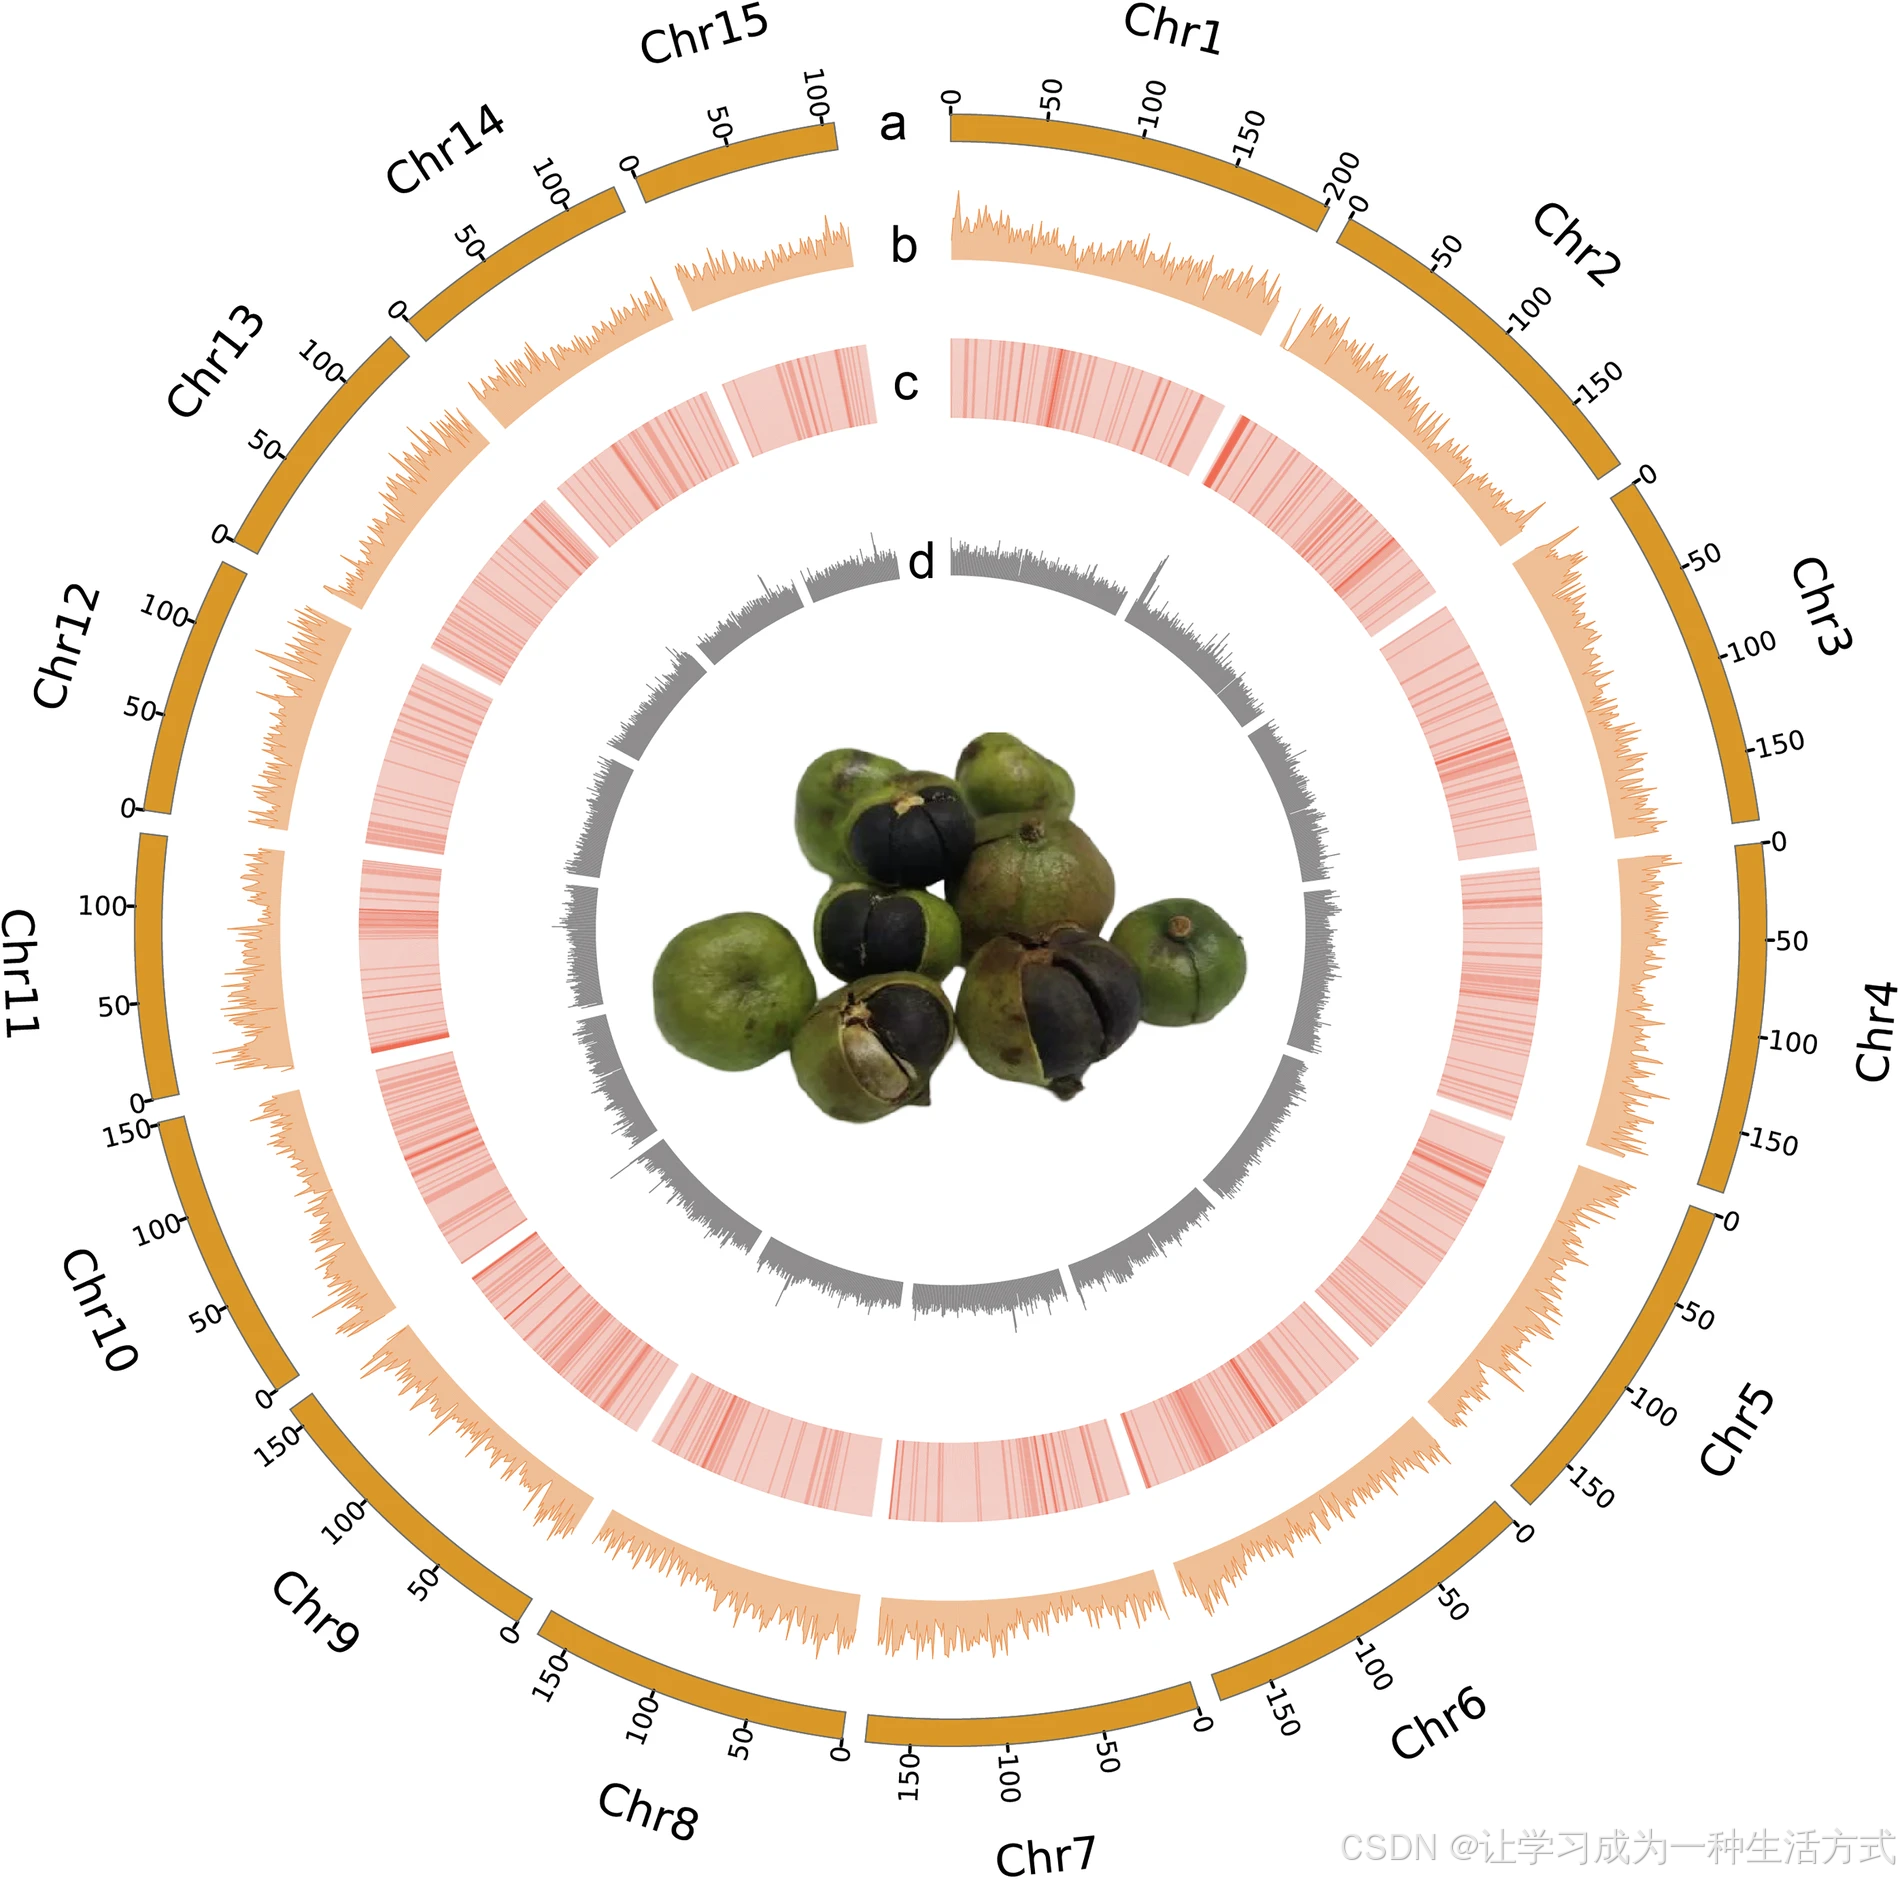
六倍体茶Camellia osmantha'宜丹'1 号单倍型染色体水平基因组组装的基因组景观图。(a) 染色体长度(单位:Mb);(b) 1-Mb 滑动窗口下的基因密度;(c) 1-Mb 滑动窗口下重复序列占比;(d) 1-Mb 非重叠窗口的 GC 含量。
重复序列鉴定
重复序列包含串联重复序列与散在重复序列。使用 Tandem Repeats Finder(v4.10)鉴定串联重复序列。利用 RepeatModeler(v1.0.8)和 LTR_FINDER(v1.0.6)对散在重复序列(也叫转座元件,TE)进行从头预测;再使用 RepeatMasker(v4.0.7),基于从头预测得到的重复序列库检索基因组内已知重复序列。同时调用 Repbase 数据库,通过 RepeatMasker(v4.0.7)的 RepeatProteinMask 模块检索已知转座元件。
本研究共鉴定得到约 1.64 Gb 重复序列;其中串联重复序列大小为 322 188 125 bp,散在重复序列大小为 1 444 938 910 bp,分别占基因组的 11.82% 与 53.02%。在散在重复序列中,长末端重复序列(LTR)、Ⅱ 类转座子、长散在核元件(LINE)分别占基因组的 48.00%、3.90%、1.97%(表 4)。
|----------------|---------------------|------------------------|---------------------|------------------------|---------------------|------------------------|---------------------|------------------------|
| Type | Repbase TEs || TE proteins || De novo || Combined TEs ** ||
| Type | Length (Mb) | Percentage (%) | Length (Mb) | Percentage (%) | Length (Mb) | Percentage (%) | Length (Mb) | Percentage (%) |
| Class I | 281.70 | 10.34 | 428.18 | 15.71 | 1244.42 | 45.66 | 1356.01 | 49.76 |
| LTR | 265.24 | 9.73 | 391.80 | 14.38 | 1227.99 | 45.06 | 1308.23 | 48.00 |
| Gypsy | 158.47 | 5.81 | 277.33 | 10.18 | 921.62 | 33.82 | 979.60 | 35.95 |
| Copia | 91.74 | 3.37 | 101.85 | 3.74 | 186.80 | 6.85 | 231.95 | 8.51 |
| LINE | 16.52 | 0.61 | 37.20 | 1.37 | 17.93 | 0.66 | 53.60 | 1.97 |
| SINE | 0.14 | 0.01 | --- | --- | 0.15 | 0.01 | 0.29 | 0.01 |
| Class II | 25.93 | 0.95 | 37.65 | 1.38 | 65.49 | 2.40 | 106.16 | 3.90 |
| Unclassified* | 0.01 | 0.00 | --- | --- | 4.19 | 0.15 | 4.20 | 0.15 |
| Total | 306.17 | 11.23 | 464.42 | 17.04 | 1305.95 | 47.92 | 1444.94 | 53.02 |
蛋白编码基因注释
本研究结合转录组证据注释、同源序列注释以及从头预测三种策略完成蛋白编码基因注释。 转录组证据注释:使用 HISAT(v2.0.1)将高质量 RNAseq 读段比对至 1 号单倍型基因组;再分别采用 StringTie(v1.2.2)进行转录本组装、TransDecoder(v5.7.1)鉴定候选编码区。 同时利用 Trinity(v2.11.0)对 RNAseq 高质量读段进行组装,参数设置为 --genome_guided_bam RNA-seq.sorted.bam --full_cleanup --genome_guided_max_intron 10000 --min_kmer_cov 3 --min_glue 3。将组装得到的转录本通过 PASA(v2.4.1)比对到 1 号单倍型基因组,依据有效转录本比对结果生成基因结构。
同源序列注释:选取 7 个物种(中华猕猴桃、拟南芥、狭叶油茶、普通油茶、茶树、山茶、浙江红花油茶)的基因组蛋白集,使用 GeMoMa(v1.9)比对至 1 号单倍型基因组,获取同源基因结构。
从头预测:在经过软掩码处理的 1 号单倍型基因组上,使用 Helixer 与 Augustus 软件预测编码区。
利用 EvidenceModeler(v2.1.0)整合以上全部基因预测结果;各类证据权重设置:PASA 预测证据权重 10,StringTie 预测证据权重 5,GeMoMa 预测证据权重 5,从头预测证据权重 1。
使用自研 Perl 脚本对基因模型进行质量过滤,过滤条件如下: (i) 开放阅读框不完整的基因; (ii) 蛋白编码区长度小于 150 个核苷酸的短基因; (iii) 内部存在终止密码子的基因; (iv) 仅含单个外显子且无已知蛋白结构域的基因; (v) 仅由从头预测证据支持、且无蛋白结构域的基因; (vi) 编码序列中转座元件覆盖度≥30%,或含有转座酶 / 转座子 / 反转录转座子结构域的基因。
过滤后的基因模型再次输入 PASA(v2.4.1),完成非翻译区以及可变剪接位点预测。最终共预测得到 60 212 个蛋白编码基因(表 5,附图 3)。
将整合后的基因集翻译为氨基酸序列,使用 DIAMOND(v0.9.30)开展功能注释,E-value 阈值设为 1e-5,比对 4 个公共数据库:NCBI 非冗余蛋白数据库(NR)、Swiss-Prot、京都基因与基因组百科全书(KEGG)、TrEMBL 数据库。同时采用 InterProScan(v5.59-91.0)鉴定基因的基因本体(GO)条目。
|----------|-----|---------------------|--------------------|
| Type || Gene number | Percentage |
| Total || 60,212 | 100% |
| NR || 59,478 | 98.78% |
| Swissprot || 39,304 | 65.28% |
| KEGG || 41,170 | 68.38% |
| TrEMBL || 59,340 | 98.55% |
| InterPro | All | 57,887 | 96.14% |
| InterPro | GO | 35,298 | 58.62% |
| Annotated || 59,769 | 99.26% |
| Unannotated || 443 | 0.74% |
基因表达与功能基因鉴定
利用 RSEM(v1.3.1)对 RNAseq 比对得到的计数矩阵计算每千碱基每百万比对片段数(FPKM),开展基因表达分析。结果显示共有 28 615 个基因(占全部基因的 47.52%)存在可检测的转录活性(FPKM ≥ 1)。
参照 PlantTFDB 5.0 数据库鉴定转录因子(TF),共得到分属于 58 个转录因子家族的 3 269 个转录因子(附图 4)。使用 RGAugury 流程在全部基因集中筛选抗病类似基因(RGA)。开花相关基因、油脂合成相关基因分别来源于 PFGD 数据库与狭叶油茶基因组。随后,将 1 号单倍型的氨基酸序列通过 DIAMOND(v0.9.30)比对至上述参考基因的蛋白序列,依据最优比对结果提取候选功能基因,并结合注释信息开展人工核查。
最终鉴定得到 2 655 个抗病类似基因与 497 个开花相关基因。本研究共识别 80 个油脂合成相关基因,其中包含 7 个生物素羧基载体蛋白基因、2 个生物素羧化酶基因、7 个羧基转移酶基因、2 个乙酰辅酶 A 羧化酶基因、8 个硬脂酰ACP 去饱和酶基因、16 个脂肪酸去饱和酶基因、19 个二酰甘油O酰基转移酶基因、7 个磷脂:二酰甘油酰基转移酶基因以及 12 个甘油3磷酸脱氢酶基因(附图 4)。
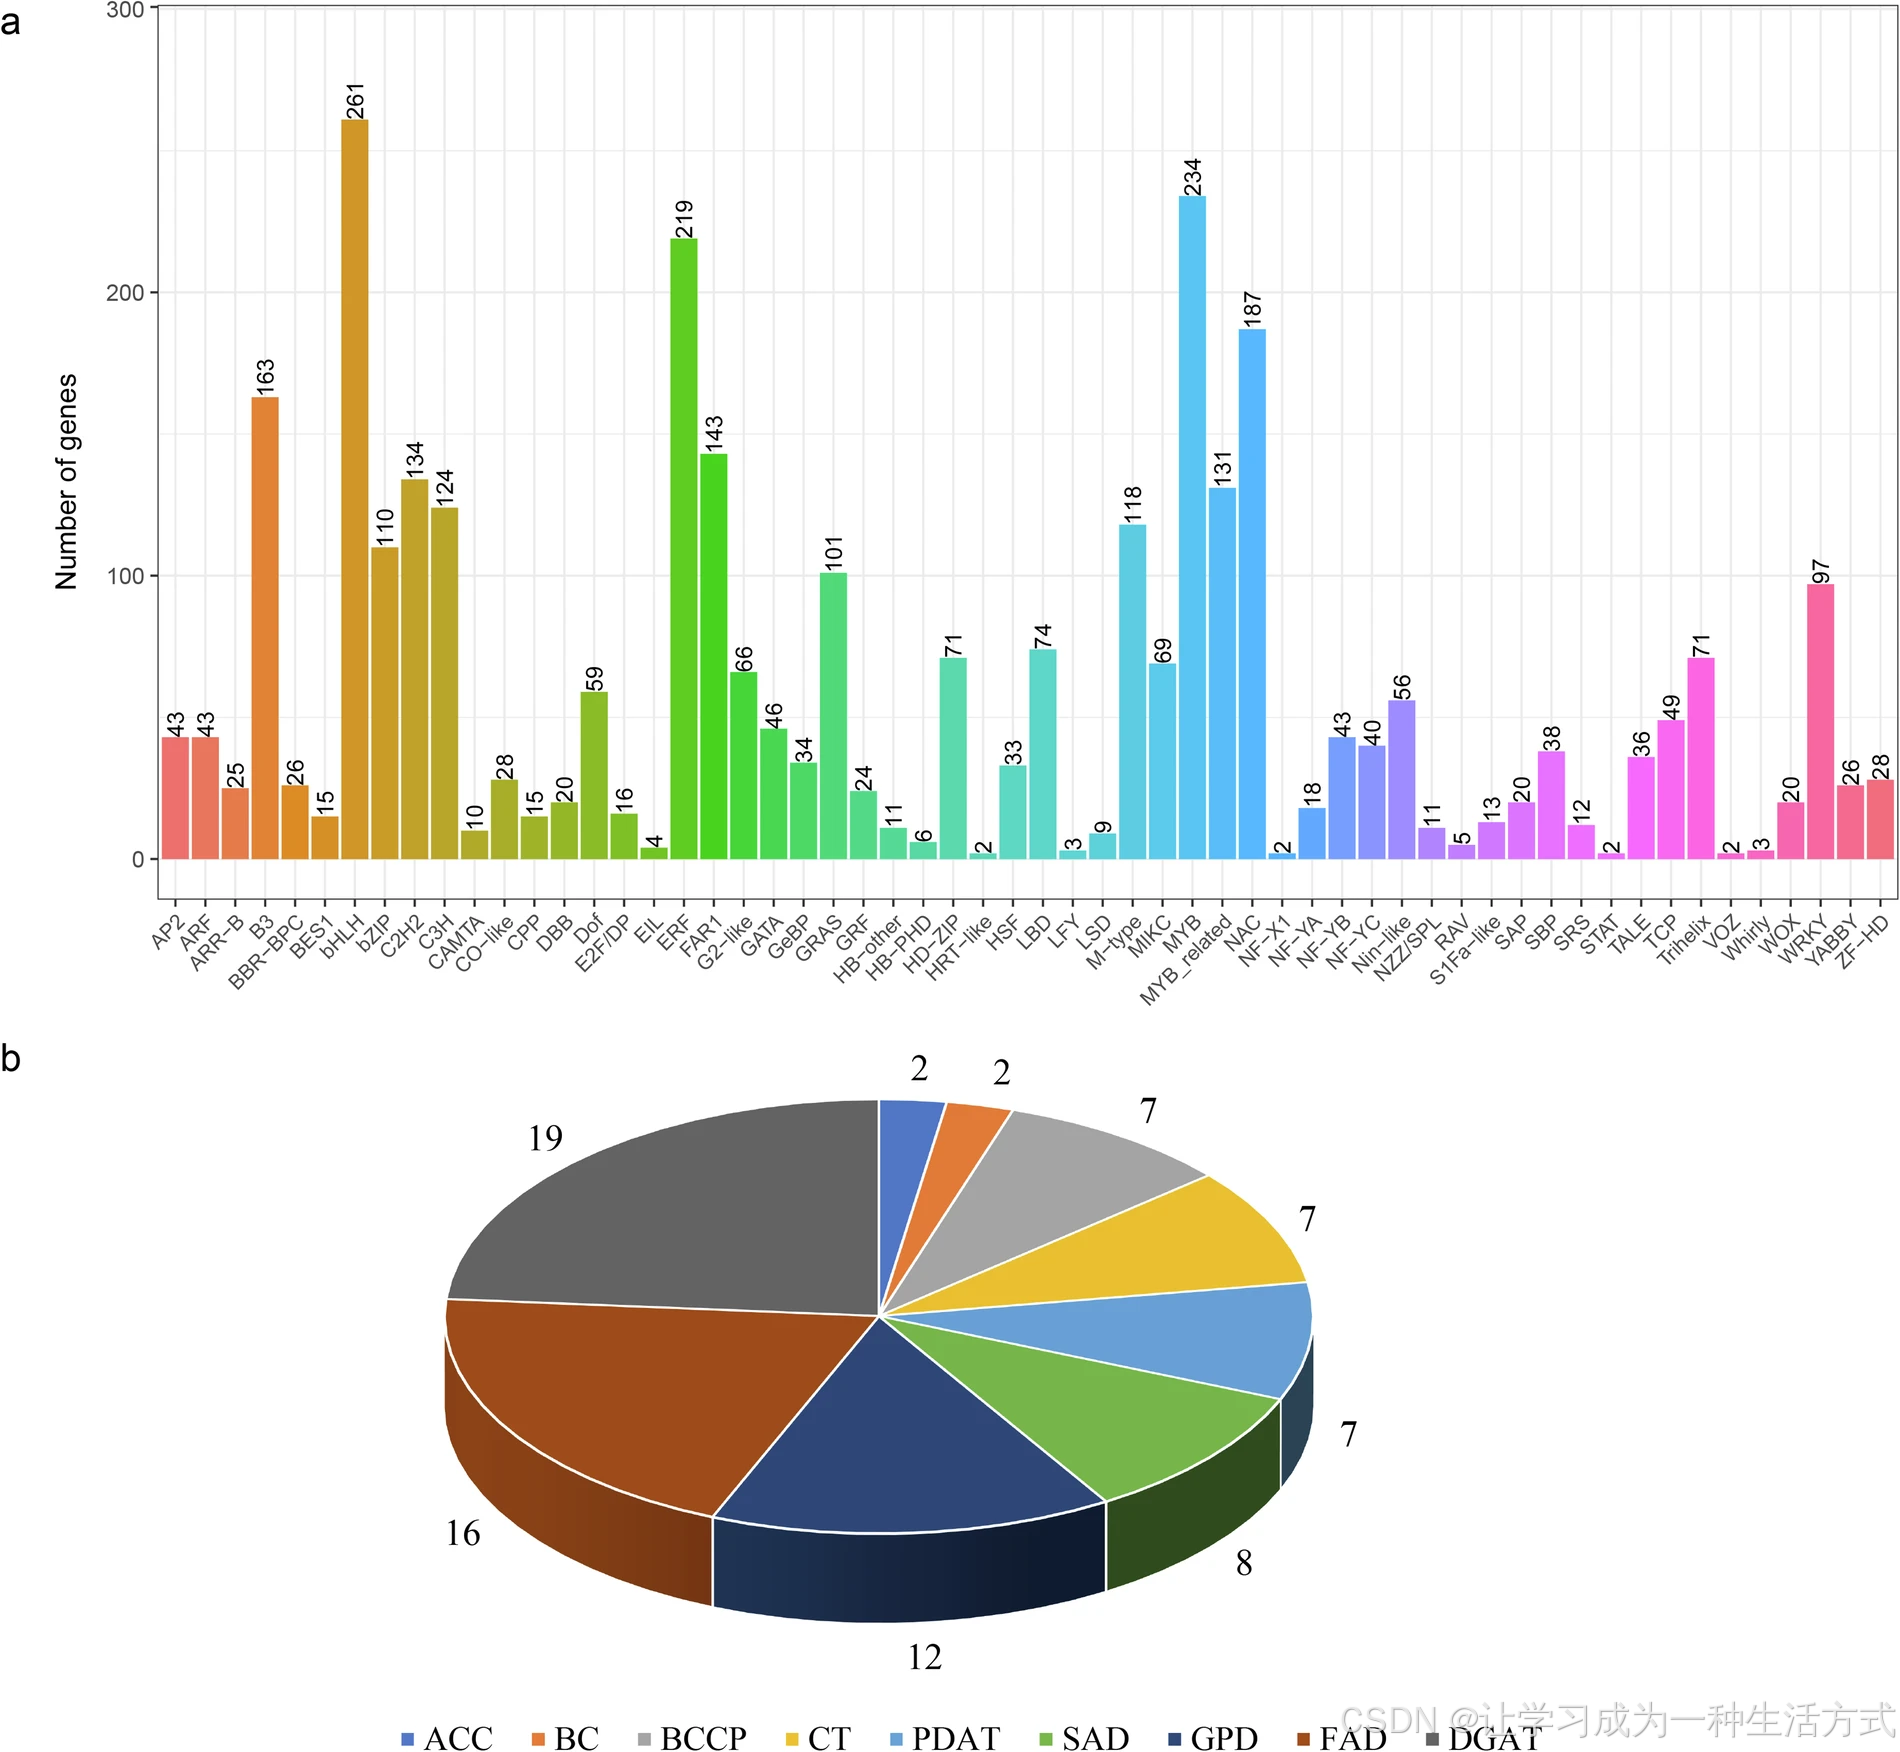
六倍体茶Camellia osmantha(Camellia osmantha)基因组基因注释结果。(a) 六倍体茶Camellia osmantha基因组预测得到的转录因子;(b) 六倍体茶Camellia osmantha基因组中预测的 80 个油脂合成相关基因。 缩写说明:ACC,乙酰辅酶 A 羧化酶;BC,生物素羧化酶;BCCP,生物素羧基载体蛋白;CT,羧基转移酶;PDAT,磷脂:二酰甘油酰基转移酶;SAD,硬脂酰ACP 去饱和酶;GPD,甘油3磷酸脱氢酶;FAD,脂肪酸去饱和酶;DGAT,二酰甘油O酰基转移酶。
非编码 RNA 注释
本研究共预测 4 类非编码 RNA:转运 RNA(tRNA)、核糖体 RNA(rRNA)、微小 RNA(miRNA)与小核 RNA(snRNA)。 使用 tRNAscan-SE(v1.3.1)预测 tRNA;采用 BLASTN 程序(E-value≤1e-5),比对拟南芥与水稻公开 rRNA 序列,鉴定 rRNA;利用 Infernal(v1.1.1)比对 Rfam 数据库(v12.0)识别 miRNA 与 snRNA。 共注释得到 2 734 条非编码 RNA,包含 180 条 miRNA、946 条 tRNA、514 条 snRNA 以及 1 094 条 rRNA(表 6)。
|--------------|--------------------------|-----------------------------|---------------------------|-------------------------|
| Type | Number of copies | Average length (bp) | Total length (bp) | % of the genome |
| miRNA | 180 | 122 | 21,962 | 0.00081 |
| tRNA | 946 | 76 | 71,807 | 0.00264 |
| rRNA | 1,094 | 172 | 187,773 | 0.00689 |
| 18S | 153 | 673 | 102,928 | 0.00378 |
| 28S | 195 | 127 | 24,851 | 0.00091 |
| 5.8S | 56 | 138 | 7,726 | 0.00028 |
| 5S | 690 | 76 | 52,268 | 0.00192 |
| snRNA | 514 | 117 | 60,314 | 0.00221 |
| CD-box | 248 | 101 | 25,057 | 0.00092 |
| HACA-box | 109 | 127 | 13,813 | 0.00051 |
| Splicing | 157 | 137 | 21,444 | 0.00079 |
| Total | 2,734 | --- | 341,856 | --- |
技术验证
本研究采用多种方法评估基因组组装的准确性与完整度。HiC 热图显示各条染色体交互模式均一,证实组装基因组中 contig 的排序与方向结果准确(附图 5)。利用 JCVI(v1.1.18)开展共线性分析,六倍体茶Camellia osmantha基因组分别与茶树、普通油茶、狭叶油茶基因组均表现出良好的共线性关系(附图 5)。此外,短读长测序数据中有 97.44% 的读段可以比对回组装基因组,基因组覆盖度达 99.40%(表 1)。
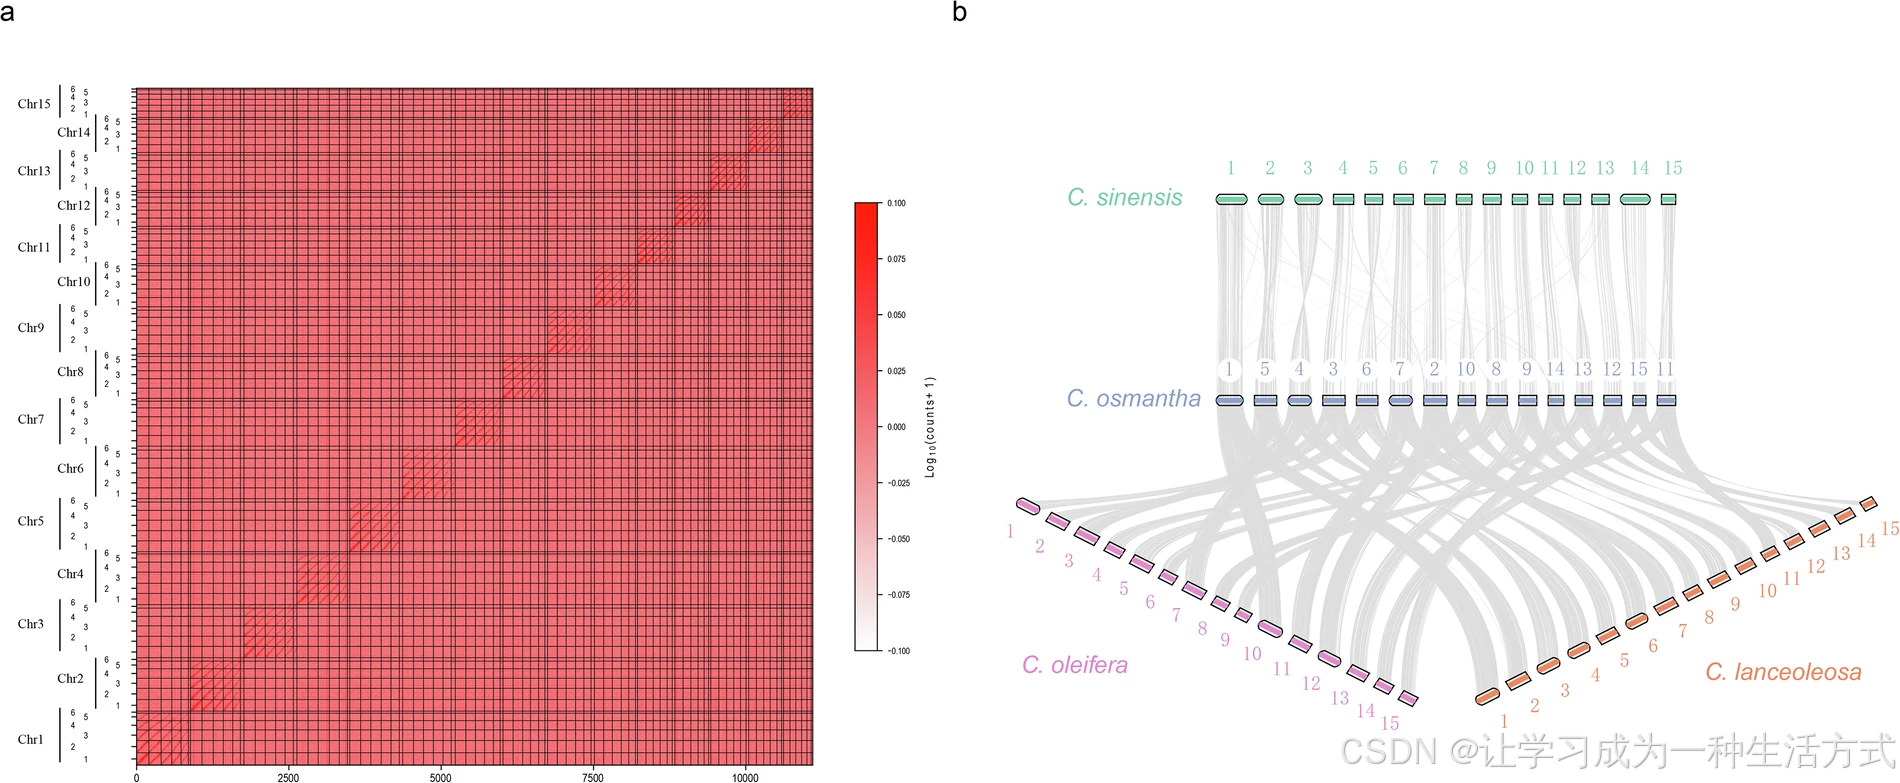
六倍体茶Camellia osmantha'宜丹'基因组组装高质量验证。(a) 基于 Hi-C 数据得到的全部 90 条假染色体的全基因组染色质交互热图;(b) 六倍体茶Camellia osmantha分别与茶树、普通油茶、狭叶油茶的基因组共线性;图中展示包含大于 30 个一对一基因对的宏观共线性区块。
除核型分析之外,本研究通过分析共线性旁系同源基因对的全基因组同义替换位点速率(Ks),进一步评估六倍体茶Camellia osmantha'宜丹'的染色体倍性。为推断全基因组复制(WGD)事件,本研究纳入 3 个山茶属二倍体物种(普通油茶、狭叶油茶、茶树)以及葡萄的基因组用于 Ks 值估算。使用 MCScan 软件(默认参数)识别共线性区块,每个区块至少包含 5 对共线性基因;采用 KaKs_Calculator(v3.0)计算 Ks 值。
一般而言,同源多倍体仅会出现单一 Ks 峰,代表一次发生于共有多倍化事件之后的近代全基因组复制;而异源多倍体则会出现多个 Ks 峰,既反映祖先基因组分化,也体现后续可能发生的杂交加倍事件。本研究中六倍体茶Camellia osmantha仅检测到 1 个近代 Ks 峰(附图 6);该 Ks 峰晚于葡萄葡萄比对结果所代表的核心真双子叶植物 γ 三倍化事件。该分布模式与 3 个二倍体山茶属物种的结果一致,支持六倍体茶Camellia osmantha最可能为同源多倍体起源。
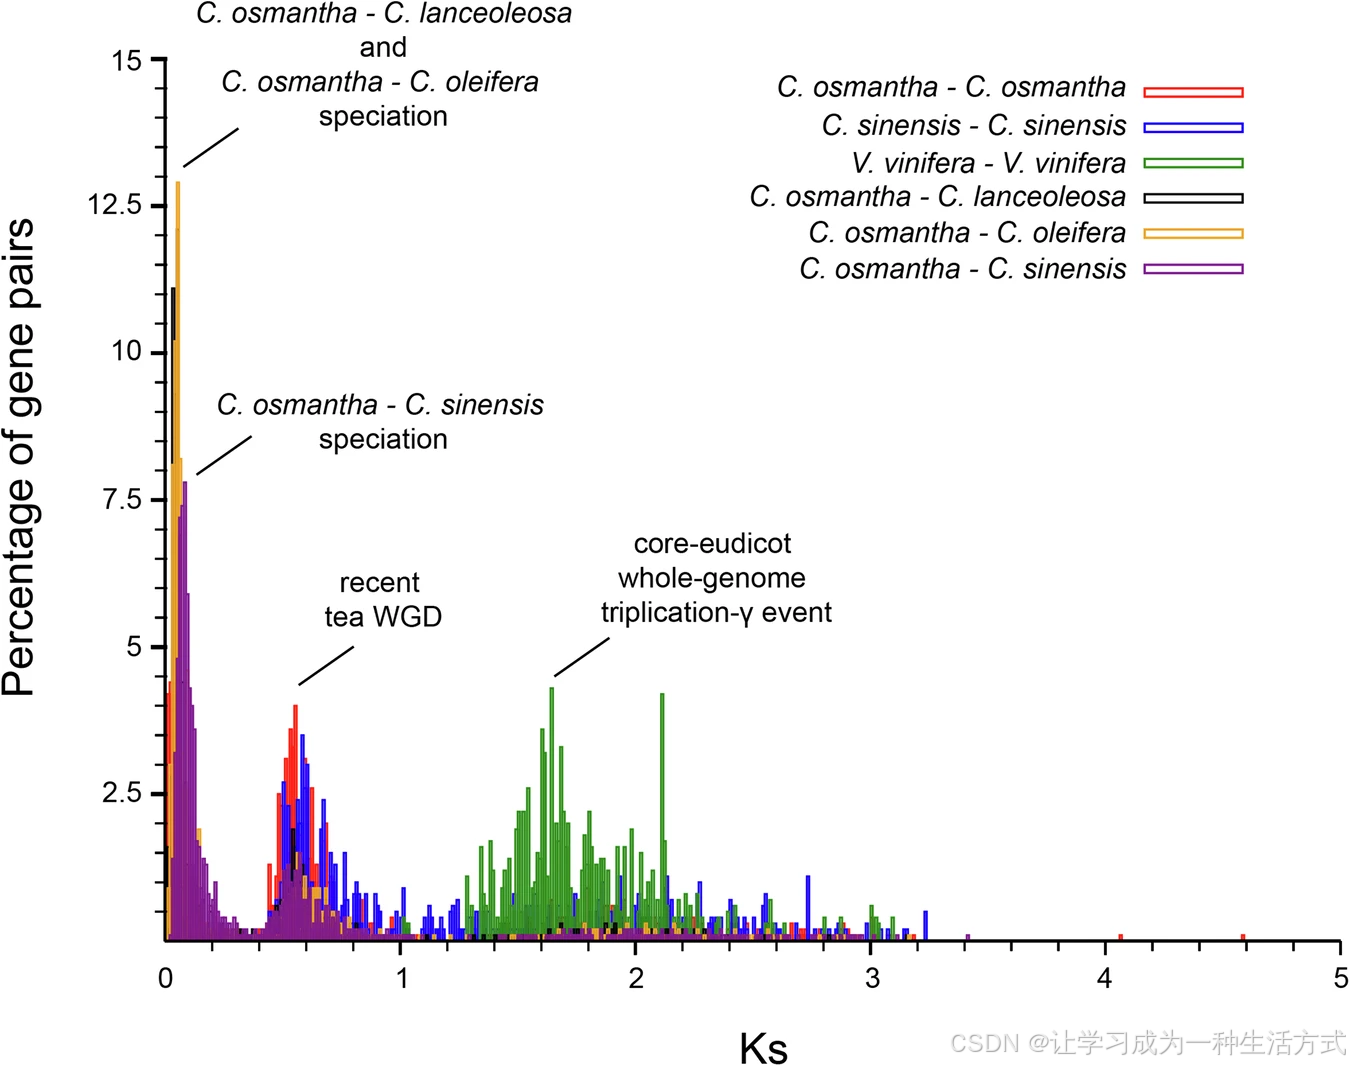
基于六倍体茶Camellia osmantha以及另外 4 个二倍体物种(普通油茶、狭叶油茶、茶树、葡萄)内部共线性旁系同源基因对的 Ks 分布揭示全基因组复制事件。
在获得的 6 套单倍型中,依据 Ou 等人的划分标准,4 套单倍型的 LAI 值介于 11.43-14.19,属于参考级组装(10 ≤ LAI < 20) ;另外 2 套单倍型 LAI 为 5.18-8.32,属于草图级组装(0 ≤ LAI < 10)。 针对 1 号单倍型,使用 Merqury(v1.3),设置 17mer 开展组装质量评估,得到 QV 质量值为 40.04(表 1)。采用 BUSCO(v5.5.0),调用 embryophyta_odb10 数据库评估基因组完整度,数据库共计 1614 个陆生植物直系同源基因,其中 1546 个被检出,完整度 95.79%(表 1)。
预测得到的蛋白编码基因中,59 769 个基因(占 99.26%,表 5)至少含有 1 个保守功能结构域。与近缘物种相比,mRNA、编码序列、外显子以及内含子的长度分布模式相近,证明注释结果可靠(附图 7)。综合以上各项验证结果,表明六倍体茶Camellia osmantha这套单倍型解析基因组组装具备优异的质量与可靠性。
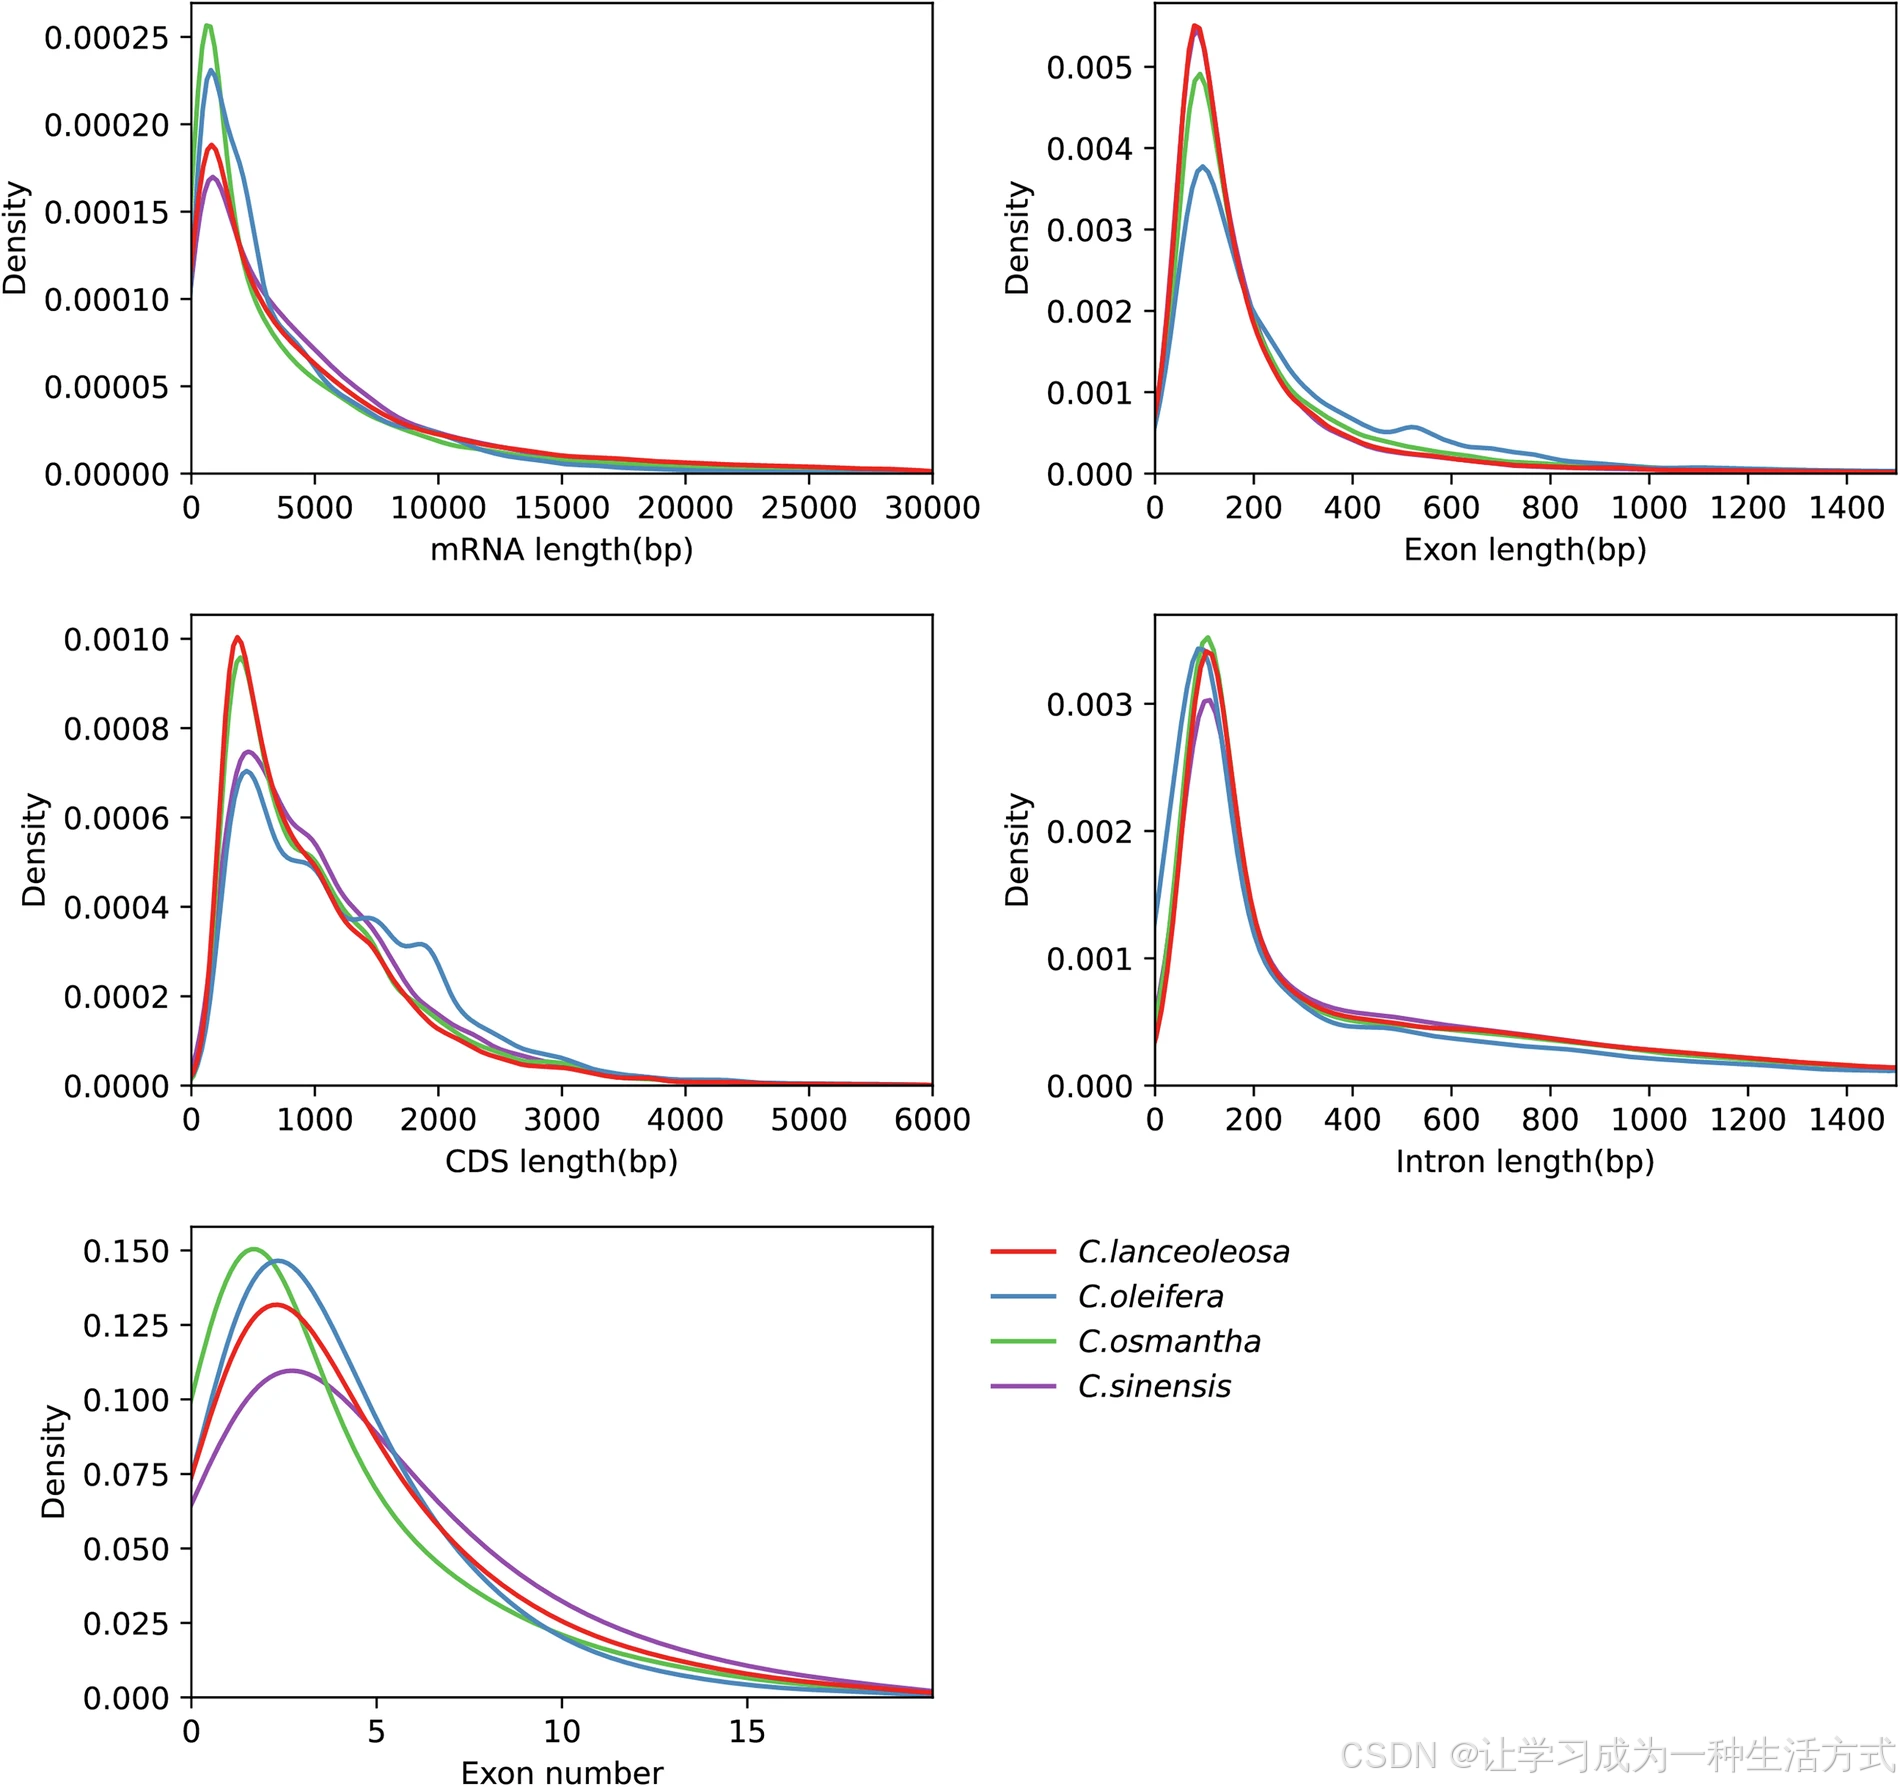
六倍体茶Camellia osmantha、茶树、普通油茶与狭叶油茶的信使 RNA(mRNA)、编码序列(CDS)、外显子、内含子长度分布以及外显子数量比较。4 个山茶属物种之间未出现明显的异常差异,说明基因结构注释质量较高。
Data availability
Raw sequencing data have been deposited in the NCBI SRA database under BioProject number PRJNA1095241, with accession numbers as follows: PacBio HiFi: SRR28582037; Hi-C: SRR28582036; RNA sequencing: SRR28582034; and DNA short-read sequencing: SRR28582035. The genome assembly is accessible in NCBI GenBank with accession number GCA_054643635.1. The genome assembly data, annotation files (GFF3, FASTA), gene functional annotation datasets, and the list of flower-related genes are available via Figshare at https://doi.org/10.6084/m9.figshare.25507024.v2. All datasets are publicly accessible without restrictions.