之前我在掘金写过一篇文章:《老婆天天吵吵要买塔罗牌,我直接用 AI 2 小时写了个在线塔罗牌》。
老婆对塔罗感兴趣,我又是做前端的,就试着做了一个能抽牌、翻牌、展示牌义和 AI 解读的网站。借助 AI,两个小时,主要流程就跑通了。
当时觉得,接下来补上登录和支付,差不多就能上线。
现在登录和支付都有了,还加了每日一牌、主题探索、个人旅程和结伴同行,项目也改名叫 Mystic Journey。但到现在,还是没什么用户。
中文入口在这里:Mystic Journey
这篇没有收入截图,也没有从零做到多少用户的经验。想接着上一篇,聊聊我后来做了什么,为什么改了方向,以及一个习惯写代码的人,开始自己做产品后遇到的麻烦。也顺便给自己的产品做个推广。
抽牌之后,还能留下什么
最开始做塔罗,确实有一部分原因是它适合做交互。卡牌展开、翻转、光效,写起来有意思,做出来也容易看到效果。
但体验完整个流程,基本就是输入问题、抽牌、看解读,然后关掉页面。有事想问的时候可能再来,平时没有打开它的理由。牌义解释本身也谈不上优势,通用 AI 就能做。
我没有删掉这部分,而是把它留下作为深度解读,另外做了一个更轻的日常入口。
每日一牌的流程很短:选一下今天的心情,翻开当天的牌,读一个反思问题。如果有想说的,就留下几句话;没有,也可以结束。
它可以当日记,也可以当每日总结,甚至只是收集牌面。我不想让用户每次打开网站,都得先准备一个值得认真讨论的问题。
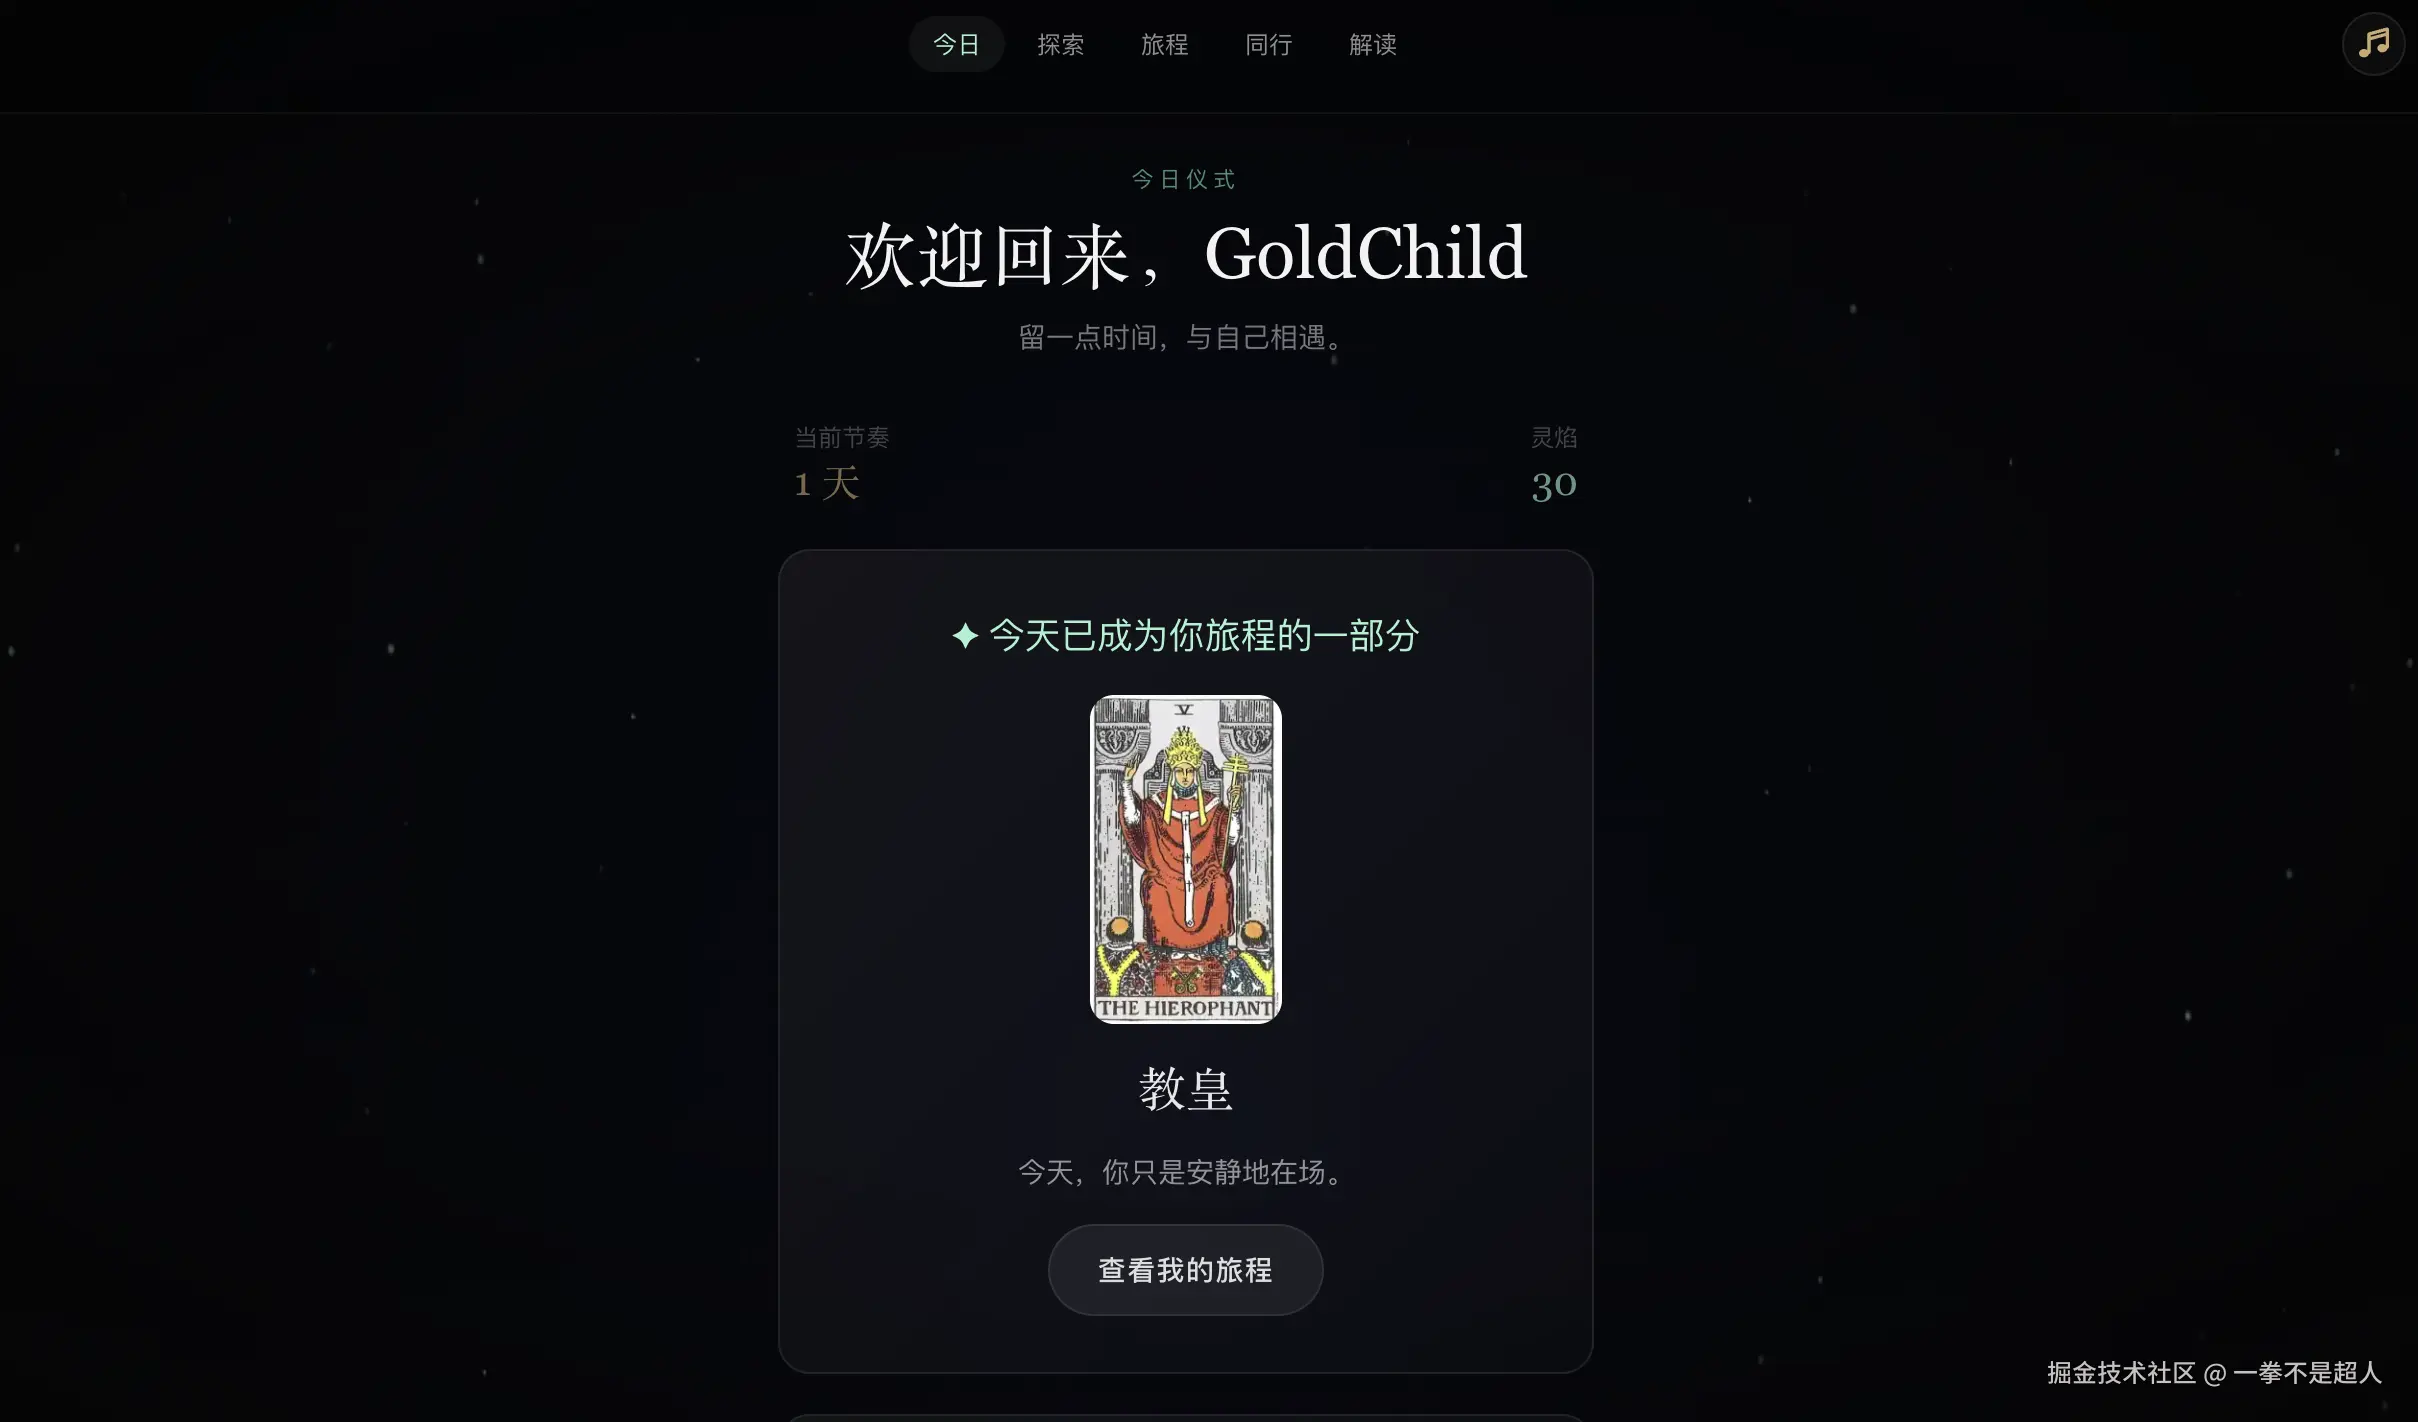
我也担心过,只有 78 张牌,抽完之后怎么办。后来觉得,把它理解成一个等待通关的牌库,并不准确。同一张牌,在工作很累和刚完成一件事的时候,能让人想到的东西未必相同。留下来的记录,也不只是牌,还有当天的处境。
当然,这只是产品设计上的理由。用户是否真的愿意每天来,还得看使用情况,不能因为内容组合足够多,就认为留存有了保证。
探索为什么没有每一步都接 AI
每日一牌比较轻,但有些问题,一两句话不太容易说清楚。所以我又做了主题探索。
目前有空间、边界、变化、自信、关系和方向六个主题,每个主题五个小章节。从看清眼前的处境,到换个角度、选一个行动,再考虑阻力和支持。可以一次做完,也可以过几天接着做。
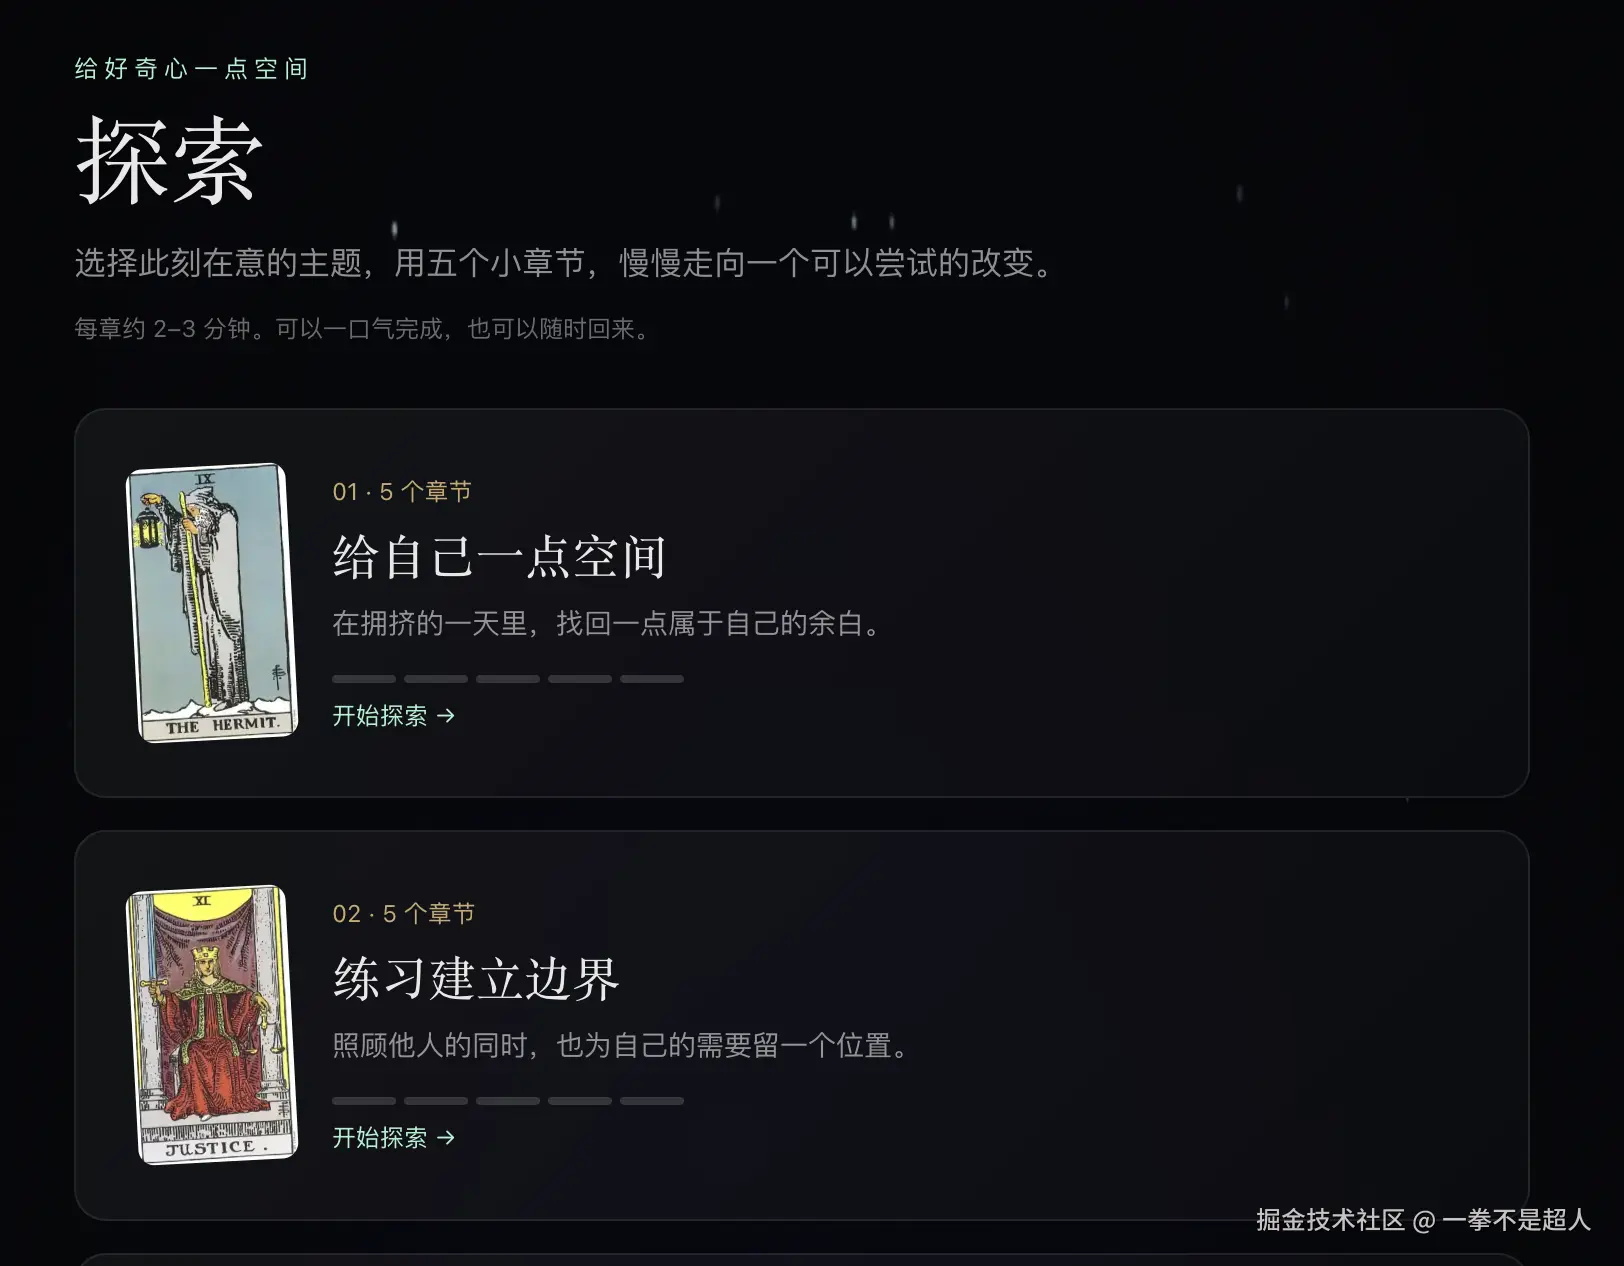
这里没有让模型每一步都现场生成。内容和分支是预先设计的,前面的选择会影响后面的行动建议,补充文字是可选项,填写后也不会自动发给模型解读。
做的时候,我更在意前后能不能接上。上一章让用户考虑边界,下一章的建议就不能完全忽略前面的选择。固定内容比较方便逐条检查,也方便修改不同语言的表达。全部交给生成,开发时可能省事,检查内容时又会把时间花回来。
现阶段,我宁愿先把有限的主题做好。开放式的问题,仍然交给深度解读。
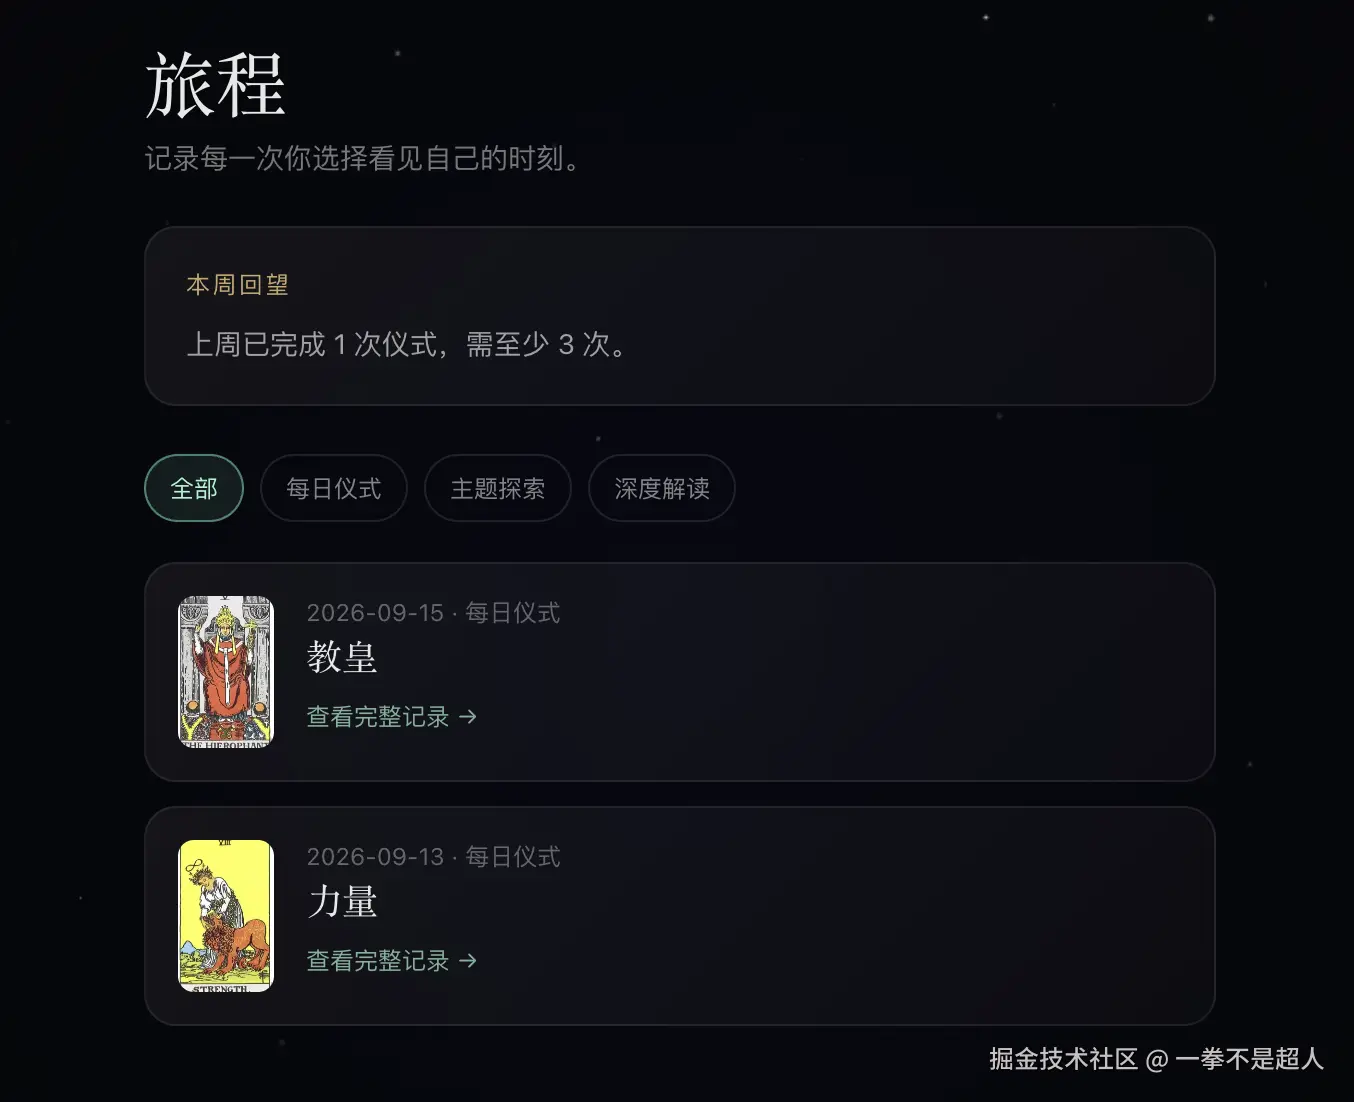
完成的仪式、探索,以及主动保存的深度解读,会放进个人旅程。以后回看,可以看到当时写了什么、选了什么,不用只对着一张牌回忆。
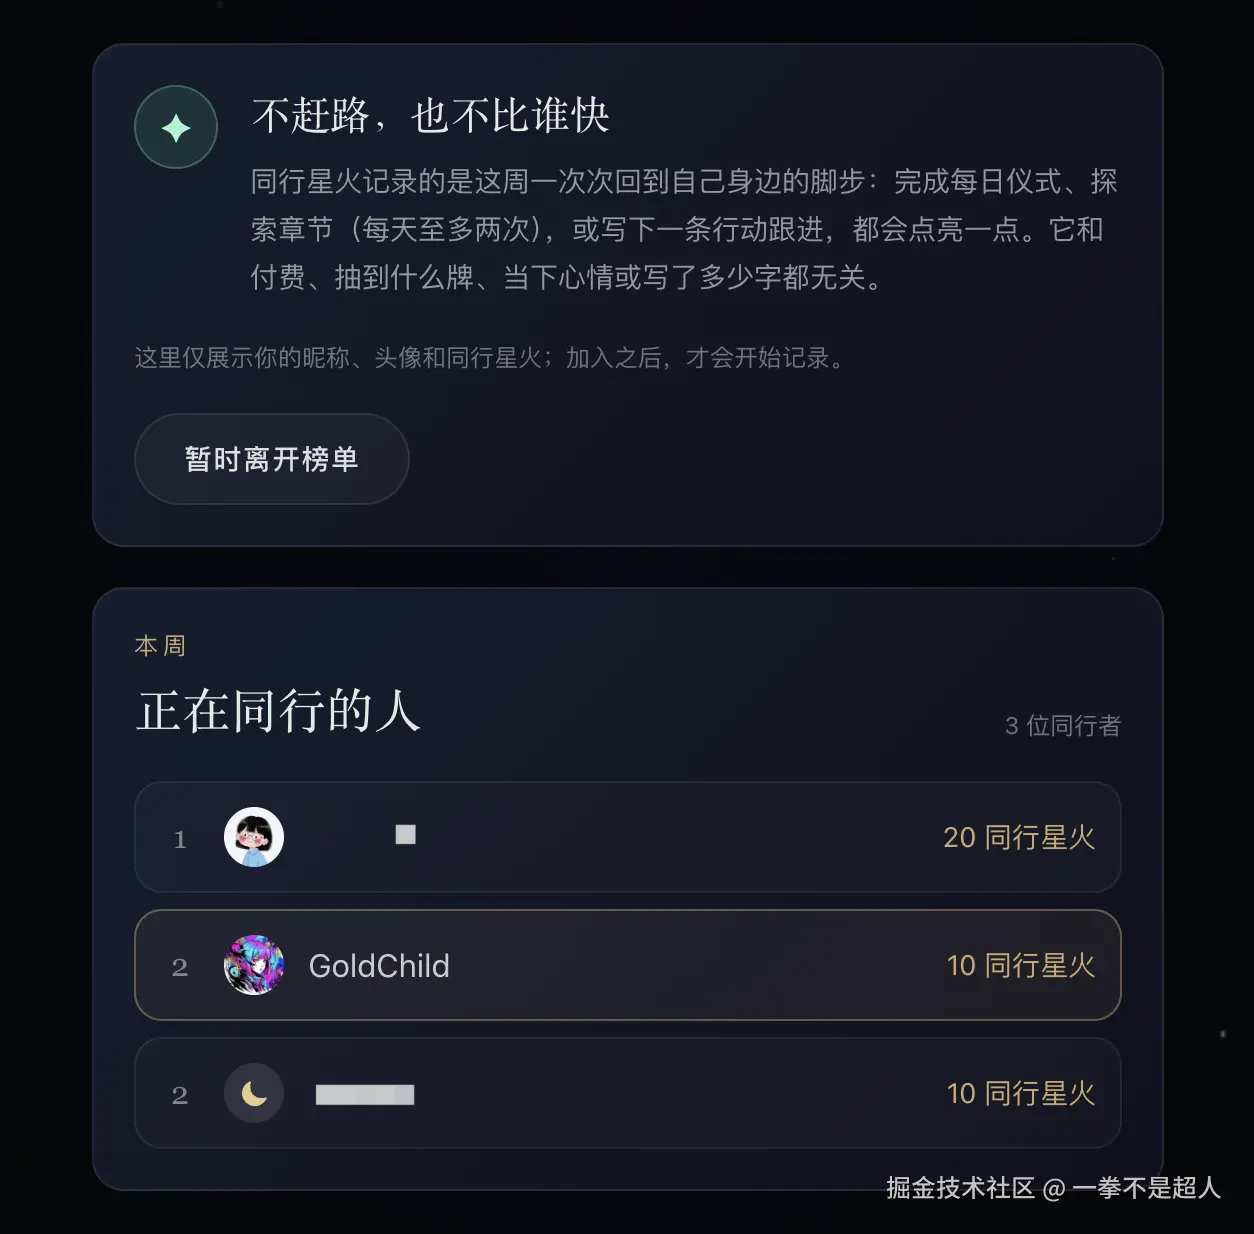
另外加了一个可自愿参加的"本周同行"。完成仪式、推进章节和行动跟进,可以积累同行星火。对外只展示昵称、头像和星火,不展示私人记录。
星火不和付费金额、心情好坏、抽到什么牌、写了多少字挂钩,也有计分上限。我希望它能让独自使用的人感到还有别人在一起做这件事。但榜单也可能让人产生比较,这个分寸究竟合不合适,目前还需要反馈。
一旦保存记录,就得考虑用户下次怎么接着用
技术栈还是比较简单:Nuxt 3 静态前端、Fastify API、SQLite,模型用 DeepSeek。现在这个体量,没有必要先把部署和维护弄复杂。
我最初想过只做本地存储,省掉账户和后端数据管理。但如果用户在电脑上开始探索,晚上拿手机想接着写,本地存储就不够用了。清理浏览器数据后记录丢失,也很难解释。
所以后来还是加了账户和云端存储。登录本身不算难,麻烦的是此后所有进度都需要考虑跨设备、重复请求和内容更新。
比如,用户提交一章后,服务端已经保存,但网络断了,浏览器没收到成功响应。再次提交时,不能把同一章再记一遍。反过来,如果手机已经推进了进度,电脑上的旧页面又提交了另一个答案,也不能直接覆盖。
探索的保存逻辑做了两层判断。下面根据当前实现简化,省略了字段校验、首次建档和同行事件记录:
ts
transaction(() => {
  const progress = loadProgress(profileId, themeId)

  // 已保存的同一份答案再次到达:返回已有进度
  if (chapter < progress.completedChapters &&
      sameAnswer(progress.answers[chapter], incomingAnswer)) {
    return { progress, changed: false }
  }

  // 不是重复请求,而是拿着旧进度继续提交
  if (progress.completed ||
      chapter !== progress.completedChapters ||
      revision !== progress.revision) {
    throw conflict(409)
  }

  appendAnswer(incomingAnswer)
  updateProgress({
    completedChapters: progress.completedChapters + 1,
    revision: progress.revision + 1,
  })
})
这里先判断是否是相同答案的重试,再检查版本。否则,第一次提交成功已经让版本号加了一,再发来的原请求就会被误判为冲突。
内容本身也有版本。探索记录保存了开始时使用的内容版本,读取时按这个版本解释答案,旧版本内容保留。不能今天改了选项顺序,昨天存下来的"第二项"就变成另一个意思。
这些东西在最初的演示里都看不到,但只要允许用户留下记录,就得慢慢补。
流式输出不难,失败后怎么收场比较费时间
AI 解读接入了 SSE,边生成边显示。正常情况下,这部分很容易跑通。真正花时间的是生成超时、只返回一半、用户关掉页面这些情况。
付费解读要消耗站内 Credits。请求发出前检查并扣减额度,但不能因为调用过模型,就把一段失败的输出算成完整服务。
目前的处理是:失败时补回本次已扣的 Credits;连接还在,就返回本地牌义作为降级结果;只有完整成功的生成结果才写入缓存。
下面只保留有限额度、未命中缓存时的 AI 调用分支:
ts
let charged = deductCredits(user, cost)
if (!charged) return localReading()

function restoreCreditsOnce() {
  if (!charged) return
  refundCredits(user, cost)
  charged = false
}

const controller = new AbortController()
const timer = setTimeout(() => controller.abort(), 15_000)
onEarlyClose(() => controller.abort())

let succeeded = false
try {
  const text = await streamReading(controller.signal, sendChunk)
  if (!text.trim() || controller.signal.aborted || connectionClosed()) {
    throw new Error('incomplete_reading')
  }
  sendDone()
  succeeded = true
  cacheCompleteReading(text)
} catch {
  restoreCreditsOnce()
  if (connectionWritable()) sendLocalFallback()
} finally {
  clearTimeout(timer)
  removeCloseListener()
  if (!succeeded) restoreCreditsOnce()
}
补回函数可以从不同失败路径进入,但同一次请求不能重复补额度。连接提前关闭时,也会尝试取消上游调用,避免用户已经离开,服务端还继续生成。
这里补的是站内使用额度,不是支付渠道退款。取消请求也不意味着模型服务商一定不计费。
目前这套补偿仍然依赖进程正常执行。如果刚扣完额度,进程就退出了,catch 和 finally 都帮不上忙。要覆盖这种情况,还需要持久化任务状态和异常核对。我不想把现在的实现写成"已经解决所有故障"。
免费的周回顾也有全局调用预算,预算不足或模型失败时用本地汇总。至少不能让一个免费入口,把模型费用变成没有上限的支出。
AI 安全,不能只写一句"忽略恶意指令"
接入模型后,我先把它能做的事限制住:生成解读。账户权限、订单状态、Credits 扣减都由服务端代码判断,模型没有操作数据库和支付的工具。
这能限制错误输出的影响范围,但不代表 Prompt 注入已经解决。用户输入仍然可能把解读带偏。提示词约束和应用权限是两回事,不能指望模型自己守住账户和付款规则。
另一个容易忽略的地方是输出展示。模型返回的是文本,到了页面里,如果直接当 HTML 渲染,就成了另一类风险。
保存后的解读使用一个很小的 Markdown 渲染函数:先转义 HTML,再处理允许的标题、列表、段落和加粗。逻辑可以概括为:
ts
function renderSavedReading(text) {
  const escaped = escapeHtml(text) // 转义 & < > " '
  return renderSupportedMarkdown(escaped)
}

// 即使原文带有 <img ...>,也先变成文本,不能直接成为标签
这个函数处理的是保存解读的展示,不是整个系统的安全证明。接口仍然要单独做账户检查、额度判断、限流和请求体大小限制。普通 IP 限流也有边界,不能把它当成完整的防滥用方案。
账户部分用加盐密码哈希,数据库保存会话 Token 的哈希,Cookie 设置 HttpOnly 等属性;验证码有有效期和尝试次数限制。查询订单时,要检查这笔订单是不是当前用户的,不能知道一个订单号就能查。
支付成功也不能相信浏览器跳转回来的参数。当前由服务端查询支付平台,回调另外验签。验签要保留原始请求体,不能先解析 JSON,再重新序列化一遍来代替原文。
主动查询和支付回调还可能确认同一笔付款,所以入账前要检查订单是否已经支付,避免重复加额度。这里涉及订单状态和余额两处写入,重复通知的处理与进程中断时的一致性,也不能混为一谈。
性能优化之外,还踩了一个文案的坑
前端做静态生成,账户和记录通过 API 获取。但静态页面也不等于打开就快:卡牌资源、动画、登录检查、接口等待,都会影响手机上的体验。
目前旅程列表分页加载,详情按需获取;头像在浏览器裁剪、压缩成 WebP 后再上传。流式解读还要检查代理缓冲,不然服务端逐段发,浏览器却可能一直等到最后。
客户端接流也不能把每次 reader.read() 当成一条完整消息。一次读取可能停在半行,中文字符也可能被拆开。现在用流式 TextDecoder 解码,再把没收齐的一行留在缓冲区,等下一段拼起来。
多语言现在有八种界面语言,牌库主要覆盖中英文,其他语言仍有英文回退。这一点得说清楚,不能把"有语言切换"当成所有内容都完成了本地化。
最近加反馈入口,还因为一个邮箱占位符把页面弄成了 500。
原因是 i18n 会把 @ 当成特殊语法。JSON 文件本身合法,文案编译却不通过。最后按消息语法把它改成字面量:
json
{
  "emailPlaceholder": "you{'@'}example.com"
}
这种错误挺容易漏。改的是一句示例文案,出问题的却是整个页面;用 JSON 解析检查也查不出来。修完后,还要一起检查其他语言里的对应字段。
做完这些,用户还是要自己去找
我已经在 Solo、出海栈、小众软件和 Indie Hackers 发过介绍,也在整理开发文章。但目前还没有哪个渠道,能让我说它已经带来了稳定的用户。
发介绍帖的时候,产品定位的问题又出现了。写"AI 塔罗解读",容易理解,但说不清现在的每日一牌和探索;写"自我探索与陪伴",又太泛,看完还是不知道进网站能做什么。
所以现在我更愿意直接讲使用过程:选一下今天的心情,抽一张牌,留几句话;如果有最近在意的事,可以选一个主题慢慢做。先让人知道要做什么,再谈设计理念。
目标市场主要面向海外,我也接了 Search Console 和 GA。前者看搜索发现和收录,后者帮助观察访问与使用。接下来想看清楚的是:人从哪里来,有没有完成第一次仪式,开始探索后停在哪里,过几天是否回来。现在数据还少,不能据此给产品下结论。
先让几个人认真用起来
我对这个项目有不少判断,但还缺少足够的真实使用来验证。几乎没有用户,既不能说明产品一定不行,也不能简单归因于"只是没推广"。
继续写功能当然很顺手。多一个按钮、多一个页面,当天就有结果。找人试用没有这么确定,发了消息,可能只收到一句"有空看看"。但到了现在,再加一个主题,也回答不了为什么别人没有开始用。
下一步想先找一小批愿意认真体验的人,看看第一次使用会不会卡住,探索的内容有没有用,过几天有没有理由回来。暂时不继续扩功能,先把这些事弄清楚。
如果你愿意试试,中文入口在这里:Mystic Journey。每日仪式和主题探索免费,深度 AI 解读按需使用 Credits。不熟悉塔罗也没关系,可以从一个最近在意的主题开始。
不用为了支持独立开发而夸它。哪一步没看懂,哪段话太空,或者用到哪里不想继续了,都可以通过站内反馈或评论区告诉我。这些具体的问题,对我现在更有帮助。