概述
矩阵乘法引擎的性能不仅取决于阵列有多大,更取决于数据以什么方式在阵列里流动、被复用多少次。
业界有三种经典数据流,NPU 通常选其一或混合。
三种数据流模式是什么?
矩阵乘法的核心计算是:
Ci,j=∑kAi,k×Bk,j Ci,j = \sum_{k} Ai,k \times Bk,j Ci,j=k∑Ai,k×Bk,j
其中 A 是 M×K,B 是 K×N,C 是 M×N。
乘加阵列由许多处理单元(PE) 组成,每个 PE 做一个乘加。
数据流模式回答的是:A、B、C 这三个矩阵,谁留在阵列里不动,谁在阵列间流动?
| 数据流模式 | 谁驻留 | 谁流动 | 适用场景 |
|---|---|---|---|
| Weight Stationary | 权重 B | 输入 A、输出 C | 卷积、RNN(权重小、复用好) |
| Output Stationary | 部分和 C | 输入 A、权重 B | 大 GEMM(避免部分和频繁写回) |
| Input Stationary | 输入 A | 权重 B、输出 C | 全连接、Transformer 的 QKV 投影 |
具体例子:2×2 矩阵乘法
为了简单,假设:
A=1234,B=5678 A = \begin{bmatrix} 1 & 2 \\ 3 & 4 \end{bmatrix}, \quad B = \begin{bmatrix} 5 & 6 \\ 7 & 8 \end{bmatrix} A=1324,B=5768
则:
C=A×B=1×5+2×71×6+2×83×5+4×73×6+4×8=19224350 C = A \times B = \begin{bmatrix} 1 \times 5 + 2 \times 7 & 1 \times 6 + 2 \times 8 \\ 3 \times 5 + 4 \times 7 & 3 \times 6 + 4 \times 8 \end{bmatrix} = \begin{bmatrix} 19 & 22 \\ 43 & 50 \end{bmatrix} C=A×B=1×5+2×73×5+4×71×6+2×83×6+4×8=19432250
假设我们有一个 2×2 的乘加阵列(4 个 PE)。
Weight Stationary(权重驻留)
策略:把 B 的每个元素固定在一个 PE 里,A 的行流经阵列。
text
阵列布局(B 驻留):
  PE00 = B[0,0] = 5    PE01 = B[0,1] = 6
  PE10 = B[1,0] = 7    PE11 = B[1,1] = 8
处理 A 的第 0 行 1, 2:
text
将 1 广播到 PE00 和 PE01
将 2 广播到 PE10 和 PE11

PE00: 1 × 5 = 5
PE01: 1 × 6 = 6
PE10: 2 × 7 = 14
PE11: 2 × 8 = 16

C[0,0] = 5 + 14 = 19
C[0,1] = 6 + 16 = 22
特点:B(权重)只加载一次,一直留在阵列里。
A 的每一行流过阵列,每个元素被复用 2 次(对 B 的两列)。适合权重小、复用多的卷积。
Output Stationary(输出驻留)
策略:部分和 C 留在阵列里累加,A 和 B 都流动。
text
阵列布局(C 的部分和驻留):
  PE00 = C[0,0] 累加器    PE01 = C[0,1] 累加器
  PE10 = C[1,0] 累加器    PE11 = C[1,1] 累加器
k=0 时:
text
A 的第 0 列是 [1, 3](A[0,0]=1, A[1,0]=3)
B 的第 0 行是 [5, 6](B[0,0]=5, B[0,1]=6)

将 1 广播到 PE00 和 PE01
将 3 广播到 PE10 和 PE11
将 5 广播到 PE00 和 PE10
将 6 广播到 PE01 和 PE11

PE00: 1 × 5 = 5      PE01: 1 × 6 = 6
PE10: 3 × 5 = 15     PE11: 3 × 6 = 18
k=1 时:
text
A 的第 1 列是 [2, 4](A[0,1]=2, A[1,1]=4)
B 的第 1 行是 [7, 8](B[1,0]=7, B[1,1]=8)

将 2 广播到 PE00 和 PE01
将 4 广播到 PE10 和 PE11
将 7 广播到 PE00 和 PE10
将 8 广播到 PE01 和 PE11

PE00: 5 + 2×7 = 19
PE01: 6 + 2×8 = 22
PE10: 15 + 4×7 = 43
PE11: 18 + 4×8 = 50
特点:部分和 C 一直留在阵列里,不需要中间写回。适合大 GEMM,因为部分和写回代价高。
Input Stationary(输入驻留)
策略:把 A 的每个元素固定在一个 PE 里,B 的列流经阵列。
text
阵列布局(A 驻留):
  PE00 = A[0,0] = 1    PE01 = A[0,1] = 2
  PE10 = A[1,0] = 3    PE11 = A[1,1] = 4
处理 B 的第 0 列 5, 7:
text
将 5 广播到 PE00 和 PE10
将 7 广播到 PE01 和 PE11

PE00: 1 × 5 = 5
PE01: 2 × 7 = 14
PE10: 3 × 5 = 15
PE11: 4 × 7 = 28

C[0,0] = 5 + 14 = 19
C[1,0] = 15 + 28 = 43
处理 B 的第 1 列 6, 8:
text
将 6 广播到 PE00 和 PE10
将 8 广播到 PE01 和 PE11

PE00: 1 × 6 = 6
PE01: 2 × 8 = 16
PE10: 3 × 6 = 18
PE11: 4 × 8 = 32

C[0,1] = 6 + 16 = 22
C[1,1] = 18 + 32 = 50特点:A(输入)驻留,B(权重)流动。适合全连接层、QKV 投影。
BM1684X 的 64 Lane 与 SIMD 架构
硬件结构
BM1684X 的矩阵引擎由 64 个 NPU(Lane) 组成,每个 Lane 内有若干 EU(执行单元),全片合计 1024 个 EU
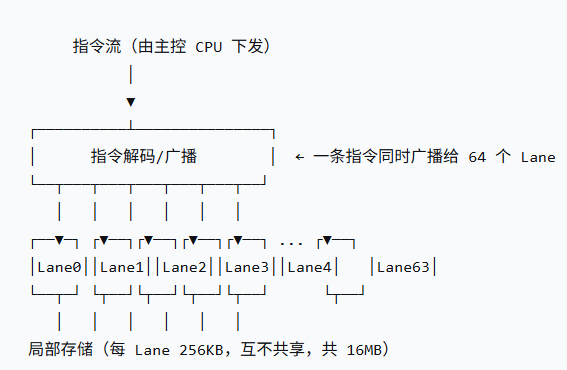
三个要点
① 局部存储按 Lane 划分且不共享
每个 Lane 只能访问自己的 256KB 局部存储,不能跨 Lane 读别人的数据。
数据要进哪个 Lane 的局部存储,由搬运指令(GDMA)精确控制。
② SIMD 意味着"一次编程,64 份数据"
同一时刻,64 个 Lane 执行同一条指令,但各自处理不同数据。Kernel 开发者不需要写 64 份代码,写一份、数据自动铺开。
代价是"一个 Lane 慢,所有 Lane 等"------负载不均衡会直接拉低利用率。
③ 为什么是 64?
一个乘加阵列的宽度通常取 32/64/128 这类 2 的幂,方便按行/按面切分张量;
同时 64 个 Lane 的并行度恰好能压满 256KB × 64 = 16MB 的局部存储带宽。
完整例子:在 BM1684X 上做矩阵乘法
假设我们要计算:
C=A×B C = A \times B C=A×B
其中:
- A:64×64 的 INT8 矩阵
- B:64×64 的 INT8 矩阵
- C:64×64 的 INT8 矩阵
编译器如何分块(lane-split)
BM1684X 有 64 个 Lane。一种自然的划分方式:Lane i 计算 C 的第 i 行。
text
Lane 0:计算 C[0, :] = A[0, :] × B
Lane 1:计算 C[1, :] = A[1, :] × B
...
Lane 63:计算 C[63, :] = A[63, :] × B
每个 Lane 需要什么数据
Lane i 需要:
- A 的第 i 行(64 个 INT8 值 = 64 字节)
- 完整的 B 矩阵(64×64 = 4096 个 INT8 值 = 4 KB)
所以每个 Lane 的局部存储里放:
text
Lane i 局部存储:
  A[i, :]  →  64 字节
  B        →  4 KB
  合计     →  约 4.1 KB(远小于 256KB)
数据搬运(GDMA)
将 B 复制到所有 64 个 Lane 的局部存储中
text
GDMA 搬运:
  B(4 KB)→ Lane 0 局部存储
  B(4 KB)→ Lane 1 局部存储
  ...
  B(4 KB)→ Lane 63 局部存储

总搬运量:64 × 4 KB = 256 KB
将 A 的每一行搬运到对应 Lane
text
A[0, :](64 B)→ Lane 0 局部存储
A[1, :](64 B)→ Lane 1 局部存储
...
A[63, :](64 B)→ Lane 63 局部存储

总搬运量:64 × 64 B = 4 KB
计算(SIMD 执行)
所有 Lane 同时执行同一条指令:
text
for k in 0..63:
    for j in 0..63:
        C[i,j] += A[i,k] × B[k,j]
每个 Lane 在自己的局部存储里读 Ai, : 和 B,计算 Ci, :,写回局部存储
数据流模式分析
这个例子用的是 Weight Stationary:
- B(权重)驻留 :B 被复制到每个 Lane 的局部存储里,计算过程中一直不动。
- A(输入)流动 :A 的每一行流经对应的 Lane。
- ** C(输出)流动** :C 的每一行算完后写回全局内存。
为什么选 Weight Stationary?
- B 只有 4 KB,很小,复制 64 份也才 256 KB,可以接受。
- B 被复用了 64 次(每个 Lane 用一次),复用好。
- A 的每一行只用一次,不需要驻留。
如果换成 Output Stationary 呢?
假设 Lane i 计算 C 的第 i 列:
text
Lane i 需要:
  A 的完整矩阵(64×64 = 4 KB)
  B 的第 i 列(64 字节)
数据流变成:
- C(部分和)驻留:每个 Lane 累加自己那一列的部分和。
- A 和 B 流动:A 需要复制到所有 Lane,B 的列流经。
对比:
| 模式 | 复制到所有 Lane 的数据 | 每个 Lane 独有的数据 | 总搬运量 |
|---|---|---|---|
| Weight Stationary | B (4 KB × 64) | A 的行 (64 B × 64) | 256 KB + 4 KB |
| Output Stationary | A (4 KB × 64) | B 的列 (64 B × 64) | 256 KB + 4 KB |
两种模式的总搬运量差不多,但 Weight Stationary 更适合 B 小、A 大的场景;
Output Stationary 更适合 A 小、B 大的场景。
总结
| 概念 | 含义 | 例子 |
|---|---|---|
| Weight Stationary | 权重驻留,输入流动 | 卷积:B 固定在阵列里,A 的行流过 |
| Output Stationary | 部分和驻留,输入和权重流动 | 大 GEMM:C 累加器留在阵列里 |
| Input Stationary | 输入驻留,权重流动 | 全连接:A 固定在阵列里,B 的列流过 |
| BM1684X 的 64 Lane | 64 个独立处理单元,SIMD 执行 | 一条指令广播给 64 个 Lane,各算各的 |
| 局部存储 | 每 Lane 256KB,互不共享 | 数据必须通过 GDMA 搬运到对应 Lane |
| lane-split | 编译器把张量按 Lane 分块 | Lane i 计算 C 的第 i 行 |
一句话:数据流模式决定了"谁留在阵列里、谁在流动",直接影响权重要不要频繁搬运、部分和要不要写回。
BM1684X 的 64 Lane SIMD 架构要求编译器把张量按 Lane 分块,并通过 GDMA 精确搬运数据。
Weight Stationary 适合权重小、复用多的卷积;
Output Stationary 适合大 GEMM;
Input Stationary 适合全连接和 QKV 投影。