一、神经网络基础
1.1、 神经网络简介
人工神经网络(Artificial Neural Netork,即ANN)是由简单神经元经过相互连接形成网状结构 ,通过调节各连接的权重值改变连接的强度,进而实现感知判断;反向传播(Back Propagation, BP) 算法的提出进一步推动了神经网络的发展。
(1)神经网络简要介绍
传统神经网络结构比较简单,训练时随机初始化输入参数,并开启循环计算输出结果,与实际结果进行比较从而得到损失函数,并更新变量使损失函数结果值极小,当达到误差阈值时即可停止循环;
神经网络的训练目的是希望能够学习到一个模型,实现输出一个期望的目标值。学习的方式是在外界输入样本的刺激下不断改变网络的连接权值。传统神经网络主要分为一下几类:前馈型神经网络、反馈型神经网络和自组织神经网络。这几类网络具有不同的学习训练算法,可以归结为监督型学习算法和非监督型学习算法;
(2)神经网络的感知器(神经元)
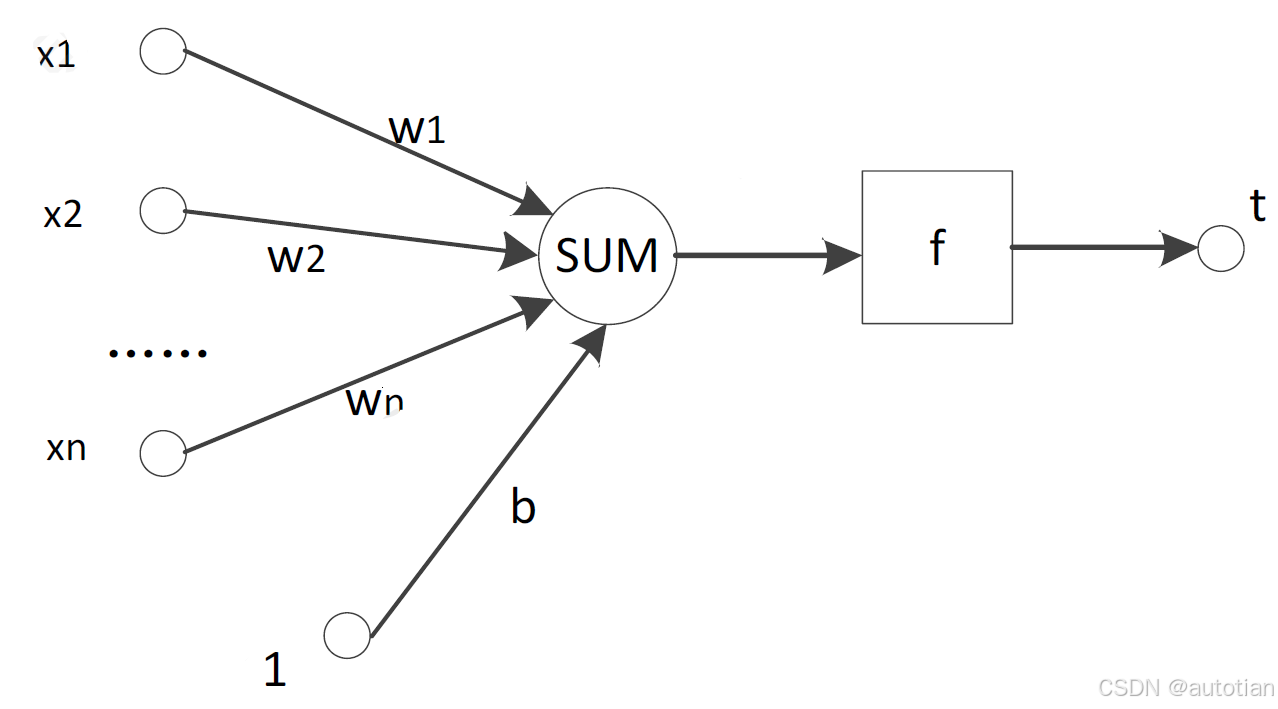
感知器 是一种结构最简单的前馈神经网络 ,也称为感知机,它主要用于求解分类问题。
一个感知器可以接收𝑛个输入𝐱=(𝑥1, 𝑥2, ... , 𝑥𝑛)T ,对应𝑛个权值𝑤=(𝑤1, 𝑤2, ... , 𝑤𝑛),此外还有一个偏置项阈值,就是图中的𝑏,神经元将所有输入参数与对应权值进行加权求和,得到的结果经过激活函数变换后输出,计算公式如下:
𝑦 = 𝑓 (𝒙. 𝐰 + 𝑏)
1.2、前馈神经外科(BP)
前馈神经网络 (Feed Forward Neural Network) 是一种单向多层的网络结构 ,即信息是从输入层开始,逐层向一个方向传递,一直到输出层结束 。所谓的**"前馈"是指输入信号的传播方向为前向** ,在此过程中并不调整各层的权值参数,而反传播时是将误差逐层向后传递,从而实现使用权值参数对特征的记忆,即通过反向传播(BP) 算法来计算各层网络中神经元之间边的权重。BP算法具有非线性映射能力,理论上可逼近任意连续函,从而实现对模型的学习.
- BP (Back Propagation)神经网络也是前馈神经网络,只是它的参数权重值 是由反向传播学习算法进行调整的;
- BP 神经网络模型拓扑结构包括输入层、隐层和输出层 ,利用激活函数 来实现从输入到输出的任意非线性映射,从而模拟各层神经元之间的交互;
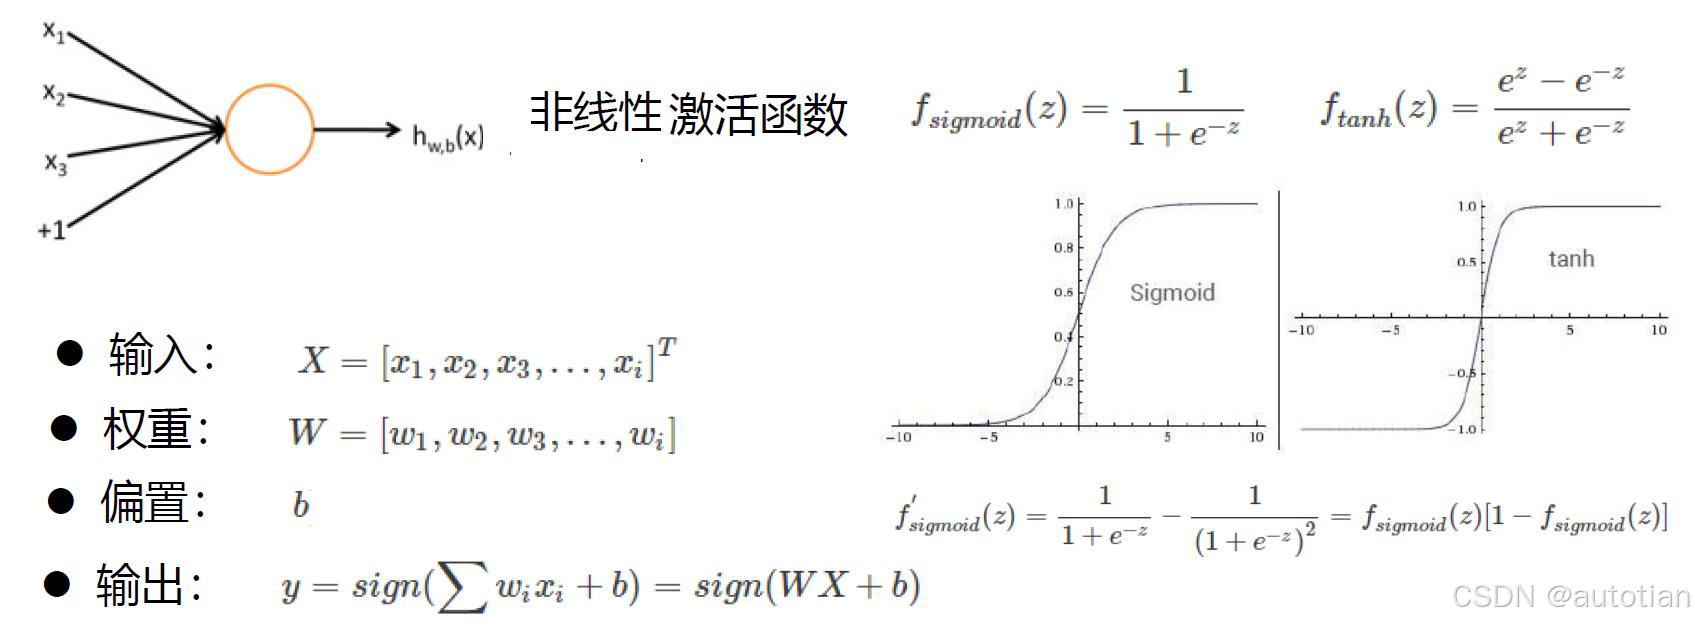
- 激活函数须满足处处可导的条件。例如,Sigmoid函数连续可微,求导合适,单调递增,输出值是0~1之间的连续量,这些特点使其适合作为神经网络的激活函数。
如上图中:第一层为输入层,中间为隐藏层,最后一层为输出层,同一层神经元是不连接的,相邻的两层是全连接的(和相邻下一层的所有节点都连接)。
表述中,为相邻两层神经元之间的权重,
表示第二层的第一个神经元,训练调节的即为权重和偏置
1.3、神经网络训练
(1)基本步骤
训练神经网络主要为修正神经网络的结构和权重,最终实现网络对样本的拟合。
如果SIgmoid函数为非线性函数,可证明其可以拟合任意的非线性映射。
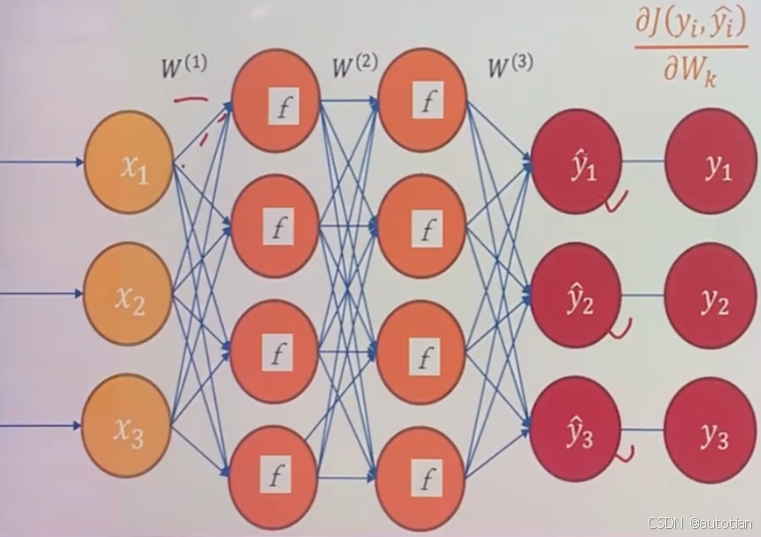
训练的基本步骤如下:
- 初始化网络权值和神经元的阈值,一般通过随机的方式进行初始化
- 前向传播:计算隐层神经元和输出层神经元的输出
- 后向传播:根据目标函数公式修正权值wij
在训练过程中,定义神经网络输出的数据为加上上标的形式,定义训练的损失函数为:
通过损失函数可以用训练损失函数代价来代表模型的拟合程度,即代价越低模型拟合度越高。
训练过程中的变量为权重和偏置,神经网络权重的个数为每一层神经元个数相乘。
对于代价的减小,可通过对各个权重求导的方式(偏置也采用同样的方法),但由于权重个数过多,求解联立方程(虽然,代价为二次,即求导后为线性),但未知数太多,维度过高。
综上分析,采用迭代的方式逐步逼近最小值,思想为每次选择一个点看一下最快下降的方向(负梯度方向相),以下是上图中简单的偏导求解:
在以上计算中,表示第i层神经元输出,其值为
。
为此,权重更新为:
其中,-号表示为负梯度,是学习率(步长),取值范围为(0,1)。
训练方式有批处理(选择所有样本挨个训练得到损失值后反向训练调整权重,不断循环迭代,直到循环次数或者损失函数值接近于设定值)和随机梯度下降法(随机选择样本/小批量选择 向前传播得到一个误差,得到后马上对权重和偏置进行调整)
梯度消失:如上面公式越靠近输入层,公式越长,其偏导数越接近于0,此时调整无法改变损失函数值,学习停顿效果变差。
(2)激活函数
激活函数通常具备以下特点:非线性、可微性、单调性、、输出值范围、计算简单、归一化
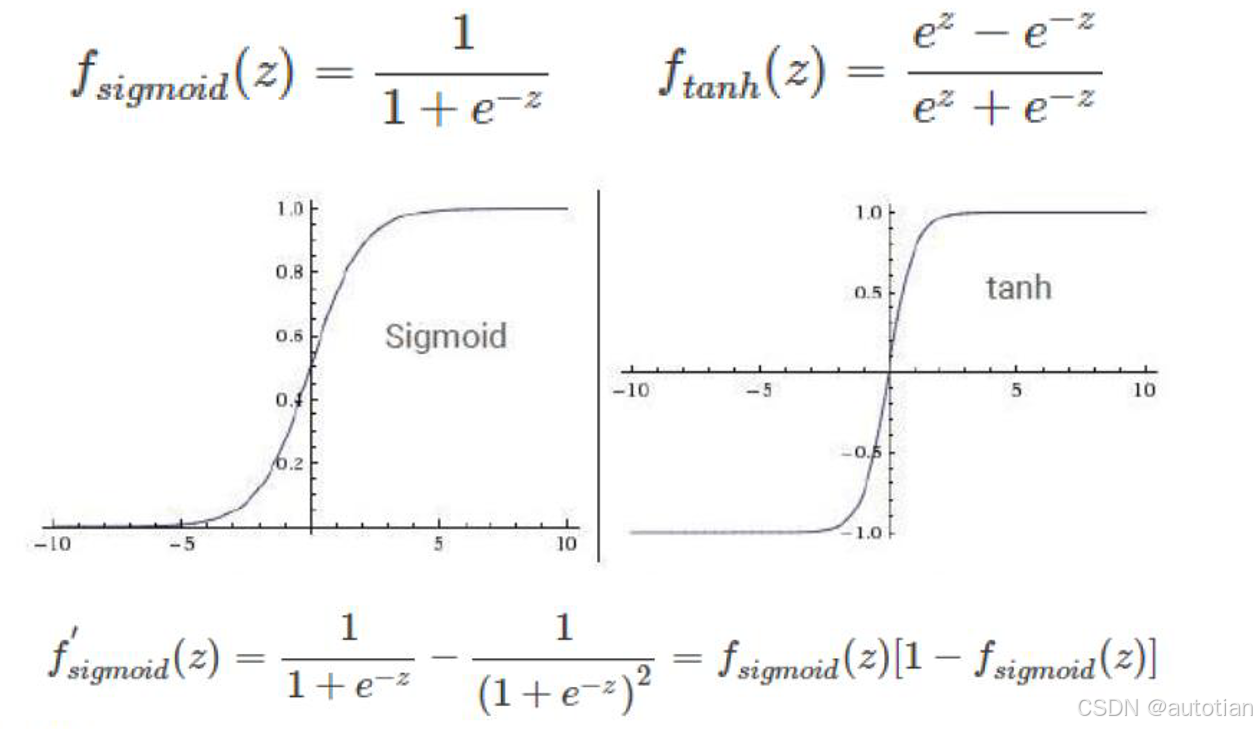
Sigmoid函数:
优点在于输出范围有限,输出在传递过程中不容易发散,输出范围为(0,1),可以在输出层表示概率值。Sigmoid函数的导数是非零的,容易计算;
缺点在于梯度下降非常明显,两头过于平坦,容易出现梯度消失的问题,输出的值域不对称(tanh函数值域为-1到1).
双曲正切函数tanh
将正切函数映射到-1,1,解决了Sigmoid函数输出值域不对称问题,且为完全可微分和反对称的。对称中心在原点。然而输出值域两头依旧过于平坦,梯度消失仍然存在。
ReLU函数
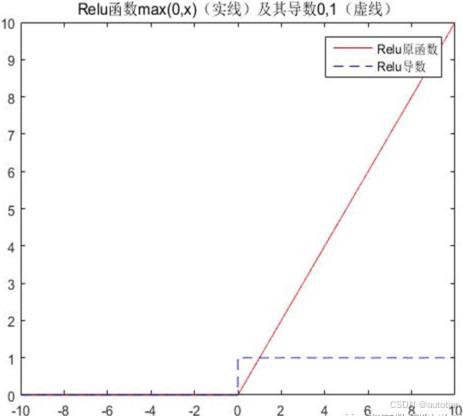
ReLU为目前最常用的激活函数,由于ReLU函数是线性特定使其收敛速度比Sigmoid、tanh更快,没有梯度饱和的情况出现,计算更高效,只需一个阈值即可获得激活值,不需要对输入归一化来防止达到饱和。
Leaky ReLU函数
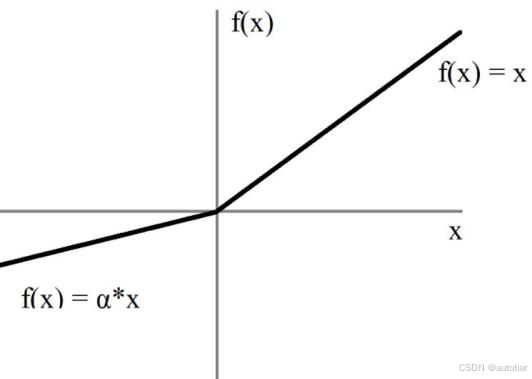
带泄漏修正线性神经元( Leaky ReLU)的出现是解决"死亡神经元"的问题.
(3)损失函数
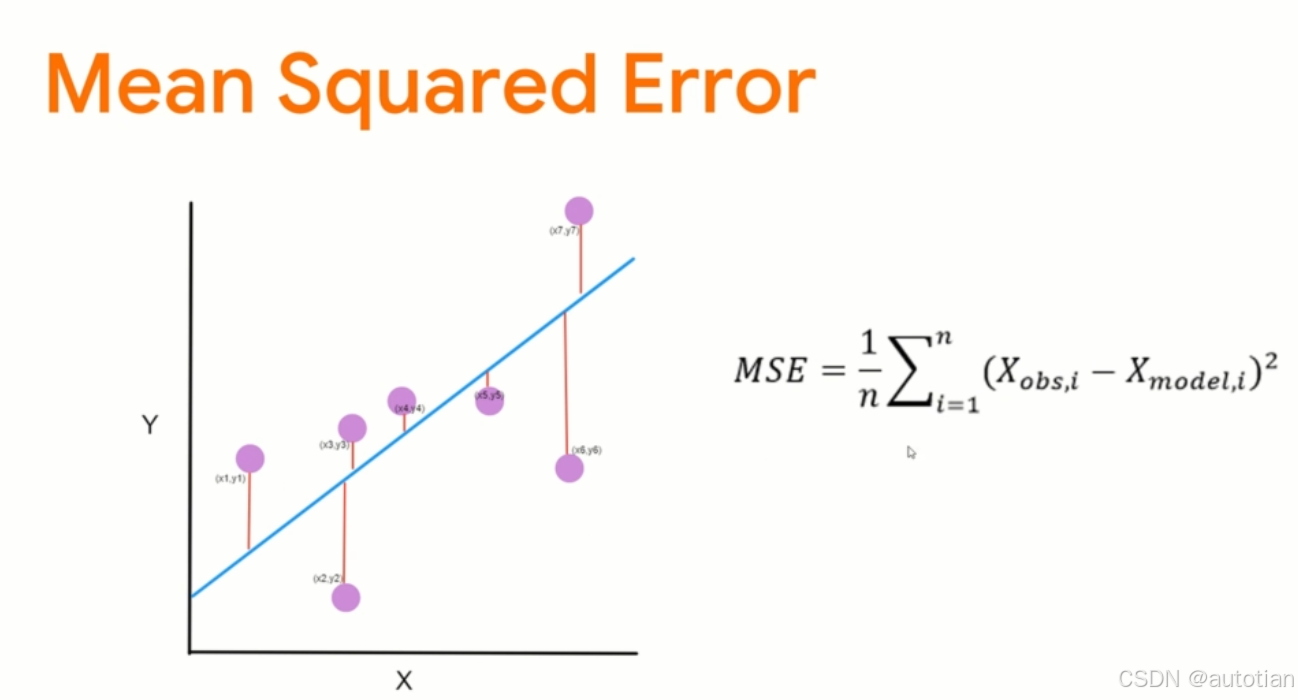
损失函数评价的是模型对样本拟合度(提供拟合的评判标准) ,预测结果与实际值越接近,说明模型的拟合能力越强,对应损失函数的结果就越小;反之,损失函数的结果越大。损失函数比较大时,对应的梯度下降比较快。为了计算方便,可以采用欧式距离作损失度量标准 ,通过最小化实际值与估计值之间的均方误差作为损失函数,即最小平方误差准则(MSE):
均方误差损失函数:
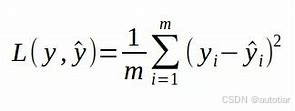
交叉熵损失函数:
交叉熵损失函数的用途主要应用在互相排斥的分类任务中;
交叉熵也可以用于目标为0,1区间的回归问题
(4)学习率
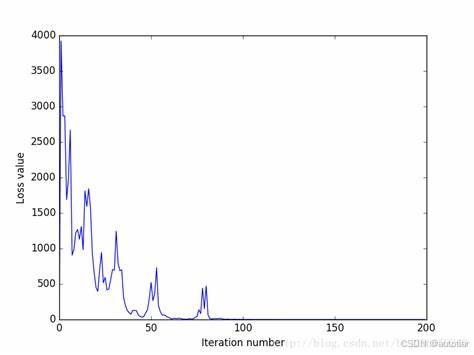
学习率控制每次更新参数的幅度,过高和过低的学习率都可能对模型结果带来不良影响,合适的学习率可以加快模型的训练速度。
常见的学习率调整方法:基于经验的手动调整、固定学习率、动量法动态调整、随机梯度下降、Adam自动调整
(5)过拟合
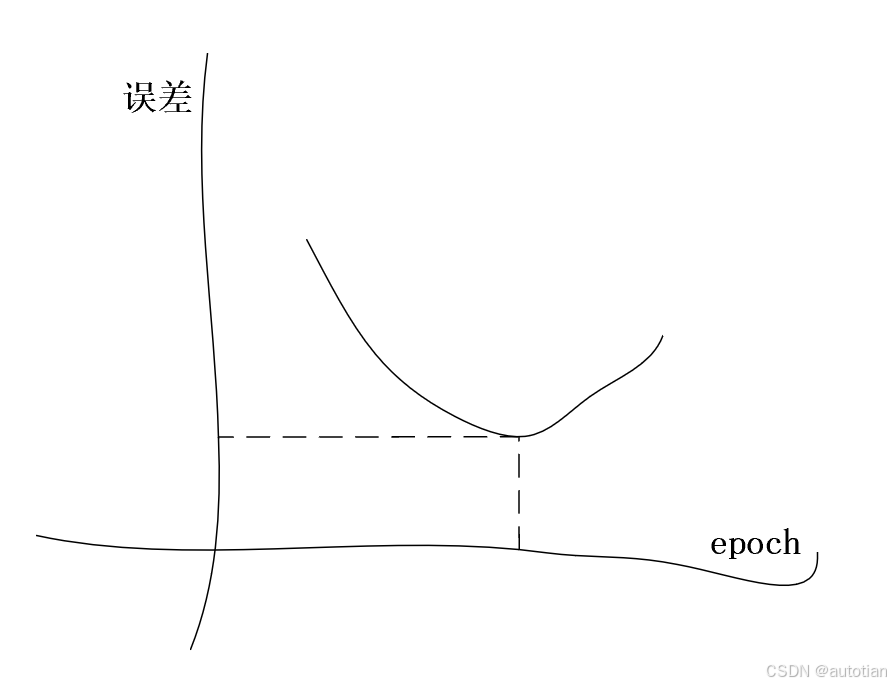
过拟合是指模型在训练集上预测效果好(损失函数很小),但在测试集上预测效果差(随着网络次数epoch的增加,损失值没有下降反而在提高)。
常用的防止过拟合的方法 :参数范数惩罚(惩罚性成本函数、正则化)、数据增强、提前终止、Bagging等集成方法、Dropout、批正则化
惩罚性成本函数
将惩罚项添加至损失函数获得高权重:
通过加入对权重的惩罚项,可让权重变小某些权重为0,变相令网络结构简化。
漏失(Dropout)
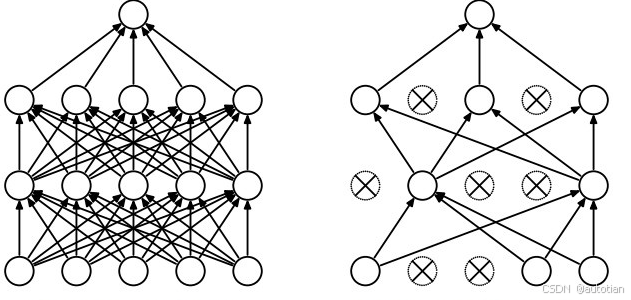
在训练神经网络时,以一定概率漏掉部分神经元(保持原有的权重不变)。做计算损失函数检验时,再恢复作用。
相当于在训练过程中,令网络结构简化。而过拟合根本原因是模型复杂,节点过多。
尽早终止(Early Stopping)
如:每实施10个epoch查看一次损失值,如果损失函数高于上次,则停止操作并使用上个模型。
动量(Momentum)
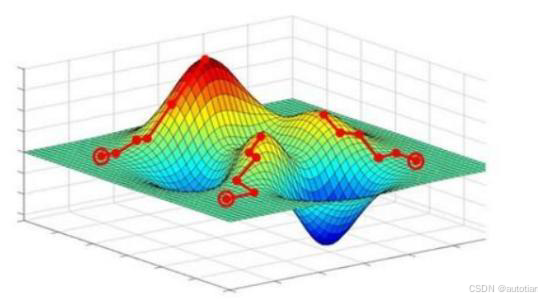
为避免陷入极小值,在权重更新的基础上加上一项动量项:
其中,表示动量。
即走的方向并不是完全按照负梯度方向,一定程度还参考了过去的速度(相当于加了一个小的扰动),虽然每次学的效果稍微差了一点,防止陷入局部最小值。
(6)训练中的问题
- 选择恰当的激活函数
- 权重初始化(最好保证均匀)
- 学习率
- 周期/训练迭代次数
- 训练过程可视化(如TensorFlow工具,把训练中成本变化的过程画出来,防止局部最小)
1.4、神经网络识别应用
在此举手写体识别案例,以更好理解神经网络的应用。
手写体识别问题:将数字分为十类(0到9),具有10个输出。
为了处理手写体的图像,将图用28x28(784)的点阵作为单层神经网络的输入。
神经网络输入设定:考虑一个黑白的图,凡是覆盖的像素编码为1,未覆盖编码为0。对于神经网络输入为一个向量,为此对于28x28,可以将第一行作为向量的前28个元素,紧接着是第二行的28个元素,直到784个元素全部排列为一个向量,即输入为784维。
神经网络输出设定:对于神经网络,有几个类别即为几个输出,识别数字共为10个,即10个类别,因此,设定输出10个节点。
隐层节点的选取:可以设定多次不同的节点数目,观察哪种设定损失值下降最快。
二、卷积神经网络
2.1、卷积神经网络的发展
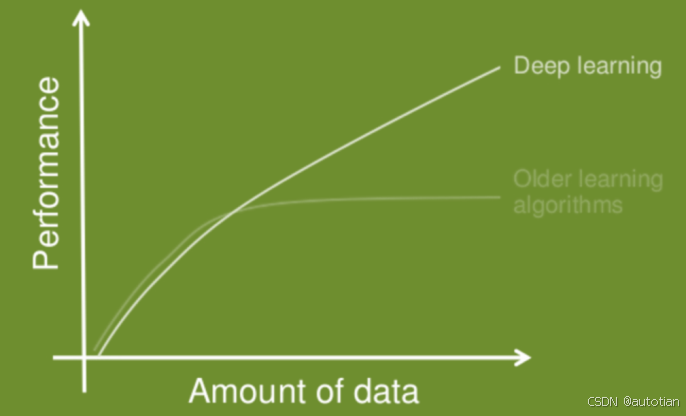
深度学习是一种利用复杂结构的多个处理层来实现对数据进行高层次抽象的算法,是机器学习的一个重要分支。传统的BP算法 仅有几层网络,需要手工指定特征且易出现局部最优问题 ,而深度学习引入了概率生成模型 ,可自动地从训练集提取特征,解决了手工特征考虑不周的问题,而且初始化了神经网络权重,采用反向传播算法进行训练,与BP算法相比取得了很好的效果。
(1)感受野
感受野------人脑与视觉感知机制
- 神经元所影响的刺激区域称为神经元的感受野(receptive field),不同神经元感受野的大小和性质都不同。
- 有些细胞对某些处在一个角度上的线条、垂直线条、直角或者明显的边缘线,都有特别的反应
。要引起这个细胞反应,直线的朝向只能落在一个很小的角度范围里(该细胞的感受野内)
(2)卷积的定义
计算公式:
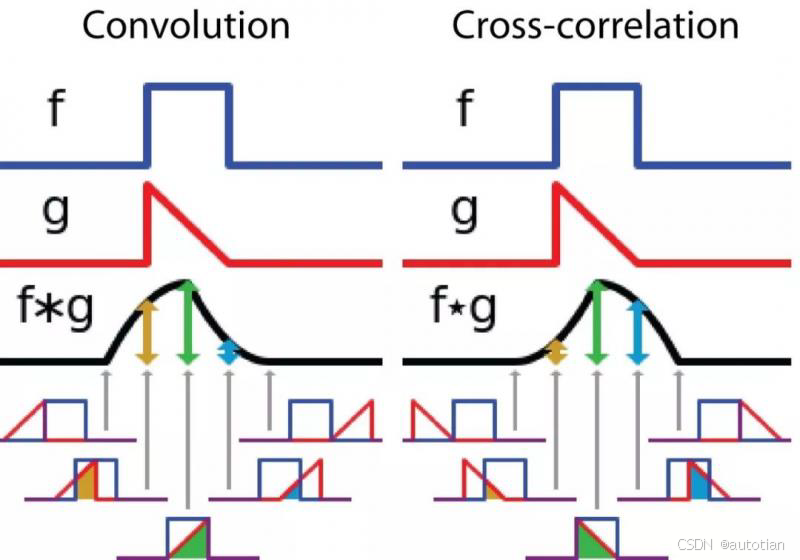
在上图卷积的示例中,由于g取,为此,先对g进行取反,即为图下方对称后的g型三角。然后开始移动g取反后的三角,卷积值即为当前三角移动到这个位置,f在其中的投影面积。
当为离散求卷积,则不停地移动一个个补偿相乘再相加(其值与设定步长有关)。
卷积实质上是一种滤波器,g函数对f函数做卷积,g函数相当于一种滤波器,可以把f函数的特征抓取,非重要特征隐掉。
2.2 图像编码与卷积
对于神经网络输入层、输出层以及隐层都要进行数值计算,对于图需要进行编码。
(1)手写体示例
对于手写体采用像素编码的形式(灰度图,没有颜色用0表示,颜色最深用256表示)
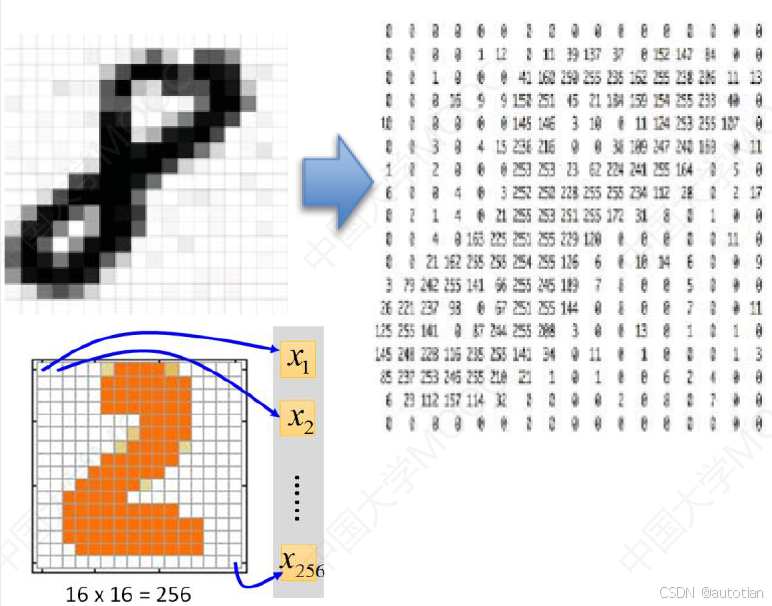
此步将图像采用灰度处理的方式获取表示图像的矩阵,即f函数运算。
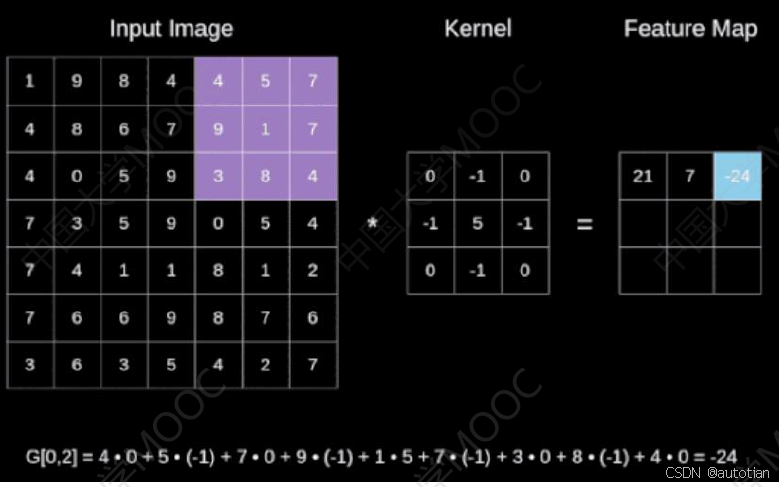
接下来需要找一个g函数,也称核函数,进行卷积运算,如下图:
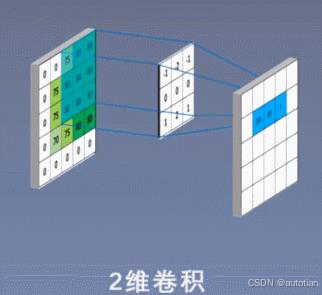
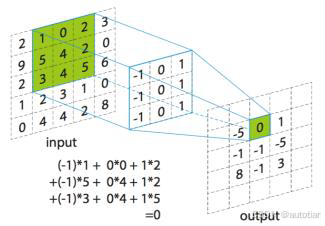
通过对图做卷积后,其特征通过g函数卷积核滤波能够保留下来,并使特征变少
(2)卷积操作及补零
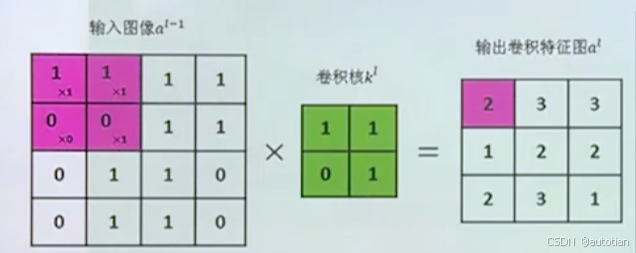
即通过卷积运算对原始图进行压缩,但同时保留其特征。
为了获取边缘特征,通过补零的Padding补零操作,令边缘点成为内部点
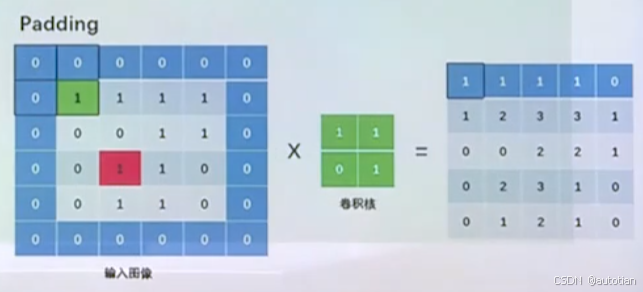
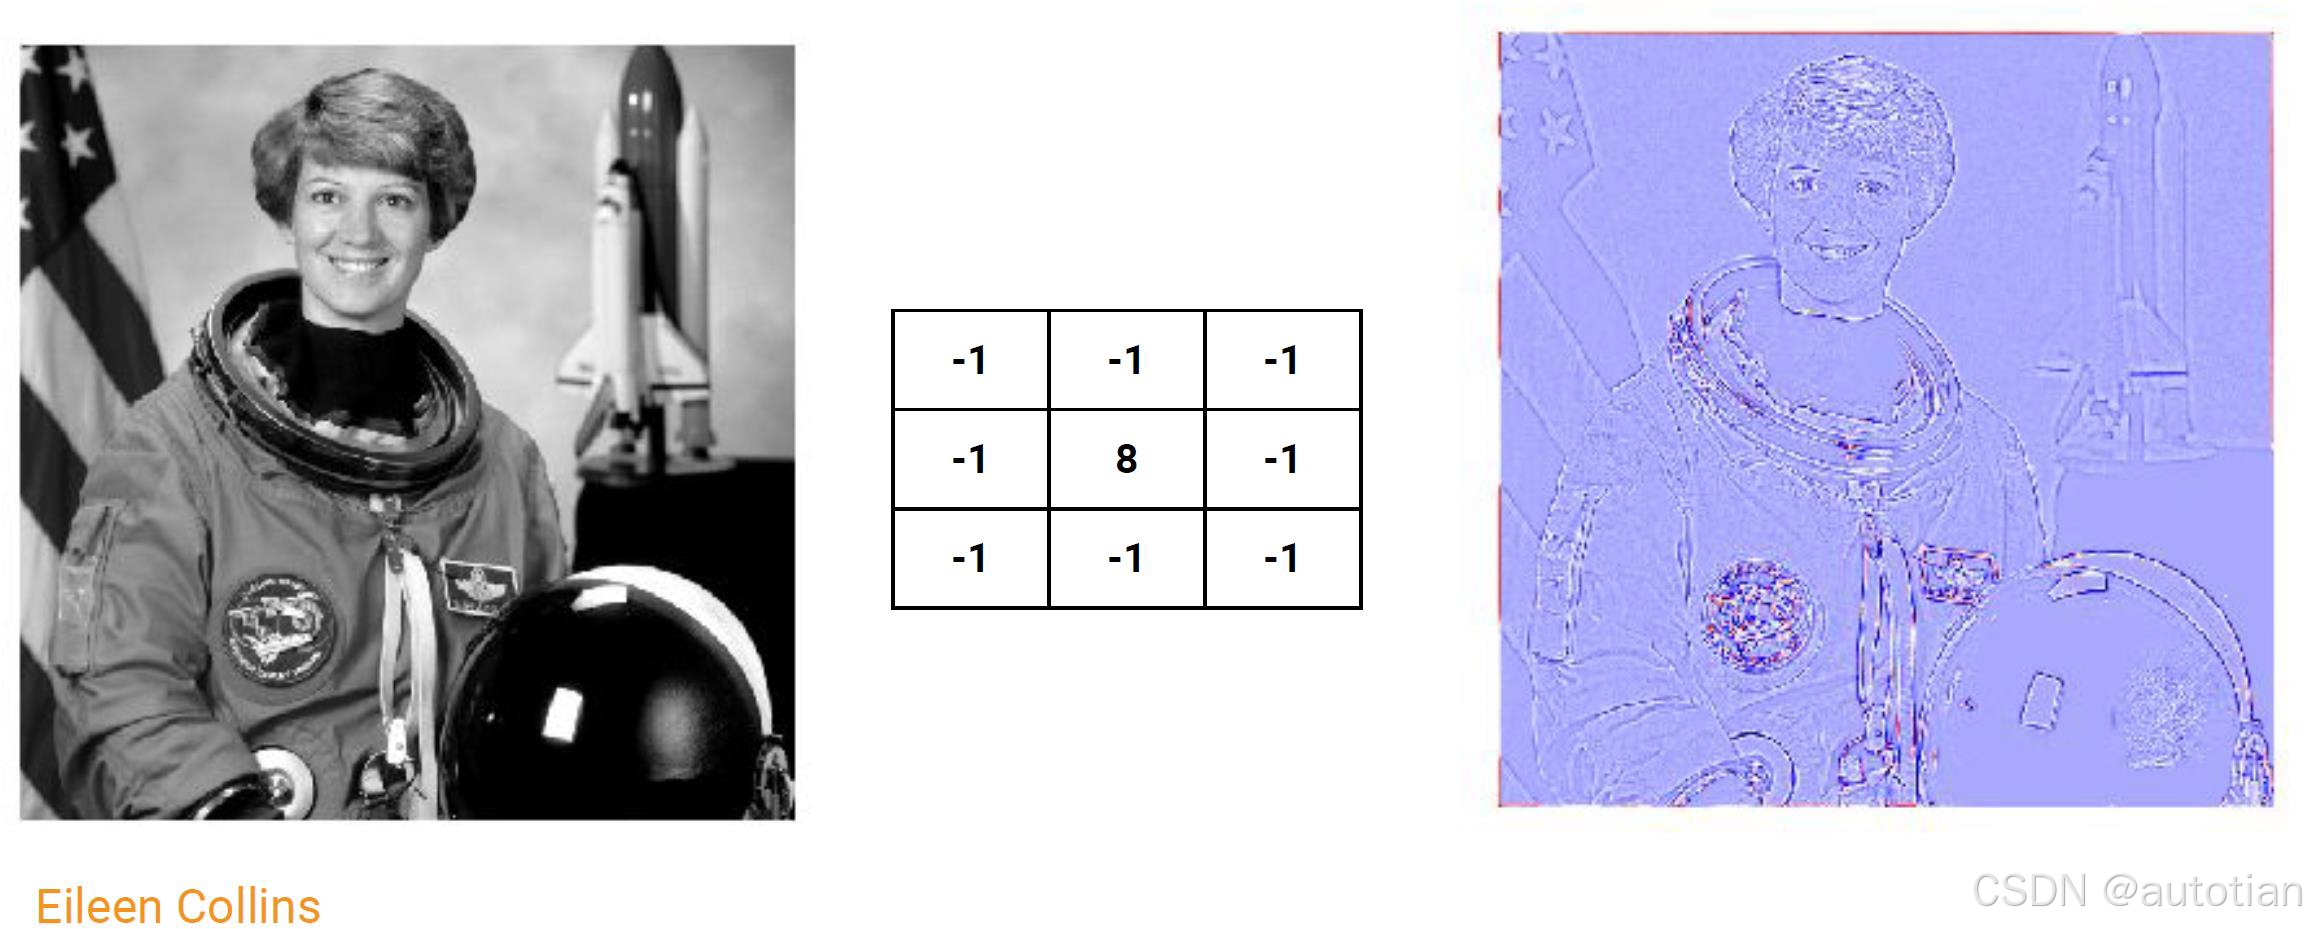
进行卷积编码,得到特征图,其包含了原始图各个方向的特征。卷积操作实现了感受野机制,能够提取图像中物体的总要特征。
下图为对图像进行一次卷积操作获取特征图后的样子
(3)神经网络中的感受野
定义公式:
其中,为步长即做卷积运算时一次移动几个像素,
为padding补零的大小即圈数(也可以非对称的补),
为卷积核大小,
为原始图大小,
为输出大小。
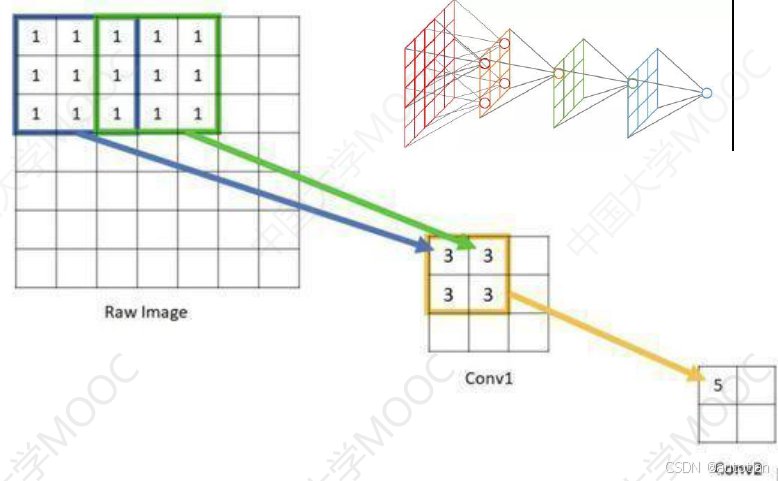
如,在下图输入图像大小为7,padding为0,f卷积核大小为3,步长为2,得到特征图大小为3
(4)多通道卷积(RGB)
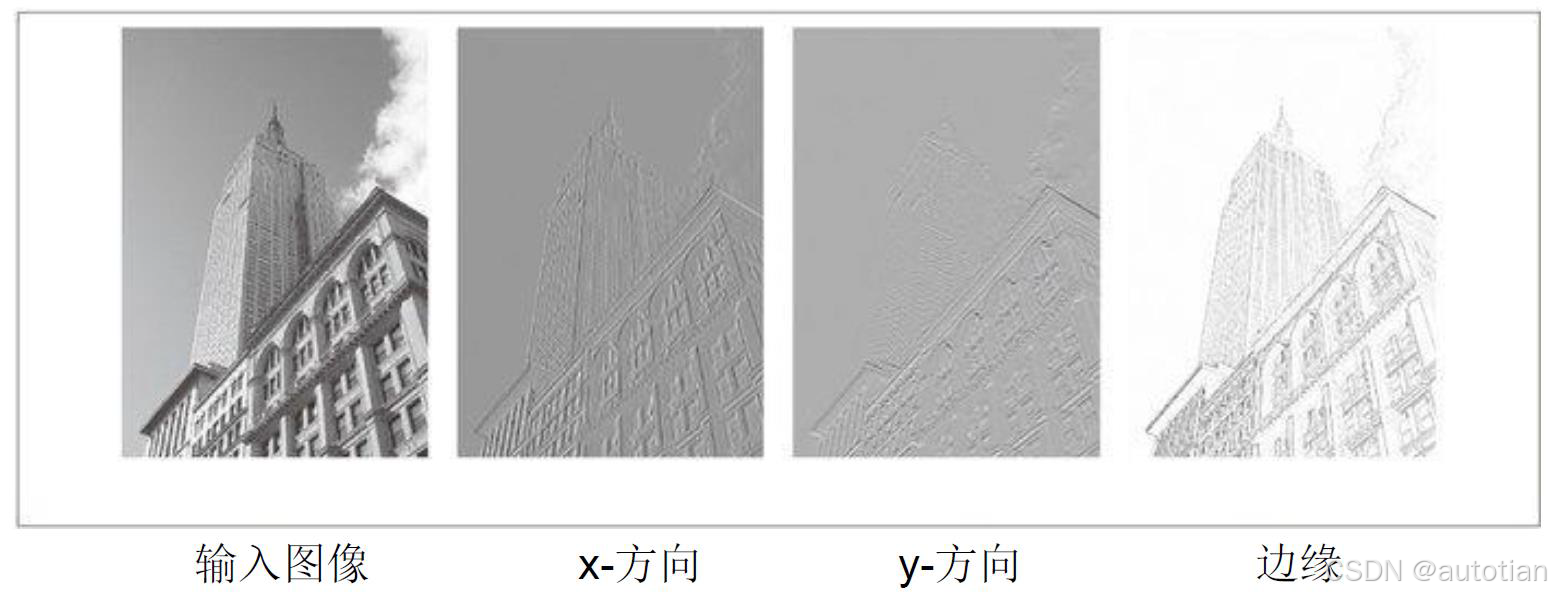
对于上图,提取x方向特征,可以将卷积核x方向即卷积核句子第一行元素设为1,其它行元素均为0;对于提取垂直方向特征,可以令卷积核垂直方向第一列均为1,其它列均为0。如果想要获取水平45度方向的特征,可以令卷积核斜对角元素均为1,其它元素均为0。
因此,对于同一张图可采用不同的卷积核,获取不同方向的特征。
一个卷积核只能获取一种特征,为获取多种特征。为此,选用多个卷积核。
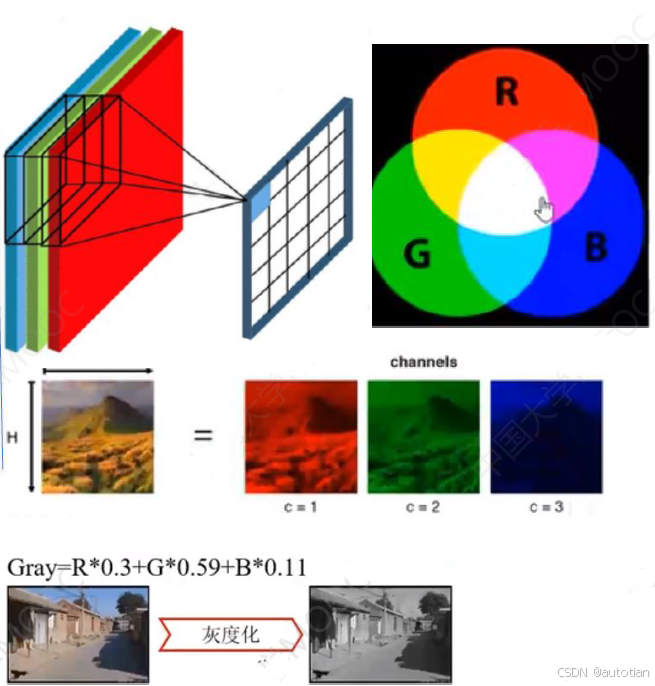
彩色图编码:
对于任意一个像素色彩都可以分成RGB三个值,为此,采用三个矩形c=1/c=2/c=3来编码这三个色彩。
采用三个卷积核分别做卷积,做完后再进行合成
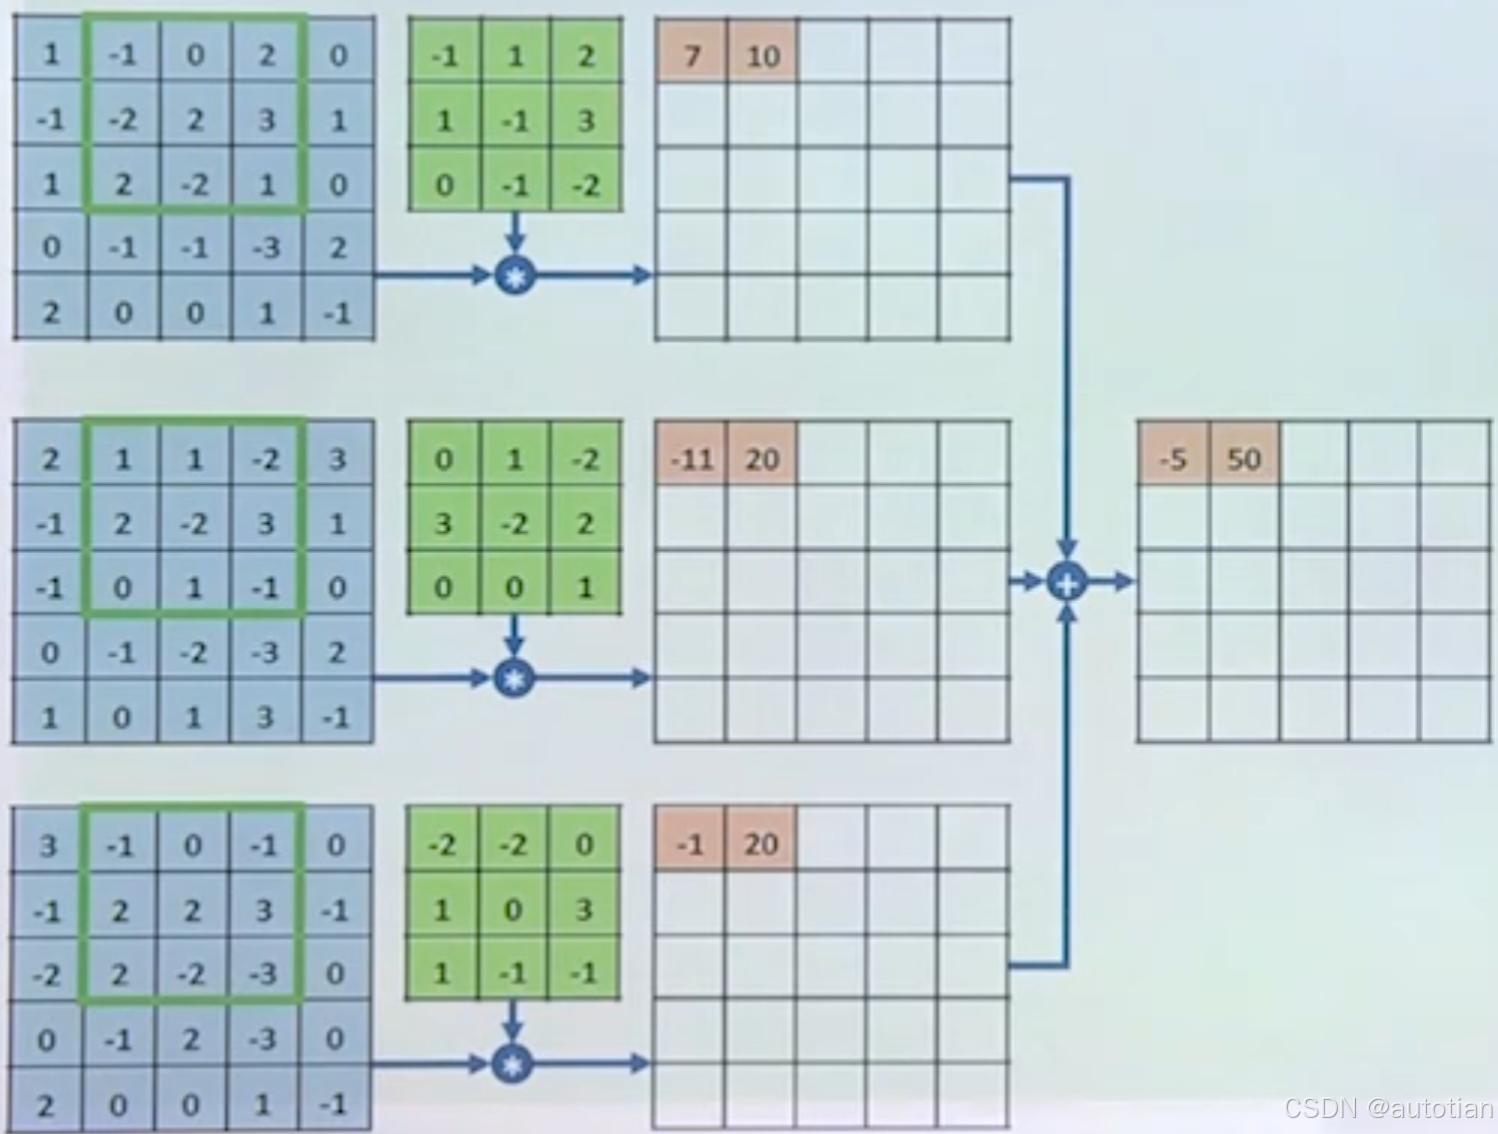
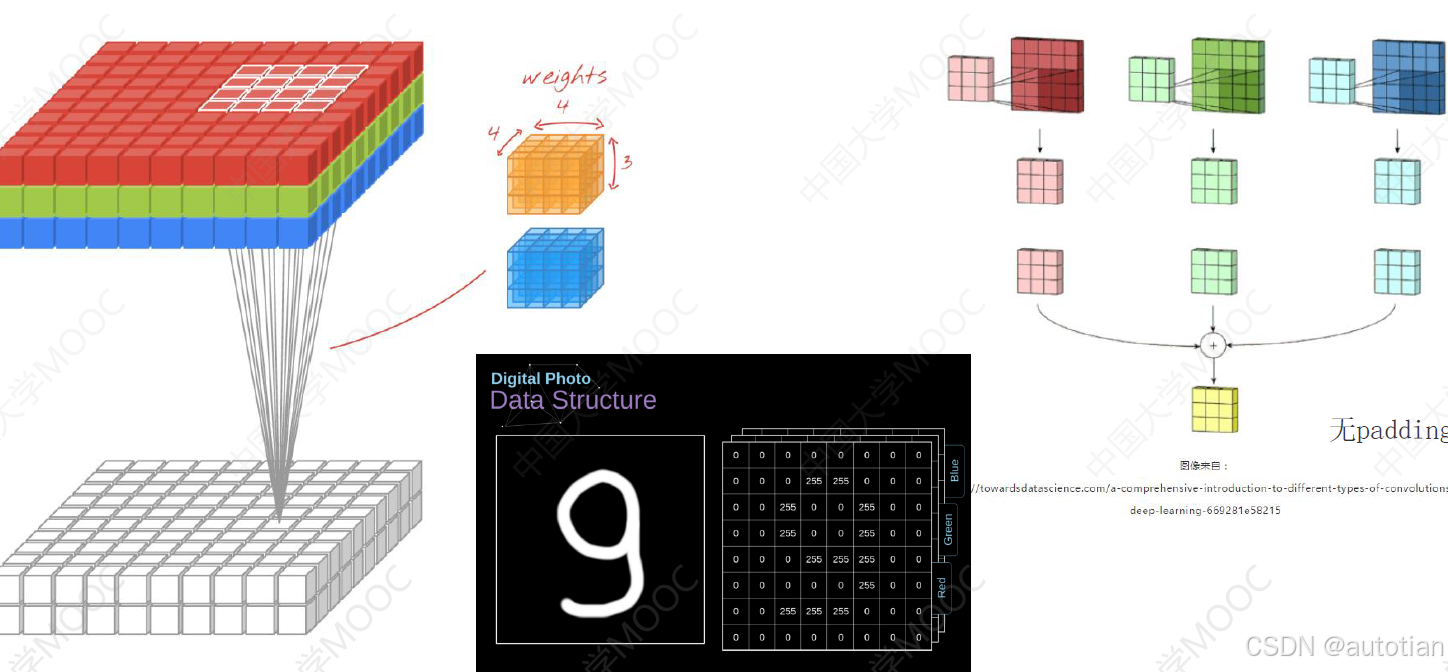
对于多通道补零,由于不同方向补零个数可能不一致,因此,计算公式为:
其中,为图像大小,
为滤波器大小,
为图像中的通道数,
为补零数,
为使用的步幅,
为滤波器个数。
对于彩色图的卷积,其本身为一种张量表示
(5)池化
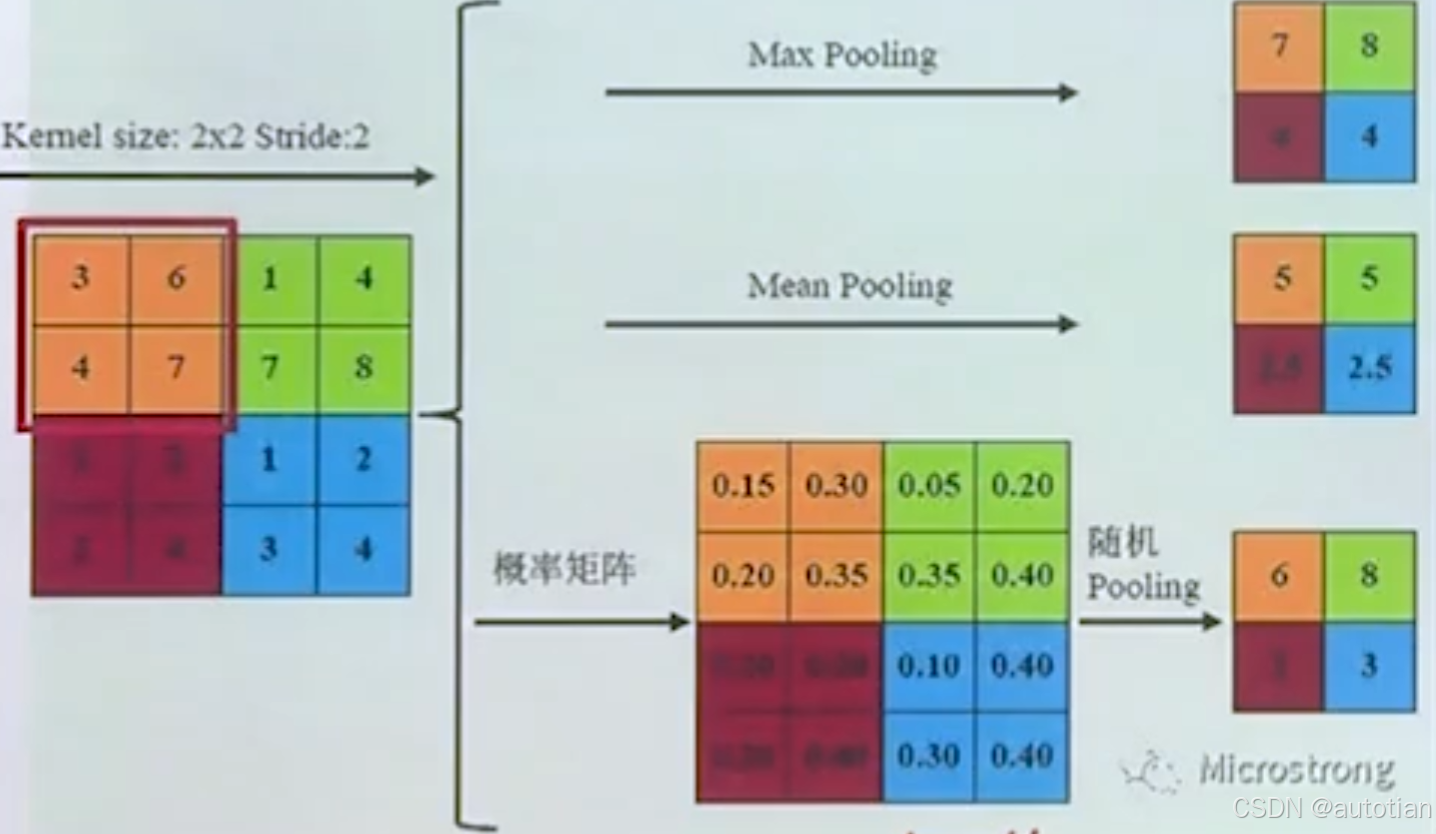
池化为进一步把信号压缩的方法,分为平均池化和最大池化。
平均池化,如下图,设定步长为2,则对每2x2的元素相加后除以元素个数,即求均值,用均值取代该2x2个元素。这样子进一步得到压缩,同时此区域若为长均值仍大,若深度较深其均值同样较大,在压缩同时还保留了特征。
最大池化:设定步长,如下图,在每2x2个元素里挑选最大值,可以突出该池化区域最突出的特征。
2.3、乐net五(Lenet5)卷积网络
LeNet卷积神经网络由LeCun在1998年提出,并成功用于手写数字识别,测试误差小于1%
其包括:输入层、卷积层、池化层、全连接层和输出层。
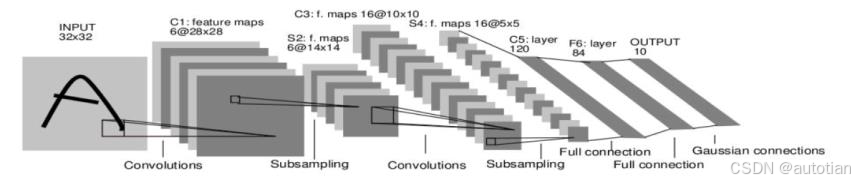
如上图,输入层选择28x28的手写图像,进行padding补零到32x32(2个填充像素)。
(1)卷积操作
主要完成特征的获取
与传统神经网络不同,卷积神经网络通过卷积核感受眼方式对特征提取。因此,在第一个卷积层采用六个卷积核(每个卷积核5x5像素),得到输出为28x28的点阵(步长为1)
对于每个卷积神经元,共有25个unit参数以及1个bias偏执参数;
对于原图32x32像素扫描中,每个像素均采用相同的网络。因此,连接后的总数目为(5*5+1)*6*(28*28)=122304个连接
总参数数目为:(5*5+1)*6=156个,其中1为偏置,5*5为卷积核像素,6为卷积核数目即6个通道。与前馈神经网络的重要区别,前馈神经网络多少个连接需要多少个参数,而在卷积神经网络由于共享了权重和偏置,优化数目大幅减少
(2)池化操作
池化即下采样,主要完成特征的压缩。卷积获取的特征编码仍然比较多数据量比较大,通过池化进一步压缩数据
如图中,采用2x2和步长为2的池化核。通过池化后特征图由28x28变为14x14.
池化后对应4条连线至形成特征图中的一个参数,同时参数也是共享的
连接数目为:(2*2+1)*6*(14*14)=5880个
参数数目:每个特征图共享参数,共2*6=12个参数(一个权重一个偏置,六个池化核)
(3)第二组卷积和池化(多通道卷积)
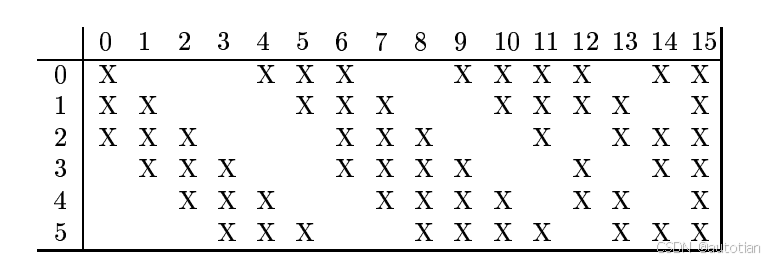
上图第二组卷积操作,共采用16个卷积核,特征提取如表中所示。即第0个卷积核提取第一组中0/1/2的特征,即一个卷积核对多个通道做卷积。
采用卷积核大小为5x5,则第二层卷积所需确定的参数为:
(5x5x3+1)x6+(5x5x4+1)x9+5x5x6+1=1516,其中里面的3/4/6为连接前面通道的数目,5x5为卷积核大小,6/9/1为进行相同连接通道数第二层卷积核的数目,1为偏置。
三、环境构建及示例
3.1 TensorFlow环境构建
(1)Anaconda环境构建
首先,下载并安装Anaconda,官方地址:Anaconda | Built to Advance Open Source AI
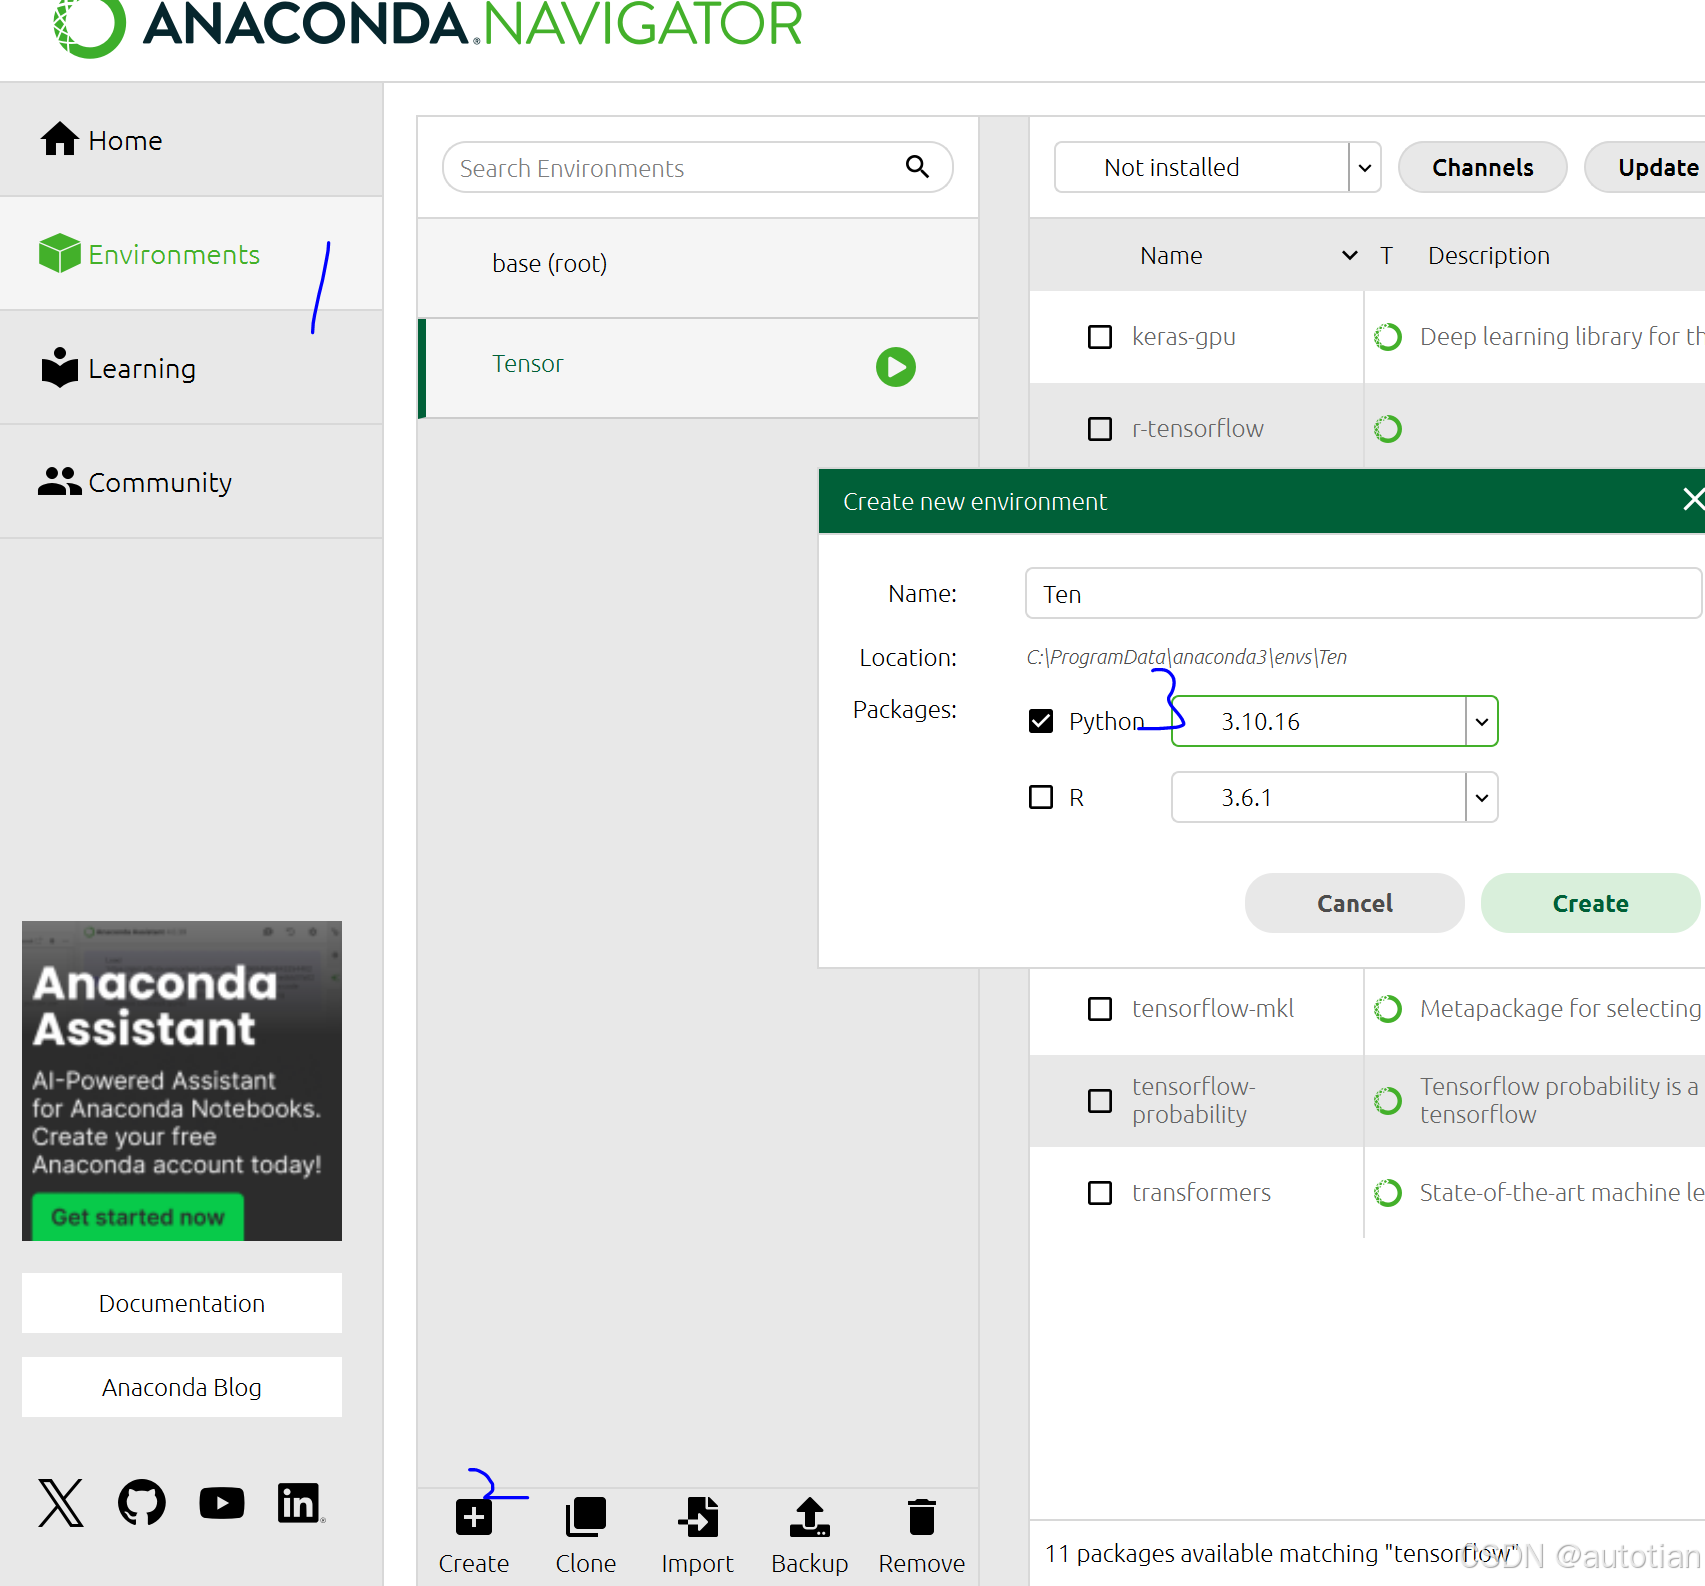
打开,程序,选择 Environments->Create->选择Python版本(目前内部TensorFlow支持3.10-3.11,后期可能会变)
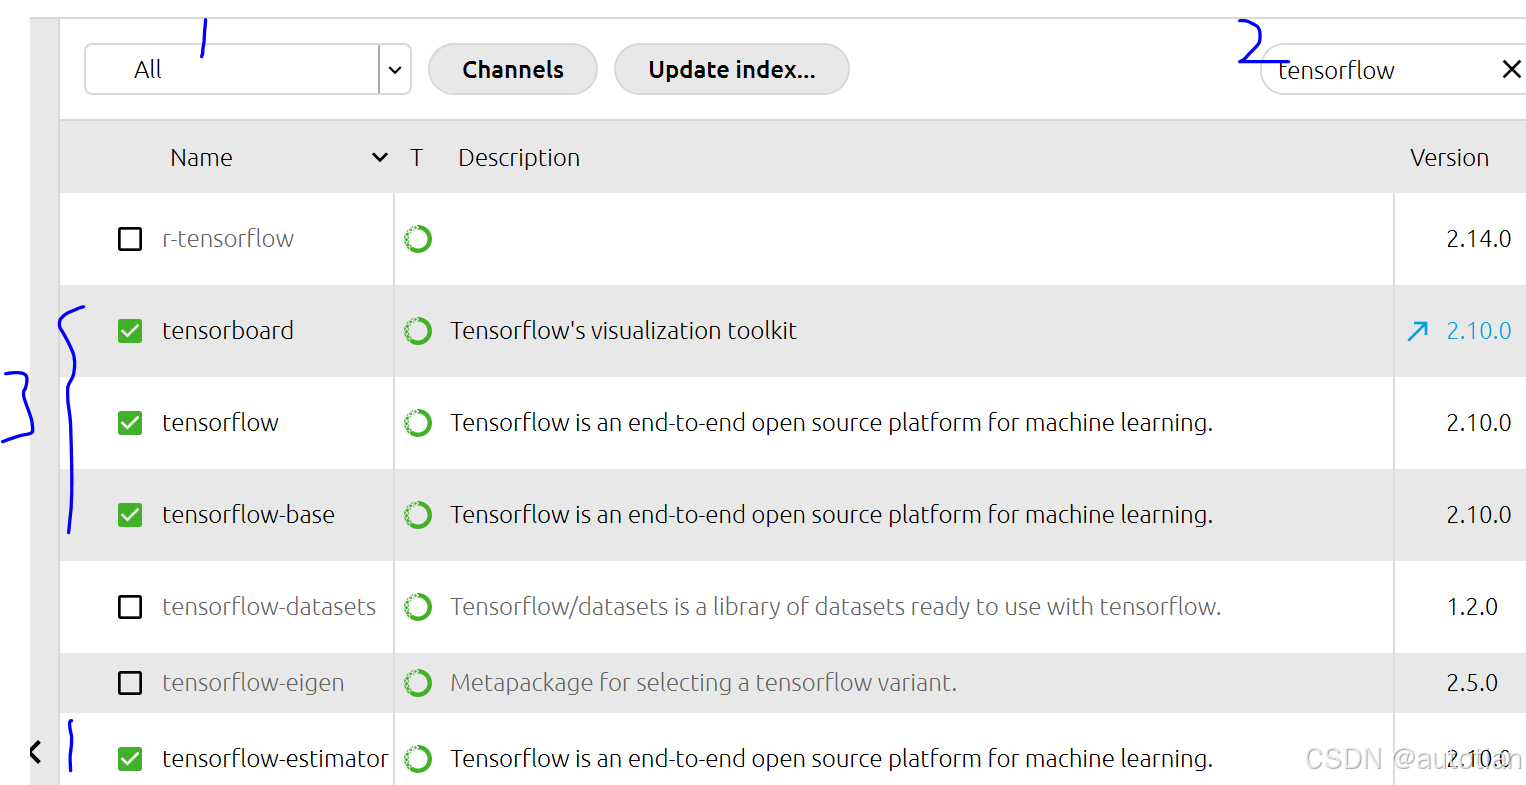
随后,在创建的环境里,上方搜索TensorFlow,并选择All,勾选tensorflow几个选项,点击Apply
点击Home,选择JupyterLab,点击Launch
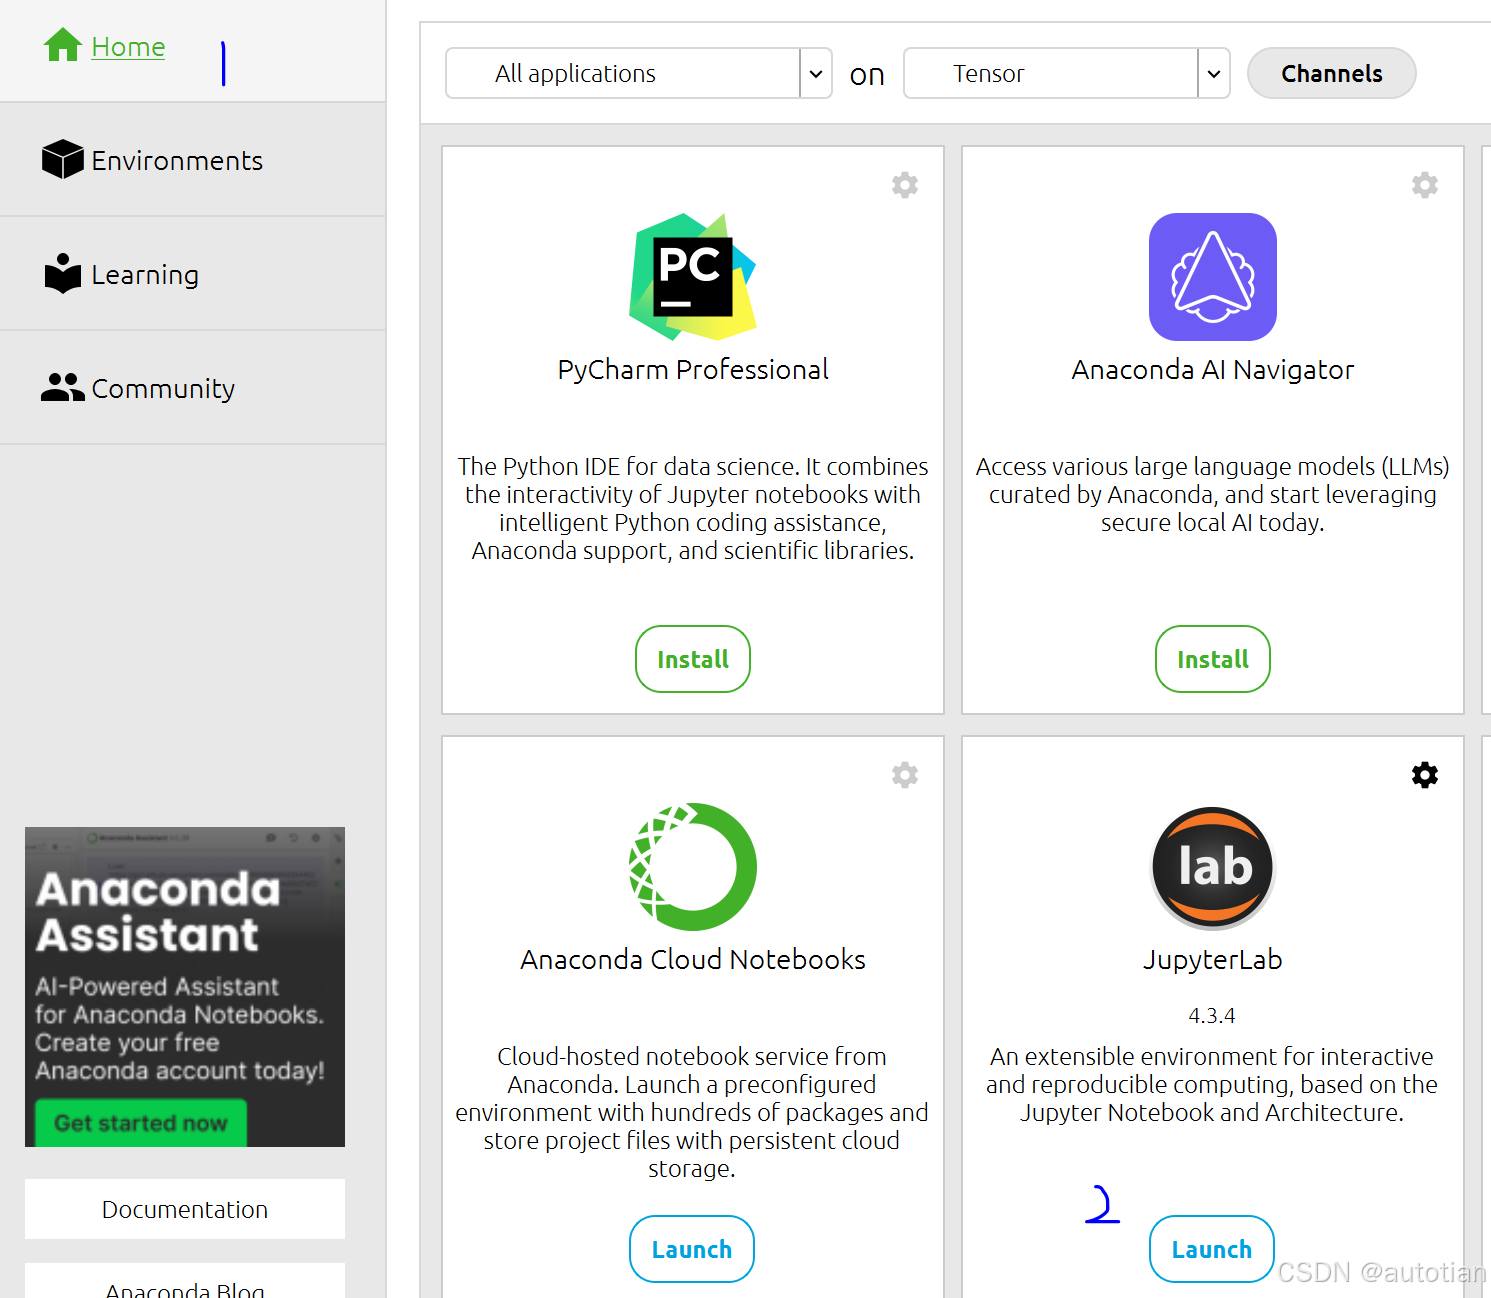
在打开的浏览器界面里选择 File->New->Notebook
输入以下两行代码,即可知道当前TensorFlow版本
python
import tensorflow as tf
print(tf.__version__)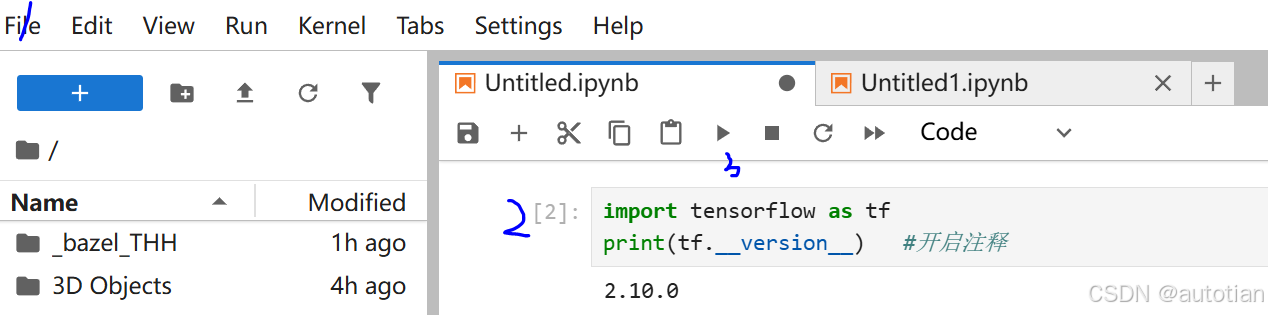
(2)一个神经元示例
通过神经元从x找到y?
x的数据为-1.0,0.0,1.0,2.0,3.0,4.0,y的数据为-3.0,-1.0,1.0,3.0,5.0,7.0
即x和y的关系为y=2x-1,输出当x=10时y的值
python
import numpy as np
from tensorflow import keras
# 构建模型
# layers表示单层,Units=1该层神经元个数为1,input_shape输入值只有1个
model=keras.Sequential([keras.layers.Dense(units=1,input_shape=[1])])
# mean_squared_error将均方误差作为误差值优化
model.compile(optimizer='sgd',loss='mean_squared_error')
# 准备训练数据
xs=np.array([-1.0,0.0,1.0,2.0,3.0,4.0],dtype=float)
ys=np.array([-3.0,-1.0,1.0,3.0,5.0,7.0],dtype=float)
# 训练模型
# epochs=100训练次数为100
model.fit(xs,ys,epochs=100)
# 使用模型
# 使用模型检查当x=10时的输出值
print(model.predict([10.0]))