企业级 Agent Memory 选型指南:如何构建可扩展的 Memory Service?
作 者:吴佳浩(Alben)
微信公众号:全栈架构师笔记
系列专栏:《企业级 Agent Memory 实战指南》· 第 04 篇
导读
单机原型阶段,Memory 是代码里的一个局部变量;企业生产阶段,Memory 是支撑成百上千 Agent 协同运转的认知中枢。
孤立的 Agent 只是工具,共享记忆的 Agent 才是组织。
未来企业真正管理的不是形形色色的 Agent,而是所有 Agent 共同依赖与演化的 Enterprise Memory Platform(Memory OS)。
在单机原型或小规模 PoC 阶段,我们通常将 Memory 作为 Agent 进程内的轻量组件直接挂载运行。但在大型企业级生产环境中,随着数十个业务 Agent(研发助理 Coding Agent、企业办公 Office Agent、客户洞察 CRM Agent、智能风控 Agent、商业智能 BI Agent)的同时上线,以及成千上万并发用户的接入,原先"进程内嵌入"的做法会立刻引发生态灾难: 企业级多 Agent 缺乏统一 Memory 的四大灾难 :
| 灾难现象 | 典型表现 | 架构根因 |
|---|---|---|
| 1. 记忆数据孤岛 (Data Silos) | Coding Agent 记住的技术栈偏好,Office Agent 无法感知,体验割裂 | 各 Agent 进程独立存储,缺乏统一的共享状态层 |
| 2. 状态并发冲突 (State Conflicts) | 多个 Subagent 并发修改项目状态,互相覆写彼此的认知导致脏写 | 缺乏分布式锁与版本控制 (CAS),发生状态撕裂 |
| 3. 安全合规失控 (Security Breaches) | 员工 A 的私有凭据或偏好,被员工 B 的 Agent 越权召回,违反 GDPR | 缺乏多租户强隔离与 RBAC 权限,无法一键合规级联销毁 |
| 4. 底层存储雪崩 (Storage Bottleneck) | 每个 Agent 实例各自执行耗时检索,底层向量与图库连接数被打爆 | 缺乏统一网关连接池与缓存控制,QPS 暴跌且延迟飙升 |
| Memory 已经不再是 Agent 的一个局部功能,而是整个 Agent Runtime 的核心基础设施。 |
企业要真正规模化落地 Agent,就必须将 Memory 从"单体功能组件"升级为高可用、高并发、安全可信的企业级独立微服务(Enterprise Memory Service / Memory Platform / Memory OS)。
一、终局视角:企业级 Agent 全景与三大 Runtime 拓扑
在企业级落地中,Agent 系统的底层架构已经收敛为清晰的"三大 Runtime"协作体系:
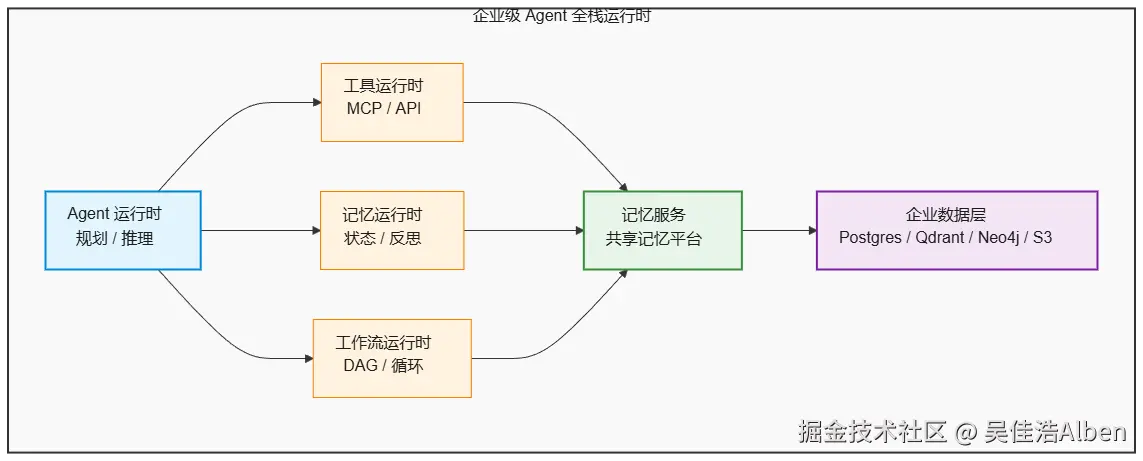
- 🔸 Tool Runtime:负责通过 MCP 协议与 API 连接物理世界(手和脚);
- 🔸 Workflow Runtime:负责多 Agent 的拓扑调度与状态流转(工作流编排);
- 🔸 Memory Runtime & Memory Service:构成跨越所有 Agent 的共享心智底座(海马体与黑板)。
一句话总结这一章的核心观点:
Tool Runtime 连接世界,Workflow Runtime 编排协作,Memory Runtime 沉淀心智。三者合一构成完整的 Agent OS。
二、技术选型决策树:什么时候需要 Memory Service?
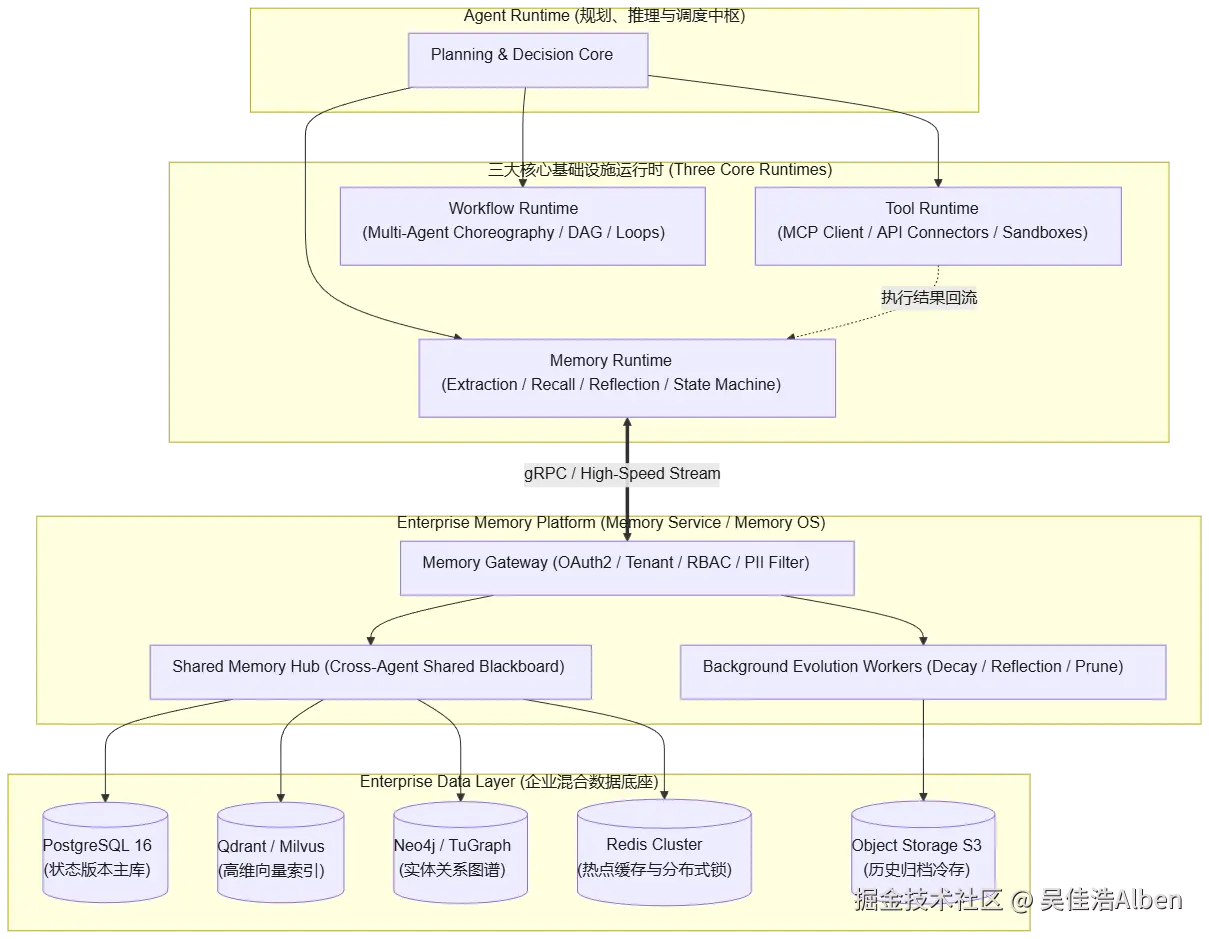
企业在立项时,架构师必须通过严密的决策链条评估系统复杂度,避免过度设计:
一句话总结这一章的核心观点:
静态查文档用 RAG,单机极客用 Hermes 嵌入式,多端协同与复杂实体推理必须上独立 Memory Service。
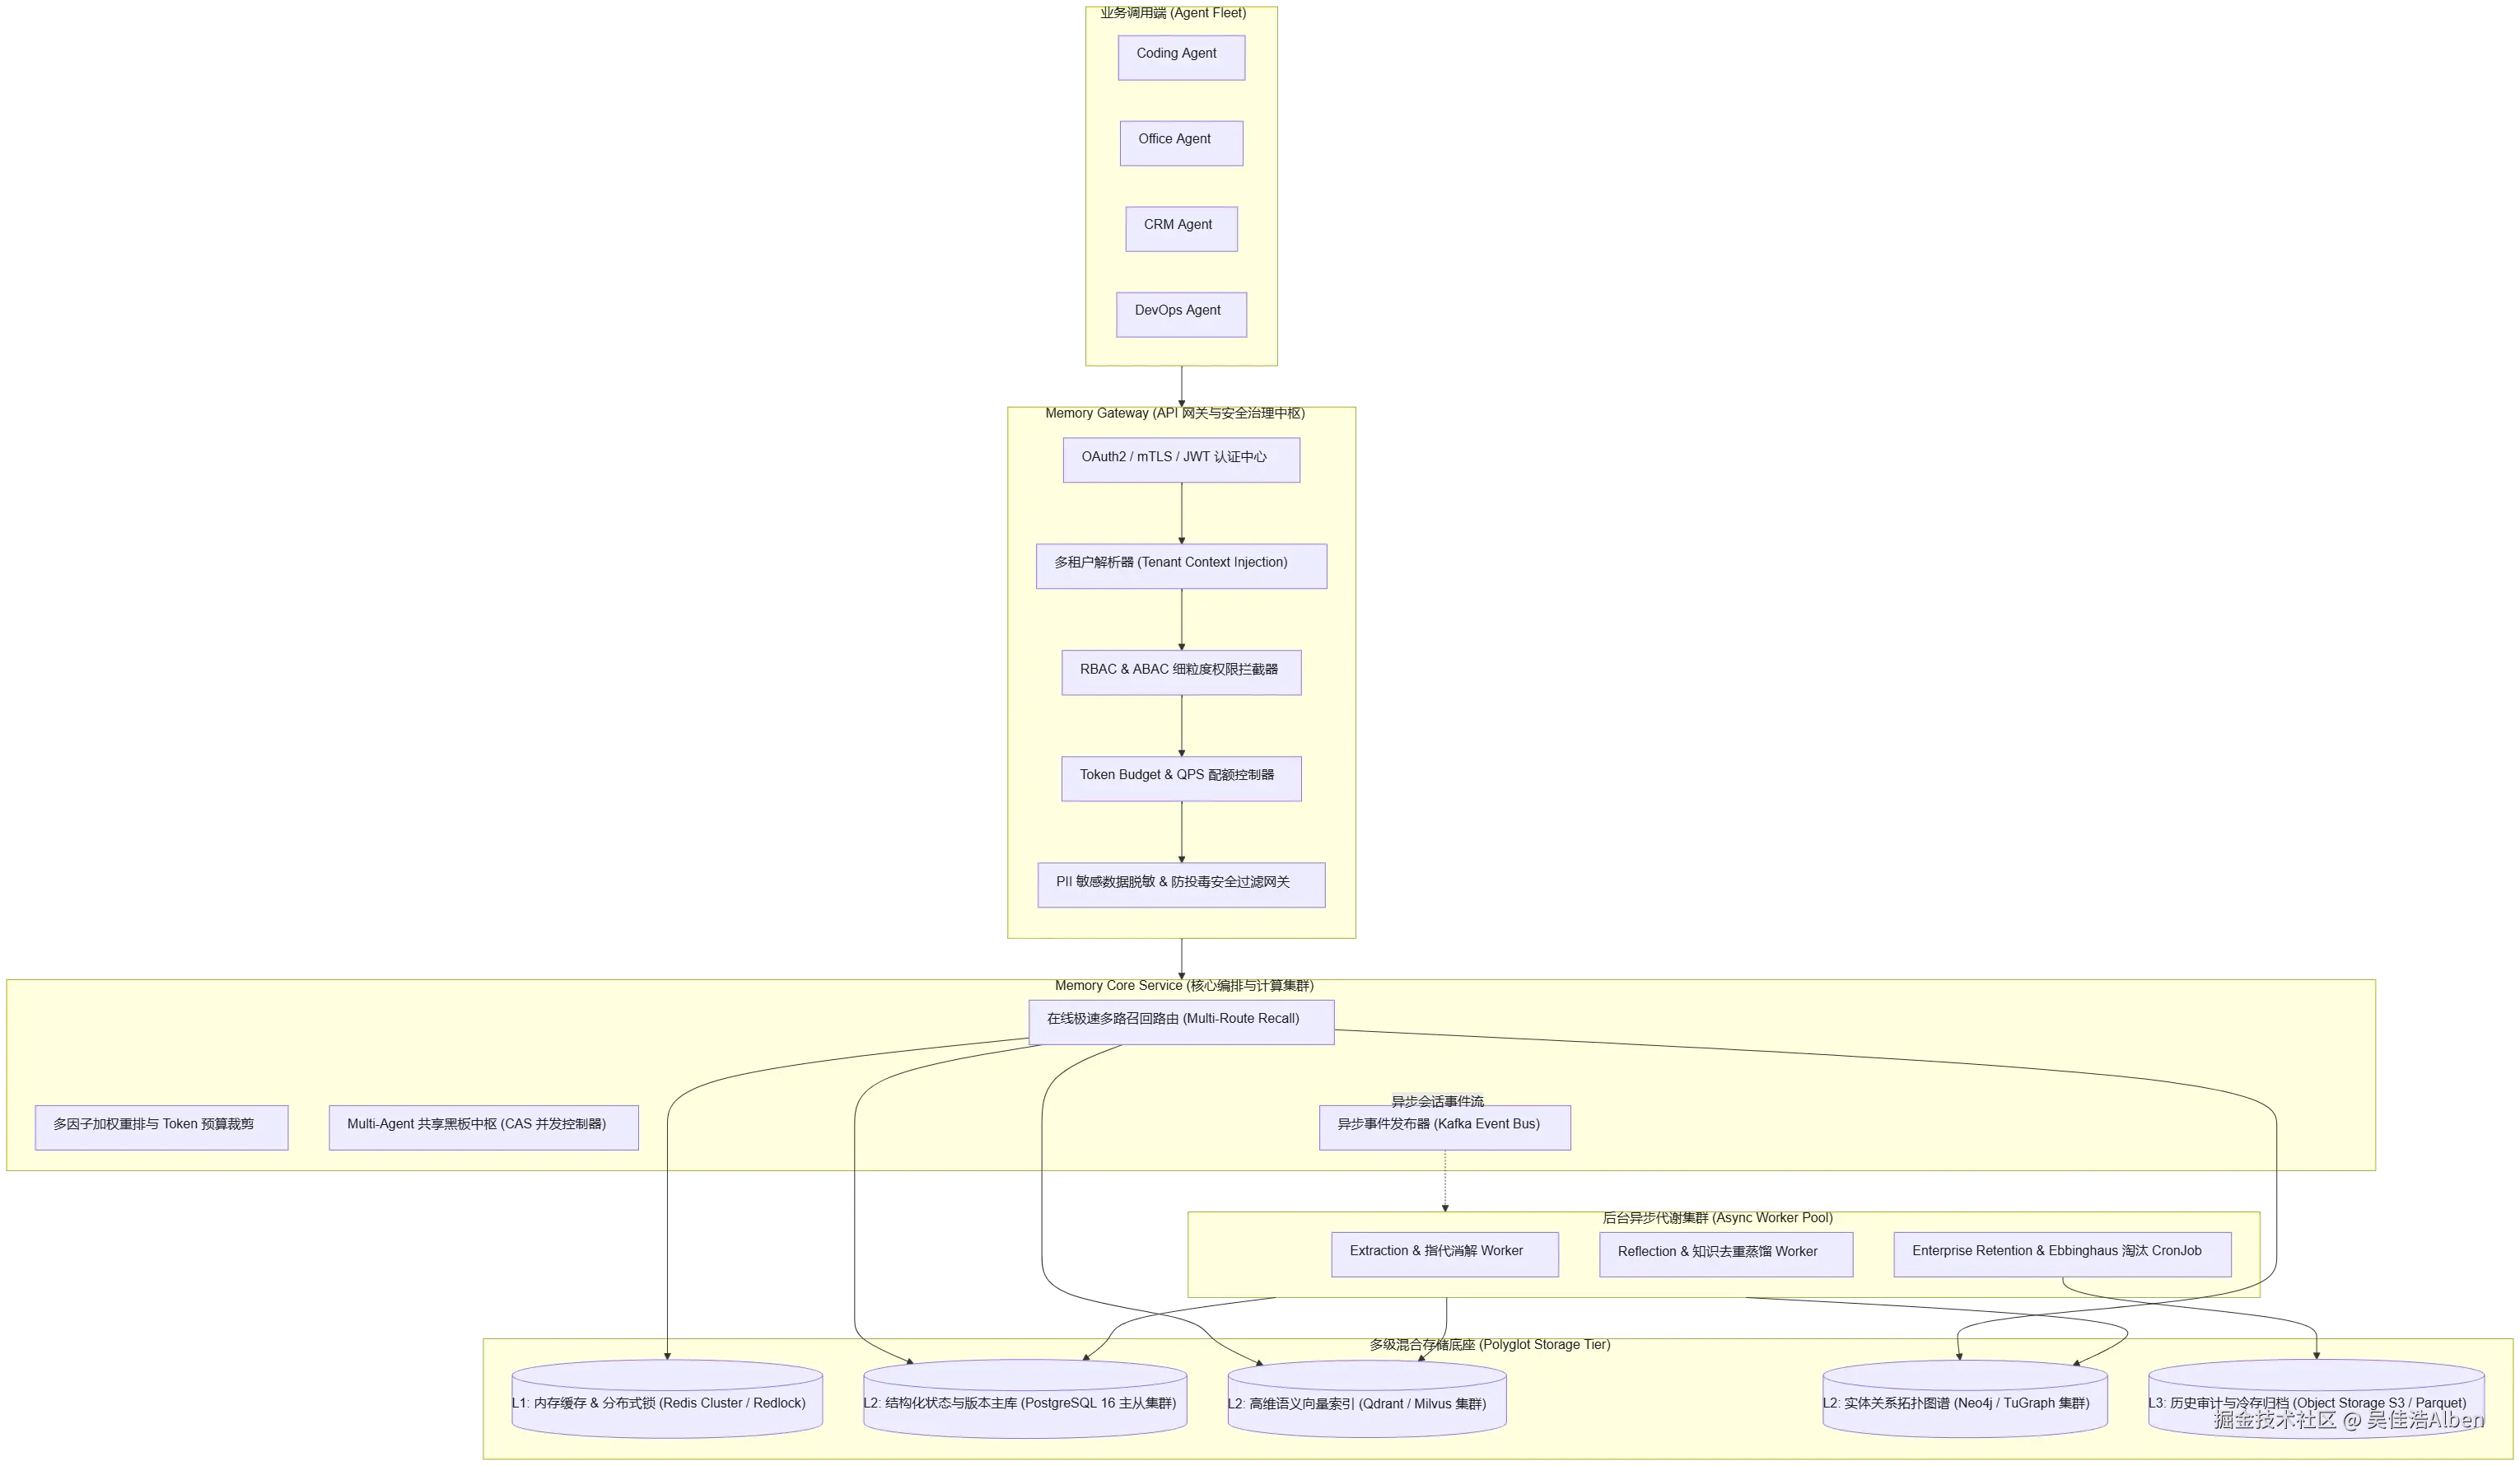
三、企业级 Memory Service 微服务拓扑架构
一个合格的企业级 Memory Service 必须具备高可用、弹性伸缩、读写分离与多租户强隔离能力。其核心微服务拓扑包含四大子系统:
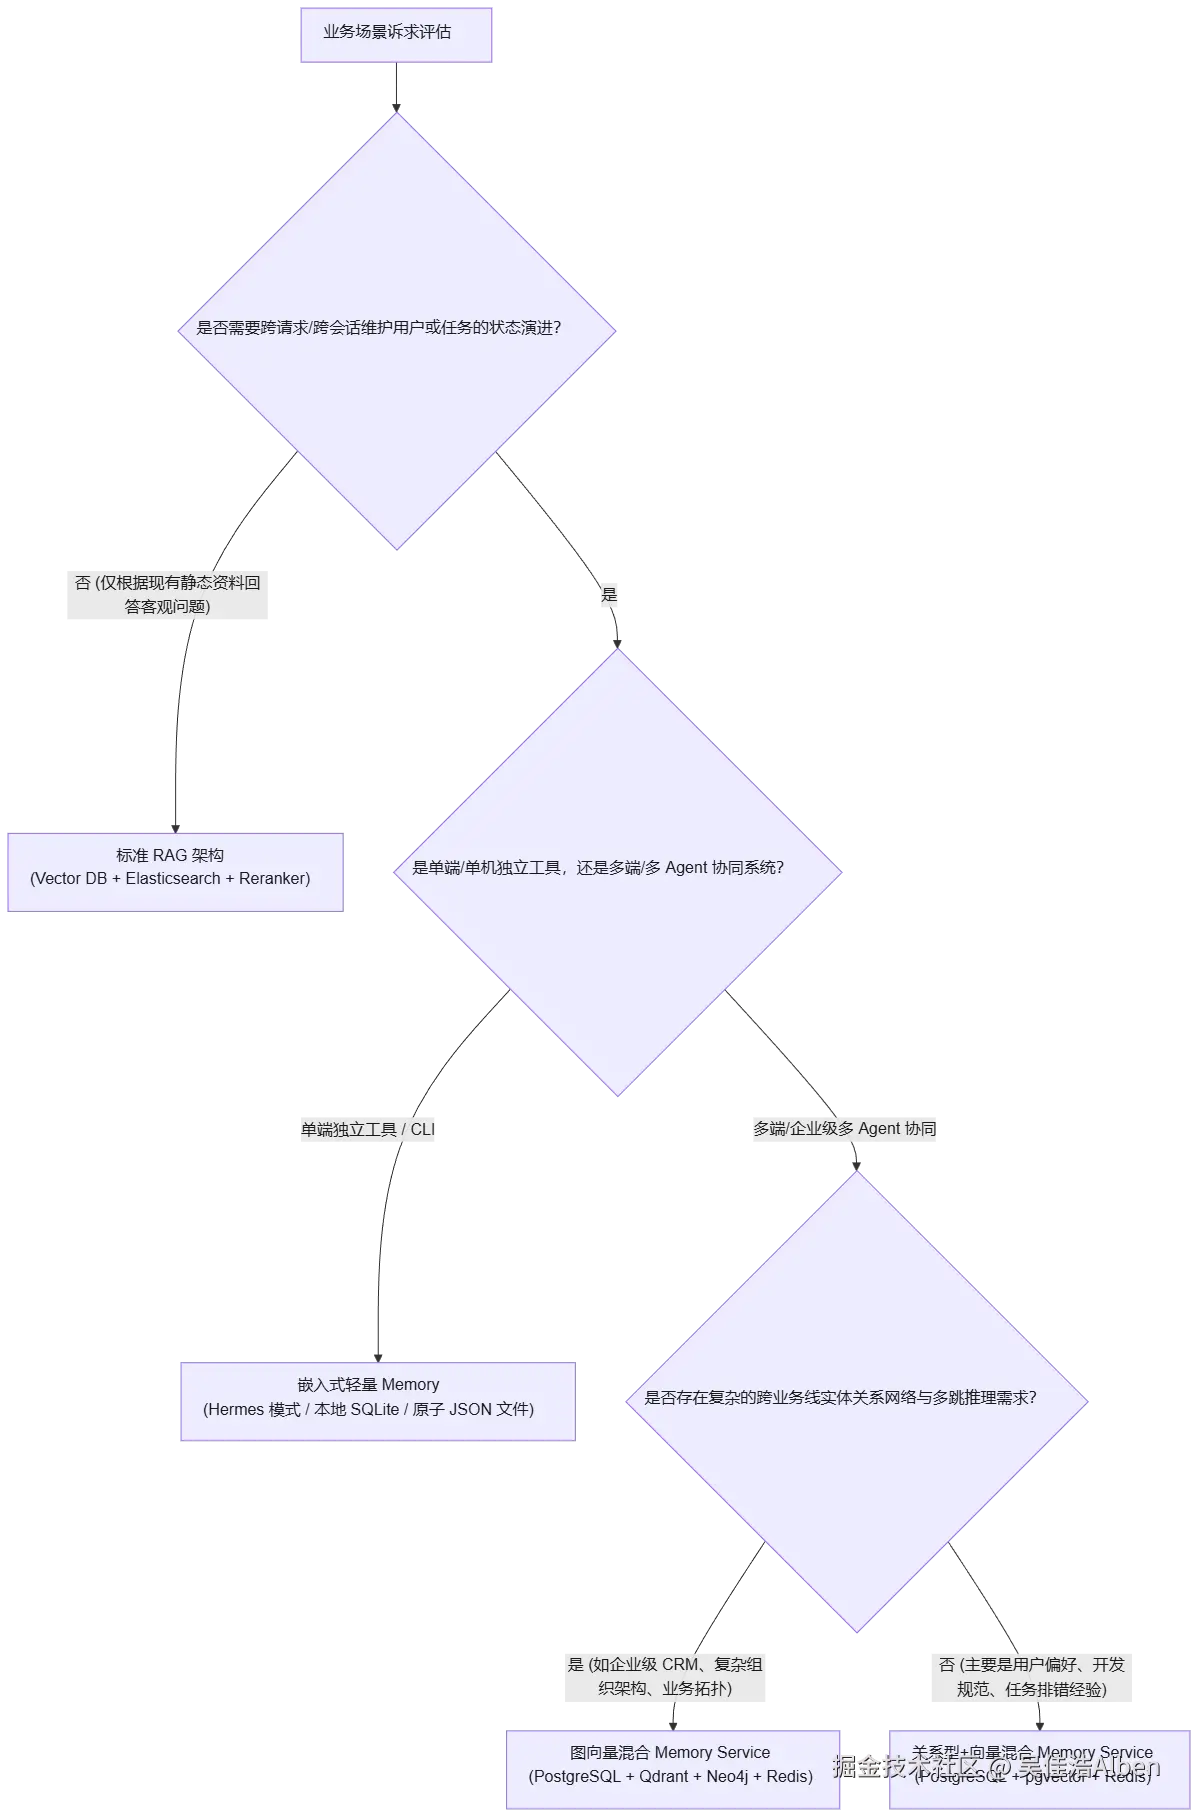
- 🔸 Memory Gateway:负责鉴权、多租户解析、细粒度 RBAC 与 PII 防投毒脱敏;
- 🔸 Core Engine:负责毫秒级多路召回路由与多 Agent 共享黑板;
- 🔸 Async Workers:离线消费 Kafka 事件,异步执行指代消解、因果反思与艾宾浩斯淘汰;
- 🔸 Polyglot Storage:L1 缓存 + L2 关系/向量/图主库 + L3 冷存分层。
一句话总结这一章的核心观点:
微服务化的本质,是把耗时的状态代谢从主对话链路上剥离出去,实现毫秒级响应与异步认知演进。
四、多 Agent 场景下的 Memory 共享与竞争:黑板模式
在企业级 Multi-Agent 协作场景下(例如架构师 Agent + 编码 Agent + 测试 Agent 协同完成复杂任务),多 Agent 之间必须既共享上下文,又杜绝脏写。
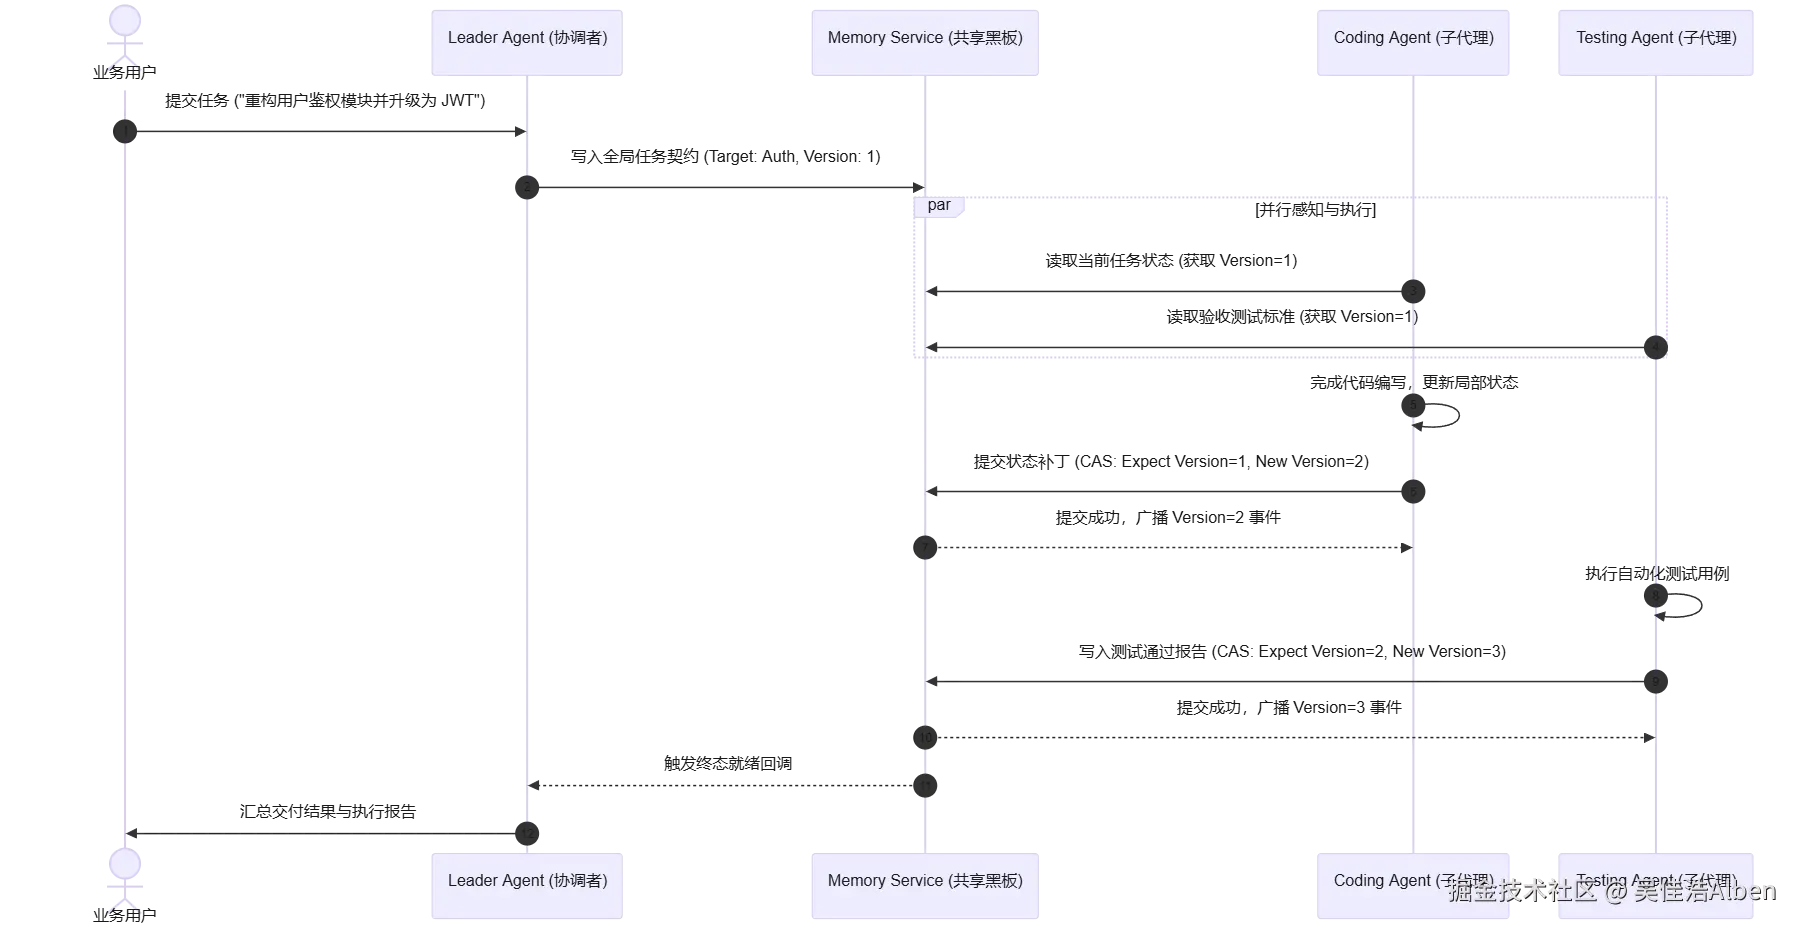
业界标准的解法是基于乐观并发控制(OCC / CAS)的分区共享黑板模式(Partitioned Blackboard Pattern):
黑板并发控制三原则
- 🔸 Compare-And-Swap(CAS)版本校验 :所有针对共享任务状态的修改必须携带
expected_version,一旦版本冲突立即拒绝并要求 Agent 重新拉取做语义合并; - 🔸 作用域强制隔离(Scope Partitioning) :严格划分
Global Shared、Team Shared与Agent Private; - 🔸 分布式租赁锁(Lease-based Locking):高危物理操作通过 Redis Redlock 申请带 TTL 的短期排他租约。
一句话总结这一章的核心观点:
没有版本控制的共享内存是并发灾难,基于 CAS 的黑板模式是 Multi-Agent 协同的基石。
五、记忆系统的安全防线(Memory Security)
在企业级落地中,Memory 面临的安全威胁远比传统数据库复杂。必须在网关与存储层构筑四道安全防线:
- 🔸 防投毒(Anti-Poisoning):识别反讽与假设句,严禁将未验证的 Password、Token 写入持久层;
- 🔸 防注入(Anti-Injection) :注入 Prompt 的记忆强制使用
<context_memory>沙箱化隔离标签包裹; - 🔸 PII 脱敏与合规:敏感实体自动掩码,支持一键级联 GDPR 物理粉碎。
一句话总结这一章的核心观点:
记忆不是无过滤的吸尘器。没有安全防线的 Memory Service,就是向黑客敞开的后门。
六、生产级数据库 DDL Schema 与微服务接口
以下为基于 PostgreSQL 16 + pgvector 构建的生产级数据库 DDL 定义与基于 FastAPI / Python 3.11+ 的微服务核心接口实现:
生产级 DDL Schema 设计 (migrations/001_init_memory_service.sql)
sql
-- 启用 pgvector 扩展与 UUID 生成器
CREATE EXTENSION IF NOT EXISTS vector;
CREATE EXTENSION IF NOT EXISTS "uuid-ossp";

-- 1. 企业多租户表
CREATE TABLE IF NOT EXISTS tenants (
    tenant_id VARCHAR(64) PRIMARY KEY,
    name VARCHAR(255) NOT NULL,
    plan_tier VARCHAR(32) DEFAULT 'enterprise',
    max_memory_items INT DEFAULT 1000000,
    created_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP
);

-- 2. 核心原子记忆实体表
CREATE TABLE IF NOT EXISTS enterprise_memories (
    id UUID PRIMARY KEY DEFAULT uuid_generate_v4(),
    tenant_id VARCHAR(64) NOT NULL REFERENCES tenants(tenant_id) ON DELETE CASCADE,
    user_id VARCHAR(128) NOT NULL,
    session_id VARCHAR(128),
    agent_id VARCHAR(64),

    -- 权限作用域 (0: Private, 1: Team, 2: Global)
    visibility_level SMALLINT DEFAULT 0 CHECK (visibility_level IN (0, 1, 2)),
    scope VARCHAR(32) NOT NULL DEFAULT 'user',
    category VARCHAR(32) NOT NULL DEFAULT 'semantic',

    -- 核心载荷
    content TEXT NOT NULL,
    embedding vector(1536), -- 匹配生产级 Embedding 模型维度

    -- 认知元数据
    importance FLOAT DEFAULT 0.5 CHECK (importance >= 0.0 AND importance <= 1.0),
    confidence FLOAT DEFAULT 1.0 CHECK (confidence >= 0.0 AND confidence <= 1.0),
    stability_hours FLOAT DEFAULT 72.0,
    access_count INT DEFAULT 0,
    version INT DEFAULT 1,

    -- 生命周期与状态
    is_archived BOOLEAN DEFAULT FALSE,
    created_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP,
    updated_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP,
    last_accessed_at TIMESTAMP WITH TIME ZONE DEFAULT CURRENT_TIMESTAMP,

    -- 扩展元数据 (JSONB)
    metadata JSONB DEFAULT '{}'::jsonb
);

-- 高并发检索索引
CREATE INDEX IF NOT EXISTS idx_mem_tenant_user_active
    ON enterprise_memories(tenant_id, user_id, is_archived)
    WHERE is_archived = FALSE;

CREATE INDEX IF NOT EXISTS idx_mem_embedding_hnsw
    ON enterprise_memories USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 64);

CREATE INDEX IF NOT EXISTS idx_mem_metadata_gin
    ON enterprise_memories USING gin (metadata);
微服务核心层实现 (src/api/gateway.py)
python
"""
memory_service_api.py
企业级 Memory Service 核心网关与统一服务接口实现
"""

from __future__ import annotations

import uuid
from datetime import datetime
from typing import Any, Dict, List, Optional
from fastapi import FastAPI, Header, HTTPException, Depends, status
from pydantic import BaseModel, Field


app = FastAPI(title="Enterprise Agent Memory Service", version="1.0.0")


# --- 契约模型 ---

class MemoryRecallRequest(BaseModel):
    query: str
    user_id: str
    session_id: Optional[str] = None
    agent_id: Optional[str] = None
    top_k: int = Field(default=5, ge=1, le=50)
    token_budget: int = Field(default=800, ge=100, le=4000)
    min_confidence: float = Field(default=0.6, ge=0.0, le=1.0)


class MemoryRecallResponse(BaseModel):
    formatted_prompt: str
    injected_tokens_estimate: int
    items_count: int
    execution_time_ms: float


class MemoryWriteRequest(BaseModel):
    user_id: str
    session_id: Optional[str] = None
    agent_id: Optional[str] = None
    content: str
    category: str = "semantic"
    importance: float = 0.5
    visibility_level: int = 0  # 0: Private, 1: Team, 2: Global
    metadata: Dict[str, Any] = Field(default_factory=dict)


# --- 核心安全与鉴权依赖 ---

async def verify_tenant_and_security(
    x_tenant_id: str = Header(..., alias="X-Tenant-ID"),
    authorization: str = Header(..., alias="Authorization"),
) -> str:
    """网关多租户解析与鉴权校验"""
    if not x_tenant_id or not authorization.startswith("Bearer "):
        raise HTTPException(
            status_code=status.HTTP_401_UNAUTHORIZED,
            detail="Invalid tenant or authorization header",
        )
    return x_tenant_id


# --- 核心 API 端点 ---

@app.post("/v1/memory/recall", response_model=MemoryRecallResponse)
async def recall_memories(
    request: MemoryRecallRequest,
    tenant_id: str = Depends(verify_tenant_and_security),
):
    """在线极速多路召回接口"""
    start_time = datetime.utcnow()

    mock_memories = [
        f"用户偏好使用 PostgreSQL 作为主力数据库 (Confidence: 1.0)",
        f"项目构建命令已固定为 'pnpm build',严禁使用 npm (Confidence: 0.95)",
    ]

    formatted_lines = ["<context_memory>"]
    for item in mock_memories:
        formatted_lines.append(f"- {item}")
    formatted_lines.append("</context_memory>")

    prompt_str = "
".join(formatted_lines)
    elapsed_ms = (datetime.utcnow() - start_time).total_seconds() * 1000.0

    return MemoryRecallResponse(
        formatted_prompt=prompt_str,
        injected_tokens_estimate=len(prompt_str) // 2,
        items_count=len(mock_memories),
        execution_time_ms=round(elapsed_ms, 2),
    )


@app.post("/v1/memory/mutate", status_code=status.HTTP_201_CREATED)
async def mutate_memory(
    request: MemoryWriteRequest,
    tenant_id: str = Depends(verify_tenant_and_security),
):
    """状态回写与事实变更接口"""
    if "password" in request.content.lower() or "secret" in request.content.lower():
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail="Security Violation: Credentials cannot be persisted into memory",
        )

    record_id = str(uuid.uuid4())
    return {
        "status": "success",
        "record_id": record_id,
        "tenant_id": tenant_id,
        "version": 1,
        "message": "Memory persisted successfully",
    }


@app.delete("/v1/memory/gdpr/purge", status_code=status.HTTP_200_OK)
async def purge_user_memories(
    user_id: str,
    tenant_id: str = Depends(verify_tenant_and_security),
):
    """GDPR / 合规级联销毁接口"""
    return {
        "status": "success",
        "tenant_id": tenant_id,
        "purged_user_id": user_id,
        "purged_records_count": 42,
        "purged_at": datetime.utcnow().isoformat(),
    }
七、生产落地踩坑总结(Pitfalls & Hard Lessons)
在多个大型企业级 Agent 项目的落地实践中,我们总结了三条最核心的避坑准则:
- 🔸 严格限制 Consolidation 的作用域边界 :实体抽取必须强绑定
Project_ID或Environment_ID,严禁跨上下文过度合并导致概念漂移(Concept Drift); - 🔸 向量库必须做租户级物理/分片隔离:严禁把所有租户数据混在一个 Collection 里单靠 Filter 过滤,否则千万级数据下 QPS 暴跌 90%;
- 🔸 必须建立自动化冷热分层流水线:活跃记忆常驻内存与向量库,90 天以上低频事件自动转为 Parquet 归档至 S3。
一句话总结这一章的核心观点:
踩坑的代价是高昂的,提前规划好隔离边界与冷热归档,是保障系统长治久安的关键。
系列总结:通向 Memory OS 的未来演进
至此,我们的四篇专栏构建了完整的体系闭环:
- 🔸 第 01 篇:从大模型应用演进史出发,追问并厘清了 Context、RAG、MCP 和 Memory 的本质边界;
- 🔸 第 02 篇:将人脑认知系统映射至 Agent 架构,建立了分层认知模型与量化评估体系;
- 🔸 第 03 篇:剖析了 Memory Runtime 的核心思想,解构了主流 Provider 的底层权衡与 SPI 统一抽象;
- 🔸 第 04 篇:构建了包含三大 Runtime、共享黑板与多级混合存储的企业级 Memory Platform 实战体系。
行业未来的终局演进:Memory OS
当我们观察行业顶级玩家的动作时,趋势已经非常明确:
- Claude / ChatGPT 开始构建跨会话的持续记忆体系;
- Cursor 开始深度解析本地代码变更历史与调试习惯形成程序性记忆;
- Hermes / Mem0 正在从单纯的轻量 SDK 演进为企业级的 Memory Platform。
未来的企业不会为每一个 Agent 单独配置孤立的 Memory 模块,而是会部署一套统一的 Memory OS。
所有的业务 Agent(Coding Agent、Office Agent、Sales Agent、CRM Agent、BI Agent)都将挂载在这套统一的企业级认知底座上,共享上下文、沉淀企业私有经验、实现跨 Agent 的无缝协同。
构建具备连续心智的企业级 Agent,是一场横跨 AI Infra、分布式存储、认知科学与软件工程的系统性长征。清晰的架构演进逻辑与扎实的工程落地,永远是架构师最核心的护城河。
筒子们本篇为《企业级 Agent 实战指南》· 第一章的第 04 篇,也就是第一章Memory的最后一篇,后续续会更新完整的agent的开发的全部过程,如果你对Agent开发感兴趣不妨关注一下本合集。