Memory Provider 实战:Hermes、Mem0、Honcho、Hindsight 为什么都这样设计?
作 者:吴佳浩(Alben)
微信公众号:全栈架构师笔记
系列专栏:《企业级 Agent Memory 实战指南》· 第 03 篇
导读
很多工程师以为接入 Memory 就是调一个 VectorDB 的 SDK;但真正跑在生产环境中的,是一个完整的 Memory Runtime。
存储只是状态的物理载体,真正的智能来自于上层的召回、重排、合并、反思与预算控制。
没有 Provider SPI 抽象,系统就会被单一数据库死锁;没有 Memory Runtime,Agent 就只是一个到处乱插数据库的简陋脚本。
在过去一年多时间里,开源社区与商业生态中涌现出一大批代表性的 Memory 框架:从极简嵌入式的 Hermes Memory ,到主打图向量双引擎的 Mem0 ,再到强调动态心智推断的 Honcho 、主打时序因果反思的 Hindsight ,以及垂直场景的 OpenViking、Supermemory、ByteRover、RetainDB。
许多团队在做技术选型时,往往只看 GitHub Star 数量或官方 Demo 演示,误以为它们只是"向量数据库(VectorDB)或 Redis 的 CRUD 封装库"。
但如果深入它们的底层源码与系统拓扑,就会发现一个根本性的设计事实:
Memory 根本不是一种存储(Storage),而是一套完整的运行时(Memory Runtime)。
在这个运行时体系中,VectorDB、GraphDB、SQL 仅仅是处于最末端的持久化存储介质;而真正的核心,在于围绕状态演进展开的 Recall、Ranking、Merge、Reflection、Profile、Forget、Budget Control 等一系列状态计算与生命周期调度。
这就是为什么整个行业最终都走向了统一的 Provider SPI(Service Provider Interface)抽象。
一、核心视角:Memory 不是存储,而是 Memory Runtime
如果把 Memory 理解为单纯的数据库读写,系统的认知能力就会极其脆弱。在现代先进 Agent 架构中,Memory Runtime 的完整生命周期流向如下: 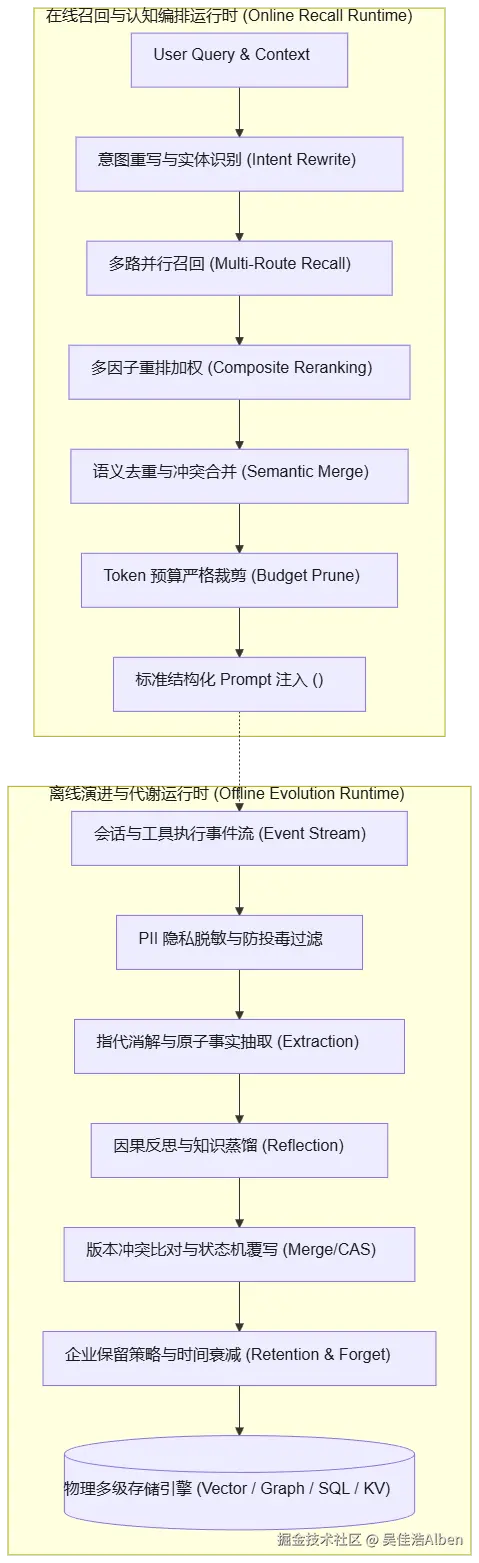
- 🔸 存储只是物理载体:VectorDB、GraphDB 只是磁盘上的字节集合;
- 🔸 运行时才是大脑中枢:包括 Prompt 注入前的多因子 Rerank、Token 预算裁剪、会话后的异步指代消解与因果反思。
一句话总结这一章的核心观点:
区分"存储"与"运行时",是理解现代 Agent Memory 架构演进的关键分水岭。
二、为什么需要统一的 Memory Provider SPI 抽象层?
如果应用层代码直接与底层的存储驱动紧密耦合,会导致四个致命的架构缺陷:
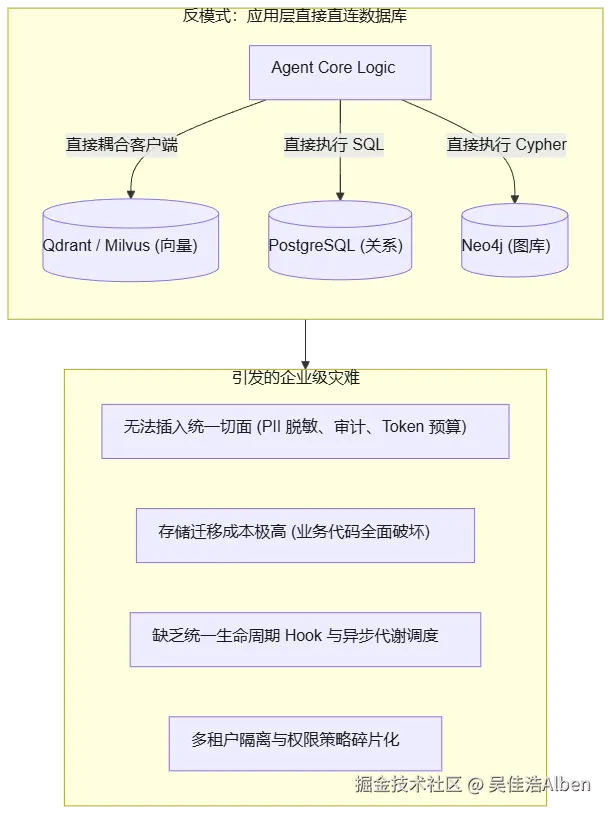
- 🔸 异构存储融合(Polyglot Persistence):单一存储介质无法同时搞定 Profile 强一致性、向量模糊检索与实体多跳图推理;
- 🔸 横切关注点与 Hook 机制:必须在读写前后插入 PII 脱敏、预算控制、租户隔离与审计埋点;
- 🔸 生命周期与业务解耦:让前台推理与后台代谢守护进程共享同一套领域模型。
一句话总结这一章的核心观点:
统一 Provider SPI 的本质,是用标准的控制平面(Control Plane)屏蔽异构存储的数据平面(Data Plane)。
三、八大主流 Memory Provider 架构与设计权衡深度剖析
主流记忆系统提供商对比:
| Provider | 核心设计哲学 | 底层存储底座 | 最适配业务场景 |
|---|---|---|---|
| Hermes | 零基础设施依赖、原子补丁;强上下文预算与直接注入 | SQLite / Markdown / JSON;单机无外部常驻服务依赖 | 桌面级/轻量 CLI;单 Agent 自闭环 |
| Mem0 | 实体关系图与向量双引擎;三级作用域 (User/Session/Agent) 动态消歧去重 | Qdrant + Neo4j / Memgraph;依赖外部图数据库与向量服务 | 多实体、长周期;跨会话复杂关系网 |
| Honcho | 用户心智模型动态推断;跨会话辩证推演与观点演进 | 关系型 + 向量 + 状态机;云原生服务化架构 | 社交陪伴、教育;强个性化对齐 |
| Hindsight | 时序事件图谱与因果回溯;事后反思与失败纠错 | 时序数据库 + 关系图谱;事件驱动溯源引擎 | 复杂任务规划;自动化测试/排错 |
| OpenViking | 工业级长短记忆混合调度;针对大规模多 Agent 协同 | 统一内存池 + 分级存储引擎;分布式服务架构 | 复杂工作流编排;企业协同平台 |
| Supermemory | 个人高频知识与书签化记忆;快速捕获与多模态链接 | 极速向量索引 + 浏览器插件;轻量云端服务 | 个人知识助理;内容收集与管理 |
| ByteRover | 软件工程专用程序性记忆;代码库变更与调试经验追踪 | AST 结构索引 + Git Commit;本地代码库嵌入 | 代码审查、重构;研发效能 Agent |
| RetainDB | 时序引擎 + 向量持久底座;高并发吞吐与时间区间检索 | 高吞吐专用时序向量数据库;分布式数据库 | 高并发生产集群;企业级 MemoryHub |
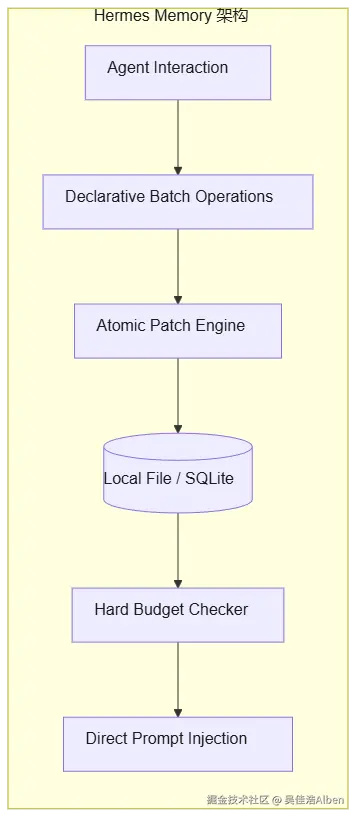
1. Hermes Memory:极简嵌入式与原子状态机
- 🔸 设计哲学:拒绝笨重的外部分布式集群,以高密度的声明式原子断言 + 强硬的 Token 预算截断实现极致的确定性;
- 🔸 架构实现 :本地 Markdown / SQLite 存储,声明式
operations: [{action, content, old_text}]原子更新。
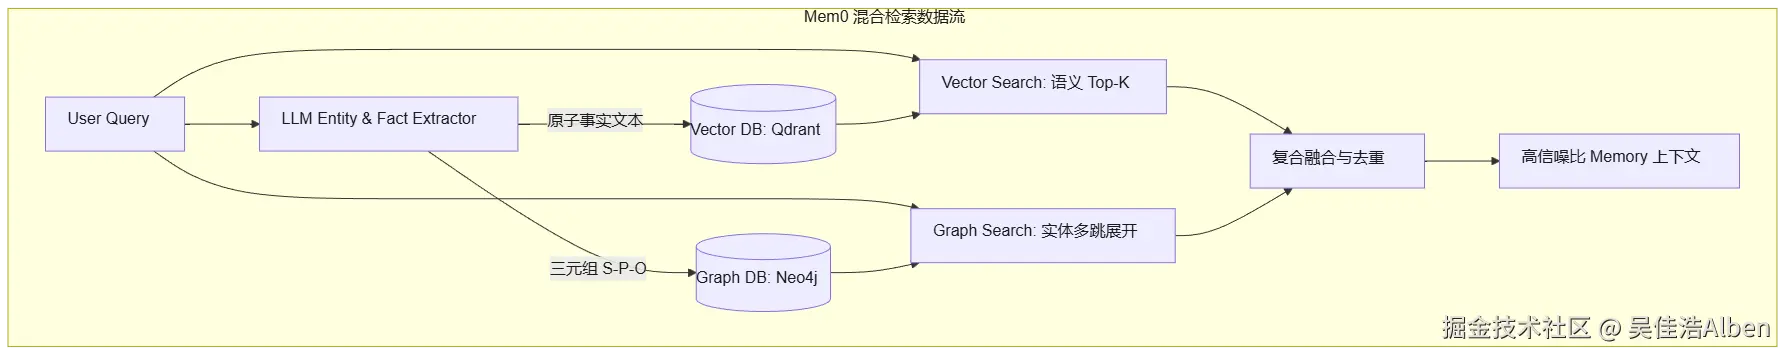
2. Mem0:图向量双引擎(Graph + Vector Hybrid)
- 🔸 设计哲学:纯向量检索无法处理实体关系多跳推理("A 是 B 的上级,B 是 C 的项目负责人");
- 🔸 架构实现:向量模糊检索与 Neo4j 实体三元组拓扑展开深度融合。
3. Honcho:动态心智推断(User Persona)
- 🔸 设计哲学:记忆核心是推断用户"是一个什么样的人",跨会话辩证推演用户的心智模型与决策偏好。
4. Hindsight:时序事件图谱与因果回溯(Temporal DAG)
- 🔸 设计哲学:复杂排错必须具备事后因果溯源能力,将 Tool 轨迹逆向反思为程序性规程。
一句话总结这一章的核心观点:
框架选型没有最好,只有权衡:本地轻量选 Hermes,复杂关系选 Mem0,因果反思选 Hindsight。
四、生产级代码实现:统一 Memory Provider SPI 与切面管道
以下为基于 Python 3.11+ 与 Pydantic v2 构建的企业级统一 Memory Provider SPI 规范与切面生命周期实现:
python
"""
memory_provider_spi_framework.py
生产级统一 Agent Memory Provider SPI 架构规范与插件化管理基座
"""

from __future__ import annotations

import abc
import enum
from datetime import datetime
from typing import Any, Callable, Coroutine, Dict, List, Optional
from pydantic import BaseModel, Field, ConfigDict


class MemoryRecord(BaseModel):
    """标准记忆数据载荷"""
    model_config = ConfigDict(frozen=False, extra="forbid")

    id: str
    tenant_id: str
    user_id: str
    session_id: Optional[str] = None
    content: str
    importance: float = Field(default=0.5, ge=0.0, le=1.0)
    confidence: float = Field(default=1.0, ge=0.0, le=1.0)
    tags: List[str] = Field(default_factory=list)
    metadata: Dict[str, Any] = Field(default_factory=dict)
    created_at: datetime = Field(default_factory=datetime.utcnow)
    last_accessed_at: Optional[datetime] = None


class SearchCriteria(BaseModel):
    """标准多维检索契约"""
    tenant_id: str
    user_id: str
    query: str
    session_id: Optional[str] = None
    top_k: int = Field(default=5, ge=1, le=50)
    min_confidence: float = Field(default=0.6, ge=0.0, le=1.0)
    token_budget: int = Field(default=800, ge=100, le=4000)
    include_entities: bool = Field(default=False)
    filter_tags: List[str] = Field(default_factory=list)


class BaseMemoryProvider(abc.ABC):
    """
    统一 Memory Provider SPI 抽象基类
    所有引擎实现 (Hermes, Mem0, Honcho, Redis, PGVector) 必须实现此契约
    """

    def __init__(self, provider_name: str, config: Dict[str, Any]):
        self.provider_name = provider_name
        self.config = config

    @abc.abstractmethod
    async def initialize(self) -> None:
        """初始化底层存储连接池、索引结构与健康检查"""
        pass

    @abc.abstractmethod
    async def add_memory(
        self,
        tenant_id: str,
        user_id: str,
        content: str,
        session_id: Optional[str] = None,
        importance: float = 0.5,
        metadata: Optional[Dict[str, Any]] = None,
    ) -> MemoryRecord:
        """单条原子记忆写入"""
        pass

    @abc.abstractmethod
    async def batch_mutate(
        self,
        tenant_id: str,
        user_id: str,
        operations: List[Dict[str, Any]],
    ) -> List[MemoryRecord]:
        """批量原子状态机操作 (add / replace / remove)"""
        pass

    @abc.abstractmethod
    async def search(self, criteria: SearchCriteria) -> List[MemoryRecord]:
        """多维统一检索 (混合向量、图关系、时效打分与预算截断)"""
        pass

    @abc.abstractmethod
    async def consolidate(self, tenant_id: str, user_id: str) -> Dict[str, Any]:
        """触发后台记忆代谢、反思提炼与过期淘汰"""
        pass

    @abc.abstractmethod
    async def delete_user_memories(self, tenant_id: str, user_id: str) -> int:
        """GDPR/合规物理删除用户所有记忆,返回删除记录数"""
        pass


# 生命周期 Hook 类型签名
HookFn = Callable[[Dict[str, Any]], Coroutine[Any, Any, Dict[str, Any]]]


class UnifiedMemoryManager:
    """
    企业级统一 Memory 管理中枢 (Facade + Pipeline)
    负责装配具体 Provider,并编排完整的生命周期 Hook 切面
    """

    def __init__(self, provider: BaseMemoryProvider):
        self.provider = provider
        self._pre_recall_hooks: List[HookFn] = []
        self._post_recall_hooks: List[HookFn] = []
        self._pre_extract_hooks: List[HookFn] = []
        self._post_extract_hooks: List[HookFn] = []

    def register_pre_recall_hook(self, hook: HookFn) -> None:
        self._pre_recall_hooks.append(hook)

    def register_post_recall_hook(self, hook: HookFn) -> None:
        self._post_recall_hooks.append(hook)

    async def recall_for_prompt(self, criteria: SearchCriteria) -> str:
        """全切面编排的提示词记忆注入链路"""
        context_data = {"criteria": criteria}

        # 1. Pre-Recall Hooks
        for hook in self._pre_recall_hooks:
            context_data = await hook(context_data)

        # 2. 调用底层 Provider 执行检索
        raw_records = await self.provider.search(context_data["criteria"])
        context_data["records"] = raw_records

        # 3. Post-Recall Hooks (如 PII 脱敏、二次 Rerank、Token 严格预算裁剪)
        for hook in self._post_recall_hooks:
            context_data = await hook(context_data)

        # 4. 格式化为标准 Prompt 片段
        final_records: List[MemoryRecord] = context_data.get("records", [])
        if not final_records:
            return ""

        formatted_lines = ["<context_memories>"]
        for r in final_records:
            formatted_lines.append(f"- [{r.metadata.get('category', 'FACT')}] {r.content}")
        formatted_lines.append("</context_memories>")

        return "".join(formatted_lines)
本篇总结
- 🔸 Memory 不是存储,而是 Memory Runtime;VectorDB 只是物理底层,真正的核心是围绕状态演进的计算与调度链路;
- 🔸 行业走向 Memory Provider SPI 抽象,是为了应对多存储融合(Polyglot Persistence)、生命周期切面 Hook 以及企业级安全治理的必然要求;
- 🔸 统一 SPI 架构使得应用层能够平滑切换底层引擎,实现从本地单机到云端分布式集群的无缝演进。
选定了 Provider 模型后,在面临数千并发用户、数十个异构 Agent 的大规模落地场景下,如何将 Memory 真正构建为一个高可用、高并发、支持多租户隔离与 Multi-Agent 协同的独立微服务(Memory Service / Memory OS)?
在收官之作中,我们将深入拆解:《企业级 Agent Memory 选型指南:如何构建可扩展的 Memory Service?》。
筒子们本篇为《企业级 Agent 实战指南》· 第一章的第 03 篇,后续续会更新完整的agent的开发的全部过程,如果你对Agent开发感兴趣不妨关注一下本合集.