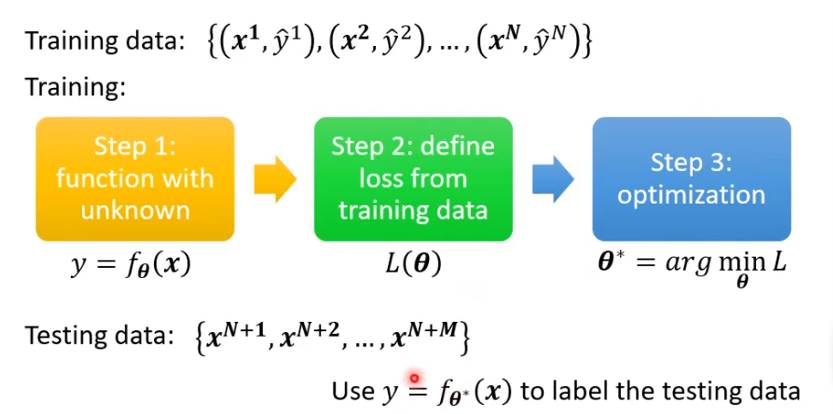
复习:上次课讲了训练模型的过程,主要有三个步骤:
1,写出一个有未知参数的function 2,计算loss判断模型好还是不好 3,优化调参减少loss
得出的最优参数就可以用来预测了
如何适用于更复杂的情景呢?
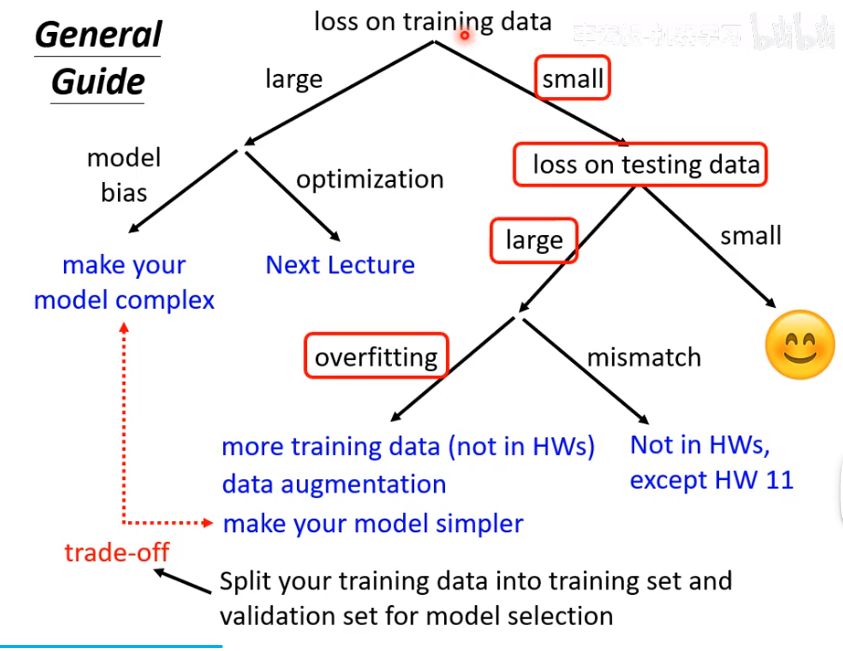
1,首先检查训练集上的损失值
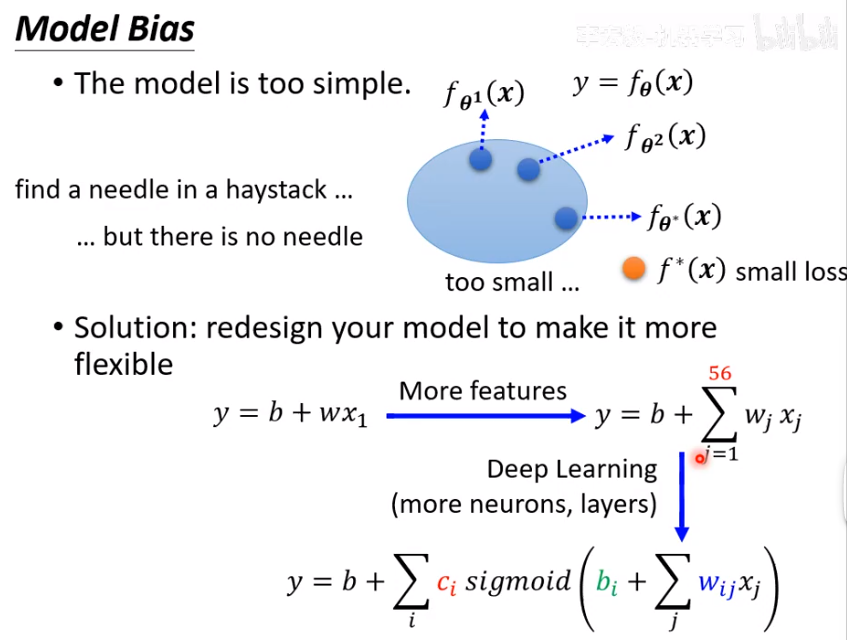
如何优化呢?如果只是想通过调参来优化,效果只是杯水车薪,可以重新设计模型输入更多特征,通过deep learning增加模型的弹性,也就是large扩大
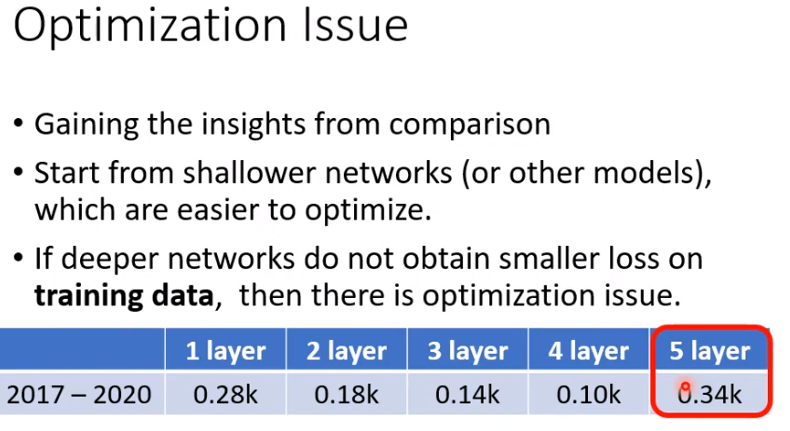
2,还可能是optimization issue,也就是没有找到最佳function
区分:如何确定是model的规模不够,还是fuction效果不佳的问题呢?
判断方法:主要是看训练集的测试数据对比,如图,56层的训练效果比20层的效果还要差很多,说明是optimization issue问题而不是model的规模还不够大,不是过拟合问题
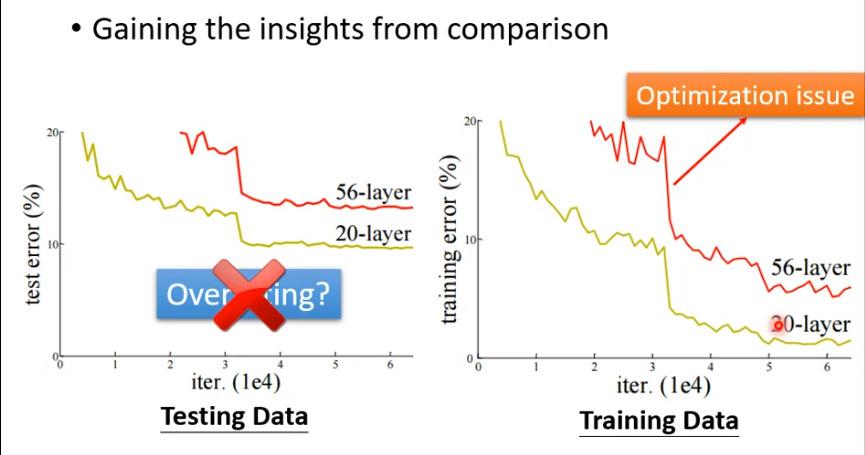
我们在日常训练中如果想确定朝那个方向调优,可以先测试比较小的问题,或者先不用深度学习模型,至于optimization issue的问题如何解决,后续会进行介绍
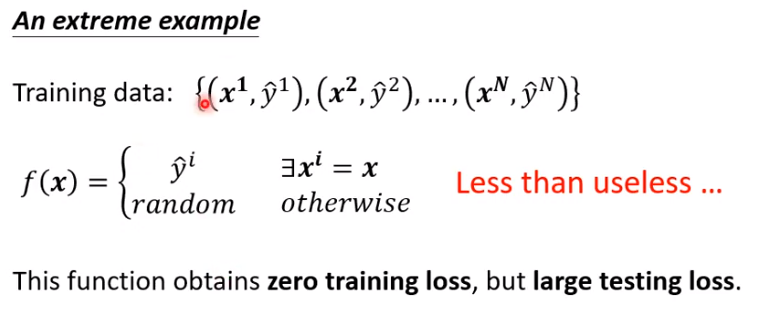
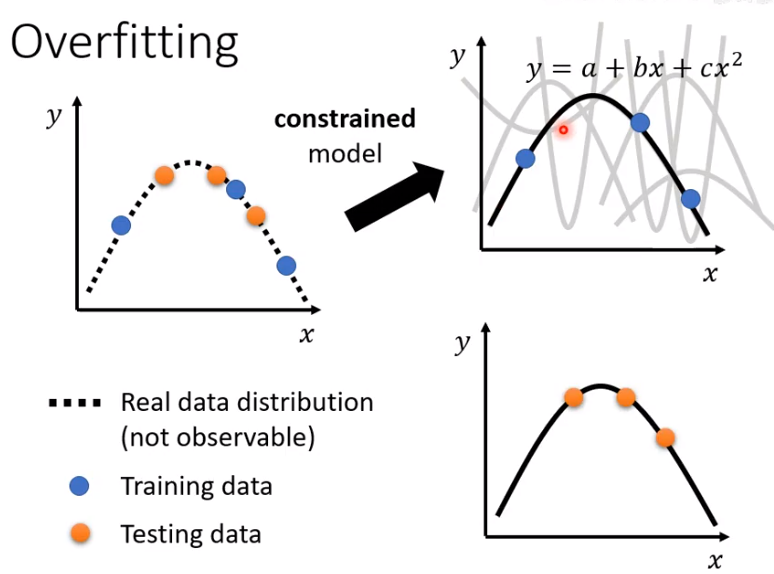
**为什么会出现过拟合的问题?**例如下面的函数:在训练集上直接输出数据,在除了训练集的数据输出随机数值
也可能是model的弹性太大,导致随机情况出现太多,如下:
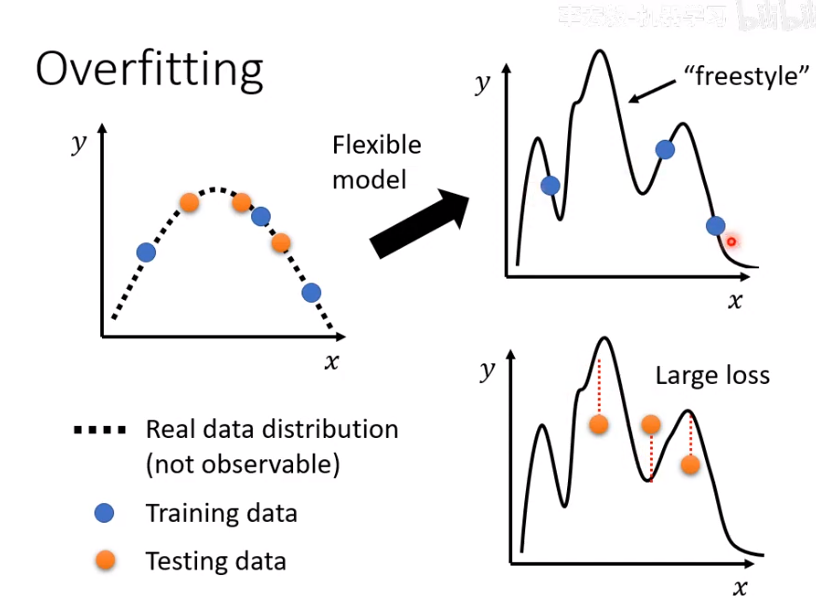
如何解决过拟合的问题呢?
1,增加训练资料(比较困难)
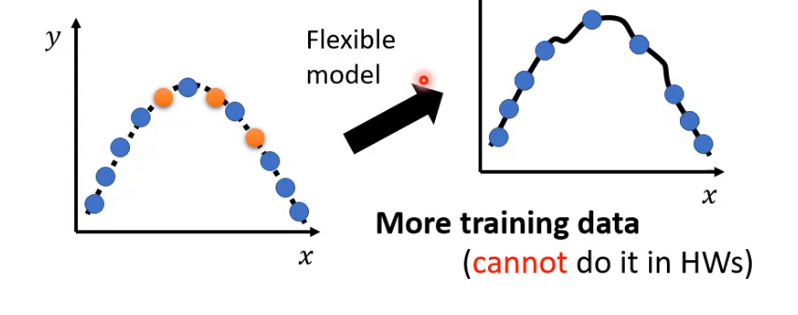
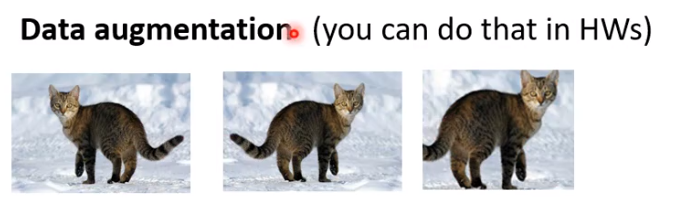
2,创造资料(可用),例如图片的翻转和放大,但是要合理,如果图片上下颠倒是不合理的
3,限制模型弹性,例如限制model函数的类型
限制方向可以是:
1,给出比较少的参数,或者共用参数,例如:fully-connected模型是比较有弹性的,但是CNN一般是比较没有弹性的
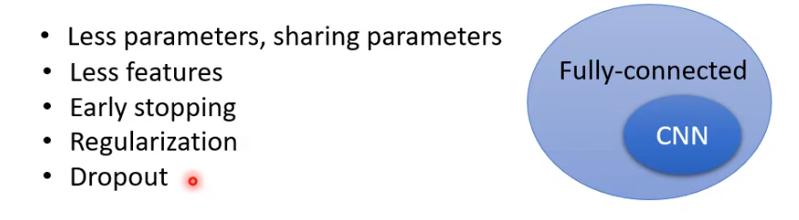
但是也不能限制过多,可能会导致model bais的问题
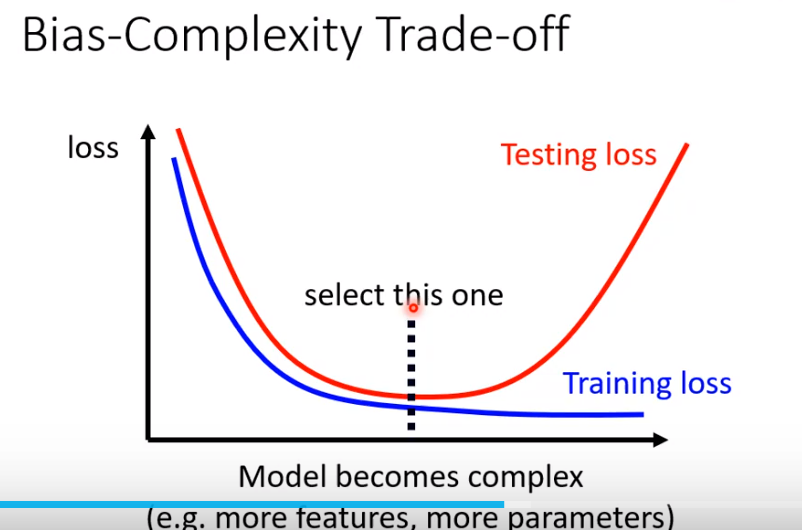
模型越复杂效果未必越好,反而可能越差
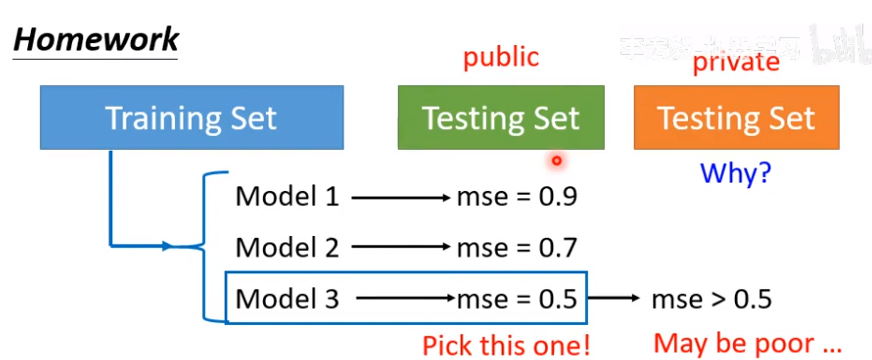
一般来说我们可以通过chioka网站选择测试模型的质量:http://www.chioka.in/how-to-select-your-final-modelsin-a-kaggle-competitio/,但是它测试使用的数据是pulic公开的,所以只要训练足够多的次数就会得到好效果,所以不要在public的testing set上调整你的模型,这样会导致private上的测试数据很差,
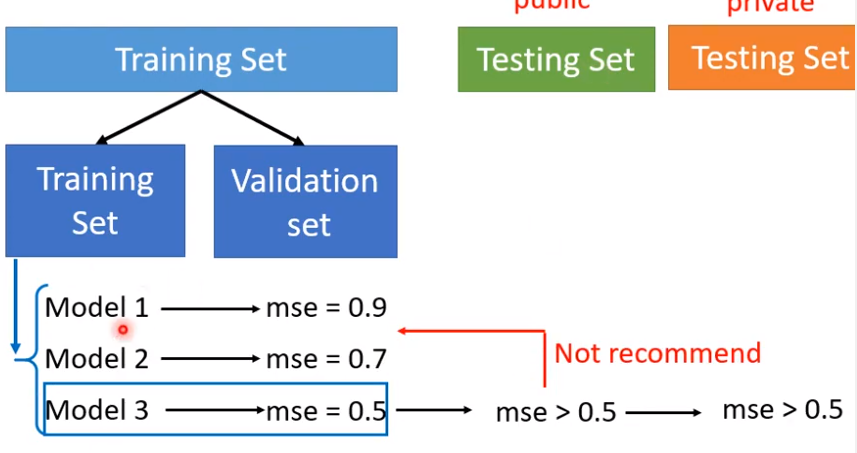
 那么如何选择model比较合理:将训练数据划分为训练集和测试集,通过validation set来验证模型质量分数,选择最优结果在上传public测试,因为是通过validation set验证,所以避免了之前说到的问题
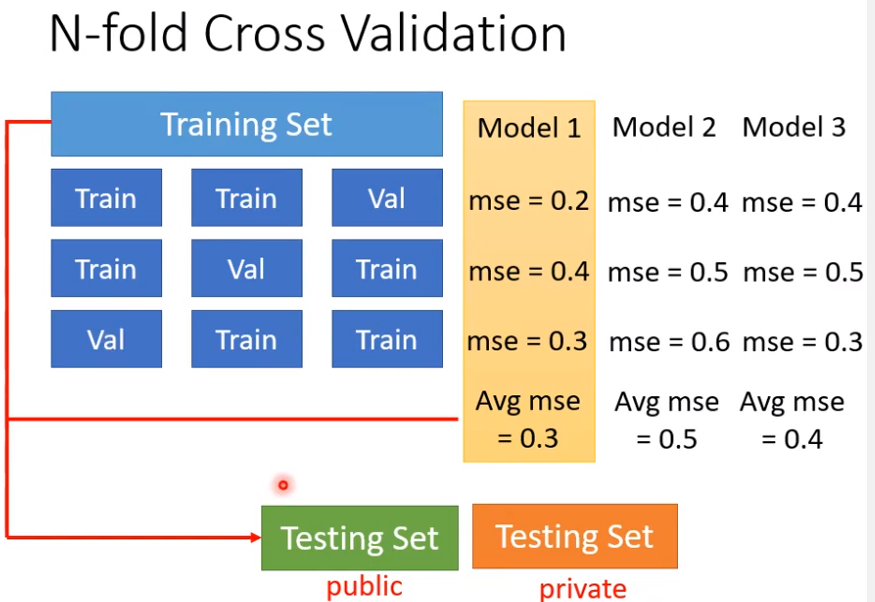
训练集和测试集的划分,平均分为N等分,然后依次验证
类神经网路训练优化攻略--optimization失败时
为什么有时optimization会失败?
有可能是在此处参数对loss的微分为0,gradient也不起作用
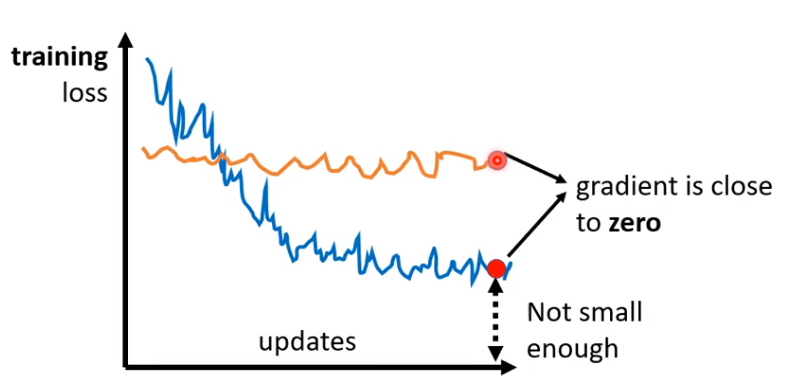
示例:
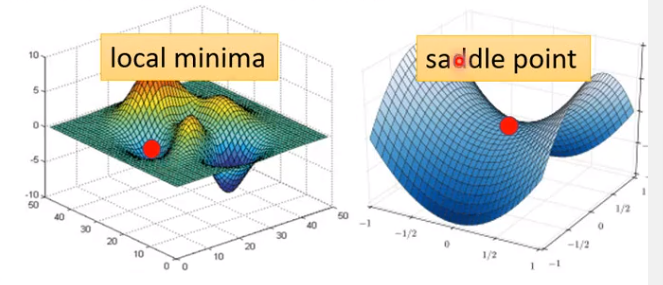
local minima问题中loss已经没有办法减少了,但是saddle point还是有可能减少的
如何区分local minima 和saddle point?
首先把对loss的function表示出来:
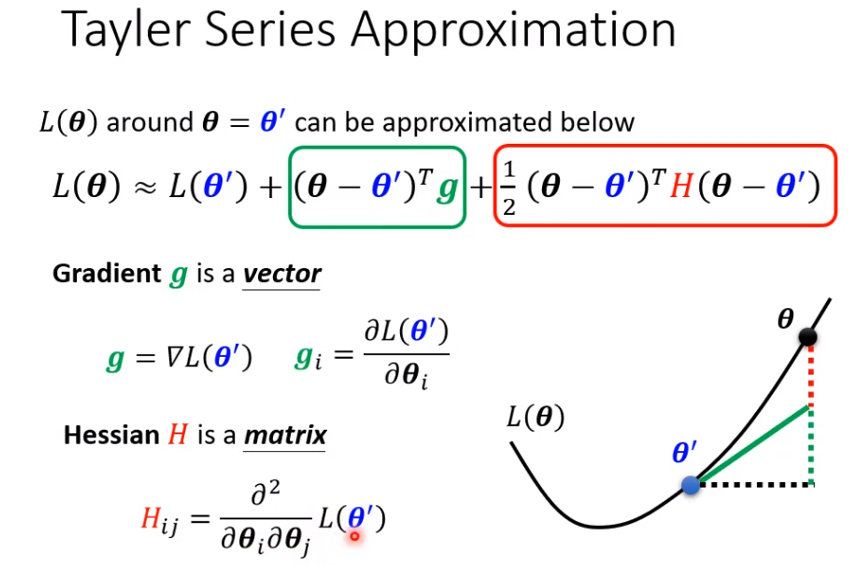
参数对loss的微分为0,gradient也不起作用时:g为0,可以用Hessian表示如下:
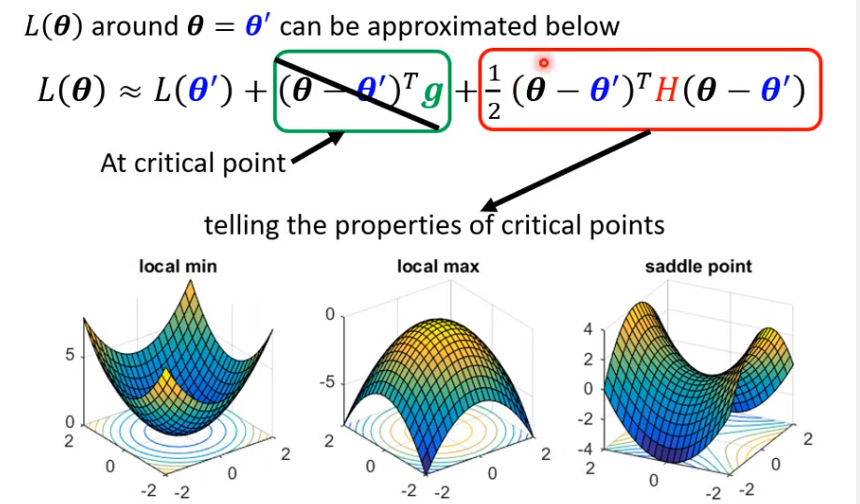
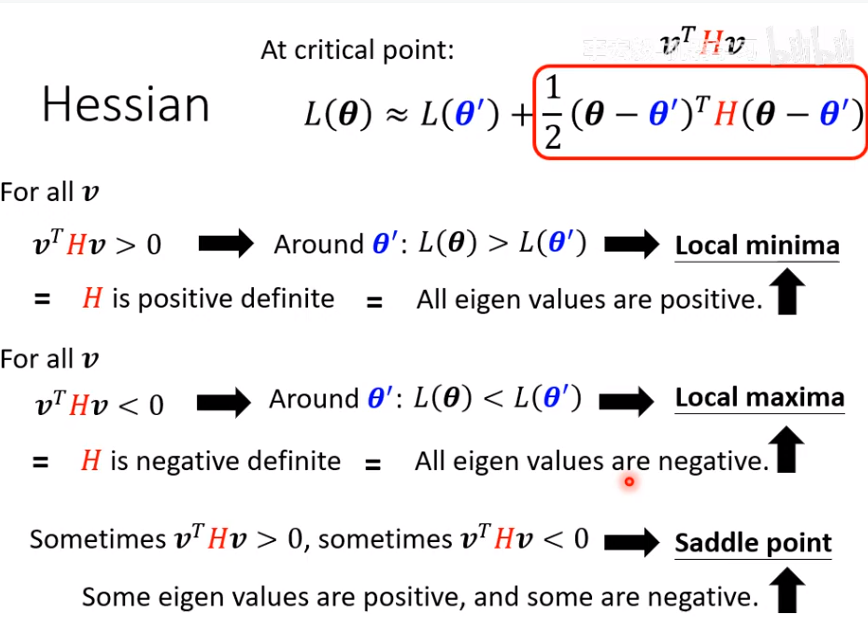
总的的来说,就是可以通过Hessian矩阵中的eigen values的值来判断是哪种类型
示例:
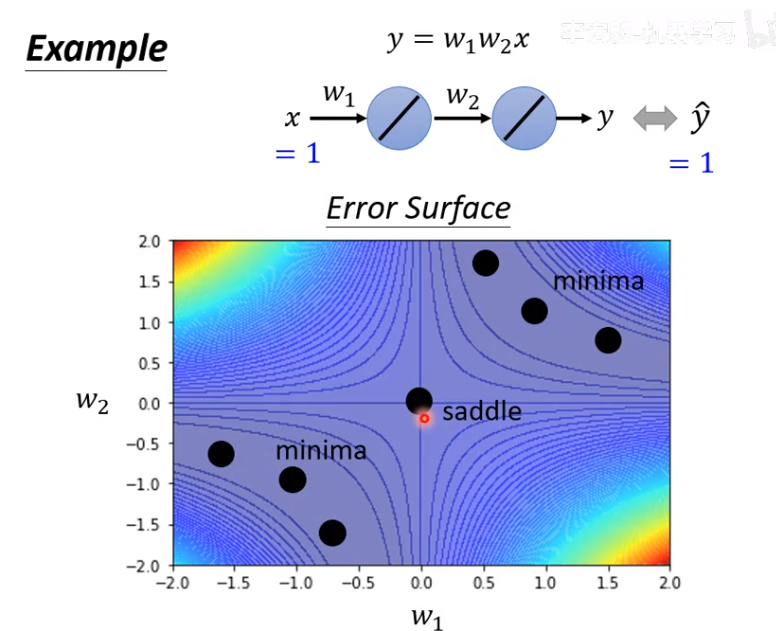
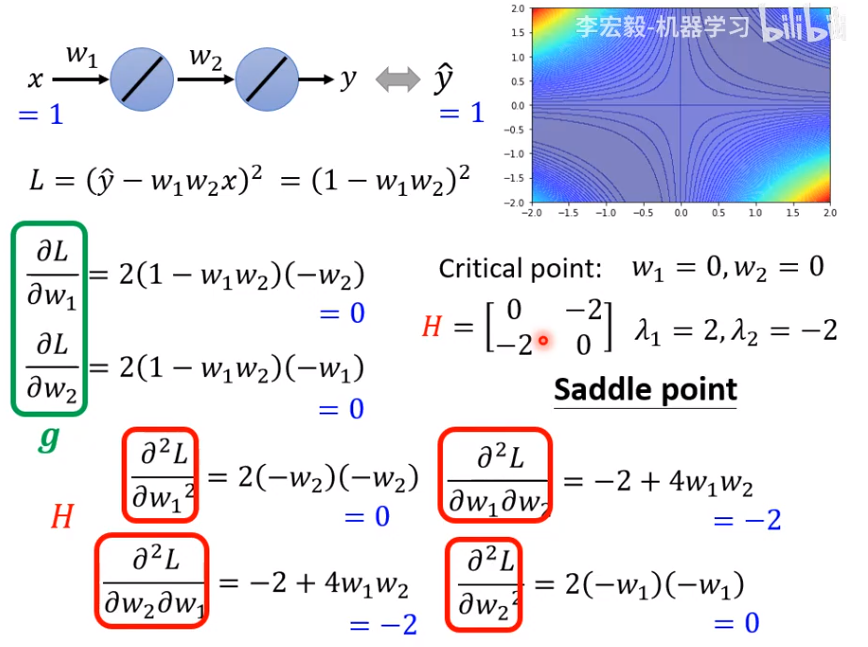
如何通过计算得到呢?
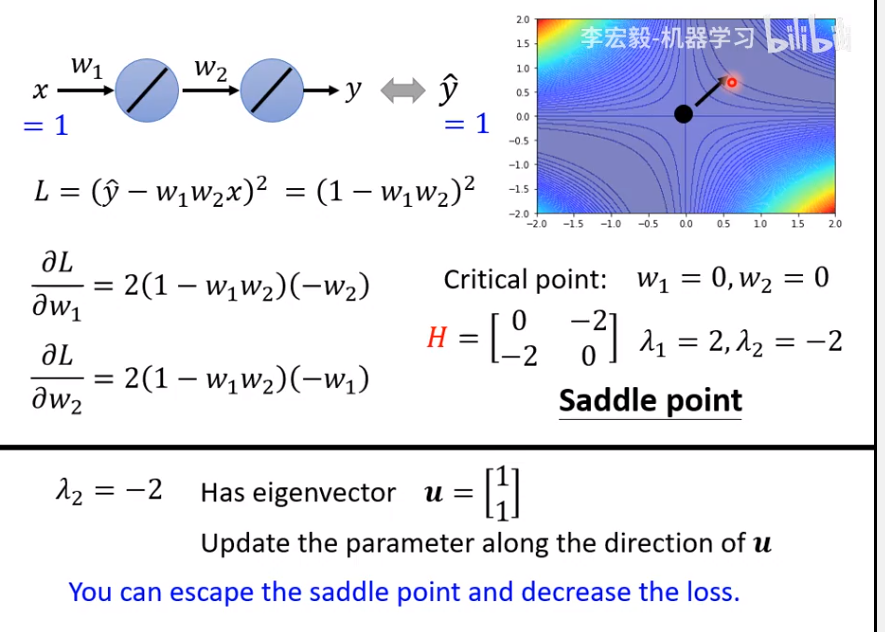
我们也可以用saddle point来判断update的方向
如下图所示当u是H的一个eigen vector时,参数沿着这个方向变化,loss就会减少
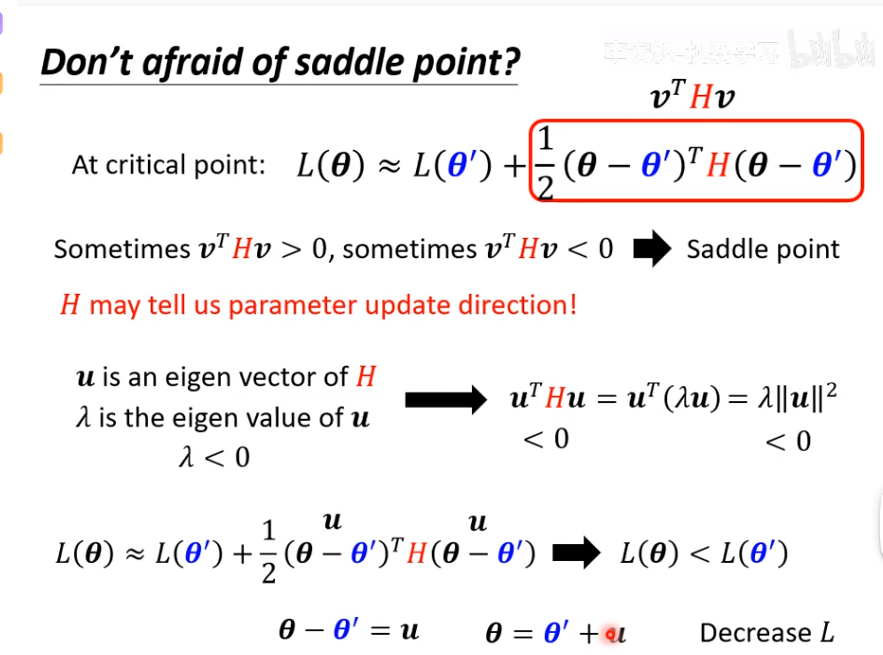
主要是要找出一个负的eigen vector,然后沿着这个方向找,通常是卡在saddle point
例:
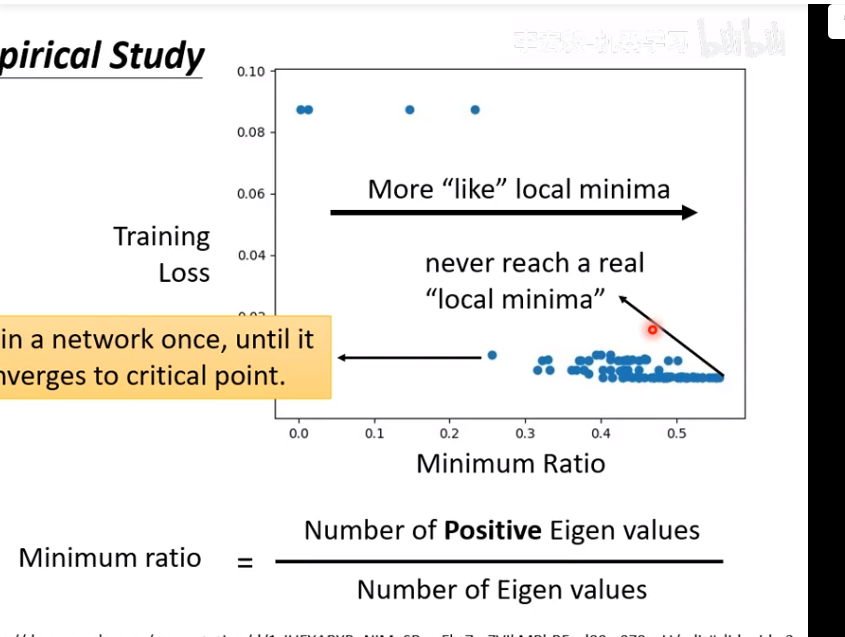
根据下图所示,local minima并不常见,最高的占比只占一半
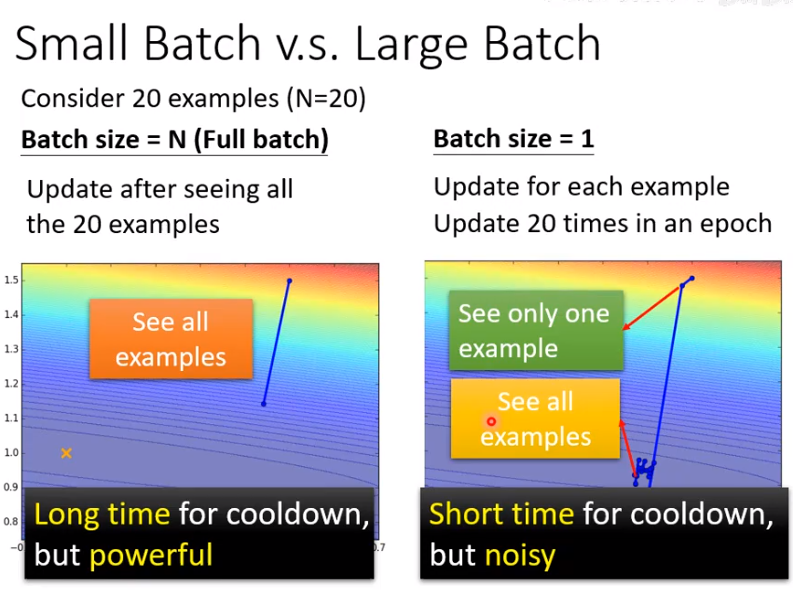
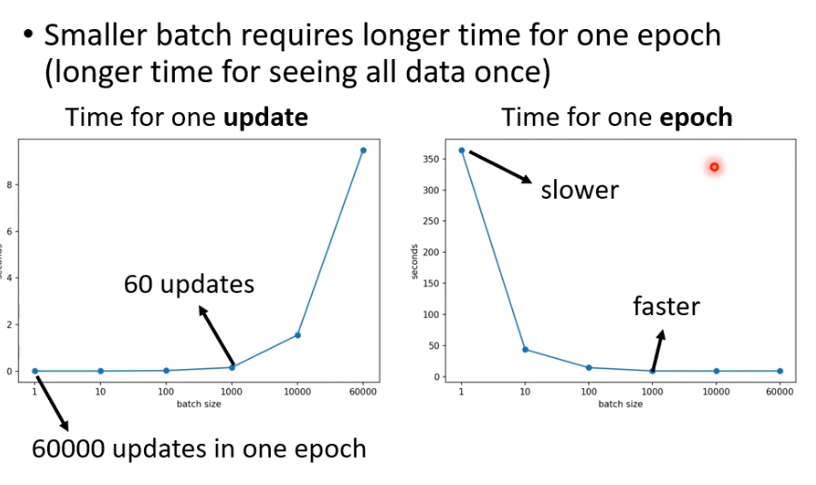
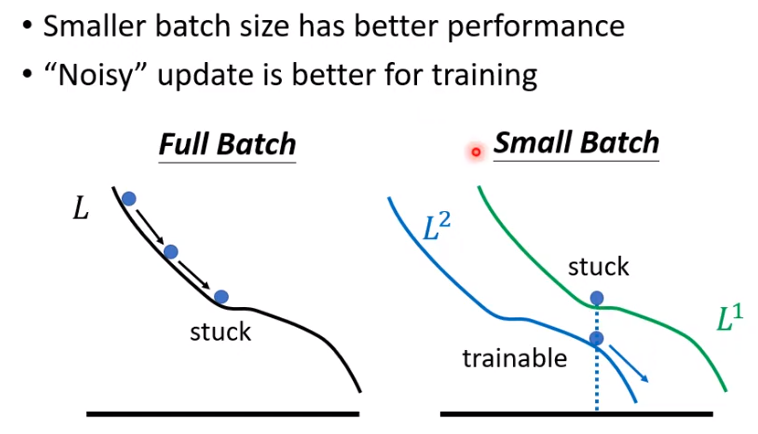
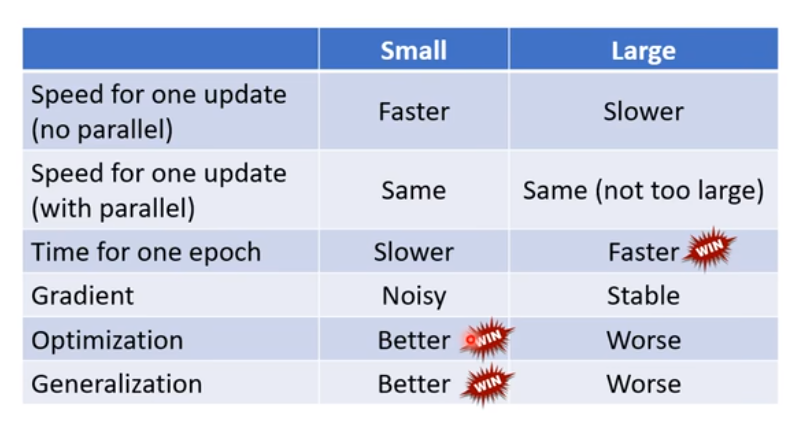
为什么要用batch呢?如果不划分batch,必须经过所有的数据然后才能update一次,使用batch更新update的次数更多,但是会产生噪声
Batch和Momentum的训练技巧
shuffle是什么意思?是指每一次epoch都会重新分一下batch,也就是每一个epoch都不一样
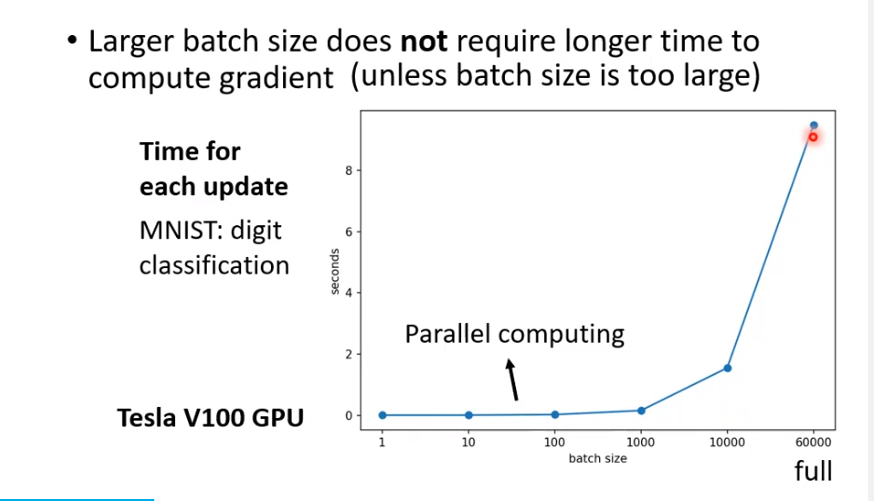
有时候甚至会出现小的batch使用的时间比大的batch时间更久的情况(考虑平行运算的情况)
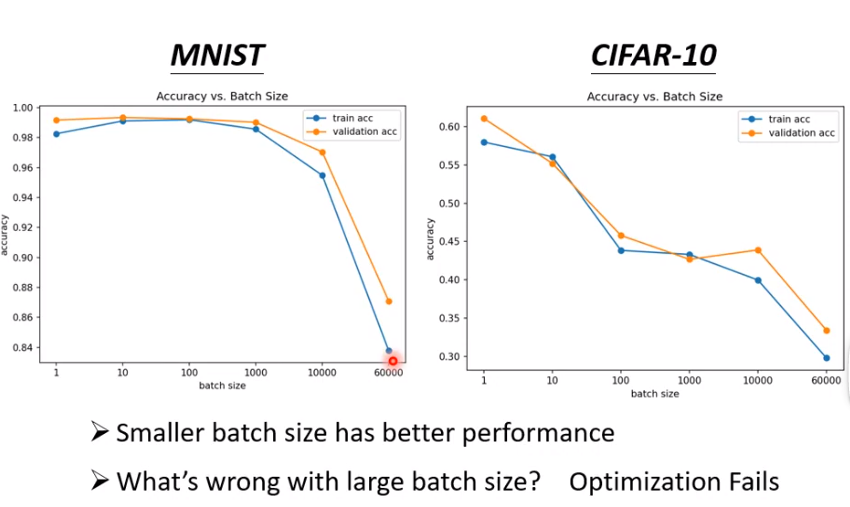
同样的model在不同的batch上表现的效果也不同:
Noisy也会出现比较好的情况,如图,多个upfate可以避免stuck的情况
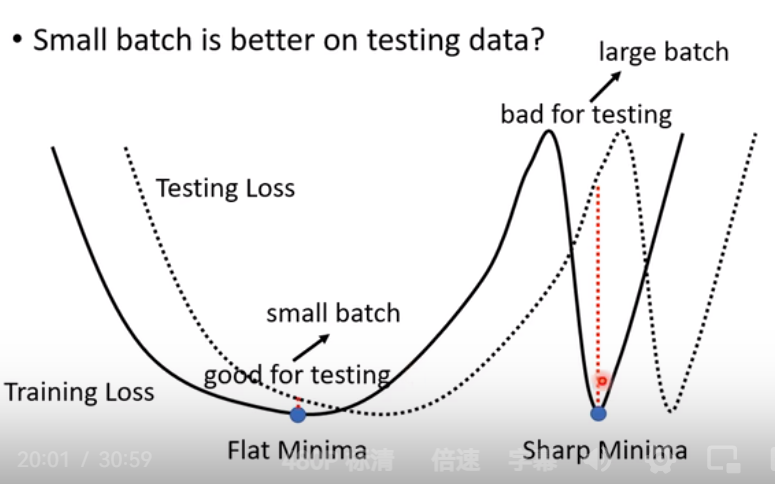
但是也有文章表明小的batch在测试集上的效果也很差,这是为什么呢?
Miniama有的比较缓和有的比较狭窄,如果batch很小,那么它就很容易跳出狭窄的minima,而更大的batch没有这么多方向不会随便跳出sharp minama,所以这个时候大的batch测试效果更好
下面的表格可以看到,有平行运算时,小batch和大batch的update速度差距并不大
Momentum
和一般的gradient descent的区别在于:加上了上一次的update方向Momentum
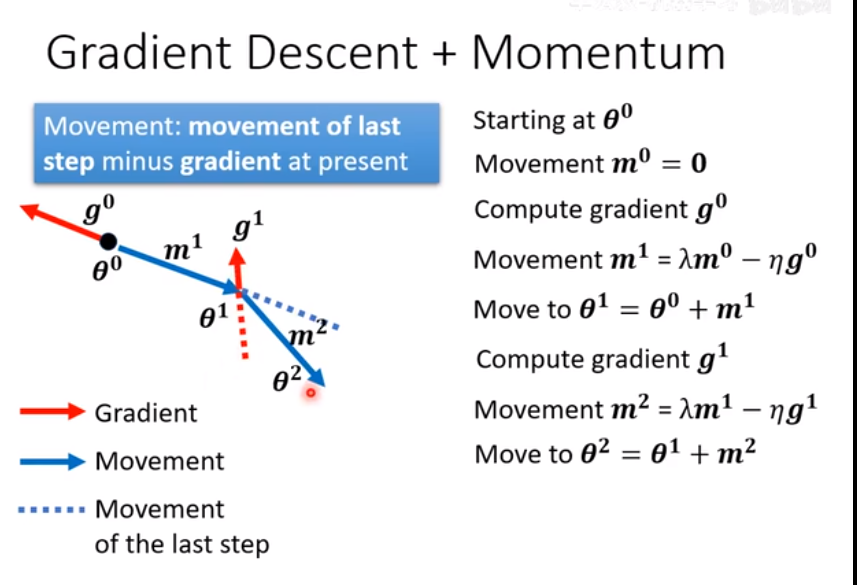
一般来说会认为是当时gradient的负方向加上前一次移动的方向,也可以理解为加入momentum后不仅了解这一次gradient还是考虑之前的所有gradient的总和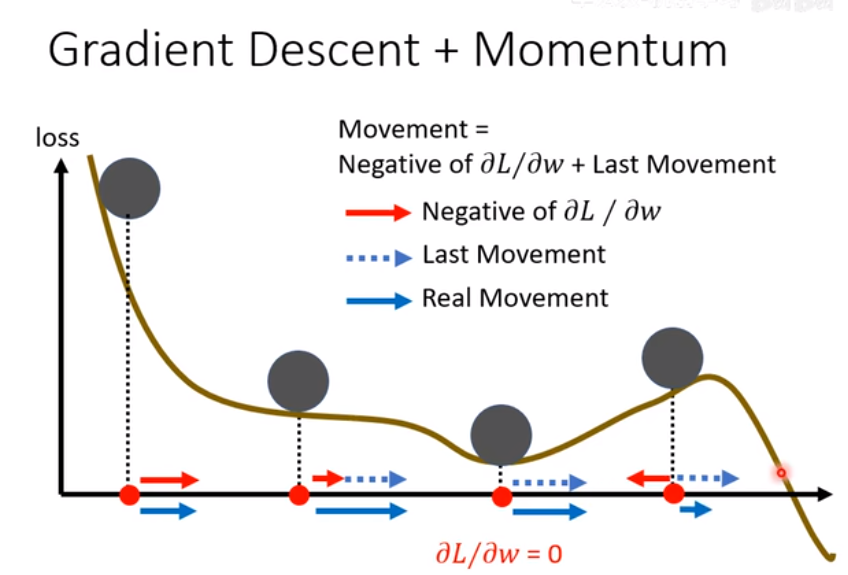
learning rate相关设置
当loss小到不再下降时,gradient不一定为0,所以这个时候不一定是local minima 和saddle point,gradient不一定为0,所以一般我们training 卡住的地方都不是critical point而是其他问题
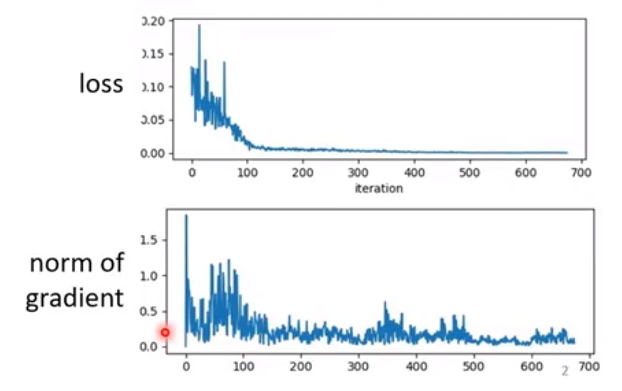
下图显示减少learning rate 并不能改善峡谷震荡问题,确实较小的rate会开始向峡谷底部进行,但是由于步距太小几乎无法走到local minima
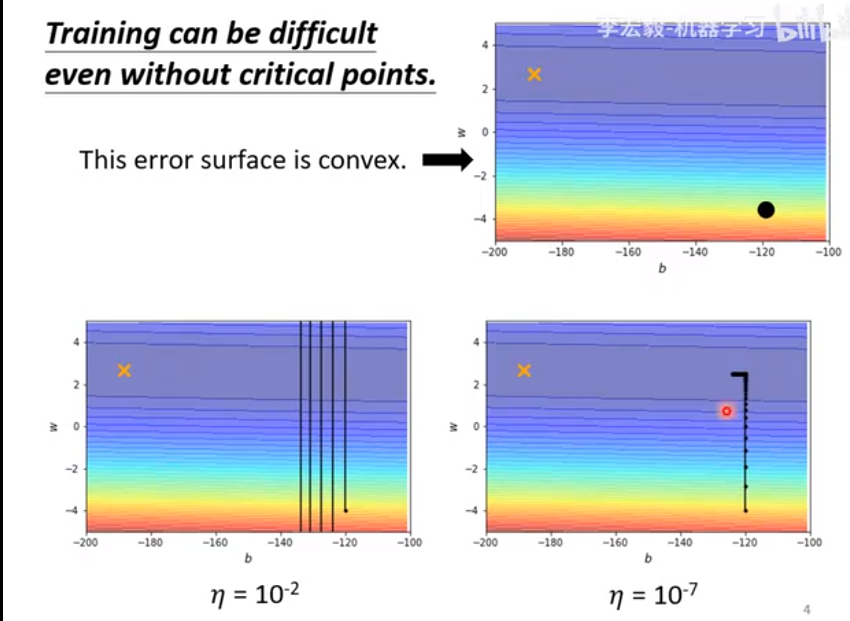 由此,我们引进特值化的learning rate,坡度大的地方learning rate要减少,坡度小的地方learning rate 要放大
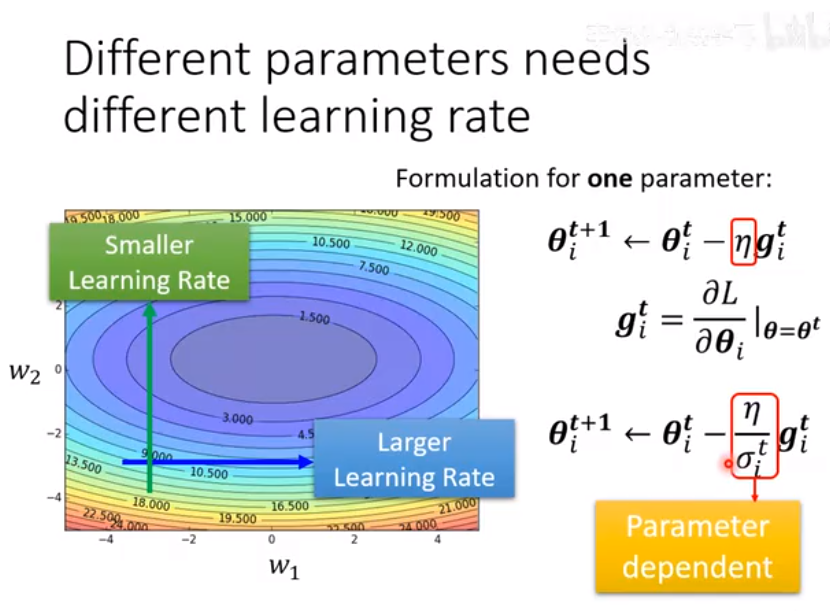
具体计算公式:
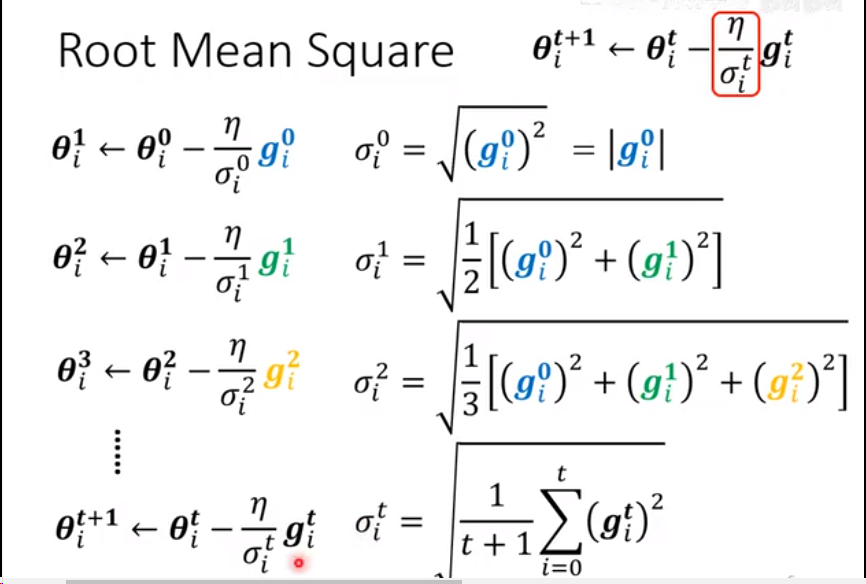
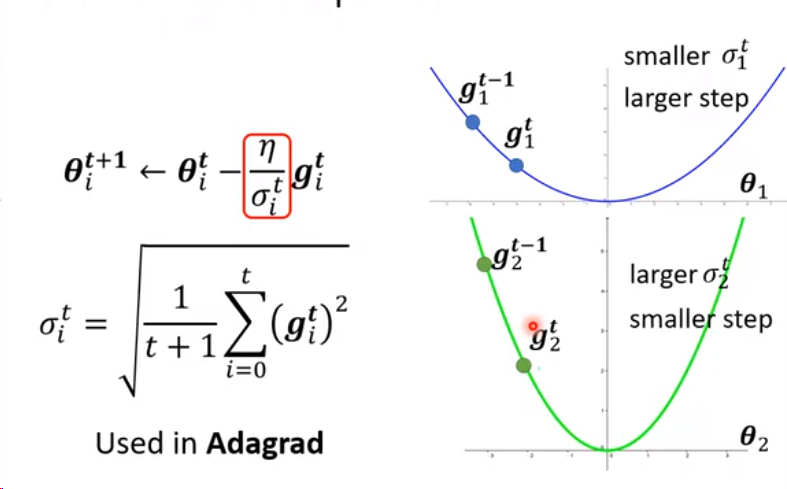 **但是对于同一个参数和同一个方向,也可能要用不同的learning rate,**如图所示:
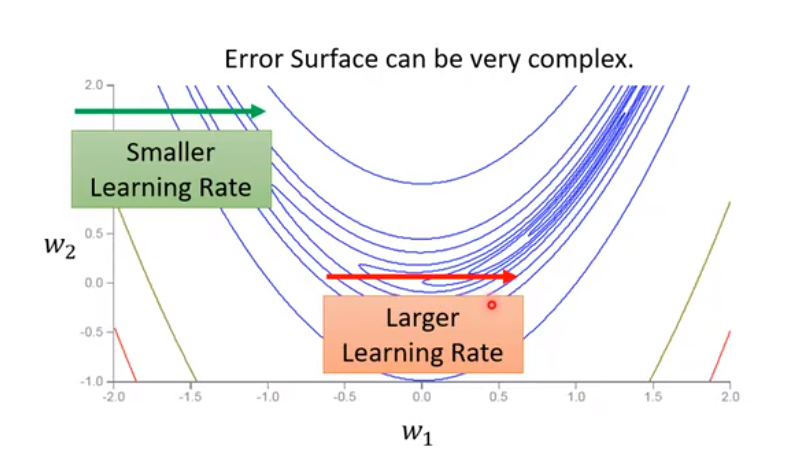
由此引入RMSPro方法,和前面的Adagrad方法的区别在于你可以自己调整现在的gradient的重要性占比:
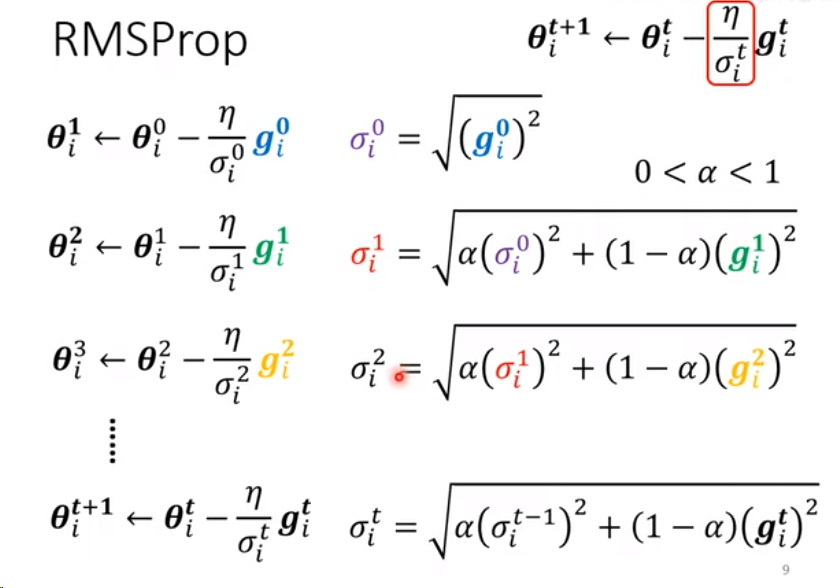
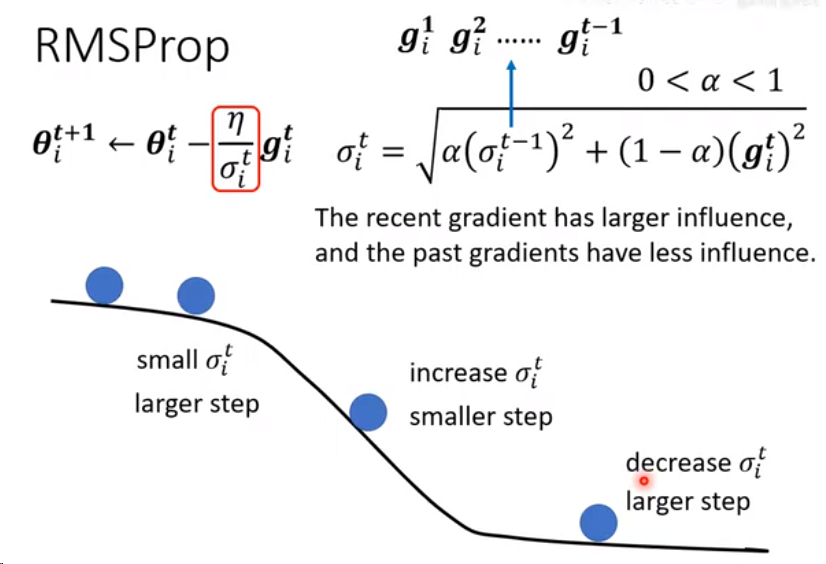
最近最常用的optimization策略是:
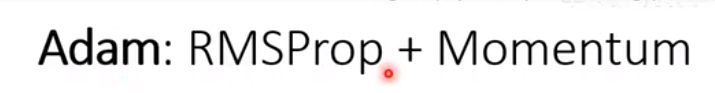
为了避免随着所有gradient相加导致震荡问题,引入Learning Rate Decay ,随着时间变化变小
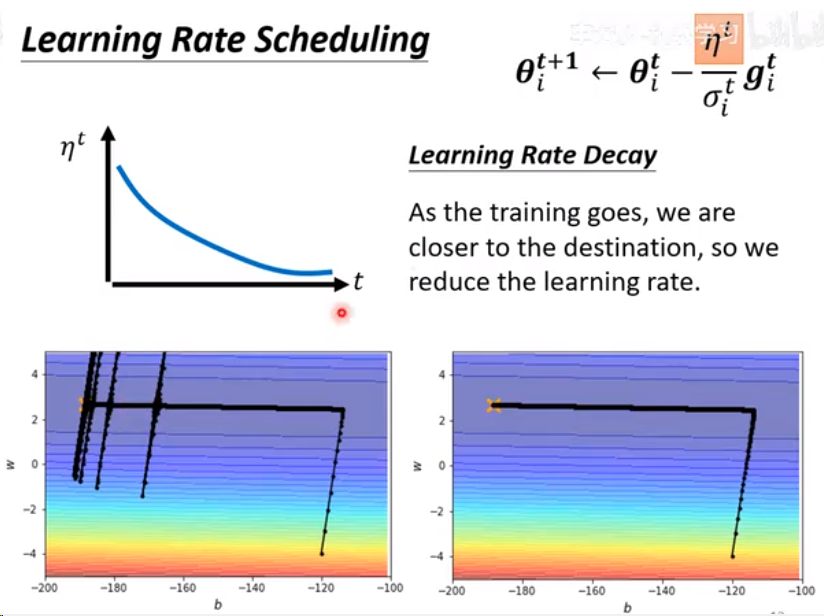
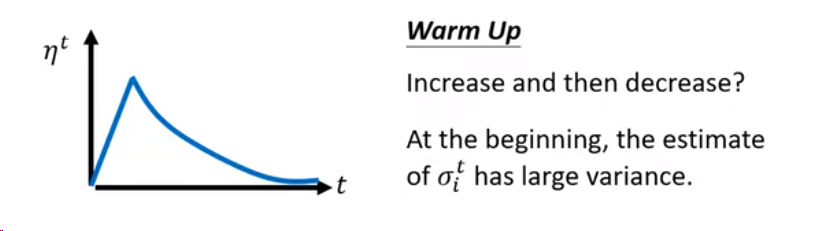
扩展:warm up技术
总结:
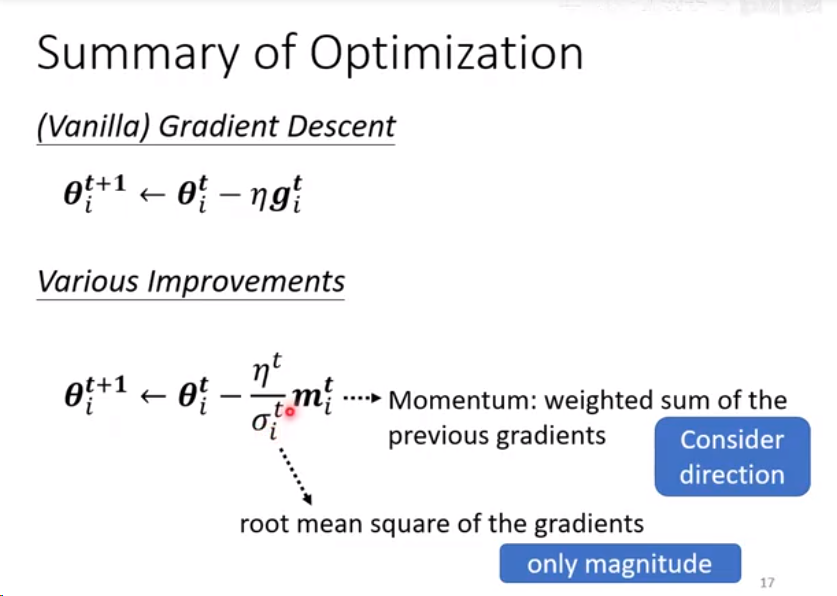
注意mi和分母虽然表示的都是gradient的总和,但是值不同,mi是有方向,而分母是绝对值只考虑大小,两者不会抵消
分类classification:和Regression类似,但是又存在区别,多了一个softmax的步骤
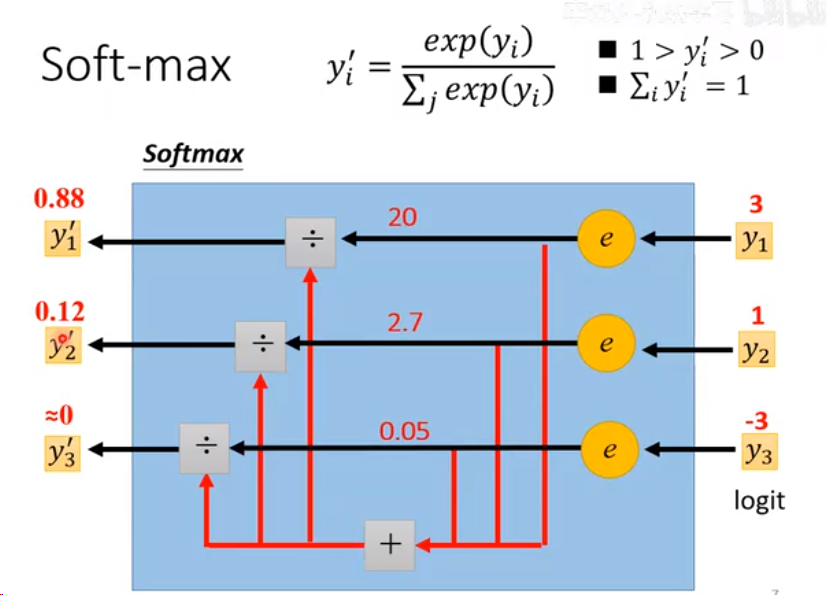
一般label的范围是0-1,但是输出的y可以是任何值,因此可以先进行一个nomalize(也就是softmax)所做的
为什么要引入分类器?
因为很多实际问题的输出不是连续数值,而是离散决策。我们需要模型从带标签数据中自动学习规律,并对新样本做出类别判断。
引入分类器的原因主要有:
-
输出是类别而非数值
比如"这封邮件是不是垃圾邮件",答案不是 3.7 或 8.2,而是"是/否"。
-
需要泛化到新样本
不能只靠人工规则,因为规则难以覆盖高维、复杂、带噪声的数据。分类器能从数据中学习决策边界。
-
需要概率和置信度
很多分类器输出"属于某类的概率",例如 0.92 是垃圾邮件,这有助于风险决策。
-
分类有专门的损失和评价指标
分类常用交叉熵、0-1 损失、合页损失等;评价用准确率、精确率、召回率、F1、AUC 等。直接套用回归通常效果不好。
常见分类器包括:逻辑回归、KNN、支持向量机、决策树、随机森林、朴素贝叶斯、神经网络等。
分类和回归(Regression)的关系
二者都属于监督学习,都从带标签数据 (x,y)(x,y) 中学习输入到输出的映射。区别主要在输出空间和目标:
| 维度 | 分类 | 回归 |
|---|---|---|
| 输出 | 离散类别 | 连续数值 |
| 例子 | 垃圾邮件/正常邮件 | 房价、温度、销量 |
| 目标 | 学决策边界或类别概率 | 拟合数值关系 |
| 常用损失 | 交叉熵、0-1 损失、合页损失 | 均方误差、平均绝对误差 |
| 评价 | 准确率、F1、AUC | MSE、MAE、R^2R2 |
| 典型模型 | 逻辑回归、SVM、决策树 | 线性回归、岭回归、回归树 |
联系也很紧密:
-
分类可以看作对连续分数做离散化决策 。很多分类器先输出一个连续分数或概率,再通过阈值或
argmax变成类别。 -
逻辑回归名字里有"回归",但它本质是分类算法,因为它输出概率并用于分类。
-
回归模型也可以被"改造"成分类器,比如线性回归输出数值后加阈值。但通常不推荐,因为输出可能不在 0,10,1,损失函数也不匹配。
-
分类器内部常含有"回归式"的打分函数,例如 SVM 的决策函数、神经网络的 logit 输出。
一句话总结:
回归回答"是多少",分类回答"属于哪一类"。分类器是学习离散决策规则的模型;分类和回归同属监督学习,但输出空间、损失函数和评价方式不同。分类常借助回归式打分或概率估计,但最终做的是离散类别决策
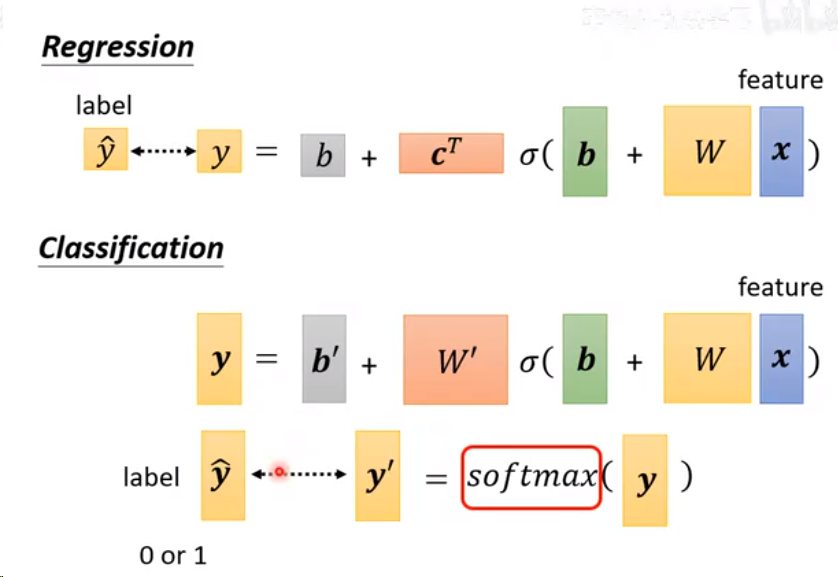
softmax的内容:
分类器的损失函数计算:
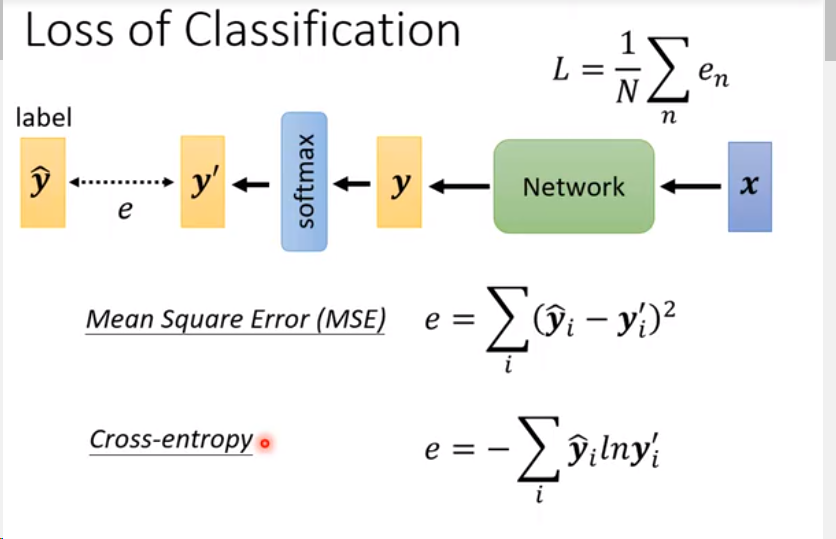
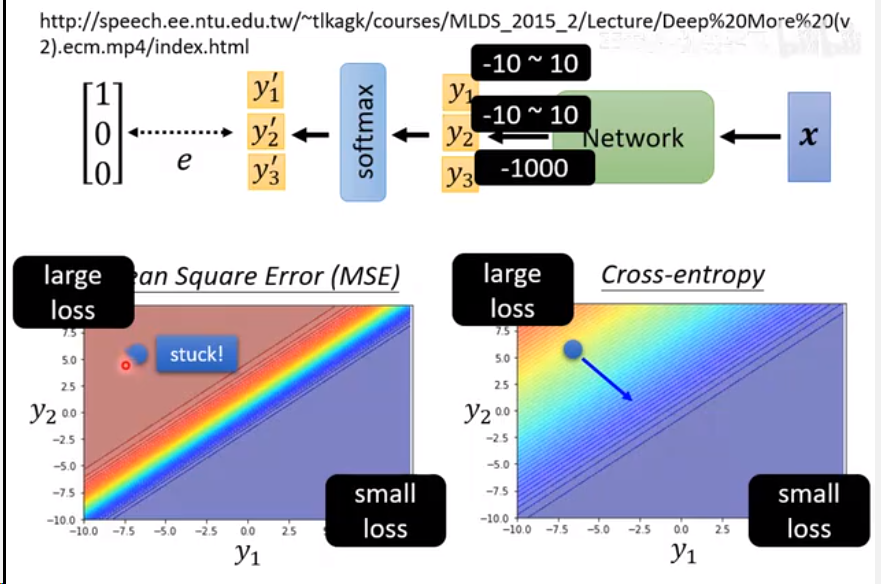
一般来说cross-entropy比mean square error更适合用于分类问题,cross-entropy一般是和softmax相捆绑的,pytorch中如果使用cross-entropy一般就自动包含softmax
下面用一个例子说明
如图所示,MSE方法中在loss很大的地方没有斜率,无法优化,而cross-entropy是有斜率的可以优化