做机器学习的时候,你大概率会遇到这样一个场景:手头的数据集特征太多,几十甚至上百个维度,训练模型慢得要命,还容易过拟合。
你心里清楚不是所有特征都有用,但到底哪些该留、哪些该砍,一时又说不上来。
主成分分析(PCA)就是用来解决这个问题的。
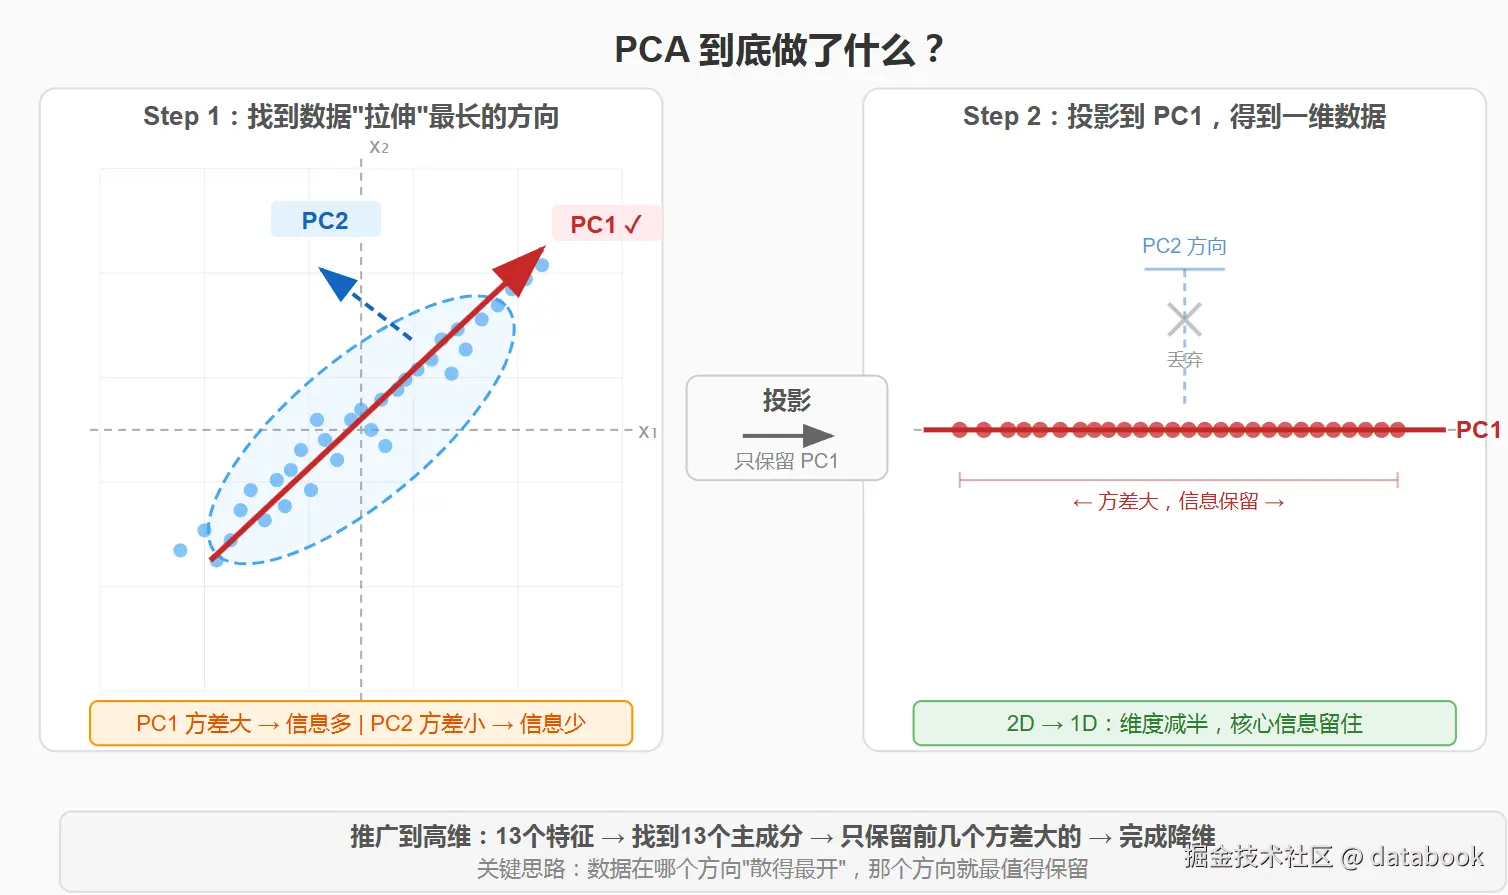
它的思路很直接------与其在原始特征里挑挑拣拣,不如把数据投影到几个新的方向上,这些方向按"能解释多少方差"从大到小排列,你只取前面几个就够了。
今天这篇文章不深挖数学原理,目标就一个:带你用 Scikit-Learn 把 PCA 跑起来,5 步搞定,看完就能用到自己的数据上。
1. 先搞清楚几个概念
在动手之前,花两分钟把几个关键概念对齐一下,后面写代码的时候心里才有底。
降维做的事就是:把高维数据压缩到更低维度的空间里,同时尽量不丢信息。
比如 13 个特征的数据,压缩成 3 个新特征还能保留大部分信息,那就赚了。
主成分是 PCA 找出来的那些新方向。你可以把它理解成数据"变化最剧烈"的轴------第一个主成分是方差最大的方向,第二个次之,依此类推,而且它们之间互相正交。
方差解释比(explained variance ratio)告诉你每个主成分捕获了多少比例的数据方差。
这个值是选主成分数量的核心依据------加起来超过 80% 或 90%,通常就够了。
下面这张图直观展示了 PCA 在做什么:原始数据在多维空间里散布着,PCA 找到方差最大的方向(图中的箭头),然后把所有数据点投影到这些方向上,用更少的坐标来表达。
还有一点值得提:Scikit-Learn 的 PCA 底层用的是 SVD(奇异值分解)来算主成分,不是直接做特征值分解。
这个细节你不用深究,知道 Scikit-Learn 帮你把数学都封装好了就行。
2. 第一步:加载数据集
我们用 Scikit-Learn 自带的 wine 数据集来演示。
这个数据集记录了葡萄酒的化学成分,13 个特征,178 条数据,维度不算高但足够展示 PCA 的效果。
加载数据就两行代码:
python
from sklearn import datasets
wine_data = datasets.load_wine(as_frame=True)
df = wine_data.data
看一下数据的规模和特征列表:
python
print(df.shape)   # (178, 13)
print(df.info())  # 13列,全是 float64
13 个特征包括酒精含量、苹果酸、灰分、镁含量等等。
这些特征量纲差异很大------酒精含量可能是十几的数值,镁含量可能是上百的数值,直接拿来做 PCA 会有问题。
这就引出了下一步。
3. 第二步:标准化数据
PCA 对数据的尺度非常敏感。如果某个特征的数值范围是 01000,另一个是 01,那大方差特征会主导主成分的方向,PCA 的结果就失真了。
所以在喂给 PCA 之前,必须先把所有特征拉到同一个尺度上。
用 StandardScaler 做标准化,让每个特征变成零均值、单位方差:
python
from sklearn.preprocessing import StandardScaler
std_scaler = StandardScaler()
scaled_df = std_scaler.fit_transform(df)
这一步看似简单,但它是 PCA 效果好坏的关键。忘记标准化是新手最常踩的坑之一。
4. 第三步:执行 PCA
数据准备好了,核心步骤来了------创建 PCA 对象,指定要保留几个主成分,然后拟合变换一步到位:
python
from sklearn.decomposition import PCA
pca = PCA(n_components=3)
pca.fit_transform(scaled_df)
这里 n_components=3 表示降到 3 维。你可以根据需要调整这个数字,后面第五步会讲怎么选合适的值。
到这一步你可能会注意到一件事:计算协方差矩阵、做 SVD 分解、找特征向量......这些数学步骤全被 Scikit-Learn 封装在 fit_transform() 一个方法里了。
这就是用成熟库的好处------你关注的是结果怎么用,不是怎么推导。
5. 第四步:查看 PCA 的关键属性
fit_transform() 跑完之后,PCA 对象身上有两个属性特别重要,帮你判断降维效果好不好。
第一个是 components_,存储的是主成分本身------也就是那些方差最大的方向向量:
python
print(pca.components_)
# 输出 3×13 的矩阵,每行是一个主成分
第二个是 explained_variance_ratio_,告诉你每个主成分捕获了多少方差比例。
把它们的和加起来,就知道 3 个主成分总共保留了百分之多少的信息:
python
print(sum(pca.explained_variance_ratio_))
# 0.6653...
大约 66.5%。这意味着从 13 维压到 3 维,丢了三分之一的方差信息。
这个值是高是低取决于你的需求,如果觉得不够,就多留几个主成分。
6. 第五步:选择主成分数量
到底该保留几个主成分?这个问题没有标准答案,但有一个很实用的方法:把 n_components 从 1 遍历到最大值,画出方差解释比的累积曲线,找一个"拐点"------过了这个点,增加主成分带来的信息增益就很有限了。
python
import numpy as np
import matplotlib.pyplot as plt

var_ratio = []
for num in range(14):
    pca = PCA(n_components=num)
    pca.fit(scaled_df)
    var_ratio.append(np.sum(pca.explained_variance_ratio_))

plt.plot(range(14), var_ratio, marker='o')
plt.xlabel('n_components')
plt.ylabel('Explained Variance Ratio')
plt.grid(True)
跑出来的曲线大致是这样的走势:
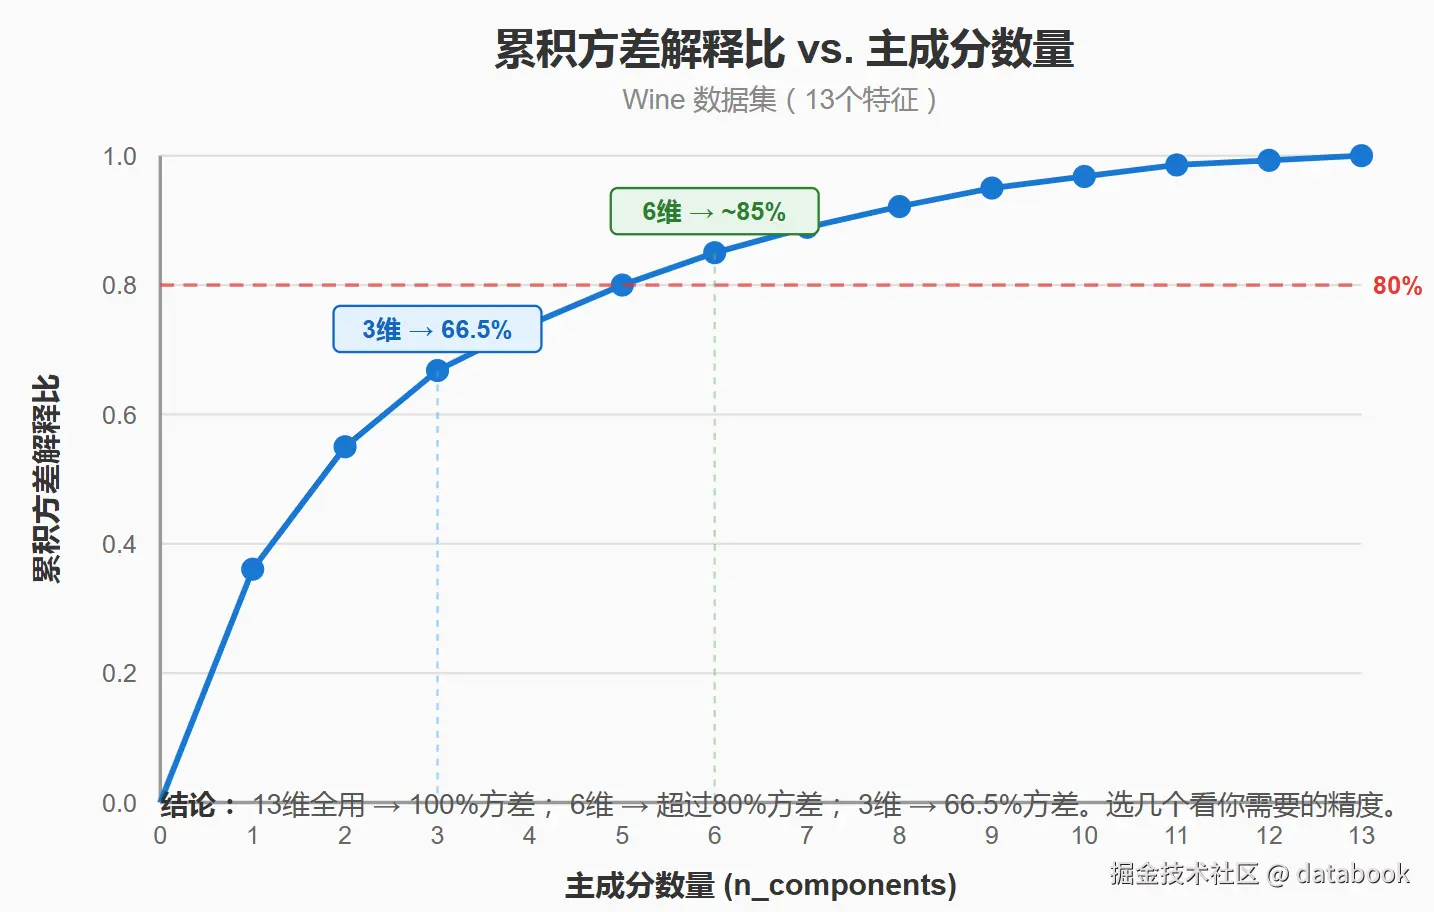
从图上能看出几个关键信息:用全部 13 个主成分时,方差解释比是 1.0(100%);大约在第 6 个主成分的位置,累积方差比就超过 80% 了。
这意味着只用不到一半的维度就能保留八成以上的信息------这就是降维的价值所在。
实际应用中,80%~90% 的方差解释比通常是个合理的区间。低于这个范围可能丢了太多信息,高于这个范围则说明多留的主成分性价比不高。
7. 几个实操建议
跑完这五步,基本的 PCA 流程就掌握了。
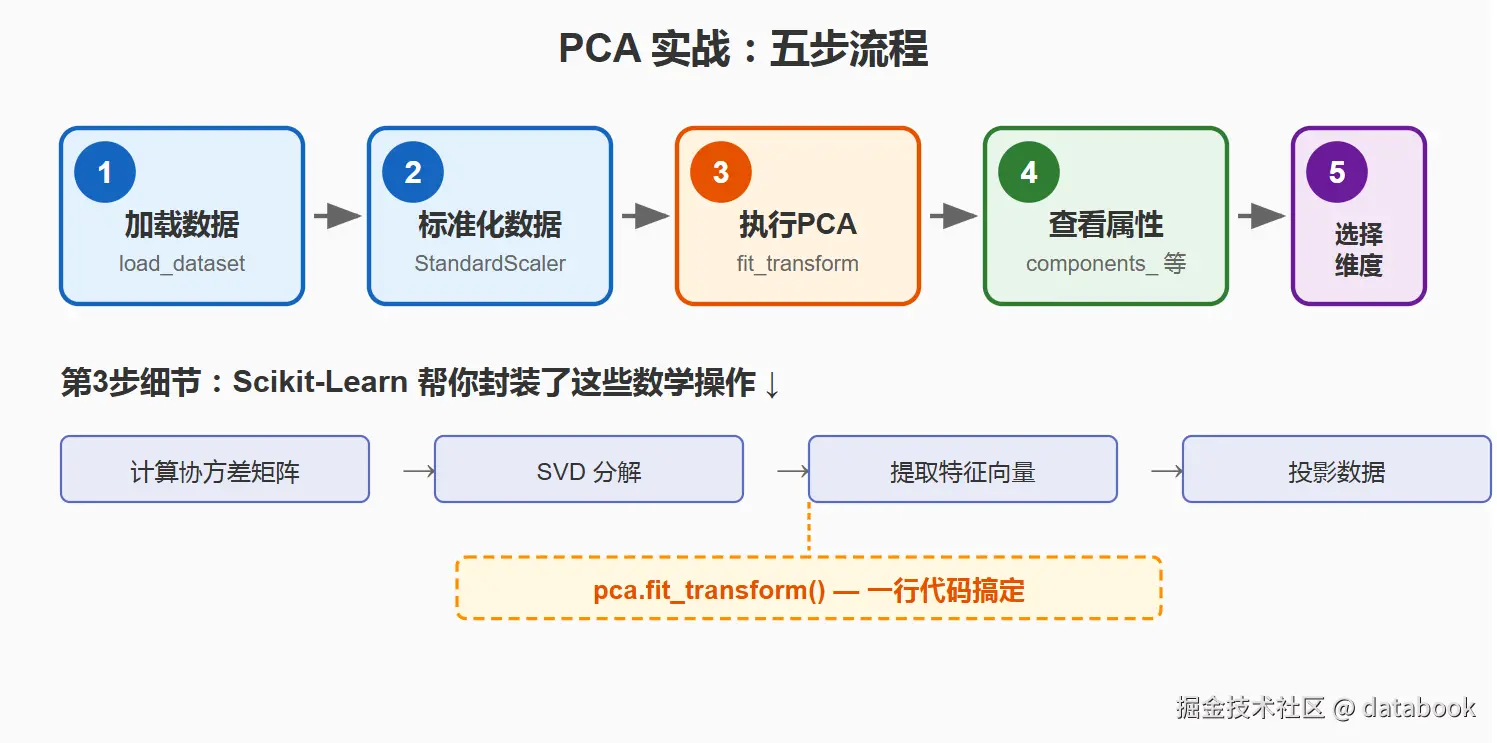
在用到自己的数据上之前,有几个点值得记住。
- 标准化那一步绝对不能省。不管你的数据看起来是不是已经差不多尺度,养成习惯先
StandardScaler走一遍,不会有副作用但能避免很多隐蔽的问题。 n_components除了传整数,还可以传一个浮点数比如0.95,PCA 会自动选择能保留 95% 方差的最少主成分数量。这个用法特别方便,省得你自己去试。- PCA 适合处理连续型数值特征。如果数据里有大量类别型特征,先用 One-Hot 编码转成数值再标准化,效果会好很多。但也要注意 One-Hot 会增加维度,这时候 PCA 的降维价值就更明显了。
- PCA 是线性降维方法,它假设主成分是原始特征的线性组合。如果你的数据有明显的非线性结构(比如卷曲的流形),PCA 可能效果一般,这时候可以考虑 t-SNE 或 UMAP 这些非线性方法。
- PCA 降维后的主成分本身没有明确的物理含义。第一个主成分可能是一堆特征的线性组合,你很难说它"代表"了什么。如果你需要可解释性强的特征选择,PCA 不是最佳选择,考虑用 Lasso 或者基于树模型的特征重要性。