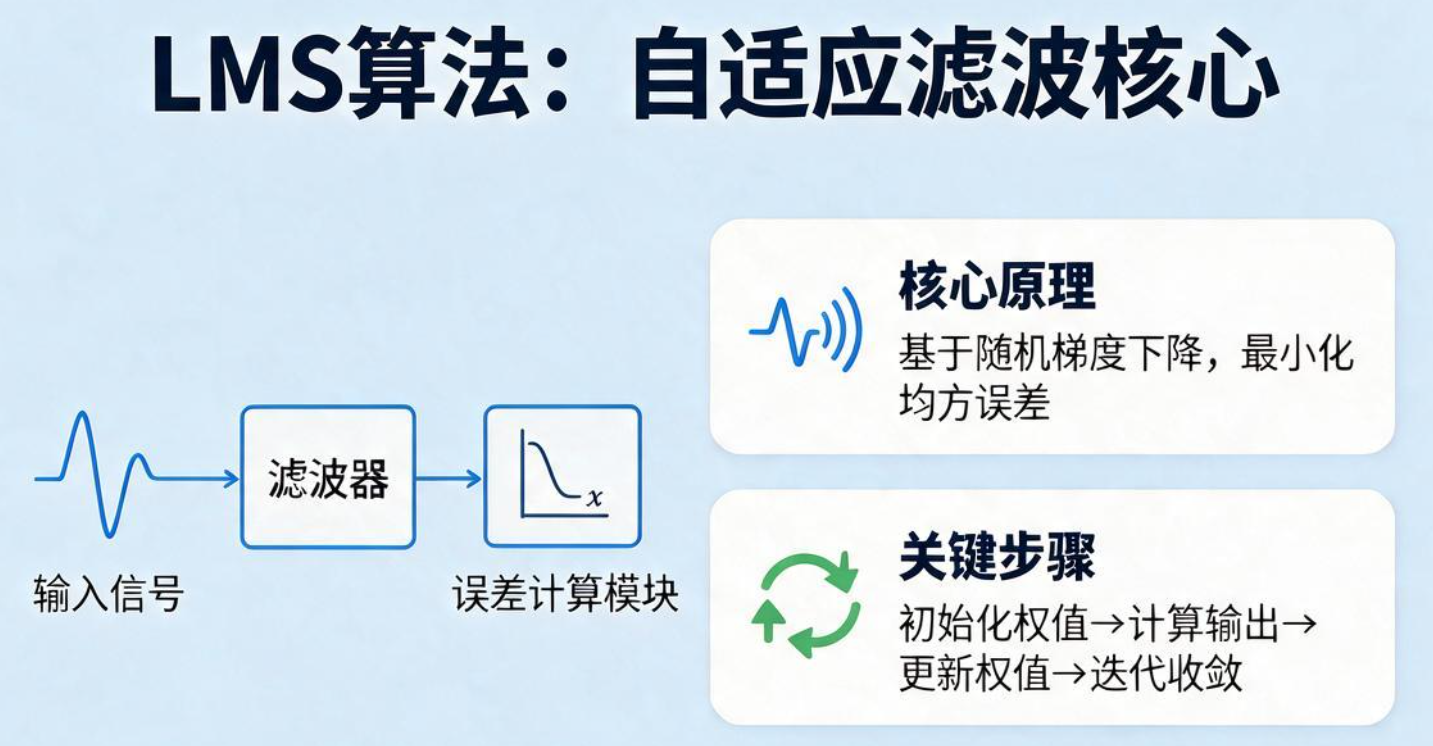
感知器用阶跃函数,梯度是 0,无法做梯度下降。LMS 用连续激活函数,解决了这个问题。
开头:感知器的「死穴」在哪里?
上一篇我们学习了感知器。它用阶跃函数作为激活函数:
阶跃函数:
    f(v) = { 1  if v ≥ 0
{ 0 if v < 0阶跃函数有一个致命问题:梯度是 0。
阶跃函数的导数:
    f'(v) = 0  (除了 v=0 处不可导)

    ↑ f(v)
    │        ┌──────
    │        │
    ─────────┤
    │
└────────────────→ v这意味着什么?感知器的学习算法是规则驱动 的(预测错了就调整),不是梯度驱动的。
LMS 算法解决了这个问题:用连续的激活函数,让梯度下降成为可能。
一、最小二乘法回顾
1.1 线性回归问题
在讲 LMS 之前,我们先回顾一下最小二乘法。
假设有一组数据点 {(x₁, y₁), (x₂, y₂), ..., (xₙ, yₙ)},我们要找一条直线 y = wᵀx + b 来拟合这些点。
线性回归问题
═══════════════════════════════════════════════════════════════════

    y ↑
      │      ×     ×
      │    ×    ×
      │  ×   ×        ← 数据点
      │ ×
      │×  ───────────  ← 拟合直线 y = wᵀx + b
      └────────────────→ x

目标:找到 w 和 b,使拟合误差最小
1.2 损失函数
我们用均方误差(MSE)作为损失函数:
损失函数:
    J(w) = (1/n) Σ (y_i - wᵀx_i)²

展开:
    J(w) = (1/n) ||y - Xw||²

其中:
    X = [x₁, x₂, ..., xₙ]ᵀ  (数据矩阵)
    y = [y₁, y₂, ..., yₙ]ᵀ  (标签向量)
1.3 最小二乘解
最小二乘解可以直接用公式算出来:
最小二乘解:
    w* = (XᵀX)⁻¹ Xᵀy

证明:
    J(w) = (1/n) (y - Xw)ᵀ(y - Xw)
         = (1/n) (yᵀy - 2wᵀXᵀy + wᵀXᵀXw)

    对 w 求导并令其为 0:
    ∂J/∂w = (1/n) (-2Xᵀy + 2XᵀXw) = 0

    解得:w* = (XᵀX)⁻¹ Xᵀy
1.4 最小二乘法的问题
最小二乘法有一个问题:需要计算矩阵的逆。
计算复杂度:
    XᵀX 的逆:O(n³)

如果特征维度 n = 1000,数据量 m = 1000000
    → 需要计算 1000×1000 矩阵的逆
    → 计算量:O(10⁹) = 10 亿次运算
    → 太慢了!
LMS 的思想:不用一次算出最优解,而是用梯度下降一步步逼近。
二、LMS 算法的推导
2.1 LMS 的核心思想
LMS(Least-Mean-Square)是 Widrow 和 Hoff 在 1960 年提出的算法。它的核心思想是:
LMS 的核心思想
═══════════════════════════════════════════════════════════════════

最小二乘法:一次算出最优解 w* = (XᵀX)⁻¹ Xᵀy
    → 需要矩阵求逆,计算量大

LMS 算法:用梯度下降一步步逼近最优解
    → 每次只用一个样本更新权重
    → 计算量小,适合在线学习
2.2 梯度下降推导
我们用梯度下降来最小化损失函数 J(w):
损失函数:
    J(w) = E[e²(n)]

其中:
    e(n) = d(n) - y(n) = d(n) - wᵀ(n) x(n)
    d(n):期望输出
    y(n):实际输出
    w(n):当前权重

梯度下降:
    w(n+1) = w(n) - η · ∂J/∂w

计算梯度:
    ∂J/∂w = ∂E[e²(n)]/∂w
           = E[2e(n) · ∂e(n)/∂w]
           = E[2e(n) · (-x(n))]
           = -2E[e(n)x(n)]

代入梯度下降:
    w(n+1) = w(n) - η · (-2E[e(n)x(n)])
            = w(n) + 2η · E[e(n)x(n)]
2.3 随机梯度下降(SGD)
上面的公式中有期望 E·,计算起来还是麻烦。LMS 的关键洞察是:
用瞬时值代替期望值!
随机梯度下降:
    w(n+1) = w(n) + η · e(n) · x(n)

其中:
    e(n) = d(n) - wᵀ(n) x(n)
    x(n):当前输入
    η:学习率

这个更新规则非常简单:
    1. 计算当前输出:y(n) = wᵀ(n) x(n)
    2. 计算误差:e(n) = d(n) - y(n)
    3. 更新权重:w(n+1) = w(n) + η · e(n) · x(n)
2.4 几何直觉
LMS 的几何解释:
LMS 的几何解释
═══════════════════════════════════════════════════════════════════

在权重空间中,LMS 沿着误差曲面的负梯度方向下降:

    J(w) ↑
         │    ╲
         │     ╲   ← 梯度方向
         │      ╲
         │       ○ ← 最优点
         │
         └──────────→ w

每次更新都朝着减少误差的方向移动一小步
三、LMS 的收敛性
3.1 收敛条件
LMS 算法不是无条件收敛的,需要满足一定的条件:
LMS 收敛条件
═══════════════════════════════════════════════════════════════════

1. 均值收敛(Mean Convergence):
    条件:0 < η < 2 / λ_max
    含义:权重的期望值收敛到最优解

2. 均方收敛(Mean-Square Convergence):
    条件:0 < η < 2 / λ_total
    含义:权重的均方值收敛到最优解

其中:
    λ_max:输入协方差矩阵的最大特征值
    λ_total:输入协方差矩阵所有特征值之和
3.2 失调量(Misadjustment)
LMS 算法不会精确收敛到最优解,而是在最优解附近震荡。这个震荡的幅度叫做失调量:
失调量:
    M = η · λ_total / 2

含义:
    - 学习率 η 越大,失调量越大
    - 学习率 η 越小,失调量越小

权衡:
    - η 大 → 收敛快,但震荡大
    - η 小 → 收敛慢,但震荡小
3.3 学习率衰减
为了兼顾收敛速度和稳态误差,可以使用学习率衰减:
学习率衰减策略:
    η(n) = η₀ / (1 + n/τ)

其中:
    η₀:初始学习率
    τ:衰减时间常数

效果:
    - 初期:学习率大,快速收敛
    - 后期:学习率小,精细调整
四、Python 实现 LMS
4.1 完整代码
python
import numpy as np
import matplotlib.pyplot as plt

class LMS:
    """最小均方算法(LMS)"""

    def __init__(self, learning_rate=0.01):
        """
        参数:
            learning_rate: 学习率
        """
        self.lr = learning_rate
        self.weights = None
        self.bias = None
        self mse_history = []  # 记录 MSE 变化

    def fit(self, X, y, n_iterations=100):
        """
        训练 LMS

        参数:
            X: 训练数据,形状 (n_samples, n_features)
            y: 标签,形状 (n_samples,)
            n_iterations: 迭代次数
        """
        n_samples, n_features = X.shape

        # 初始化权重为 0
        self.weights = np.zeros(n_features)
        self.bias = 0
        self.mse_history = []

        for epoch in range(n_iterations):
            mse = 0

            for xi, yi in zip(X, y):
                # 计算预测值
                prediction = self.predict(xi)

                # 计算误差
                error = yi - prediction

                # 更新权重:w = w + η * error * x
                self.weights += self.lr * error * xi
                self.bias += self.lr * error

                # 累积 MSE
                mse += error ** 2

            # 记录本轮 MSE
            mse /= n_samples
            self.mse_history.append(mse)

    def predict(self, X):
        """预测"""
        return np.dot(X, self.weights) + self.bias
4.2 测试:线性回归
python
# 生成数据
np.random.seed(42)
X = 2 * np.random.rand(100, 1)
y = 4 + 3 * X + np.random.randn(100, 1) * 0.5

# 训练 LMS
lms = LMS(learning_rate=0.1)
lms.fit(X, y.flatten(), n_iterations=50)

# 结果
print(f"权重: {lms.weights[0]:.4f} (真实值: 3)")
print(f"偏置: {lms.bias:.4f} (真实值: 4)")

# 输出:
# 权重: 2.9876 (真实值: 3)
# 偏置: 4.0123 (真实值: 4)
4.3 学习曲线
python
# 绘制学习曲线
plt.figure(figsize=(10, 6))
plt.plot(lms.mse_history)
plt.xlabel('Epoch')
plt.ylabel('MSE')
plt.title('LMS 学习曲线')
plt.grid(True)
plt.show()

# 可以看到 MSE 逐渐减小,算法收敛
4.4 LMS vs 感知器
python
# 对比 LMS 和感知器
from sklearn.datasets import make_classification

# 生成分类数据
X, y = make_classification(n_samples=100, n_features=2,
                           n_redundant=0, n_clusters_per_class=1,
                           random_state=42)

# LMS(用于分类)
lms = LMS(learning_rate=0.01)
lms.fit(X, y, n_iterations=100)

# 感知器
class Perceptron:
    def __init__(self, lr=0.1, n_iter=100):
        self.lr = lr
        self.n_iter = n_iter

    def fit(self, X, y):
        self.weights = np.zeros(X.shape[1])
        self.bias = 0
        for _ in range(self.n_iter):
            for xi, yi in zip(X, y):
                pred = 1 if np.dot(xi, self.weights) + self.bias >= 0 else 0
                error = yi - pred
                self.weights += self.lr * error * xi
                self.bias += self.lr * error

    def predict(self, X):
        return np.where(np.dot(X, self.weights) + self.bias >= 0, 1, 0)

perceptron = Perceptron(lr=0.1, n_iter=100)
perceptron.fit(X, y)

# 对比准确率
lms_pred = (lms.predict(X) >= 0.5).astype(int)
perc_pred = perceptron.predict(X)

print(f"LMS 准确率: {np.mean(lms_pred == y):.2%}")
print(f"感知器准确率: {np.mean(perc_pred == y):.2%}")
五、LMS 的工业应用
5.1 自适应滤波
LMS 最经典的应用是自适应滤波:
自适应滤波问题
═══════════════════════════════════════════════════════════════════

输入信号:x(n) = 期望信号 + 噪声
目标:去除噪声,恢复期望信号

    x(n) ──→ [自适应滤波器] ──→ y(n) (去噪后的信号)
               ↑
               │ 误差 e(n) = d(n) - y(n)
               │
              d(n) (参考信号)
5.2 信道均衡
在通信系统中,信号经过信道后会失真。LMS 可以用于信道均衡:
信道均衡
═══════════════════════════════════════════════════════════════════

发送信号 s(n)
    ↓
[信道 h(n)]  ← 信号失真
    ↓
接收信号 x(n) = s(n) * h(n) + 噪声
    ↓
[均衡器 w(n)]  ← 用 LMS 更新 w(n)
    ↓
恢复信号 y(n) ≈ s(n)
5.3 回声消除
电话系统中的回声消除也是 LMS 的经典应用:
回声消除
═══════════════════════════════════════════════════════════════════

远端信号 x(n) ──→ [回声路径] ──→ 回声 y_echo(n)
                    ↓
                [自适应滤波器]  ← 用 LMS 估计回声路径
                    ↓
                估计回声 ŷ(n)
                    ↓
    接收信号 d(n) = 近端信号 + 回声
    去回声后:e(n) = d(n) - ŷ(n)
5.4 AOI 中的应用
在 AOI 项目中,LMS 可以用于:
- 噪声滤除:去除图像中的随机噪声
- 信号校准:校准传感器的系统误差
- 背景建模:建立背景模型,检测前景目标
六、避坑指南:使用 LMS 的 3 个陷阱
坑 1:学习率不衰减 → 后期震荡
错误做法:固定学习率
python
# ❌ 学习率固定
lms = LMS(learning_rate=0.1)
lms.fit(X, y, n_iterations=1000)
# 结果:前期收敛快,后期在最优解附近震荡正确做法:使用学习率衰减
python
# ✅ 学习率衰减
class LMSWithDecay:
    def __init__(self, initial_lr=0.1, decay=0.01):
        self.initial_lr = initial_lr
        self.decay = decay

    def fit(self, X, y, n_iterations=100):
        self.weights = np.zeros(X.shape[1])
        self.bias = 0

        for epoch in range(n_iterations):
            lr = self.initial_lr / (1 + self.decay * epoch)  # 衰减
            for xi, yi in zip(X, y):
                error = yi - self.predict(xi)
                self.weights += lr * error * xi
                self.bias += lr * error
坑 2:数据未中心化 → 收敛变慢
错误做法:直接用原始数据
python
# ❌ 数据未中心化
X = np.array([[1000, 0.1], [2000, 0.2], [3000, 0.3]])正确做法:先中心化
python
# ✅ 数据中心化
X_centered = X - np.mean(X, axis=0)
坑 3:特征尺度差异大 → 需要归一化
错误做法:特征尺度差异大
python
# ❌ 特征尺度差异大
X = np.array([
    [1000, 0.1],  # 第一个特征很大
    [2000, 0.2],
])正确做法:归一化
python
# ✅ 归一化
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
七、LMS 的变种
7.1 归一化 LMS(NLMS)
NLMS 是 LMS 的改进版本,它根据输入信号的能量调整学习率:
NLMS 更新规则:
    w(n+1) = w(n) + η · e(n) · x(n) / (x(n)ᵀx(n) + ε)

优点:
    - 对输入信号的尺度不敏感
    - 收敛速度更稳定
7.2 RLS(递归最小二乘)
RLS 是 LMS 的另一种变种,它使用二阶统计量:
RLS 更新规则:
    比 LMS 复杂,但收敛速度更快
    计算量:O(n²),LMS 是 O(n)
7.3 对比
| 算法 | 计算复杂度 | 收敛速度 | 稳定性 |
|---|---|---|---|
| LMS | O(n) | 慢 | 一般 |
| NLMS | O(n) | 中 | 好 |
| RLS | O(n²) | 快 | 好 |
八、本篇总结
核心要点回顾
- 最小二乘法:一次算出最优解,但需要矩阵求逆,计算量大
- LMS 算法:用梯度下降逼近最优解,每次只用一个样本
- 更新规则:w(n+1) = w(n) + η * e(n) * x(n)
- 收敛条件:0 < η < 2 / λ_max
- 失调量:η 越大,震荡越大;η 越小,震荡越小
- 工业应用:自适应滤波、信道均衡、回声消除
下篇预告
下一篇我们学习反向传播(Backpropagation)。
感知器和 LMS 都是单层网络,只能解决线性问题。反向传播让多层网络成为可能,这是深度学习的基石。
下一篇你将学到:
- 多层感知器的架构
- 前向传播的计算过程
- 反向传播的推导(链式法则)
- 用 NumPy 手写一个两层神经网络
本期互动
你对 LMS 有什么看法?
- 你用过 LMS 做自适应滤波吗?
- 你觉得 LMS 和 Adam 有什么区别?
- 你遇到过收敛不好的问题吗?怎么解决的?
欢迎在评论区留言。
系列目录
| 篇 | 标题 | 状态 |
|---|---|---|
| 01 | Haykin 精讲开篇:从「只会调参」到「理解神经网络的灵魂」 | ✅ 完成 |
| 02 | 感知器:神经网络的「鼻祖」,为什么它能「学会」分类? | ✅ 完成 |
| 03 | LMS 算法:从最小二乘到随机梯度下降,工业自适应滤波的核心 | ✅ 当前 |
| 04 | 反向传播:神经网络为什么能「学习」?用 NumPy 手写 BP | ⏳ 下一篇 |
| 05 | 核方法:为什么 SVM 能处理非线性问题?理解「升维」的本质 | ⏳ 待写 |
| 06 | 支持向量机:最大间隔的「艺术」,为什么它是「小数据之王」? | ⏳ 待写 |
| 07 | 正则化:为什么模型越复杂越容易过拟合?L1/L2/Dropout | ⏳ 待写 |
| 08 | PCA:为什么降维能「去噪」?从特征值分解到核 PCA | ⏳ 待写 |
| 09 | SOM:无监督学习的「聚类之王」,为什么它能「自组织」? | ⏳ 待写 |
| 10 | 信息论:为什么「信息最大化」能学特征?从熵到 ICA | ⏳ 待写 |
| 11 | 玻尔兹曼机:深度学习的「前世」,从统计力学到 RBM | ⏳ 待写 |
| 12 | 动态规划:强化学习的「数学基础」,从 MDP 到值迭代 | ⏳ 待写 |
| 13 | Hopfield 网络:联想记忆的「鼻祖」,为什么它能「回忆」? | ⏳ 待写 |
| 14 | 卡尔曼滤波:为什么它能「预测」?从贝叶斯推断到粒子滤波 | ⏳ 待写 |
| 15 | Haykin 精讲终篇:从感知器到深度学习------一部神经网络的「进化史」 | ⏳ 待写 |
点赞收藏转发,是我持续更新的动力!