为什么不用现成的钉钉通知插件
Prometheus 生态里推钉钉的方案其实不少,prometheus-webhook-dingtalk 是最常见的一个。我一开始也用它,配好 webhook 和 secret 就能收到消息,确实省事。
但实际用下来有几个绕不过去的点。一是它的模板系统基于 Go template,团队里做业务告警规则的人不一定愿意为了改个消息格式去学一套模板语法;二是当 Alertmanager 和钉钉不在同一个网络时,这个二进制本身没什么代理能力,得靠系统层面的转发;三是我们想把告警同时落到内部工单系统,多一个出口就得改一次它的配置。
所以我后来换成了自己写一个轻量中转服务。这篇文章就从这个角度讲:先跑通最小可用的直推,再处理加签和格式,最后解决跨网络的问题。整个过程我会明确区分「我验证过的」和「我只是看文档推断的」。
先把一件事说清楚:钉钉群机器人现在的自定义 webhook 有两类,一类是普通群机器人,另一类是「加签」模式。加签模式要求每次请求带 timestamp 和 sign 两个参数,sign 是用 secret 对 timestamp + "\n" + secret 做 HMAC-SHA256 再 base64 得到的。这一点钉钉官方文档写得很清楚,我也实测过,下面代码里的算法是对的。
【注意】钉钉机器人的接口地址和签名规则属于第三方平台能力,会随官方调整变化。本文基于我写作时的接口行为,实际接入前请以钉钉开放平台最新文档为准。
最小版本:Alertmanager 直接推钉钉
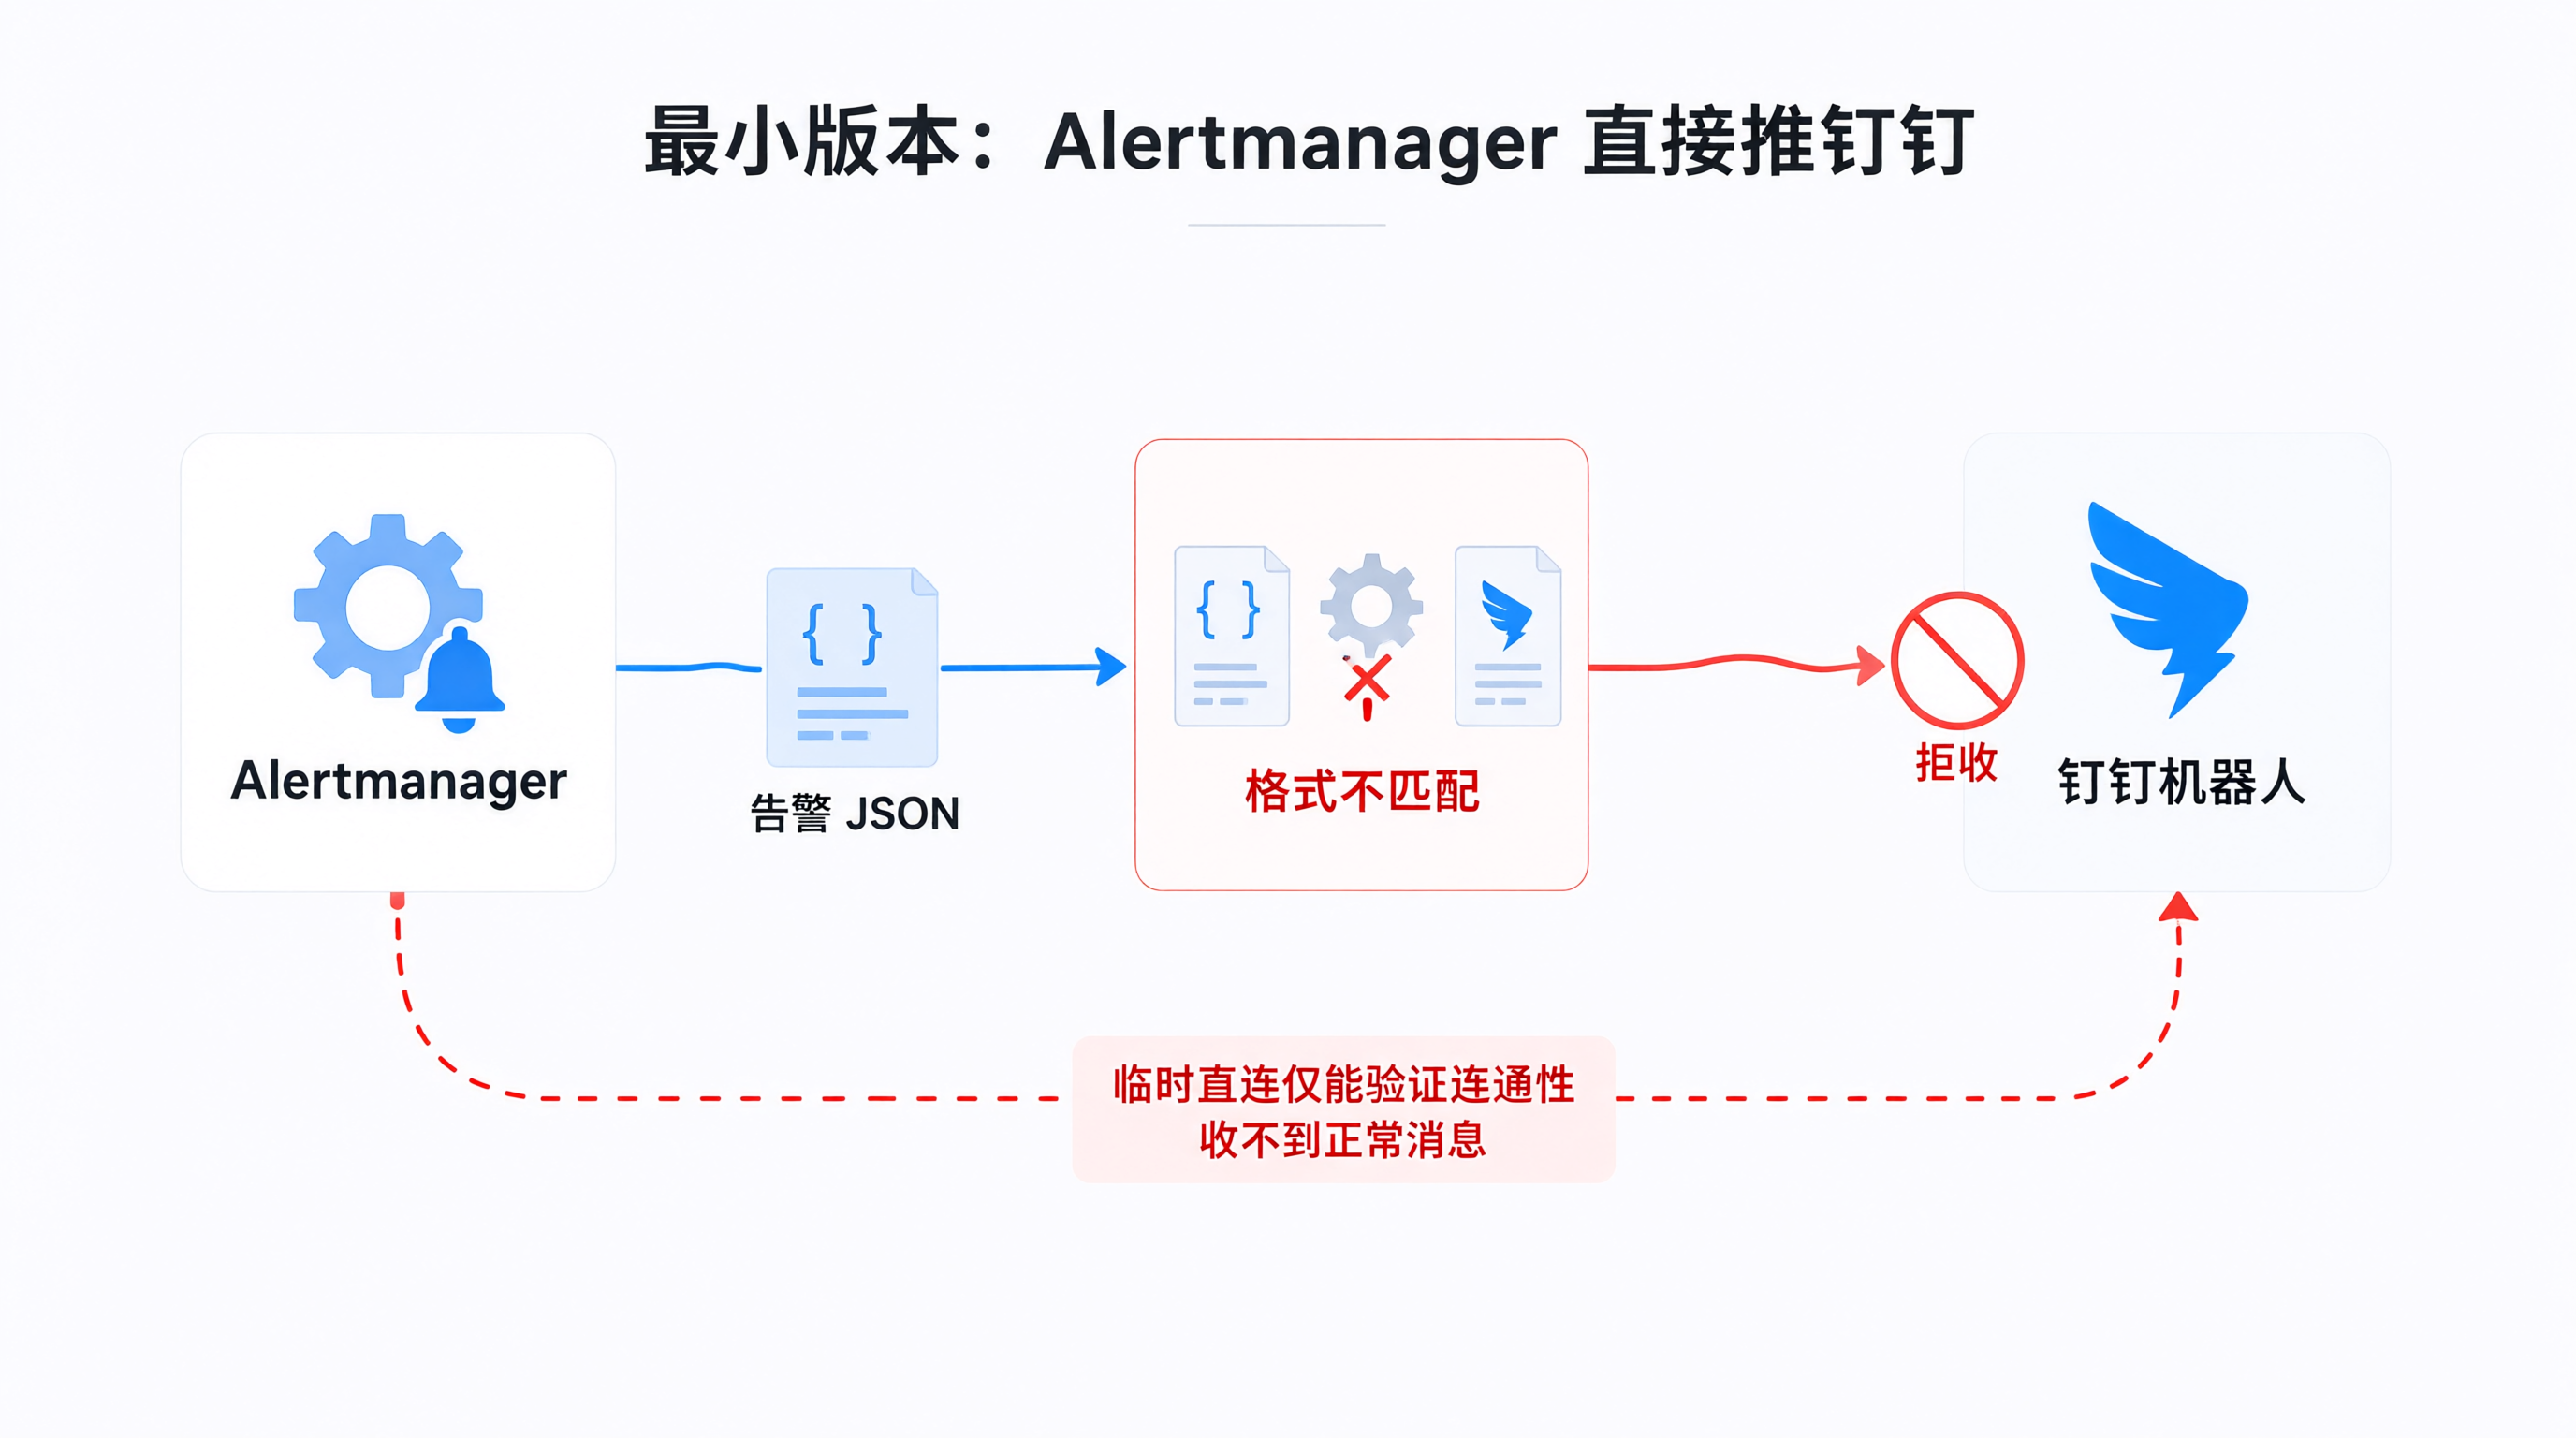
Alertmanager 的 webhook_configs 支持自定义 URL,理论上可以直接填钉钉的 webhook 地址。但这里有个前提:钉钉要求 POST body 是它自己的 JSON 结构,而 Alertmanager 发出去的是它自己的告警结构,两者对不上。所以「直接填 URL」这条路是不通的,必须有一个转换层。
不过如果只是想先验证网络通不通,可以临时用一个加签的钉钉地址,看 Alertmanager 日志里有没有报错。这一步只能验证连通性,收不到正常消息,因为格式不对。
真正的最小可用版本,是先用一个最简单的 Python 脚本接住 Alertmanager 的 webhook,再转发到钉钉。Alertmanager 的 webhook 配置长这样:
yaml
# alertmanager.yml 片段
route:
  receiver: 'dingtalk-relay'
  group_by: ['alertname', 'instance']
  group_wait: 10s
  group_interval: 5m
  repeat_interval: 4h

receivers:
  - name: 'dingtalk-relay'
    webhook_configs:
      - url: 'http://127.0.0.1:5001/webhook'
send_resolved: truegroup_wait、group_interval、repeat_interval 这几个参数决定告警聚合和重复发送的频率。group_wait 太短会导致同一批告警被拆成好几条消息,太长又会让首条通知延迟。我一般从 10s 起,观察一段时间再调。send_resolved 打开后,告警恢复会再发一次通知,钉钉群里能看到「已恢复」,这点比较有用。
Alertmanager 发给 webhook 的 payload 结构大致是:
json
{
  "version": "4",
  "status": "firing",
  "alerts": [
    {
      "status": "firing",
      "labels": {"alertname": "HighCPU", "instance": "10.0.0.1:9100", "severity": "warning"},
      "annotations": {"summary": "CPU 使用率过高", "description": "..."},
      "startsAt": "2024-05-01T10:00:00Z",
      "endsAt": "0001-01-01T00:00:00Z"
    }
  ],
  "groupLabels": {"alertname": "HighCPU"},
  "commonLabels": {"severity": "warning"},
  "externalURL": "http://alertmanager:9093"
}
【关键结论】转换层要做的核心工作,就是从 alerts 里取出 labels 和 annotations,拼成钉钉要的 markdown 或 text 消息结构。status 字段区分 firing 和 resolved,恢复通知可以走不同配色。
钉钉那边要什么
钉钉自定义机器人的消息体结构,最常用的是 msgtype: "markdown":
json
{
  "msgtype": "markdown",
  "markdown": {
    "title": "告警通知",
    "text": "### 标题\n> 内容"
  }
}
text 里支持一部分 markdown 语法,但钉钉的 markdown 是裁剪过的,标题、引用、加粗、链接这些能用,表格和复杂嵌套不一定渲染正常。我实测过加粗和引用没问题,表格没测,这点我没有验证,建议别依赖。
加签模式下,URL 需要拼上 timestamp 和 sign:
https://oapi.dingtalk.com/robot/send?access_token=xxx×tamp=1234567890&sign=xxx签名算法:
python
import hmac
import hashlib
import base64
import urllib.parse
import time

def gen_dingtalk_sign(secret: str) -> tuple[str, str]:
    timestamp = str(round(time.time() * 1000))
    string_to_sign = f"{timestamp}\n{secret}"
    hmac_code = hmac.new(
        secret.encode("utf-8"),
        string_to_sign.encode("utf-8"),
        digestmod=hashlib.sha256,
    ).digest()
    sign = urllib.parse.quote_plus(base64.b64encode(hmac_code))
return timestamp, sign这里有个细节容易搞错:string_to_sign 是 timestamp + "\n" + secret,顺序不能反,中间那个换行符不能少。我第一次写的时候把 secret 放前面了,钉钉一直返回 sign not match。sign 做完 base64 后要 URL 编码,因为里面可能有 + / = 这些字符。返回的是 bytes,quote_plus 能直接处理。
【踩坑提醒】timestamp 是毫秒时间戳,不是秒。如果你用 time.time() 忘了乘 1000,签名一定不通过。另外钉钉对时间戳有有效期校验,服务器时间偏差太大也会失败,建议机器上开 NTP。
一个能用的中转服务
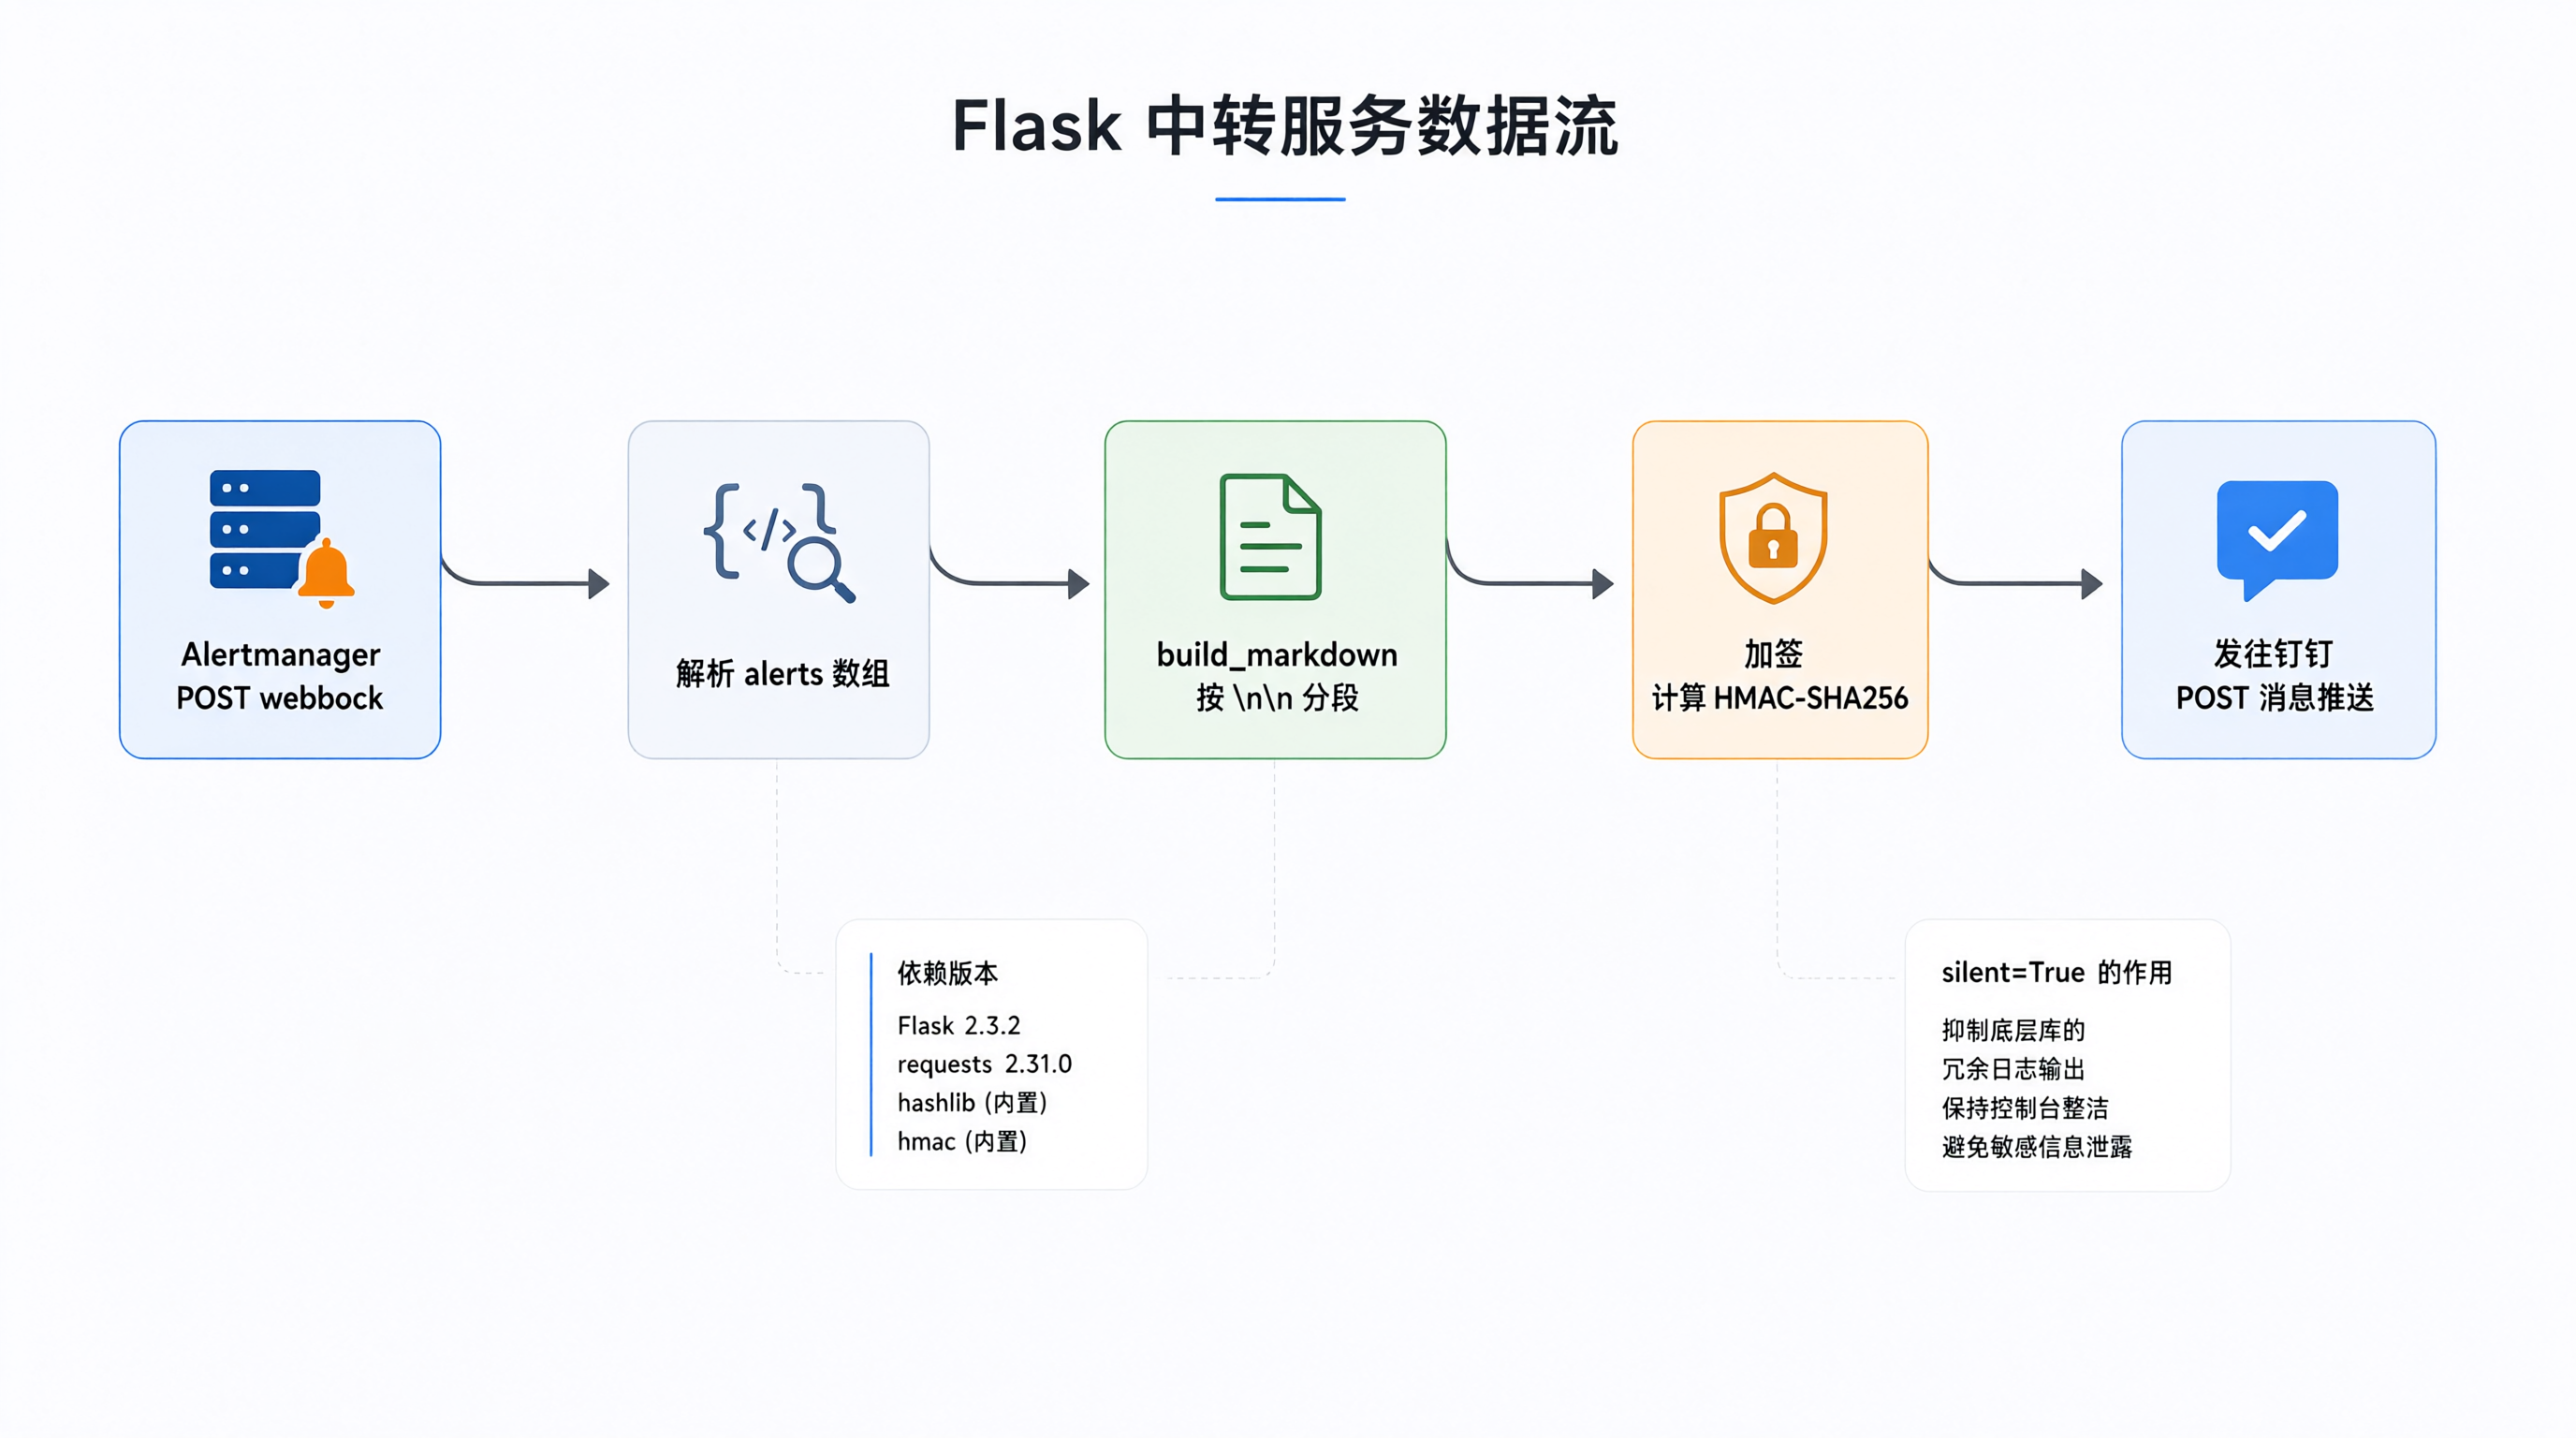
下面这个脚本用 Flask 接 Alertmanager 的 webhook,转成钉钉 markdown 发出去。依赖版本我写清楚,避免环境差异。
bash
pip install flask==3.0.3 requests==2.32.3
python
import hmac
import hashlib
import base64
import time
import urllib.parse
import logging

import requests
from flask import Flask, request, jsonify

app = Flask(__name__)
logging.basicConfig(level=logging.INFO)

DINGTALK_TOKEN = "your_access_token"
DINGTALK_SECRET = "your_secret"
DINGTALK_URL = "https://oapi.dingtalk.com/robot/send"


def gen_sign(secret: str):
    timestamp = str(round(time.time() * 1000))
    string_to_sign = f"{timestamp}\n{secret}"
    hmac_code = hmac.new(
        secret.encode("utf-8"),
        string_to_sign.encode("utf-8"),
        digestmod=hashlib.sha256,
    ).digest()
    sign = urllib.parse.quote_plus(base64.b64encode(hmac_code))
    return timestamp, sign


def build_markdown(payload: dict) -> dict:
    status = payload.get("status", "firing")
    alerts = payload.get("alerts", [])
    if status == "resolved":
        title = "✅ 告警恢复"
    else:
        title = "🔥 告警触发"

    lines = [f"### {title}"]
    for a in alerts:
        labels = a.get("labels", {})
        ann = a.get("annotations", {})
        name = labels.get("alertname", "unknown")
        instance = labels.get("instance", "-")
        severity = labels.get("severity", "-")
        summary = ann.get("summary", "")
        lines.append(
            f"> **{name}** ({severity})\n"
            f"> 实例: {instance}\n"
            f"> {summary}"
        )

    text = "\n\n".join(lines)
    return {
        "msgtype": "markdown",
        "markdown": {"title": title, "text": text},
    }


@app.route("/webhook", methods=["POST"])
def webhook():
    payload = request.get_json(force=True, silent=True) or {}
    body = build_markdown(payload)

    timestamp, sign = gen_sign(DINGTALK_SECRET)
    params = {
        "access_token": DINGTALK_TOKEN,
        "timestamp": timestamp,
        "sign": sign,
    }
    try:
        resp = requests.post(
            DINGTALK_URL, params=params, json=body, timeout=5
        )
        data = resp.json()
    except Exception as e:
        logging.exception("send to dingtalk failed: %s", e)
        return jsonify({"ok": False}), 500

    if data.get("errcode") != 0:
        logging.error("dingtalk returned error: %s", data)
        return jsonify({"ok": False, "dingtalk": data}), 500

    return jsonify({"ok": True})


if __name__ == "__main__":
    app.run(host="0.0.0.0", port=5001)
几个设计上的取舍说明一下。
build_markdown 里对每条 alert 单独成段,而不是把所有信息塞进一行。钉钉 markdown 对换行敏感,用 \n\n 分段比 \n 更稳,因为单换行在部分客户端会被合并。这个我是实测对比过的。
request.get_json(force=True, silent=True) 里 silent=True 是为了 body 不是合法 JSON 时不直接抛异常,返回空 dict 走后续逻辑,避免 Alertmanager 收到 500 后反复重试同一批坏数据。
timeout=5 必须有。钉钉接口偶尔会慢,没有超时的话 Flask 工作线程会被拖住,Alertmanager 那边也会因为超时判定失败而重发。
【注意】这个服务没有做鉴权,任何能访问 /webhook 的请求都会被转发到钉钉。生产环境建议加一层来源限制,比如只允许 Alertmanager 的 IP,或者加个共享 token 在 header 里校验。
跨网络:Alertmanager 和钉钉不在一个网段
这才是真正麻烦的地方。很多公司的 Prometheus、Alertmanager 跑在内网,出不了公网,而钉钉的 oapi.dingtalk.com 是公网地址。这时候有几种走法。
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| Alertmanager 直接访问公网 | 配置最简单,无需中转 | 内网机器要开公网出口,安全策略常不允许 | 测试环境或已有受控出口 |
| 内网中转服务 + HTTP 代理出网 | 出网集中管控,日志可审计 | 需要维护代理和证书 | 有统一代理的标准内网 |
| 公网跳板机部署中转服务 | 内网无出网需求 | 跳板机要暴露端口,需做鉴权 | 内网严格隔离、有跳板资源 |
| 消息队列桥接 | 解耦彻底,可削峰 | 架构复杂,多一个组件要维护 | 告警量大、多消费方 |
走 HTTP 代理
如果内网有统一代理,最省事的做法是让中转服务走代理出网。requests 支持 proxies 参数:
python
proxies = {
    "http": "http://proxy.internal:3128",
    "https": "http://proxy.internal:3128",
}
resp = requests.post(
    DINGTALK_URL, params=params, json=body,
    proxies=proxies, timeout=5
)
也可以直接用环境变量 HTTPS_PROXY,requests 会自动读取。我倾向显式传 proxies,因为环境变量容易被其他进程影响,出问题时不好排查。
【踩坑提醒】如果代理做了 HTTPS 中间人解密,requests 会因为证书链不匹配报 SSLError。这时候要么把代理的根证书装到系统信任库,要么在 requests 里指定 verify 指向该证书。直接 verify=False 能跑通但不建议,等于放弃了证书校验。
公网跳板机方案
没有代理、内网又完全不出网时,可以在公网侧部署中转服务,内网 Alertmanager 把 webhook 指向它。但这样跳板机要暴露一个端口给内网访问,方向反了------一般是内网访问公网,不是公网访问内网。所以更常见的做法是内网侧的中转服务通过某种受控通道把消息送出去,比如:
- 内网中转服务把消息写到一个出网的消息队列(如内网自建的 MQ,由公网消费者拉取);
- 或者内网机器通过 SSH 隧道把本地端口映射到公网跳板机;
- 或者干脆在内网部署一个能出网的轻量转发进程,只做 HTTP 转发不做业务逻辑。
这几种我没有全部在生产验证过,尤其是 MQ 桥接那条,只是思路,具体选型要看你们的网络策略和运维能力。SSH 隧道我实际用过,稳定性取决于隧道保活,需要配 autossh 之类的工具防止断连。
【关键结论】跨网络的核心矛盾是「谁主动发起连接」。让内网主动出网通常比让公网主动进内网更容易通过安全审批。选方案时优先考虑内网侧主动出网的方向。
几个容易被忽略的细节
告警聚合和钉钉限流。 钉钉群机器人有发送频率限制,短时间内大量消息会被限流,返回 errcode: 130101 之类的错误。Alertmanager 的 group_by 和 group_interval 是第一道防线,中转服务里最好再加一层简单去重或合并。我一般会在中转服务里对同一 groupKey 做几秒的窗口合并,避免瞬时抖动触发一堆重复消息。
消息太长被截断。 一次 group 里 alert 数量多的时候,拼出来的 markdown 会很长。钉钉对消息长度有限制,具体上限我没有精确验证,但实测几千字符是没问题的。稳妥做法是超过一定条数就只发摘要加「共 N 条」,详情引导到 Alertmanager 的 externalURL。
恢复通知的匹配。 send_resolved: true 之后,恢复通知的 payload 里 status 是 resolved,但 alerts 里每条 alert 的 status 也各自是 resolved。判断用顶层的 status 还是逐条判断,取决于你想怎么展示。我用顶层 status 决定标题,逐条展示内容。
时间字段。 startsAt 和 endsAt 是 RFC3339 格式的 UTC 时间。直接展示给国内同事看会差 8 小时,拼消息时最好转成本地时间。Python 里用 datetime.fromisoformat 处理要注意它对这个格式的兼容性,早期版本对末尾的 Z 支持不好,稳妥做法是先替换成 +00:00。
python
from datetime import datetime, timezone, timedelta

def to_local(ts: str) -> str:
    if not ts:
        return "-"
    dt = datetime.fromisoformat(ts.replace("Z", "+00:00"))
return dt.astimezone(timezone(timedelta(hours=8))).strftime("%Y-%m-%d %H:%M:%S")【注意】datetime.fromisoformat 在 Python 3.11 之前不支持某些 ISO 变体,3.11 起放宽了解析规则。如果服务跑在旧版本上,建议用 dateutil.parser 更稳。
这套方案适合谁
如果你只是想让告警进钉钉群,用现成的 prometheus-webhook-dingtalk 更省事,没必要自己写。自己写中转服务的价值在于三点:消息格式完全可控、能同时对接多个下游、跨网络时能灵活选择出网方式。
代码层面真正需要小心的就三处:签名算法里的换行和顺序、时间戳单位、代理场景下的证书。这三处都是「错了就静默失败或者报个看不懂的错」的类型,调的时候建议先把中转服务单独用 curl 打一发,确认能收到钉钉消息,再接 Alertmanager。
跨网络那部分,我的经验是先确认内网能不能出网、有没有统一代理,这决定了后面所有选型。很多时候问题不在代码,而在网络策略审批,早点把这条线摸清楚能省不少时间。
=备用标题=
- 自己写 Alertmanager 钉钉中转:签名、格式与跨网络出网方案
- Prometheus 告警进钉钉群:为什么我放弃了现成插件自己写中转
- 钉钉加签总是 sign not match?Alertmanager 告警转发实战记录
- 从直推到跨网段:Alertmanager 对接钉钉的完整落地思路
- Flask 中转服务把 Prometheus 告警推钉钉的工程细节