这是 RocketMQ 系列的第三篇。前两篇分别在架构和发送层面提到过「落盘 = 改 CommitLog + ConsumeQueue 两个文件」「顺序写、零拷贝、刷盘让落盘接近内存性能」------这些伏笔本篇全部展开。我们把镜头对准 Broker 内部,看一条消息到底是怎么被存下来的,以及为什么能存得「又快又不丢」。
一、存储的三大文件
Broker 的存储部分由三个目录组成,各司其职:
| 目录 | 作用 | 一句话 |
|---|---|---|
| CommitLog | 消息主体存储 | 所有消息的「总账本」 |
| ConsumeQueue | 消费队列索引 | 逻辑队列的真正实现 |
| IndexFile | 消息检索索引 | 按 Key / 时间查消息 |
三个文件的关系,先看一张图:
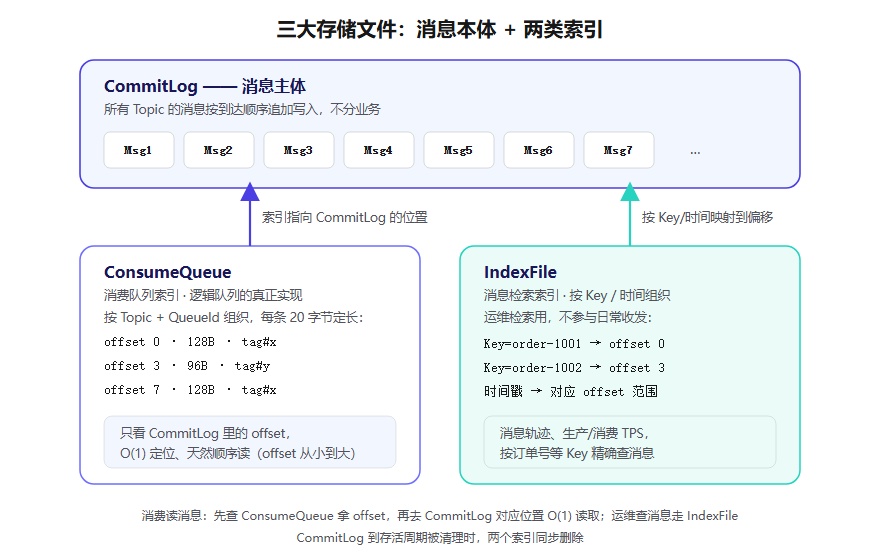
下面逐个介绍。
1. CommitLog:消息主体
消息本身直接存在 CommitLog 里 。只要消息传过来,就按顺序追加写入,完全不管它是哪个 Topic 的------不同业务、不同 Topic 的消息全部混在一起,按到达顺序排成一条长队。
CommitLog 是一块连续的磁盘空间 ,每个 CommitLog 文件申请 1G 的存储空间。写满 1G 之后,就会新建一个文件继续写(文件名就是该文件的起始偏移量,见第三节)。
它内部有三板斧,让它快得接近直接读内存:
- 顺序追加写入(第三节详解,这是它快的根基)
- 刷盘策略(第二节详解,权衡可靠性与性能)
- 零拷贝策略(第三节详解,优化读的路径)
2. ConsumeQueue:逻辑队列的真正实现
前面我们讲过「Topic 下有多个队列」,这里要揭穿一个本质:队列只是一个逻辑概念,它真正的物理形态,就是一个 ConsumeQueue 文件。
ConsumeQueue 按 Topic + QueueId 组织------每个 Topic 的每个队列,都对应一份 ConsumeQueue 索引文件。
它是索引文件 ,不存消息内容,只存「消息在 CommitLog 里的位置」。每个条目是固定 20 字节的定长结构:
| 字段 | 大小 | 含义 |
|---|---|---|
| CommitLog Offset | 8 字节 | 消息在 CommitLog 中的偏移位置 |
| Message Size | 4 字节 | 消息的大小 |
| Tag HashCode | 8 字节 | Tag 的哈希值,消费端过滤用 |
正因为条目定长、只存位置,它有两大优点:
- O(1) 定位:拿到索引,直接定位到 CommitLog 对应位置读文件,极其快速。
- 天然顺序读 :CommitLog 里的消息按到达顺序写入,所以 ConsumeQueue 里存的 offset 一定是从小到大 排好的。消费者消费时,只需批量取出一批索引,再按顺序读取 CommitLog 对应位置,就能批量顺序读------这比随机跳读高效得多。
3. IndexFile:按 Key / 时间检索
IndexFile 是另一类索引文件,按 Key 和时间戳 组织,主要用于运维检索:比如按时间统计某个 Topic 的生产 TPS / 消费 TPS、查询某条消息的完整轨迹、按 Key(订单号)精确查消息。
它对日常收发没有影响,业务开发基本用不到,这里记住「它是运维的检索工具」即可,不深入展开。
这三个文件的分工:CommitLog 存消息本体,ConsumeQueue 和 IndexFile 都是「索引」,本身不存消息内容。消息落盘之后,Broker 的后台线程(ReputMessageService)会异步地把新消息的索引构建进 ConsumeQueue 和 IndexFile,所以消费者很快就能通过 ConsumeQueue 查到新消息,而不需要直接扫 CommitLog。
二、落盘流程与刷盘策略
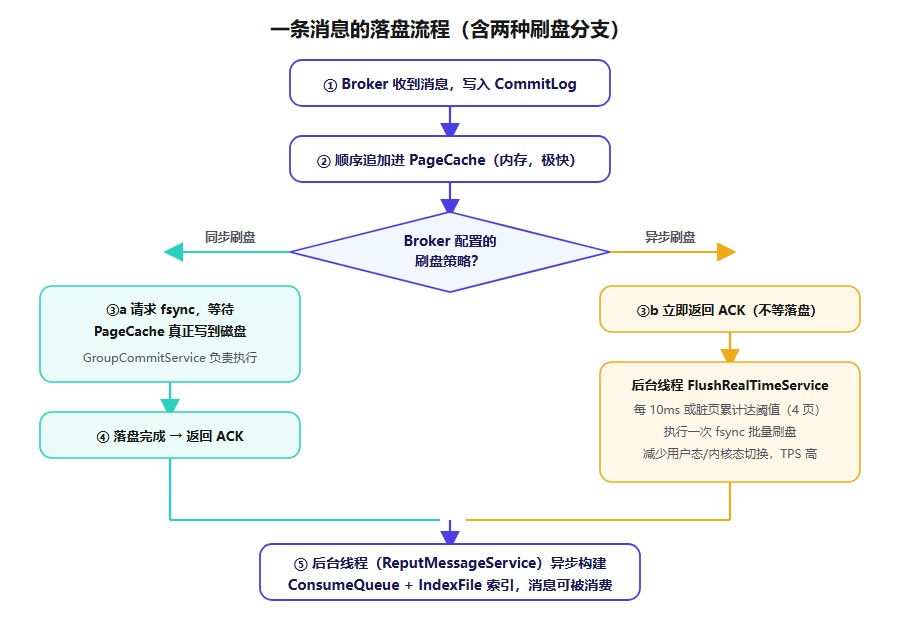
三个文件看完了,现在回到「一条消息落盘」这条主线:消息进 Broker 后,先写 PageCache,再由刷盘策略决定 ACK 何时返回。这个过程是存储可靠性的核心,流程图如下:
1. 写入 CommitLog:先到 PageCache
Broker 收到消息后,直接向 CommitLog 顺序追加 。但这步写入并不是立刻落到磁盘 ,而是先写进 PageCache(页缓存)------它是操作系统管理的内存缓存,读写速度远超磁盘。所以这一步极快。
2. 刷盘策略:决定 ACK 何时返回
通过前两篇我们知道:除了单向消息,消息持久化完成后 Broker 要返回 ACK 给生产者。问题来了------「持久化完成」到底指什么?写到 PageCache 算完成,还是落到磁盘才算? 这就产生了两种刷盘策略:
同步刷盘(SYNC_FLUSH)
- 消息写入 CommitLog 后,必须等 PageCache 的内容真正刷到磁盘,才返回 ACK。
- 由同步刷盘线程组(GroupCommitService)负责,写入方会等待刷盘结果。
- 可靠性最高,但每次都要等磁盘落盘,性能相对低。
- 场景:金融、强一致业务。
异步刷盘(ASYNC_FLUSH)
- 消息写入 PageCache 后立即返回 ACK,不等落盘。
- 刷盘交给一个专门的异步线程 FlushRealTimeService :它每隔 10ms ,或者PageCache 中脏页累计到一定量 (默认 4 页)时,执行一次
fsync,把这段时间攒下的内容一次性刷到磁盘。 - 批量刷盘大大减少了用户态和内核态的频繁切换,TPS 远高于同步刷盘。
- 场景:大部分日常业务。
那异步刷盘到底安不安全?其实风险很低 :PageCache 里的数据,只有在整台机器宕机或内核崩溃时才会丢失,而且丢失窗口最多只有 10ms。这个窗口非常小,所以日常业务用异步刷盘完全够,还能显著提升 TPS------这也是它成为默认配置的原因。
3. 索引构建:落盘流程的最后一步
消息写进 CommitLog(无论同步还是异步刷盘)之后,ConsumeQueue 和 IndexFile 的索引不是同步生成的,而是异步构建------这是「一条消息落盘」流程的最后一步:
后台有一个专门的线程(ReputMessageService)无限轮询 CommitLog:只要发现 CommitLog 里已写入的最大位点(offset)和自己记录的不一致,就立即把新消息的索引构建出来,写入对应的 ConsumeQueue 和 IndexFile。
因为是异步且高频轮询,消费者几乎立刻就能通过 ConsumeQueue 找到新消息,感受不到延迟。
到这里,一条消息的落盘全流程就走完了:写 CommitLog(PageCache)→ 刷盘决定 ACK → 异步构建两个索引 → 消息可被消费。
三、为什么顺序写这么快
CommitLog 之所以敢「所有消息一把梭、顺序追加」,核心前提是:磁盘的顺序写,远比随机写快。这里把物理原理讲透。
1. 机械硬盘的物理真相:随机写 vs 顺序写
机械硬盘(HDD)的物理结构是:一张旋转的盘片 + 一个移动的磁头。写入数据时:
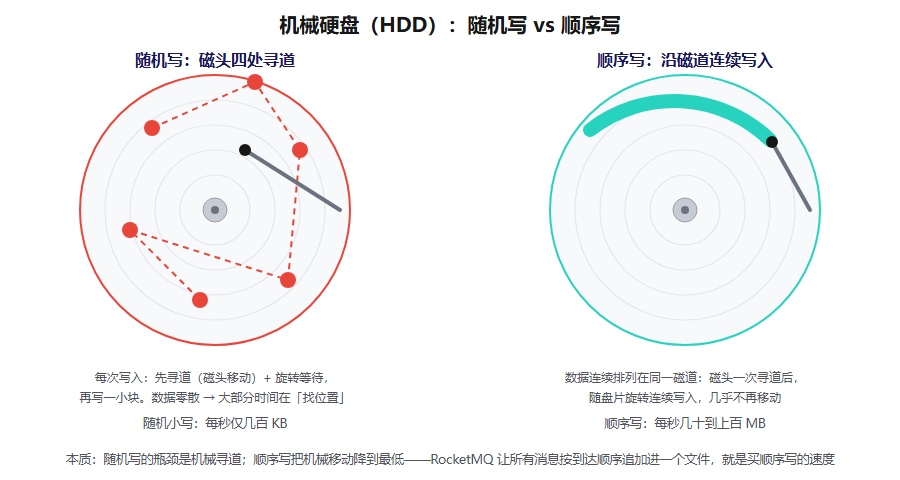
- 随机写 :磁头需要先移动(寻道)到目标磁道,再等盘片旋转到目标扇区,才能开始写。寻道和旋转等待都是机械运动,一次就要花好几毫秒。而且每次写的数据往往又小又零散------所以随机小写的性能极差,可能每秒只能写几百 KB,大部分时间都浪费在「找位置」上。
- 顺序写 :数据在盘片上连续排列,磁头只需移动一次,之后就一直沿轨道连续写下去,几乎不需要反复寻道。于是磁盘的吞吐可以接近它的物理带宽(每秒几十到上百 MB)。
两者差距的本质是:随机写的瓶颈是机械寻道,顺序写把机械移动次数降到了最低。所以 RocketMQ 把「所有消息按到达顺序追加进一个文件」作为存储的根基------它本质上是在用「顺序写」换取接近内存的落盘速度。两者对比见下图:
(SSD 没有机械寻道,顺序随机的差距没那么夸张,但顺序写对 SSD 同样友好,能减少写放大、延长寿命。这里不展开。)
2. CommitLog 的 1G 分片与清理
前面说过每个 CommitLog 文件是 1G、写满新建。为什么不分一个超大文件?两个原因:
- 方便定位与顺序读 :文件按「起始偏移量」命名(如
00000000000000000000、0000000001073741824......),知道消息的全局偏移,就能直接算出它在哪个文件里,快速定位。 - 方便清理 :旧的 CommitLog 不能无限保留,否则磁盘会满。它的存活周期 由两个条件控制,满足其一就删除最旧的文件:
- 按时间 :默认保留 72 小时 (
fileReservedTime,可配置),超过即删。 - 按磁盘占用 :默认磁盘使用率超过 75% (
diskMaxUsedSpaceRatio)时,强制删除最旧文件,保证磁盘不满。
- 按时间 :默认保留 72 小时 (
注意:删除 CommitLog 时,对应的 ConsumeQueue、IndexFile 索引也会一并清理。这也是为什么消费完的历史消息会「过期消失」------它们不是被特意删的,而是 CommitLog 到了存活周期被清掉了。
3. 页缓存:内存加速
第二节讲的是「写」这一侧:消息先写进 PageCache。现在看「读」这一侧,PageCache 同样在加速。
消费者拉取消息时,先去 PageCache 里找 :很多时候,新写入的消息还躺在 PageCache 里,消费者直接命中缓存 ,相当于是纯内存的快速读写,根本不需要磁盘 I/O。只有当消息已经被刷盘、并被后续写入挤出 PageCache 之后,消费者才会真正落到磁盘上去读。
这就是 RocketMQ「消息尽量在 PageCache 中被消费完」的设计哲学------理想状态下,一条消息的生产和消费全在内存里完成,磁盘只是最终的持久化兜底。
4. 零拷贝:把读的路径压缩到极致
传统读取一条消息(发送给消费端) 的路径是这样的:
磁盘 → 内核缓冲区(PageCache) → 用户态应用缓冲区 → 内核 Socket 缓冲区 → 网卡这条链路涉及多次内核态 ↔ 用户态的上下文切换 ,以及多次内存拷贝(每经过一层就要拷一遍),CPU 被白白消耗在「搬运数据」上。传统路径见下图:
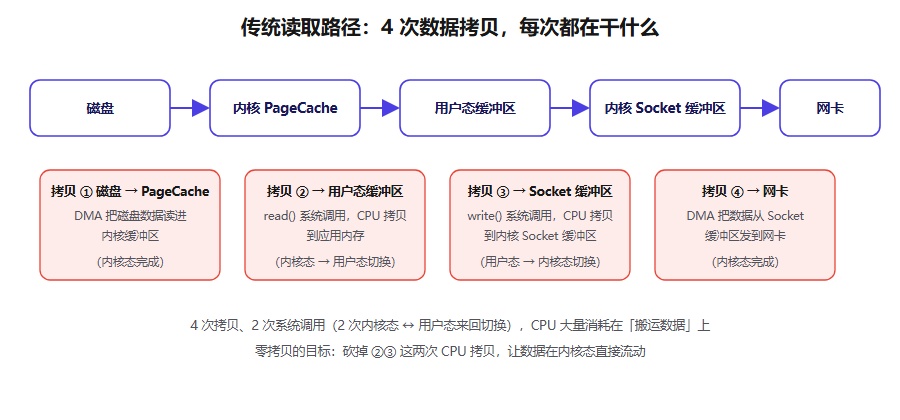
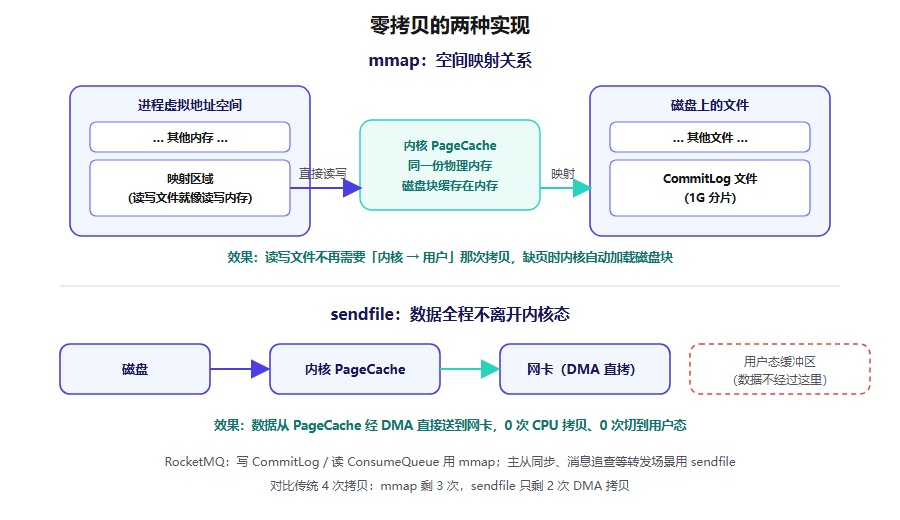
零拷贝(Zero Copy) 的思路是:让数据在内核态直接流动,避免无谓的拷贝和切换。典型技术有两种:
- mmap(内存映射):把文件映射到用户态虚拟内存,应用直接读写这块映射,省掉「内核缓冲区 → 用户态缓冲区」的那次拷贝。RocketMQ 写 CommitLog、读 ConsumeQueue 走的就是它。
- sendfile / transferTo :数据从 PageCache 出发,直接通过 DMA 拷贝到网卡,全程不经过用户态,连 CPU 拷贝都省了。RocketMQ 在需要把消息转发(比如主从同步、消息追查)时可以使用它。
两者省掉的拷贝用下图对比,一眼就能看出差别:
一句话总结:顺序写解决「快落盘」,PageCache + 零拷贝解决「快读写」,三者叠加,就是 RocketMQ 敢于把「每条消息都落盘」还保持高吞吐的全部秘密。
四、主从复制(HA)
落盘解决的是「单机不丢消息」,但单机仍然可能挂。RocketMQ 用主从复制来解决 Broker 的高可用。
1. 为什么需要主从
Broker 支持主从部署:一个 Master 带一个或多个 Slave,Master 负责写入,Slave 实时同步 Master 的消息。这样一旦 Master 宕机,Slave 手里还有完整的数据,可以接管服务,消息不会因为一台机器挂了就丢了。
2. 复制方式:同步复制 vs 异步复制
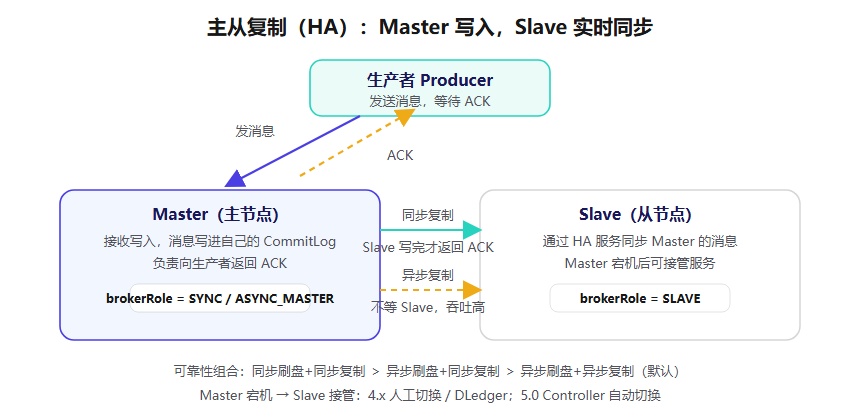
Master 把消息写进自己的 CommitLog 之后,会通过 HA 服务把新消息同步给 Slave(Slave 同样先写自己的 PageCache/CommitLog)。根据「要不要等 Slave 写完」,分为两种:
- 同步复制(SYNC_MASTER) :Master 必须等 Slave 写入完成 ,才认为这条消息发送成功、返回 ACK。Master 和 Slave 数据始终一致,不丢消息,但每条消息都要等一次网络传输,吞吐受影响。
- 异步复制(ASYNC_MASTER) :Master 不等 Slave ,自己写完就返回 ACK,Slave 慢慢追。吞吐高,但如果 Master 在 Slave 追上来之前宕机,可能丢失尚未同步的消息。
3. 刷盘 × 复制:可靠性组合矩阵
Broker 上「刷盘策略」和「复制方式」是两个独立维度,组合起来形成不同的可靠性等级:
| 组合 | 可靠性 | 说明 |
|---|---|---|
| 同步刷盘 + 同步复制 | 最高 | Master 落盘且 Slave 落盘才返回,任何单点故障都不丢消息 |
| 异步刷盘 + 同步复制 | 高 | Slave 有完整副本,但 Master 未落盘部分可能丢 |
| 异步刷盘 + 异步复制 | 默认 | 吞吐最高,容忍「未落盘 + 未同步」两个小窗口的丢失 |
实际部署中,金融、强一致场景用第一档,绝大多数业务用默认的第三档。
4. 故障切换
Master 宕机后,Slave 可以接管继续提供服务。注意两点:
- 丢失窗口:在异步复制下,Slave 可能落后于 Master,接管时会丢掉 Master 上尚未同步的消息(这正是「异步复制 + 异步刷盘」组合允许的丢失窗口)。
- 切换机制 :RocketMQ 4.x 时代,主从切换需要人工介入(或使用 DLedger 模式实现自动选主);5.0 开始引入了 Controller 组件,可以自动完成 Broker 的主从切换。这一块属于部署运维细节,这里知道「Slave 能接管、切换有自动和人工两种方式」即可。
主从复制的整体结构如下:
小结
这一篇把 RocketMQ 存储的底牌全亮出来了:三大文件各司其职------CommitLog 顺序追加存消息主体(1G 分片、按 72h/磁盘水位清理),ConsumeQueue 用 20 字节定长索引实现逻辑队列(O(1) 定位、天然顺序读),IndexFile 按 Key/时间供运维检索。落盘流程是「写 PageCache → 按同步/异步策略刷盘并返回 ACK → 后台线程异步构建 ConsumeQueue/IndexFile」,PageCache 同时服务读写,让消息尽量在内存里被消费完。它快的根基是顺序写 (绕开机械寻道)+ 页缓存 (内存加速)+ 零拷贝 (省掉拷贝与切换);不丢的根基是主从复制 (同步/异步)× 刷盘(同步/异步)的可靠性组合。
从下一篇开始,我们把镜头转向消费端------消息是怎么被 Consumer 拉走、消费进度如何管理、失败重试与死信队列又是怎么回事。