如何把一套 SAP ABAP 工程 Skill 从 opencode 运行时中「萃取」出来,让它独立运行在自开发的Agent上?本次实践来复刻 opencode 的 Skill 调用机制(发现 → 路由 → 注入 → 工具循环)。最终目标:用自然语言对话即可让 Agent 读写 ABAP 源码、执行代码审查、做传输门控评估,最终可直接集成进企业 Chatbot中。
背景:
我在用 sap-engineering-skill 这个仓库------它把 SAP ABAP 的日常工程工作(读源码、代码审查、传输门控、集成问答)封装成了 4 个 Skill,配合 opencode 这样的 AI Agent 框架使用。opencode 做的事很简单:扫描 SKILL.md → 注入 LLM 上下文 → 给 LLM 暴露 Bash/Read/Write 工具。
问题是 opencode 把自己的运行时和 skill 绑在了一起------skill 没有独立可运行的形态。我想知道:skill 本身能不能直接跑在裸 Python + 本地大模型上?
答案是可以。本次实践记录整个「萃取」过程,你会看到 opencode 的 skill 机制本质上只是一套 prompt + tool 的协议,与特定 Agent 框架无关。
理解 opencode Skill 的调用本质
sap-engineering-skill 的 4 个 skill 都是纯文档驱动的------没有自定义代码,只有 SKILL.md + references/ + 一个可选的 CLI 脚本(sap_adt_cli.py / tr_collector.py)。
opencode 的 skill 运行时可以抽象成 4 步:
┌─────────────────────────────────────────────────────────────────┐
│  opencode 运行时                                                 │
├─────────────────────────────────────────────────────────────────┤
│                                                                 │
│  1. Skill 发现                                                   │
│     扫描 ~/.agents/skills/ 下的子目录,解析每个 SKILL.md 的       │
│     YAML frontmatter(name / description / type / permissions)│
│                                                                 │
│  2. 意图路由                                                     │
│     用 description 匹配用户输入,选出最相关的 skill               │
│                                                                 │
│  3. 上下文注入                                                   │
│     把 SKILL.md 全文拼进 system prompt,告诉 LLM:               │
│     "请按这里的步骤执行"                                         │
│                                                                 │
│  4. 工具循环                                                     │
│     LLM 按 SKILL.md 指示调用 Bash/Read/Write                    │
│     → 执行工具 → 结果喂回 LLM → 直到产出最终回答                 │
│                                                                 │
└─────────────────────────────────────────────────────────────────┘
4 个 skill 中,sap-adt-cli 和 sap-transport-gate 会调用 CLI 脚本,abap-code-review 和 sap-integration-wiki 纯靠读 references/*.md 然后组织语言。但不管哪种,运行时只需要 「能执行 shell 命令」和「能读写文件」 这两个能力。
这就是可移植性的秘密------skill 不是代码库,而是一套 LLM 行为规范。我们不需要复刻 opencode 的完整实现,只需要复刻这 4 步。
用 Python 复刻运行时
6 个文件就能搭起来。架构:
SAPAgent/
├── config.yaml              # LLM + skill 路径 + 安全配置
├── requirements.txt
└── sap_agent/
    ├── skill_registry.py    # 扫描 skills/ 解析 SKILL.md
    ├── llm_client.py        # OpenAI 兼容协议(支持本地 vLLM/oMLX)
    ├── tools.py             # run_command / read_file / write_file / list_directory
    ├── agent.py             # 主循环(路由 → 注入 → 工具循环)
    └── main.py              # CLI + 交互式 REPL
Skill Registry
python
def discover_skills(skills_dir: str | Path) -> list[Skill]:
    """扫描 skills_dir 下每个子目录,解析 SKILL.md。"""
    for entry in sorted(Path(skills_dir).iterdir()):
        if entry.is_dir():
            yield parse_skill_md(entry / "SKILL.md")
解析用正则拆 frontmatter:^---\s*\n(.*?)\n---\s*\n(.*)$,前半段 YAML 提取元数据,后半段就是要注入 LLM 的正文。
意图路由LLM 比关键词匹配好
我试过用关键词匹配("review" → abap-code-review,"OData" → sap-integration-wiki),效果很差------"审查程序 DEVK900123 是否可以上线" 同时命中代码审查和传输门控。
改用 LLM 做路由:把所有 skill 的 description 拼成列表,让 LLM 选一个。这个额外的 LLM 调用开销很小(description 加起来不到 1KB),但路由精度比正则高一个量级。路由失败时 Agent 会输出所有可用 skill 让用户显式指定。
本地 LLM:oMLX + OpenAI 兼容协议
我的 Mac 上跑的是 oMLX.app------Apple Silicon 原生 MLX 推理,SSD KV cache 让 tool-calling agent 的多轮对话几乎零预热延迟。
yaml
# config.yaml
llm:
  base_url: "http://localhost:8000/v1"
  api_key: "sk-0501"        # oMLX 可配置 API key
  model: "Qwen3.6-35B-A3B-4bit"
  temperature: 0
  max_tokens: 8192
OpenAI SDK 的 base_url 参数让任何 OpenAI 兼容端点都能无缝接入------不管是本地 oMLX/vLLM/Ollama 还是云端 Qwen/DeepSeek。我们没引入 LangChain 或任何 Agent 框架,就是裸 SDK + tool calling。
复刻 opencode 的核心行为
python
messages = [
    {"role": "system", "content": SYSTEM_PROMPT_TEMPLATE.format(
        skill_name=skill.name,
        skill_dir=str(skill.skill_dir),
        skill_content=skill.content,   # ← SKILL.md 全文注入
    )},
    {"role": "user", "content": user_input},
]

for _ in range(30):
    resp = llm.chat(messages, tools=TOOL_DEFINITIONS)
    message = extract_message(resp)
    tool_calls = parse_tool_calls(message)

    if not tool_calls:
        return message.content        # LLM 给出最终回答

    # 执行工具,把结果喂回 LLM
    messages.append(assistant_toolcall_message)
    for tc in tool_calls:
        result = tool_executor.execute(tc.name, tc.arguments)
        messages.append({"role": "tool", "tool_call_id": tc.id, "content": result})
TOOL_DEFINITIONS 就是 OpenAI function calling 格式的 JSON Schema------run_command / read_file / write_file / list_directory。与 opencode 的 Bash/Read/Write 工具一一对应。
端到端验证
一切打通后的实战:
bash
$ python -m sap_agent --skill sap-adt-cli "检查表 T001 的结构"Agent 内部发生了什么:
[skill] 激活: sap-adt-cli
  │ 注入 SKILL.md 全文到 system prompt
  │ 注入绝对路径: skills/sap-adt-cli/scripts/sap_adt_cli.py
  │ 注入可用工具: run_command / read_file / write_file / list_directory
  │
  ├─→ [tool] run_command("python3 ...sap_adt_cli.py status")
  │    ← 返回连接信息:URL=http://sap.ksyun.ai:50152, User=SAP_HUIGE, Client=600
  │
  ├─→ [tool] run_command("python3 ...sap_adt_cli.py get-table T001")
  │    ← 返回 JSON:22 个字段(mandt, bukrs, butxt, ort01, land1, waers...)
  │
  └─→ LLM 整理 JSON → 输出中文表格
最终输出(摘选):
表 T001(公司代码)的结构如下:
主键字段
字段名 类型 说明 MANDTmandt 客户端 BUKRSbukrs 公司代码 非主键字段(共 20 个)
BUTXT / ORT01 / LAND1 / WAERS / SPRAS / KTOPL / PERIV / KOKFI / RCOMP / ADRNR ...
从用户输入到 SAP 返回数据再到 LLM 整理输出,整个链路只经过了 2 次工具调用 + 3 次 LLM 请求 (1 次路由 + 2 次工具循环)。在本地 Qwen 上,整个响应时间大约 30 秒。
两个值得注意的点
1. Skill 是行为规范,不是代码库
sap-engineering-skill 里没有一个 .py 文件是「agent 专用」的------所有 Python 代码都是独立的 CLI 工具。opencode 做的事只是把 SKILL.md 文档喂给 LLM,让 LLM 按文档调用这些工具。这意味着 任何能调 LLM + 能执行 shell 的运行时都能跑这些 skill,不绑定 opencode。
2. LLM 路由比关键词匹配更靠谱
对于"审查程序 DEVK900123 是否可以上线"这种可能同时命中多个 skill 的查询,关键词匹配的组合爆炸问题很难优雅解决。LLM 路由用 1KB 的 description + 一次轻量调用解决了这个问题,成本可以忽略。
项目代码
完整代码在 SAPAgent/ 目录,6 个 Python 文件加一个 YAML 配置。启动命令:
bash
cd SAPAgent
pip install -r requirements.txt
python -m sap_agent # 交互模式
python -m sap_agent --list-skills
python -m sap_agent --verbose "对zfi_auto_clearing程序进行优化"
审核结果如下(截取部分):
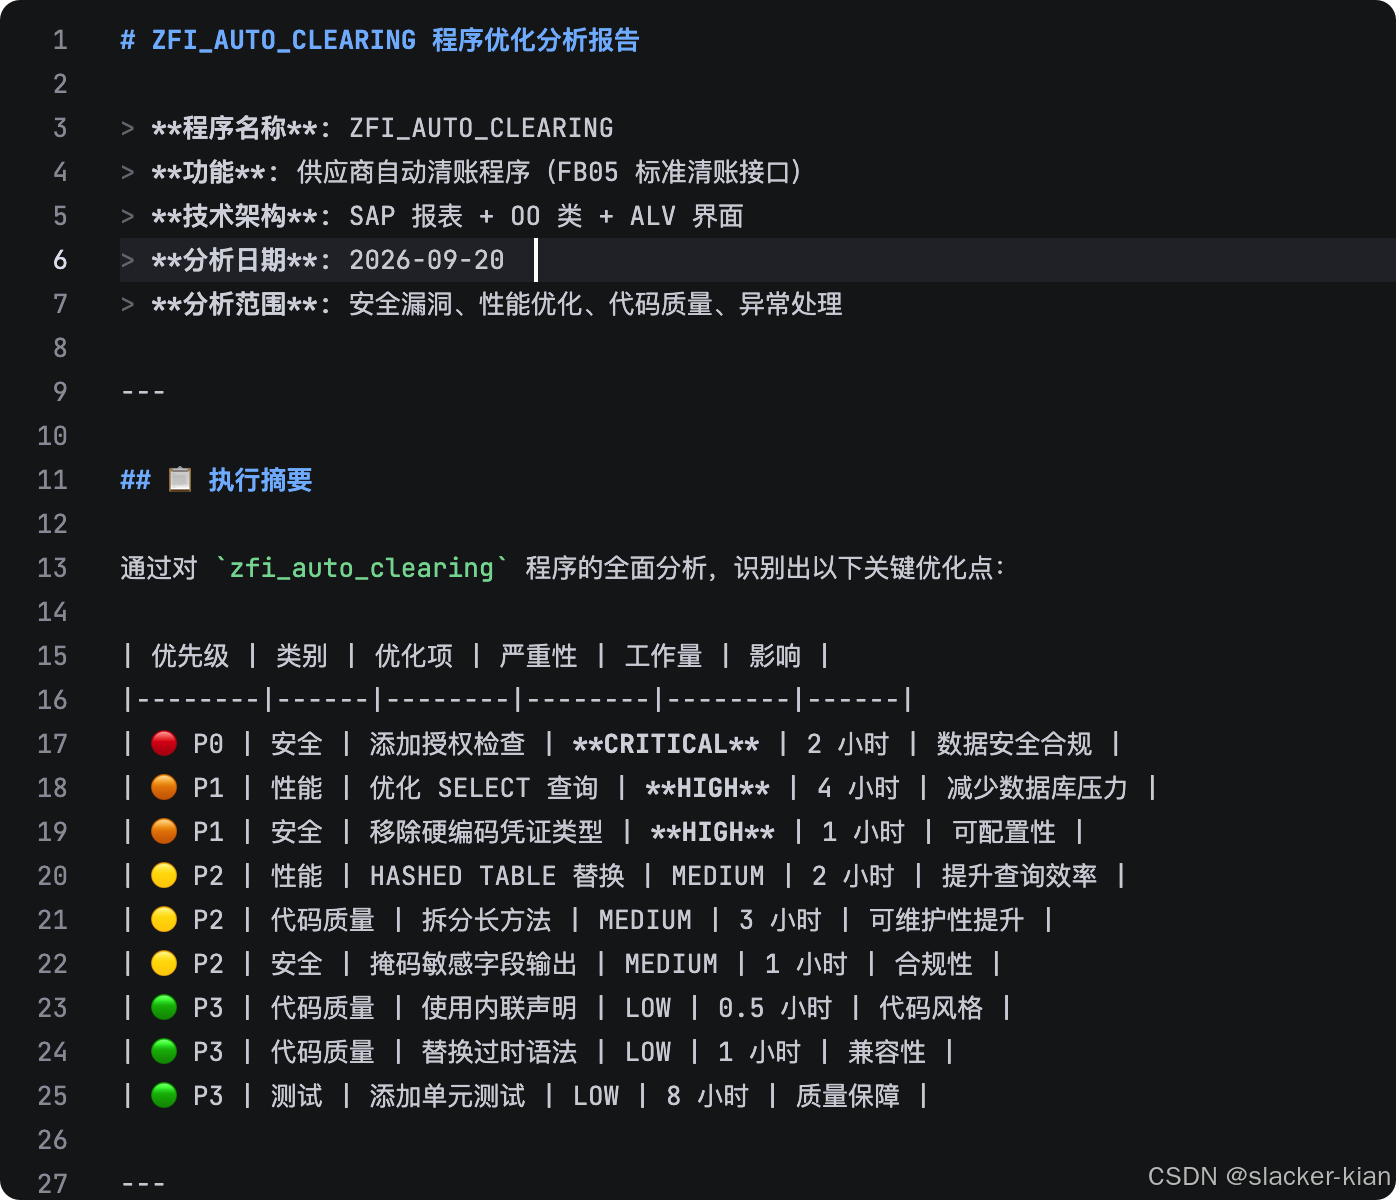
他在分析报告中还给出了工作量,因为是本地模型,性能较差,小的改动都要花费很长时间。
致谢
- shrek-abaper/sap-engineering-skill --- 4 个高质量 Skill + 设计优雅的 ADT CLI,本次实践在此基础上封装,目的是脱离Opencode的依赖,实现独立的Agent,后续可集成在chatbot中。