📖标题:CanvasAnneal: Curriculum Reinforcement Learning for Diffusion Language Models
🌐来源:arXiv, 2609.13060v1
🛎️文章简介
🔸研究问题:扩散语言模型在强化学习训练初期,因为从纯噪声开始生成,探索效率极低且难以发现有效的推理路径,如何解决这个探索瓶颈?
🔸主要贡献:论文提出CanvasAnneal框架,利用强教师模型的推理轨迹作为初始引导,并通过课程学习逐渐减少引导,显著加速了扩散模型在复杂推理任务上的收敛速度。
📝重点思路
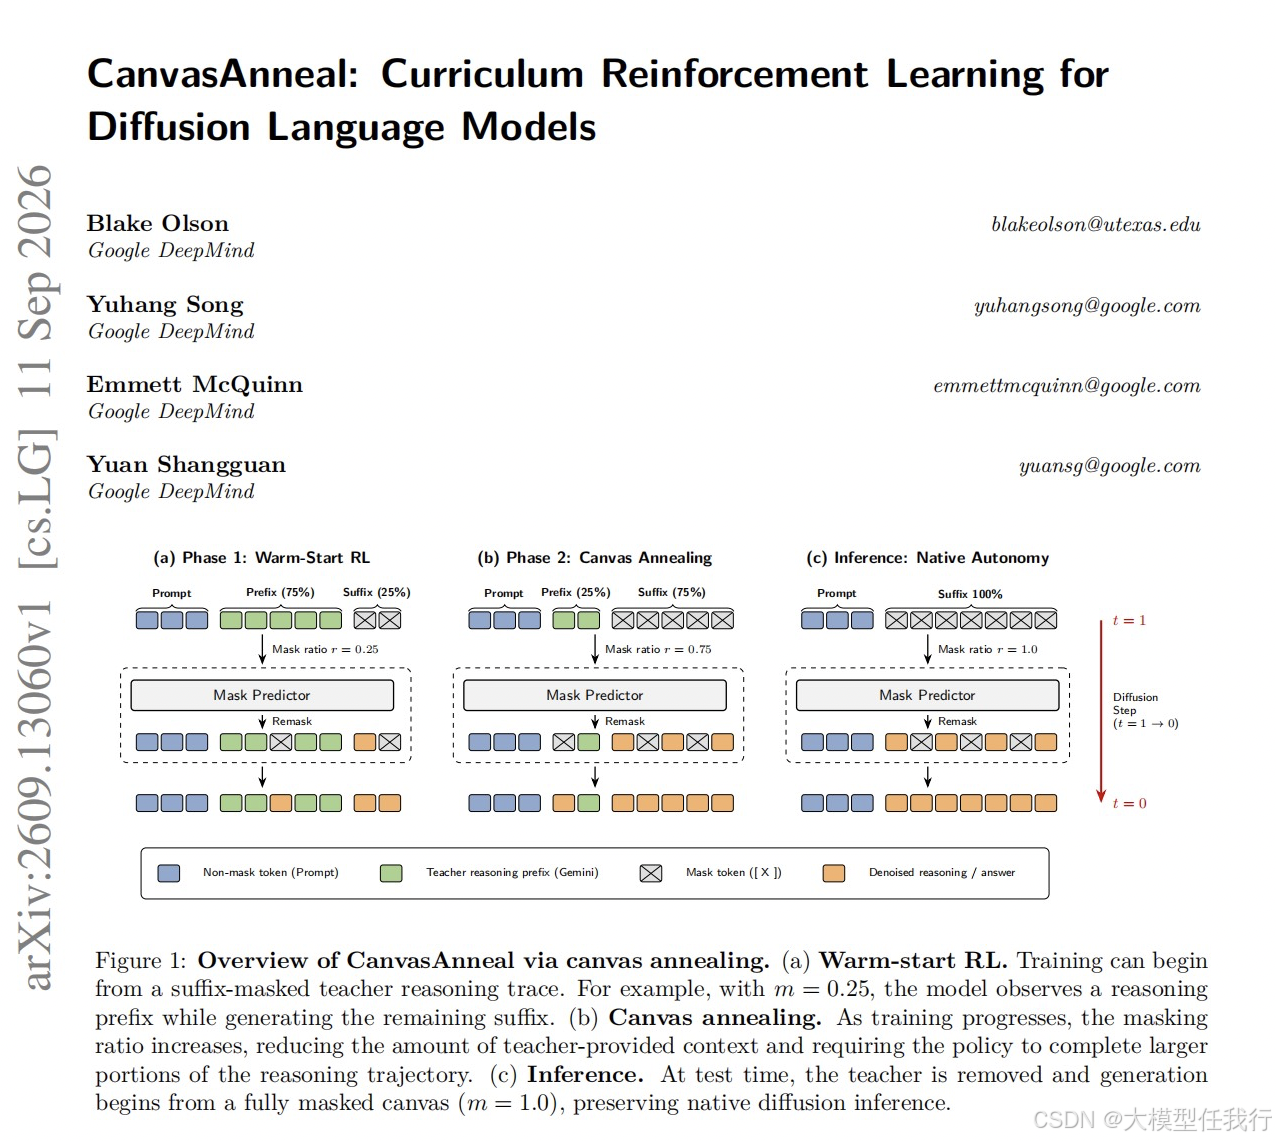
🔸引入教师先验进行热启动:在强化学习初期,不直接从全掩码的噪声画布开始,而是将更强教师模型生成的推理轨迹前缀注入到初始画布中,为模型提供结构化的探索方向。
🔸实施后缀掩码策略:采用连续的后缀掩码方式,保留教师推理轨迹的前缀部分,只掩码后半部分让模型去补全。相比随机掩码,这种方式更能保持推理逻辑的连贯性,要求模型学会延续已有的思维链条。
🔸动态Beta混合课程调度:设计了一个随训练进度变化的动态课程。早期保留大部分教师引导(低掩码率),随着训练进行,通过Beta分布逐渐增加掩码比例,减少教师提供的上下文,迫使模型独立生成更多推理步骤。
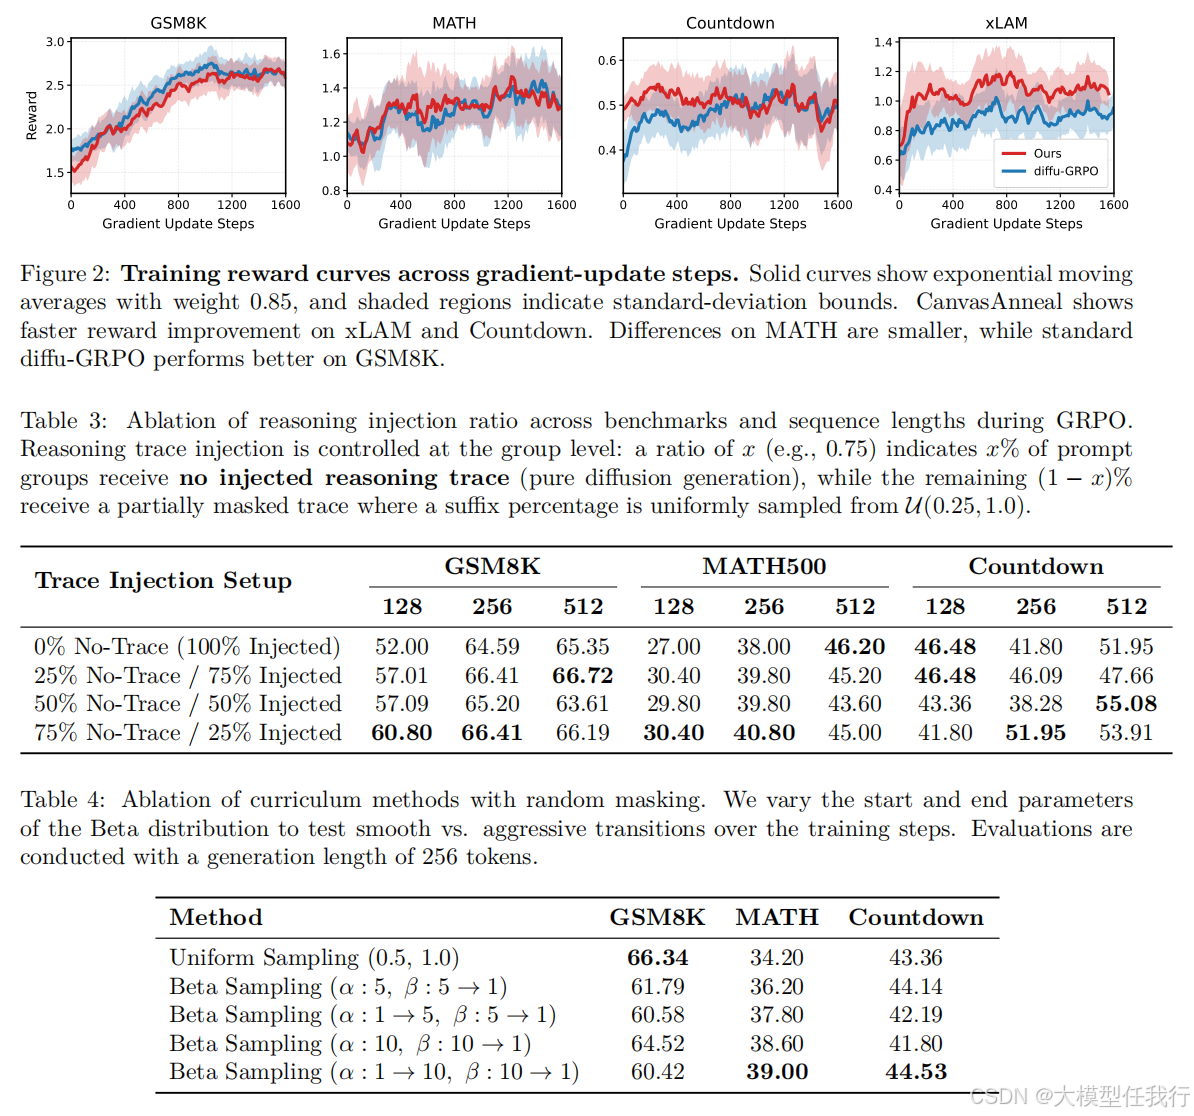
🔸保留纯噪声探索:在每一批训练中,始终保留一定比例(如25%或75%,视任务而定)的样本完全从纯噪声开始生成,防止模型过度依赖教师引导,确保其具备从零生成的能力。
🔸结合组相对策略优化:在同一提示词组内共享相同的初始画布和掩码比例,确保组内优势计算的公平性,利用diffu-GRPO算法进行策略更新,实现端到端的强化学习训练。
🔎分析总结
🔸数学推理性能提升:在MATH500和Countdown基准测试中,CanvasAnneal在不同生成长度下均优于标准的diffu-GRPO方法,证明了课程引导对复杂多步推理的有效性。
🔸工具使用能力增强:在Tau2工具调用基准上,该方法在所有领域(零售、航空、电信)均取得一致的性能提升,平均得分显著高于基线,表明其能更好地学习复杂的工具执行逻辑。
🔸收敛速度大幅加快:实验显示,在xLAM和Countdown任务上,CanvasAnneal达到特定奖励阈值所需的训练步数比基线少7.4倍至18.8倍,极大地提高了训练样本效率。
🔸任务依赖性明显:该方法在GSM8K等较简单或不同分布的任务上并未表现出优势,甚至略逊于基线,说明课程引导的效果高度依赖于任务的复杂度和奖励景观的特性。
🔸无需教师模型推理:尽管训练阶段使用了教师模型,但在最终推理测试时,模型完全从全掩码画布自主生成,不增加任何额外的推理延迟,保持了扩散模型的并行生成优势。
💡个人观点
论文将"课程学习"的思想融入到了扩散模型的强化学习中,把教师的推理过程当作一个逐渐撤去的"脚手架"。