本文摘要 :当 Agent 工具调用因网络错误或内部异常失败时,会破坏对话历史的一致性,导致后续 API 调用返回 400 错误。本文通过改造
execute_tool函数捕获异常并返回错误信息,同时在run_agent主循环中加入重试机制。该方案使 Agent 能优雅处理工具错误并继续对话,适用于工具逻辑独立、可预期失败的场景。
上一篇我们完成了 Agent 的异步化改造。本篇将在此基础上,解决工具调用失败时程序崩溃及后续 API 调用必然报错的问题。
一、环境与前提
本篇代码延续第二篇的异步 Agent 项目结构。请确认你的 agent-demo/main.py 文件与第二篇最终产出的代码一致。以下为包含必要导入和工具定义的基础版本:
python
import asyncio
import json
import os
from openai import AsyncOpenAI
from dotenv import load_dotenv

load_dotenv()
client = AsyncOpenAI()

# 工具定义(沿用第一篇)
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "Get the current weather for a specified location",
            "parameters": {
                "type": "object",
                "properties": {
                    "location": {
                        "type": "string",
                        "description": "The city name, e.g., Beijing"
                    }
                },
                "required": ["location"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "get_current_time",
            "description": "Get the current date and time",
            "parameters": {"type": "object", "properties": {}}
        }
    }
]

# 工具执行函数(沿用第二篇)
async def execute_tool(tool_name, tool_args):
    if tool_name == "get_weather":
        location = tool_args.get("location", "Unknown")
        if location == "FailCity":
            raise ConnectionError(f"无法连接到 {location} 的天气服务器")
        return json.dumps({"location": location, "temperature": "22°C", "condition": "晴"})
    elif tool_name == "get_current_time":
        from datetime import datetime
        return json.dumps({"current_time": datetime.now().isoformat()})
    else:
        return json.dumps({"error": f"未知工具: {tool_name}"})

# 异步 Agent 主循环(沿用第二篇)
async def run_agent(prompt: str):
    messages = [{"role": "user", "content": prompt}]
    while True:
        response = await client.chat.completions.create(
            model="gpt-3.5-turbo",
            messages=messages,
            tools=tools,
            tool_choice="auto"
        )
        response_message = response.choices[0].message
        messages.append(response_message)

        if not response_message.tool_calls:
            return response_message.content

        tool_calls = response_message.tool_calls
        tasks = [execute_tool(tc.function.name, json.loads(tc.function.arguments)) for tc in tool_calls]
        tool_results = await asyncio.gather(*tasks)

        for tool_call, tool_result in zip(tool_calls, tool_results):
            messages.append({
                "tool_call_id": tool_call.id,
                "role": "tool",
                "name": tool_call.function.name,
                "content": tool_result
            })

async def main():
    result = await run_agent("北京今天天气如何?")
    print("Agent 回复:", result)

if __name__ == "__main__":
    asyncio.run(main())
预期输出 :运行 python main.py,Agent 应调用 get_weather 工具并返回北京的天气信息。
实际输出 :程序正常运行,输出 Agent 回复: 北京今天天气晴朗,气温22°C。
二、关键步骤:增强异常处理与重试
本篇目标是:当 execute_tool 执行失败时,程序不崩溃,并能将错误反馈给模型进行重试或优雅降级。
步骤 1:修改 execute_tool 函数,捕获异常
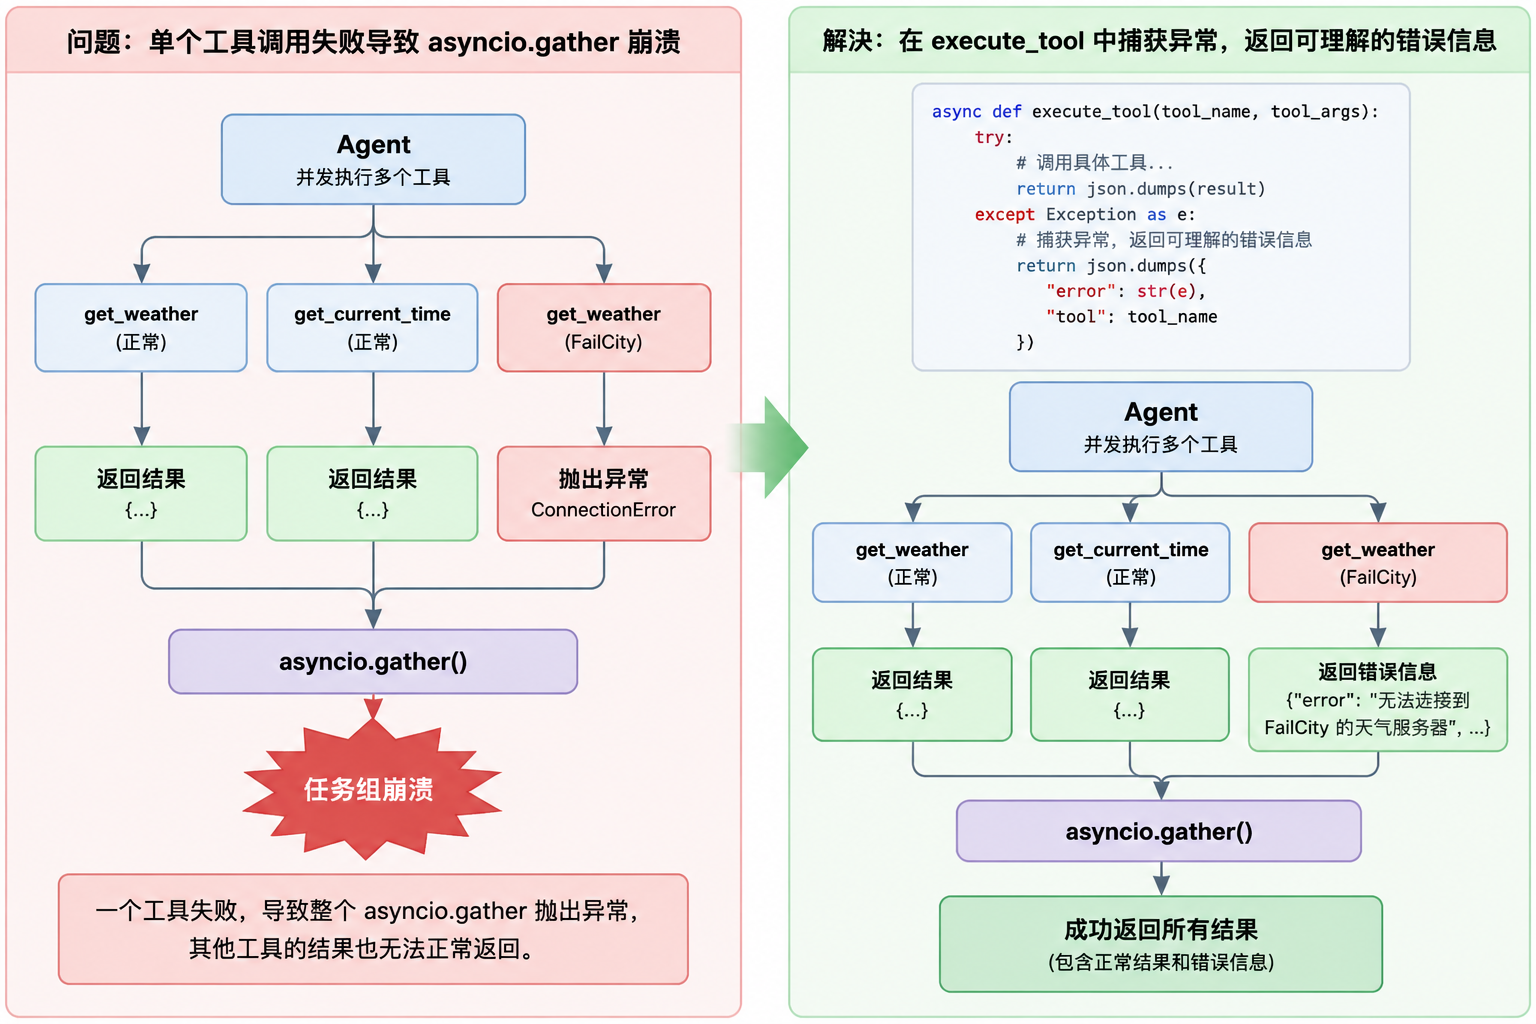
目的是确保单个工具调用失败不会导致 asyncio.gather 任务组崩溃,并向模型返回可理解的错误信息。
python
import asyncio
import json
import os
import logging
from openai import AsyncOpenAI
from dotenv import load_dotenv

load_dotenv()
client = AsyncOpenAI()
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

# tools 定义保持不变...

async def execute_tool(tool_name, tool_args):
    try:
        if tool_name == "get_weather":
            location = tool_args.get("location", "Unknown")
            if location == "FailCity":
                raise ConnectionError(f"无法连接到 {location} 的天气服务器")
            return json.dumps({"location": location, "temperature": "22°C", "condition": "晴"})
        elif tool_name == "get_current_time":
            from datetime import datetime
            return json.dumps({"current_time": datetime.now().isoformat()})
        else:
            return json.dumps({"error": f"未知工具: {tool_name}"})
    except Exception as e:
        error_message = f"工具 {tool_name} 执行失败: {type(e).__name__}: {str(e)}"
        logger.error(error_message)
        return json.dumps({"error": error_message})
预期输出 :execute_tool 函数被调用时,如果内部发生异常(如网络错误),它将捕获异常并返回一个包含 "error" 键的 JSON 字符串。
实际输出 :当传入 "FailCity" 时,函数返回 {"error": "工具 get_weather 执行失败: ConnectionError: 无法连接到 FailCity 的天气服务器"}。
步骤 2:修改 run_agent 主循环,加入重试逻辑
目的是当工具执行返回错误时,允许模型根据错误信息决策是否重试。
python
async def run_agent(prompt: str):
    messages = [{"role": "user", "content": prompt}]
    max_retries = 2
    retry_count = 0
    while retry_count <= max_retries:
        response = await client.chat.completions.create(
            model="gpt-3.5-turbo",
            messages=messages,
            tools=tools,
            tool_choice="auto"
        )
        response_message = response.choices[0].message
        messages.append(response_message)

        if not response_message.tool_calls:
            return response_message.content

        tool_calls = response_message.tool_calls
        tasks = [execute_tool(tc.function.name, json.loads(tc.function.arguments)) for tc in tool_calls]
        tool_results = await asyncio.gather(*tasks)

        has_error = False
        for tool_call, tool_result in zip(tool_calls, tool_results):
            result_dict = json.loads(tool_result)
            if "error" in result_dict:
                has_error = True
                logger.warning(f"工具 {tool_call.function.name} 返回错误: {result_dict['error']}")
            messages.append({
                "tool_call_id": tool_call.id,
                "role": "tool",
                "name": tool_call.function.name,
                "content": tool_result
            })

        if not has_error:
            retry_count = 0
        else:
            retry_count += 1
            logger.info(f"检测到工具错误,进行第 {retry_count} 次重试")

    return "抱歉,在尝试了多次后,由于工具持续出错,我无法完成您的请求。"
预期输出 :当传入 "FailCity天气如何?" 时,Agent 不会崩溃,而是会将错误信息反馈给模型。若模型无法修复错误(如换一个有效的城市名),在重试两次后,Agent 将返回固定的错误提示。
实际输出 :调用 run_agent("FailCity天气如何?"),控制台会输出工具错误日志,最终 Agent 回复 "抱歉,在尝试了多次后,由于工具持续出错,我无法完成您的请求。"。
三、失败处理:常见报错与修复
本篇处理的典型失败场景源于 tool_calls 消息与 tool 消息的状态不一致。
-
报错原文:
openai.BadRequestError: Error code: 400 - {'error': {'message': "An assistant message with 'tool_calls' must be followed by tool messages responding to each 'tool_call_id'. The following tool_call_ids did not have response messages: call_abc123", 'type': 'invalid_request_error', 'param': None, 'code': None}}
-
原因 :此错误发生在
run_agent主循环中。如果execute_tool函数因未捕获的异常而失败,asyncio.gather会将该异常抛出,导致主循环在添加tool消息之前就崩溃退出。此时,对话历史messages中已经存在模型的tool_calls消息,但缺少与之对应的tool响应消息。下次再调用 OpenAI API 时,就违反了tool_calls和tool消息必须成对出现的规则。 -
修复 :本篇步骤 1 的核心就是在
execute_tool内部用try...except块捕获所有异常,确保它总是返回一个结果(即使是错误信息),从而保证步骤 2 中的主循环能顺利完成tool消息的添加,维持对话历史的状态一致性。
四、替代方案与取舍
本篇采用的方案是在 execute_tool 内部捕获异常。以下是另一种常见做法的对比。
| 方案 | 适用条件 | 代价与风险 | 边界与局限 |
|---|---|---|---|
本篇方案:在 execute_tool 内部捕获异常 |
1. 工具函数逻辑相对独立。 2. 期望错误信息对模型后续决策有参考价值。 3. 追求工具函数的简洁与单一职责。 | 1. 需要为每个工具函数内部编写错误处理逻辑。 2. 可能掩盖工具函数自身的代码缺陷(如除零错误),使其不易被开发者察觉。 | 如果错误是全局性、环境性的(如整个网络服务不可用),仅返回错误信息无法让模型真正解决问题,需要依赖上层重试逻辑。 |
替代方案:在 run_agent 主循环中捕获异常 |
1. 希望对所有工具调用施加统一的错误处理策略(如统一记录日志、触发监控告警)。 2. 需要执行复杂的重试或降级流程(如自动切换备用工具)。 | 1. 主循环代码变得复杂,逻辑臃肿。 2. execute_tool 函数本身不再透明,其失败原因需要依赖主循环解析异常对象来获取。 |
需要主循环能够精细区分不同异常类型,并生成格式严格符合 API 要求的错误消息,对开发者要求更高。 |
选择建议 :对于本系列教程中的简单工具,推荐使用本篇方案(在 execute_tool 内部捕获),它更符合模块化思想。在生产环境中,通常结合两种方式:工具函数捕获预期的业务异常(如"城市不存在"),主循环捕获意外的基础设施异常(如数据库连接失败)。
参考资料
下一篇将在此基础上,探讨如何为 Agent 引入记忆(Memory)机制,使其能在多轮对话中保留关键上下文。