一、导言:一道分水岭
2026年10月的第一周,全球AI产业迎来了一个标志性时刻。
10月3日,德国统一日。德国Aleph Alpha以Apache 2.0许可证发布781亿参数的MoE模型Kolibri 1,主打政府与受监管行业的主权部署。10月5日,美国布鲁克林初创公司Reflection AI发布首个开放权重模型Beam,被路透社称为"西方对中国开源AI系统的回应"。次日,法国Mistral AI发布总参数量达1.05万亿的Mistral Large 4(代号"Le Chonk"),官方口径为"美国与欧洲最强开放权重模型"。
在此之前的9月,中东已经先行落子:9月3日,沙特HUMAIN基于中国MiniMax M3推出4280亿参数的阿拉伯语模型HUMAIN M3;同日,阿联酋MBZUAI发布覆盖0.9B到375B、共六款规格的K2 Horizon家族,并称之为"AI历史上最大的完全开源模型发布"(按参数量计)。更早的2026年1月,阿联酋TII的Falcon-H1 Arabic已凭借混合Mamba-Transformer架构在阿拉伯语评测中取得领先。
短短数日之内,横跨大西洋、波斯湾与东亚的开放模型密集发布,勾勒出2026年全球AI格局的本质特征:开放模型已从技术路线的选择,演变为国家战略、产业竞争和地缘博弈的交汇点。
理解这一格局,需要超越"谁强谁弱"的表层比较,进入三个更深层的结构性维度:不同区域为何选择不同的开放路径?这些路径背后是什么力量在驱动?以及,当开放模型的能力逼近闭源前沿时,全球AI的权力结构将如何被重塑?
在展开分析之前,需要先做一个贯穿全文的概念辨析。2026年全球AI治理的核心争议之一,正是"开源"与"开放权重"的界限。开源促进会(OSI)于2024年10月发布的《开源AI定义1.0》(OSAID)要求,一个真正开源的AI系统不仅要公开模型参数,还须提供完整的训练与推理代码,以及足以重建实质性等效模型的训练数据信息。然而,当前绝大多数被广泛称为"开源"的模型------包括Qwen、DeepSeek、Kimi以及本文讨论的几乎所有模型------实际上只开放了权重,训练代码和数据信息并未完整披露。这一区分并非学术之争:它直接决定了一家企业能否复现系统、能否通过许可证审查、能否在必要时迁移到其他供应商,也决定了欧盟AI法案的监管豁免能否适用。本文在涉及具体模型时,将严格区分"开源"与"开放权重"两个概念。
二、2026年的新坐标系:中国开放模型的结构性崛起
要理解欧美和中东为何在2026年密集发力开放模型,必须先理解它们共同面对的坐标系------中国开放权重模型的崛起。
这不仅是性能层面的追赶,更是生态层面的结构性位移。据Hugging Face发布的2026年春季全球开源AI生态报告,在2025年2月至2026年2月期间,该平台41%的大模型下载量来自中国研发的模型,美国模型下载量占比为36.5%,中国模型累计下载量突破100亿次。
图1:Hugging Face平台开源模型下载量(2025.2---2026.2),中国6.63亿次居首,对应约41%份额。来源:Hugging Face《State of Open Source on Hugging Face》2026年春季报告(经公开报道转引),与正文引用同一出处
阿里巴巴的Qwen系列在Hugging Face上的累计下载量约为20.45亿次(截至2026年8月),基于Qwen构建的衍生模型数量达到151,448个,约为Meta旗下模型衍生品总量的2.6倍。〔注1〕Hugging Face CEO克莱芒·德朗格公开表示,中国在开源权重AI模型领域占据领先地位。〔注2〕
在调用量层面,据AI模型聚合平台OpenRouter数据,中国模型周调用量大幅超过美国模型,且已连续二十余周保持领先。〔注3〕但需要明确指出:调用量反映的是规模化采用,而非技术能力领先。中国开放模型的低价策略(甚至免费)天然推高调用量。a16z合伙人Martin Casado在2025年下半年观察到的现象是:前来寻求融资的硅谷AI初创公司中使用中国开源模型的概率约为80%。〔注4〕这是概率估计,而非精确统计比例,反映的是成本驱动的工程选择,而非能力判断。
性能差距的收敛同样值得关注,但需要审慎解读。Mozilla于2026年9月发布的报告指出,顶尖开放权重模型与闭源前沿模型之间的能力差距已缩短至约4.4个月。然而,这一数据基于METR的时间horizon指标,测量的是"模型在50%成功率下能完成的任务时长"。METR的方法论显示,AI agent的时间horizon在早期约每7个月翻一番,而2024---2025年已加速至约每4个月。〔注5〕根据这一指标,最佳闭源模型可完成约12小时的任务,而最佳开放模型约为7小时------闭源模型可完成任务的长度约为开放模型的1.7倍。
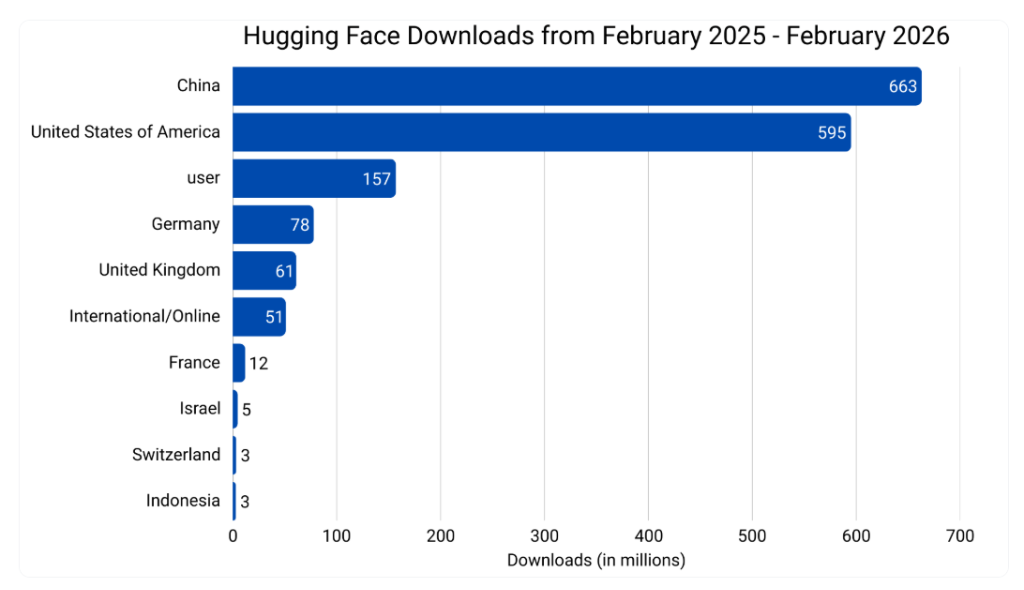
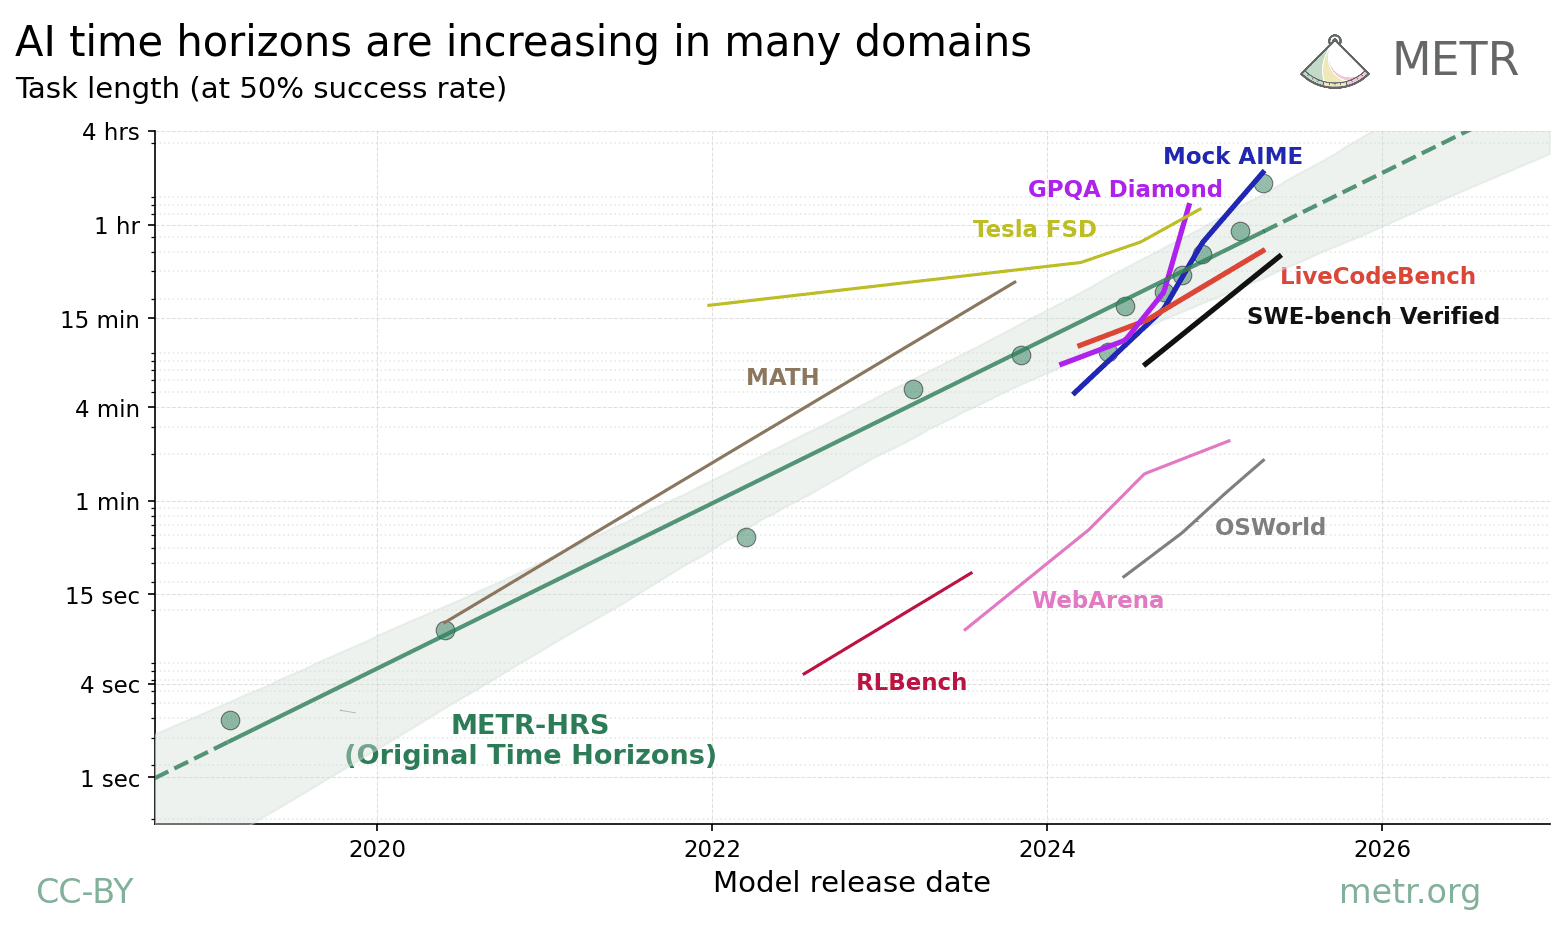
图2:METR时间horizon趋势------AI可自主完成的任务时长持续增长。来源:METR(CC-BY)
"时间差缩短"不等于"能力差距收窄"------如果开放模型只是在追赶闭源模型的上一代能力,那么绝对差距可能并未缩小,只是迭代节奏的错位在缩短。
在具体基准上,2026年7月月之暗面发布的Kimi K3在Frontend Code Arena前端代码测试中以1679分排名第一,超过Claude Fable 5和GPT-5.6 Sol。在Terminal Bench 2.1上,Kimi K3达到88.3分,与头名相差仅0.5分。但Frontend Code Arena是一个前端代码专项测试,不能代表模型在推理、长上下文、多模态、Agent等综合能力上的水平。
这些数据共同指向一个审慎的判断:开放权重模型已从闭源模型的"低配版"演变为全球AI能力供给中具有独立竞争价值的一极,但"一极"不等于"主导",其竞争力高度依赖于具体任务场景和成本约束条件。
三、多极化格局的地理分布:从基础模型供给到应用层扩散
面对中国开放权重模型的崛起,不同区域选择了截然不同的应对路径。在展开之前,需要先交代本章的框架分工:中国既是各区域应对行动的参照系,也是多极化格局中最重要的供给侧一极------但正因其规模优势已在第二章单独论述,本章3.1聚焦其他区域的四条供给侧路径,3.2转向需求侧的应用扩散。这些路径的差异,根植于各自的政治经济结构、产业禀赋和战略焦虑。同时明确两个分析概念:其一,"极"的判定标准是自主的基础模型训练能力与持续迭代能力------中东因其嫁接的规模与主权级投入列入供给侧,尚不具备自主迭代能力的东南亚则归入需求侧;其二,"需求侧"指以部署与适配为主要活动的生态位,而非不参与基础模型生产的区域------它同样可以主动建设制度基础设施,其边界甚至可被低成本跨越(详见3.2)。"多极化"的图景并非均匀分布:"极"与"应用场"两者共同塑造了2026年全球AI生态的实际面貌。
3.1 供给侧:四条基础模型路径
3.1.1 美国路径:重资本追赶,以"开放权重"争夺生态入口
美国在开放模型领域曾长期由Meta主导,但随着Llama系列迭代节奏放缓,前沿开放模型的重心在2025---2026年明显向中国倾斜。填补这一空白的,不是Meta,而是一批由前DeepMind和OpenAI研究人员创立的新兴公司。
Reflection AI是这一趋势的代表。这家由前Google DeepMind研究员创立的公司累计融资约47亿美元,并获得英伟达注资。其发布的Beam模型采用稀疏MoE架构,总参数5010亿、激活参数230亿,预训练使用了23.8万亿tokens,并在约1万块NVIDIA GB300 GPU上进行了为期4周的高算力强化学习训练。〔注6〕
Beam的定位值得注意:它将自己包装为"面向企业和公共部门的工作马模型",核心策略是允许机构基于Beam进行私有数据微调。在性能上,Reflection官方称Beam在编码和Agent任务中"与GLM-5.2竞争,并接近Qwen 3.8-Max",但在原始能力上Kimi K3仍然领先,Beam的优势在于推理效率。在可验证的基准上,Beam在DeepSWE v1.1上得分44.4,低于Kimi K3的68.0和DeepSeek V4.1 Flash的74.2;在Terminal Bench 2.1上得分为80.1,而Kimi K3为88.3,DeepSeek V4.1 Flash为90.6。
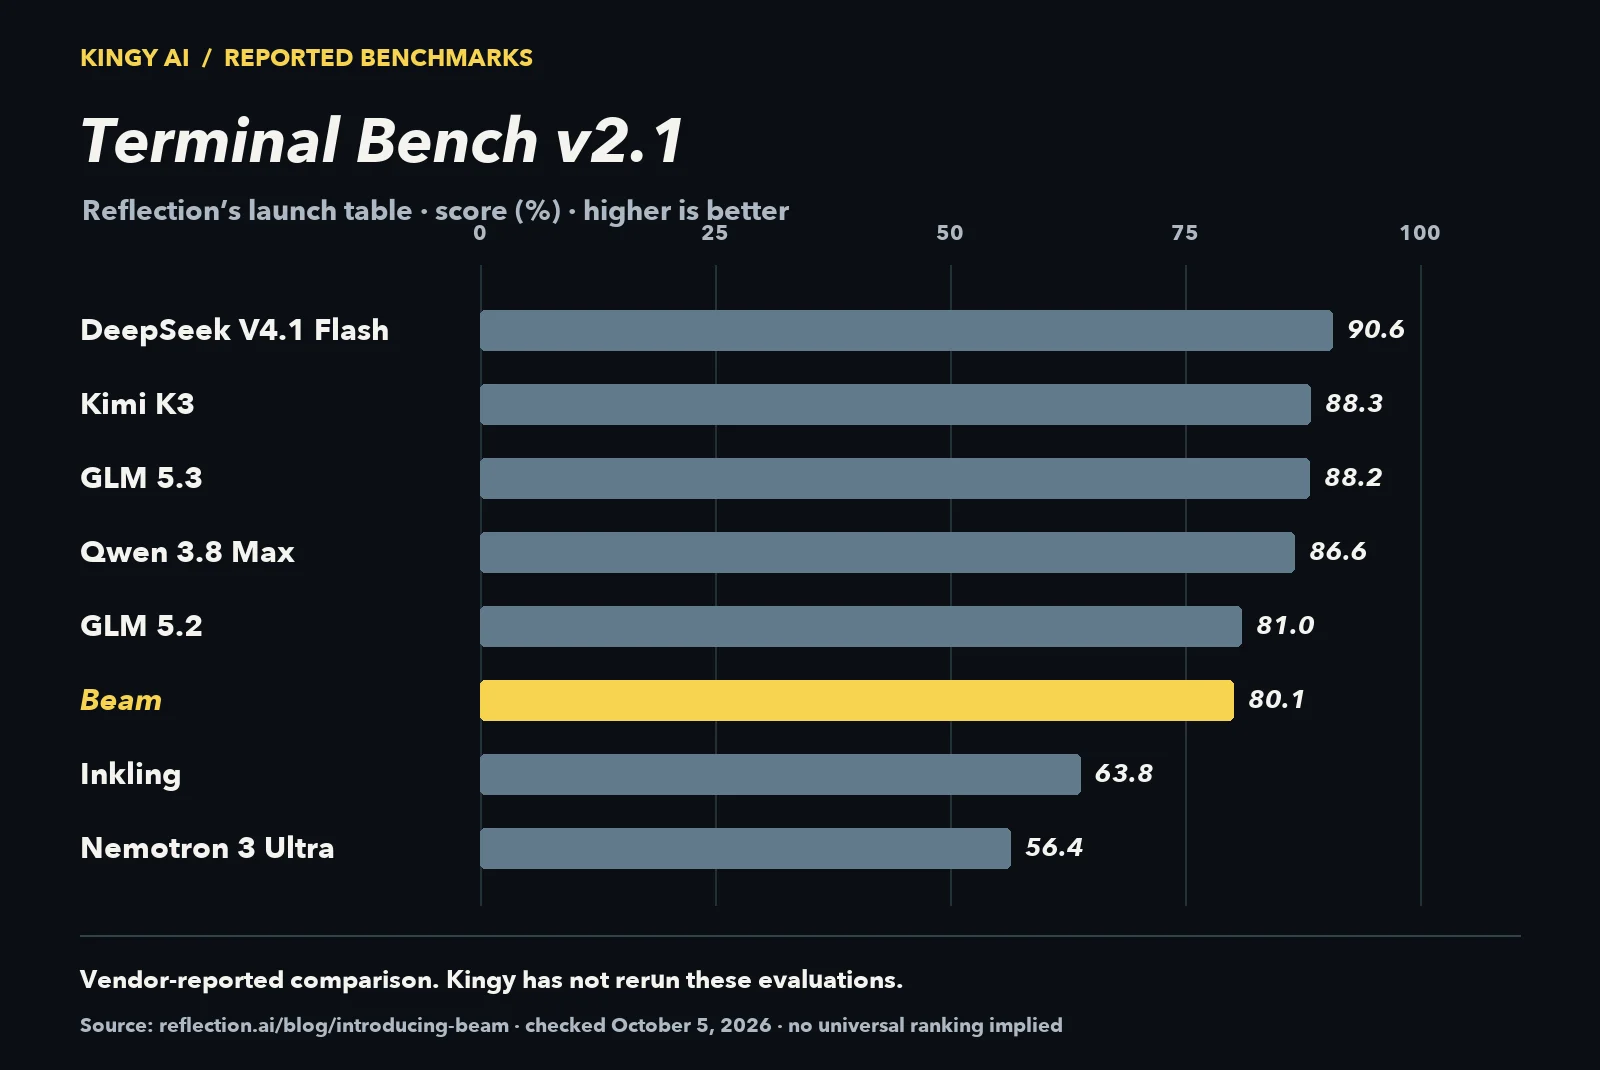
图3:Terminal Bench v2.1基准对比------Beam 80.1分,Kimi K3 88.3分,DeepSeek V4.1 Flash 90.6分。来源:Reflection官方发布数据,经Kingy AI整理
3.1.2 欧洲路径:以主权合规为壁垒,内部路线分化
欧洲的开放模型战略与美国截然不同。但需要注意的是,欧洲内部并非铁板一块------Mistral走的是规模竞赛路线,Aleph Alpha走的是细分合规路线,二者的驱动逻辑存在根本差异。
Mistral AI是欧洲规模路线的代表。2026年10月发布的Mistral Large 4是一个原生多模态MoE模型,总参数1.05万亿。激活参数存在两个官方口径:发布公告为每token激活490亿,其技术文档页则标注520亿------两页面同日上线且一度互不更正,两个数字的差异究竟源于何种口径,官方说明尚待确认。〔注10〕其上下文窗口官方标称100万token,而第三方评测平台记录的预览API实际值约为51.2万。技术文档页另给出16亿参数的视觉编码器(发布公告未提及该数字)。该模型覆盖160多种语言,从零开始在Mistral位于欧洲数据中心的3,800块NVIDIA Grace Blackwell GPU上训练完成。Mistral Large 4目前处于公开预览阶段,权重与许可证预计将在安全测试后发布------许可证的延迟公布本身即是一个信号:在最需要提供商用确定性的环节选择沉默,使其合规确定性暂时弱于Apache 2.0竞品,开发者在评估时应将"许可证状态"本身纳入考量。
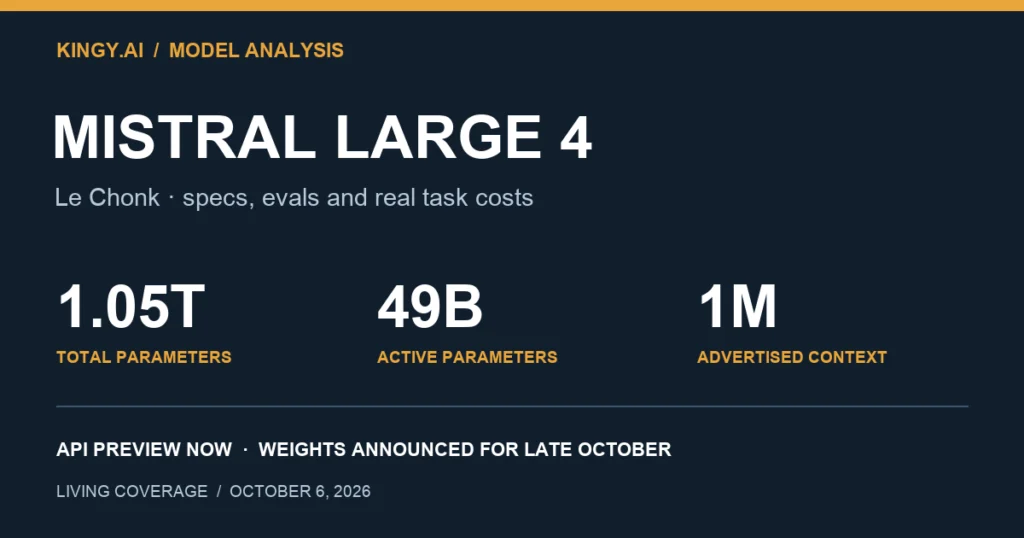
图4:Mistral Large 4(Le Chonk)核心规格------1.05万亿总参数、每token激活490亿(官方公告口径;文档页为520亿,口径差异官方说明待确认)、100万上下文(官方标称)。来源:Mistral官方发布,经Kingy AI整理
Aleph Alpha走的是另一条路。其于10月3日发布的Kolibri 1是一个781亿参数的MoE模型,每token仅激活约34.6亿参数(约4.4%的总参数),采用Apache 2.0许可证,在德国和芬兰的数据中心从零训练。Kolibri 1仅支持德语和英语,德语文本占其预训练数据的约23%。其核心卖点是合规与透明:所有训练数据经过超过450万个URL的屏蔽列表筛选,技术报告详细记录了版权、数据保护和欧盟AI法案合规措施。但值得注意的是,其训练代码并未随权重一同公开------Kolibri 1是"开放权重",而非OSAID意义上的"开源"。〔注9〕
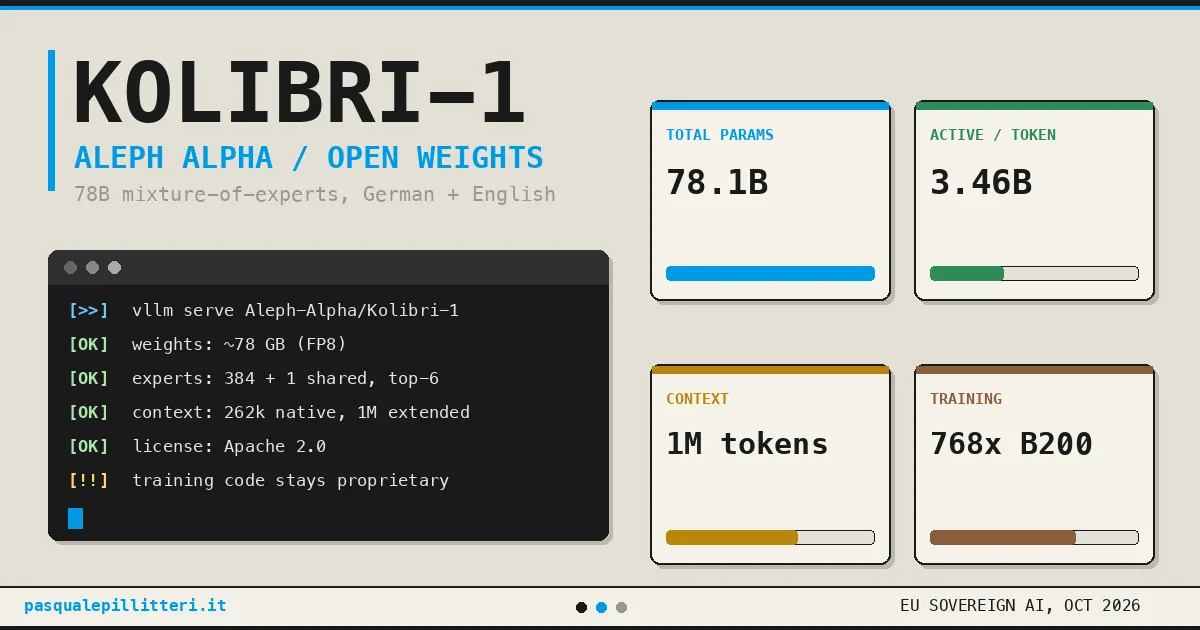
图5:Kolibri-1规格卡------78.1B总参、每token激活3.46B、1M上下文、Apache 2.0;训练代码未随权重公开。来源:Aleph Alpha官方资料,第三方整理
然而,欧洲路径的可持续性面临严峻挑战。2026年9月16日,Aleph Alpha宣布与加拿大Cohere签署最终业务合并协议(双方于同年4月首次披露合并意向),以构建"跨大西洋主权AI公司"。一家欧洲主权AI的代表公司与一家加拿大公司合并,这本身就动摇了"欧洲主权AI路径"的叙事根基。
3.1.3 中东路径:以主权资本嫁接开放基座,从权重走向全开源
中东的策略与前两者都不同。它不试图从头构建基础模型能力,而是利用资本优势和政治意愿,将全球领先的开放基座"嫁接"到本土需求上。
阿联酋在这一方向上走得最远。TII于2026年1月发布的Falcon-H1 Arabic采用混合Mamba-Transformer架构,提供3B、7B和34B三种规格。34B版本在Open Arabic LLM Leaderboard(OALL)上得分75.36%,超越了参数量两倍于它的两个对手(Meta Llama-3.3 70B与Qwen2.5 72B)------但不宜解读为全榜第一,可验证的更高分来自其他阿拉伯语专精模型。需要说明的是,OALL由TII自身发起并维护,该成绩宜解读为"在自家榜单上的领先",其含金量受评测方与受测方同一的利益关系影响。
MBZUAI于9月3日发布的K2 Horizon系列覆盖从0.9B到375B的六款模型,宣称"AI历史上最大的完全开源模型发布"(按参数量计)。旗舰模型375B-A23B采用稀疏MoE架构,每个token激活23B参数,支持512K上下文窗口。但"完全开源"的成色需要分层看待:小规格模型(0.9B/3.7B/7B)在发布当天开放了权重与训练代码,训练数据则分两种形式提供------可再分发的直接开放,无法再分发的提供详细构建方法;而旗舰375B及36B的中间checkpoint、训练数据与训练代码在发布时仍标注为"将发布"。尽管如此,在权重开放已成主流的市场上,愿意把训练流程摆上货架本身已构成差异。
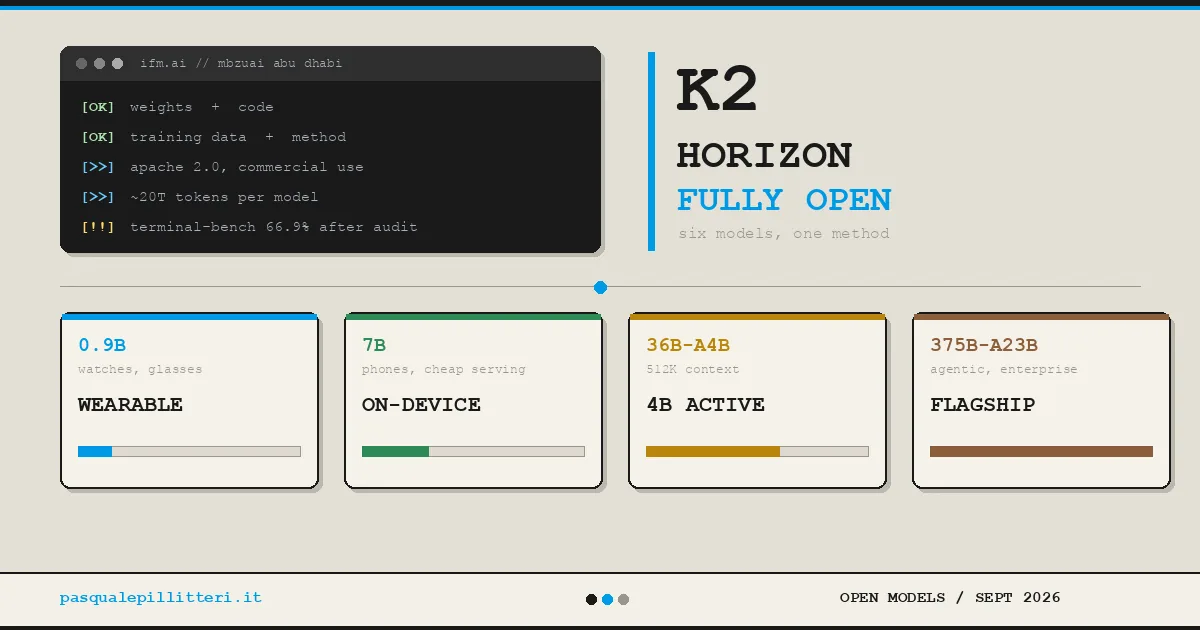
图6:K2 Horizon模型家族------六款模型覆盖0.9B到375B,Apache 2.0。来源:MBZUAI基础模型研究所(IFM)
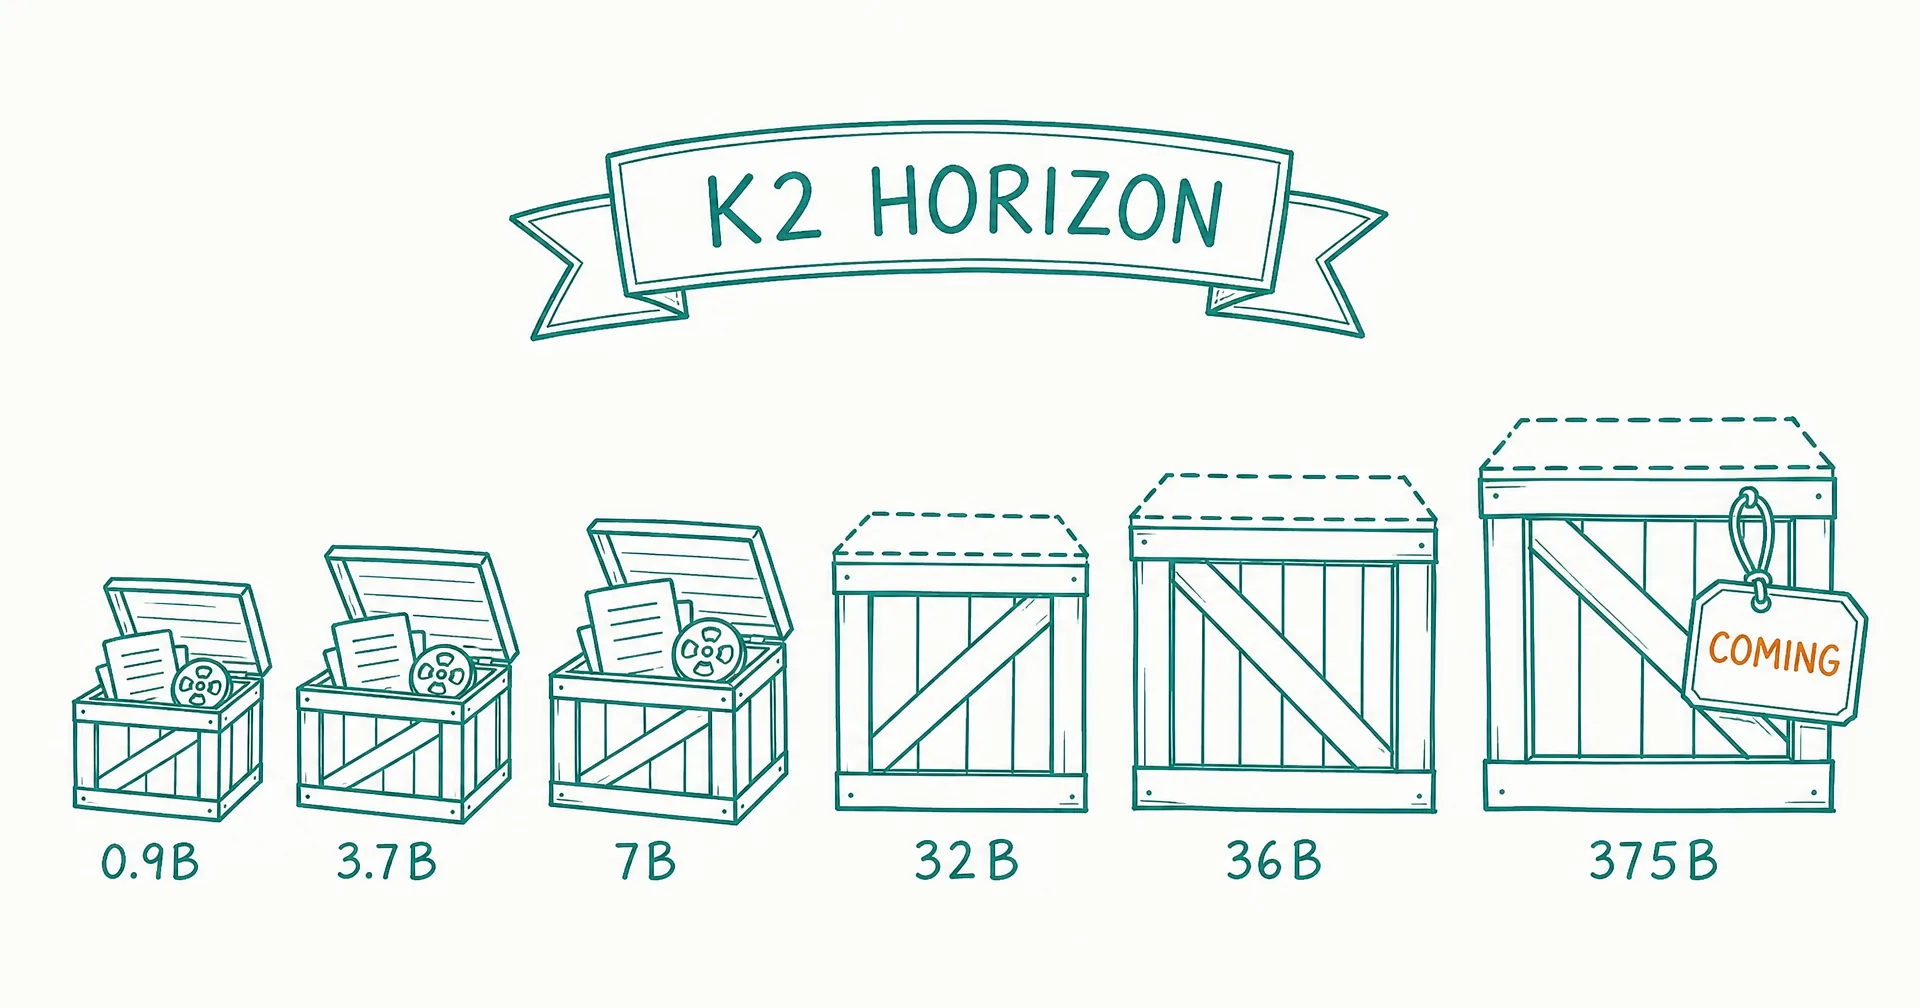
图7:K2 Horizon各规格开放程度对照------0.9B/3.7B/7B当天放齐权重与代码(训练数据分直接开放与构建方法两种形式),32B/36B/375B的部分工件仍为"将发布"。来源:CellCog分析
沙特则采取了另一种策略。HUMAIN基于中国MiniMax M3开放模型,使用超过1万亿阿拉伯语tokens进行后训练,推出了4280亿参数的阿拉伯语大模型HUMAIN M3。这标志着中国开放模型首次成为海外国家级AI项目的基础模型。但这一模式存在显著的脆弱性:HUMAIN M3的整个技术栈构建于中国开放模型之上。如果中国实施出口管制,或者沙特出于地缘政治考量转向其他基座,该模型将面临重构风险。
3.1.4 印度路径:国家算力支撑,从零构建本土开放模型
2026年,印度成为全球开放模型格局中不可忽视的一极。印度AI公司Sarvam在IndiaAI Mission的算力支持下,于2026年2月发布(3月以Apache 2.0协议开源)Sarvam 30B和Sarvam 105B两款MoE架构模型。
Sarvam 105B是一个约1050亿参数的模型,每个token激活约103亿参数,具有128K上下文窗口。训练完全在印度境内完成,使用IndiaAI Mission提供的算力------4,096张NVIDIA H100 SXM,由Yotta数据中心提供。据Sarvam官方白皮书,该模型"在所有评测维度上对比GPT-4赢得约90%的成对比较",官方博客另给出STEM、数学与编程维度84%的细分;评测采用LLM-as-judge协议(以Gemini 3为评判模型)。〔注7〕第三方评测整理还提及GPT-4o、Gemini 3、Llama 70B等对比对象,但白皮书可确认的主要对比对象为GPT-4。〔注11〕这反映的是特定评测协议下的比较胜率,而非全面的性能领先。
图8:Sarvam 30B/105B开源发布------"主权模型"路线。来源:Sarvam AI官方博客;架构细节见Hugging Face模型卡
印度的路径既非中国式的生态输出,也非美国式的重资本追赶,也非欧洲式的主权合规,而是"国家算力+本土数据+开放权重"的第三条道路。IndiaAI Mission提供了政府资金支持,Nvidia提供技术合作,Yotta提供数据中心基础设施。这种模式的核心特征在于:以政府投资解决算力瓶颈,以开放权重降低部署门槛,以本土语言数据构建差异化优势。
3.2 需求侧:全球南方的应用层扩散
如果说上述四条路径构成了"多极化"的供给侧,那么非洲和拉丁美洲则构成了"多极化"的需求侧------它们并不参与基础模型的"极"竞争,却是开放权重模型生态渗透最底层的验证场。
在非洲,肯尼亚的开发者正在将DeepSeek和Qwen应用于法律科技、商业智能、文档处理和编程等场景。乌干达的法律检索系统基于Qwen构建,为农民提供多种当地语言的信息服务。非洲开发者"几乎都选择了DeepSeek、Qwen和Kimi等中国平台",这一趋势的驱动力不仅是成本,更是开放权重模型在本地部署和微调上的灵活性------而这些围绕特定基座沉淀的微调脚本、教程与问答,正是下文结语所称"软性中心"的经验素材:它们降低了迁移的吸引力,却也为当地开发者构筑了真实的能力壁垒。
在拉丁美洲,一个更具警示性的案例是巴西里约热内卢市政府旗下IT公司IplanRIO于2026年6月发布的Rio 3.5 Open 397B。该模型宣称以Qwen 3.5 397B为基座完成了自研后训练,并在多项基准上超越Qwen 3.7 Plus。但发布次日,Nex-AGI即通过权重张量分析指认其为Nex-N2-Pro与Qwen3.5-397B按约0.6:0.4比例逐元素合并的产物,看不到任何独立训练的痕迹;IplanRIO随后公开致歉,承认上传的是"用于对比测试的合并基线版本",而非宣传中的最终自研版本。
这一插曲并未否定开放基座的赋能效应------一个市政IT团队确实能在有限资源下"组装"出基准分数可观的模型------但它揭示了应用层扩散的另一面:当衍生模型的署名、训练声明与合规审查缺位时,"基于开放权重"可能成为最低成本的营销话术。开放生态的活力与它的失序风险,是同一枚硬币的两面。它还提示了一个结构性问题:如果"需求侧"可以不经训练就产出"自研"模型,那么供给与需求的二分边界本身,就是可以被低成本跨越的。
3.2的经验材料印证了导语中的判断:需求侧的界定是生态位而非地理标签------Rio 3.5争议恰恰说明,"不参与基础模型生产"的旧式界定在开放权重时代已不再成立。全球南方构成了开放权重模型生态渗透的最底层验证:一个模型生态是否真正具有全球影响力,不仅看它在基准测试上排第几,更看它能否被资源有限的开发者用于解决本地问题------以及,当这种使用越界时,谁来执行规则。
东南亚的动向则说明,这个生态位正在向更复杂的方向演化。2025年11月,新加坡国家AI计划AISG宣布其SEA-LION项目放弃Meta Llama体系,转而以阿里Qwen3-32B为基座打造Qwen-SEA-LION v4,随后登顶SEA-HELM开源榜------一个国家级AI项目弃美投中,是开放基座全球渗透最有力的注脚之一。2026年,这一区域生态继续加密:SEA-LION v4.5(5月)加入agentic能力并以MIT许可发布,v4.8与英伟达合作推出该系列首个MoE架构;配套的SEA-Guard(2月)提供按区域文化校准的安全层,SEA-HELM则提供区域评测基准。周边国家的路径差异,折射出驱动因素的不同:印尼以超大消费互联网市场为引力,GoTo基于SEA-LION构建Sahabat-AI并接入Gojek与GoPay的语音助手;新加坡A*STAR的MERaLiON专攻Singlish语音,走的是国家科研能力路线;泰国SCB 10X的Typhoon依托金融集团深耕泰语,是产业资本驱动的垂直路线;越南VinAI则主要由数据驻留法规(第53号法令)塑造,是合规驱动的本地化------同样是"应用扩散",四种产业结构与监管环境给出了四种形态。东南亚的经验提示:需求侧的应用扩散并不必然依附于单一大国输出的"极"------它既可以嫁接中国基座,也可以生长出自己的区域能力,而区域评测基准与安全层的自建,正是对"制度性锁定"的一手回应。至于"第五极":按3.1节的供给侧定义,"极"的标准是自主的基础模型训练能力与持续迭代能力;以此衡量,东南亚当前更像"应用场+制度基础设施"的组合------它拥有区域评测基准、安全层与活跃的应用生态,但基础模型供给仍嫁接于他国基座。能否成极,取决于SEA-LION路线能否从"基于Qwen的再训练"生长出自主迭代能力------其衡量无外乎三点:下一代模型的发布节奏是否自主可控、训练算力是否不受制于单一供应方、技术路线能否摆脱对基座厂商更新的被动跟随。2026年尚不能下定论。
四、底层逻辑:四条路径与需求侧扩散的驱动力
四条路径的差异并非偶然,而是各自政治经济结构的必然产物。
美国路径的驱动力是"生态焦虑"。美国在闭源前沿模型上仍然领先,但在开放生态中,中国模型已在采用规模上形成主导------以下载量、衍生模型数量与调用量计,而非以能力指标计。当a16z合伙人观察到硅谷路演初创公司使用中国开放模型的概率约为80%时,这反映的是工程实践中成本与性能权衡的理性选择。Reflection AI和Thinking Machines Lab的出现,本质上是以风险资本和算力优势为杠杆,试图重新夺回开放生态的入口。英伟达向Reflection AI注资的战略意图也在于此:如果开放模型的默认基座变为中国模型,围绕这些模型构建的推理基础设施、工具链和商业生态都将与中国深度绑定。
欧洲路径的驱动力是"监管主权"。欧洲长期以来面临一个尴尬局面:它制定了全球最全面的AI监管框架,却在AI技术供给上严重依赖美国和中国的公司。Mistral和Aleph Alpha的模型发布,本质上是欧洲试图用"合规优势"来弥补"技术差距"的战略尝试。但Aleph Alpha与Cohere的合并表明,在规模竞赛面前,"合规优势"可能不足以支撑一家独立的基础模型公司。
中东路径的驱动力是"战略多元化"。海湾国家在AI领域的投入不仅是为了经济转型,更是为了在美中技术竞争中获得议价空间。通过同时与中国和美国的技术体系保持合作,中东国家避免了在任何一方的技术生态中被"锁定"。但K2 Horizon把训练流程摆上货架的尝试,又显示出一种超越"嫁接"的战略雄心:阿联酋正在从"应用开放基座"转向"参与定义开放标准"------即便这种定义目前仅部分兑现。
印度路径的驱动力是"数字公共基础设施的延伸"。印度在数字身份和支付系统上的成功为其AI战略提供了模板:以政府投资建设算力和数据基础设施,以开放权重降低私营部门的进入门槛。
全球南方应用扩散的驱动力是"部署灵活性优先于性能前沿"。对于非洲和拉美的开发者而言,模型是否在Frontend Code Arena上排名第一并不重要,重要的是它能否在本地部署、能否用本地语言微调、能否以可承受的成本运行。开放权重模型在这些维度上的优势,远比基准测试上的几个百分点更具实际意义。
五、深层趋势:边界消融与定义争夺
5.1 性能边界收窄的技术机制
开源与闭源的性能边界持续收窄,但技术机制需要更深入的分析。MoE架构的普及是这一趋势的关键技术驱动力。MoE通过稀疏专家路由,在不增加每token计算量的前提下扩大总参数量。Sarvam 105B每token仅激活约10.3B参数,Kolibri每token仅激活3.46B参数,这意味着推理时的实际计算量远小于总参数量所暗示的规模。此外,蒸馏技术的成熟使中小团队能够从大型模型中提取能力。开放模型与闭源模型差距缩小的部分原因,是训练门槛本身的下降,而非开放模型在绝对能力前沿上追平了闭源。
5.2 "开放"定义的争夺
2026年的重要变化是,"开放权重"与"开源"之间的区别正在从技术社区的讨论进入董事会和监管机构的视野。OSAID要求的三类工件------参数、代码、数据信息------中,绝大多数声称"开源"的模型只满足第一类。这种差异具有实质法律意义:Apache 2.0赋予完整的商用与再分发自由,而自定义许可的约束形式多样------Meta对Llama系列要求衍生模型以"Llama"命名并附带可接受使用政策;Mistral对部分规格采用限定非生产用途的研究许可;Qwen部分规格的自定义许可区分商用层级------据公开许可文本,月活超过1亿触发署名义务,经营MaaS等特定商用场景且收入超过阈值的企业需另行授权------此类条款对规模化商业部署构成实质约束,评估时应逐条核对各模型的当前许可文本。
5.3 地缘政治与开放AI的张力
中国开放模型的全球扩散已引发政策关注。据公开报道,中国商务部已与阿里巴巴、字节跳动和智谱等公司就限制训练模型的关键数据向海外传输、以及允许外国用户下载模型权重等问题进行了沟通,但中国仍将允许海外客户访问这些模型和服务。〔注8〕与此同时,中国在BRICS等多边场合倡导开源AI合作。
这两者之间的张力并非自相矛盾,而可能反映的是中国内部不同政策目标之间的博弈:如何在保持技术影响力和防止核心技术外泄之间取得平衡。
英伟达于2026年9月以约129亿美元收购Hugging Face,则从另一个方向揭示了开放AI基础设施的集中化趋势。英伟达在公告中承诺:Hugging Face将继续允许模型制作者、开发者和用户上传和下载他们选择的模型和数据集,并将继续支持其他芯片厂商的硬件接入。关于承诺的落地形态,公开报道存在冲突:有报道称相关承诺已写入提交SEC的交易文件,另有报道指出截至发稿尚无公开的SEC文件披露完整承诺条款------这一冲突有待公开文件确认。〔注12〕但无论如何,承诺的法律约束力不等于实际运营中的中立性------当平台的所有者同时也是最大算力供应商时,结构性利益冲突仍然存在。
六、闭源阵营的应对:维持差距的策略
第五章讨论了开放阵营内部的边界消融与地缘政治张力,但开放模型的追赶并非在真空中发生------如果只从开放模型一侧看问题,就会忽略一个关键变量:闭源前沿模型在2026年并非静止不动。
METR Time Horizon的数据依然显示,最强闭源模型可处理约12小时的人类专家任务,而最强开放权重模型约7小时。这一差距的缩小(约4.4个月)是在闭源模型本身也在快速迭代的前提下实现的。换言之,这4.4个月是"节奏差"而非"存量差":以当前约4个月的能力翻倍周期换算,它约相当于开放模型落后闭源前沿"一个身位";而1.7倍的存量差(12小时对7小时)能否消除,取决于开放模型的翻倍速度能否持续超过闭源前沿------目前双方节奏大体相当,尚无收敛的实质性证据。
闭源阵营的策略也在演化:从单纯的API服务,转向深度嵌入企业工作流、提供专属微调能力和合规保障。这些"非模型能力"的壁垒------工具集成、生态锁定、安全认证------可能比模型本身的性能差距更难被开放模型逾越。这也提示了一个与3.2节相呼应的结构性观察:闭源阵营的认证与安全审查机制,客观上扮演着开源生态目前缺失的"守门人"角色------Rio 3.5式的署名与来源争议之所以能在开源世界发生,与缺乏低成本、标准化的模型来源认证机制直接相关。但"守门人"不是无代价的:准入式审查与开放生态的互操作性天然冲突,若开源世界引入同等强度的守门机制,其开放性也将随之受损。一个未被充分讨论的可能性是:失序或许正是开放性的结构性代价,而非可以零成本修补的技术缺陷------本文结尾倡导的"最低限度规则"能否成立,恰恰取决于署名与来源认证能否以信息披露义务(而非准入许可)的方式运作。
七、结语:多极化的稳定性与制度性锁定
2026年的全球开放模型格局,呈现出清晰的层次结构。在供给侧,美国以重资本和算力优势追赶,欧洲以主权合规和专业化深耕,中东以资本嫁接和全栈开放快速崛起,印度以国家算力支撑从零构建,而中国以规模效应和生态渗透保持领先。在需求侧,非洲和拉美以开放权重模型为基座,进行着最活跃也最具风险的应用层创新。
但"多极化"本身是一个需要解释的问题,而非一个需要描述的事实。历史上,技术生态(操作系统、移动平台)往往收敛为少数主导者。AI开放生态为何可能不同?
一个关键差异在于:模型权重可以被无限复制和本地部署,不存在操作系统那样的"网络效应锁定"。更根本的是权重的不可撤回性:API服务可以被提供方单方面关闭或提价,而已发布的权重无法被收回------Meta不能收回Llama,任何一极都无法通过"关停"惩罚迁移者。但这一属性有其反面:安全风险同样不可撤回------一个被证实存在严重漏洞的开放权重模型无法被"召回",这正是闭源阵营安全论证的核心,也是欧盟AI法案对高风险系统不提供开源豁免的逻辑所在:开放生态的稳定性与安全责任之间存在一笔结构性的交换。对受监管行业而言,这笔交换是具体的------开放权重在审计与责任追溯上天然处于劣势,主权部署与私有微调(Beam、Kolibri的核心卖点)只能部分对冲:在数据敏感而威胁模型相对静态的场景(政务文书、内部检索),对冲接近充分;在威胁模型持续演化、安全修复依赖上游更新的场景,对冲有限------评估的分界线是:漏洞修复是否依赖提供方的持续更新。当然,"权重可无限复制"并不等于"能力可零成本迁移":微调适配、评测验证与工具链重建都是实打实的成本,这正是前文权衡框架将"生态依赖"列为核心维度的原因。这些成本是迁移任何模型都要付出的工程摩擦,其量级随生态成熟度而异------从一个拥有丰富微调工具与社区支持的成熟生态迁出,与接入一个新兴模型,摩擦并不对称:头部开源基座积累的并非"租",而是"引力"------它不阻止你迁走,而是持续降低迁走的吸引力。引力与锁定的区别不在效果,而在可竞争性:引力是开放竞争的产物,任何一极都可以通过建设社区来积累它,它也不排斥用户同时使用多个基座;锁定则是排他的结构位置,其收益来自排除竞争本身。但引力有自我强化的风险:当头部生态强到使挑战者无法积累最初一批采用者时,引力就转化为事实标准------分析上的临界点,在于新进入者还能否获得最小规模的社区,可观察的指标是:挑战者发布后的90天内,是否出现非官方资助的第三方微调脚本、独立评测与问答沉淀(而非仅有发布方的宣传物料;该窗口为经验性设定,应随案例积累校准)。还有一点值得注意:开放权重时代的多归属(multi-homing)成本远低于闭源API时代------用户可以同时部署Qwen与Beam而不必二选一,这显著削弱了"赢者通吃"的线性风险------但多归属的低成本不等于多归属的对称性:在两个基座上投入同等工程努力的"有效成本"仍因工具链成熟度而异,这决定的是引力自我强化的速度,而非其有无。"事实标准"更可能以"默认首选"而非"唯一选择"的形态出现。最后,需求侧的规模效应正在放大这种引力:当数以百万计开发者的教程、微调脚本与问答社区围绕少数头部模型构建时,"默认基座"本身即是一种事实上的锁定------多极化并不意味着无中心,而是存在多个被持续争夺的中心。持久锁定只能来自模型之外------制度、认证与生态。
在展开制度分析之前,需要先界定两个概念:本文所称的"稳定性",指没有任何一极能主导或消灭其他极;"碎片化",指极之间互操作性的丧失。两者可以分离------碎片化的生态里,各极反而因互不替代而更"稳定",但代价是组合与切换自由的丧失。因此判断多极化是否健康,核心变量是多归属成本:当用户能以低成本同时使用多个基座时,多极化是稳定且有效率的;当多归属被制度或技术抬高时,稳定就退化为碎片化。之所以以多归属成本为"健康"的判准,是因为AI模型的价值高度依赖组合与再组合------ensemble、路由、微调生态与工具链的跨基座复用------多归属成本度量的正是组合自由的剩余。另一股力量是制度性锁定。技术生态的收敛不仅来自网络效应和算力集中,还来自标准、认证和监管互认:欧盟AI法案的合规认证抬高了模型进入受监管行业的文档与评估成本;出口管制直接决定权重与算力的可获取性;数据出境规则塑造的则是"持续服务"而非"获取"------其约束对象并非本就未公开的开源训练数据,而是基座厂商与海外伙伴的联合训练、云端微调服务与持续的后训练更新。三者的作用域不同------合规认证作用于"使用"环节,出口管制作用于"获取"环节,数据出境规则作用于"持续服务"环节------且呈串联关系:任一环节被切断,其余环节的努力便失去落点。做一个简单的场景检验:若某国对权重实施出口管制但允许数据出境,而另一区域同时收紧合规要求,那么"获取"环节的断裂会使合规成本失去作用对象,但已持有权重的存量用户与第三国镜像仍使"使用"环节部分有效------这正是串联而非严格相乘的含义。同样不确定的还有开放权重本身的可获取性:一旦模型出口管制从"讨论"走向"落地","中国基座"能否继续作为全球南方开发者的默认选项,将取决于制度而非技术。出口管制具有双重效应:它既可能加速生态的碎片化,也可能反向充当"多极化加速器"------其他区域被迫发展替代基座,极的数量反而增加。但就本文的稳定性标准而言,决定性的不是极的数量,而是极之间能否保持互操作与权重的可获取------若替代基座各自封闭,"极的增加"非但不是多极化的胜利,反而是碎片化的加速。如果每个主要区域都发展出独立的合规认证体系和技术标准,那么"多极化"将不再是开放生态的特征,而是碎片化生态的委婉说法。判断这一临界点是否逼近,可以观察三个信号:各区域的合规认证结果是否开始互认;权重下载是否出现区域性阻断;以及头部模型的衍生生态是否按阵营分化------当微调模型、教程与评测都开始以阵营为界时,互操作已名存实亡。需要说明的是,三个信号齐备是互操作恶化的必要而非充分条件------反向力量同样存在:开源社区的自组织揭发、跨区域的微调协作,以及商业上互认可免除重复合规成本的动力,都可能延缓甚至逆转这一过程。回头以互操作性这一标准检验第三节的经验材料:中东"嫁接"路径对互操作性的依赖最高------其技术栈本就建立在他国基座之上;印度以Apache 2.0主动降低互操作门槛;欧洲的合规差异化是互操作的最大变量;而东南亚自建评测基准(SEA-HELM)与安全层(SEA-Guard),若其认证结果最终只在本区域内被承认,则可能成为第一批按阵营划界的信号。
对于开发者、企业和政府而言,在Qwen、Llama、Mistral、Falcon、Sarvam等模型之间做选择,需要一个可操作的权衡框架:
| 维度 | 关键问题 | 优先级建议 |
|---|---|---|
| 能力匹配 | 模型在核心任务上的基准表现是否满足需求? | 核心任务优先,避免为"通用能力"支付溢价 |
| 许可证 | 是否允许商用?是否有限制条款? | 法务合规先行,Apache 2.0与自定义许可差异显著 |
| 透明度 | 是否提供训练代码和数据信息? | 需要复现或审计的场景优先 |
| 数据主权 | 训练数据来源是否可控?是否满足GDPR/欧盟AI法案? | 受监管行业优先 |
| 生态依赖 | 对上游基座的持续依赖程度如何?迁移成本多高? | 长期战略优先 |
| 地缘风险 | 基座提供方所在国的政策稳定性如何? | 政府、国防、关键基础设施场景优先 |
开源运动最初的理想是技术无国界、知识共享。2026年的现实是,开放权重模型已成为国家间技术竞争的重要工具和战略资产。这不是开源理想的失败,而是它成功的代价:当开放模型的能力强大到足以支撑一个国家的AI基础设施时,它就不可避免地成为地缘政治的一部分。
如何在"技术主权"和"开放合作"之间找到可持续的制度设计,将是未来数年全球AI治理面临的核心命题。这一问题没有简单的答案,但历史经验至少提供了几个可检验的方向:Apache基金会与Linux基金会的多利益相关方中立治理,证明竞争性企业可以在共享基础设施上共处;Mozilla的公共利益使命则说明使命型治理可以约束平台的中立性。这些模式能否移植到AI,取决于一个关键差异:模型权重、训练数据与评测基准构成的工件组合远比源代码复杂,纯基金会模式难以覆盖训练数据的治理。较可行的路径或许是"最低限度规则+互认":以权重不可撤回性为既成事实,建立覆盖署名义务、来源认证与评测互认的底线规则,再让竞争在底线之上展开。署名与来源认证可直接回应当前的真实痛点(Rio 3.5式争议),其"强制"不必来自诉讼------模型卡披露正从社区惯例升级为平台规则与监管要求的交集(Hugging Face对模型卡字段的规范、欧盟AI法案对技术文档的要求,构成了准强制的底座)------平台规则的执行力受替代品稀缺约束:当发布方是某语言唯一的高质量模型提供者时,下架威胁的可信度下降,这正是监管要求作为第二层底座的必要性所在。披露真实性的验证可由三层分工覆盖:发布方自填模型卡,平台抽检与权重谱系技术验证(如Rio事件中的逐张量比对)负责录入真实性,社区检测负责异常报告,监管处置负责追责。社区检测的自组织力量亦可被制度放大:Nex-AGI对Rio 3.5的揭发证明开放生态的透明度使伪装难以长期存续,基准运营方与云服务商若在评测准入与部署环节引用来源认证结果,这种揭发就不必依赖个别社区的技术能力。评测互认则可依托现有的区域基准网络------欧盟的评估生态、中东的阿拉伯语榜单、新加坡的SEA-HELM------通过交叉承认避免认证各自为政。如果这种制度设计不存在,我们面对的又将是怎样一种碎片化的AI未来?
创作不易,禁止抄袭,转载请附上原文标题及其链接
附注
注1:Qwen累计下载量与衍生模型数出自公开报道(2026年8月)
注2:德朗格关于中国开源领先地位的表态有公开报道支持
注3:OpenRouter周调用量的具体数值(如"57.46万亿tokens")量级异常庞大,仅保留方向性表述。
注4:a16z合伙人Martin Casado的"80%"为2025年下半年的个人观察,属概率估计。
注5:METR早期翻倍周期约7个月;2024---2025年已加速至约4个月(Time Horizon 1.1,2026年1月)。
注6:Reflection AI融资额、训练细节出自公司官方博客与发布材料。
注7:数据出自Sarvam官方博客(2026年3月6日)及其自建基准;该基准采用LLM-as-judge协议(Gemini 3为评判模型),结论的普适性受评测设计影响。
注8:关于中国商务部与企业沟通的详细报道详细可见FT中文网等原始出处。
注9:关于Kolibri-1训练代码是否公开,二手报道口径不一(有报道称"未作为开源发布",亦有报道称"已随模型发布")。本文采用"权重开放、训练代码未随附"的保守表述,建议以Aleph Alpha官方仓库的实际公布内容为准。
注10:Mistral激活参数490亿(官方公告)与520亿(技术文档页)两口径并存;本文不再转引未经证实的口径解释,差异说明以官方文档最终版本为准。
注11:Sarvam对比模型清单(GPT-4o、Gemini 3、Llama 70B)出自第三方评测整理,未在Sarvam官方可检索页面中完整列出。
注12:关于英伟达承诺是否已写入SEC文件,公开报道相互冲突------chinaaet.cn报道称"已写入SEC文件,具有法律约束力",Yahoo Finance则指出"英伟达未在8-K中披露具有约束力的治理承诺";本文在正文呈现冲突本身,最终以SEC公开文件为准。