AI Agent 上生产前先加三道闸门:审批、限权、可回放的工程实践
关于"模型说执行就执行"的争论,其实很少停留在模型层。真正把团队拦在生产环境门外的,是这样一个问题:当 Agent 的一次工具调用产生不可逆副作用时,系统能不能在毫秒级拦住它、让人介入、并在三天后完整复现当时发生了什么。这不是提示词工程问题,而是运行时的可控性工程问题。近期社区里"先加三道闸门再碰真实业务"的提法引起了不少讨论 1,本文在此基础上向后端纵深推进:把审批做成可持久化的状态机,把限权落到工具治理的实处,把第三道闸门升级为可重放的 Harness。
一、Demo 能跑,与能上生产之间的距离
1.1 一次失控调用的典型链路
先看一个合成的示意场景,它不是真实事故,但结构上接近团队最常见的失控路径:
业务人员输入:"把 A 仓的超储部分调拨到 B 仓。"
Agent 规划后选择工具
create_stock_transfer,构造参数时把数量字段理解为"整仓全量",同时漏掉了目标仓的容量校验参数,直接提交了一张调拨单。
把这条链路拆开,失控通常发生在四段:
| 阶段 | 发生了什么 | 失控的表现 | 缺失的约束 |
|---|---|---|---|
| 意图理解 | 自然语言转成任务目标 | 目标被放大或曲解 | 意图澄清、确认 |
| 工具选择 | 从工具集中挑一个 | 选中语义相近但危险的工具 | 工具风险分级 |
| 参数构造 | 填写调用参数 | 字段含义错配、范围越界 | 参数校验、权限收窄 |
| 副作用执行 | 调用下游系统 | 不可逆写入已完成 | 审批、可回滚、留痕 |
注意,四段里只有一段是"模型能力"问题,另外三段都是工程问题。指望通过更强的模型、更精细的提示词消除后三段风险,在工程上不成立:模型输出本质上是概率性的,而生产系统要求的是确定性边界。可控性工程的思路,正是把确定性约束放在运行时,而不是放在模型的"自觉"上。
1.2 三道闸门分别解决什么
本文所说的三道闸门是一个工程化提法,不是行业标准术语,但它们各自对应一类明确的失效模式:
- 审批(决策授权):解决"该不该做"。在有风险的动作执行前中断,把决策权交给人或策略引擎,而不是交给模型。
- 限权(能力边界):解决"能做什么"。即使用错工具、参数错配,也只能在被允许的范围内造成影响。
- 可回放(行为可追可复现):解决"事后怎么说清"。让每一次运行都能被审计、被复现、被用于回归评估。
三者缺一不可,且互相不能替代。只有审批没有限权,审批者面对的是海量高危请求,最终变成无脑点"同意";有限权没有审批,不可逆动作仍然会以合法权限被执行;两者都有但无法回放,出事之后既不能定位根因,也不能证明系统当时的行为符合规则。
1.3 适用边界与阅读路线
本文聚焦运行时工程约束,不覆盖提示注入的系统化治理、模型越狱防御、训练侧安全对齐等主题;这些是另一条战线,与本文措施互补。代码示例均为结构示意的伪代码,具体 API 需以所用框架的官方文档为准。
| 章节 | 主要闸门 | 可直接取用的产出 |
|---|---|---|
| 第二章 | 审批 | 风险分级矩阵、审批状态机、持久化要点 |
| 第三章 | 限权 | 权限收窄维度、MCP 坑位清单、运行时硬约束 |
| 第四章 | 可回放 | 事件日志 schema、回放边界 |
| 第五、六章 | 三者串联 | 端到端时序、Checklist、实施路径 |
二、闸门一:把审批做成状态机,而不是弹窗
2.1 哪些动作必须审批:风险分级矩阵
审批不是所有调用都要走,否则系统会被拖死。判断依据主要是三个维度:可逆性 (能否撤销)、影响面 (影响单条记录还是全局)、敏感度(是否涉及资金、合规、对外触达)。
以开源项目 double-ai-agent_1 的业务域为参照:该项目基于 Spring AI Alibaba Graph 构建,涵盖自然语言驱动的 BI 查询与智能库存调拨,并宣称支持 RAG、人工审批与图状态持久化 3。其中两类工具的风险等级显然不同:
| 工具 | 动作类型 | 可逆性 | 影响面 | 风险级 | 策略 |
|---|---|---|---|---|---|
query_bi_metrics |
只读查询 | 完全可逆 | 单一数据域 | 低 | 自动放行,仅留痕 |
create_stock_transfer |
业务单据写入 | 流程内可撤销,但已触发下游作业则代价高 | 跨仓、跨部门 | 中高 | 强制人工审批 |
send_notification_external |
对外触达 | 不可逆 | 外部客户 | 高 | 双人审批 + 限额 |
一个可复用的空白模板如下,建议在工具注册时就强制填写,未填写的工具默认最高风险级:
yaml
# 配置示意,字段为设计建议,非任何框架的原生格式
tool: create_stock_transfer
risk_level: high            # low / medium / high / critical
reversible: partial
impact_scope: cross_domain  # single_record / single_domain / cross_domain / global
approval_policy:
  required: true
  approvers: 1              # 或 2 表示双人复核
  sla_minutes: 30
  on_timeout: reject        # 超时默认拒绝,优于默认放行
param_constraints:
  max_quantity: 5000
  allowed_warehouses: ["A", "B", "C"]
rollback:
method: compensating_order # 补偿式撤销,而非假装删除这里有一个容易被忽略的取舍:审批粒度 。工具级审批实现简单但粗糙,参数级审批精准但实现和体验成本高,业务单据级审批最贴近组织流程但需要与单据系统集成。实践中常见做法是工具级定策略、参数级做校验、单据级做留痕,三层叠加。double-ai-agent_1 的实际审批粒度究竟落在哪一层,需要读源码确认,仓库描述本身不能作为实现细节的证据 3。
2.2 中断-等待-恢复:审批的运行时模型
审批的本质是一次长事务:Agent 执行到高危动作前挂起,把执行上下文序列化,等待外部决策,再从断点恢复。它必须处理的状态迁移至少包括:批准、驳回、超时、改参重试。
text
运行中 ──触发高危工具──> 待审批 ──批准──> 运行中
                          │
                          ├──驳回──────> 终止(或回退到上一步重新规划)
                          ├──超时──────> 终止(默认拒绝)
                          └──改参重试──> 运行中(生成新 step_id,保留原请求记录)
对应的骨架逻辑(结构示意):
python
# 伪代码:展示状态迁移骨架,不对应任何具体 SDK
async def run_step(ctx, action):
    policy = policy_engine.evaluate(action)
    if policy.level >= RISK_MEDIUM:
        checkpoint = persist.save(
            run_id=ctx.run_id,
            step_id=ctx.step_id,
            snapshot=ctx.snapshot(),      # 含计划、中间变量、工具候选
            pending_action=action,
        )
        decision = approval_bus.wait(checkpoint.id, timeout=policy.sla)
        if decision.kind == "rejected":
            return terminate(ctx, reason=decision.reason)
        if decision.kind == "timeout":
            return terminate(ctx, reason="approval_timeout")
        if decision.kind == "edited":
            action = decision.action        # 改参后重新校验,而不是直接放行
            policy = policy_engine.evaluate(action)
        ctx.restore(checkpoint.id)
    return tool_executor.execute(action)   # 仍需经过限权层,见第三章
四个容易踩空的点:
- 审批不是授权的终点。改参后的动作必须重新过策略引擎,否则"改参"就成了绕过审批的后门。
- 超时默认应为拒绝。默认放行会在审批人力不足时把风险全部释放到生产。
- 并发互不阻塞。多次运行、同一运行的多个待审批点应各自独立,不应互相排队。
- 驳回要有语义。"驳回并终止"与"驳回并重新规划"是不同策略,需按动作类型区分。
关于 Spring AI Alibaba Graph 是否提供官方的中断、人工介入与恢复 API,本次研究材料不足以给出确切结论;double-ai-agent_1 声称具备人工审批与图状态持久化能力 3,但具体 API 形态需以框架官方文档和仓库源码为准。若框架不提供原生支持,采用上述自研 checkpoint 模式是可行路径,代价是要自己解决序列化、幂等与恢复语义。
2.3 状态持久化:进程重启后审批还有效
如果审批状态只存在于内存里,服务一次发布就会丢掉所有待办,用户看到的是"调用凭空消失"。持久化设计至少要回答三件事:
- 存什么:执行快照(计划、上下文摘要、待执行动作)+ 决策记录(谁、何时、批准/驳回/改参、理由)。
- 幂等键怎么设计 :
run_id + step_id + action_hash,保证同一动作重复提交不会生成多张审批单。 - 恢复语义:重启后从最近快照恢复到断点,已执行的副作用不得重放,这要求工具调用本身也带幂等键。
一个可行的事件与快照组合是:审批单与决策记录用关系型数据库落表(便于查询与权限控制),执行过程用事件日志追加(见第四章)。double-ai-agent_1 把"图状态持久化"列为其企业级能力之一 3,可作为参照实现的方向,但其是否只存快照、是否含事件流、崩溃恢复语义如何,需要核对源码后才能判断。
2.4 审批体验的工程细节
审批系统最常见的失败不是技术失败,而是审批疲劳。要让人真正判断,审批单必须包含:调用工具名、参数差异(相对系统建议值或上一版本)、预期副作用、影响对象数量、回滚方式与成本、该动作的历史批准/驳回统计。
降低疲劳的手段包括:低风险动作按策略自动放行并事后抽查、同类批量请求合并审批、设置 SLA 超时告警、对反复驳回的任务类型直接降低 Agent 的自主级别。审批率与驳回率应作为持续指标观察:驳回率过低往往意味着审批者在无脑批准,而不是 Agent 越来越准。
三、闸门二:最小权限与 MCP 的真实坑位
3.1 工具即权限:按数据域 × 动作 × 环境收窄
"给模型全部工具,然后用提示词约束它不要乱用"是可控性工程里的第一反模式。提示词是概率性的,工具集是确定性的;把安全边界放在概率性的一侧,等于没有边界。正确的做法是在注册层就做裁剪:模型看到的工具集,本来就只是它被允许使用的那一部分。
收窄的三个维度:
| 维度 | 取值示例 | 收窄方式 |
|---|---|---|
| 数据域 | 订单 / 库存 / 财务 / 用户 | 按租户与角色绑定可见工具 |
| 动作类型 | 读 / 写 / 对外触达 | 写与触达类单独注册、单独审批 |
| 环境 | dev / staging / prod | 生产工具集最小化,禁止跨环境混用 |
yaml
# 工具集组装示意,需替换为实际框架的注册写法
contexts:
  - name: inventory_agent_prod
    tenant: tenant_a
    allowed_tools:
      - query_bi_metrics        # 只读
      - create_stock_transfer   # 写入,强制审批
    denied_tools:
      - drop_table
      - send_notification_external
    network_egress:
      allow: ["erp.internal.example"]
另外,凭据不应随工具描述暴露给模型。正确形态是:Agent 只拿到工具句柄,真实凭据由执行侧在调用时注入,且按会话隔离、可轮换、可吊销。
3.2 MCP 接入的真实坑位清单
MCP 解决的是"模型如何发现和调用工具",不解决"工具该不该被调用"。从"能连上"到"生产可用",社区实践反馈中反复出现的问题包括以下几类 26:
| 坑位 | 表现 | 应对 |
|---|---|---|
| 工具描述歧义 | 语义相近的工具被误选 | 描述中写明边界与副作用;风险级标注 |
| 工具数量爆炸 | 上下文被工具 schema 填满,成本与误选率上升 | 按场景动态裁剪工具集,分层注册 |
| schema 与实际行为不一致 | 声称只读,实际触发写入 | 契约测试;执行侧二次校验 |
| 鉴权凭据传递 | 会话间串用、无法轮换 | 执行侧注入、按会话隔离、短时效 |
| 长会话与服务重启 | 连接断开、工具结果丢失、无法恢复 | 重连策略 + 事件落盘(见第四章) |
| 工具结果超长 | 返回被截断后模型基于残缺信息继续决策 | 摘要与原文分存,关键字段强制校验 |
| 多 Server 版本漂移 | 同名工具在不同环境下行为不同 | 版本锁定 + 环境隔离 + 变更审计 |
需要说明的是:上表是根据社区讨论与实践文章归纳的候选清单 26,其中具体条目与归因仍建议对照 MCP 官方规范逐条核实,本次研究材料未提供规范原文链接,本文不对其版本号与条款细节作断言。社区文章的单点经验也不能当作普遍结论 7。
3.3 运行时硬约束:沙箱、出网与审计
权限收窄之外,还有一类约束必须在运行时硬性执行,任何提示词都不应能绕过:
- 命令执行沙箱:涉及 shell 或代码执行的工具运行在隔离容器中,限制文件系统写入范围与 CPU/内存配额。
- 出网白名单:Agent 的网络出口默认拒绝,仅放行业务必要域名,防止数据外带。
- 工具调用强制入审计:无论成功、失败还是被拦截,都留下记录。没有记录的拦截等于没有拦截。
- 资源配额:单次运行的工具调用次数、总 token 消耗、执行时长设上限,超限即中断。多智能体编排中尤其需要轮次上限,避免子任务互相驱动而无限扩张 68。
有团队在数月落地实践中总结过类似经验:权限与隔离问题往往比模型效果问题更早爆发 7。这也解释了为什么限权应当排在效果调优之前。
四、闸门三:可重放的 Harness
4.1 为什么要回放:三种诉求,三种保真度
"可回放"经常被简化成"有日志",但三类诉求对保真度的要求并不相同:
| 诉求 | 需要什么 | 保真度要求 |
|---|---|---|
| 排障 | 完整执行过程、每步输入输出 | 高,要能还原分支与中间状态 |
| 回归评估 | 可比对的输入输出对 | 中,重点是可重复执行同一用例 |
| 合规审计 | 不可篡改的决策留痕 | 高,且要求完整性与时间顺序可验证 |
Harness 的概念正在从"测试脚手架"演变为运行时基础设施:它负责驱动 Agent 循环、管理状态、记录事件,并支持从任意断点恢复。SmartAI/ava 将自己描述为面向 Python 的"durable、replayable 的编码智能体 Harness" 4,CSDN 上关于 hermes-agent 的文章也把 Harness 作为框架组件单独讨论 5。这两个来源印证了"Harness 正在成为独立关注点"这一趋势,但其内部录制格式、恢复语义与成熟度需要阅读源码或文档后才能判断,本文不依据标题推断实现细节。
4.2 Harness 里到底录什么
一次运行至少要记录以下事件,才能支撑上述三类诉求:
json
{
  "schema_version": "1",
  "run_id": "run_20260318_ab12",
  "step_id": "step_007",
  "event_type": "tool_call",
  "ts": "2026-03-18T10:21:33.412Z",
  "actor": "agent:inventory_bot",
  "payload": {
    "tool": "create_stock_transfer",
    "params_digest": "sha256:...",
    "risk_level": "high",
    "policy_decision": "require_approval",
    "approval_id": "apr_9f31"
  },
  "env": {"app_version": "1.8.2", "model": "recorded", "mcp_server_versions": {"erp": "2.3.0"}}
}字段清单为设计建议,不代表任何现有框架的格式。要点有三个:run_id / step_id 串联全链路 ;payload 存摘要,原文进对象存储并以哈希关联 ,避免日志库爆炸;环境信息必须记录,包括应用版本、模型标识、各 MCP Server 版本,否则换一次依赖就无法复现。
此外,审批决策点必须作为事件记录,而不是只留在审批系统的界面上。审计要回答的问题是"当时系统为什么允许这个动作",这需要决策依据与执行动作在同一时间线上。
4.3 事件日志与状态快照的组合
只存最终结果无法排障,只存事件流在长链路里恢复成本高。实践中的取舍通常是:事件日志追加写,快照定期存。
| 方案 | 优点 | 代价 | 适用 |
|---|---|---|---|
| 仅结果 | 成本最低 | 无法复盘 | 不推荐用于生产 |
| 仅事件流 | 完整可追 | 长链路恢复需重放全量 | 短链路、低频任务 |
| 事件流 + 快照 | 恢复快、可追溯 | 双写一致性要处理 | 多数生产场景 |
一致性上的稳妥做法是:快照只记录"已确认完成的 step 边界",任何进行中的步骤都不进快照,恢复时从最近快照加后续事件重建。
4.4 确定性回放的边界
必须明确一点:回放验证的是编排、权限与工具链路,不是模型能力。LLM 输出存在随机性,同一输入两次调用可能得到不同计划。要做到可重放,录制模式下需要把不确定性来源全部固定:
- 模型原始请求与响应全文录制,重放时直接使用录制结果,不再调用模型;
- 时间、随机数、外部服务响应在录制模式下一并捕获,重放时替换真实调用;
- 工具执行分两类:纯函数型可真正重跑,有副作用型在重放中以录制结果代替,并显式标注"模拟执行"。
这里有一条红线:回放时绝不能修改录制数据来"让测试通过"。一旦允许编辑录制内容,回放就从验证手段退化成了自我安慰。录制数据应只读、可校验哈希、与原始执行环境的版本信息绑定。
五、端到端走查:一次库存调拨如何穿过三道闸门
沿用前文的示例场景(示例,非真实实现),把整条链路串起来:
text
用户输入:"把 A 仓超储部分调拨到 B 仓"
   │
   ├─ 1. 意图澄清:确认品种、数量口径、目标仓
   ├─ 2. 规划:生成计划,选取工具 create_stock_transfer
   ├─ 3. 限权检查:工具在该租户工具集内?参数通过数量与仓别校验?
   │        └─ 不通过 → 拦截并记录事件,结束
   ├─ 4. 风险判定:high → 触发审批
   │        ├─ 保存 checkpoint(快照 + 待执行动作)
   │        ├─ 挂起,进入待审批
   │        └─ 批准 → 恢复;驳回 → 终止;超时 → 拒绝
   ├─ 5. 执行:调用下游系统,携带幂等键
   ├─ 6. 落盘:工具调用、结果、审批决策写入事件日志
   └─ 7. 可回放:任意时间可从事件与快照重建本次运行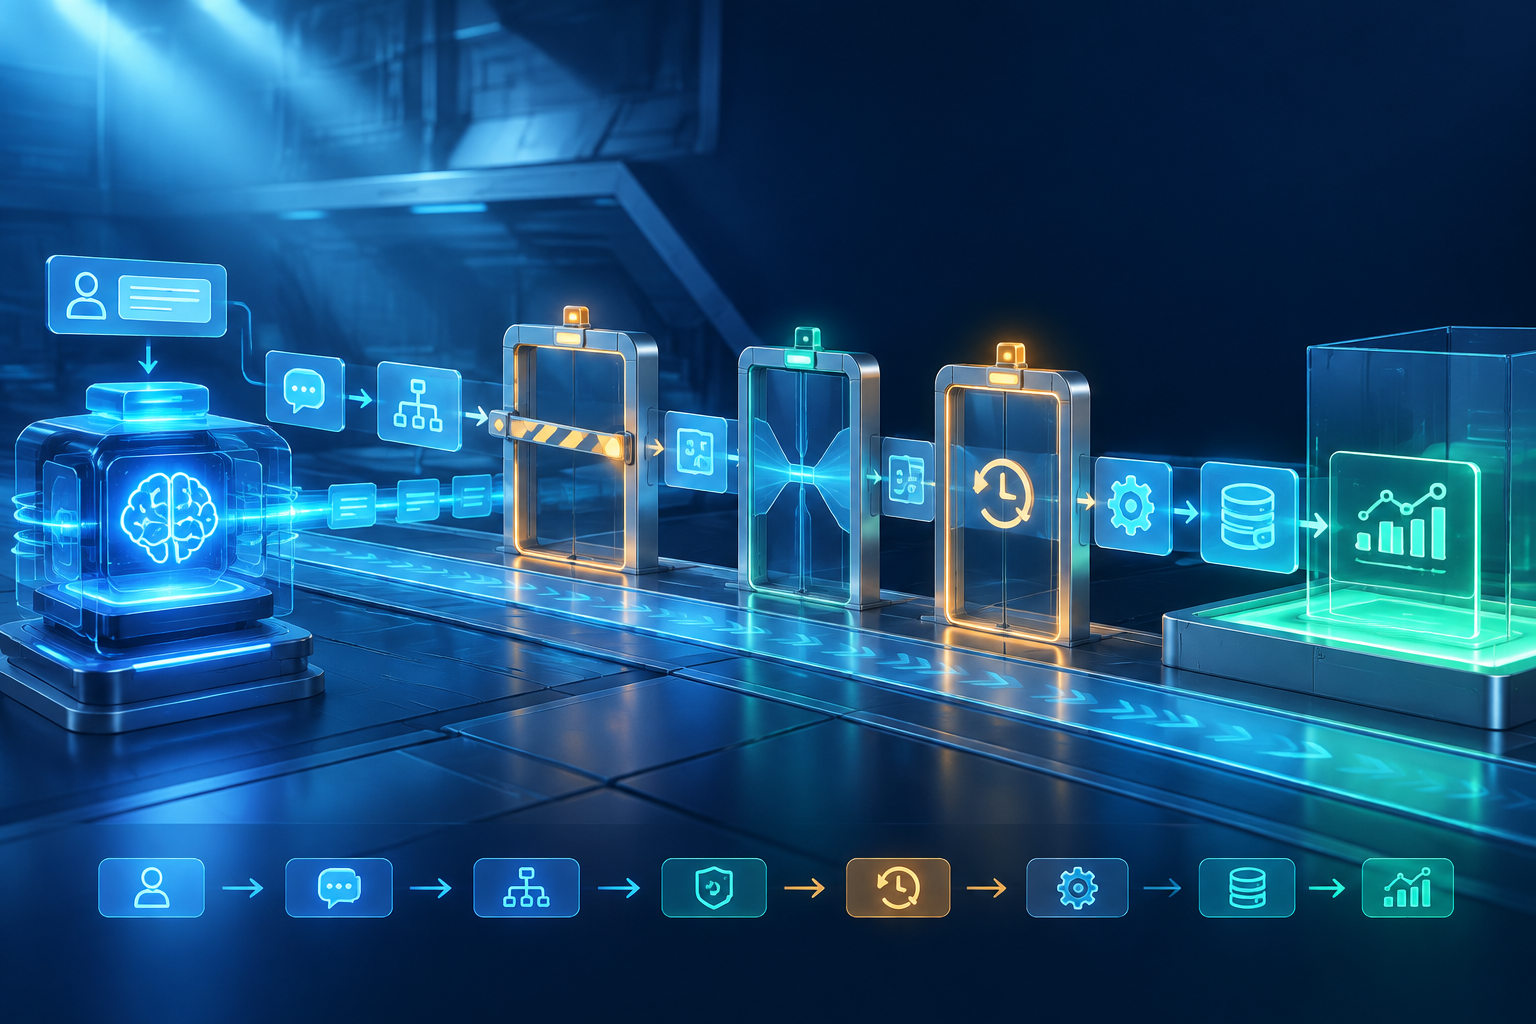
配置层面建议"先严后松":生产环境初期对中高风险动作全部强制审批,灰度稳定后按动作类型逐步放开低风险自动放行;权限白名单只增不减需要经过变更评审,所有配置变更本身也要入审计。上线后重点观测的指标:
| 指标 | 观察意义 | 建议关注点(非行业基准) |
|---|---|---|
| 待审批平均时长 | 审批是否成为瓶颈 | 持续接近 SLA 需扩容审批人力或下调自主级别 |
| 审批驳回率 | 计划质量与风险识别 | 长期接近零需警惕无脑批准 |
| 工具调用拦截率 | 权限与参数校验是否生效 | 突然归零可能意味着校验被绕过 |
| 回放成功率 | 留痕完整性 | 低于预期优先检查事件丢失 |
| 异常恢复次数 | 状态机健壮性 | 频繁恢复需检查外部依赖稳定性 |
阈值应由各团队按自身业务风险设定,本文不提供通用基准值。
六、上线清单与反模式
6.1 上线前 Checklist
审批
- 所有工具已标注风险等级,未标注者默认最高级
- 中高风险动作的审批策略已配置,超时默认拒绝
- 审批单包含参数摘要、预期副作用与回滚方式
- 改参后动作会重新过策略引擎
限权
- 工具集按租户、角色、环境裁剪,生产工具集最小化
- 凭据由执行侧注入,按会话隔离,支持轮换与吊销
- 命令执行有沙箱,网络出口默认拒绝并有白名单
- 工具调用(含被拦截的)全部进入审计日志
- 单次运行的调用次数、时长、消耗设上限
可回放
- 事件日志含 run_id / step_id / 环境版本信息
- 审批决策作为事件记录,与执行动作同时间线
- 录制模式固定模型响应、时间、随机数与外部响应
- 录制数据只读、可校验,禁止为通过测试而修改
观测
- 待审批时长、驳回率、拦截率、回放成功率有看板与告警
- 配置与权限变更本身有审计记录
6.2 常见反模式
- 审批疲劳:所有调用都审批,最终人人无脑批准。应按风险分级,把人力留给高风险动作。
- 权限一刀切后偷偷开白名单:临时豁免没有记录、没有到期时间,等于长期漏洞。
- 只存结果不存过程:出问题只能看到"失败了",看不到"为什么失败"。
- 把审批做成前端弹窗:进程重启即丢状态,审批记录与执行动作对不上账。
- 回放时修改录制数据:验证机制失效,且掩盖了真实缺陷。
- 把提示词当权限:任何"请不要调用 X 工具"都不构成安全边界。
6.3 分阶段实施路径
资源有限时,建议顺序是审计留痕 → 权限收窄 → 审批状态机 → 可重放 Harness。理由是:留痕成本最低、收益立刻可见,且是后续所有工作的数据基础;权限收窄直接削减爆炸半径;审批状态机依赖前两者的策略与事件能力;完整 Harness 的投入最大,但能同时服务排障、回归与合规。
每阶段的"够了"标准:留痕阶段能回答"过去 24 小时 Agent 调用了哪些工具";限权阶段能在测试中证明越权调用被拦截;审批阶段能演示进程重启后审批单仍可恢复并继续执行;Harness 阶节能对任一历史运行重放并给出与录制一致的行为序列。
七、结语
三道闸门的共同本质,是把模型的自由度关进运行时的确定性约束里。模型负责提出方案,系统负责决定方案能不能执行、执行到什么范围、事后如何还原。这不是对模型能力的不信任,而是工程系统的基本要求:任何产生真实副作用的组件,无论它内部是规则引擎还是神经网络,都必须服从同样的授权、边界与审计规则。
值得强调的是,本文的技术判断基于公开的社区文章与仓库描述,其中不少实现细节尚未逐条核对源码与官方规范 23456。把这些当作方向性参考,落到自己的系统前先做验证,本身就是可控性工程的一部分。
参考资料
1 前端开发者做 Agent:模型说执行就执行?先加 3 道闸门再碰真实业务,掘金。https://juejin.cn/post/7636280185700990986
2 热榜都在吹 MCP Skills 万能,我搭了个 AI Agent 才发现最大的坑不是 Skill,掘金。https://juejin.cn/post/7605807405308051519
3 豆芽/double-ai-agent_1:企业级双引擎 AI 智能体(Spring AI Alibaba Graph,RAG、人工审批、图状态持久化),Gitee。https://gitee.com/mitouhao/double-ai-agent_1
4 SmartAI/ava:A durable, replayable coding-agent harness for Python,GitHub。https://github.com/SmartAI/ava
5 【Agent】构建 Harness | hermes-agent 框架组件,CSDN。https://blog.csdn.net/qq_35812205/article/details/160281584
6 2026年AI Agent开发实战:MCP协议深度解析与多智能体协作架构完全指南,掘金。https://juejin.cn/post/7628131346834063410
7 从 3 个月 AI Agent 落地实战,聊透我踩过的坑和摸到的门道,掘金。https://juejin.cn/post/7601034810313130038
8 AI Agent 工作流编排:用 Subagent 实现复杂任务分解,掘金。https://juejin.cn/post/7616650313060155443
注:本次研究资料未提供 MCP 官方规范原文链接,文中涉及规范版本、能力协商与鉴权机制的内容未作具体断言,建议实施时另行对照官方文档核实;上述来源多为社区文章与仓库描述,其中的实现细节需以源码与官方文档为准。