目录
-
- 一、为什么先看「怎么找代码」
- [二、路线一:预建索引 + 语义检索](#二、路线一:预建索引 + 语义检索)
- [三、路线二:Agent 实时搜索](#三、路线二:Agent 实时搜索)
- [四、路线三:代码知识图谱(以 WES Code 的 CKG 为例)](#四、路线三:代码知识图谱(以 WES Code 的 CKG 为例))
- 五、三条路线放在一起看
- 六、按场景怎么选
- 七、我自己是怎么分工的
- 小结
网上的 AI 编程工具横评,比的大多是模型、价格和补全速度。
这些当然重要,但在几万行以上的真实项目里,决定体验的往往是另一件事:工具怎么找到这次该看的代码。模型再强,拿到的上下文不对,答案也对不了。
这篇不给工具打分。我按「怎么理解代码库」把主流工具分成三条技术路线,讲清每条路线擅长什么、短板在哪,最后给一份按场景的选型思路。涉及各家工具的说法,都以官方文档和团队公开的分享为准。
一、为什么先看「怎么找代码」
上下文窗口越来越大,但依然装不下一个真实项目。装得越多,越贵、越慢,模型的注意力也会被稀释。所以每个工具都得解决同一个问题:从几万个文件里,挑出这次该看的那几十个。
挑法不同,结果差别很大。比如这个问题:
改
CreateOrder的函数签名,会影响哪些地方?
它要的不是「和 CreateOrder 长得像的代码」,而是「所有调用了它的地方」,而且一个都不能漏。不同的找法,在这类问题上的表现差距最明显。
目前主流的找法,可以归成三条路线:
| 路线 | 怎么找代码 | 代表 |
|---|---|---|
| 预建索引 + 语义检索 | 提前把代码切块、算成向量,提问时按语义相似度召回 | Cursor、GitHub Copilot、Trae |
| Agent 实时搜索 | 不建索引,模型自己一轮轮 glob、grep、读文件 | Claude Code |
| 代码知识图谱 | 提前解析语法树,建出符号和调用关系图,按关系取代码 | WES Code 的 CKG、Aider 的 repo map |
需要先说明一点:现在的工具基本都是混合的。Cursor 的 Agent 在语义检索之外也大量用 grep,Copilot 没有索引时也会退回文本搜索。表里写的是各自最有代表性的那条路线,第五节会再说混合的问题。
二、路线一:预建索引 + 语义检索
怎么做的
打开项目时,工具把代码按函数、类这样的语法单元切成块,每块用 embedding 模型算成一个向量,存进向量库。提问时,把问题也转成向量,找出最相近的一批代码块放进上下文。
写成代码,流程大概是这样(示意,不是哪一家的真实实现):
python
chunks = split_by_syntax(repo)                       # 按函数、类切块
index.add([embed(c.text) for c in chunks], chunks)   # 每块算一个向量,存进向量库

query = embed("谁调用了 ChargeCard?")
hits = index.search(query, top_k=20)                 # 取和问题最像的 20 块
注意最后一行:返回的是和问题「最像」的 20 块代码,不是「所有相关」的代码。这一点决定了它的长处,也决定了它的短处。
各家的公开说法
- Cursor:官方文档写明会为代码计算 embedding。官方博客提到,代码按语法切块,用 Merkle 树判断哪些文件变了、只重算变化的部分;文件路径加密后才发到服务端,代码内容不以明文存储。它的 Agent 同时大量使用 grep,官方的说法是两者结合效果最好。
- GitHub Copilot:维护一份语义代码搜索索引。托管在 GitHub 上的仓库由 GitHub 远程建索引,其他仓库由 Copilot 另外建语义索引。没有索引时,Agent 用文本搜索、grep 等工具照样能工作。
- Trae :为工作区构建代码索引,5000 个文件以内打开项目时自动建,更大的项目要手动建;用
#Workspace、#Folder提问时,从索引里召回相关内容。官方文档没有公开具体算法,从用法看属于预建索引这一类。
擅长什么
用自然语言描述的模糊问题。「登录失败之后的重试逻辑在哪」,不知道函数名也能找到;命名不统一的老项目里,这一点尤其有用。
短板
- 相似不等于相关。 向量衡量的是「长得像不像」,不是「有没有调用关系」。问「谁调用了
ChargeCard」,排在前面的往往是它的定义和名字相近的函数;调用方里真正相关的可能只有一行return ChargeCard(amount),未必排得进前 20。至于通过接口间接调用它的函数,代码里压根没有 ChargeCard 这个词,更难被召回。 - 召回是前 N 条,漏了你不知道。 查个大概没问题,做影响面分析时这一点最要命。
- 索引需要同步。 各家都做了增量更新,但刚改完代码、刚切完分支,总有一个时间差。
- 要留意索引存在哪里。 有的在服务端(加密存储),有的在本地。对合规要求严格的团队,这是选型时要问清楚的一项。
三、路线二:Agent 实时搜索
怎么做的
不提前建任何索引。模型像工程师一样,先用 glob 按文件名找、再用 grep 搜关键词、打开文件读,看到线索再搜下一轮,直到觉得信息够了。
代表:Claude Code
它的负责人 Boris Cherny 在访谈里讲过这段取舍:早期版本用过 RAG,也试过本地向量库,最后发现模型驱动的 glob + grep 效果最好,而且好出一大截;另外两个原因是索引会和代码不同步,以及索引放在哪儿本身就是安全问题。现在它也可以接入 LSP(语言服务),做跳转定义、查找引用。
擅长什么
- 零准备,打开就能用,读到的永远是磁盘上的最新代码。
- 函数名、报错信息这类精确字符串,搜得又快又准。
- 灵活:可以顺手跑测试、看命令输出,边查边验证。
短板
- 慢,而且费 token。 每一轮搜索结果都会进上下文,一个问题搜五六轮很常见。
- 依赖命名。 grep 搜的是字符串。通过接口调用、依赖注入进来的实现、同名但不同义的函数,要么漏掉,要么搜出一堆无关结果。
- 大项目里容易搜不全。 结果太多会被截断,或者模型搜到一部分就停了,而你不知道它停在了哪里。
实测:用 grep 找调用方
用一个很小的示例项目看得更清楚。项目里有 4 个文件:
go
// payment/card.go
func ChargeCard(amount int) error { return nil }

// payment/tx.go
func CreateTransaction(amount int) error { return ChargeCard(amount) }

// payment/retry.go
func RetryPayment(amount int) error {
	var err error
	for i := 0; i < 3; i++ {
		if err = ChargeCard(amount); err == nil {
			return nil
		}
	}
	return err
}

// order/service.go
type Charger interface{ Charge(amount int) error }

type CardCharger struct{}

func (CardCharger) Charge(amount int) error { return payment.ChargeCard(amount) }

func PlaceOrder(c Charger, amount int) error { return c.Charge(amount) }问题是:改 ChargeCard 的行为,哪些函数会受影响? 答案是 4 个:CreateTransaction、RetryPayment、CardCharger.Charge,以及通过 Charger 接口间接调用它的 PlaceOrder。
grep 的结果:
bash
$ grep -rn 'ChargeCard(' demo
demo/order/service.go:9:func (CardCharger) Charge(amount int) error { return payment.ChargeCard(amount) }
demo/payment/card.go:3:func ChargeCard(amount int) error { return nil }
demo/payment/retry.go:6:		if err = ChargeCard(amount); err == nil {
demo/payment/tx.go:3:func CreateTransaction(amount int) error { return ChargeCard(amount) }
直接调用的 3 处都找到了,但函数定义那一行也混了进来;PlaceOrder 则完全没出现,因为它的代码里根本没有 ChargeCard 这个词。要找到它,Agent 得先意识到 CardCharger 实现了 Charger 接口,再去搜谁调用了 .Charge(。真实项目里叫 Charge 的方法可能有几十个,多出来的搜索轮数和无关结果就是这么来的。
四、路线三:代码知识图谱(以 WES Code 的 CKG 为例)
怎么做的
用解析器(比如 tree-sitter)把每个文件解析成语法树,提取出函数、方法、类型这些符号,再把它们之间的关系解析出来:谁调用谁、谁实现了哪个接口、谁覆盖了哪个方法。整个项目就变成一张图,点是符号,边是关系。提问时按关系取代码,而不是按相似度。
这条路线也不是哪一家独有的。开源的 Aider 用 tree-sitter 提取各文件里的定义和引用,按文件之间的引用关系排序,挑出最重要的函数签名组成 repo map 放进上下文;Sourcegraph 的精确代码导航(跳转定义、查找引用)建立在 SCIP 索引之上。
我日常用的就是 WES Code,下面看看它的 CKG(Code Knowledge Graph)具体是怎么做的。以下细节来自它的官方文档。
CKG 的图是怎么建出来的
建图一共 10 道工序(文档里叫 10-Pass):
- 文件发现
- 语法树解析(tree-sitter)
- 符号提取
- 调用边提取
- 跨文件边解析
- 歧义消解
- 影响面分析
- 孤儿函数检测
- 全文索引(SQLite FTS5)
- 统计聚合
前 6 道是把图建出来,后 4 道是在图上做分析,顺带建一份全文索引。改了一个文件时,只重新提取这个文件的符号和调用边,再更新跨文件关系和全文索引,不用整个项目重建。索引存在本机的工作区目录里,可以随时删掉重建。
有个细节我觉得值得一提:解析调用关系时,它不猜。
比如 svc.Save() 这样一个调用,先按「类型.方法」精确匹配;对不上,再按包路径匹配;还对不上,只有全项目恰好只有一个同名符号时才连上这条边。有多个候选,就标记为「未解析」,而不是随便挑一个。宁可少一条边,也不连错一条边。
动手:不到 80 行 Go 代码提取调用关系
上面第 2~4 道工序(解析语法树、提取符号、提取调用边)听起来抽象,其实用 Go 标准库就能写一个最简版本。下面这段代码只依赖 go/parser 和 go/ast,把目录下每个函数调用了谁都记下来,再反查「谁调用了 X」:
go
// callgraph.go:只用标准库,从语法树里提取「谁调用了谁」
package main

import (
	"fmt"
	"go/ast"
	"go/parser"
	"go/token"
	"os"
	"path/filepath"
	"sort"
	"strings"
)

func main() {
	root, target := os.Args[1], os.Args[2] // 用法:go run callgraph.go ./demo ChargeCard
	fset := token.NewFileSet()
	callers := map[string][]string{} // 被调用的名字 → 调用方列表

	filepath.Walk(root, func(path string, info os.FileInfo, err error) error {
		if err != nil || !strings.HasSuffix(path, ".go") {
			return nil
		}
		file, err := parser.ParseFile(fset, path, nil, 0)
		if err != nil {
			return nil
		}
		for _, decl := range file.Decls {
			fn, ok := decl.(*ast.FuncDecl)
			if !ok || fn.Body == nil {
				continue
			}
			caller := file.Name.Name + "." + funcName(fn)
			ast.Inspect(fn.Body, func(n ast.Node) bool {
				if call, ok := n.(*ast.CallExpr); ok {
					pos := fset.Position(call.Pos())
					site := fmt.Sprintf("%s (%s:%d)", caller, filepath.Base(pos.Filename), pos.Line)
					callers[calleeName(call.Fun)] = append(callers[calleeName(call.Fun)], site)
				}
				return true
			})
		}
		return nil
	})

	list := callers[target]
	sort.Strings(list)
	fmt.Printf("%s ← 被以下函数调用:\n", target)
	for _, c := range list {
		fmt.Println("  ", c)
	}
}

// funcName 返回函数名;方法带上接收者类型,比如 CardCharger.Charge
func funcName(fn *ast.FuncDecl) string {
	if fn.Recv == nil || len(fn.Recv.List) == 0 {
		return fn.Name.Name
	}
	t := fn.Recv.List[0].Type
	if star, ok := t.(*ast.StarExpr); ok {
		t = star.X
	}
	if id, ok := t.(*ast.Ident); ok {
		return id.Name + "." + fn.Name.Name
	}
	return fn.Name.Name
}

// calleeName 只取被调用的名字:payment.ChargeCard(...) → ChargeCard,c.Charge(...) → Charge
func calleeName(expr ast.Expr) string {
	switch f := expr.(type) {
	case *ast.Ident:
		return f.Name
	case *ast.SelectorExpr:
		return f.Sel.Name
	}
	return ""
}
对第三节的示例项目跑一下:
bash
$ go run callgraph.go ./demo ChargeCard
ChargeCard ← 被以下函数调用:
   order.CardCharger.Charge (service.go:9)
   payment.CreateTransaction (tx.go:3)
   payment.RetryPayment (retry.go:6)
和 grep 相比,结果是按「函数」列出来的,定义那一行也不会混进来。但 PlaceOrder 还是没有,单独查 Charge 才能看到它:
bash
$ go run callgraph.go ./demo Charge
Charge ← 被以下函数调用:
   order.PlaceOrder (service.go:11)
问题在于,这个小程序只认名字。它知道 PlaceOrder 调了一个叫 Charge 的方法,却不知道 c 是 Charger 接口、CardCharger 实现了这个接口;如果项目里还有别的类型也有 Charge 方法,它们会被混在一起。
这个小程序缺的,正是真实的图谱要多做的那几道工序:
- 跨文件边解析 :知道
payment.ChargeCard指的是哪个包里的哪个函数; - 歧义消解:同名的函数不混在一起,实在分不清的就标成未解析;
- 接口实现关系 :知道
CardCharger实现了Charger,PlaceOrder → Charger.Charge → CardCharger.Charge → ChargeCard这条链才连得起来。
WES Code 的 CKG 用 IMPLEMENTS(接口实现)和 OVERRIDES(方法覆盖)两类边来处理这种多态调用,同名分不清的情况交给「歧义消解」那道工序。
能回答哪些问题
按关系查询,最典型的是这几类(示例):
谁调用了这个函数:
text
chargeCard ← 被以下函数调用:
├── createTransaction   (internal/payment/tx.go:45)
├── retryPayment        (internal/payment/retry.go:23)
└── processRefund       (internal/payment/refund.go:67)
改了它,最终会影响哪些接口: 沿调用图一路往上,追到入口函数为止。
text
chargeCard
  ← createTransaction
    ← ProcessOrder
      ← HandleOrderAPI     (POST /api/orders)
      ← HandleBatchImport  (POST /api/orders/batch)
  ← retryPayment
    ← HandleRetryPayment   (POST /api/payments/retry)
  ← processRefund
    ← HandleRefundAPI      (POST /api/refunds)
改签名的影响范围: 直接调用者、间接调用者、受波及的包、需要重跑的测试。
哪些函数没人调用: 可能是死代码,也可能只是通过反射调用。文档里专门提醒了,后一种要人工确认。
这些分析结果(当前文件的调用链、影响面、相关符号)会被组装进 AI 的上下文。也就是说,AI 拿到的是按关系挑出来的代码,而不是按相似度挑出来的。在编辑器里,悬停在函数上能看到调用者数量,函数定义上方有调用统计,项目概览里有一张可以点开的调用图。
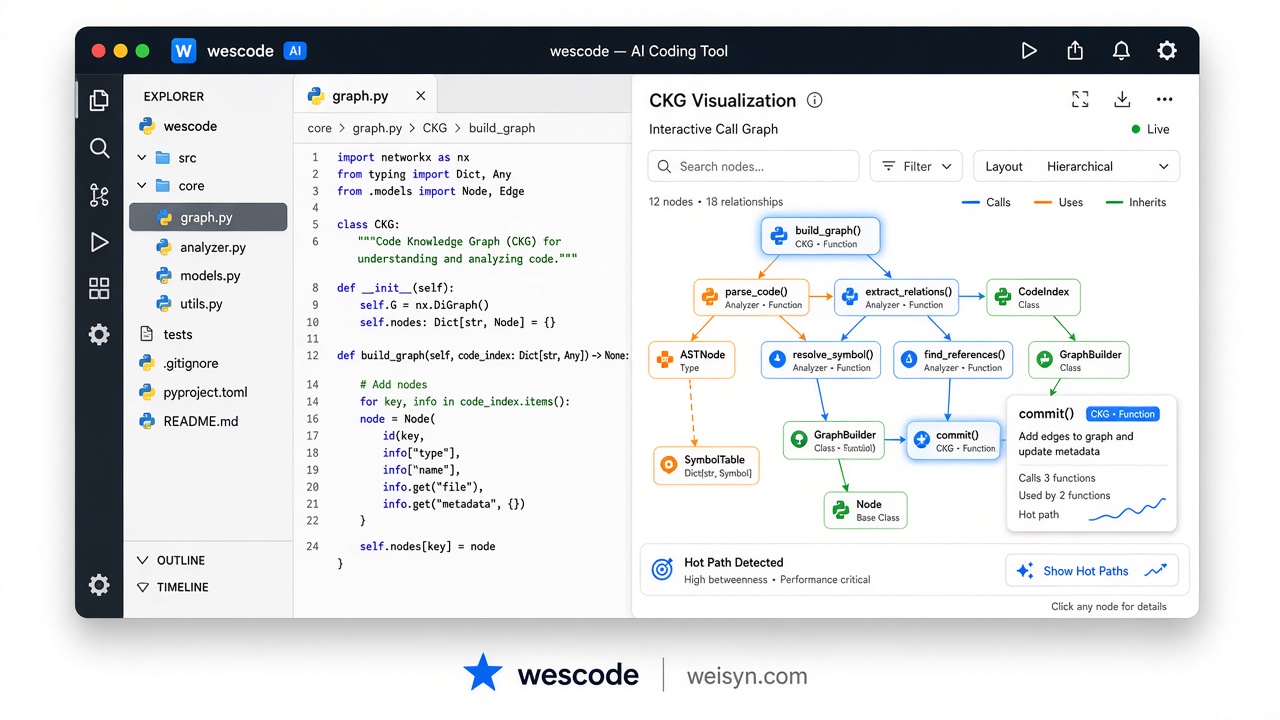
和 LSP 的「查找所有引用」有什么区别
LSP 的查找引用、调用层级也是结构化信息,适合在编辑器里一个符号一个符号地点开看。知识图谱的区别在于,它把整个项目的关系提前算好并存了下来。所以像全项目的孤儿函数统计、一次列出某个函数到所有 API 入口的路径、把关系结果直接组装进 AI 的上下文,这些事更适合放在图上做。
这条路线的短板
- 要先建索引。 第一次打开大项目,要等索引跑完;这期间问影响面,结果是不完整的。
- 语言覆盖取决于解析器。 没有对应解析器的语言、DSL、模板文件,只能退回全文搜索。
- 静态分析看不到运行时。 反射、依赖注入容器、字符串拼出来的路由、跨服务的 HTTP / RPC 调用、消息队列,这些关系在图里不会有边。
- 有些边是故意不连的。 前面说的「多个候选不猜」,代价就是个别调用关系处于未解析状态。
- 模糊的语义问题不是强项。 「哪里的报错提示对用户不友好」这种问题,按关系查帮不上忙,语义检索更合适。
五、三条路线放在一起看
| 维度 | 语义检索 | Agent 实时搜索 | 知识图谱 |
|---|---|---|---|
| 前期准备 | 要建索引 | 不需要 | 要建索引 |
| 代码刚改完 | 等增量同步 | 直接读最新代码 | 等增量更新 |
| 「登录重试逻辑在哪」这类模糊问题 | 擅长 | 取决于关键词选得准不准 | 不擅长 |
| 「谁调用了 X」 | 不擅长 | 直接调用能搜到,间接调用容易漏 | 擅长 |
| 影响面能不能列全 | 无法确认 | 取决于搜得全不全 | 静态解析到的部分能列全 |
| token 消耗 | 中等 | 较高,多轮搜索会累积 | 较低 |
| 反射、动态调用、跨服务调用 | 只能看文本 | 只能看文本 | 看不到 |
真实的工具基本都是混合路线:Cursor 是语义检索加 grep,Copilot 是语义索引加文本搜索,Claude Code 是 grep 加 LSP,WES Code 在 CKG 之外也有一份全文索引。所以选工具时,与其问「它用的是哪条路线」,不如问一句:遇到跨文件的问题,它靠什么兜底?
六、按场景怎么选
小项目、脚本、一次性任务。 几千行以内,三条路线差别不大,挑用着顺手的就行。
日常问答。 「这个功能在哪」「这段逻辑怎么走」,语义检索和 Agent 搜索都够用。
改公共函数、跨文件重构、评估影响面。 优先考虑有调用关系能力的工具。没有的话,至少用 IDE 的「查找所有引用」逐个确认,再全局搜一遍字符串兜底。
接手陌生的大项目。 先看全局结构:入口在哪、主干是哪几条调用链、哪些是死代码。这是知识图谱最有用的场景之一。
大量反射、元编程、动态派发的项目。 知识图谱的优势会变小,Agent 搜索加上跑测试更可靠。
代码不能离开本机。 先看清楚索引建在哪里、存在哪里,以各家官方文档为准。另外别忘了,调用云端模型本身也会把代码发出去,真要做到不出本机,得配合本地模型。
七、我自己是怎么分工的
我日常用的是 WES Code,大致这样分工:
- 模糊的问题,直接在对话里问,不刻意指定文件;
- 改公共函数之前,先问一句「改 X 的签名会影响哪些地方」,拿到直接调用方、间接调用方和要重跑的测试,再决定改动范围;
- 接手新项目,先打开项目概览,看调用图和孤儿函数,找出主干;
- 涉及反射、依赖注入、跨服务调用的地方,图里没有边,我会再全局搜一遍字符串,再跑一遍测试兜底。
最后这条最重要:不管哪条路线,静态看不到的关系,最后都得靠测试来补。
小结
- 选 AI 编程工具,除了模型和价格,还要看它怎么理解代码库。
- 语义检索擅长模糊问题,Agent 实时搜索零准备、最新鲜,知识图谱擅长调用关系和影响面。
- 现实中的工具都是混合的,关键看跨文件的问题靠什么兜底。
- 运行时才能看到的关系,哪条路线都看不到,要靠测试补上。
文中 CKG 的部分来自我在 WES Code 里的实际使用和它的官方文档。你们在大项目里用 AI 编程工具,最常遇到的是「找不到」还是「找不全」,欢迎评论区聊聊。
觉得有用的朋友,欢迎点赞、收藏、关注,后面会继续分享 AI 编程的实战经验。