Looped Transformer 从"让模型学会反复计算"的架构设计,发展为推理时扩展计算量的方法,进一步走向对循环位置、次数和实际计算成本的联合优化。
它的价值在于把"拥有多少参数"和"执行多少计算"部分解耦;未来的关键则是让每一次额外计算产生可验证的收益。 多循环本身并不保证更强。
先统一一下概念。Universal Transformer 依次使用不同层:
h_1 = F_1(h_0), h_2 = F_2(h_1), h_3 = F_3(h_2)
Looped Transformer 则重复使用共享参数的模块:
h(r+1) = F_theta(h®, x)
其中 r是内部计算轮次。有些架构每轮重新注入输入 x,有些不这样做。循环主要发生在表示的"深度方向",因此可以在不输出额外文字的情况下继续计算。这也是它与通过生成更多 token 来延长思维链的主要区别。
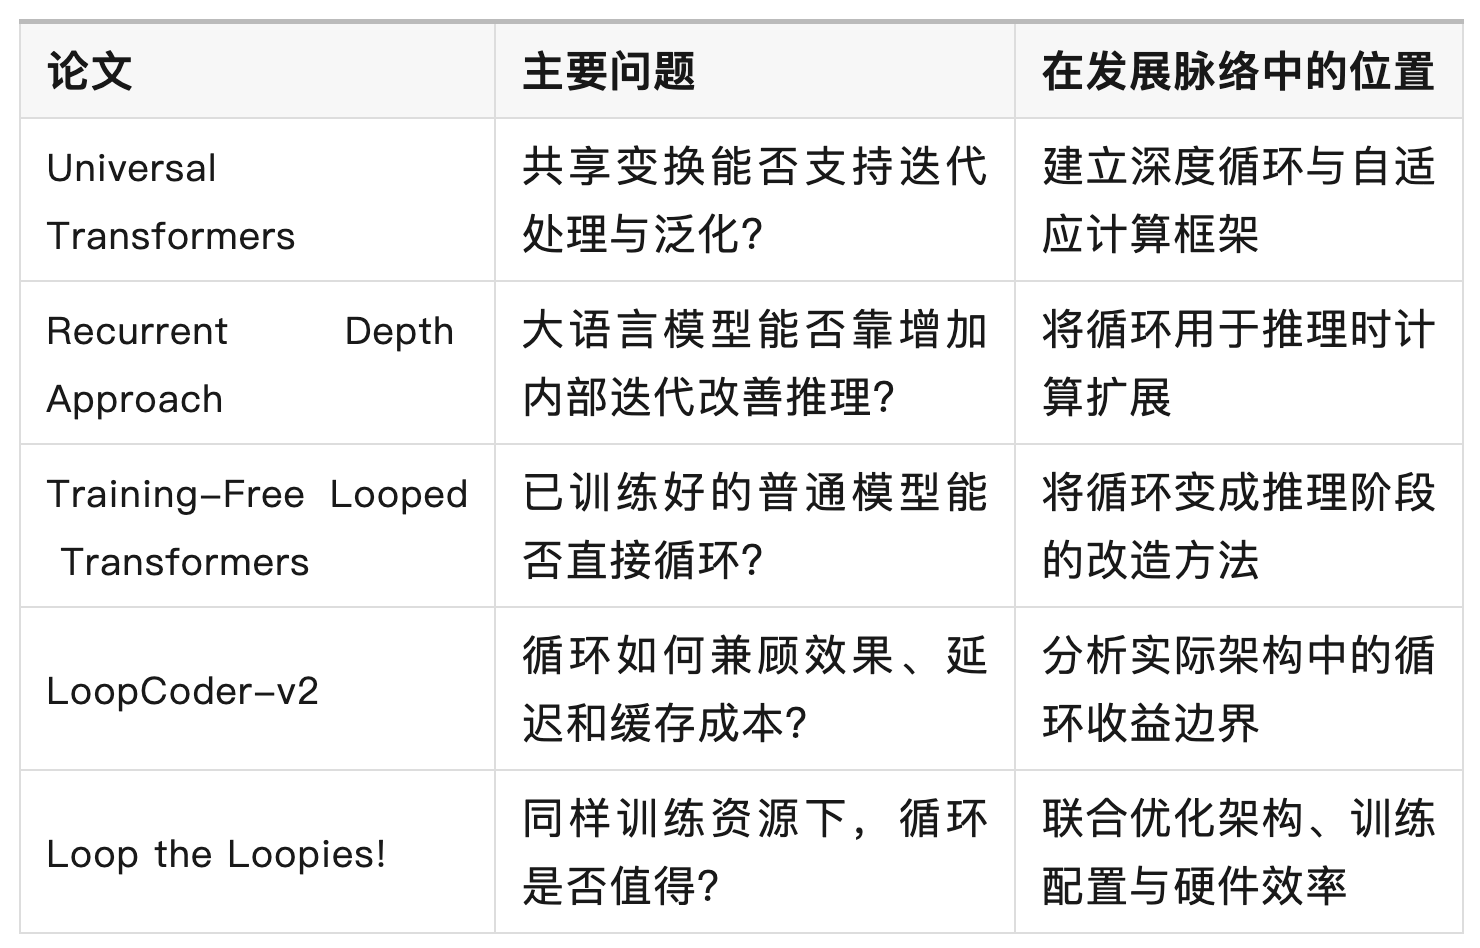
1 Universal Transformers 的贡献,是把"迭代算法"的结构引入 Transformer。
UT 反复更新各位置的表示,位置之间通过注意力交换信息,并允许不同位置通过 ACT 机制选择不同计算步数。它在算法任务和语言理解任务中展示了收益,包括对训练之外输入长度的泛化。
这里最有启发性的思想是:学习一个可以重复执行的操作,可能比为每个处理阶段学习独立操作,更适合算法式任务。但这是归纳偏置带来的可能优势,不代表循环自动获得推理能力。论文在特定假设下讨论的计算普适性,也不能直接理解为实际模型能够解决任意问题。
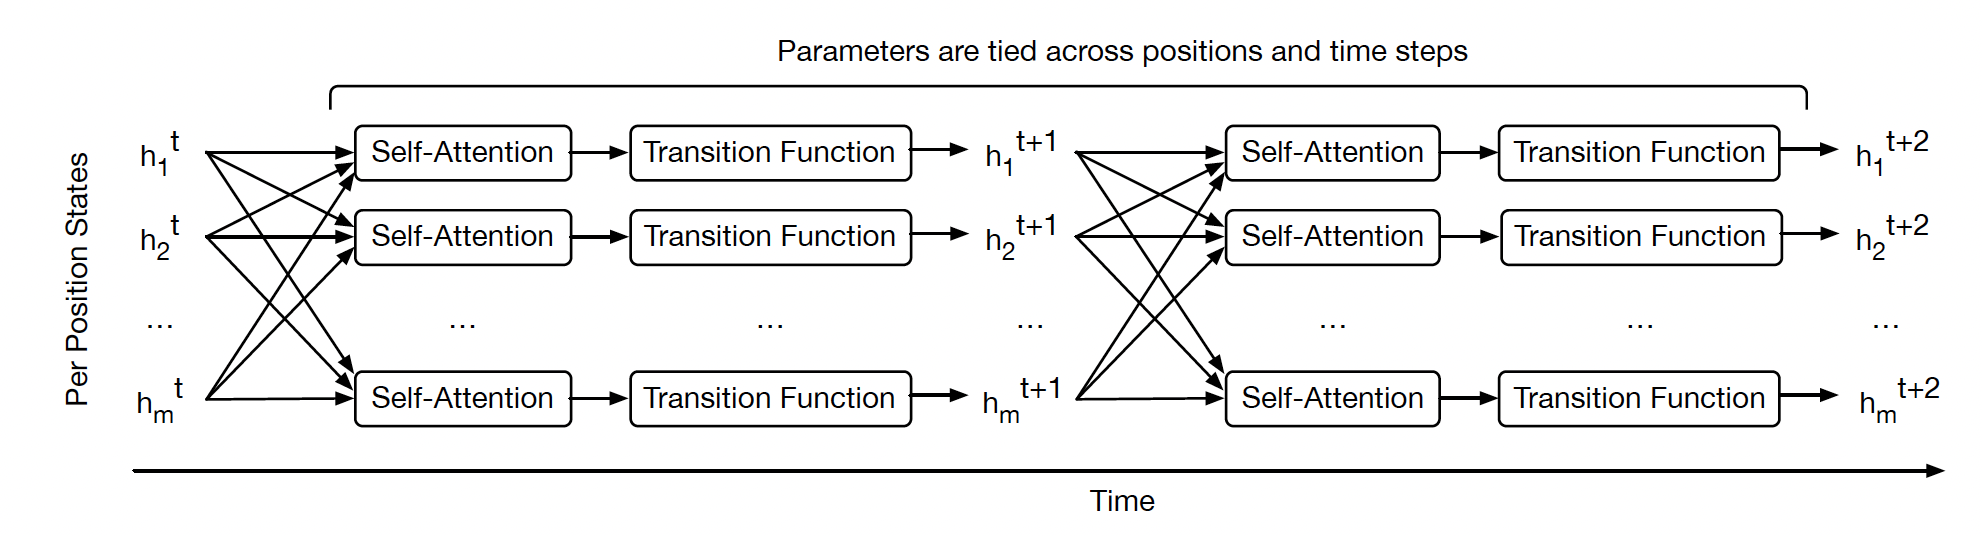
2 Recurrent Depth Approach 把问题推进到:"同一个模型,能否在推理时多算一会儿?"
其模型采用"输入处理---循环核心---输出处理"结构,训练时随机采样循环次数,并用截断反向传播控制训练开销。作者训练了 3.5B 参数、800B token 的模型,观察到增加推理循环能改善若干任务,而且不同任务的收益饱和点不同。
这一步使循环次数成为可调的计算预算。不过,论文所说的计算量可达到约 50B 参数模型的水平,不是说它全面达到 50B 模型的能力。此外,内部循环与显式思维链可以共同使用;该论文也包含 CoT 条件下的评测。
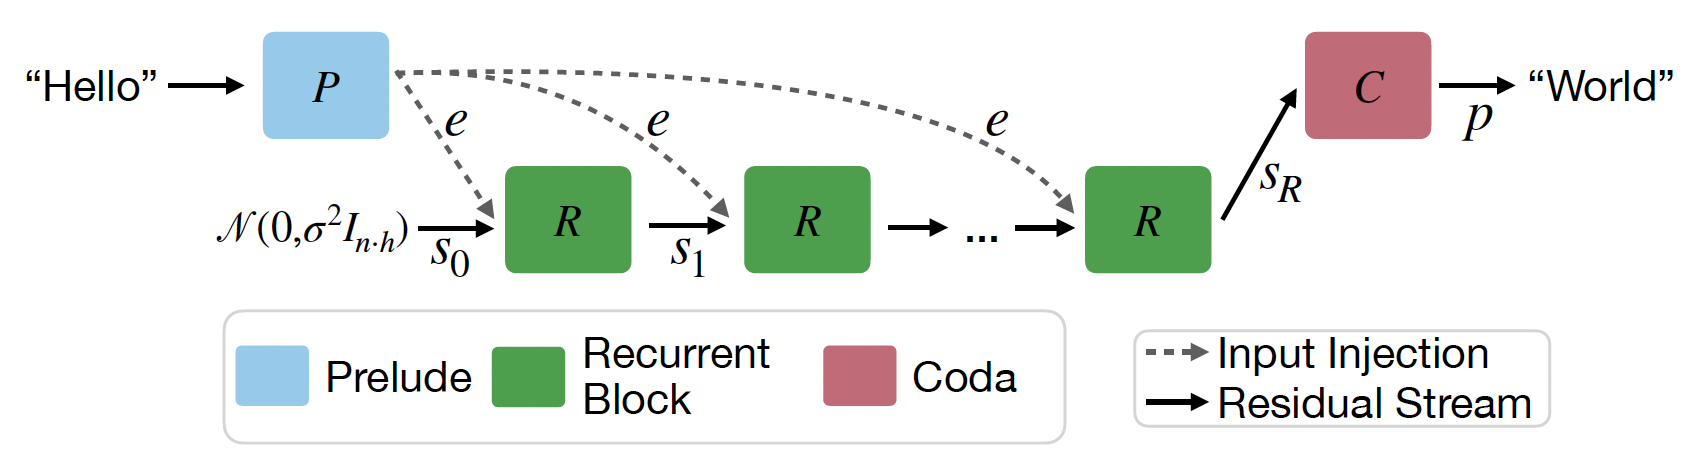
3 Training-Free Looped Transformers 表明:循环能力不一定只能通过从头训练获得。
它冻结已有模型,重复调用中间层,但发现直接重复通常会损害效果。方法通过较小的残差更新及与原输出的混合,控制表示偏移;例如报告 Qwen3-4B-Instruct 的 MMLU-Pro 提升 2.64 个百分点。
其重要意义是降低尝试门槛,但"免训练"仍需要额外推理计算。它提供的 ODE 解释也应谨慎理解:更精细地积分某个残差场,并不在数学上保证答案更正确。收益仍需通过任务实验验证,不能把数值近似精度直接等同于语义正确性。
4 LoopCoder-v2 说明:循环收益会受到信息流设计的制约。
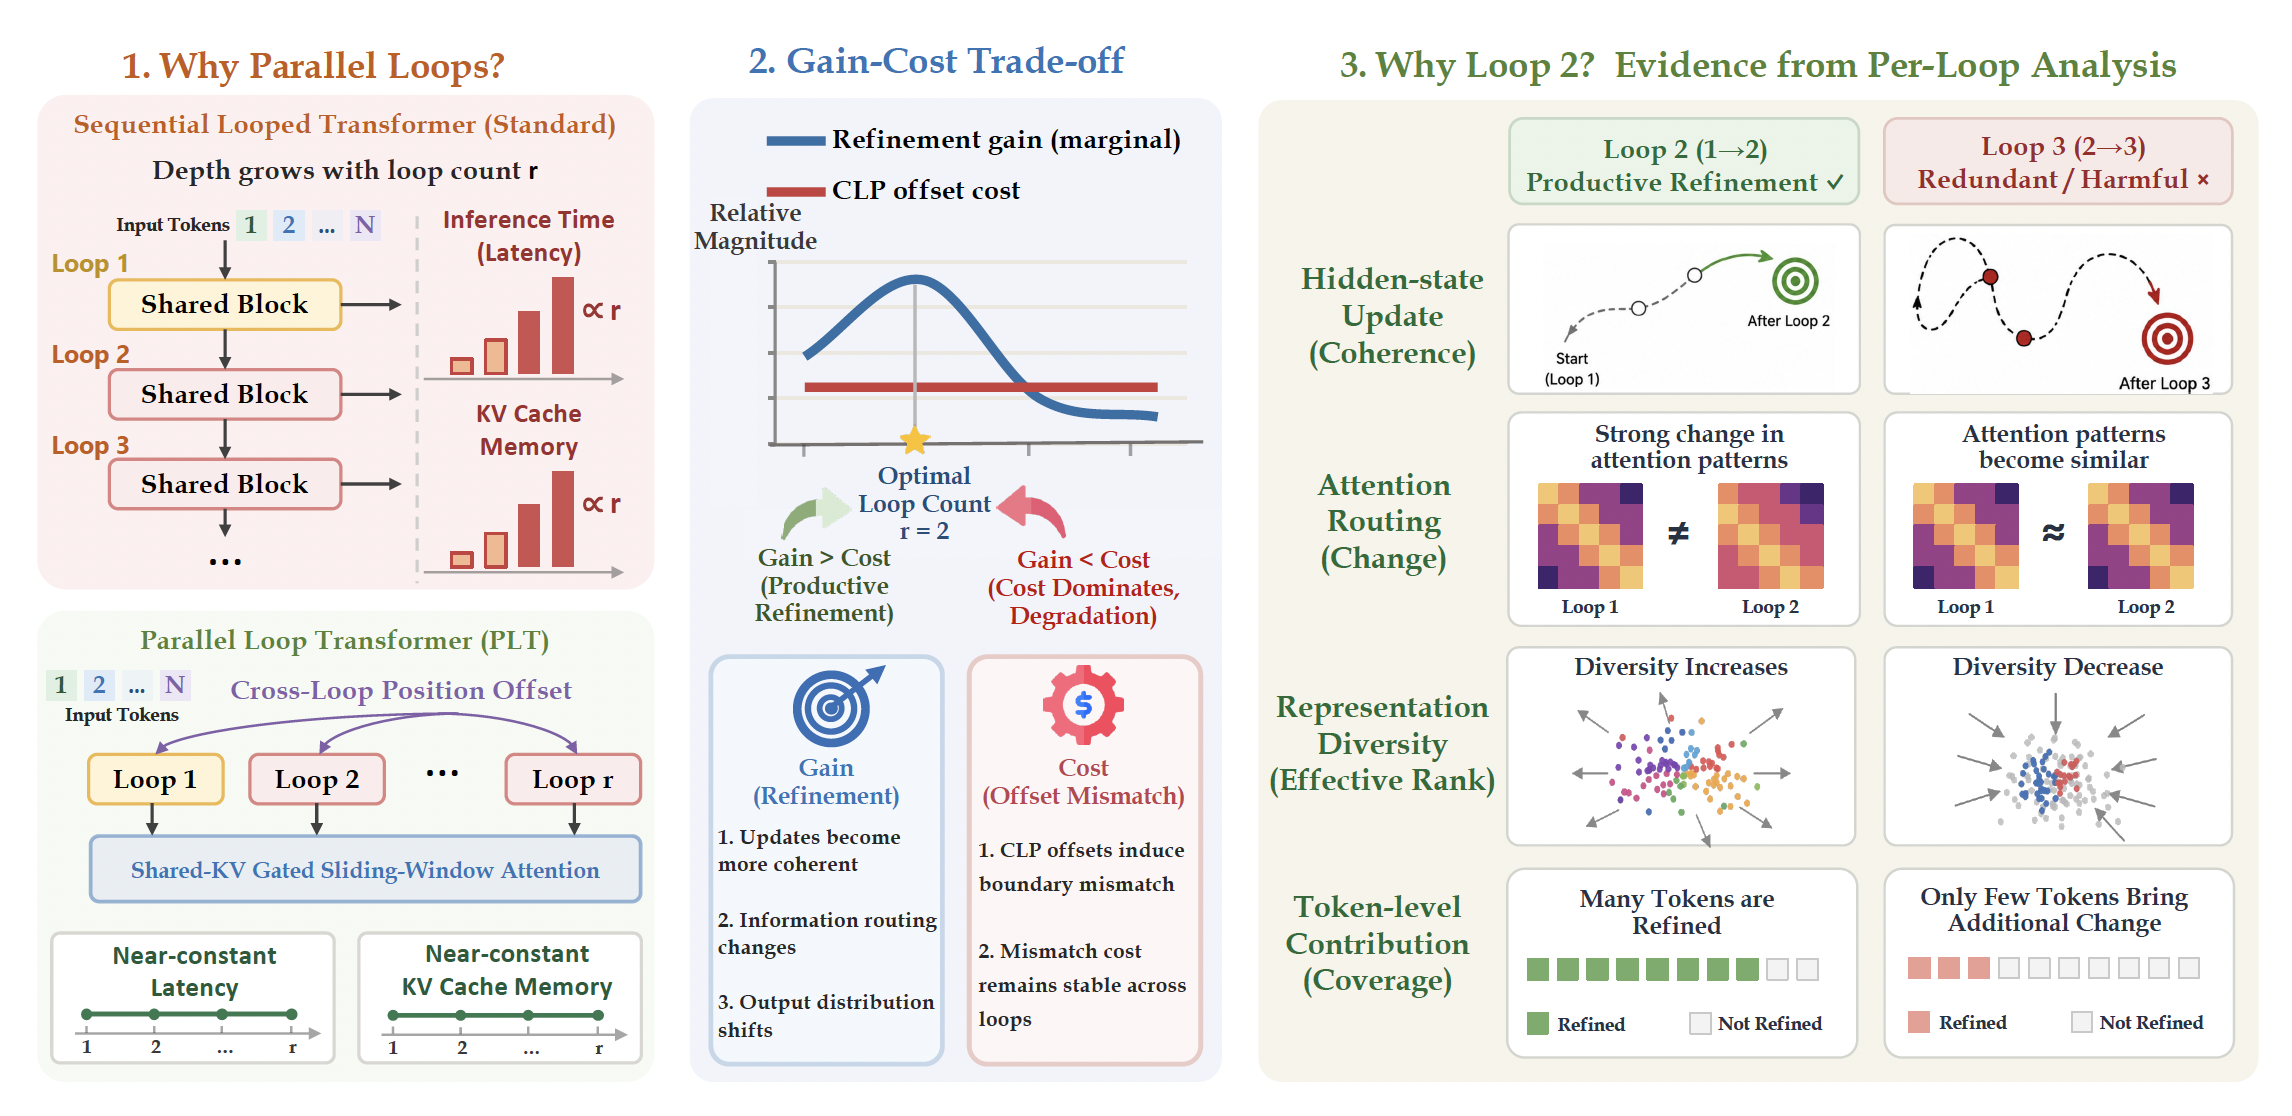
它研究 PLT(Parallel Looped Transformer),通过跨循环位置偏移及 KV 共享降低执行成本。在其 7B 代码模型实验中,两轮循环表现最好,更多轮次出现退化;作者用后续更新收益减小、表示多样性下降及位置错配解释这一现象。标题中的"Only Loop Once"指额外循环一次,即总共两轮。
这篇论文最值得保留的结论是:循环次数必须结合架构选择。 "两轮最优"是这里的实验发现,不能推广成所有循环模型的规律。位置偏移是 PLT 的特定设计,其代价不能归到所有深度循环架构上。
5 Loop the Loopies! 把衡量标准推进到实际资源效率。
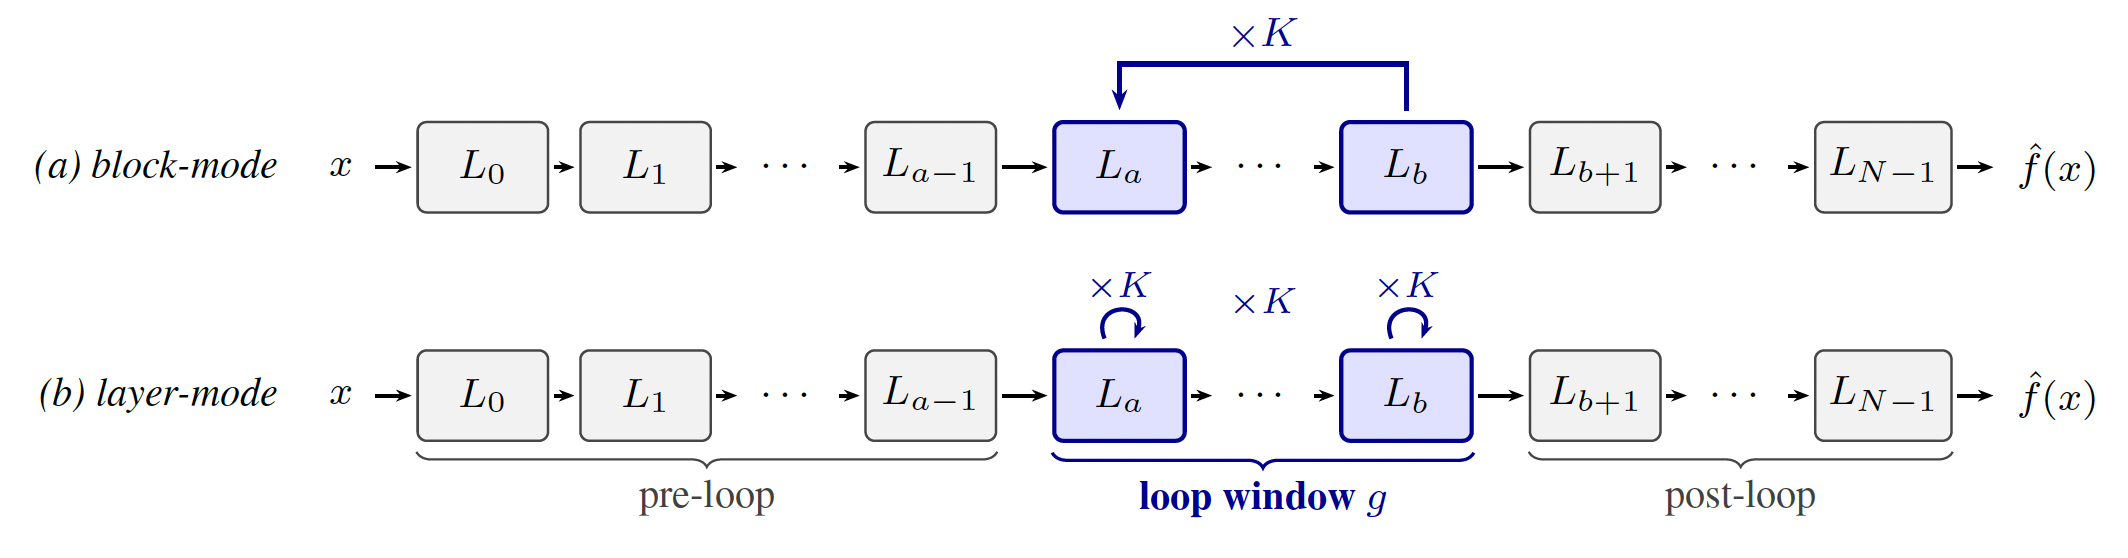
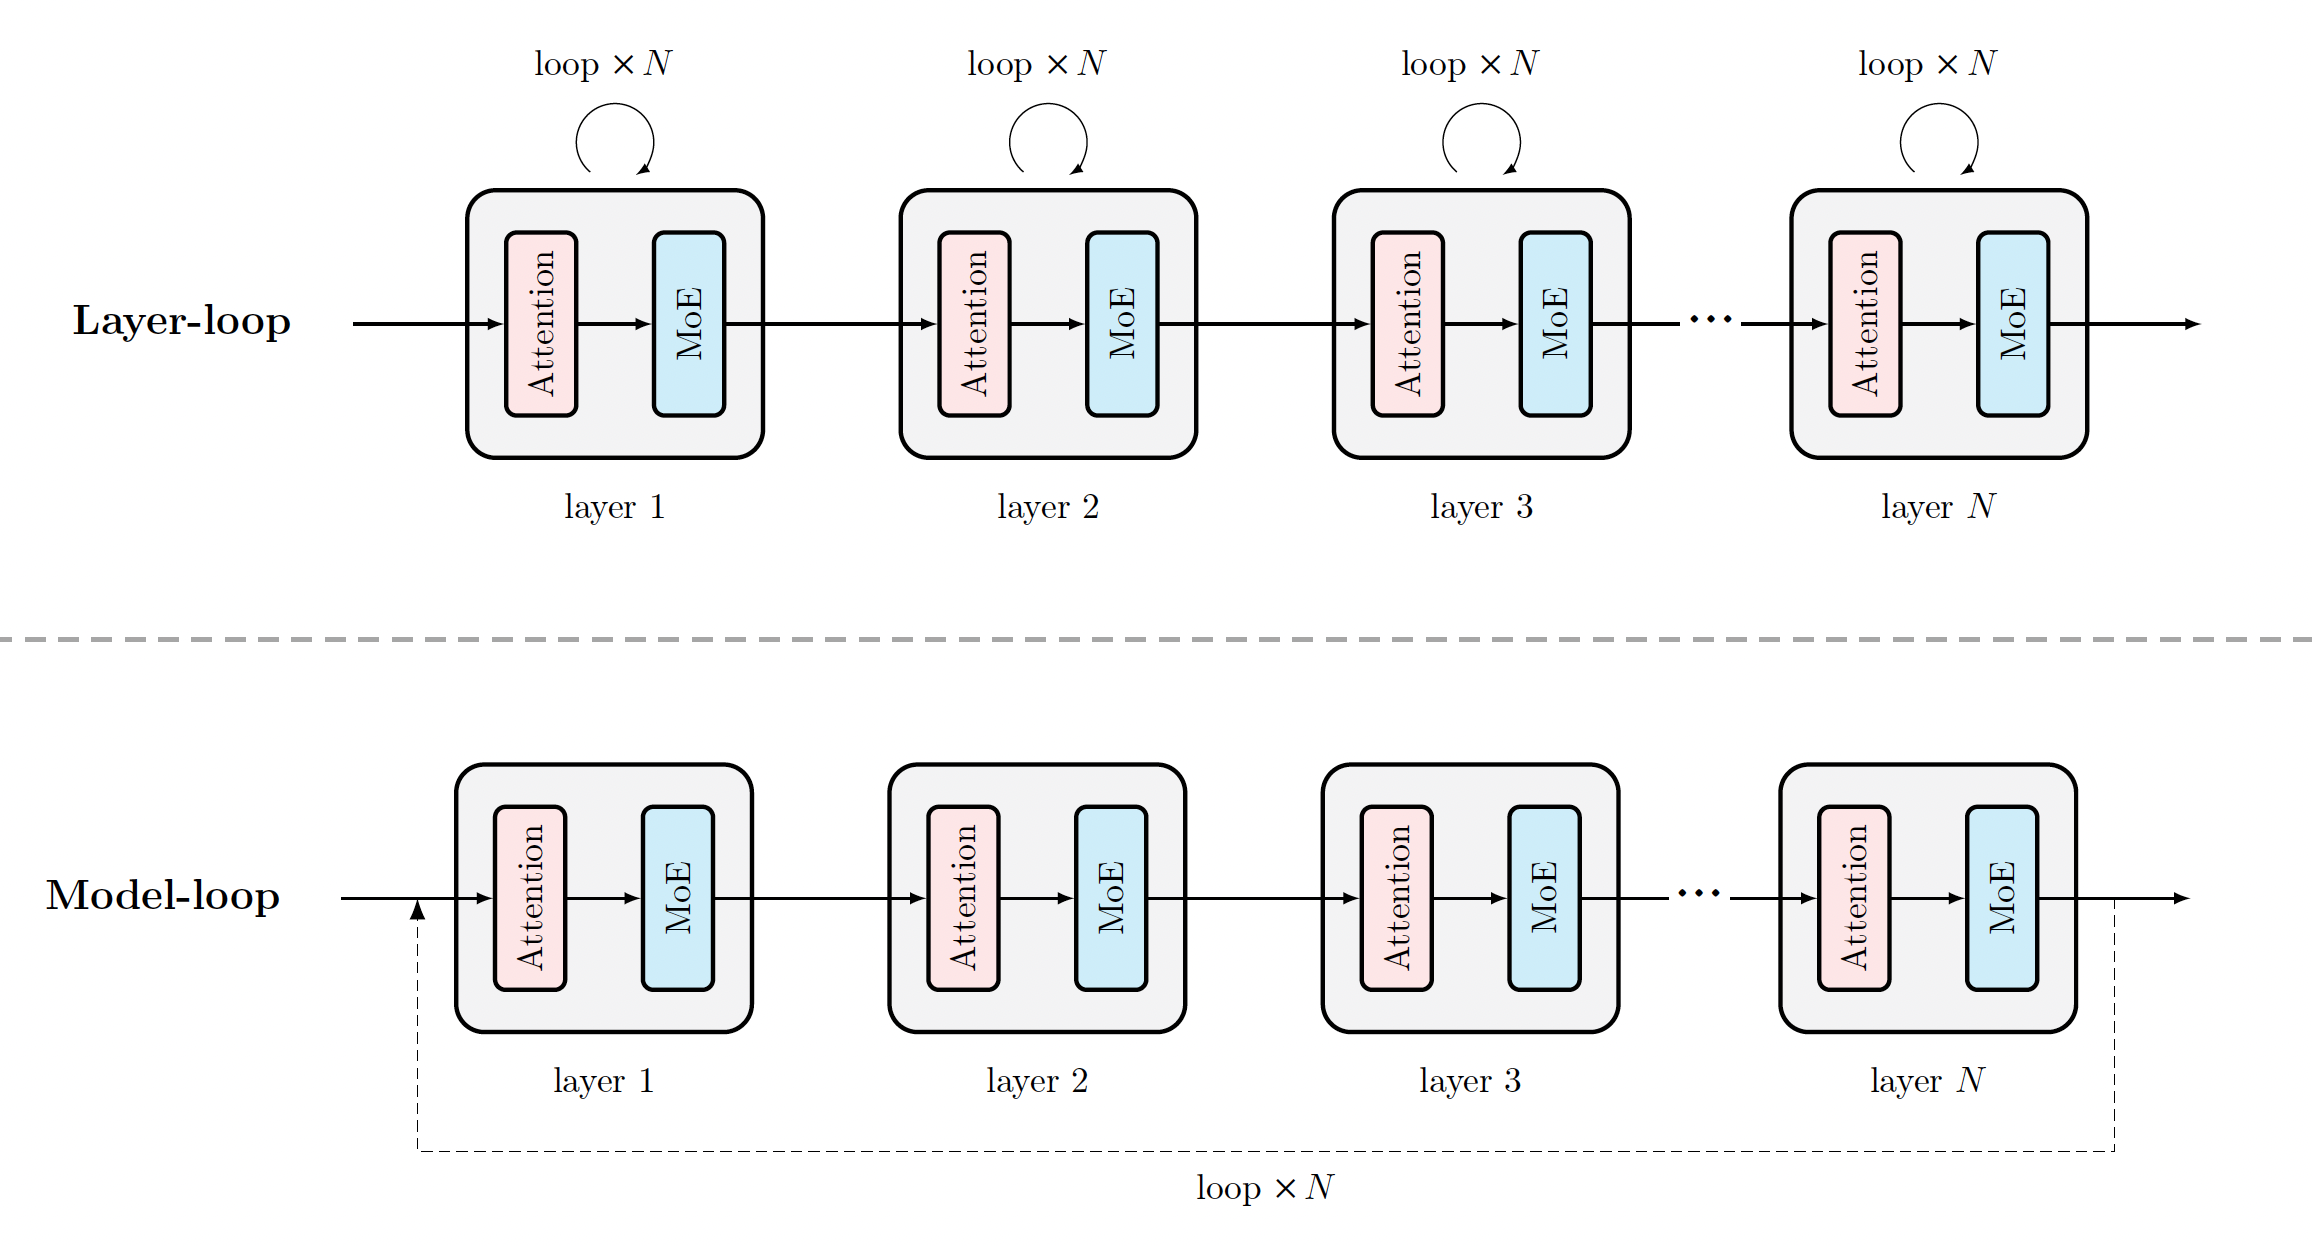
Loopie 使用逐层循环,例如 A→A→B→B,而不是整段重复的 A→B→A→B,并将其用于 MoE。一个关键细节是:其主要资源匹配依据是实测训练步耗时,并非严格相等的理论 FLOPs;方法利用内存余量增大微批次,再把效率收益用于增加模型容量。
因此,它的贡献包含架构与训练系统的协同设计。不能把全部收益都解释成循环的独立贡献,也不能把其两轮配置与 LoopCoder-v2 的两轮最优混为一谈:前者主要考虑训练资源分配,后者还涉及特定并行结构的信息错配。
这五篇论文放在一起,能够帮助我们更准确地理解 loop 的作用。
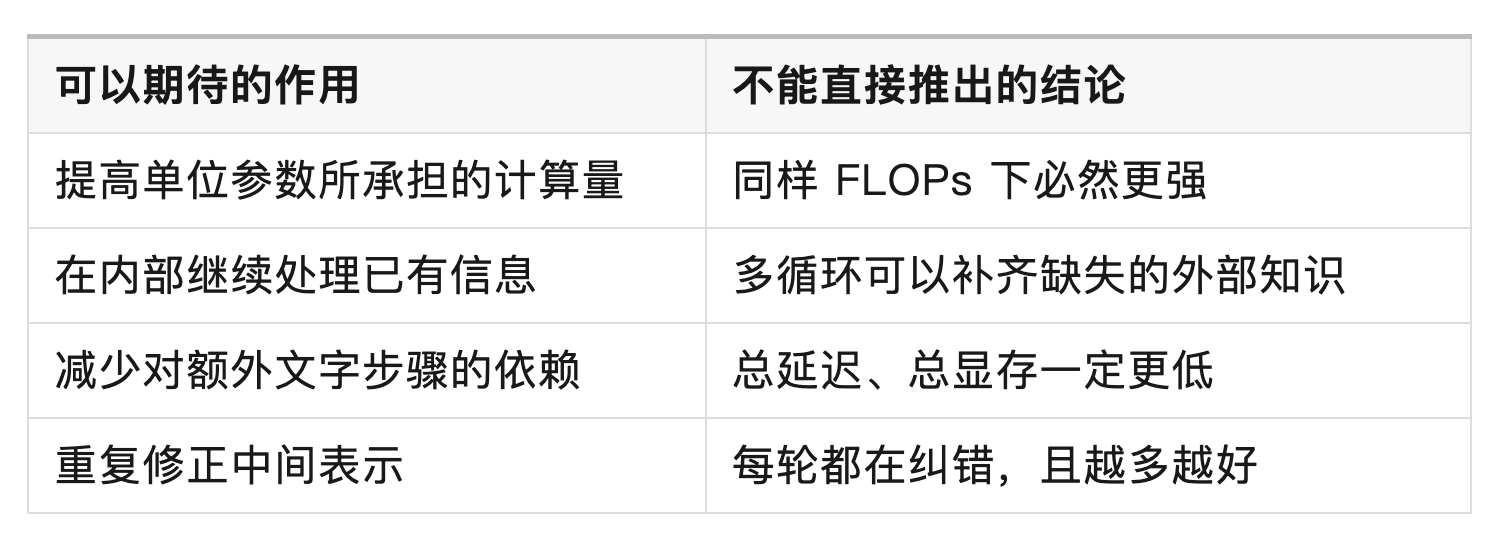
1)首先,它让模型用更多计算复用已有参数。 若循环核心有 L 层、执行 R轮,有效计算深度大致随 LR 增长,而核心权重不随 R 增长。因此,它可能适合权重存储受限、却愿意为困难问题支付更多计算的场景。
但应区分三件事:
2)其次,它提供了一种迭代处理的结构。 对同一组约束反复协调、组合已有信息、逐步修改候选表示,都可能从循环中受益。但"隐状态发生了变化"不足以说明发生了有效推理:变化也可能是重复、振荡或信息损失。
3)再次,它增加了计算预算分配的自由度。 对一个困难问题,可以选择增加内部循环、延长文字推理、增加候选答案,或者调用工具。循环提供了其中一个选项。真正值得研究的是这些选项各自的边际收益,以及如何组合。
由此看未来方向,有以下五项探索:
1 从固定循环次数,转向预测"再算一轮是否值得"。
可以根据当前状态、输出分布变化和任务特征决定是否继续。但不能简单使用"表示已经收敛"作为停止标准:模型也可能稳定在错误答案上。
更有价值的目标是预测额外计算带来的正确率增益,并与成本比较。评测应回答:同样平均延迟下,自适应循环是否优于固定循环?
2 从完全共享,转向共享核心与少量阶段差异的结合。
同一个模块需要处理早期粗糙表示和后期精细表示,这两类输入的需求可能不同。可探索共享主体权重,同时增加循环阶段编码、小型适配器或门控机制。
关键问题是:能否只增加少量参数,就让后续循环持续有效,而不是迅速饱和?
3 联合优化内部循环、显式推理和外部验证。
我更看好一种混合路线:内部循环负责局部表征处理,文字步骤承载较长的中间结果,程序执行或检索提供外部反馈。
研究重点应是预算控制:什么时候值得继续内部计算,什么时候应该写下中间步骤,什么时候必须获得新信息。对代码任务,这可以用测试通过率与端到端耗时直接衡量。
4 把循环位置、MoE 路由和缓存策略一起设计。
循环整段网络、逐层循环和只循环中间局部,改变的不仅是执行顺序,也包括模块接收的表示分布。MoE 还需要决定是否沿用专家选择,缓存则涉及复用效率与信息新鲜度的权衡。
一个有价值的研究问题是:如何识别最值得重复计算的部分,而不是让所有层、所有 token 承担相同循环开销?
5 建立更严格的成本对照与因果验证。
比较时至少应分别报告:参数量、训练 FLOPs、训练耗时、推理延迟和峰值显存。它们回答不同问题,不能用其中一个替代其余指标。
机制分析也应从"观察到隐状态变化"推进到干预实验:跳过某轮、替换某轮状态、扰动循环输入后,哪些能力会消失?这样才能辨别循环是在执行必要的中间计算,还是仅改变输出校准。
如果以科研选题的角度排序,推荐"预算约束下的自适应循环":以固定循环为基础,学习什么时候继续、何时停止,并与延长 CoT、增加采样次数进行等延迟比较。它直接连接这五篇论文尚未共同解决的问题------如何把有限计算分配到最能提高答案质量的地方。
参考文献
- Universal Transformers。https://arxiv.org/abs/1807.03819
- Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach。https://arxiv.org/abs/2502.05171
- Training-Free Looped Transformers。https://arxiv.org/abs/2605.23872
- LoopCoder-v2: Only Loop Once for Efficient Test-Time Computation Scaling。https://arxiv.org/abs/2606.18023
5.Loop the Loopies! https://arxiv.org/abs/2607.16051