✨作者主页 :IT毕设梦工厂✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
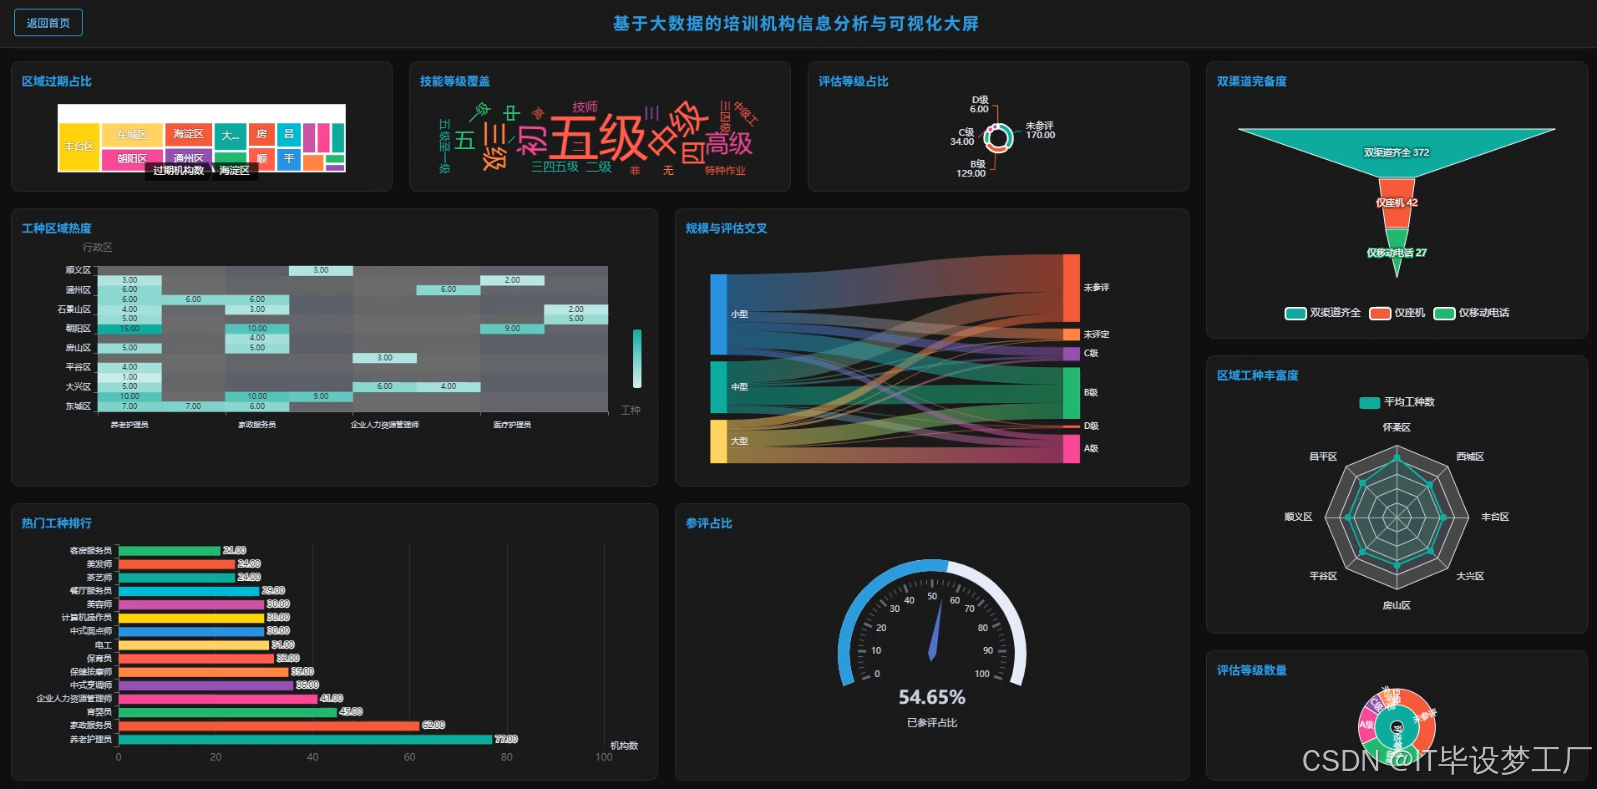
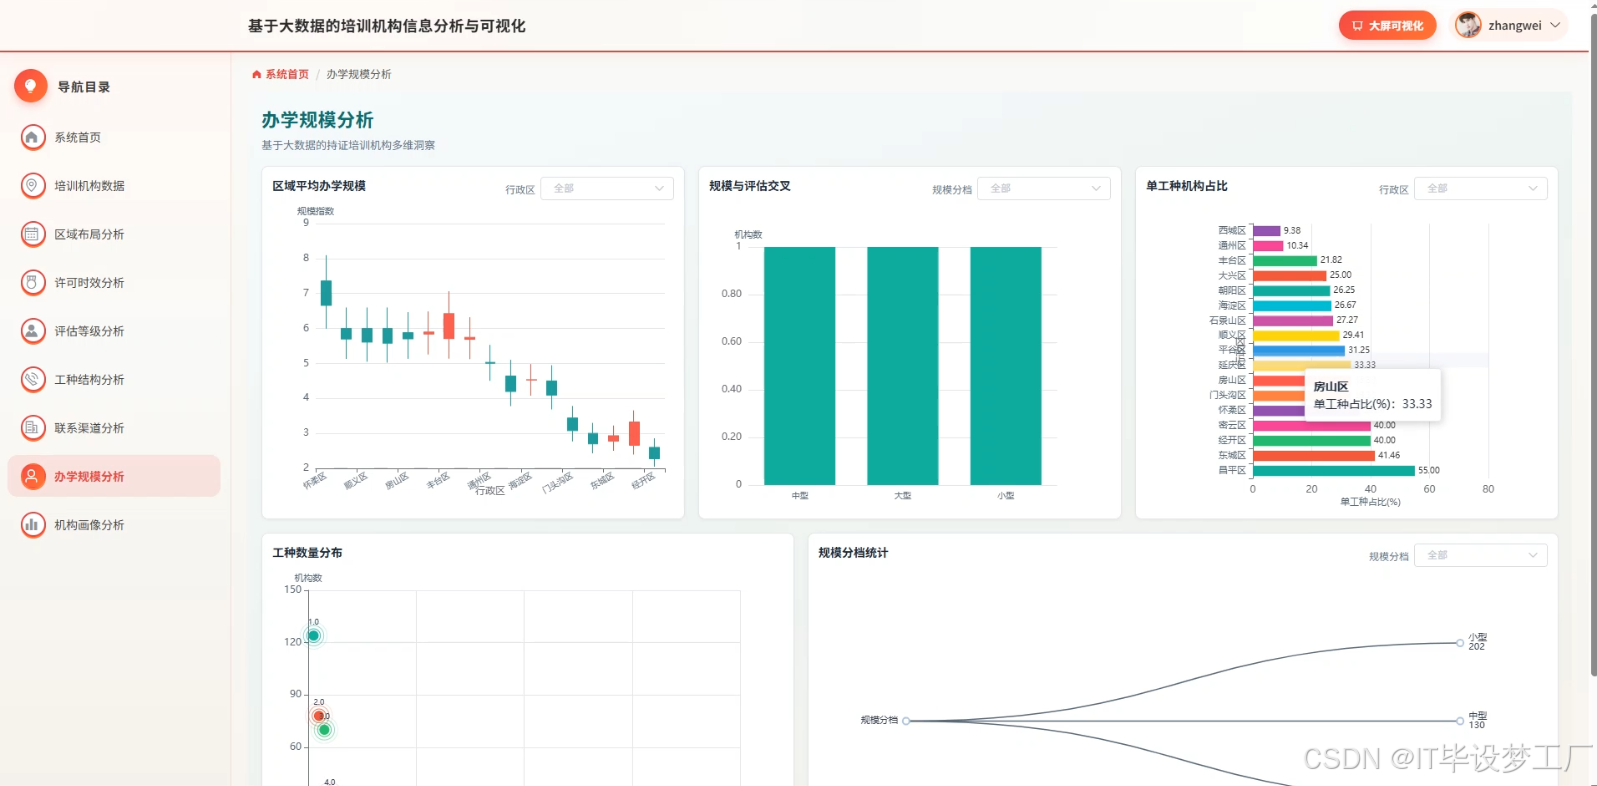
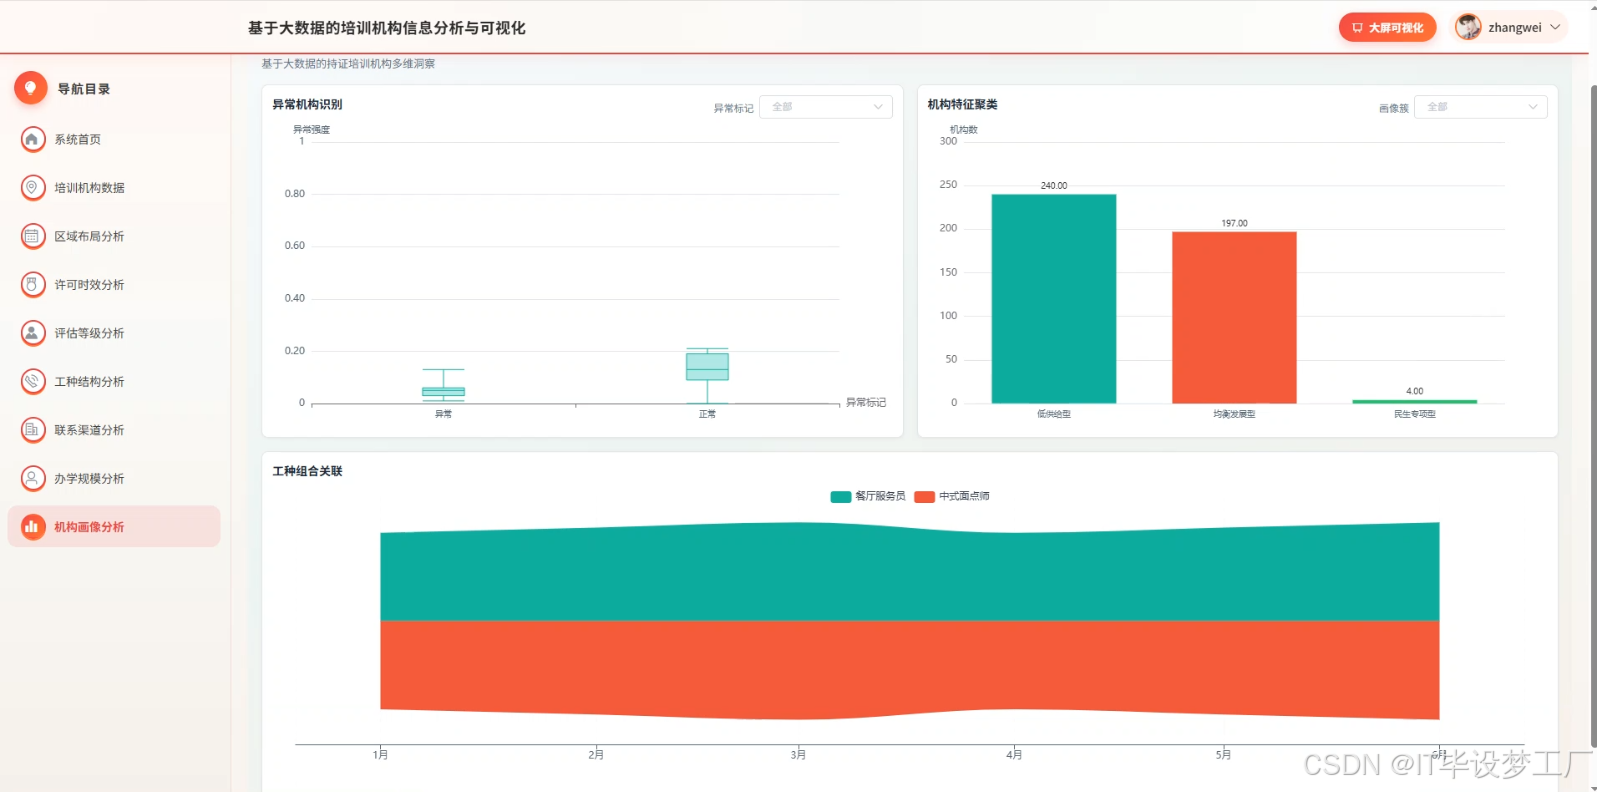
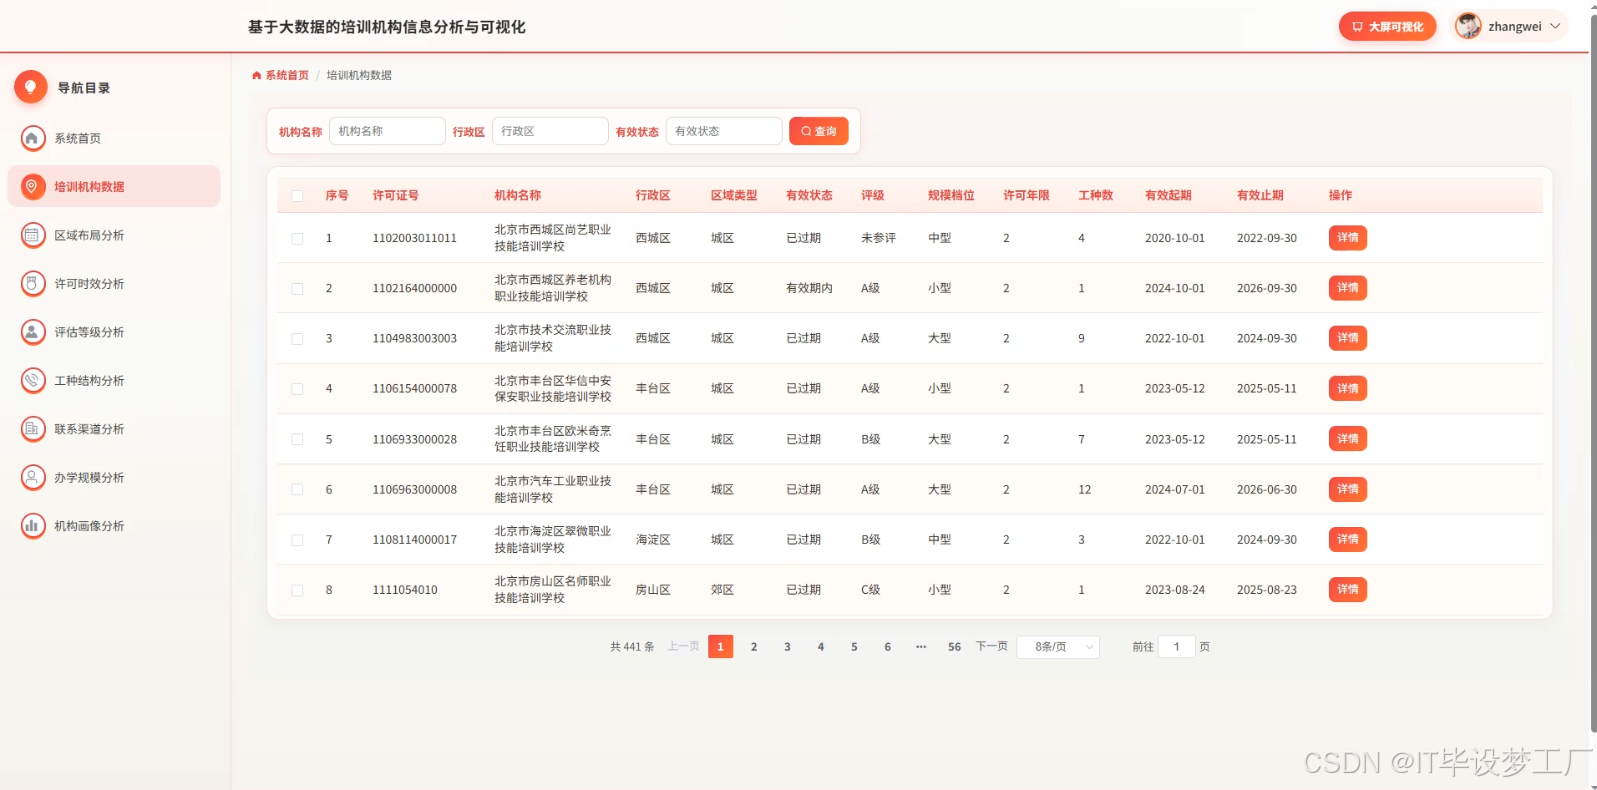
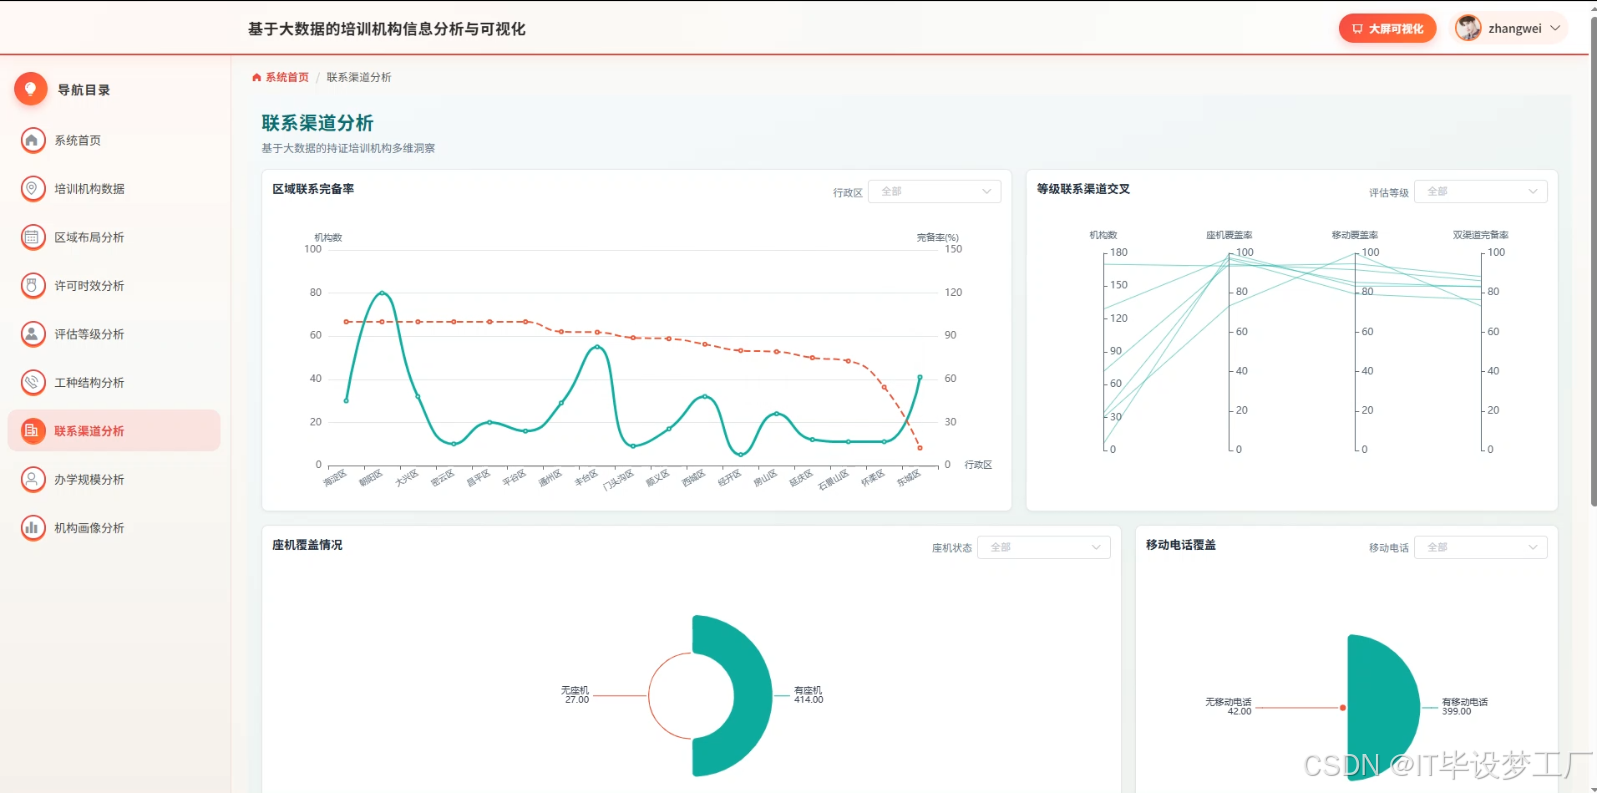
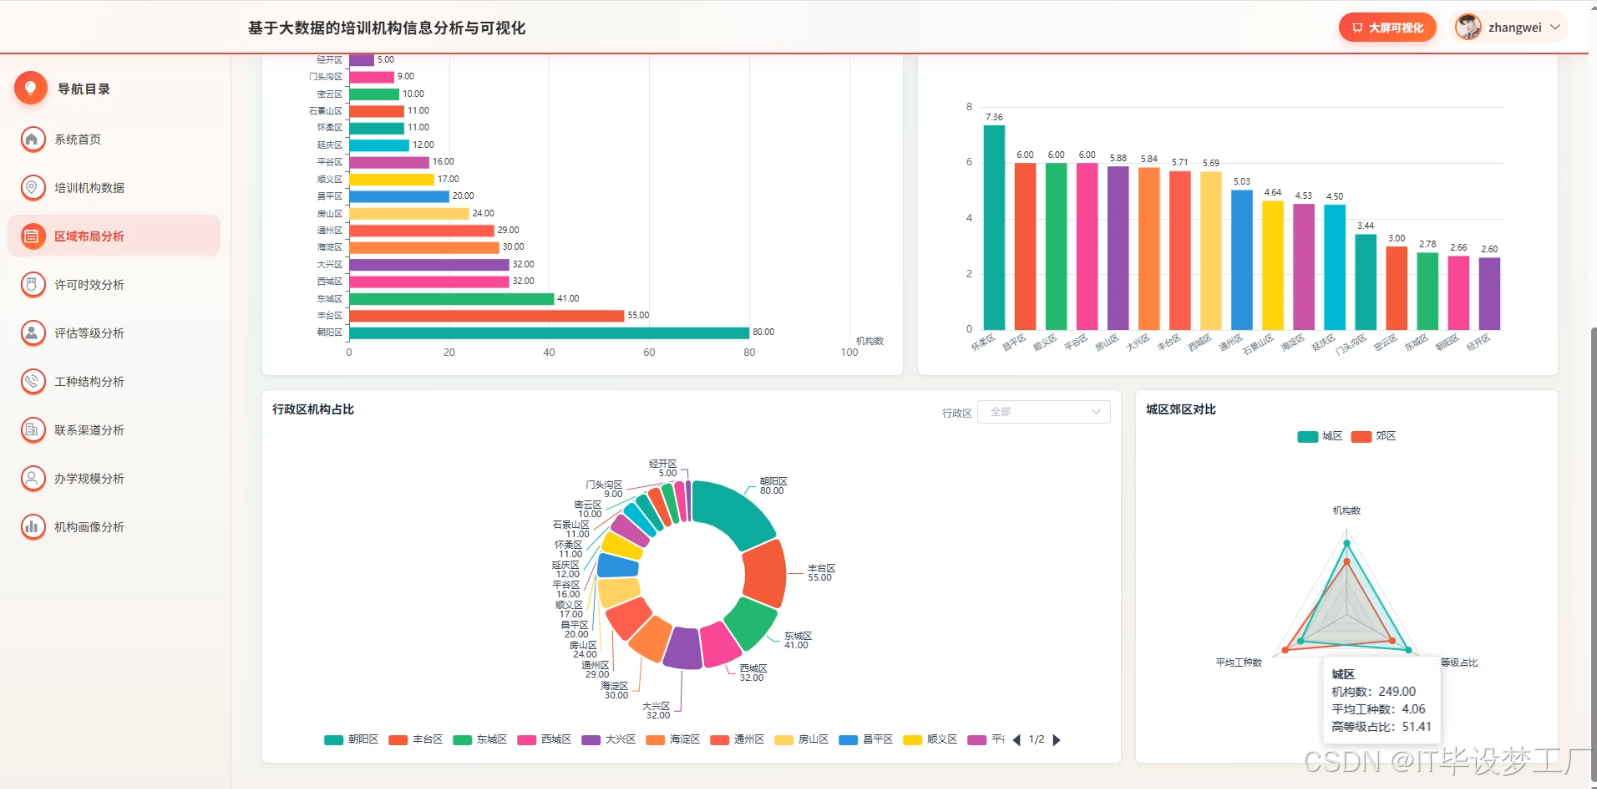
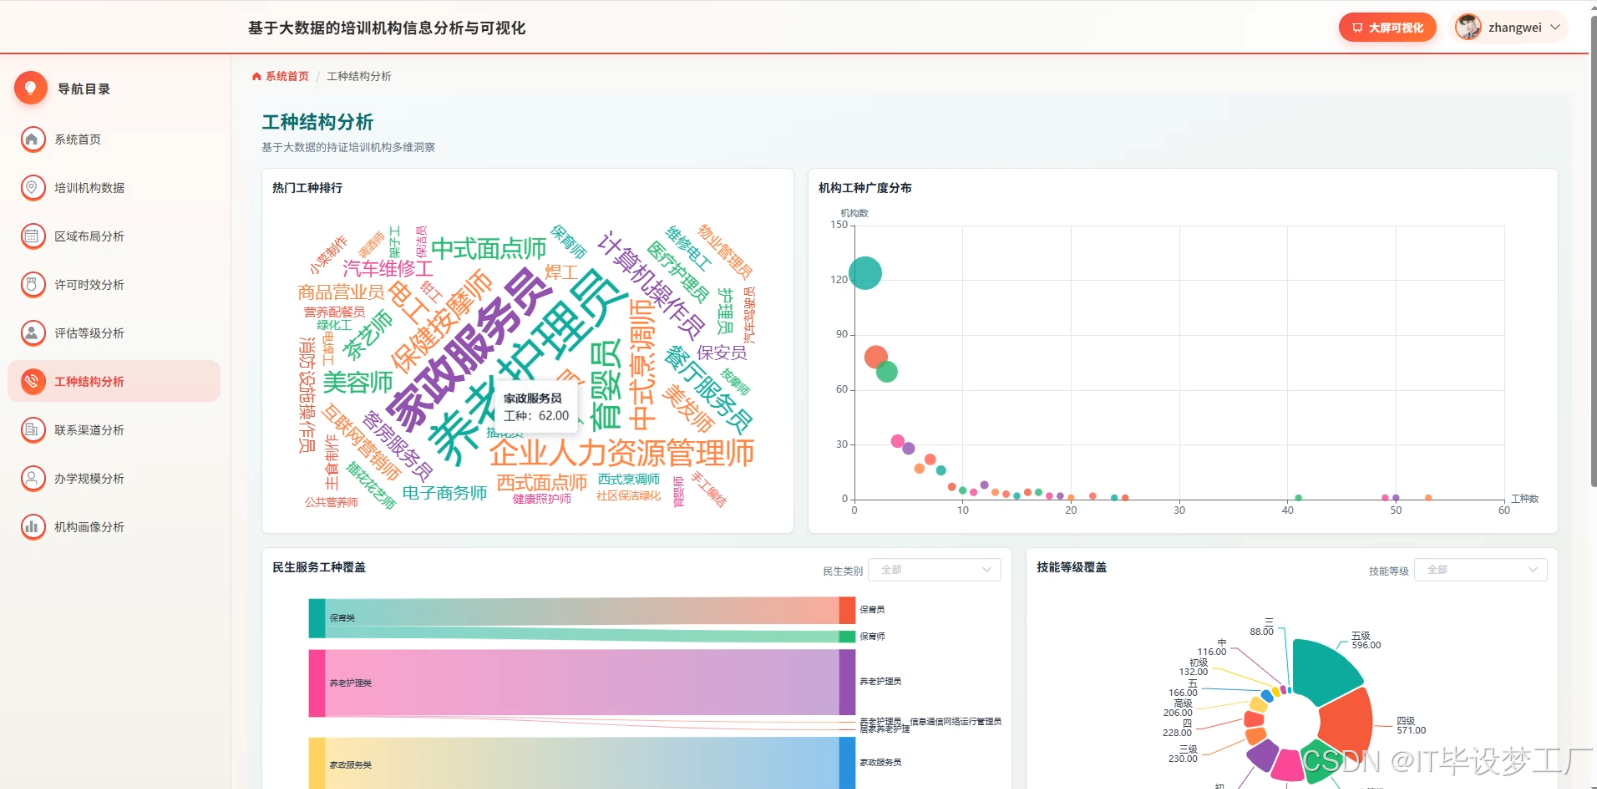
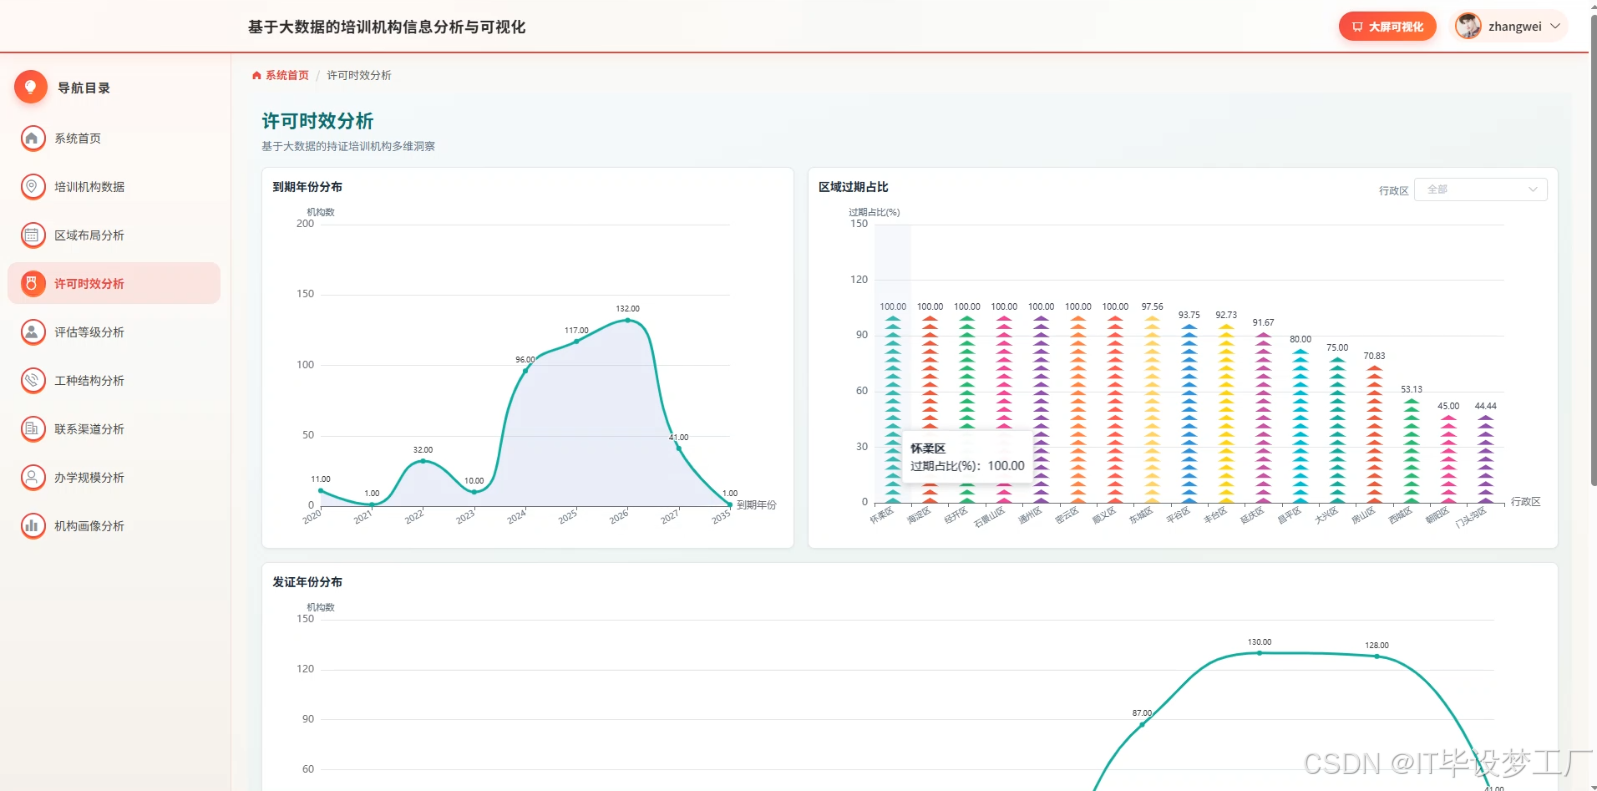
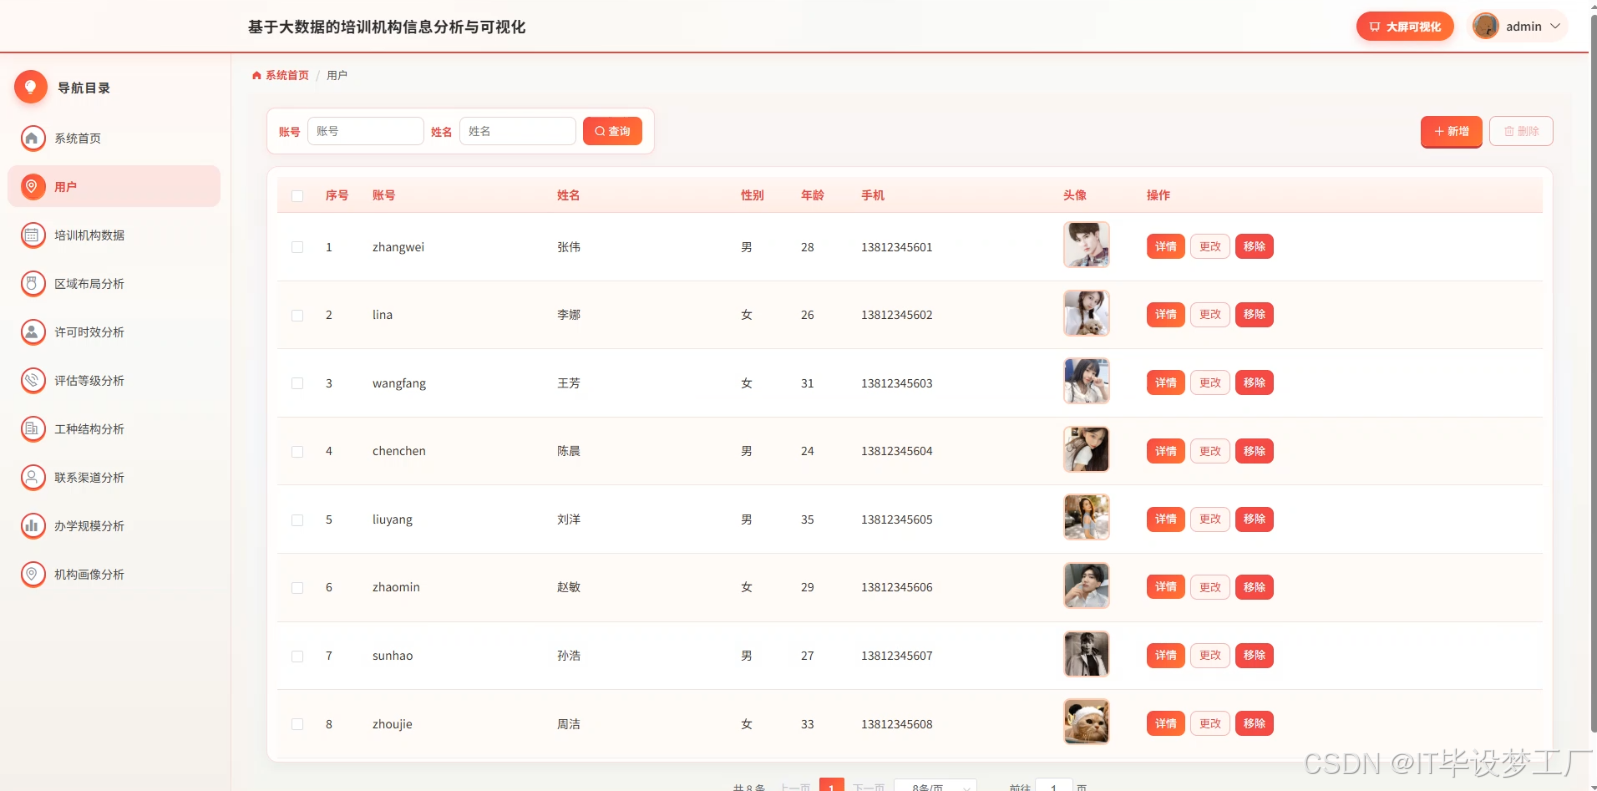
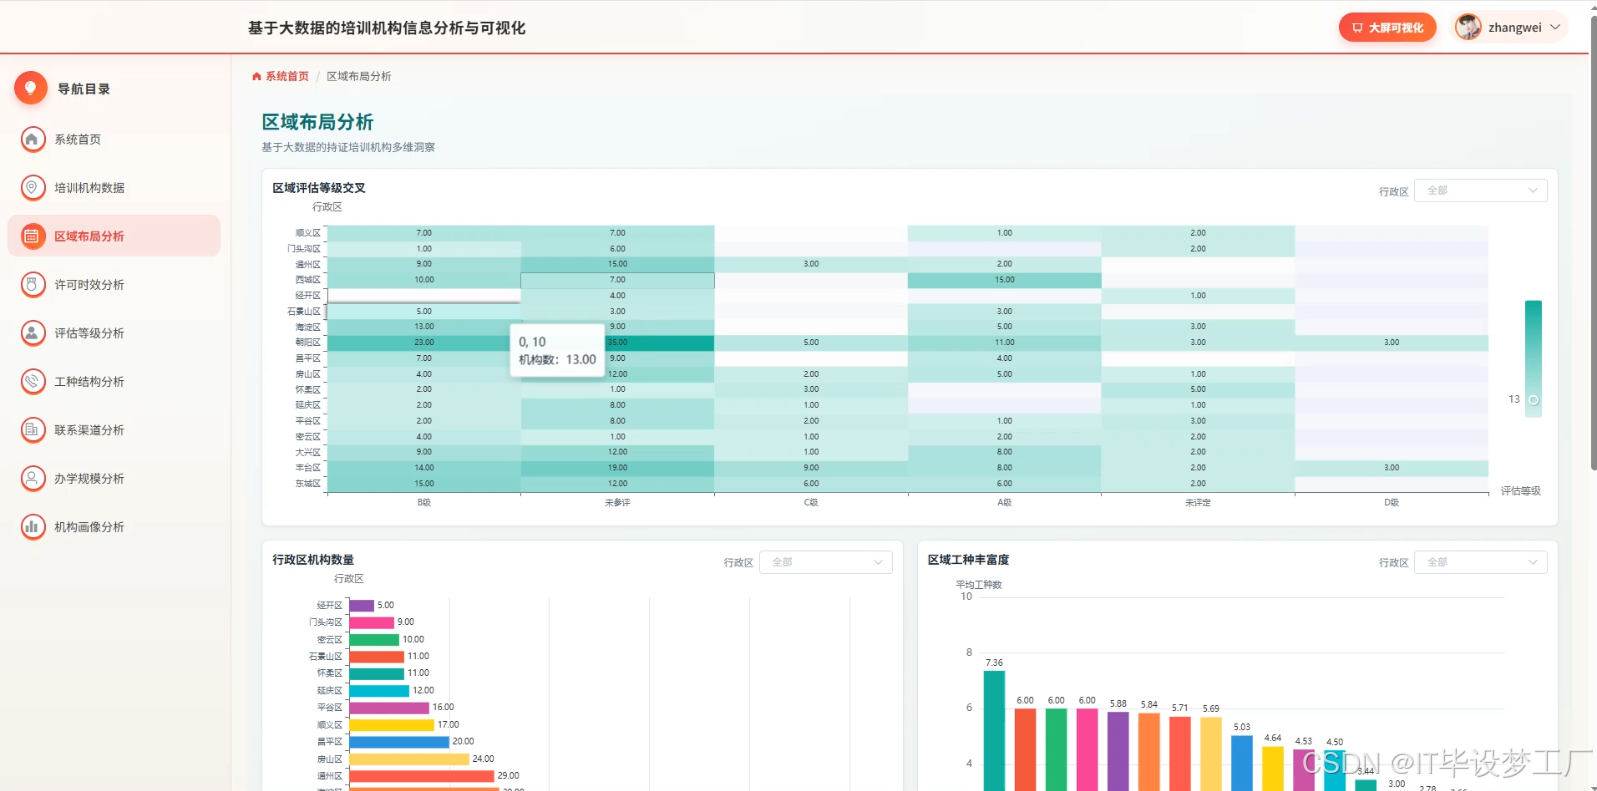
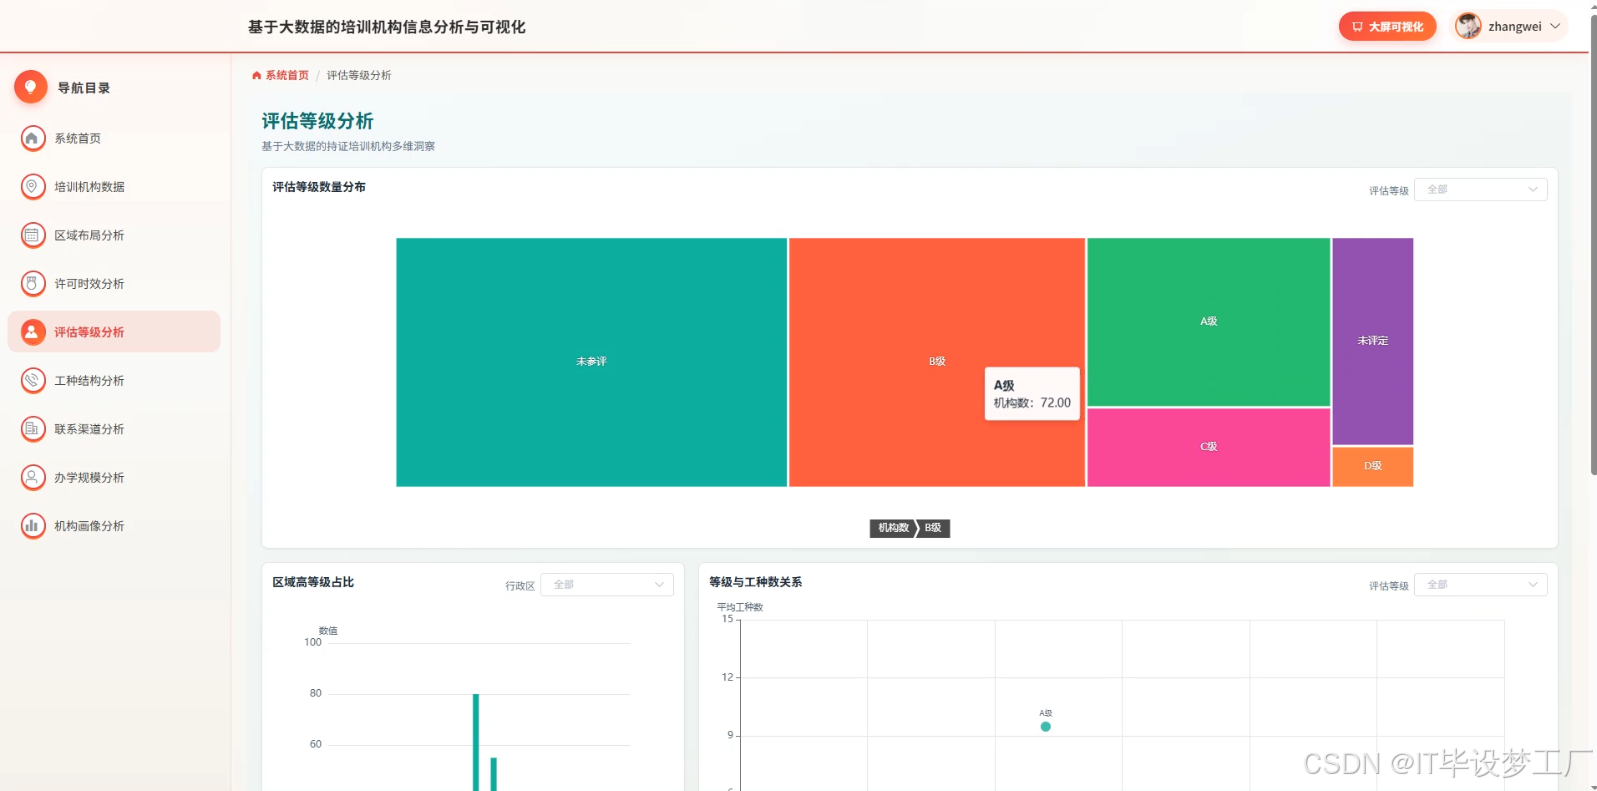
本系统名为《基于大数据的培训机构信息分析与可视化》,主要围绕培训机构相关数据展开分析与展示。系统采用 Hadoop 和 HDFS 做数据存储基础,使用 Spark、Spark SQL 对培训机构数据进行读取、清洗、聚合和统计,后端支持 Python+Django 与 Java+Spring Boot 两个版本,前端使用 Vue、ElementUI、Echarts、HTML、CSS、JavaScript、jQuery 完成页面交互与图表展示,数据库使用 MySQL 保存分析结果和用户信息。系统功能包括系统首页、大屏可视化、用户管理、培训机构数据、区域布局分析、许可时效分析、评估等级分析、工种结构分析、联系渠道分析、办学规模分析、机构画像分析、个人信息和修改密码。通过这些功能,可以把培训机构在不同区域的分布情况、许可到期情况、评估等级、工种结构、联系渠道、办学规模和机构画像等内容用图表方式呈现出来,方便用户快速查看数据特征,也方便毕业设计过程中理解大数据分析从存储、计算到可视化的完整流程。
二、开发环境
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
三、系统界面展示
- 基于大数据的培训机构信息分析与可视化系统界面展示:
四、部分代码设计
- 项目实战-代码参考:
python
spark = SparkSession.builder.appName("TrainingOrgAnalysis").master("local[*]").config("spark.sql.warehouse.dir","hdfs://localhost:9000/user/hive/warehouse").getOrCreate()
def region_layout_analysis():
    df = spark.read.option("header", True).csv("hdfs://localhost:9000/training/org_info.csv")
    df.createOrReplaceTempView("org_info")
    region_df = spark.sql("""
        SELECT region, COUNT(*) AS org_count,
               SUM(CASE WHEN scale_level='大型' THEN 1 ELSE 0 END) AS large_count,
               SUM(CASE WHEN scale_level='中型' THEN 1 ELSE 0 END) AS medium_count,
               SUM(CASE WHEN scale_level='小型' THEN 1 ELSE 0 END) AS small_count,
               AVG(CAST(evaluate_score AS DOUBLE)) AS avg_score
        FROM org_info
        GROUP BY region
    """)
    total = region_df.agg(sum("org_count").alias("total_count")).collect()[0]["total_count"]
    result = region_df.withColumn("org_ratio", round(col("org_count") / total * 100, 2))
    result = result.withColumn("layout_level", when(col("org_ratio") >= 30, "集中").when(col("org_ratio") >= 15, "较集中").otherwise("分散"))
    result = result.orderBy(col("org_count").desc())
    result.write.mode("overwrite").format("jdbc").option("url","jdbc:mysql://localhost:3306/training_analysis").option("dbtable","region_layout_result").option("user","root").option("password","123456").save()
    chart_data = result.select("region","org_count","large_count","medium_count","small_count","avg_score","org_ratio","layout_level").toPandas()
    chart_data["avg_score"] = chart_data["avg_score"].round(2)
    return chart_data.to_dict(orient="records")
def license_validity_analysis():
    df = spark.read.option("header", True).csv("hdfs://localhost:9000/training/license_info.csv")
    df = df.withColumn("start_date", to_date(col("start_date"), "yyyy-MM-dd"))
    df = df.withColumn("end_date", to_date(col("end_date"), "yyyy-MM-dd"))
    df = df.withColumn("remain_days", datediff(col("end_date"), current_date()))
    df = df.withColumn("valid_status", when(col("remain_days") < 0, "已过期").when(col("remain_days") <= 90, "即将到期").otherwise("有效"))
    df.createOrReplaceTempView("license_info")
    status_df = spark.sql("SELECT region, valid_status, COUNT(*) AS license_count FROM license_info GROUP BY region, valid_status")
    pivot_df = status_df.groupBy("region").pivot("valid_status", ["有效","即将到期","已过期"]).sum("license_count").fillna(0)
    pivot_df = pivot_df.withColumn("total_count", col("有效") + col("即将到期") + col("已过期"))
    pivot_df = pivot_df.withColumn("expire_ratio", round((col("即将到期") + col("已过期")) / col("total_count") * 100, 2))
    pivot_df = pivot_df.withColumn("warning_level", when(col("expire_ratio") >= 40, "高").when(col("expire_ratio") >= 20, "中").otherwise("低"))
    pivot_df = pivot_df.orderBy(col("expire_ratio").desc())
    pivot_df.write.mode("overwrite").format("jdbc").option("url","jdbc:mysql://localhost:3306/training_analysis").option("dbtable","license_validity_result").option("user","root").option("password","123456").save()
    result = pivot_df.toPandas()
    return result.to_dict(orient="records")
def organization_profile_analysis():
    org_df = spark.read.option("header", True).csv("hdfs://localhost:9000/training/org_info.csv")
    job_df = spark.read.option("header", True).csv("hdfs://localhost:9000/training/job_structure.csv")
    contact_df = spark.read.option("header", True).csv("hdfs://localhost:9000/training/contact_channel.csv")
    org_df.createOrReplaceTempView("org_info")
    job_df.createOrReplaceTempView("job_structure")
    contact_df.createOrReplaceTempView("contact_channel")
    profile_df = spark.sql("""
        SELECT o.org_id, o.org_name, o.region, o.scale_level, o.evaluate_level,
               COUNT(DISTINCT j.job_type) AS job_type_count,
               COUNT(DISTINCT c.channel_type) AS contact_channel_count,
               MAX(o.student_count) AS student_count
        FROM org_info o
        LEFT JOIN job_structure j ON o.org_id = j.org_id
        LEFT JOIN contact_channel c ON o.org_id = c.org_id
        GROUP BY o.org_id, o.org_name, o.region, o.scale_level, o.evaluate_level
    """)
    profile_df = profile_df.withColumn("scale_tag", when(col("student_count") >= 1000, "大规模").when(col("student_count") >= 300, "中规模").otherwise("小规模"))
    profile_df = profile_df.withColumn("job_tag", when(col("job_type_count") >= 8, "工种丰富").when(col("job_type_count") >= 4, "工种适中").otherwise("工种单一"))
    profile_df = profile_df.withColumn("contact_tag", when(col("contact_channel_count") >= 3, "渠道多元").otherwise("渠道较少"))
    profile_df = profile_df.withColumn("profile_label", concat_ws("-", col("region"), col("scale_tag"), col("evaluate_level"), col("job_tag"), col("contact_tag")))
    profile_df.createOrReplaceTempView("org_profile")
    label_df = spark.sql("SELECT profile_label, COUNT(*) AS org_count FROM org_profile GROUP BY profile_label ORDER BY org_count DESC")
    label_df.write.mode("overwrite").format("jdbc").option("url","jdbc:mysql://localhost:3306/training_analysis").option("dbtable","org_profile_result").option("user","root").option("password","123456").save()
    result = profile_df.select("org_id","org_name","region","profile_label","student_count","job_type_count","contact_channel_count").toPandas()
    return result.to_dict(orient="records")
五、论文参考
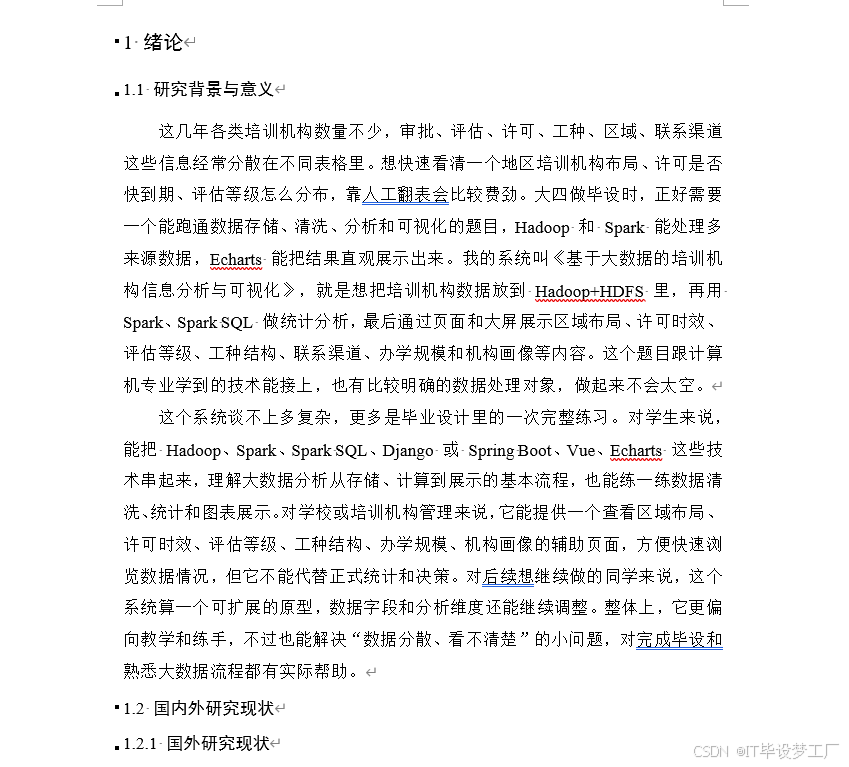
- 计算机毕业设计选题推荐-基于大数据的培训机构信息分析与可视化系统-论文参考:
六、系统视频
- 基于大数据的培训机构信息分析与可视化系统-项目视频:
项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的培训机构信息分析与可视化|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇