一、再谈端口号
端口号本质:16 位无符号整数,范围 0~65535,用来标识一台主机内部不同的应用进程。
IP 地址:定位主机;端口号:定位主机里面的进程。套接字 = IP: 端口,唯一标识网络中的一个进程。
端口号范围划分
- 熟知端口(0 ~ 1023,Well-Known) 固定分配给一些标准服务,由 IANA 统一规定。
- 21:FTP 文件传输
- 22:SSH 远程登录
- 80:HTTP
- 53:DNS(DNS 查询默认 UDP)
- 登记端口(1024 ~ 49151) 没有固定分配,第三方应用注册使用。
- 短暂端口(49152 ~ 65535) 客户端临时使用,通信结束自动释放。客户端发起请求时,操作系统随机分配。
端口号是传输层的概念,网络层、数据链路层没有端口号。
两个经典问题
- 一个进程是否可以bind多个端口号?
可以
- 一个端口号是否可以被多个进程bind?
不可以
二、UDP 协议
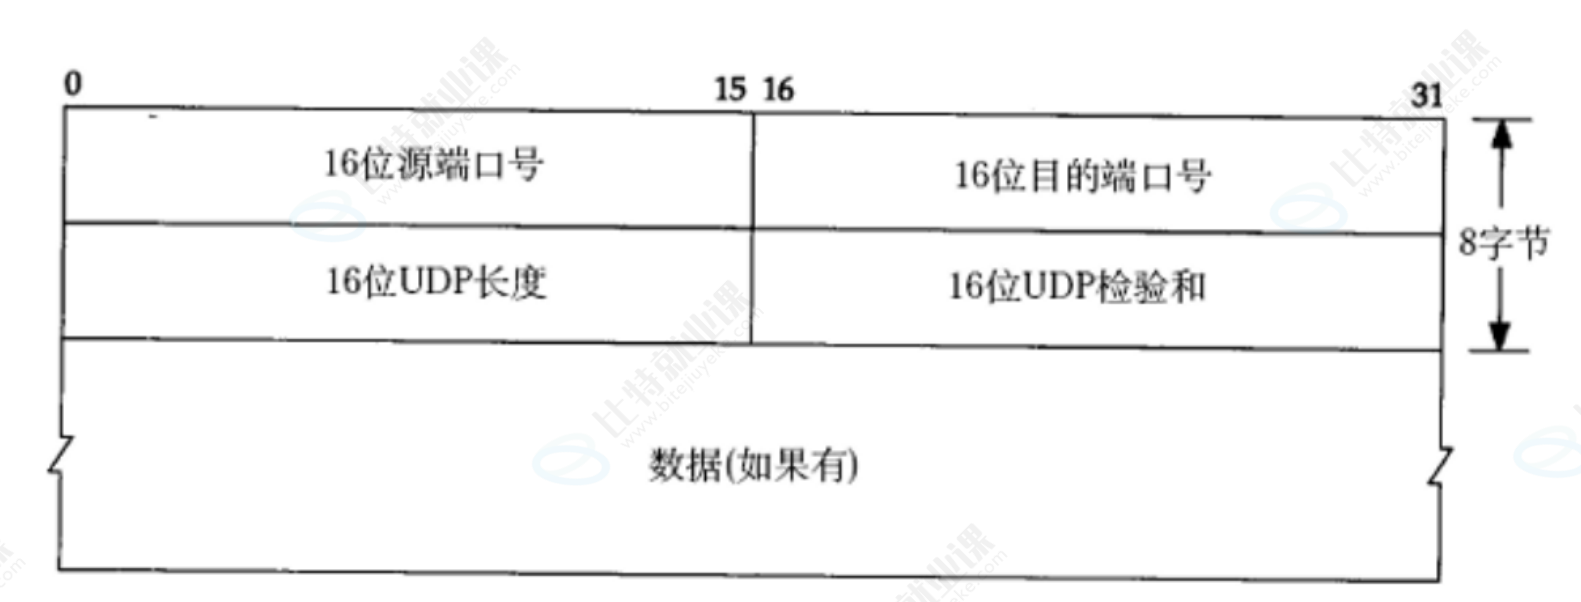
UDP:User Datagram Protocol,无连接、不可靠、面向数据报的传输层协议。
UDP 的特点
- 无连接:通信前不需要像 TCP 一样三次握手建立连接,发数据直接封装报文发给对方,开销小、延迟低。
- 不可靠传输:没有确认应答、超时重传、流量控制、拥塞控制。报文丢了、乱序,UDP 本身不会处理。
- 面向数据报 :应用层交给 UDP 多大的数据,UDP 就原样打包发送,不会拆分 / 合并。一次 recvfrom 只能读取一个完整报文。
- 头部开销极小:固定 8 字节,对比 TCP 最少 20 字节头部。
- 支持一对多:支持广播、组播。
我们注意到, UDP协议首部中有一个16位的最大长度. 也就是说一个UDP能传输的数据最大长度是 64K(包含UDP首部). 然而64K在当今的互联网环境下, 是一个非常小的数字. 如果我们需要传输的数据超过64K, 就需要在应用层手动的分包, 多次发送, 并在接收端手动拼装;
1.为什么我们写socket地时候,port是16位的????
传输层协议(TCP/UDP)规定,报文首部的端口字段固定为 16bit。所以端口范围 0~65535。Socket 传入的端口号,最终由内核填充进传输层报文头部。
2.报头和载荷要如何分离&&有效载荷分用问题
udp采用固定长度的报头
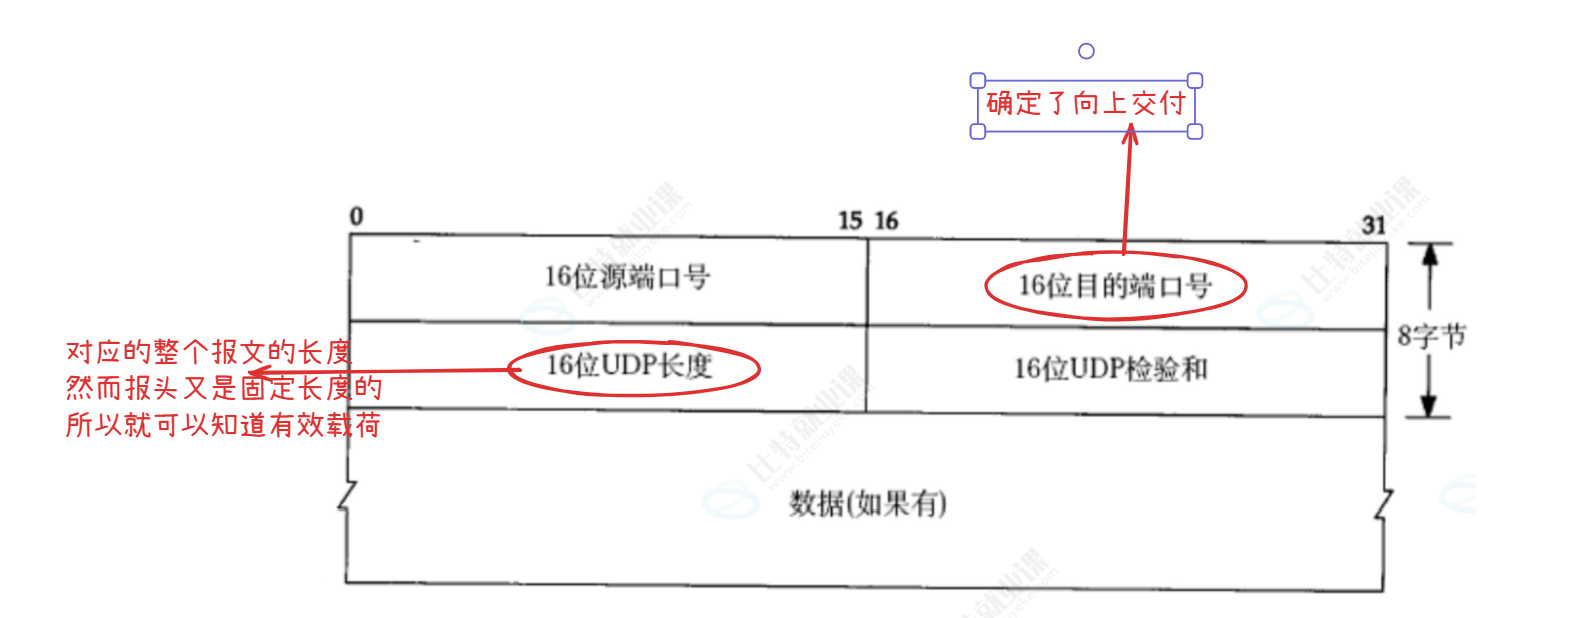
UDP 首部结构非常简洁,仅 8 字节。 目的端口号是向上交付的关键,主机收到 UDP 报文后,传输层根据目的端口号,把报文交给对应的应用进程。 UDP 长度字段记录整个 UDP 报文(首部 + 数据)的总字节数。因为 UDP 首部固定为 8 字节,所以有效数据载荷的大小 = UDP 长度 − 8。当 UDP 长度 = 8 时,代表报文只有首部,不带任何应用数据。 检验和用来检测报文在传输过程中是否发生比特错误;一旦校验失败,报文直接丢弃,UDP 不会发送错误通知给发送端。
3.udp存不存在粘包问题
不存在,udp->用户数据报协议
UDP 是面向数据报的协议。应用层每调用一次发送接口,就生成一个独立 UDP 报文;接收端调用一次recvfrom,只会读取一个完整的数据报。报文之间边界由内核严格区分,不会出现多个数据包粘连合并在一起的情况。
对比:TCP 是面向字节流,没有报文边界,因此会产生粘包问题。 补充注意:UDP 虽然没有粘包,但存在丢包、乱序问题。
4.如何理解udp协议报头的
将其看作结构体,操作系统内部,c写的,双方可以互传结构体变量
可以把 UDP 报文头部理解成操作系统内核 C 语言里定义的结构体。 内核在封装 UDP 报文时,填充结构体里的源端口、目的端口、长度、校验和这四个成员;收到报文时,按照这个结构体格式解析读取字段。
5.如何理解封装过程
开辟缓冲区,将内容写入,将最开始地指针往前移动,填写报文描述内容地基本信息
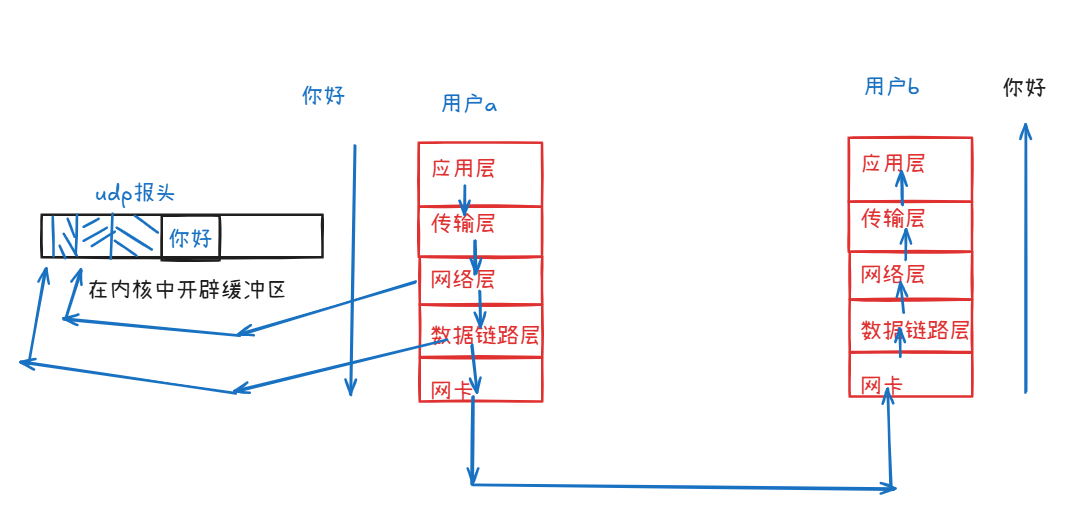
也就是说封装本质上是对结构体变量的拷贝
应用层产生数据之后,数据会逐层向下交付,每经过一层,都会在数据头部新增本层协议首部 ,这个过程就叫做封装。操作系统内核会预先开辟一块缓冲区,先把上层数据写入缓冲区,再把缓冲区起始指针向前移动,在前面填入当前协议的头部信息(结构体字段)。封装本质上就是内核把各层协议头部结构体 + 用户数据拷贝到同一块内核缓冲区。
6.如何理解报文,重新理解封装,进一步理解
在操作系统内核中,网络报文不只是单纯一段二进制字节流。系统里会同时存在大量报文,它们处于不同状态(正在封装、等待发送、接收中、待解包等)。内核需要一套机制来描述、管理和组织这些报文,Linux 内核中使用 struct sk_buff(套接字缓冲区)这个结构体来描述一个报文。
sk_buff 结构体内部维护了多组指针,指向缓冲区里协议头与数据的位置。整个封装和解封装的过程,本质上就是移动 sk_buff 内部指针,而不是频繁拷贝内存数据。 封装:向下逐层添加协议头,向前移动指针; 解封装:向上逐层剥离协议头,向后移动指针。报文本身的内存数据尽量不做复制,只修改结构体指针,以此提升内核网络栈性能。
同时大量 sk_buff 对象会通过链表这类数据结构组织起来,形成报文队列,方便内核调度、收发。
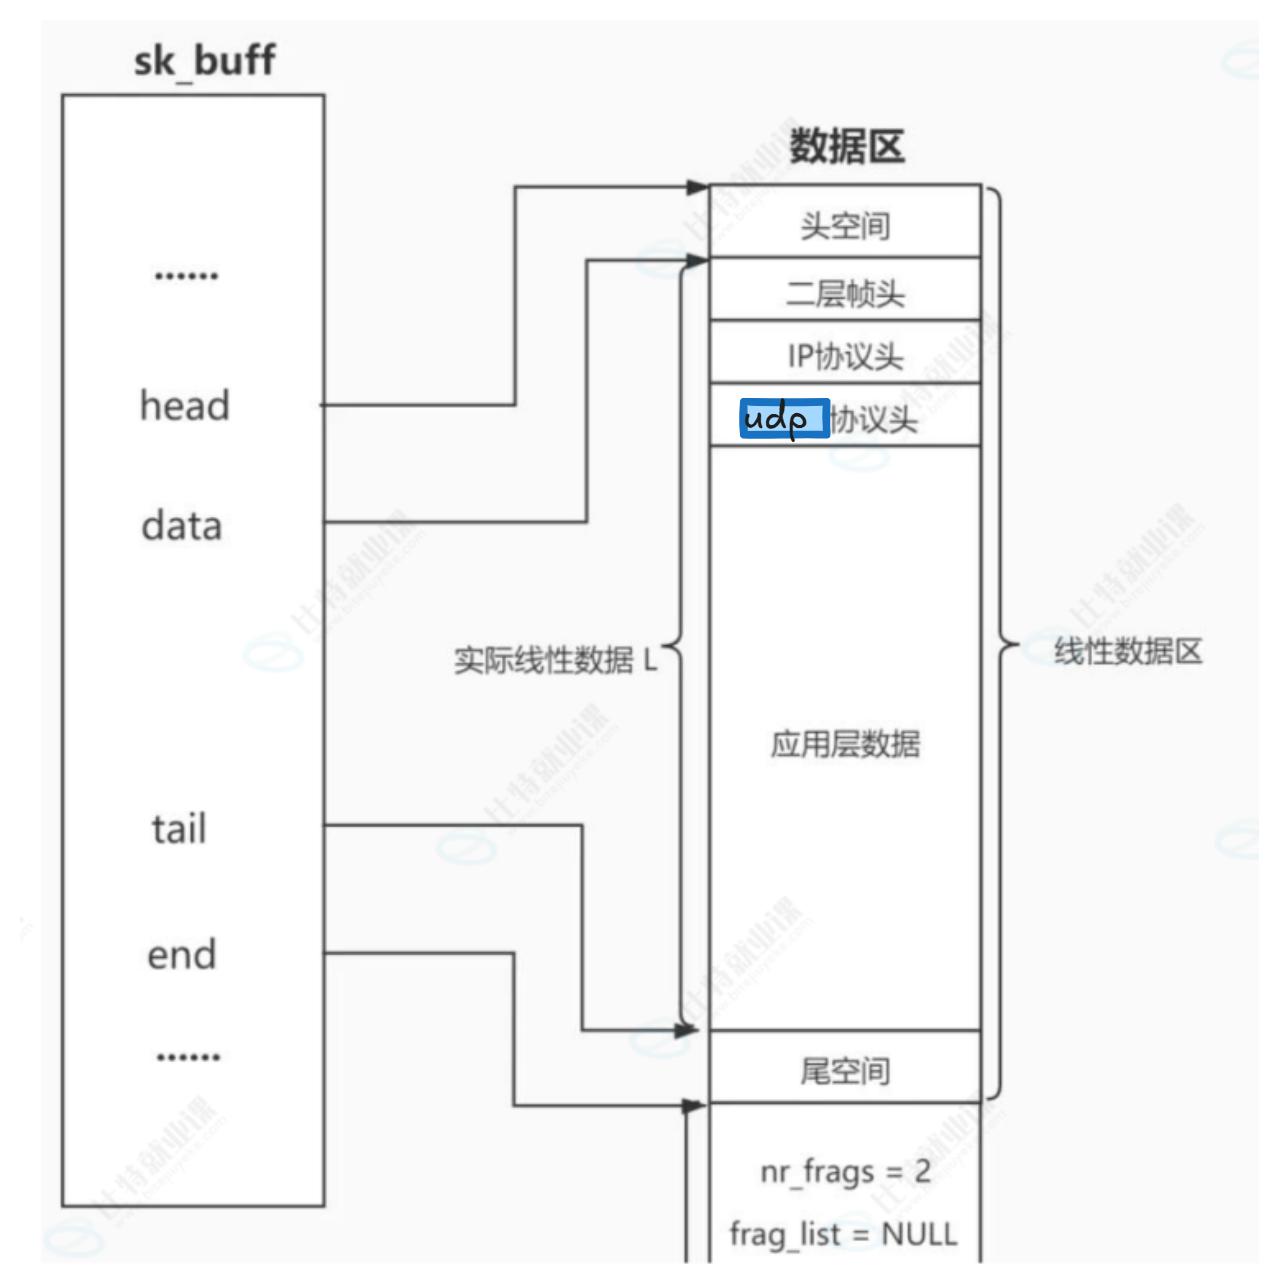
报文贯穿协议,封装和解包地过程,就是对于一个结构体指针地移动
7.当我们收到一个报文的时候,我们是如何做到用文件原理,读到数据应用层
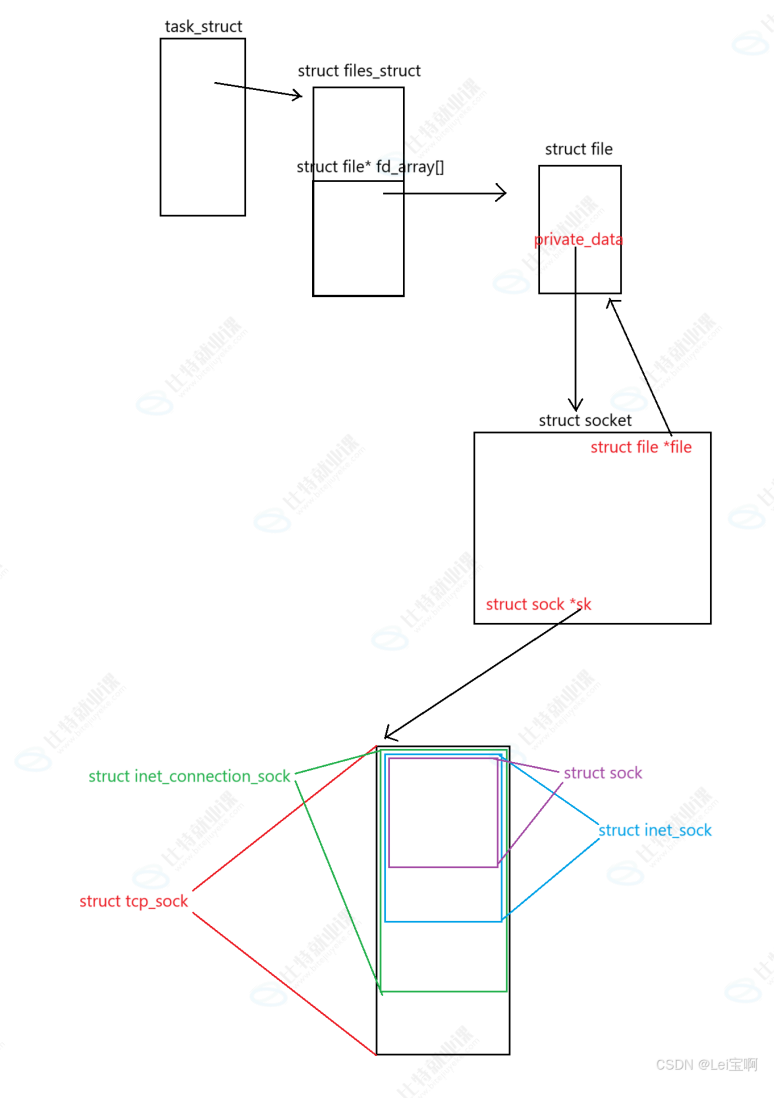
Linux 有一句核心思想:一切皆文件,Socket 本质上也是一个文件描述符(fd),
- 进程
task_struct里面维护files_struct,files_struct内部有fd_array[]数组,数组下标就是文件描述符 fd。数组里面存放struct file*指针,指向这个打开的文件对象。我们调用socket()创建套接字时,内核会创建一个struct file结构体,并且把它挂到进程的 fd 数组里。struct file里面有成员private_data,指向struct socket结构体,把普通文件和套接字区分开。struct socket里面有struct sock *sk,struct sock是网络层套接字核心结构体。对于 UDP/TCP,会通过继承的方式扩展出inet_sock,再细分出tcp_sock/inet_connection_sock,存放协议相关参数、接收缓冲区。网卡收到报文,内核产生中断,把报文封装成
sk_buff,放到对应sock的接收缓冲区。应用程序调用
recvfrom()/read(),本质就是对 Socket 这个文件描述符发起读文件操作:
- 系统调用会根据 fd 找到进程
fd_array里对应的struct file;- 通过
private_data拿到struct socket,再找到struct sock;- 从
sock的接收缓冲区取出sk_buff报文,把报文的数据拷贝到应用层提供的用户缓冲区;- 内核移除这份
sk_buff,完成读取。
8.udp协议既然不可靠,为什么还要有它???
首先要厘清概念:UDP 的 "不可靠" 并不是说数据一定会传不过去,而是UDP 本身不做丢包检测、超时重传、流量控制、拥塞控制,丢包之后 UDP 不会自动重发。 TCP 的 "可靠",就是依靠确认应答、超时重传等机制,保证数据完整、有序地交付给应用层。
UDP 的特点:协议头部极简(仅 8 字节),没有发送缓冲区,但拥有接收缓冲区。接收缓冲区只负责暂存到达的报文,UDP 不保证报文到达的先后顺序。
正因为 UDP 省去了 TCP 复杂的握手、重传、拥塞控制逻辑,开销极小、延迟低。很多场景下,我们更看重低延迟,丢少量数据影响不大,就适合使用 UDP:
- 音视频通话、直播、游戏实时画面(丢一两帧画面人感知不强,但是不能等待重传带来卡顿)
- DNS 域名解析(请求报文很短,追求快速响应)
- TFTP 简单文件传输
对于实时性要求高,用户体量大的场景