从这篇开始,我们正式踏进线程同步与互斥的章节。内容跟前面的线程篇一脉相承,接得严丝合缝。这篇先把互斥量的概念和接口操作讲清楚,下一篇再往下深挖,拆解它的原理与封装。好,我们开始吧。
目录
[1.1 理解进程与线程的互斥需求](#1.1 理解进程与线程的互斥需求)
[1.2 互斥量mutex------解决并发访问冲突](#1.2 互斥量mutex——解决并发访问冲突)
[1.2.1 多线程并发为什么会产生问题](#1.2.1 多线程并发为什么会产生问题)
[1.2.2 从"抢票"看操作的非原子性](#1.2.2 从“抢票”看操作的非原子性)
[1.2.3 多线程并发下的问题是如何一步步发生的](#1.2.3 多线程并发下的问题是如何一步步发生的)
[1.2.4 从并发问题引出互斥锁](#1.2.4 从并发问题引出互斥锁)
[1.3 mutex的核心接口------初始化、加锁与解锁](#1.3 mutex的核心接口——初始化、加锁与解锁)
[1.3.1 互斥量的初始化与销毁](#1.3.1 互斥量的初始化与销毁)
[1.3.2 互斥量如何加锁与解锁](#1.3.2 互斥量如何加锁与解锁)
[1.3.2.1 加锁时,执行流究竟发生了什么](#1.3.2.1 加锁时,执行流究竟发生了什么)
[1.3.3 互斥锁的本质------如何保证临界区原子性](#1.3.3 互斥锁的本质——如何保证临界区原子性)
[1.3.4 进程间互斥锁------如何实现跨进程同步](#1.3.4 进程间互斥锁——如何实现跨进程同步)
[1.3.4.1 实现思路与核心要点](#1.3.4.1 实现思路与核心要点)
[1.3.4.2 结合代码理解具体实现](#1.3.4.2 结合代码理解具体实现)
[1.4 给抢票程序加上互斥锁](#1.4 给抢票程序加上互斥锁)
[1.5 关于互斥锁,还需要思考什么](#1.5 关于互斥锁,还需要思考什么)
[1.5.1 关于锁机制的两个核心问题](#1.5.1 关于锁机制的两个核心问题)
[1.5.2 用"超级自习室"理解临界区与原子性](#1.5.2 用“超级自习室”理解临界区与原子性)
一、线程互斥------为什么需要一把锁
1.1 理解进程与线程的互斥需求
多线程最迷人的地方,是它们共享同一片地址空间;最危险的地方,也是它们共享同一片地址空间。线程们挤在同一个进程里,代码段、数据段、堆区,统统共用。你定义一个全局变量,所有线程都能伸手去摸;你malloc一块内存,谁都可以往里写。这本来是好事,协作零成本。可一旦多个线程同时去碰同一份数据,麻烦就来了。
想象一个最简单的场景:一个全局整型count,两个线程各自对它做一万次count++。你心里盘算,最后应该是两万。跑起来一看,一万四千多,少了一大截。为什么?因为count++这行代码,在汇编层面根本不是一步完成的。它至少拆成三步:从内存读进寄存器,寄存器里加一,再写回内存。两个线程如果同时踩进这个流程,甲刚读完,还没写回,乙也读走了同一个旧值。两人各自加一,再分别写回,结果只涨了一次。好好的两万,就这么被吞了。
这种"多个执行流并发访问共享资源,最终结果取决于谁先谁后"的现象,就是竞态条件(Race Condition)。根源在于,对共享资源的访问不是原子的,中间能被切走,能被插队。
要解决它,就得立规矩:任何时刻,只允许一个线程进入那段会碰共享资源的代码。 这就是互斥。
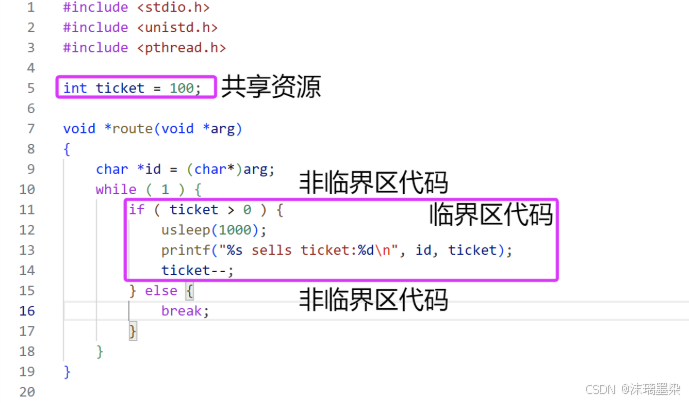
那段会碰共享资源的代码,我们给它一个名字,临界区 。而那份被多线程争抢的资源,就叫临界资源 。这些概念,其实我们在信号量那篇已经埋过伏笔,今天算是正式接上了。规矩怎么立?最常用的工具,就是互斥量(Mutex)。它像一把锁,线程进临界区之前先加锁,出来再解锁。锁在谁手里,谁才有资格动共享数据。其他人?门口等着。
1.2 互斥量mutex------解决并发访问冲突
1.2.1 多线程并发为什么会产生问题
大多数情况下,线程用的数据都是局部变量。这些变量的地址空间就在线程自己的栈里,归属单一,别的线程想碰也碰不到。可有时候,很多变量需要在多个线程之间共享。这类变量,我们叫它共享变量。线程之间靠共享数据来交互、来协作,听起来挺美。
但多个线程并发地操作同一个共享变量,麻烦就来了。我们用一段模拟抢票的demo来验证一下:
cpp
#include <stdio.h>
#include <unistd.h>
#include <pthread.h>

int ticket = 100;

void *route(void *arg)
{
    char *id = (char*)arg;
    while ( 1 ) {
        if ( ticket > 0 ) {
            usleep(1000);
            printf("%s sells ticket:%d\n", id, ticket);
            ticket--;
        } else {
            break;
        }
    }
}

int main( void )
{
    pthread_t t1, t2, t3, t4;

    pthread_create(&t1, NULL, route, (void*)"thread 1");
    pthread_create(&t2, NULL, route, (void*)"thread 2");
    pthread_create(&t3, NULL, route, (void*)"thread 3");
    pthread_create(&t4, NULL, route, (void*)"thread 4");

    pthread_join(t1, NULL);
    pthread_join(t2, NULL);
    pthread_join(t3, NULL);
    pthread_join(t4, NULL);
}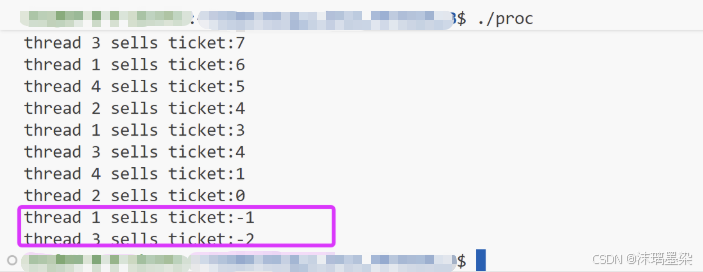
四个线程,一起抢这100张票。逻辑看着严丝合缝:先判断ticket > 0,再打印,再减一。跑起来你就等着看吧,票数会莫名其妙地卖成负数,或者同一个票号被好几个线程重复卖出。四个线程抢得越欢,数据错得越离谱。
为什么?因为if (ticket > 0)、printf、ticket--这三步,中间任何一处都可能被切走。一个线程刚判断完"还有票",还没来得及减,另一个线程也判断"还有票"。两人各卖各的,结果票号重复,余额超卖。这正是我们前面说的竞态条件,活生生的现场。
1.2.2 从"抢票"看操作的非原子性
为什么票会卖成负数?三个原因,一环扣一环:
- 第一,if判断为真之后,代码随时可能被切走。 你刚确认"还有票",CPU时间片一到,控制权就被内核收走,交给别的线程了。判断和执行之间,裂开一道口子。
- 第二,usleep模拟了一段漫长的业务过程。 在这段"漫长"的时间里,其他线程可不会干等着。它们一个接一个地冲进这段代码,全都看到"还有票",全都以为自己能卖。
- 第三,ticket--这步操作,本身就不是原子的。 很多人以为它是一步完成的,其实不是。反汇编一看便知:
cpp
152  40064b: 8b 05 e3 04 20 00    mov  0x2004e3(%rip),%eax   # 600b34 <ticket>
153  400651: 83 e8 01             sub  $0x1,%eax
154  400654: 89 05 da 04 20 00    mov  %eax,0x2004da(%rip)   # 600b34 <ticket>
就这一行ticket--,拆开是三条汇编指令:
- load:把共享变量ticket从内存加载到寄存器。
- update:在寄存器里执行减一操作。
- store:把新值从寄存器写回ticket所在的内存地址。
三步走,中间任何一步都可能被切走。甲线程load完还没store,乙线程也load了同一个旧值。两人各自减一,各自写回,结果只减了一次。票就这么卖多了,余额就这么穿底了。
先把一个结论撂在这儿:单条汇编语句是原子的。 但ticket--不是单条,它是三条。原子性的边界,就卡在这个细节上。
1.2.3 多线程并发下的问题是如何一步步发生的
ticket--的操作分三步,对应三句汇编:
- load:把共享变量 ticket 从内存加载到寄存器。
- update:在寄存器里执行减一。
- store:把新值从寄存器写回 ticket 的内存地址。
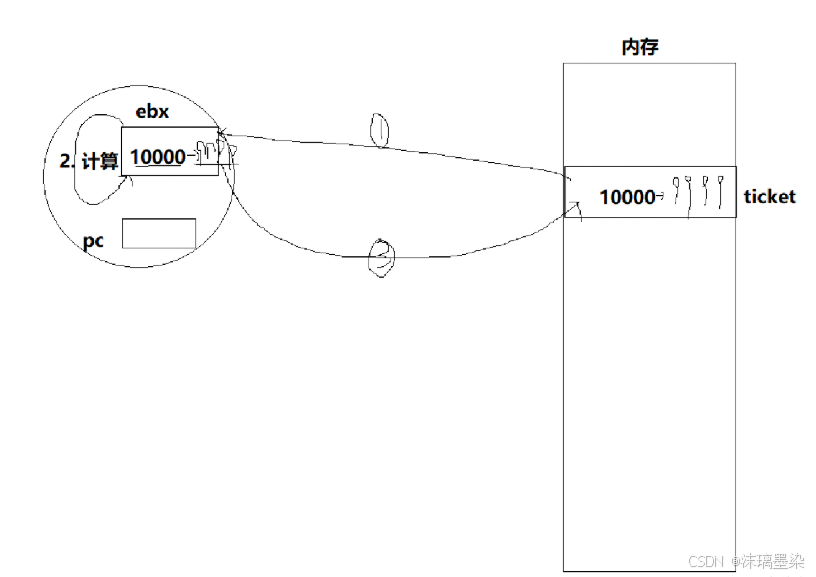
下面两个场景,把这三步被切碎之后会发生什么,演得明明白白。
场景一:条件穿透与连续扣减
当ticket = 1时,线程1到4全都通过了if判断,进入usleep挂起。随后它们被陆续唤醒,一场混乱就此拉开:
- 线程1挂起在写回前:它执行完load(读到1)和update(算得0),还没store就被切走。上下文里%eax = 0被保存下来,内存里却还是1。
- 线程2率先清零:它完整走完load(1)→ update(0)→ store,内存变成0。
- 线程3扣成负数:线程3醒来,直接load到当前内存里的0,update得-1,store写回,内存变成-1。
- 线程4继续往下扣:load(-1)→ update(-2)→ store,内存变成-2。
- 线程1覆写掩盖异常:线程1恢复运行,拿着当初保存的旧上下文(%eax = 0),直接一个 store 把0写回内存,把后面几个线程的计算结果全盖掉了。
场景二:上下文还原导致的数据覆写
- 步骤1(线程A载入旧值后被切走):假设内存里ticket = 100。线程A执行load,把100读进自己的寄存器%eax。正准备update,时间片耗尽,线程A被挂起,系统把它的上下文保存起来------%eax = 100。
- 步骤2(线程 B 持续扣减):线程B被调度上来,连着做了好几次ticket--,把内存里的ticket从100一路扣到了10。
- 步骤3(线程A恢复上下文覆写内存):线程A再次被调度,系统恢复它的上下文,%eax重新变回100。线程A从被打断的update处接着跑,100 - 1 = 99,然后store把99写回内存。
结果就是:线程B辛辛苦苦扣到10的成果,一瞬间被抹掉了,内存里的ticket倒退回99。并发数据覆盖,就是这么发生的。
1.2.4 从并发问题引出互斥锁
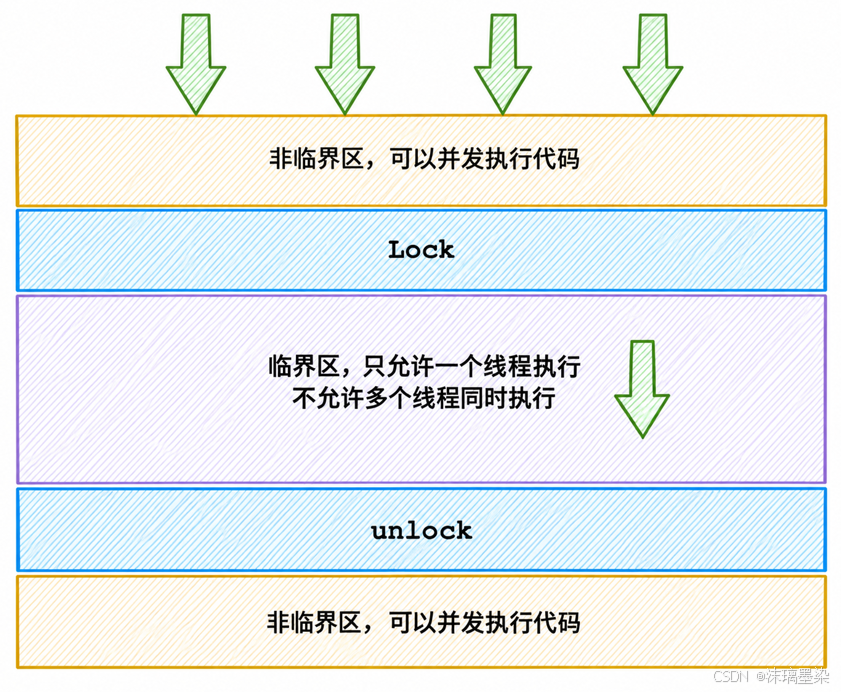
要治住上面这团乱麻,得守住三条规矩:
-
代码必须有互斥行为:一个线程进了临界区,其他线程就得在门外候着,谁也不许闯进来。
-
同一时刻只放一个进去:多个线程同时想进临界区,而里面恰好没人,那也只能放一个进去,不能一拥而上。
-
不占着茅坑不拉屎:线程不在临界区里干活,就没有资格拦着别人进去。
说到底,这三条规矩拧成一股绳,就是要一把锁。Linux给这把锁起了个名字------互斥量。
1.3 mutex的核心接口------初始化、加锁与解锁
加锁这件事,有个原则得先记住:粒度尽量细。 锁的范围能收多紧就收多紧,别把一大堆跟临界区无关的代码也圈进去。圈得越大,并发度越低,线程们排队等锁的时间就越长,得不偿失。
1.3.1 互斥量的初始化与销毁
多线程里用互斥锁,头文件得先请进来:pthread.h。互斥量的类型,叫pthread_mutex_t。初始化它,有两条路。
**静态分配:**用宏PTHREAD_MUTEX_INITIALIZER,直接给全局或静态互斥量做初始化。写法很干脆:
cpp
pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER;这种静态初始化的互斥量,不用你手动销毁,程序跑完自己就收拾了,省心。
**动态分配:**调pthread_mutex_init函数来初始化。
cpp
int pthread_mutex_init(pthread_mutex_t *restrict mutex,
const pthread_mutexattr_t *restrict attr);- mutex:指向要初始化的那个互斥量对象。
- attr:互斥量的属性设置。平时传 NULL,用默认属性就够。
有初始化,就有销毁。销毁互斥量,靠的是pthread_mutex_destroy:
cpp
int pthread_mutex_destroy(pthread_mutex_t *mutex);销毁这件事,有几条规矩不能破:
- 用PTHREAD_MUTEX_INITIALIZER静态初始化的互斥量,不需要销毁,程序结束自动释放。
- 千万别销毁一个还处于加锁状态的互斥量。锁还攥在别人手里,你把锁砸了,这不是添乱吗?
- 已经被销毁的互斥量,必须确保后续再没有任何线程尝试去锁它。用过期的锁,行为不可预测,后果自负。
1.3.2 互斥量如何加锁与解锁
互斥量的加锁与解锁,核心就三个接口:
**阻塞加锁:**int pthread_mutex_lock(pthread_mutex_t *mutex);
**非阻塞加锁:**int pthread_mutex_trylock(pthread_mutex_t *mutex);
**解锁操作:**int pthread_mutex_unlock(pthread_mutex_t *mutex);
返回值统一:成功返回0,失败返回错误号。
1.3.2.1 加锁时,执行流究竟发生了什么
调用pthread_mutex_lock申请锁的时候,执行流会面临两种局面:
**获取成功:**互斥量当前没被锁,函数一把将它锁住,返回成功。持锁成功的线程,可以继续往后跑,放心大胆地访问临界区代码和临界资源。
**获取失败与阻塞:**如果互斥量已经被别的线程锁住了,或者好几个线程同时抢锁、自己没抢到,那pthread_mutex_lock就会让当前线程陷入阻塞,执行流被挂起,安静等着,直到互斥量被释放、解锁,它才有机会重新竞争。
1.3.3 互斥锁的本质------如何保证临界区原子性
锁本身,也是一种临界资源。 为什么?因为竞争申请锁的时候,所有多线程都得先"看见"这把锁。看不见,就谈不上抢。既然大家都盯着同一个东西,那它天然就是被争抢的对象,自然也是临界资源。
加锁和解锁的过程,必须是原子的。 这一点没得商量。无论pthread_mutex_lock、pthread_mutex_trylock还是pthread_mutex_unlock,内部操作都得是原子级的,一气呵成,中间不能被切走。不然,锁自己都锁不住自己,还怎么去锁别人?
锁的核心能力是什么? 一句话:把临界区代码的执行,从并行变成串行。 持锁线程在临界区里干活的时候,没人能打扰它,它的操作不会被打断。这,其实就是一种变相的原子性,本来不是原子的那串代码,被锁一包,对外看起来就成了一个整体。
1.3.4 进程间互斥锁------如何实现跨进程同步
互斥锁默认的管辖范围,只限于进程内部,属性是PTHREAD_PROCESS_PRIVATE。可要是把它跟共享内存(shm)搭在一起,再配上进程间共享属性,就能把锁的势力范围扩展到多个进程之间,实现跨进程的同步与互斥。
1.3.4.1 实现思路与核心要点
**首地址挂载锁结构:**把共享内存的首地址强制类型转换一下,比如(pthread_mutex_t *)shm,直接当互斥锁对象使。所有映射了这块共享内存的进程,看到的都是同一把锁。
**修改共享属性:**初始化锁之前,必须先通过pthread_mutexattr_setpshared把属性设成 PTHREAD_PROCESS_SHARED。不设,锁就只认自己人,跨进程免谈。
**避免静态初始化:**共享内存里的锁,只能用pthread_mutex_init动态初始化,PTHREAD_MUTEX_INITIALIZER 那个宏在这儿不管用。
1.3.4.2 结合代码理解具体实现
cpp
#include <stdio.h>
#include <unistd.h>
#include <sys/mman.h>
#include <pthread.h>

struct SharedData {
    pthread_mutex_t mutex; // 挂在共享内存头部的互斥锁
    int data;              // 进程间共享的临界资源
};

// 1. 初始化进程间互斥锁(由创建共享内存的进程执行)
void init_process_mutex(struct SharedData *shm) {
    pthread_mutexattr_t attr;
    pthread_mutexattr_init(&attr);
    pthread_mutexattr_setpshared(&attr, PTHREAD_PROCESS_SHARED); // 设为进程间共享
    pthread_mutex_init(&(shm->mutex), &attr);                    // 动态初始化
    pthread_mutexattr_destroy(&attr);
}

// 2. 跨进程加锁访问示例
void access_shared_resource(struct SharedData *shm) {
    pthread_mutex_lock(&(shm->mutex));   // 锁住共享内存头部的互斥量,阻塞等待

    // 临界区操作
    shm->data++;

    pthread_mutex_unlock(&(shm->mutex)); // 解锁
}
1.4 给抢票程序加上互斥锁
给抢票逻辑加上互斥锁之后,整个流程就稳了。先看优化后的代码:
cpp
#include <iostream>
#include <pthread.h>
#include <string>
#include <vector>
#include <unistd.h>

int ticket = 10000;
pthread_mutex_t LOCK = PTHREAD_MUTEX_INITIALIZER;

void* BuyTicket(void* args) {
    std::string* name = (std::string*)args;
    std::cout << "我是子线程[" << *name << "]"
              << ",我的线程ID是 " << pthread_self() << std::endl;

    while (true) {
        pthread_mutex_lock(&LOCK);

        if (ticket > 0) {
            usleep(1);
            ticket--;
            std::cout << "线程[" << *name << "]抢到一张票,"
                      << "ticket = " << ticket << std::endl;
            pthread_mutex_unlock(&LOCK);
        }
        else {
            pthread_mutex_unlock(&LOCK);
            break;
        }
    }
    return nullptr;
}

int main() {
    std::vector<pthread_t> ptd;

    for (int i = 0; i < 5; i++) {
        pthread_t tid = 0;
        std::string* name = new std::string("Thread" + std::to_string(i));
        pthread_create(&tid, NULL, BuyTicket, name);
        ptd.push_back(tid);
    }

    for (int i = 0; i < 5; i++) {
        pthread_join(ptd[i], nullptr);
    }
}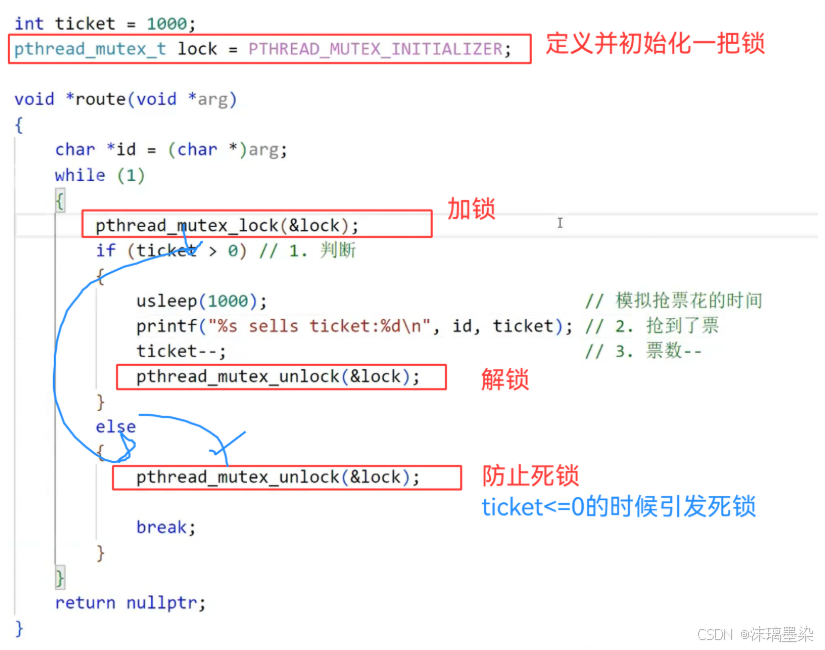
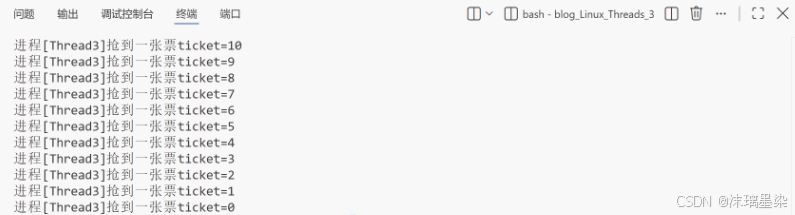
改动其实就一处:在while循环里,一进来先加锁,退出之前再解锁。 于是,判断票数、减票、打印,这一整段操作被锁包成了一个整体。哪个线程抢到锁,哪个才有资格看票、卖票。其他线程?门口等着,等锁释放了再进来。这样一来,之前那些"判断完被切走""减到一半被插队"的乱象,全被锁挡在了门外。票数不会再穿底,票号也不会重复。锁的粒度也算合理,只圈住了真正碰共享数据的部分,没把整个循环都锁死。不过有两个小地方,可以再讲究一点:
整体来看,这段代码已经能把"互斥"这件事说清楚了:一把锁,把并行的临界区操作,串成了一条安全有序的流水线。
1.5 关于互斥锁,还需要思考什么
1.5.1 关于锁机制的两个核心问题
问题一:如果有线程不遵守规则,不加锁就直接访问临界资源,会怎样?
答案是:这属于严重的程序Bug。互斥锁本质上是一种软约束,一份编程约定。它不像红绿灯有交警执法,全靠所有线程自觉遵守。你必须保证,每一个访问该临界资源的线程,都老老实实走完"申请锁 → 访问临界区 → 释放锁"这套流程。但凡有一个线程不守规矩,绕开锁直接伸手去碰共享数据,这套保护机制就彻底形同虚设。
一把锁,锁得住君子,锁不住流氓。规则是大家一起守的,破一个口子,整堵墙都塌了。
问题二:加锁之后,在临界区内部允许线程切换吗?切换了会怎样?
完全允许切换,而且不会出任何安全问题。原理在于:即便持锁线程在临界区里被切走,它只是暂时失去了 CPU 执行权,但它并没有释放锁。它手里还攥着那把锁,只是暂时没法动弹而已。这段时间里,其他线程被调度上来,试图申请锁,一看,锁被占着,全都乖乖陷入阻塞,排队等着。所有线程都得等那个持锁线程重新被调度回来,把临界区代码跑完、把锁释放掉,才有资格重新参与竞争。
所以,锁的威力不在于"不让线程被切换",而在于**"锁没释放,谁也别想进来"**。线程可以走,锁得留下。这个道理搞通了,互斥锁的底层逻辑,你就真正吃透了。
1.5.2 用"超级自习室"理解临界区与原子性
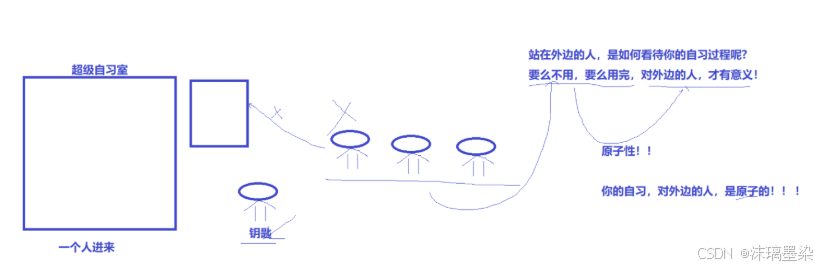
把临界资源想象成一间只能容下一人的"超级自习室",互斥锁就是门口唯一的那把钥匙。谁抢到钥匙,谁才有资格推门进去。钥匙只有一把,人却有一群。
自习室门外,站着一排等着进去的人,他们就是其他正在竞争锁的线程。门关着,里面的人是谁、在干什么、是奋笔疾书还是趴在桌上打盹,门外的人一概管不着,也管不了。
关键在于:哪怕里面那位自习到一半,突然停下笔来发呆、休息、甚至睡着了,也就是持有锁的线程被系统切走了,门外的人照样进不去。为什么?因为钥匙还在他兜里。他没出来,门就锁着。你们再着急,也只能干等。
所以,对门外排队的人来说,你的自习过程只呈现出两种有意义的状态:要么你还没进去,要么你已经自习完毕、揣着钥匙走出来了。 中间那段"你在里面磨蹭了多久、被切换了多少次",他们根本感知不到,也无从干预。
这种"要么不做,要做就做完"的整体印象,对门外的人来说,就是原子性 。锁并没有阻止你被切换,它只是保证了:门没开,钥匙没交,里面的事对外界来说就是一个不可分割的黑箱。
如果这篇文章对你有帮助,别忘了点个赞、点个收藏、点个关注。你的每一次反馈,都是我继续硬核输出的最大动力。我们下篇见。