HDFS读写流程与MapReduce原理深度解析(面试高频考点)
本文从底层原理出发,图文并茂地详解 HDFS写流程、HDFS读流程、MapReduce完整工作机制,并补充DataNode/NameNode工作原理、HDFS回收站等核心知识点。大数据面试高频考点,建议收藏!
📑 目录
- 一、HDFS写流程(8步详解)
- 二、HDFS读流程(4步详解)
- 三、MapReduce工作原理
- [3.1 整体流程总览](#3.1 整体流程总览)
- [3.2 Map端处理(切片→Map→溢写→合并)](#3.2 Map端处理(切片→Map→溢写→合并))
- [3.3 Shuffle阶段(数据拉取)](#3.3 Shuffle阶段(数据拉取))
- [3.4 Reduce端处理(合并→Reduce→输出)](#3.4 Reduce端处理(合并→Reduce→输出))
- 四、HDFS核心机制
- 五、HDFS常用Shell命令
- 六、总结
一、HDFS写流程(8步详解)
HDFS写数据是面试最常考的问题之一。下面这张图完整展示了客户端上传文件到HDFS的全过程:
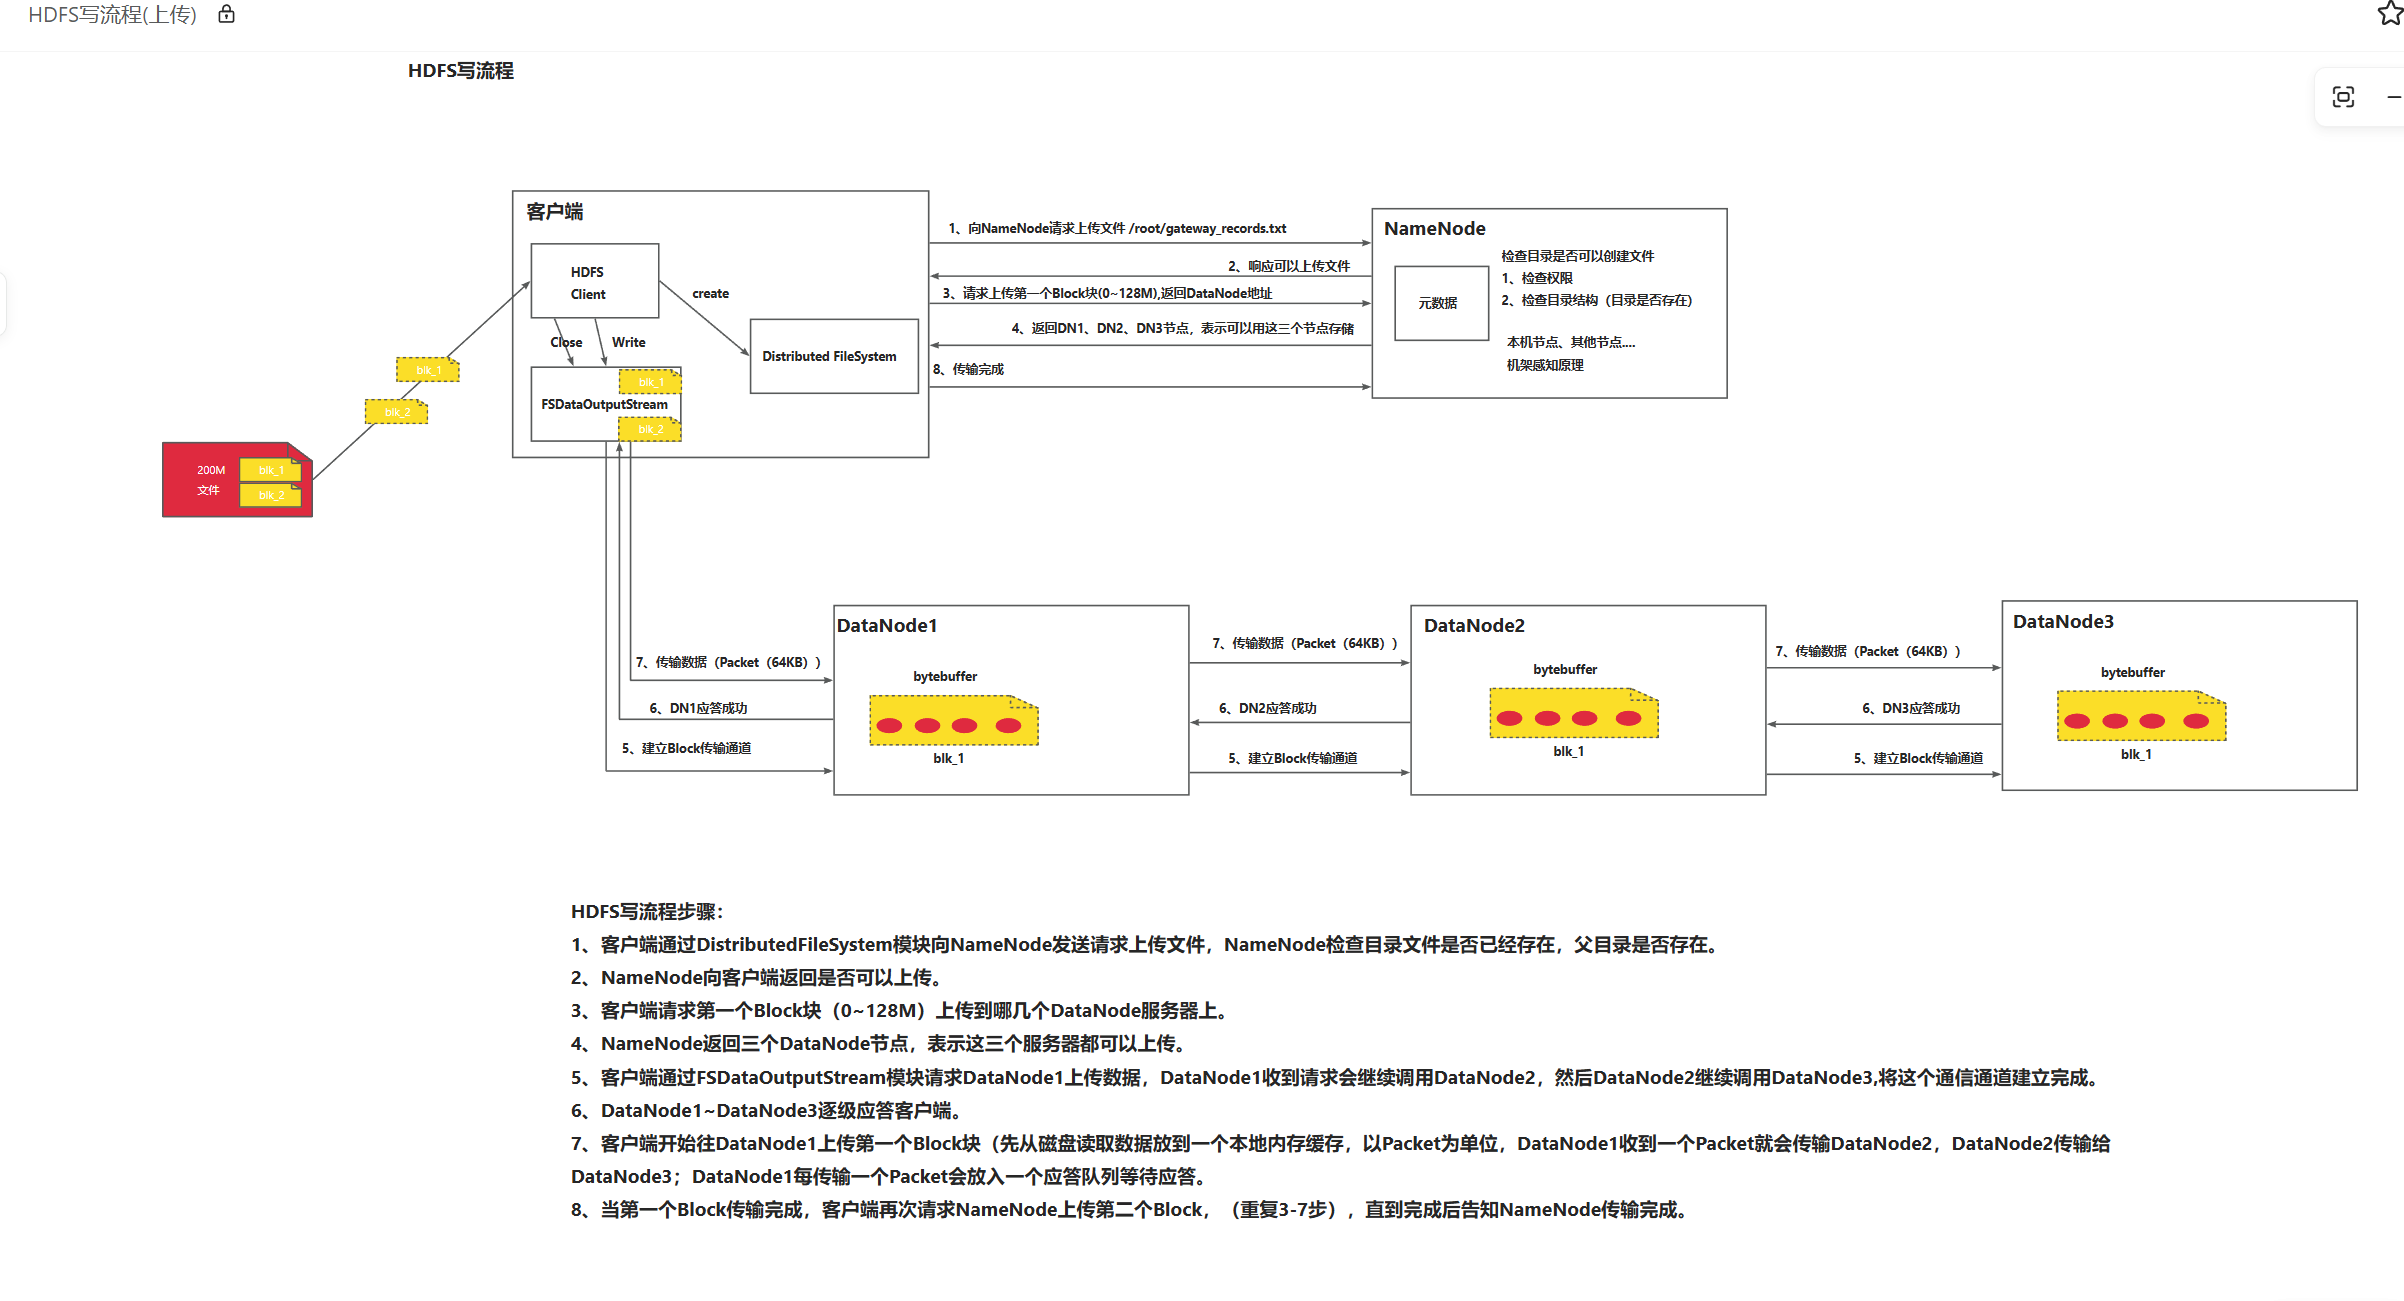
整个流程分为 8个步骤,涉及客户端(HDFS Client / DistributedFileSystem / FSDataOutputStream)、NameNode、多个DataNode之间的交互:
步骤详解
第1步:客户端请求上传文件
客户端通过 DistributedFileSystem 模块向 NameNode 发送上传文件请求(比如上传 /root/gateway_records.txt)。
NameNode收到请求后做一系列检查:
- 检查权限
- 检查目录结构(目录是否存在)
- 检查文件是否已经存在
第2步:NameNode响应
NameNode检查通过后,向客户端返回 "可以上传" 的响应。如果检查不通过(比如文件已存在、权限不足),则直接报错。
第3步:请求第一个Block的DataNode地址
客户端请求第一个Block块(0~128M)应该上传到哪些 DataNode 服务器上。
💡 为什么要问NameNode?因为DataNode列表是NameNode根据机架感知策略选出来的。
第4步:NameNode返回DataNode列表
NameNode返回3个DataNode节点(比如 DN1、DN2、DN3),表示这三个服务器都可以存这个Block。
副本数默认是3,可通过
dfs.replication配置。
第5步:建立Block传输通道(Pipeline管道)
客户端通过 FSDataOutputStream 模块请求 DataNode1 上传数据,DataNode1收到请求后会继续调用 DataNode2 ,然后DataNode2继续调用 DataNode3,将这个通信通道建立完成。
这就是所谓的 Pipeline(管道) ------ 数据像流水一样,依次流过每个DataNode。
第6步:DataNode逐级应答
通道建立好后,DataNode3 → DataNode2 → DataNode1 → 客户端,逐级应答 通道建立成功。
第7步:传输数据(Packet为单位)
客户端开始往DataNode1上传第一个Block块:
- 先从磁盘读取数据放到一个本地内存缓存
- 以 Packet(64KB) 为单位传输
- DataNode1收到一个Packet就会传输给DataNode2,DataNode2传输给DataNode3
- DataNode1每传输一个Packet会放入一个应答队列等待应答
🔑 核心细节:数据不是等第一个DataNode写完再发给第二个,而是边收边转发,形成流水线,大大提高传输效率。
第8步:传输完成,继续下一个Block
当第一个Block传输完成,客户端再次请求NameNode上传第二个Block,重复3~7步,直到所有Block传输完成,最后告知NameNode传输完成。
二、HDFS读流程(4步详解)
读完了写流程,再来看看读流程。相比写流程,读流程要简单一些:
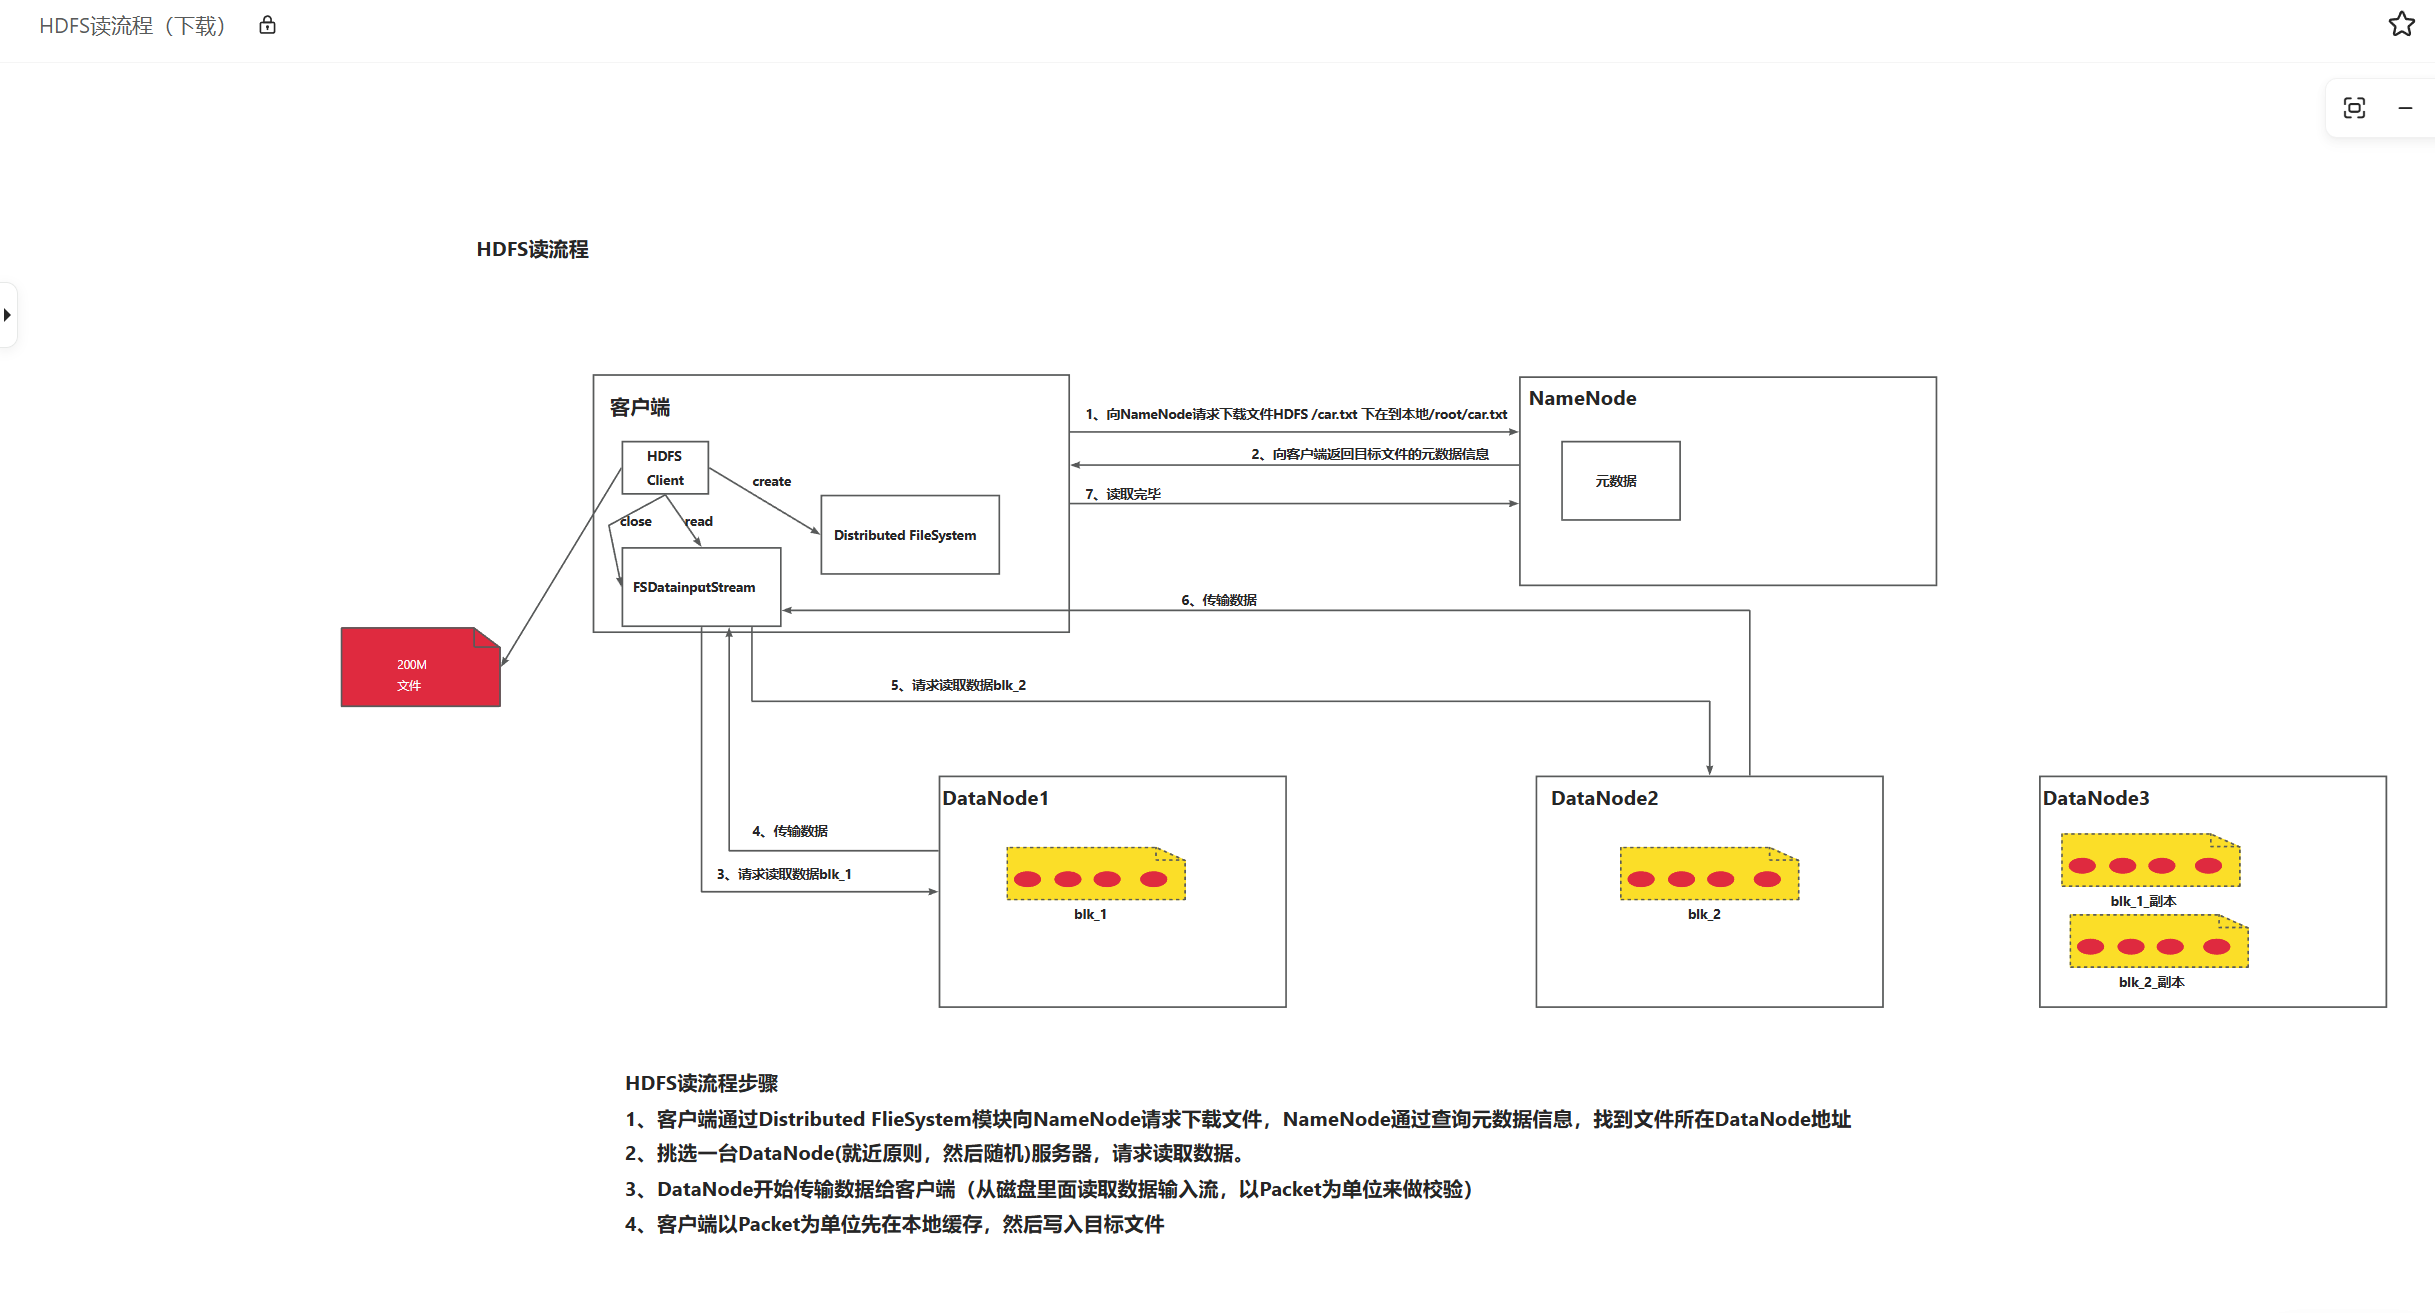
HDFS读流程分为 4个步骤:
步骤详解
第1步:客户端请求下载文件
客户端通过 DistributedFileSystem 模块向 NameNode 请求下载文件(比如下载 /car.txt 到本地 /root/car.txt)。
NameNode通过查询元数据信息,找到文件所有Block所在的DataNode地址列表。
第2步:挑选DataNode(就近原则)
客户端拿到Block位置信息后,挑选一台DataNode来读取数据。挑选原则:
🎯 就近原则(机架感知):优先选择离客户端最近的DataNode
- 同一节点(如果客户端本身就是DataNode)
- 同一机架
- 同一数据中心
- 都没有就随机选一台
第3步:DataNode传输数据
DataNode开始传输数据给客户端:
- 从磁盘里面读取数据,以 Packet为单位 输出
- 每个Packet都会做校验,确保数据完整性
第4步:客户端缓存并写入文件
客户端以Packet为单位先在本地缓存,校验通过后写入目标文件。读完一个Block后继续读下一个,直到所有Block读完。
💡 思考 :为什么读流程不需要Pipeline?
因为读的时候,客户端只需要从最近的一个副本读取就行,不需要把所有副本都读一遍。而写的时候,所有副本都要写入,所以需要Pipeline。
三、MapReduce工作原理
MapReduce的核心是"分而治之",但完整的工作流程远比"Map + Reduce"复杂。下面这张图展示了MapReduce从输入到输出的完整生命周期:
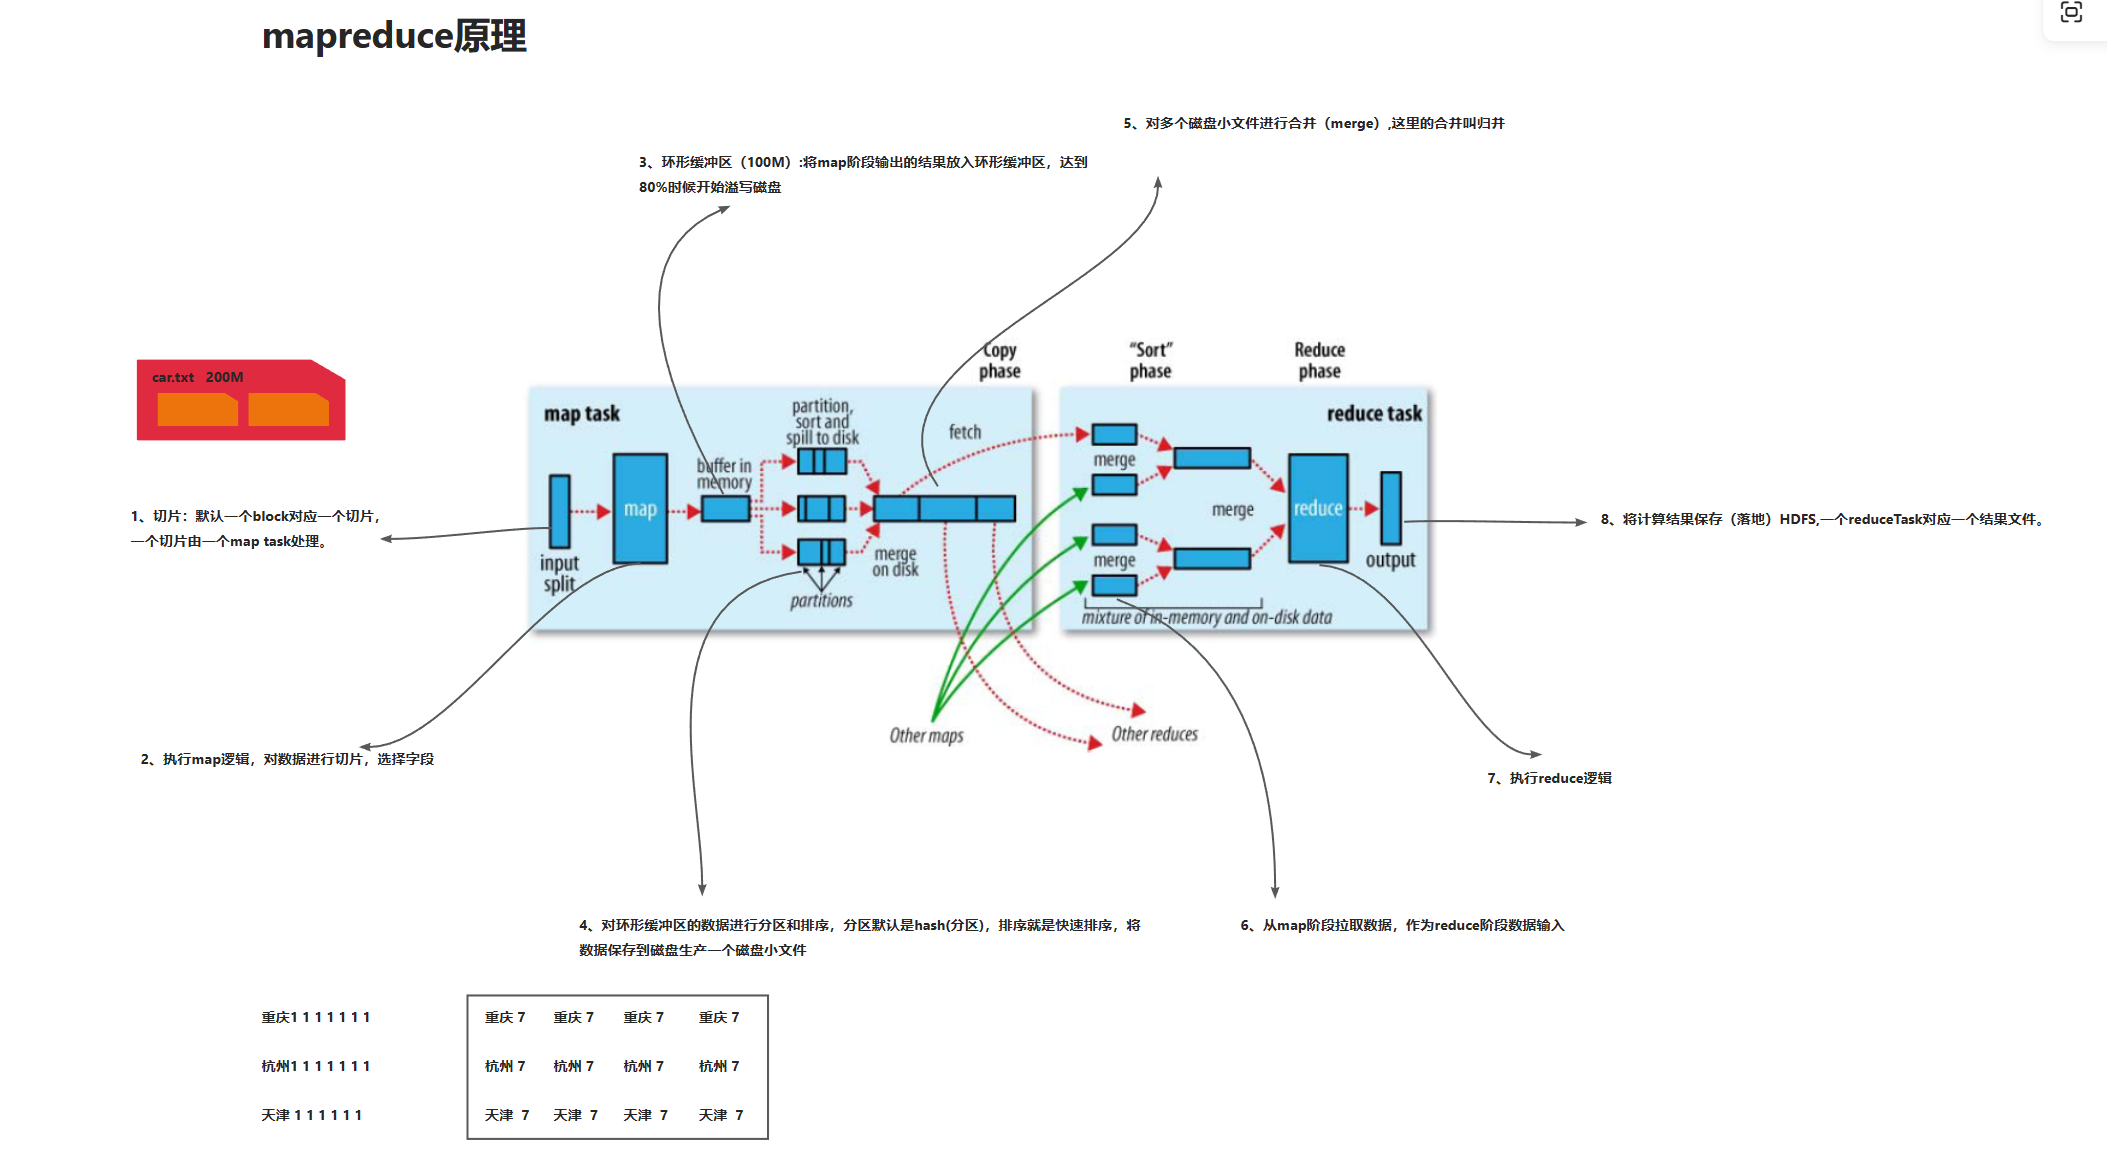
3.1 整体流程总览
整个MapReduce工作流程可以分为 8个核心阶段,按位置归为三大块:
| 阶段 | 位置 | 做了什么 |
|---|---|---|
| 1. Input Split | Map端 | 数据切片,一个切片对应一个MapTask |
| 2. Map | Map端 | 执行自定义Map逻辑,输出key-value |
| 3. 环形缓冲区 | Map端 | Map输出写入内存缓冲区 |
| 4. Partition & Sort | Map端 | 分区 + 快速排序,溢写到磁盘 |
| 5. Merge on Disk | Map端 | 多个溢写文件合并(归并排序) |
| 6. Copy Phase | Shuffle | ReduceTask拉取Map端数据 |
| 7. Sort & Reduce | Reduce端 | 归并合并 + 执行Reduce逻辑 |
| 8. Output | Reduce端 | 结果写入HDFS |
🔥 Shuffle是什么? 第5~7步(Map端Merge → Copy → Reduce端Merge)统称为 Shuffle,即Map输出到Reduce输入之间的过程。Shuffle是MapReduce的心脏,也是性能调优的关键。
3.2 Map端处理(切片→Map→溢写→合并)
Map端共5个阶段,数据从输入到输出一个有序的分区文件:
① Input Split(数据切片)
- 逻辑上对数据进行切分,默认 一个Block对应一个切片
- 一个切片由一个MapTask处理
- Block是物理切分 (128M),Split是逻辑切分
② Map阶段
- 每个MapTask执行用户自定义的
map()方法 - 输出
<key, value>键值对
③ 环形缓冲区与溢写
- Map输出先写入内存中的环形缓冲区(默认100M)
- 达到 80% 时开始溢写磁盘(spill),同时20%空间继续接收数据
- 目的:减少磁盘IO,提高效率
④ 分区与排序(Partition & Sort)
- 溢写前对数据做两件事:Hash分区 (保证同key进同Reduce)+ 快速排序
- 排序后的数据保存到磁盘,生成一个磁盘小文件
- 一个MapTask可能产生多个溢写小文件
⑤ Merge合并(归并排序)
- MapTask完成后,多个溢写小文件合并成一个文件
- 合并后每个分区内部仍然有序
- 可选优化:Combiner(Map端局部Reduce,减少网络传输数据量)
3.3 Shuffle阶段(数据拉取)
Shuffle是连接Map和Reduce的桥梁,核心就是数据拉取:
- Map端全部完成后,ReduceTask从各个MapTask上拉取属于自己分区的数据
- 数据先存到内存缓冲区,满了再溢写到磁盘
- 这个过程叫 Copy Phase / Fetch
举个例子:100个MapTask + 5个ReduceTask → 每个Reduce要从100个Map拉数据 → 共500次网络传输
3.4 Reduce端处理(合并→Reduce→输出)
① Sort归并 + Reduce逻辑
- 将从不同MapTask拉来的数据进行归并排序,得到全局有序数据集
- 相同key的value组成迭代器,调用一次
reduce()方法 - 执行用户自定义的Reduce逻辑(求和、求平均等)
② Output输出到HDFS
- 一个ReduceTask对应一个结果文件(part-r-00000, part-r-00001...)
- N个ReduceTask产出N个结果文件
📌 Shuffle一句话总结:把Map的输出变成Reduce的输入的整个过程 = 分区排序 + 溢写合并 + Copy拉取 + 归并合并
四、HDFS核心机制
DataNode工作机制
DataNode是HDFS中真正存储数据的节点:
- 数据块存储:数据以Block形式存储在本地磁盘上
- 心跳机制:定期向NameNode发送心跳(默认3秒一次),10分钟没心跳则判定挂掉
- 块报告:定期上报自己存储的所有Block列表
- 数据读写:响应客户端读写请求,实际传输数据
🏥 心跳机制的作用:NameNode通过心跳感知DataNode存活。某节点挂了,会在其他节点补充副本,保证副本数不变。
NameNode工作机制
NameNode存储元数据(目录树、文件与Block映射、Block与DataNode映射),涉及两个核心文件:
| 文件 | 作用 |
|---|---|
| FsImage | 元数据镜像文件,保存某一时刻的完整元数据 |
| Edits | 编辑日志,记录所有元数据的修改操作 |
工作流程:启动时加载FsImage → 回放Edits得到最新元数据 → 后续修改写入Edits
🔄 SecondaryNameNode的作用:定期合并FsImage和Edits,防止Edits过大,加快NN启动速度。注意:2NN不是热备,不能立即顶上。
HDFS回收站(Trash)
- 删除文件时先移动到
.Trash目录,不会立即删除 - 超过过期时间(默认6小时)后才真正删除
- 回收站里的文件可以恢复
配置参数 :fs.trash.interval(分钟为单位)
💡 命令行
hdfs dfs -rm删除的文件默认进回收站;API删除需要手动开启。
数据完整性校验
HDFS通过 CRC32校验和 保证数据完整性:
- 写入时计算每个Chunk(默认512字节)的校验和,随数据一起存储
- 读取时重新计算并对比,不一致则自动去其他副本读取
五、HDFS常用Shell命令
操作HDFS的命令格式:hdfs dfs -命令 参数 或 hadoop fs -命令 参数
基本操作
shell
# 查看根目录
hdfs dfs -ls /

# 递归查看目录
hdfs dfs -ls -R /

# 创建目录
hdfs dfs -mkdir /test
hdfs dfs -mkdir -p /a/b/c   # 递归创建

# 上传文件(本地 → HDFS)
hdfs dfs -put local.txt /test/
hdfs dfs -copyFromLocal local.txt /test/   # 同上

# 下载文件(HDFS → 本地)
hdfs dfs -get /test/file.txt ./
hdfs dfs -copyToLocal /test/file.txt ./    # 同上

# 查看文件内容
hdfs dfs -cat /test/file.txt
hdfs dfs -tail /test/file.txt   # 查看文件末尾

# 删除文件/目录
hdfs dfs -rm /test/file.txt
hdfs dfs -rm -r /test           # 递归删除目录

# 查看文件大小
hdfs dfs -du -h /test/

# 统计HDFS总容量
hdfs dfs -df -h /

# 移动/重命名
hdfs dfs -mv /test/a.txt /test/b.txt
管理命令
shell
# 格式化NameNode(只能执行一次!)
hdfs namenode -format

# 进入安全模式
hdfs dfsadmin -safemode enter

# 离开安全模式
hdfs dfsadmin -safemode leave

# 查看安全模式状态
hdfs dfsadmin -safemode get

# 手动触发Balancer(数据平衡)
hdfs balancer
六、总结
本文通过四张架构图,系统梳理了HDFS和MapReduce的核心原理:
📌 HDFS核心
| 知识点 | 核心要点 |
|---|---|
| 写流程 | 8步:请求上传 → NN检查 → 要DN地址 → 返回DN列表 → 建Pipeline → 应答 → Packet传输 → 完成 |
| 读流程 | 4步:请求下载 → 就近选DN → 传输数据 → 本地写入 |
| NameNode | 管元数据,FsImage + Edits,2NN辅助合并 |
| DataNode | 存数据,心跳 + 块报告 |
| 回收站 | 删除文件先放.Trash,过期才真删 |
| 数据完整性 | CRC32校验和 |
📌 MapReduce核心
| 阶段 | 做什么 |
|---|---|
| Input Split | 逻辑切片,一个切片一个MapTask |
| Map | 执行自定义map逻辑 |
| 环形缓冲区 | 100M内存,80%溢写 |
| Partition & Sort | Hash分区 + 快速排序 |
| Merge | 归并排序,合并溢写文件 |
| Copy | Reduce拉取数据 |
| Sort + Reduce | 归并合并 + 自定义reduce逻辑 |
| Output | 写入HDFS |
🔥 面试高频考点:HDFS读写流程、MapReduce的Shuffle过程、NameNode/DataNode工作机制,这三个一定要吃透!