1. 整理问卷:先得到一张"每个人有哪些症状"的数据表
论文最终纳入3037名学生,使用PHQ-9、GAD-7和ISI三个量表,共23道症状题。因此,用于网络分析的症状数据可以整理为:
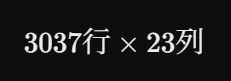
每一行是一名学生,每一列是一道症状题。 年龄、性别和睡眠时型等信息另外保留,用于描述样本和后续分组。例如,下面是三名学生、三个条目的假设记录:
| 学生 | 情绪低落PHQ2 | 疲劳PHQ4 | 难以控制担忧GAD2 |
|---|---|---|---|
| 甲 | 2 | 1 | 0 |
| 乙 | 0 | 3 | 2 |
| 丙 | 1 | 0 | 1 |
作者对数据进行了两类处理。
量表总分用于描述样本。 原始条目评分相加得到PHQ-9、GAD-7和ISI总分,随后按照相应筛查阈值,统计达到标准的人数和比例。
条目二值化用于建立网络。 对PHQ-9和GAD-7,原始0分记为0,1、2、3分都记为1,分别表示症状未出现和出现。
上面的假设记录转换后就是:
| 学生 | 情绪低落:有无 | 疲劳:有无 | 难以控制担忧:有无 |
|---|---|---|---|
| 甲 | 1 | 1 | 0 |
| 乙 | 0 | 1 | 1 |
| 丙 | 1 | 0 | 1 |
实际研究将23个条目按论文报告的二值化思路整理,得到用于建网的数据表。下文把这张表记为X。下一步,模型利用这些逐人记录估计症状之间的关联。
2. 估计网络:让模型从所有学生的症状组合中,计算连接强度
这一阶段同时涉及三个概念:Ising模型、LASSO正则化和EBIC模型选择。
论文报告使用Ising模型和eLasso方法,通过R中的estimateNetwork及IsingFit等工具估计网络。为了说明"0和1怎样计算成边权",下面补充作者所用方法的计算原理,依据其方法文献和软件官方说明。
Ising模型,中文通常称"伊辛模型",是一种描述多个二分类变量之间关联的统计模型。 每个变量只有两种状态,例如0和1。"变量"就是研究中观察的一项内容。在这篇论文中,每一个症状就是一个变量。可以把"模型"理解为一套数学规则:用这套规则描述这些症状如何组合出现,再根据实际问卷估计其中的关系强弱。假设研究者收集了很多人的三个症状:
学生 睡眠问题 疲劳 情绪低落 甲 1 1 1 乙 1 1 0 丙 0 0 0 丁 0 1 1 Ising模型提供了描述这种关系的数学形式。通过大量参与者的记录,可以估计症状之间的连接参数,再将这些参数画成网络中的连线。这里"把其他症状一起纳入分析",就是前面讲的条件关联。
作者将3037名学生的23个症状条目二值化,再利用Ising模型估计症状网络。它承担的是从逐人的症状记录,建立症状关联模型这一环节。
当研究对象是多个"有/无"变量,并且希望分析它们之间的关系时,可以考虑Ising模型。
LASSO正则化:在计算关系时加上约束,让模型更精简。估计症状关系时,数据里既包含值得研究的规律,也包含这批样本的偶然波动。正则化,就是在模型计算中加入约束,控制模型的复杂程度,减少对偶然波动的过度迎合。LASSO是其中一种具体方法。LASSO模型约束了模型里的系数。在这里,系数可以先理解为"描述两个症状关联强弱的数值"。LASSO会让系数向0收缩,其中一部分会被压到0,由此同时完成缩小系数和选择连接。例如,在某个教学示例的估计结果中:
睡眠问题与疲劳的连接系数为0.6:保留这条连接。
睡眠问题与另一症状的连接系数为0:模型省去这条连接。
这些结果是在带约束的计算过程中产生的。可以把它理解为:每增加一些连接强度,模型就要承担相应的"复杂度成本";保留连接需要带来足够的数据解释收益。
LASSO有一个控制约束强度的参数,通常写作 λ。 约束较弱时,模型倾向于保留较多连接;约束较强时,系数受到更明显的压缩,模型倾向于更精简。这就产生了一个新问题:如何调整这个参数才能使它最为合适。下一部分的EBIC,就是本文所用方法回答这个问题的工具。
LASSO用在估计症状连接系数的过程中,帮助形成较精简的网络。论文报告使用eLasso压缩部分估计值,并将部分连接压到0。更广泛地说,LASSO也用于回归和预测建模,帮助约束系数、选择变量。
模型需要估计很多关系时,LASSO通过约束系数,帮助控制复杂程度。
EBIC的中文名称是"扩展贝叶斯信息准则"。可以把它理解为一套比较候选模型的评分规则。它综合考虑两个方面:
对数据的解释程度: 这个方案对实际观察到的问卷回答解释得怎么样?
模型的复杂程度: 这个方案需要保留多少关系,以及候选关系的规模有多大?
在同一组可比较的候选模型中,EBIC数值越小,按照这套准则越值得选择。
刚才说,LASSO的约束可以调强,也可以调弱。因此,同一份数据经过不同约束程度的计算,会产生多个候选方案。有的方案保留较多关系,有的方案更精简。EBIC帮助比较这些方案,在解释数据与控制复杂程度之间作出选择。
假设正在分析"疲劳"与其他22个症状的关系。下面是假设的候选方案和评分:
候选方案 LASSO约束程度 保留的关联症状数 EBIC评分 甲 较弱 14个 460 乙 中等 8个 430 丙 较强 2个 475 在这个例子中,乙的EBIC最低,因此选乙。也就是说,按照EBIC的评价,乙在数据解释程度和模型复杂度之间取得了更合适的平衡。具体选择哪种约束程度,由实际数据和候选方案的评分决定。
按照论文采用的eLasso方法原理,软件会针对每个症状,在不同LASSO约束产生的候选方案中计算EBIC,选择对应方案,再将各症状的结果整合为网络。
当存在多个候选模型,需要从中选择一个时,EBIC提供比较依据。
第一步:选一个症状,同时分析它与其余22个症状的关系
eLasso使用带正则化的逻辑回归,依次估计每个症状与其余症状的联系。以"情绪低落"为例。模型读取3037名学生的情绪低落记录,把它作为当前分析的结果变量;同时读取这批学生其余22个症状的记录,作为解释变量。可以把计算关系理解为:

这里的f是逻辑回归给出的概率计算关系。模型需要估计每个症状对应的系数,从而描述:其余症状一起纳入分析时,某个症状与情绪低落的关联有多强。"条件关联"中的"条件",就体现在这里:疲劳与低落之间的关联,是在同时考虑另外21个症状后估计的。随后,模型把"疲劳"作为当前分析对象,用其余22个症状解释疲劳的有无;再换成下一个症状。23个症状依次接受这样的分析。
第二步:在计算系数时加入正则化约束
软件需要从数据中寻找一组合适的系数。可以将它理解为:一方面尽量解释学生实际报告的0和1,另一方面控制模型复杂程度。其计算目标可以用一个简化表达式概括:

前半部分关注模型对数据的解释程度;后半部分对系数施加约束。约束会使部分系数缩小,其中一些变成0。这就是LASSO正则化的作用。因此,估计连接强度与选择保留哪些连接,是在同一建模过程中完成的。
第三步:用EBIC选择合适的约束程度
不同约束强度,会得到不同的连接方案。作者采用的方法用扩展贝叶斯信息准则,简称EBIC,比较候选方案对数据的拟合与复杂程度,选择相应模型。到这里,三个方法就连接起来了:Ising模型规定二分类症状关系的形式;LASSO在估计中约束连接系数;EBIC帮助选择模型复杂程度。软件最后将各个症状分析得到的连接估计,按边选择与对称化规则整合为一张无向网络。这一步输出症状两两之间的估计边权。它们组成下一步要使用的边权矩阵。
3. 得到边权矩阵:整篇网络分析的核心中间结果
把23个症状同时放在行和列上,交叉位置填写它们的边权,就得到一张23*23的矩阵。下文将它记为W。IsingFit的输出包含这样的加权邻接矩阵。整个数据转换就是:

下面设置一个只有五个症状的教学示例网络。这些权重专门用于后面的手工演算;论文实际分析使用23个节点及其估计权重。五个症状分别是:
A:情绪低落;B:疲劳;C:难以控制担忧;D:睡眠维持困难;E:睡眠问题带来的苦恼。
| 边权矩阵 | A:低落 | B:疲劳 | C:担忧 | D:睡眠维持困难 | E:睡眠苦恼 |
|---|---|---|---|---|---|
| A:低落 | 0 | 0.4 | 0.2 | 0 | 0 |
| B:疲劳 | 0.4 | 0 | 0.3 | 0.6 | 0.3 |
| C:担忧 | 0.2 | 0.3 | 0 | 0.2 | 0 |
| D:睡眠维持困难 | 0 | 0.6 | 0.2 | 0 | 1.2 |
| E:睡眠苦恼 | 0 | 0.3 | 0 | 1.2 | 0 |
例如,B行、D列的0.6,表示这个示例网络中"疲劳---睡眠维持困难"的连接强度。矩阵上下对称,同一对症状对应同一条无向连接;对角线设为0。将矩阵中的非零连接画出来,就得到网络图。
到这一步,症状网络已经建立。接下来,作者从同一张W中提取三类信息:整体中心性、跨症状群连接,以及自杀相关条目的连接。
4. 从同一张矩阵计算EI和BEI,回答两个不同的问题
4.1 计算EI:哪些症状的整体连接最突出?
一步预期影响EI的定义是:把一个节点与其他节点直接相连的边权相加,并保留边权的正负号。
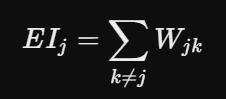
在刚才的示例矩阵里,计算D"睡眠维持困难"的EI,就是将D这一行相加:
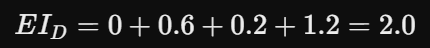
计算B"疲劳"的EI:
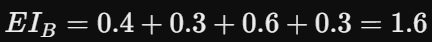
对所有节点重复计算,得到:
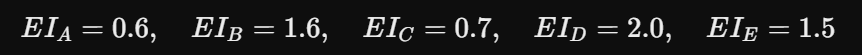
因此,在这个教学示例中,D的EI最高,是整体连接最突出的节点。论文的实际计算也是沿着这个思路,从23个节点的边权得到23个EI值。实际结果中,睡眠维持困难ISI2的EI最高,随后是难以控制担忧GAD2、睡眠问题带来的苦恼ISI7、难以放松GAD4和情绪低落PHQ2。
这里的证据链是:
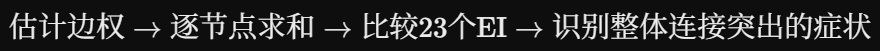
4.2 计算BEI:哪些症状与其他症状群联系最突出?
计算BEI时,还需要知道每个节点属于哪个症状群。在论文中,三个量表对应PHQ抑郁症状群、GAD焦虑症状群和ISI失眠症状群。桥分析关注这些症状群之间的连接。一步桥预期影响BEI的计算是:只加上该节点通向其他症状群的边权。
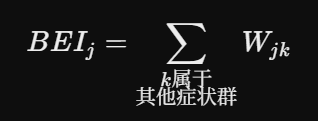
4.3 作者怎样确定"桥症状"?
作者计算23个节点的BEI,再以第80百分位数作为选择阈值,识别跨症状群连接相对靠前的节点。论文最终识别出五个桥症状:疲劳PHQ4、睡眠问题PHQ3、情绪低落PHQ2、内疚PHQ6、难以控制担忧GAD2,其中疲劳的桥指标最高。这一部分完整的计算链是:

这一步的输出两组节点指标,以及整体连接和跨群连接分别突出的症状。
5. 分析自杀相关连接:重点查看PHQ-9第9题在矩阵中的位置
有了完整的W ,作者还希望回答:哪些症状与自杀相关条目直接相连?这些连接有多强?PHQ-9第9题已经包含在23个节点中。论文将这一题的非零回答视为自杀相关表现的存在,并重点展示它与其他症状的联系。
从数据操作上,可以理解为:取出W中PHQ-9第9题对应的一行,查看其余22个位置的边权。
作者发现,有12个症状与该条目直接相连。连接最强的五个依次是内疚PHQ6,边权0.99;情绪低落PHQ2,0.96;难以控制担忧GAD2,0.65;动作迟缓或坐立不安相关表现PHQ8,0.50;食欲变化PHQ5,0.49。
随后,作者围绕PHQ-9第9题重新排列节点,将直接相连的症状放在中间,绘制成流式网络。因此,这一步的计算关系是:

6. 重新抽取参与者:检查边权和中心性对样本变化是否敏感
到这里,作者已经得到了网络和重点症状。接下来需要评价:换一种样本组成,这些估计结果还能保持到什么程度?论文报告使用1000次非参数重采样评估边权估计,并使用删减样本的重采样方法评价中心性稳定性。
非参数重采样:
简单说,就是:从已有数据中反复抽取样本,每次重新计算,看看结果会有多大波动。 抽取采用"有放回"的方式,同一条记录可以被重复抽中。
假设原来有5名学生:甲、乙、丙、丁、戊。每次仍然抽取5条记录:
抽样次数 抽到的学生记录 第一次 甲、甲、丙、丁、戊 第二次 乙、丙、丙、戊、戊 第三次 甲、乙、乙、丁、丁 每抽中一名学生,就保留他的完整问卷回答。每次用抽到的数据重新计算,就能观察样本组成变化时,结果怎样变化。
在本文中,作者进行了1000次非参数重采样,每次重新估计症状网络,再观察同一条边的边权在这些计算中如何波动,以评估边权估计的不确定性。
"非参数"表示抽样直接依据现有数据,无需先指定总体服从正态分布等某种具体分布。
也就是说,通过反复抽取学生记录 → 反复建立网络 → 看连接强度波动多大。
下面的操作解释依据该研究引用的网络稳定性方法文献。
6.1 边权重采样:反复抽人、建网、收集边权
非参数bootstrap的基本做法是:从原有参与者中有放回地抽取整行记录,形成重采样数据,再重新估计网络。在这项研究中,可以把一次重采样理解为:

"有放回"表示:同一个学生可能被抽中多次,另一些学生可能在这一次抽样中没有出现。每次抽取都保留该学生完整的23项症状记录。重复这个过程,就会得到许多重采样网络:
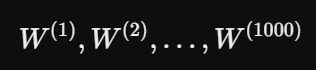
假设关注"入睡困难---睡眠维持困难"这条边,就从每张重采样网络中取出它的边权,观察其分布和区间。估计值越集中,对该边强度的估计通常越精确。这样就可以看到每条边在重采样中的波动情况,为边权估计补充抽样不确定性信息。
6.2 中心性稳定性:减少参与者,重新计算整组EI和BEI
删减样本的重采样,关注的是不同样本量下网络指标的稳定程度。其过程是:
随机保留部分学生 → 重新建网 → 重新计算23个EI或BEI → 与全样本结果比较。
例如,全样本产生一组EI:
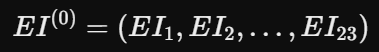
随机删减部分学生后,再得到:
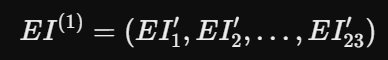
接着,按症状一一对应,计算两组EI的相关:
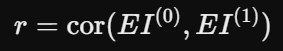
相关越高,表示删减前后EI的整体高低格局越接近。在不同删减比例下反复计算,就能得到相关稳定性系数CS。
论文报告EI的CS为0.75。按CS的定义,这表示在测试范围内,删去75%的参与者后,重算的中心性仍能按95%的概率标准,与原始中心性保持至少0.70的相关。作者据此认为EI结果具有较好的稳定性。这一部分与前面的计算紧密相连,它为"哪些症状在当前数据中连接较突出"这一结论,补充了样本敏感性证据:
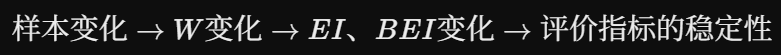
7. 按人群重新建网:比较不同性别和睡眠时型的症状连接
最后一个问题是:不同人群的症状关联结构,是否存在差异?这一步需要回到参与者数据表 X,根据分组信息拆分行。
7.1 分组后,分别得到两张网络
以性别为例:
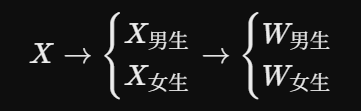
两组均保留相同的23个症状列,以便逐一比较对应连接。睡眠时型采用相同思路:作者根据MSFsc指标的样本中位数划分高、低夜型倾向组,再分别估计网络。
7.2 比较什么?
作者使用网络比较检验NCT,比较整体连接强度与网络结构。从NCT的计算原理看,整体连接强度通常汇总网络中的边权绝对值,比较两组总体连接程度;网络结构检验关注对应边权的差异,使用最大边权差异作为检验统计量。
7.3 怎样判断观察到的差异是否突出?
NCT使用置换检验。其基本过程是:先根据真实分组计算网络差异,然后随机重新分配组标签,保留每个人的完整问卷记录和两组人数,再次建网并计算差异。反复进行后,得到随机重分组条件下的差异分布。将真实差异与这个分布比较,得到p值。论文报告进行了1000次迭代。
论文实际结果为:性别比较中,整体连接强度和网络结构的p值分别为0.55、0.96;睡眠时型比较中,相应p值分别为0.87、0.28。作者据此报告两类分组的整体网络差异均未达到统计显著水平。
8. 总结
| 研究环节 | 使用的输入 | 计算后得到什么? | 支持回答的问题 |
|---|---|---|---|
| 问卷整理 | 逐人逐题原始评分 | 二值数据表 X | 每个人出现了哪些症状? |
| 网络估计 | X | 边权矩阵 W | 症状之间的条件关联有多强? |
| EI分析 | W | 每个症状的EI | 哪些症状整体连接突出? |
| BEI分析 | W+症状群标签 | 每个症状的BEI及桥症状 | 哪些症状跨群连接突出? |
| 重点节点分析 | W中PHQ9的连接 | 直接关联症状及连接强度 | 哪些症状与自杀相关条目联系紧密? |
| 重采样分析 | 重新抽取或删减后的参与者数据 | 边权波动、中心性稳定性 | 结果对样本变化有多敏感? |
| 分组比较 | 各组参与者数据 | 分组网络与NCT检验结果 | 不同人群的网络是否存在显著差异? |
正文还报告了节点冗余检查,以及利用相邻症状估计节点可预测性的辅助分析;后者以节点外圈展示。它们分别补充变量信息重叠与节点可预测程度的描述。
作者先将3037名学生的逐题回答整理为症状有无数据,通过Ising模型、正则化和EBIC选择,估计23个症状之间的连接强度。随后,对同一张网络分别计算EI和BEI,识别整体连接突出与跨症状群连接突出的症状,并重点提取自杀相关条目的连接。接着,通过反复抽取、删减参与者重新建网,评估边权和中心性的稳定性;再按性别和睡眠时型分组建网,检验人群差异。
这条证据链最终支持的是:在这批青少年的横断面问卷中,哪些症状具有较突出的关联位置,以及这些结果的样本稳定性和组间表现。 症状变化的先后顺序、因果作用和实际干预效果,则需要通过纵向研究与干预研究继续检验。