上一篇讲整条链路怎么串起来的,这一篇开始拆代码。
本篇范围 :仓库地图 +opencv_basics/六个练习文件(共 553 行)。
阅读前提:对照仓库源码看,代码片段都标了行号。
系列安排:opencv_basics/→task1_lightbar/→task2_apriltag/→task3_serial/。
1. 先看代码地图
| 文件 | 行数 | 一句话职责 |
|---|---|---|
opencv_basics/basic_image.py |
42 | 读图、看尺寸与通道数、分离 BGR 与 HSV |
opencv_basics/blue_mask.py |
96 | HSV 阈值 + B-R 差分求交,得到蓝色掩膜 |
opencv_basics/morphology.py |
94 | 对比 1×1 / 3×3 / 7×7 的开闭运算效果 |
opencv_basics/contours.py |
136 | 轮廓提取 + 面积/长宽比/填充率三重筛选 |
opencv_basics/polygon_approximation.py |
145 | 对比轮廓、多边形近似、旋转矩形三种表达 |
opencv_basics/extract_frame.py |
40 | 从视频抽指定帧,用于单帧调试 |
task1_lightbar/detect_video.py |
227 | 逐帧检测流水线(下一部分讲) |
task2_apriltag/calibrate_camera.py |
161 | 棋盘格标定 |
task2_apriltag/detect_tag.py |
103 | AprilTag 检测 |
task2_apriltag/estimate_pose.py |
169 | solvePnP 位姿估计 |
task3_serial/cv1_protocol.py |
49 | CV1 报文组帧 + XOR 校验 |
task3_serial/detect_apriltag_serial.py |
160 | 主循环与串口发送 |
| 依赖方向是这样的: |
模块边界的一句话原则 :task3_serial/cv1_protocol.py 是全项目唯一不 import cv2 的功能模块。它只做「数字 → 字符串 → 字节」的转换,所以能脱离相机和串口单独测试------这一点在后面讲任务三时会体现价值。
2. 六个文件共用一个骨架
把六个文件的开头对齐看,会发现它们是同一个模板的六次填肉:
python
import sys

from pathlib import Path

import cv2

def main() -> int:

if len(sys.argv) != 2:

print("用法: python basic_image.py <图片路径>")

return 1

image_path = Path(sys.argv[1])

image = cv2.imread(str(image_path))

if image is None:

print(f"无法读取图片: {image_path}")

return 1

# ... 真正的逻辑 ...

return 0

if __name__ == "__main__":

raise SystemExit(main())
这个模板里的四个约定,值得单独说:
-
main() -> int+raise SystemExit(main()):脚本的返回值就是进程退出码,0成功、1失败。这样脚本既能手敲,也能被别的脚本或 CI 调用并判断结果。 -
参数校验先行 :
len(sys.argv) != 2时就打印用法并退出,而不是让sys.argv[1]抛IndexError。 -
cv2.imread失败返回None,不抛异常 。这是 OpenCV 最容易埋雷的地方------路径写错、格式不支持,程序都会安静地继续跑,最后在一个和读图毫无关系的地方崩掉。所有文件都做了if image is None检查,这是好习惯。 -
输出统一写进相对路径
output/,所以必须从仓库根目录运行 。这一点在实际使用时比看起来重要:从opencv_basics/目录里运行basic_image.py,结果会落到opencv_basics/output/,而不是你以为的位置。
不过这个模板有两处没做全,后面会各遇到一次:int(sys.argv[2]) 没有捕获转换失败,cv2.imwrite 的返回值时查时不查。
3. basic_image.py:把一张图拆开看
python
blue, green, red = cv2.split(image)

gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

hsv = cv2.cvtColor(image, cv2.COLOR_BGR2HSV)

output_dir = Path("output")

output_dir.mkdir(exist_ok=True)

cv2.imwrite(str(output_dir / "original.jpg"), image)

cv2.imwrite(str(output_dir / "blue_channel.jpg"), blue)

cv2.imwrite(str(output_dir / "green_channel.jpg"), green)

cv2.imwrite(str(output_dir / "red_channel.jpg"), red)

cv2.imwrite(str(output_dir / "gray.jpg"), gray)

cv2.imwrite(str(output_dir / "hsv.jpg"), hsv)
为什么第一件事是拆通道? 因为「蓝色灯条」这个说法在代码里必须落成具体的数值判断。先把 B、G、R 三个通道摊开看一遍,才能知道这个蓝色到底是 (255, 100, 50) 这种高饱和的纯蓝,还是混了大量亮度的浅蓝------这一步决定了后面 HSV 阈值该往宽了给还是窄了给。
这里有一个值得展开讲的细节:hsv.jpg 其实看不出「颜色」。 cv2.imwrite 永远按 BGR 顺序解释数组,所以它会把 H 通道当成蓝、S 当成绿、V 当成红写出去。得到的图能反映三个通道的分布,但不能拿它判断「这块是不是蓝色」。想看色相分布,更直观的做法是只把 H 通道抠出来存成单通道灰度图:
python
h_channel = hsv[:, :, 0] # H ∈ [0, 179]

cv2.imwrite(str(output_dir / "h_channel.png"), h_channel)
另一个细节:所有掩膜和通道图都存成了 .jpg。 JPEG 是有损压缩,会在阈值边界附近生成原本不存在的中间灰度(比如本该是 0 的地方出现 8、13),而掩膜的全部意义就是「非 0 即 1」。调试掩膜一律用 .png,一步就能避免这种自找的困惑。
【:原图 + H 通道灰度图 + blue_channel 对比,说明「同一块蓝,在三个通道里长什么样」。】
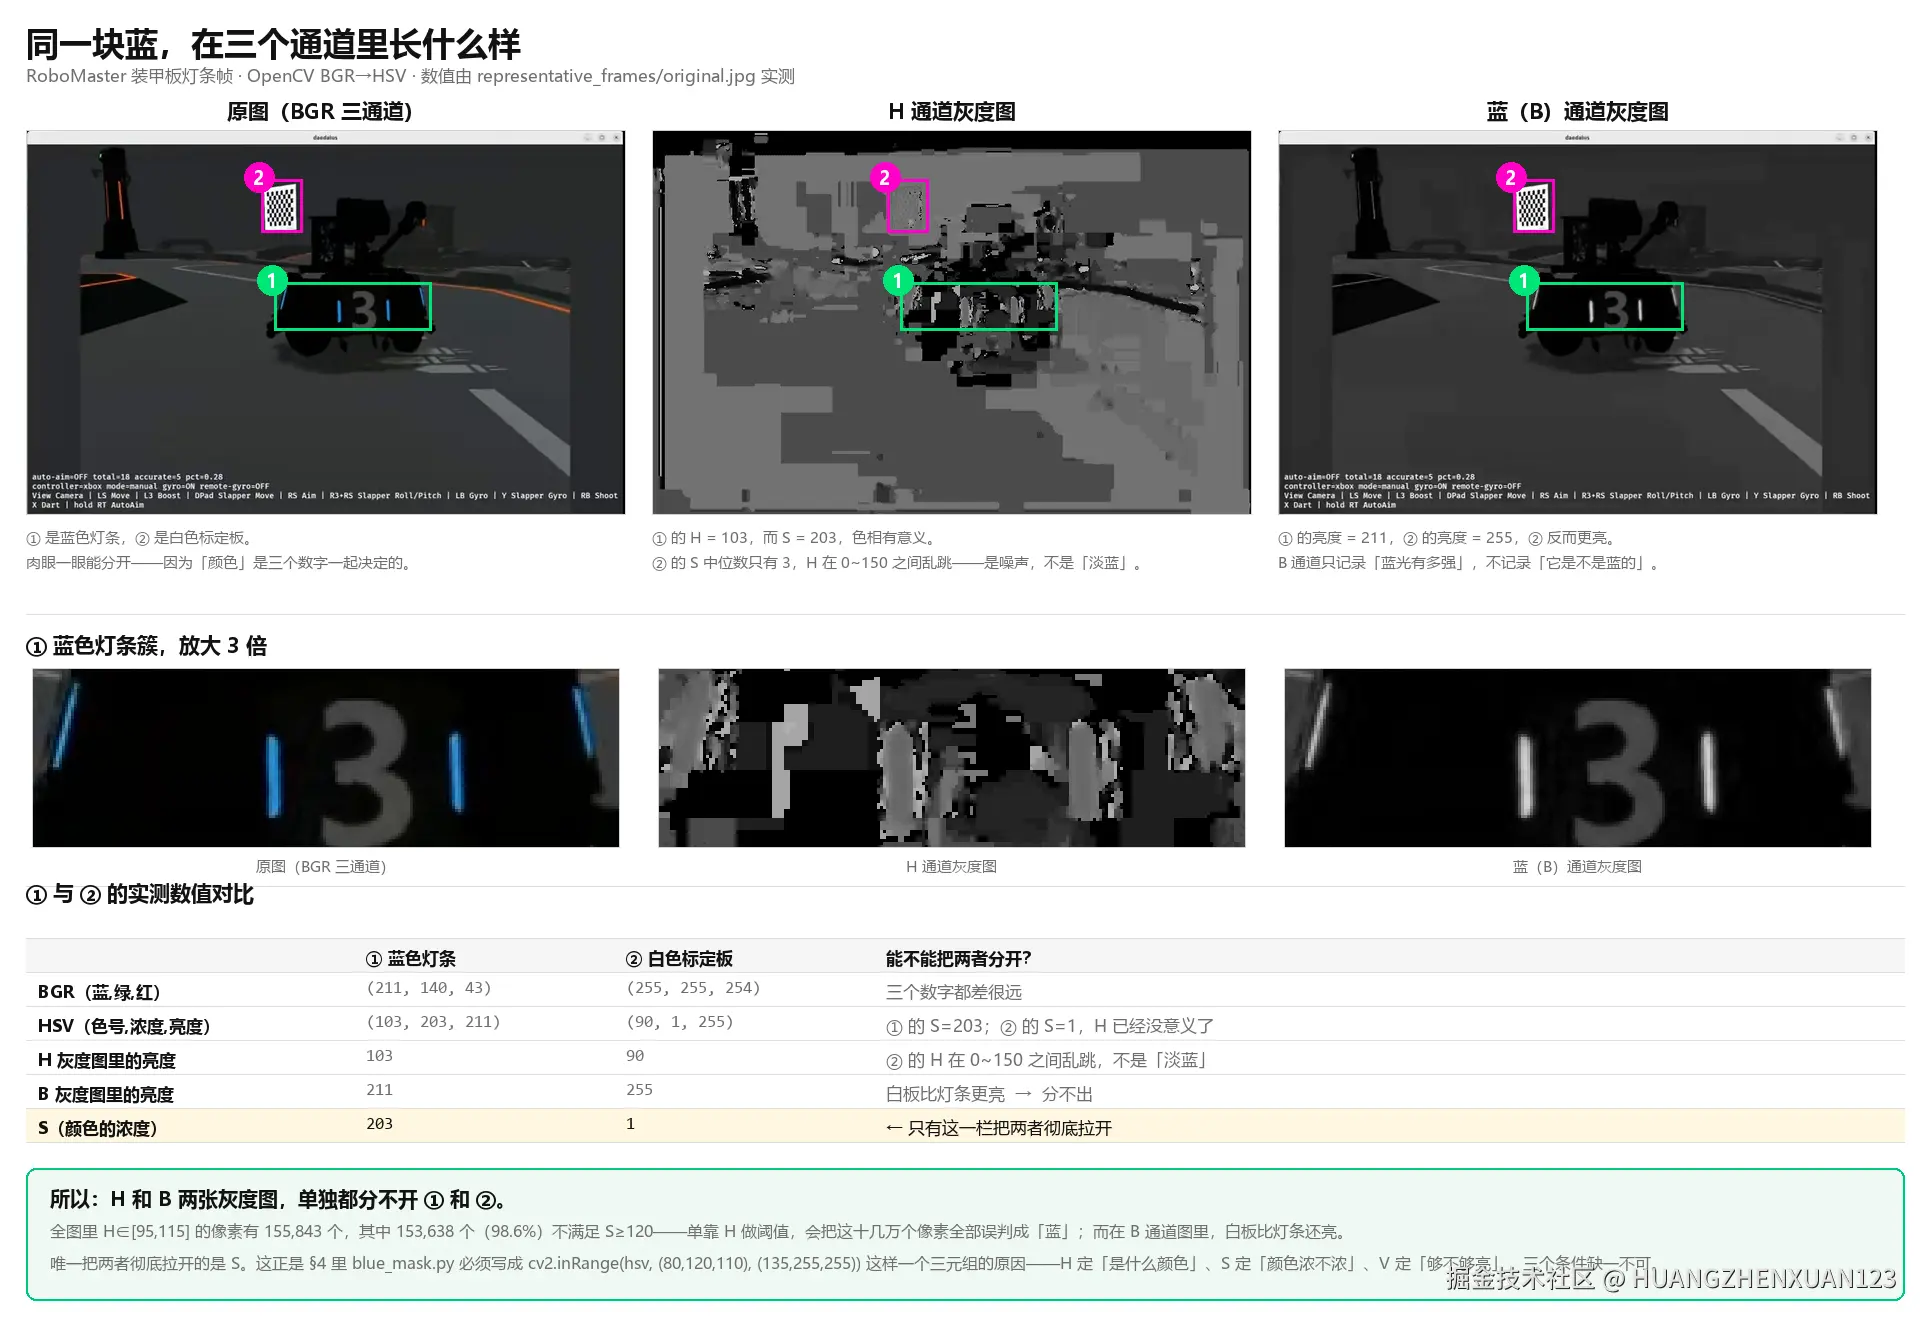 可改进 :参数从
sys.argv 换成 argparse(自带 --help 和类型校验)、输出格式改 .png、把 image.shape 与 image.dtype 打出来(uint8 还是 float32 决定了后续 inRange 的哪个刻度:)。
4. blue_mask.py:一次「颜色怎么算」的完整推导
这个 96 行的文件是整个任务一的算法核心,值得逐段看。
python
hsv = cv2.cvtColor(image, cv2.COLOR_BGR2HSV)

lower_blue = (80, 120, 110)

upper_blue = (135, 255, 255)

hsv_mask = cv2.inRange(hsv, lower_blue, upper_blue)
(1) H 的范围是 0--179,不是 0--360。 OpenCV 为了把 H 塞进 8 位整数,把 360° 压缩了一半。这意味着如果有人按「角度」的直觉写下 upper_blue = (360, 255, 255),inRange 不会报错,它只会让整个掩膜变成全黑------因为 360 超出 uint8 的表示范围,阈值条件永远不成立。这是最典型的「静默失效」:程序跑通了,输出全黑,你却在怀疑视频格式。
(2) cv2.subtract 而不是 numpy 减法,是这段代码最值得讲的一行。
python
blue_channel, green_channel, red_channel = cv2.split(image)

blue_difference = cv2.subtract(blue_channel, red_channel)

difference_mask = cv2.threshold(

blue_difference, 40, 255, cv2.THRESH_BINARY

)[1]
图像是 uint8,取值范围 0--255。如果这里写成 blue_channel - red_channel,numpy 会做模 256 回绕 :10 - 20 得到的不是 0,而是 246。结果就是「红比蓝强的像素」被算成了「极度偏蓝」,掩膜完全反过来,而且不会报任何错。cv2.subtract 做的是饱和运算 ,10 - 20 得到 0,这才是「差值」应有的语义。
一句话记住:只要在两幅
uint8图像之间做减法,就用cv2.subtract,别用-。
(3) cv2.threshold 返回的是元组。 它返回 (retval, dst),这里用 [1] 取第二个元素(二值化后的图)。很多人第一次写会忘记下标,然后得到一个 tuple,在后面 bitwise_and 时才报出莫名其妙的类型错误。
(4) 两个掩膜求交,才是最终判据。
python
blue_mask = cv2.bitwise_and(hsv_mask, difference_mask)-
hsv_mask回答的是「色相是否落在蓝色区间」; -
difference_mask回答的是「蓝通道是否明显强于红通道」; -
两者的交集回答的是「既符合蓝色色相、又确实是蓝主导」。
为什么需要第二个条件?因为在高光、过曝、偏白的区域,H 值会剧烈跳变甚至落到蓝色区间里,光看 H 会把白色反光误判成灯条。用两个弱相关特征求交,比把一个特征调到极致更稳------这也是后面任务一能靠一套固定阈值跑完整段视频的原因。
(5) bitwise_and(image, image, mask=...) 是抠图的标准写法。
python
blue_result = cv2.bitwise_and(image, image, mask=blue_mask)同一个图和自己做按位与,结果就是原图本身;mask 参数则决定「哪些位置保留原值、哪些位置清零」。等价于先 copy() 再逐像素置黑,但是 C 层实现,一次调用完成。mask 必须是单通道,且尺寸与原图一致。
(6) 用 countNonZero 把效果量化。
python
white_pixels = cv2.countNonZero(blue_mask)

total_pixels = blue_mask.shape[0] * blue_mask.shape[1]

percentage = white_pixels / total_pixels * 100
这 3 行让调参从「肉眼看图」变成了「看一个数」。改阈值时,占比从 2.1% 跳到 8.4%,你就知道这一改动了多大的面积。
但要注意这个指标的局限 :它只统计「面积占比」,不区分「正确检出的灯条」和「误检的噪点」。占比变大既可能是灯条更完整,也可能只是噪点变多。所以它适合作为方向指示,真正的判断仍要靠候选轮廓的数量与位置(这正是
contours.py要解决的问题)。
【:hsv_mask / difference_mask / blue_mask / blue_result 四联图,直观展示「求交」把哪些区域砍掉了。这张对比图是本节最有说服力的材料。】
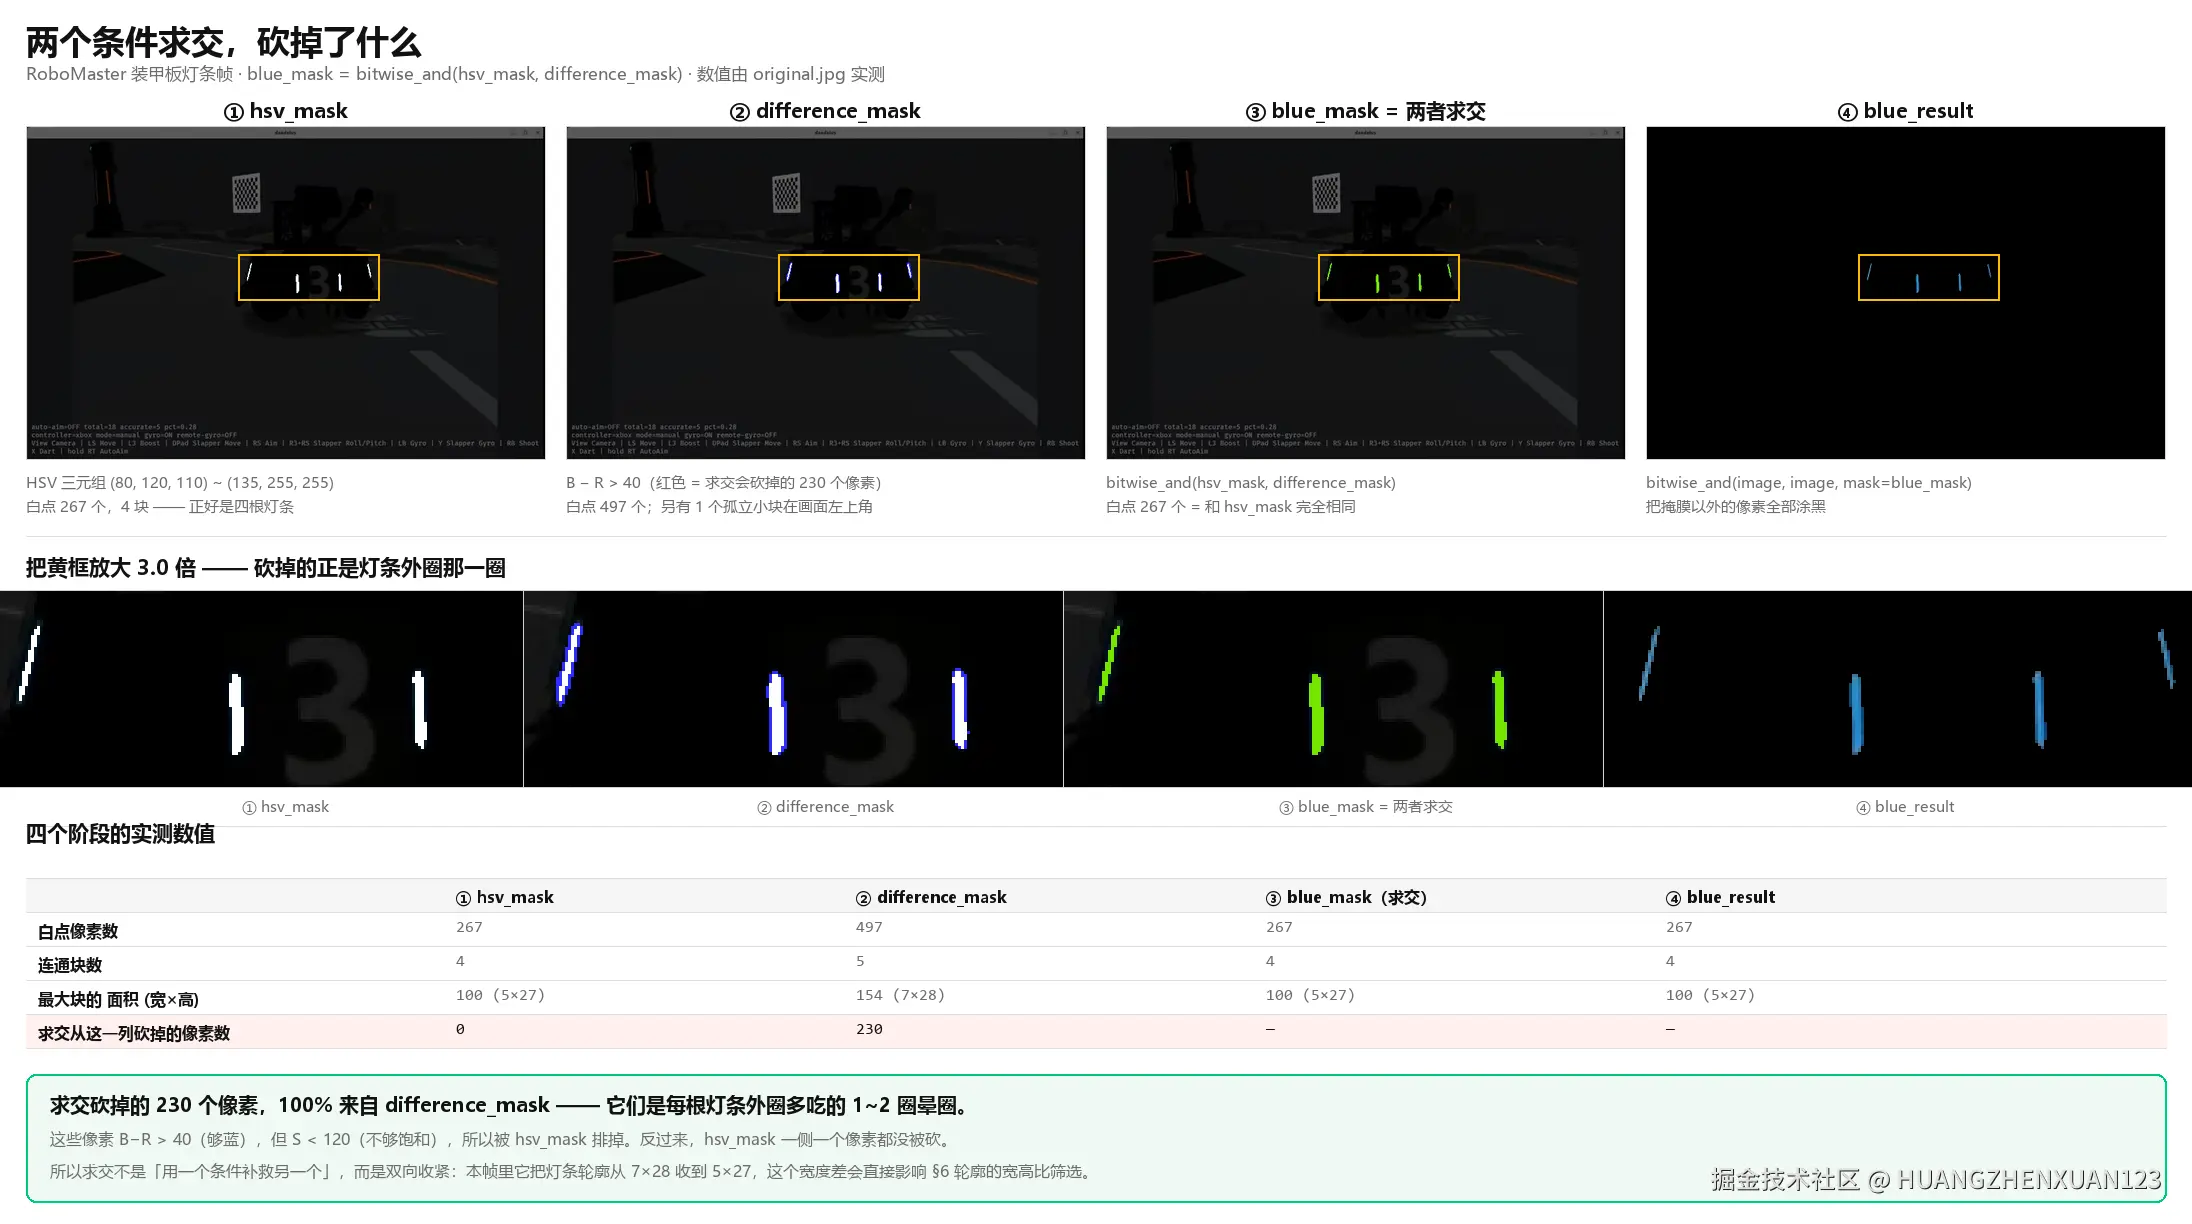 可改进 :三个阈值目前是函数内的裸变量,建议提到文件顶部或改成命令行参数;再进一步,可以把掩膜以半透明叠加的方式画在原图上(
cv2.addWeighted),比黑底抠图更容易看出边界对不准的问题。
5. morphology.py:1×1 的卷积核等于什么也没做
这个文件用 6 次调用穷举了 {1×1, 3×3, 7×7} × {开运算, 闭运算}:
python
kernel_1x1 = cv2.getStructuringElement(cv2.MORPH_RECT, (1, 1))

opened_1x1 = cv2.morphologyEx(mask, cv2.MORPH_OPEN, kernel_1x1)

closed_1x1 = cv2.morphologyEx(mask, cv2.MORPH_CLOSE, kernel_1x1)

# ... 3x3 与 7x7 同理
先说结论:1×1 结构元下的开运算和闭运算都是恒等变换。 腐蚀和膨胀都是「用结构元覆盖的邻域求最小/最大值」,当结构元只有一个像素时,邻域就是它自己,输出必然等于输入。所以:
text
MORPH_OPEN (1×1) ≡ MORPH_CLOSE (1×1) ≡ 原图这直接解释了一个看起来奇怪的现象:任务一的 README 里写着「形态学卷积核 1 × 1(对比实验后保留流程)」。准确的表述应该是:这一步被保留了,但它对图像不做任何修改。 我试过、发现大核会吃细长目标、所以我把它退化成空操作,而不是含糊地写成「使用形态学去噪」。
这里还暴露了一个实验记录上的问题。 同目录的 experiment_notes.md 写的是:
text
## 初步选择

当前图片暂时选择 3x3,因为它对目标形状影响较小。
而最终视频流程用的是 1×1。两者并不矛盾,但说明实验记录缺少「适用范围」这一栏:那句结论是在单张图上得出的,换到整段视频就成了另一回事。写实验记录时至少标注三件事------用的哪张图、信噪比大概什么水平、结论适用于哪些帧。
开运算和闭运算的区别(对照着记):
| 操作 | 顺序 | 主要作用 | 过头的后果 |
|---|---|---|---|
开运算 MORPH_OPEN |
先腐蚀后膨胀 | 去掉零散小亮斑、断开细连接 | 细小目标(远景灯条)整体消失 |
闭运算 MORPH_CLOSE |
先膨胀后腐蚀 | 填补内部空洞、连接断裂 | 相邻目标粘连成一个 |
可改进 :现在 6 个变量是手写的,加一个 5×5 就要再抄两段。改成循环 + 打印每个结果的 countNonZero,就能把「肉眼对比」升级成「量化对比」:
python
for k in (1, 3, 7):

kernel = cv2.getStructuringElement(cv2.MORPH_RECT, (k, k))

for name, op in (("open", cv2.MORPH_OPEN), ("close", cv2.MORPH_CLOSE)):

out = cv2.morphologyEx(mask, op, kernel)

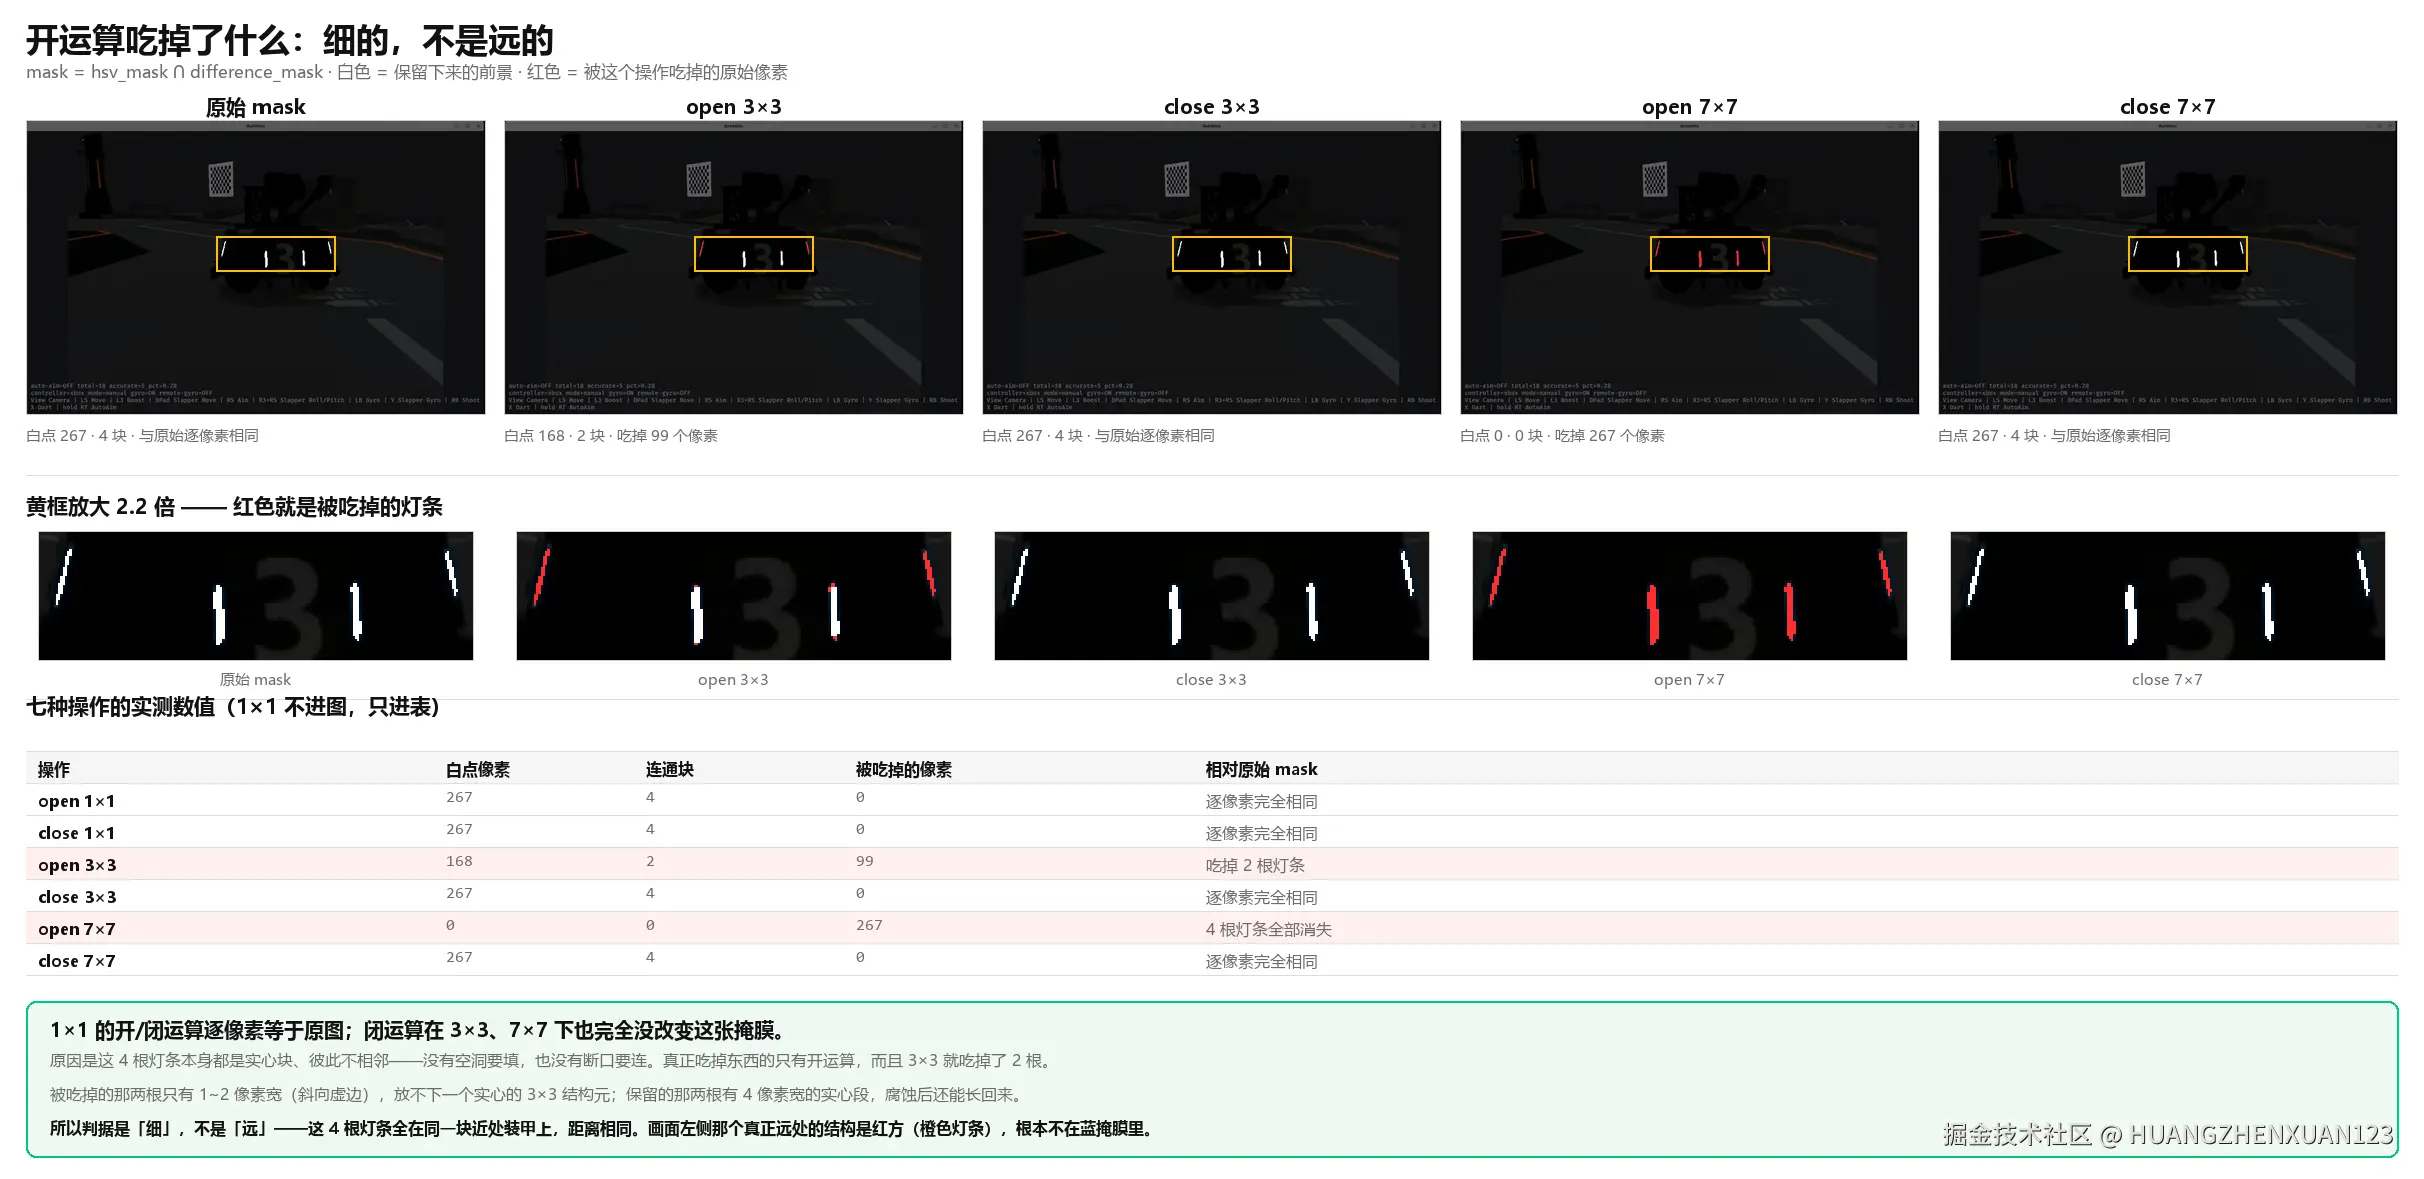
print(f"{name} {k}x{k}: 前景像素 = {cv2.countNonZero(out)}")【mask_original 与 3×3 / 7×7 的开闭结果拼图,重点展示「7×7 开运算把远处灯条吃掉了」。】 但要注意「远景」这个说法。 实测本帧,被 3×3 开运算吃掉的两根灯条并不比另外两根远 ------四根都在同一块近处装甲上,距离相同。它们被吃掉的原因是细:
| 灯条 | 面积 | 外接框 | 填充率 | 3×3 开运算 |
|---|---|---|---|---|
| 左外 | 47 | 7×25 | 27% | 消失 |
| 右外 | 39 | 6×20 | 32% | 消失 |
| 左内 | 100 | 5×27 | 74% | 保留(100 → 96) |
| 右内 | 81 | 5×26 | 62% | 保留(81 → 72) |
腐蚀要求「结构元覆盖范围内全部是前景」。那两根消失的灯条在掩膜里只是 1~2 像素宽的斜向虚边,一个 3×3 的实心块都放不下,腐蚀一次就整根没了;保留的那两根有 4 像素宽的实心段,腐蚀后虽然变细,膨胀还能长回来。
顺带:闭运算在 3×3、7×7 下也完全没改变这份掩膜(267 → 267,始终 4 块)。四根灯条本身是实心块、彼此不相邻,没有空洞要填、没有断口要连。
(画面左侧确实有个真正远处的结构,但那是红方------橙色灯条,根本不在蓝掩膜里。)
6. contours.py:筛选条件是怎么来的
这是练习目录里信息密度最高的文件。核心在循环里:
python
contours, _ = cv2.findContours(

mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE

)

# ...

for contour in contours:

area = cv2.contourArea(contour)

if area < min_area or area > max_area:

continue

rectangle = cv2.minAreaRect(contour)

center, size, angle = rectangle

width, height = size

short_side = min(width, height)

long_side = max(width, height)

if short_side <= 0:

continue

aspect_ratio = long_side / short_side

# ...

fill_ratio = area / rectangle_area
(1) findContours 的返回值数量随版本变化。 OpenCV 3.x 返回三个值 (image, contours, hierarchy),4.x 起改成两个 (contours, hierarchy)。现在写的 contours, _ = 在 OpenCV 4/5 下正确,但如果哪天环境退到 3.x,会直接抛 ValueError: too many values to unpack。这里用的是 OpenCV 5.0.0,所以没问题------但这段代码等于把版本绑死在 4.0 以上,
(2) RETR_EXTERNAL + CHAIN_APPROX_SIMPLE 是性价比最高的组合。 前者只取最外层轮廓(灯条的孔洞、内部纹理全忽略),后者只保留拐点、丢掉直线上的中间点。两者的共同效果是:轮廓数量更少、每个轮廓的点更少,后面所有计算的代价都跟着降。
(3) 长宽比必须先归一化,这一步绝不能省。
python
width, height = size

short_side = min(width, height)

long_side = max(width, height)

aspect_ratio = long_side / short_side
minAreaRect 返回的 (width, height) 不保证顺序 :同一个矩形,旋转角度跨过某个阈值后,宽高会互换。如果直接写 aspect_ratio = width / height,那这个值会在 15 和 1/15 之间反复横跳,筛选结果随角度剧烈变化------而且看起来「有时候能跑对」,极难排查。用 min/max 归一化之后,长宽比恒 ≥ 1,语义才是稳定的「细长程度」。
(4) 填充率是个聪明的补充判据。
python
fill_ratio = area / rectangle_area # 轮廓面积 / 旋转矩形面积-
规则的细长灯条:轮廓几乎填满矩形,
fill_ratio接近 1; -
弯折、带毛刺、形状不规则的目标:填充率明显偏低。
它补上了「面积 + 长宽比」会漏掉的一类情况------形状不对但尺寸对的干扰物(比如一段斜着的细长反光)。用一个额外判据换掉一批误检,代价只是两次乘除。
(5) 但这里有一个真正的空条件。
python
min_aspect_ratio = 1.0

max_aspect_ratio = 15.0

# ...

if (

aspect_ratio < min_aspect_ratio

or aspect_ratio > max_aspect_ratio

):

continue
因为 aspect_ratio = long_side / short_side,恒有 aspect_ratio >= 1,所以 aspect_ratio < 1.0 永远不成立。下界这一半是死代码。
这不算 bug(不影响结果),但它是「参数没想清楚」的信号:写下 1.0 的时候,脑子里想的可能还是「1:1 到 1:15」,而没意识到归一化之后下界已经自动满足了。改法有两种 :要么去掉下界、只留 max_aspect_ratio(语义更诚实);要么把下界抬到真实有区分度的值(任务一用的是 1.5,它确实能滤掉近方形的干扰)。
(6) 三处参数各写一套。 对比一下同名参数:
| 参数 | contours.py |
polygon_approximation.py |
task1 README |
|---|---|---|---|
| 最小面积 | 10 | 100 | 3 |
| 最大面积 | 5000 | 100000 | 100000 |
| 长宽比下界 | 1.0 | 1.5 | 1.5 |
| 长宽比上界 | 15.0 | 20 | 20 |
三份数值都不一样。这在练习阶段完全正常(本来就是拿来试的),但写博客时值得主动点破 :最终起作用的只有任务一那一套,练习目录里的数字是历史痕迹。更重要的是引出结论------阈值一旦超过两个脚本都要用,就该抽到配置文件里,否则「哪一份是准的」只能靠回忆。
(7) 代码卫生。 第 43 行 max_area = 5000 后面跟着两个空格,且这一行和下面的 for 之间少了空行;第 25--28 行有一个多余空行。不影响运行,但这类痕迹会让代码看起来比实际更「临时」。上一个 ruff 或 black 就能统一掉。
7. polygon_approximation.py:为什么多边形没能进入最终方案
这个文件不在 README 的目录结构里,但它做的事情很关键------同时画出轮廓、多边形近似、旋转矩形三种表达,用来决定最终用哪一种。
python
perimeter = cv2.arcLength(contour, True)

polygon = cv2.approxPolyDP(

contour,

0.02 * perimeter,

True,

)
approxPolyDP 的第二个参数是精度,不是形状。 epsilon = 0.02 * perimeter 的含义是:允许近似折线偏离原轮廓的最大距离为周长的 2%。epsilon 越小,折线越贴近原轮廓、顶点越多;epsilon 越大,顶点越少、越接近一个粗粒度的多边形。True 表示轮廓是闭合的。
三个候选方案的定位差别是这样的:
| 表达方式 | 输出 | 优点 | 缺点 |
|---|---|---|---|
| 原始轮廓 | 几十到几百个点 | 信息最全 | 点数随形状波动,不适合做特征 |
| 多边形近似 | 几个顶点 | 顶点数可作为形状特征(4 个点 ≈ 四边形) | 对 epsilon 敏感,容易多出/少掉顶点 |
旋转矩形 minAreaRect |
中心 + 宽高 + 角度 | 维度固定、可直接算长宽比 | 丢失形状细节 |
最后选旋转矩形,原因很实用:它输出维度固定 。轮廓点数会变,顶点数会抖,而 (center, size, angle) 永远是三个数------这对于「拿阈值去筛」这件事是决定性的。
但这份对比实验在本帧上其实是空跑的。 脚本的 min_area = 100 把四条轮廓全部过滤掉了------它们最大的 contourArea 只有 72。结果是三张输出图与原图逐字节相同 (MD5 一致),valid_count = 0,一条线都没画出来。
把 min_area 降到 10(也就是 contours.py 用的值)才画出东西:
| id | 轮廓点数 | 多边形顶点数 | epsilon | 旋转矩形 |
|---|---|---|---|---|
| 0 | 14 | 5 | 1.13 | 3 个数 |
| 1 | 14 | 4 | 1.08 | 3 个数 |
| 2 | 20 | 4 | 0.84 | 3 个数 |
| 3 | 25 | 3 | 1.06 | 3 个数 |
四根灯条是同一种东西,多边形顶点数却给出 5 / 4 / 4 / 3。 拿它当形状特征,阈值根本没法定;而旋转矩形恒定输出 3 个数。这就是"选 minAreaRect 不是因为它更准,而是因为它的输出维度固定"的实证------形状上三者几乎完全重合,看合并图就能确认。
顺带一个渲染顺序问题。 合并图的绘制顺序是「轮廓(2px) → 多边形(3px) → 矩形(2px)」,后画的盖住先画的。四条线本来就几乎重合,结果蓝色轮廓被红色多边形盖掉、红蓝又被绿色矩形盖掉,肉眼在第③格里基本只看得见绿色。要同时看清三者,得改成三条细线,或者把三种表达并排画而不是叠加。
这段代码留下的最大价值是它的「未完成感」。 polygon 被算出来了、也被画出来了,但从未参与筛选:
python
cv2.drawContours(polygon_result, [polygon], -1, (0, 0, 255), 3)

# 然后就没有了:polygon 再没被用到
这是一次「做了对比实验,但实验结论没有改变决策」的诚实痕迹。如果要把这个思路用起来,最自然的一步是用顶点数当形状特征:
python
if len(polygon) == 4: # 近似四边形 → 更像装甲板本体

...
还有一个细节值得表扬、也应该推广:这个文件做了尺寸一致性校验。
python
if image.shape[:2] != mask.shape[:2]:

print("原图和掩膜尺寸不一致")

return 1掩膜和原图尺寸不一致时,drawContours 和 bitwise_and 会给出要么报错、要么错位的结果。这是六个文件里唯一做了这道校验的,其它文件都应该抄过去。
最后一个副作用需要说明。 它的输出目录是任务一的交付目录:
python
output_dir = Path("task1_lightbar/representative_frames")一个基础练习脚本往任务一的交付目录里写文件,模块边界被穿透了。好处是------任务一 README 里那些代表帧,其实就是这个脚本生成的 ,这解释了那批图的来源;坏处是读者按顺序执行练习脚本时,会意外改动任务一的提交材料。更干净的做法是输出到自己的 output/,需要时再手动挑选。
【插图位:raw_contours / polygon_approximation / contour_polygon_rectangle 三张图,蓝线=轮廓、红线=多边形、绿线=旋转矩形,一眼看出三者的取舍。】
8. extract_frame.py:最短的文件,两个真实隐患
40 行,但正是这个文件最能说明「调试工具也值得写好」。
python
video_path = Path(sys.argv[1])

frame_number = int(sys.argv[2])

capture = cv2.VideoCapture(str(video_path))

if not capture.isOpened():

print(f"无法打开视频: {video_path}")

return 1

capture.set(cv2.CAP_PROP_POS_FRAMES, frame_number)

success, frame = capture.read()

capture.release()

if not success:

print(f"无法读取第 {frame_number} 帧")

return 1

output_path = Path("opencv_basics/debug_frame.jpg")

cv2.imwrite(str(output_path), frame)
(1) int(sys.argv[2]) 没有防错。 其它文件都做了 len(sys.argv) 校验,但这里少了类型校验:python extract_frame.py a.mp4 abc 会直接抛 ValueError 回溯,而不是给出「帧号必须是整数」的提示。一致性上的小缺口,修起来就是加个 try/except 或换 argparse(type=int)。
(2) 输出路径有三重隐患叠在一起。 Path("opencv_basics/debug_frame.jpg") 是相对当前工作目录的硬编码路径,而且:
-
没有
parent.mkdir(parents=True, exist_ok=True)------目录不存在时不会自动建; -
cv2.imwrite的返回值没有被检查 ------imwrite写失败只返回False,不抛异常。
两个问题叠加的结果是:从 opencv_basics/ 目录里运行这个脚本,路径会变成 opencv_basics/opencv_basics/debug_frame.jpg,写入静默失败,而程序照旧打印「已保存第 N 帧」。你去找图,找不到;去怀疑帧号,方向全错。
对比一下
contours.py里的写法------它检查了返回值:
python
saved = cv2.imwrite(str(output_path), result)

if not saved:

print(f"保存结果失败: {output_path}")

return 1
同一个项目里两种标准,这不只是风格问题,而是「哪些失败会被发现」的问题。 建议统一成后者。
(3) capture.set(CAP_PROP_POS_FRAMES, ...) 是「近似跳转」。 对部分编码(尤其带 B 帧的 H.264)来说,定位到第 N 帧可能落在 N 附近而不是精确的 N,而且 read() 返回的第一帧未必就是你想要的那帧。抽帧做调试时,最好把实际读到的帧号也打印出来核对:
python
print(f"请求帧号: {frame_number}, 实际位置: {capture.get(cv2.CAP_PROP_POS_FRAMES)}")为什么这个工具重要? 因为调参时反复跑整段视频,一次要几十秒;抽一帧出来单独试,一秒出结果。调试链路的效率,最终会转化成调参的质量------能在同样的时间里多试 20 组阈值,结果自然不一样。
9. 这一部分的小结
练习目录里踩到的坑,全部在任务一里复现了一遍(或者被提前避开了):
| # | 坑 | 出现在 | 后果 | 对任务一的影响 |
|---|---|---|---|---|
| 1 | HSV 的 H 只有 0--179 | blue_mask.py |
写成 0--360 会静默得到全黑掩膜 | 阈值范围写对了 |
| 2 | uint8 相减会回绕 |
blue_mask.py |
用 - 会把掩膜完全反过来 |
用了 cv2.subtract |
| 3 | minAreaRect 宽高顺序不定 |
contours.py |
长宽比在 15 与 1/15 间跳变 | 统一用 min/max 归一化 |
| 4 | 1×1 结构元 = 恒等变换 | morphology.py |
以为在做去噪,实际没做 | README 里如实标注为 1×1 |
| 5 | 相对路径 + 不查 imwrite |
extract_frame.py |
写图失败但打印成功 | 输出统一从仓库根目录运行 |
如果让我重写这一部分,只做三件事: 把重复的 main() 模板抽成一个公共模块;把所有阈值集中到一个配置文件;给每个练习脚本的输出加上前景像素数统计,让对比从「看图」变成「看数」。
下一部分预告
第 2 部分讲 task1_lightbar/detect_video.py(227 行,任务一的主体):逐帧主循环怎么组织、耗时统计应该把哪一段包进去、VideoWriter 为什么经常写出 0 字节文件、以及参数为什么至今还写在代码里。