《Agentic Design Patterns》第 8 章导读:记忆管理(Memory Management)
本文是对开源书籍《Agentic Design Patterns》第 8 章的解读与导读,内容忠实呈现原文,并附个人思考。
原书在线阅读:https://adp.xindoo.xyz/ | 翻译项目代码仓库:https://github.com/xindoo/agentic-design-patterns
你有没有过这种经历:跟一个 AI 助手聊了半天,它突然忘了你刚说过的话?或者你上周刚告诉过它你的偏好,这周它又问一遍?
这些问题的本质都是记忆。人类有短期记忆(工作记忆)和长期记忆,前者让你能连贯地对话,后者让你记住人和事。智能体也一样------没有记忆,它永远只能处理"当前这一句",永远是"第一次见你"。
第 8 章讲的记忆管理(Memory Management) ,就是解决这个问题的:怎么让智能体记住事情?记多久?怎么存?怎么取?
一、两种记忆:短期 vs 长期
书中把智能体的记忆分为两大类,跟人类的记忆系统很像:
| 记忆类型 | 对应人类 | 存储位置 | 特点 |
|---|---|---|---|
| 短期记忆(上下文记忆) | 工作记忆 | LLM 上下文窗口 | 容量有限、临时、会话结束就没了 |
| 长期记忆(持久记忆) | 长期知识库 | 外部数据库/向量库 | 容量大、持久、跨会话 |
短期记忆保存的是当前正在处理的信息------最近的对话消息、智能体的回复、工具调用结果、反思内容等等。它的好处是直接、即时,LLM 一眼就能看到。但问题也很明显:上下文窗口就那么大,装不下太多东西;而且会话一结束,这些信息就全没了。
"长上下文模型"本质上只是扩大了短期记忆的容量------原来能记 10 轮对话,现在能记 100 轮了。但它还是"临时的",下次对话又从零开始。而且长上下文的处理成本也高。
长期记忆 就不一样了。它存在智能体"外面"------通常是数据库、知识图谱或向量数据库里。智能体需要的时候,就去查一下,把相关的信息"加载"到短期记忆里用。向量数据库的好处是可以做语义搜索------按含义相似性检索,而不是精确匹配关键词。
这个"外部存储 + 按需检索 + 注入上下文"的模式,其实就是我们常说的 RAG(检索增强生成)的底层逻辑。
二、记忆的用武之地
记忆管理不是锦上添花,而是智能体从"问答工具"升级为"智能助手"的必要条件。书中列举了几个主要应用场景:
- 聊天机器人与对话式 AI:短期记忆维持对话连贯性,长期记忆记住用户偏好和历史,让交互更个性化。
- 面向任务的智能体:短期记忆跟踪任务进度(做到哪一步了、目标是什么),长期记忆存放用户的特定数据。
- 个性化体验:长期记忆存用户偏好、行为习惯、个人信息,让智能体"越用越懂你"。
- 学习与改进:把成功的策略、犯过的错误存进长期记忆,下次遇到类似情况就能做得更好。
- 信息检索(RAG):知识库就是智能体的长期记忆,回答问题前先去"回忆"相关知识。
- 自主系统:机器人/自动驾驶汽车用短期记忆处理当前环境,用长期记忆存储地图、路线等通用知识。
一句话:记忆让智能体有了"历史感"和"身份感"------它知道你是谁、你们聊过什么、之前做过什么,而不是每次都像第一次见面。
三、Google ADK 的记忆三件套:Session / State / Memory
Google ADK 把记忆管理拆成了三个层级,设计得很清晰:
- Session(会话):一个独立的聊天线程,记录这个对话里的所有消息和操作(Events)
- State(状态):Session 里的"草稿本",存当前对话的临时数据
- Memory(记忆):跨会话的可搜索知识库,是真正的"长期记忆"
Session:管理聊天的整个生命周期
Session 是 ADK 中最基础的记忆单元。每个聊天线程对应一个 Session 对象,里面存了:
- 唯一标识符(谁的、哪个应用、哪个会话)
- 事件的时间顺序记录(用户说的话、智能体的回复、工具调用......)
- 状态数据(state)
- 最后更新时间戳
SessionService 负责管理会话的整个生命周期:创建、恢复、记录活动、删除。书中给出了三种实现:
python
# 1. 内存版(适合测试,重启就没)
from google.adk.sessions import InMemorySessionService
session_service = InMemorySessionService()

# 2. 数据库版(持久化,生产用)
from google.adk.sessions import DatabaseSessionService
session_service = DatabaseSessionService(db_url="sqlite:///./my_agent_data.db")

# 3. Vertex AI 版(Google Cloud 上的可扩展生产方案)
from google.adk.sessions import VertexAiSessionService
session_service = VertexAiSessionService(project=PROJECT_ID, location=LOCATION)
State:会话的草稿本
每个 Session 都有一个 state 字典,就像智能体在对话期间的临时工作记忆。session.events 存的是完整聊天历史,而 session.state 存的是结构化的动态数据------用户偏好、任务进度、标志位等等。
State 的组织也很有讲究,用键前缀区分作用域:
user:前缀:跟用户绑定,跨所有会话持久化app:前缀:应用级数据,所有用户共享temp:前缀:只在当前处理轮次有效,不持久存储
更新 State 有两种方式:
简单方式------output_key:直接把智能体的文本响应存到 state 里。
python
greeting_agent = LlmAgent(
    name="Greeter",
    model="gemini-2.0-flash",
    instruction="生成一个简短、友好的问候语。",
    output_key="last_greeting"  # 自动把响应存到 state["last_greeting"]
)
标准方式------在工具里用 tool_context.state:适合更复杂的状态更新。
python
def log_user_login(tool_context: ToolContext) -> dict:
    state = tool_context.state
    # 递增登录次数
    state["user:login_count"] = state.get("user:login_count", 0) + 1
    state["task_status"] = "active"
    state["user:last_login_ts"] = time.time()
    state["temp:validation_needed"] = True
return {"status": "success", "message": f"总登录次数:{state['user:login_count']}"}书中特别提醒:不要直接修改 session.state 字典,要走标准的事件处理机制(output_key 或 state_delta)。直接改会绕过事件历史、可能不持久化、还可能有并发问题。
MemoryService:长期记忆
Session 和 State 是"单次聊天的短期记忆",MemoryService 管的是"跨聊天的长期记忆"。
MemoryService 的核心能力就两个:
- 存 :把会话里的内容提取出来存进长期记忆(
add_session_to_memory) - 取 :按语义搜索相关记忆(
search_memory)
同样有多种实现:
python
# 内存版(测试用)
from google.adk.memory import InMemoryMemoryService
memory_service = InMemoryMemoryService()

# Vertex AI RAG 版(生产用,语义搜索)
from google.adk.memory import VertexAiRagMemoryService
memory_service = VertexAiRagMemoryService(
    rag_corpus=RAG_CORPUS_RESOURCE_NAME,
    similarity_top_k=5,
    vector_distance_threshold=0.7
)
四、LangChain / LangGraph 中的记忆
LangChain 生态也有完整的记忆管理方案。
短期记忆:对话历史
最基础的是 ChatMessageHistory(手动管理)和 ConversationBufferMemory(自动集成到链中):
python
from langchain.memory import ConversationBufferMemory
from langchain.chains import LLMChain

memory = ConversationBufferMemory(memory_key="history")
conversation = LLMChain(llm=llm, prompt=prompt, memory=memory)

# 对话会自动记住历史
conversation.predict(question="我想预订航班。")
conversation.predict(question="我叫 Sam。")
conversation.predict(question="我的名字是什么?")  # 它会回答 Sam
长期记忆:三种类型 + BaseStore
LangGraph 把长期记忆细分为三类,跟人类记忆的分类很对应:
| 类型 | 人类对应 | 存什么 | 用途 |
|---|---|---|---|
| 语义记忆 | 记住事实 | 用户偏好、领域知识 | 个性化交互 |
| 情景记忆 | 记住经历 | 过去的事件、成功的交互序列 | 少样本提示、经验复用 |
| 程序记忆 | 记住规则 | 核心指令、行为模式 | 自我改进(反思 → 更新指令) |
存储上用 BaseStore,按命名空间组织,支持语义搜索:
python
from langgraph.store.memory import InMemoryStore

store = InMemoryStore(index={"embed": embed_fn, "dims": 2})

# 按命名空间 + 键存储
store.put(
    (user_id, "chitchat"),  # 命名空间(类似文件夹)
    "a-memory",              # 键(类似文件名)
    {"rules": ["用户喜欢简短语言", "用户只说英语和 python"]}
)

# 按内容语义搜索
items = store.search(
    (user_id, "chitchat"),
    query="语言偏好"
)最有意思的是程序记忆的自我更新------智能体通过"反思"来修改自己的指令:
- 回顾当前指令和最近交互;
- 找出可以改进的地方;
- 生成新的、更好的指令;
- 存回长期记忆,下次就用新指令工作。
这其实就是让智能体自己"进化"自己的行为模式。
五、Vertex Memory Bank:托管式长期记忆
最后,书中还介绍了 Vertex AI 的 Memory Bank 服务------一个托管的长期记忆方案。
它的工作方式是:用 Gemini 模型异步分析对话历史,自动提取关键事实和用户偏好,存进持久化存储。新会话开始时,智能体可以通过语义搜索把相关记忆"调出来",实现跨会话的连续性和个性化。
好处是开箱即用,不用自己搭向量数据库、写提取逻辑。而且不仅支持 Google ADK,还支持 LangGraph、CrewAI 等其他框架。
六、速览
- 问题背景:智能体需要记住过去的交互才能执行复杂任务、提供连贯体验。没有记忆,智能体只能做一次性问答,无法维护对话上下文、无法从经验中学习、无法提供个性化响应。核心难题是怎么同时管理好"当前对话的临时信息"和"长期积累的持久知识"。
- 解决方案:实现"短期 + 长期"的双组件记忆系统。短期记忆在 LLM 上下文窗口内保存最近交互,维持对话流畅;长期记忆用外部数据库(如向量存储)实现,支持高效语义检索。框架(如 Google ADK)提供专门的组件来管理这个过程:Session 管对话线程,State 管临时数据,MemoryService 管长期知识库。
- 实践建议:当智能体不只是回答单个问题时,就需要记忆管理。需要维护对话上下文、跟踪多步骤任务进度、通过回忆用户偏好提供个性化交互、从过去的成功/失败中学习改进------这些场景都离不开记忆。
七、可视化总结
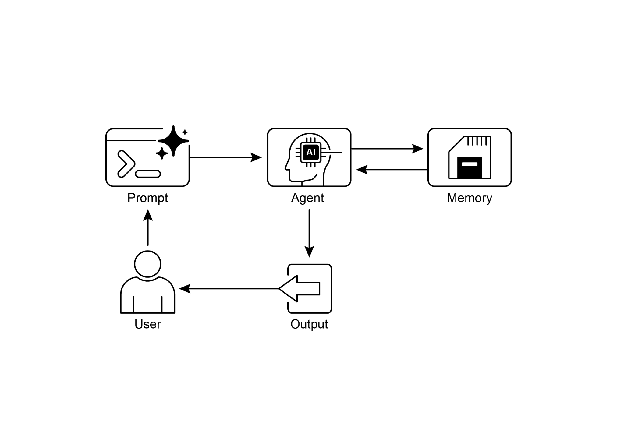
图 1:记忆管理设计模式------短期记忆维持当前对话,长期记忆跨会话积累知识。
关键要点
- 记忆对于智能体处理事务、学习和个性化交互至关重要;
- 对话式 AI 依赖两种记忆:单个聊天的短期记忆 ,和跨会话的长期记忆;
- 短期记忆是临时的,通常受 LLM 上下文窗口限制;
- 长期记忆使用向量数据库等外部存储,通过语义搜索访问;
- Google ADK 用 Session(聊天线程)、State(临时数据)和 MemoryService(长期知识)管理记忆;
- LangChain 提供 ConversationBufferMemory 等工具自动注入对话历史;
- LangGraph 通过 BaseStore 实现高级长期记忆,支持语义、情景、程序三种记忆类型。
结语与个人思考
记忆管理这个话题,表面上看是"怎么存、怎么取"的技术问题,但往深了想,它其实关系到智能体的"自我"是什么。
人类的身份感很大程度上建立在记忆之上------你之所以是"你",是因为你记得你经历过什么、你喜欢什么、你做过什么决定。如果一个智能体每次见到你都"失忆",那它对你来说就永远是个陌生人。
从这个角度看,长期记忆不只是一个功能模块,它是智能体个性化的基础。有了它,智能体才能从"通用工具"变成"你的助手"。
但记忆管理也有很多现实挑战:
第一个是遗忘的必要性。人类会遗忘,这不是缺陷,而是一种保护机制------不重要的信息被过滤掉,重要的才被保留。智能体的记忆如果什么都存,最后检索出来的全是噪音,反而影响效果。怎么定义"什么值得记住"、怎么淘汰旧记忆,是个很有意思的问题。
第二个是记忆的准确性。如果智能体记错了------比如把你"喜欢咖啡"记成了"喜欢茶"------那它的个性化反而会起反效果。尤其是当记忆是 LLM 自动提取的时候,提取的准确性直接决定了记忆的质量。
第三个是隐私边界。智能体记住的用户信息越多,隐私风险就越大。哪些信息可以记、哪些不能记、用户怎么控制自己的记忆数据,这些都是产品化时必须面对的问题。
最后,我觉得最有想象力的方向是程序记忆的自我进化------智能体不只是记住事实,还能修改自己的行为规则。这已经很接近"学习"的本质了。当然,这也带来了新的挑战:如果智能体改坏了自己的指令怎么办?怎么保证它的进化方向是好的?这些问题,下一章"学习和适应"会继续深入。
下一步,建议阅读第 9 章 学习与适应(Learning and Adaptation)------看看智能体怎么通过经验自主提升能力,甚至自我进化。
本文基于开源书籍《Agentic Design Patterns》(https://github.com/xindoo/agentic-design-patterns ,在线阅读 https://adp.xindoo.xyz/ )整理,供学习交流,版权归原作者所有。