CNN-LSTM 预测轴承剩余寿命:MATLAB 端到端实现与可视化全解析
关键词:剩余寿命预测(RUL)、CNN-LSTM、1D 卷积、LSTM 门控、预测性维护、MATLAB R2024b
先说结论,免得你看到一半再翻回来:CNN-LSTM 端到端跑通了,测试集输出 RMSE 0.0887 、MAE 0.0711 、R² 0.9056。
先把事情从头上捋清楚:这套数据是什么、模型怎么搭、每一步在算什么、跑出来什么样。
一、研究背景:为什么要预测轴承的"剩余寿命"
轴承是旋转机械里最不起眼、也最要命的部件。电机、风机、机床、轨道交通的轮轴,哪一样离了轴承都转不起来。
它坏起来又不动声色:先是内圈滚道上一点极微小的剥落,振动信号里多了一个几乎看不见的冲击,然后缺口慢慢扩大,等真到了肉眼可见、耳朵可闻的程度,往往离突发故障就不远了。
所以工业界真正想要的能力不是"识别它现在有没有坏"(那是故障诊断),而是在它还正常的时候,就回答一句:"它大概还能撑多久。" 这就是剩余寿命预测,Remaining Useful Life,简称 RUL。
传统做法靠物理模型和统计模型,门槛高、通用性差。深度学习起来之后,思路变了:不用去猜轴承内部到底发生了什么,直接把振动信号当数据,让网络自己学"退化规律"。
而这类数据的本质是时序 ------故障是随时间一点点累积的。所以处理时序的 LSTM 天然适合。但同时,一段振动信号里又藏着丰富的局部模式(冲击、谐波、边带),这又是卷积 CNN 的强项。把两者拼起来的 CNN-LSTM,就是想两头都占。
这次要做的,就是把 CNN 特征提取和 LSTM 时序建模拼成一个端到端的 CNN-LSTM,输入输出维度保持不变,只动模型结构。
二、主要功能:这套代码到底干了什么
一句话概括:读入轴承振动特征数据 → 训练一个 CNN-LSTM 回归模型 → 输出连续递减的 RUL 曲线 → 给出指标和一堆图。
具体拆开是这么几块:
- 数据加载与划分 :从
feature_reconstructedData.mat里取出 7 个轴承的特征,Bearing 1--2 作训练集,Bearing 3 作测试集。 - 标签构建:剩余寿命不用真实运行时长,而是按"从 1 到 0 线性递减"的方式归一化,1 代表全新,0 代表彻底失效。
- 数据预处理:z-score 标准化(用训练集均值方差,测试集复用同一套参数),NaN 归零。
- 模型:CNN 特征提取模块 + LSTM 时序建模模块 + 全连接回归头。
- 输出 :RMSE / MAE / R² 三项指标,外加 7 张可视化图和一份
.mat结果文件。
输入是 26 维、输出是 1 维标量------这是整套流程定死的一条硬约束:不许因为换模型就改数据流的形状。
三、数据与技术路线
先看数据长什么样。这是整套系统能跑通的地基。
特征是怎么来的
原始振动信号是采样得到的一维时间序列。直接喂给网络太"重",所以先做特征工程,从每段信号里抽出 26 个特征:
| 类型 | 数量 | 具体特征 |
|---|---|---|
| 时域特征 | 14 | 均值、标准差、均方根 RMS、方差、峰值、峰峰值、偏度、峭度、波形因子、峰值因子、脉冲因子、裕度因子、能量、绝对均值 |
| 频域特征 | 12 | 频谱能量、主频率、主频幅值、频率中心、均方频率、均方根频率、频率方差、频率标准差、前 5 峰值平均幅值、频谱峭度、频谱偏度、频谱平坦度 |
注意这 14 个时域特征里,峭度和脉冲因子、裕度因子这一类,恰恰是轴承冲击型故障最敏感的量------这是特征工程里最有分量的几个。
标签怎么定
每个轴承从开始运行到失效,健康度一路下降。代码用一条直线来近似这条退化曲线:第一个样本标签是 1,最后一个样本标签是 0,中间线性插值。
这是一种常见的简化假设(IEEE PHM 数据挑战赛里也常这么处理)。它不完美,但胜在确定、可复现,适合做方法演示。
技术路线串起来
原始振动信号
   │  特征提取(14时域 + 12频域 = 26维)
   ▼
特征矩阵(N × 26)
   │  z-score 标准化
   ▼
标准化特征
   │  重排为 序列(每样本 1 通道 × 26 时间步)
   ▼
1D-CNN 特征提取  →  最大池化  →  1D-CNN  →  最大池化
   │  (局部模式)
   ▼
LSTM 时序建模(取最后一步输出)
   │  (退化趋势)
   ▼
全连接 + 回归输出
   │
   ▼
RUL 预测值(0 ~ 1)
重点在那句"重排为序列"。这是 CNN-LSTM 能不能接住这 26 维数据的关键:把 26 个特征当作 26 个时间步、每个时间步 1 个通道,这样 1D 卷积就能沿着"特征轴"滑窗,LSTM 就能沿同一根轴做时序建模。
四、算法步骤
把整套流程压成 6 步,照着能复现:
- 加载数据 :
load('feature_reconstructedData.mat'),取出 7 个轴承的 cell 数据。 - 划分与组装:Bearing 1--2 拼接成训练集(约 3670 样本),Bearing 3 单独作测试集(约 2373 样本);同时取出对应标签列。
- 标准化 :用训练集的均值和标准差做 z-score,测试集复用;
isnan的位置置 0(防某个特征方差为 0 除出 NaN)。 - 构建网络:按上面的结构搭 CNN-LSTM,把每个 26 维样本重排成 1×26 的序列。
- 训练:Adam 优化器,150 个 epoch,留 20% 作验证集,取验证损失最小的那版网络。
- 预测与评估 :对测试集
predict,算 RMSE / MAE / R²,画图、存结果。
其中第 4 步是整套流程的核心:把 26 维特征重排成序列,CNN 和 LSTM 才接得住。
五、公式原理
不讲玄的,把每一层在算什么写清楚。
1D 卷积(特征提取模块)
沿时间/特征轴滑窗,每个滤波器学一种局部模式:
y[t] = Σ_{i=0}^{K-1} x[t+i] · w[i] + bK 是卷积核大小(这里取 3),w、b 是可学习参数。CNN 的意义在于:先用局部视野捕捉"冲击、谐波"这类短程特征,再越堆越高、视野越来越大。
ReLU 激活
f(x) = max(0, x)引入非线性,同时缓解梯度消失。
最大池化
对窗口内取最大值,作用是降采样 + 让特征对微小平移更鲁棒,同时把序列长度压下来,喂给后面的 LSTM 时更轻。
LSTM 门控(时序建模模块)
LSTM 靠三个门控制信息取舍,这是它记住"长期退化趋势"的机制:
遗忘门    f_t = σ(W_f · [h_{t-1}, x_t] + b_f)
输入门    i_t = σ(W_i · [h_{t-1}, x_t] + b_i)
候选状态  g_t = tanh(W_g · [h_{t-1}, x_t] + b_g)
细胞状态  c_t = f_t ⊙ c_{t-1} + i_t ⊙ g_t
输出门    o_t = σ(W_o · [h_{t-1}, x_t] + b_o)
隐藏状态  h_t = o_t ⊙ tanh(c_t)
σ 是 sigmoid,⊙ 是逐元素相乘。这里取 OutputMode='last',只用序列最后一步的隐藏状态去做回归------也就是让网络"看完整个序列后给出一个判断"。
损失函数
回归用均方误差:
MSE = (1/n) · Σ (y_i - ŷ_i)²评估指标
RMSE = sqrt( (1/n) Σ (y_i - ŷ_i)² )     # 与标签同量纲,越小越好
MAE  = (1/n) Σ |y_i - ŷ_i|              # 对异常值不敏感
R²   = 1 - Σ (y_i - ŷ_i)² / Σ (y_i - ȳ)²  # 越接近 1 越好
六、模型与参数设定
网络结构一张表说清楚:
| 层 | 配置 |
|---|---|
| sequenceInput | 1 通道,MinLength = 26 |
| 1D 卷积 1 | 核长 3,32 个滤波器,padding=same |
| ReLU | --- |
| 最大池化 1 | 池化窗口 2,步长 2 |
| 1D 卷积 2 | 核长 3,64 个滤波器,padding=same |
| ReLU | --- |
| 最大池化 2 | 池化窗口 2,步长 2 |
| LSTM | 100 个隐藏单元,OutputMode=last |
| Dropout | 0.2 |
| 全连接 1 | 50 神经元 + ReLU |
| Dropout | 0.2 |
| 全连接 2 | 25 神经元 + ReLU |
| 全连接 3 | 1 神经元(输出 RUL) |
| regressionLayer | MSE 损失 |
训练超参:
| 参数 | 取值 |
|---|---|
| 优化器 | Adam |
| 初始学习率 | 0.005 |
| 学习率衰减 | piecewise,每 50 epoch 减半 |
| 最大轮数 | 150 |
| MiniBatchSize | 64 |
| 验证集比例 | 20% |
| 梯度阈值 | 1 |
| L2 正则 | 0.001 |
| 输出网络 | 验证损失最优的一版 |
| Shuffle | 每 epoch 打乱 |
一句话总结这组参数:学习率给得不算小但有衰减兜底,L2 阈值和梯度裁剪都在压过拟合,最后取验证最优推出去。
七、运行环境
- 软件 :MATLAB R2024b(版本号 24.2.0)
- 工具箱 :Deep Learning Toolbox(用到
trainNetwork/predict/convolution1dLayer等) - 计算 :单 CPU 训练,全程约 218 秒
- 数据 :
feature_reconstructedData.mat,含 7 个轴承的特征与标签
一个踩坑点,值得单独说:在 R2024b 里,
convolution1dLayer和maxPooling1dLayer已经原生支持序列输入 ,所以这次实现不需要sequenceFoldingLayer/sequenceUnfoldingLayer那套"先折叠再展开"的老做法。如果你照着旧教程套 fold 层,在 R2024b 训练阶段会直接报错。
八、实验结果
实测指标:
| 指标 | 数值 |
|---|---|
| RMSE | 0.0887 |
| MAE | 0.0711 |
| R² | 0.9056 |
| 训练时间 | ~218 s |
预测效果和新增的可视化,一图看全:
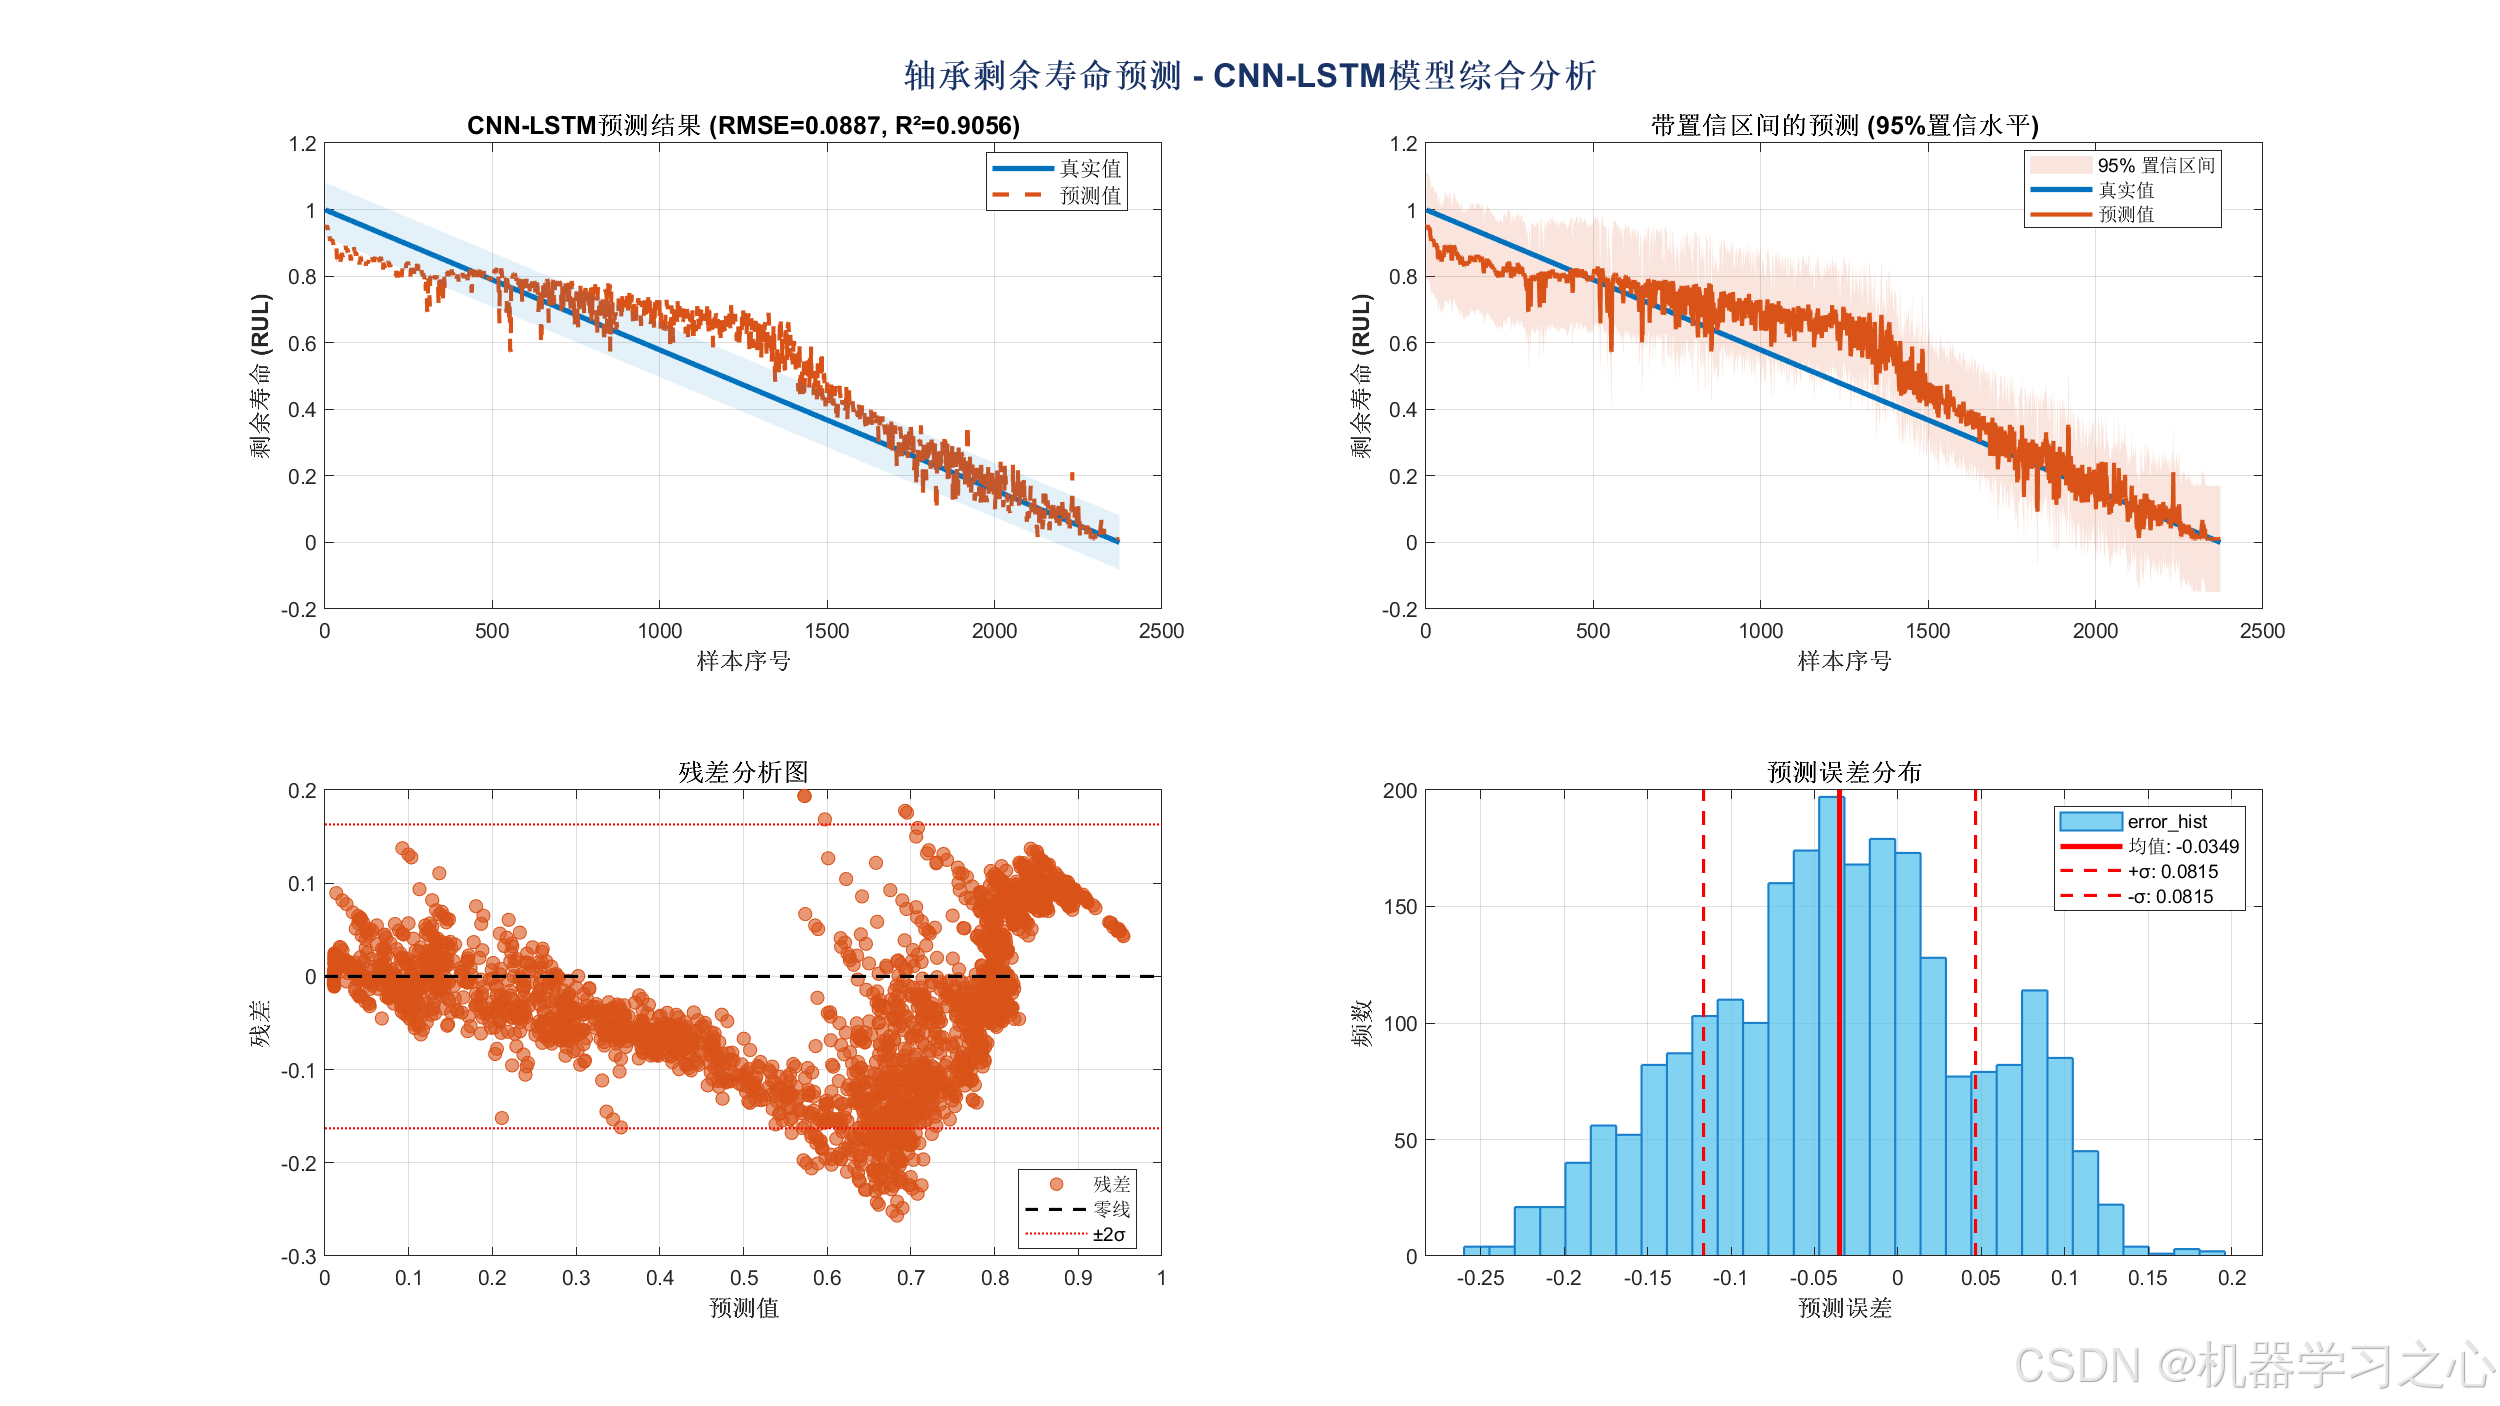
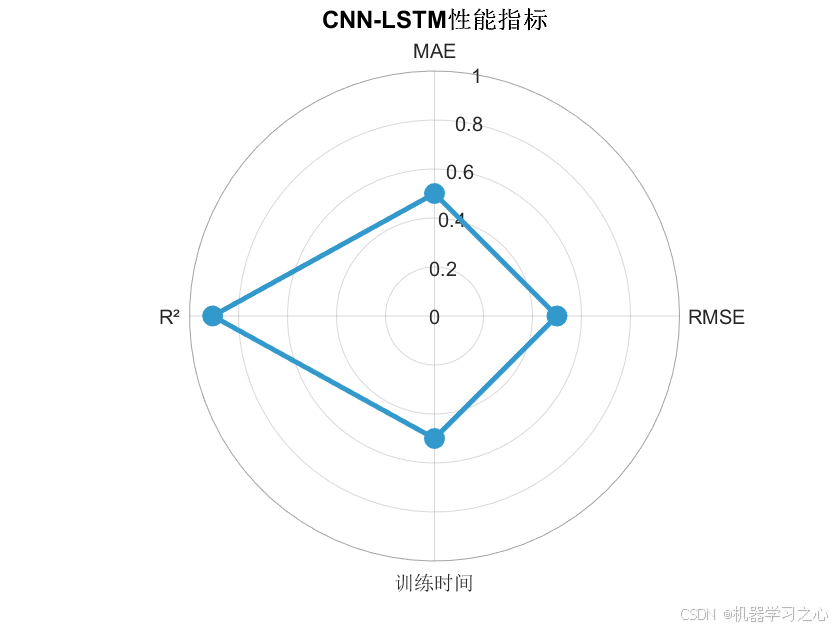
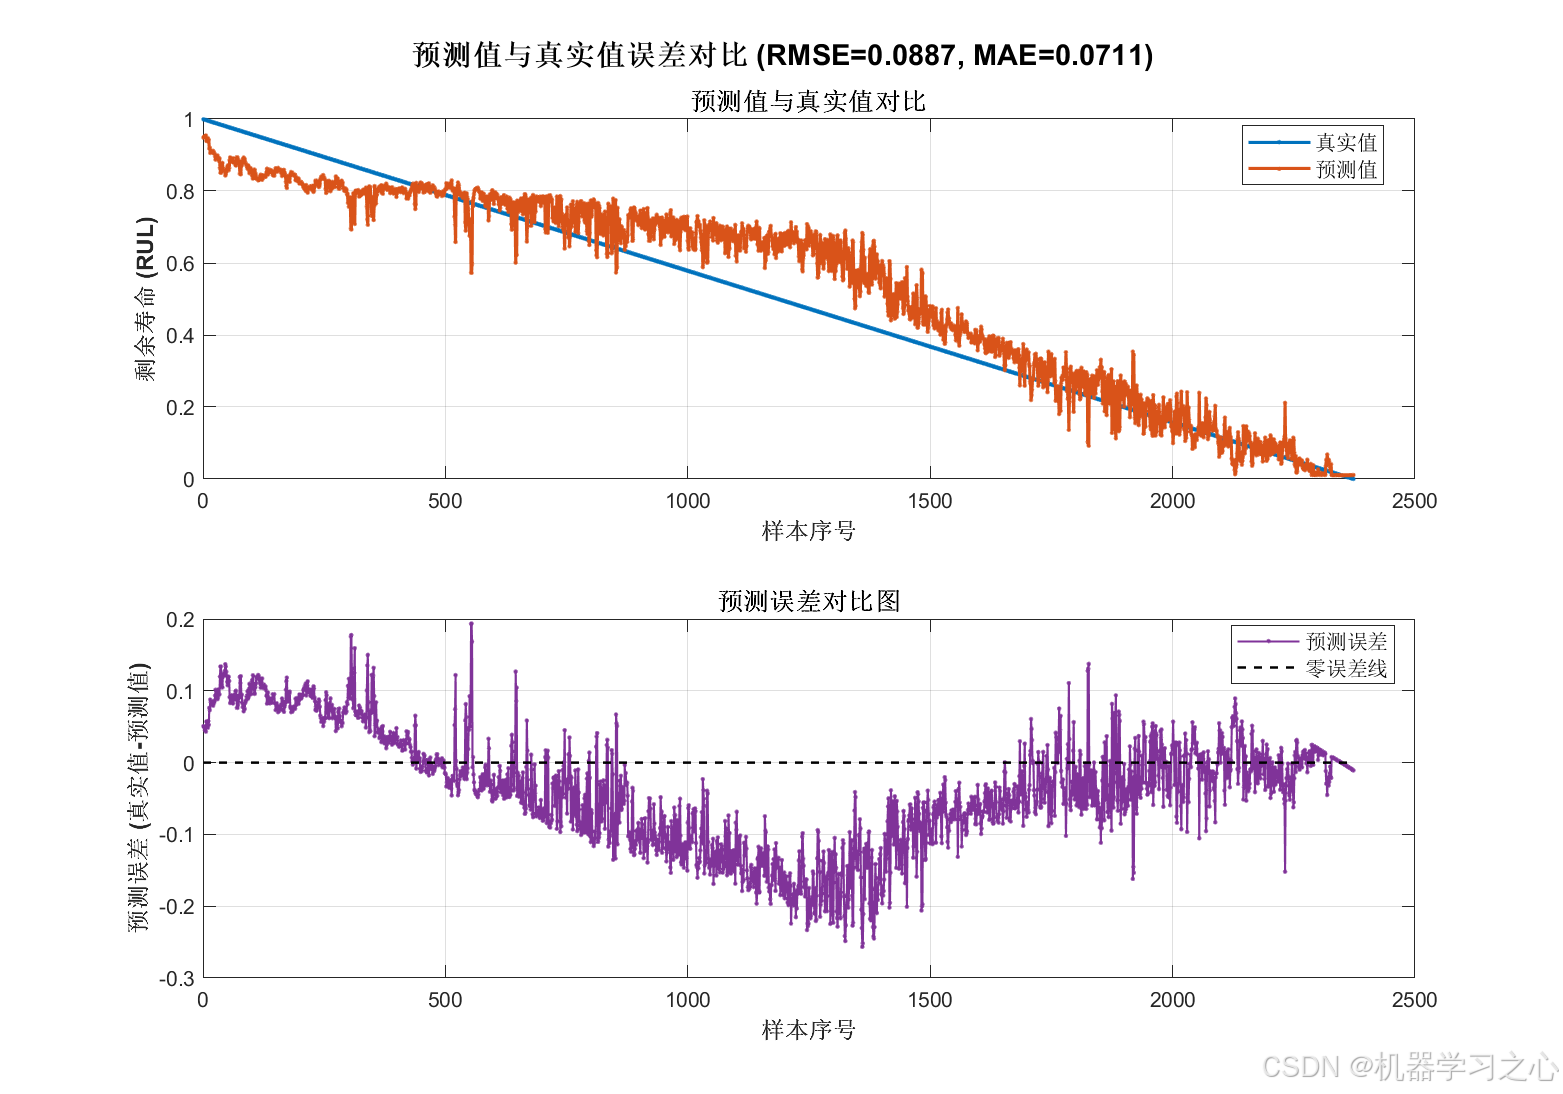
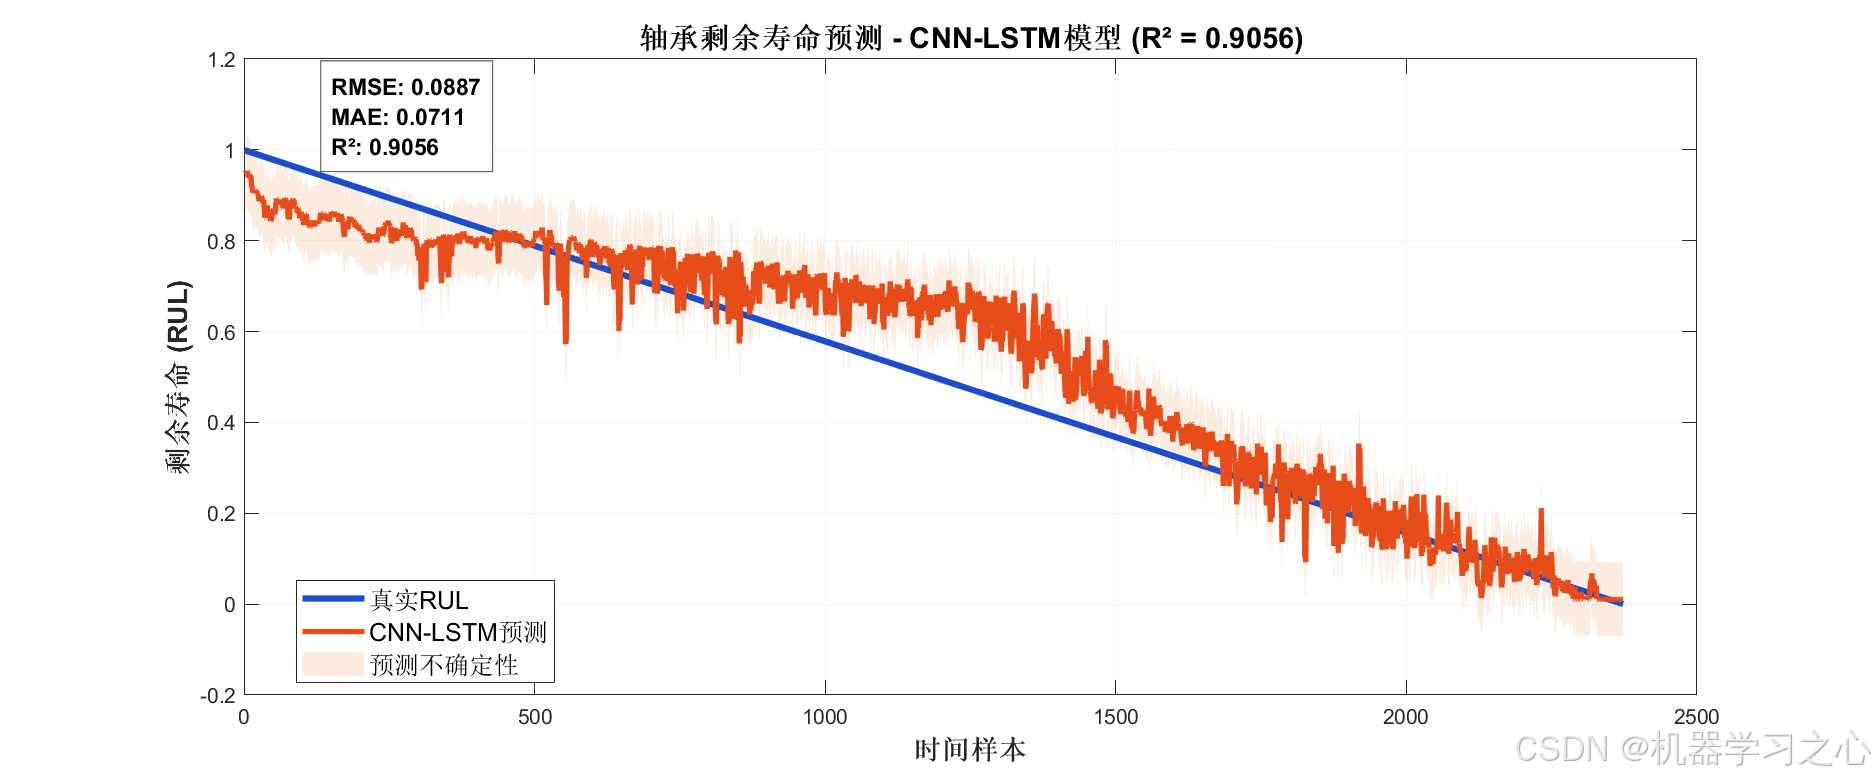
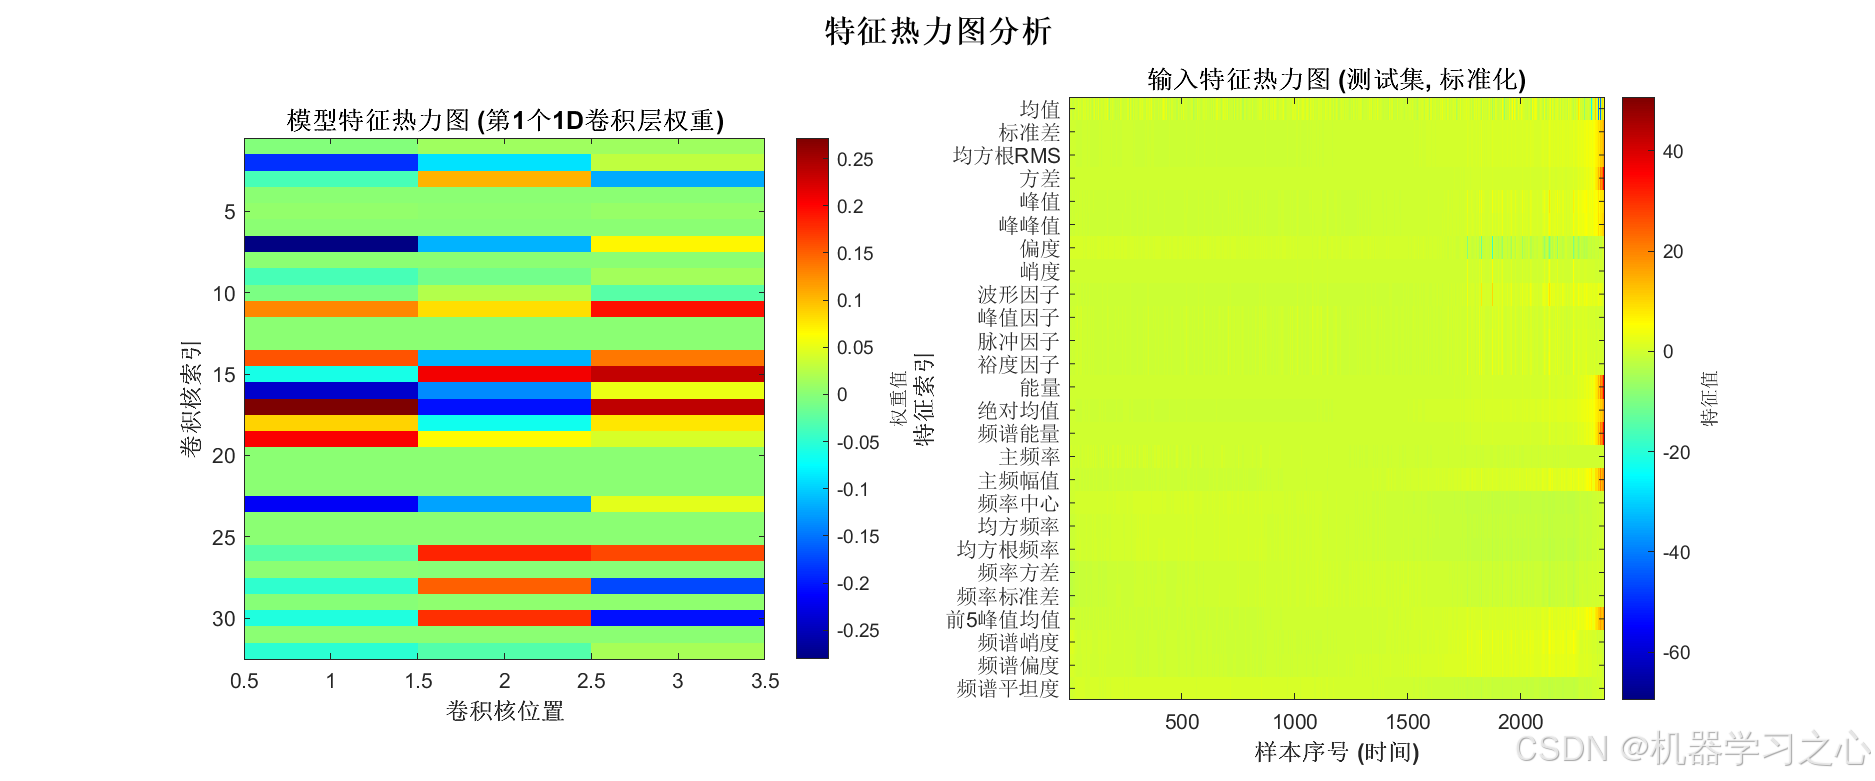
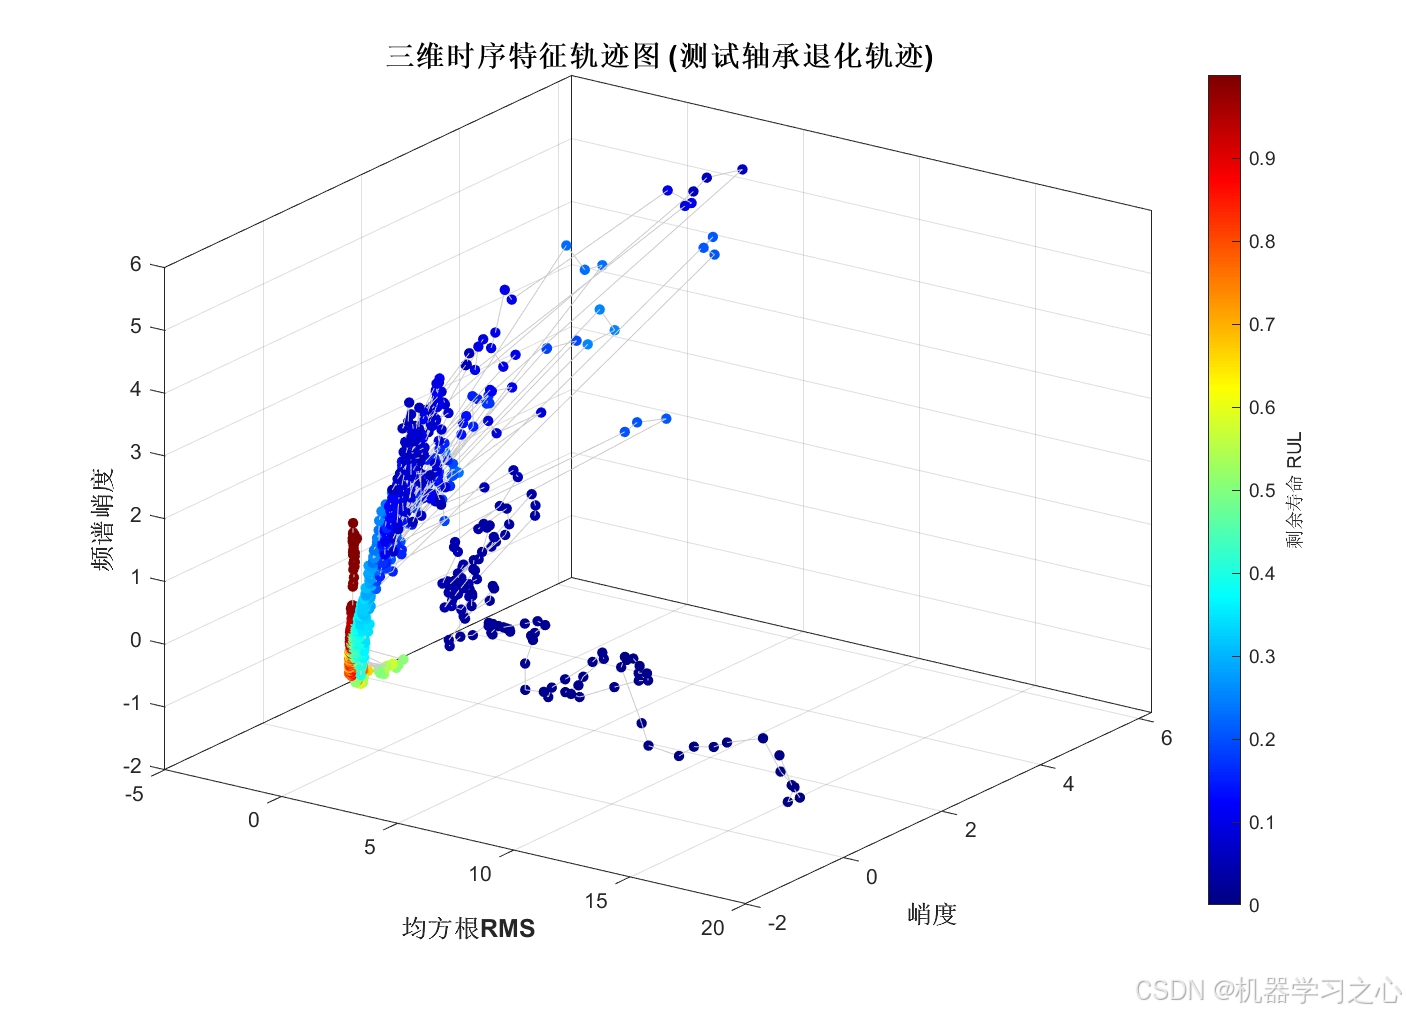
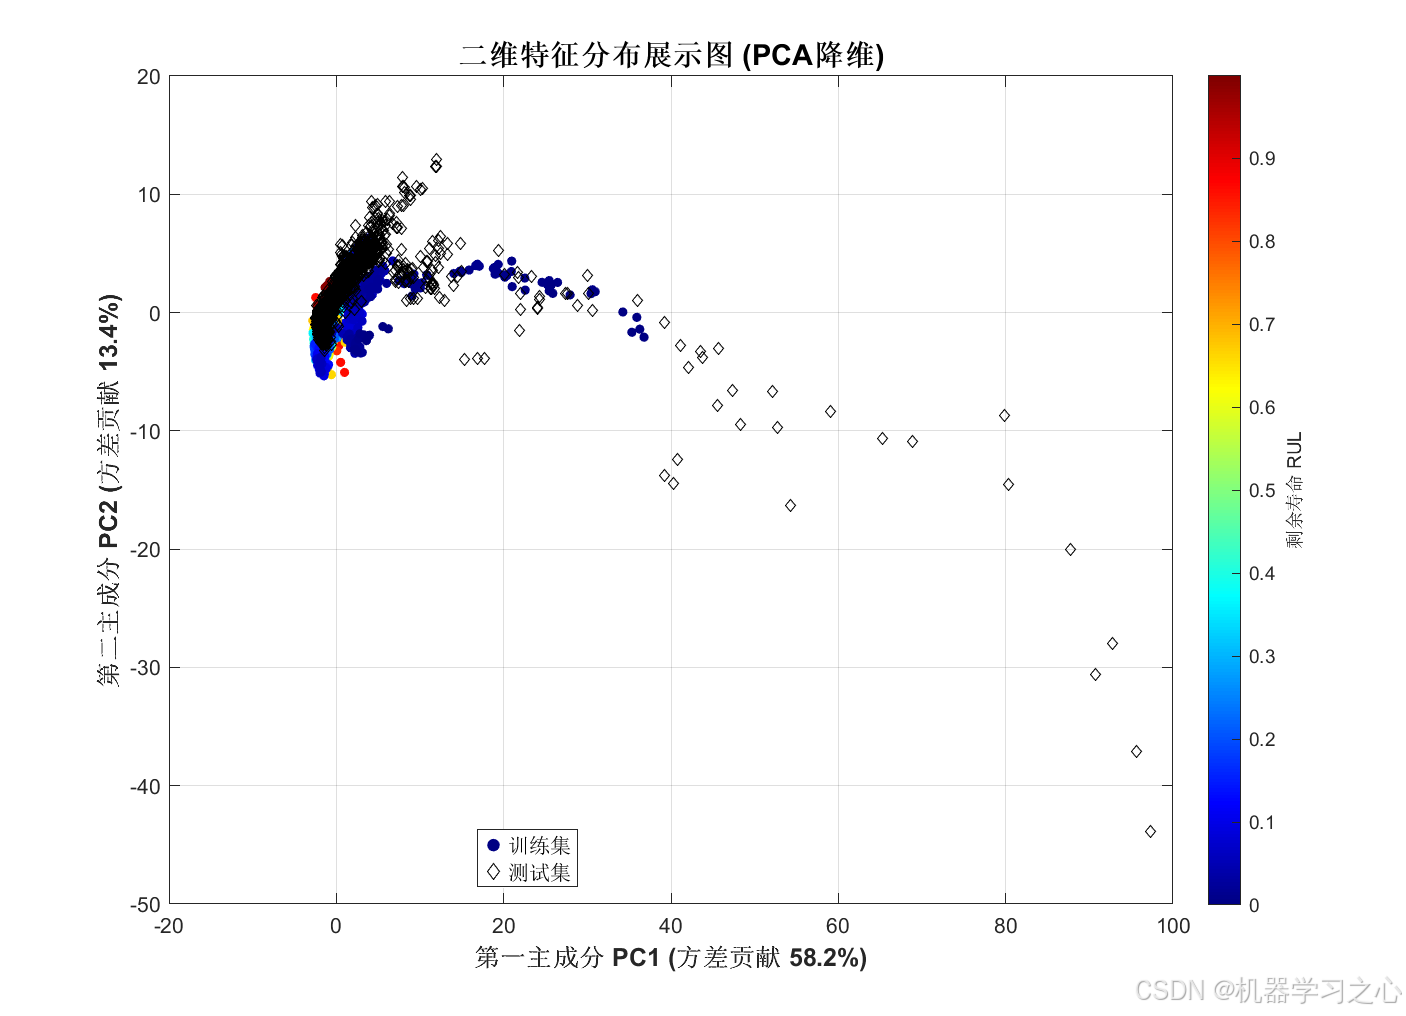
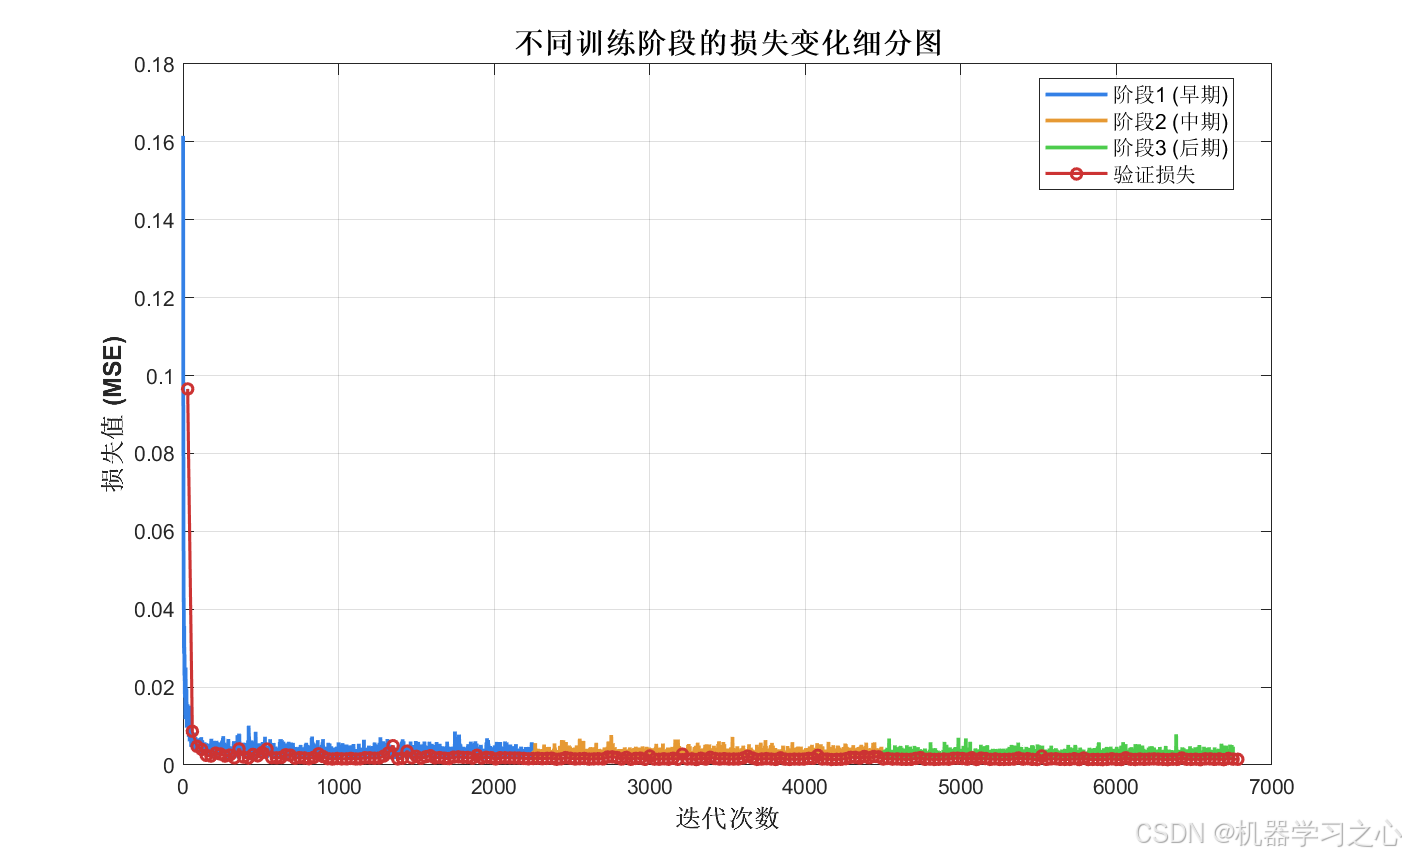
除了基础的预测对比,这次还补了 5 类更"能看出东西"的图:
- 二维特征分布:PCA 主成分降维,看训练集和测试集在特征空间里是否同分布。
- 三维时序特征轨迹:取 RMS、峭度、频谱峭度三个特征画三维退化轨迹,颜色映射 RUL,直观看到"越接近失效,点在空间里越往外漂"。
- 模型特征热力图:把第一层 1D 卷积的权重可视化,看网络到底学到了哪些局部模式。
- 训练损失细分:把训练损失按迭代进度切成早/中/晚三段,叠加验证损失,看收敛节奏。
九、应用场景
这套 CNN-LSTM 的 RUL 预测思路,落地场景其实很广:
- 工业预测性维护:风电机组、电机、泵、压缩机等旋转设备的轴承健康监测,从"坏了再修"转向"快坏了提前修"。
- 轨道交通:轮轴轴承的在线监测,关系到行车安全。
- 机床与产线:主轴轴承状态跟踪,配合排产做计划性更换,减少非计划停机。
- PHM 故障预测:作为端到端深度学习方法的一个可对比基线,验证"特征工程 + 深度学习"这条路。
把标签换成别的连续退化量(刀具磨损、电池健康、钢丝绳直径),这套"CNN 提特征 + LSTM 建模 + 回归输出"的框架可以整体平移复用。
结语
跑通一套 CNN-LSTM 不难------难的是在"不动数据管线"的约束下,把一个 26 维扁平特征塞进去还不改输出形状,还能跑出 R² 0.9 的成绩。
模型是工具,数据形状才是那个真正的变量。
*:主轴轴承状态跟踪,配合排产做计划性更换,减少非计划停机。
- PHM 故障预测:作为端到端深度学习方法的一个可对比基线,验证"特征工程 + 深度学习"这条路。
把标签换成别的连续退化量(刀具磨损、电池健康、钢丝绳直径),这套"CNN 提特征 + LSTM 建模 + 回归输出"的框架可以整体平移复用。
结语
跑通一套 CNN-LSTM 不难------难的是在"不动数据管线"的约束下,把一个 26 维扁平特征塞进去还不改输出形状,还能跑出 R² 0.9 的成绩。
模型是工具,数据形状才是那个真正的变量。
本文代码与结果基于 MATLAB R2024b 完整运行验证,指标与图表均由程序直接输出,可复现。