📚 本文收录于「bksczm」的系列专栏
|-----------------------------------------------------------------------------------------------------------------------------------------------------|-----------------------------------------------------------------------------------------------------------------------------------------------------|
|  Linux |
 C/C++ |
|  MySQL |
 面试题 |
|  Redis ||
一、什么是 Redis
1.1 Redis 的定位
Redis(Remote Dictionary Server)是一个基于内存的、开源的高性能 key-value 型 NoSQL 数据库,常被用作缓存、消息队列、分布式锁等。
传统关系数据库(如 MySQL)的数据主要存储在硬盘上,读写都涉及磁盘 IO,效率受硬件限制;Redis 把数据主要放在内存中进行操作,因此读写速度极快(单机可达十万级 QPS)。
注意:Redis 并非"完全不碰磁盘",它支持 RDB 快照 和 AOF 日志两种持久化机制,把内存数据定期/实时写入磁盘,防止宕机丢数据。
1.2 Redis 与语言级变量的区别
两者确实都在内存中操作数据,关键区别在于能否跨进程、跨主机共享:
| 对比维度 | 语言级变量 | Redis |
|---|---|---|
| 本质 | 进程地址空间内的内存 | 独立的服务进程 |
| 访问方式 | 直接内存寻址(函数/变量访问) | 基于 TCP/Unix socket 通信 |
| 单主机单进程内效率 | 极高(无网络开销) | 较低(有序列化和网络开销) |
| 跨进程共享 | 需要自己做 IPC(共享内存、管道等) | 天然支持,多个客户端连同一个 Redis |
| 跨主机共享 | 不支持(需自己写 socket 协议) | 天然支持(网络服务) |
| 生命周期 | 随进程退出而消失 | 独立进程,可持久化 |
结论:
- 单主机、单进程内,用本地变量比 Redis 高效得多;
- 但在多进程、多主机环境下,要让多个服务共享同一份内存数据,Redis 把"网络通信 + 数据管理 + 并发控制"都封装好了,远比自己实现 IPC/socket 共享内存优秀。
1.3 Redis 与 MySQL 配合:缓存架构
内存容量远小于外存,不可能把所有数据都放 Redis,因此实际采用 MySQL + Redis 结合的方案:
- MySQL:作为持久化的主数据库,存储全量数据;
- Redis :作为缓存,存储热数据(高频访问的数据)。
这背后是"二八原理":约 20% 的热点数据能满足 80% 的访问请求。
典型读取流程(Cache Aside 模式):
请求 → 先查 Redis
        ├─ 命中:直接返回(内存,极快)
        └─ 未命中:查 MySQL → 把结果写入 Redis → 返回
1.4 Redis 的核心特性(补充)
- 基于内存,读写性能极高;
- 单线程命令处理模型 :6.0 之前网络 IO 与命令执行都是单线程(基于 epoll 的 IO 多路复用);6.0 之后网络 IO 引入多线程,但命令执行仍为单线程,天然避免了锁竞争;
- 丰富的数据类型:String、List、Hash、Set、ZSet(有序集合)、Bitmap、HyperLogLog、Geo、Stream;
- 支持持久化:RDB(快照)和 AOF(追加日志);
- 支持高可用与分布式:主从复制、哨兵(Sentinel)、Redis Cluster 分片集群;
- 典型用途:缓存、排行榜(ZSet)、计数器、分布式锁、消息队列(Stream/Pub-Sub)、限流。
二、为什么需要分布式:架构演进
2.1 单机架构及其瓶颈
最初只有一台主机,同时承担 服务(应用)+ 存储(数据库)全部功能。
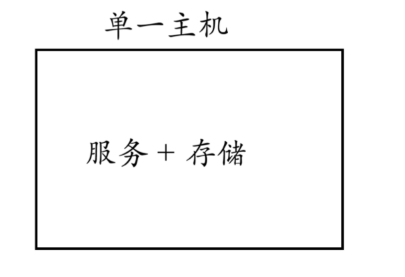
单机的硬件资源都有上限:
| 资源 | 瓶颈 |
|---|---|
| CPU | 核数有限,并行处理能力有上限 |
| 内存 | 内存条数量和容量有上限 |
| 外存 | 磁盘容量和 IO 有上限 |
| 网络 | 半连接队列、文件描述符、带宽都有上限 |
单机一旦达到任何一个资源上限,性能就会触顶,且无法通过简单升级硬件无限扩展(垂直扩展成本指数级增长)。
2.2 垂直拆分:应用与存储分离
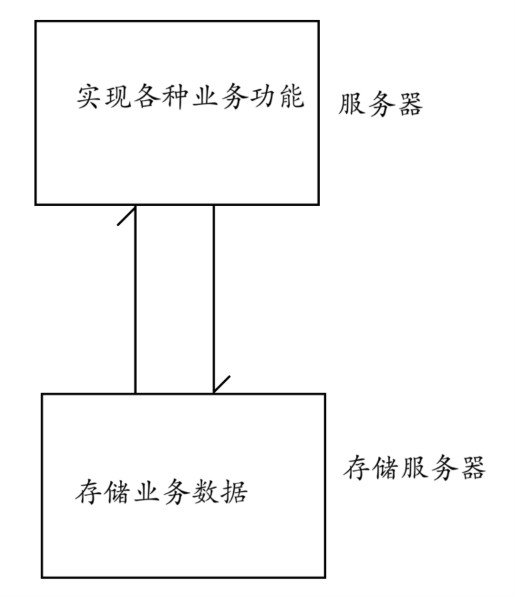
第一步演进:把"应用"和"存储"拆到两台主机。
- 应用服务器 :执行业务逻辑,特化 CPU 和内存,对外存要求不高;
- 存储服务器 :负责数据存储,特化外存容量和 IO 性能(追求性能用 SSD)。
这种按职责拆分称为垂直拆分,好处是两类服务器可以按需配置、独立扩展。
2.3 应用集群 + 负载均衡
应用与存储分离后,如果访问量继续增大,单台应用服务器 仍然扛不住所有请求。于是部署多台应用服务器组成应用集群,并在前面增加 负载均衡器(网关)分发请求。
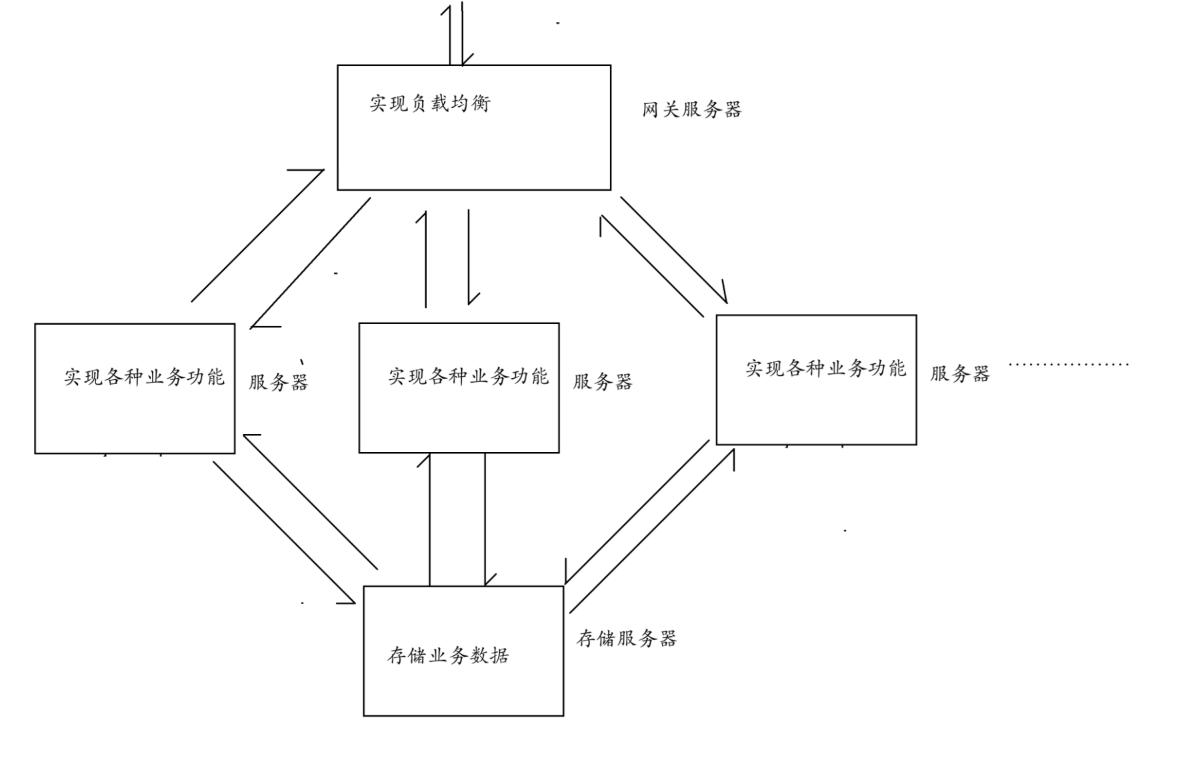
负载均衡器的分层(由外到内):
- DNS / GSLB(全局负载均衡):按地域、机房分流;
- 四层负载均衡(LVS):工作在传输层,按 IP+端口转发,性能极高;
- 七层负载均衡(Nginx):工作在应用层,可按 URL、Header 等做更精细的路由。
网关本身只做请求转发/分配,不做重业务,单次处理耗时很短。但极高并发下网关自身也可能成为瓶颈。
2.4 多机房 / 异地多活
当单个机房的网关和集群也扛不住时(或为了容灾、就近接入),部署多个机房(多套完整集群) ,通过 DNS 解析 / GSLB 把用户请求分配到最近或最空闲的机房。
- 异地多活:多个机房都能独立提供完整服务;
- 同城双活/异地灾备:侧重高可用和容灾。
2.5 读写分离(主从复制)
负载均衡解决了应用层压力,但存储服务器的读压力依然巨大。实际业务中读远多于写 ,于是采用一主多从的读写分离:
- 主服务器(Master) :数量较少,负责写操作;
- 从服务器(Slave/Replica) :数量较多,负责读操作;
- 主节点通过 binlog 复制把数据变更同步到从节点。
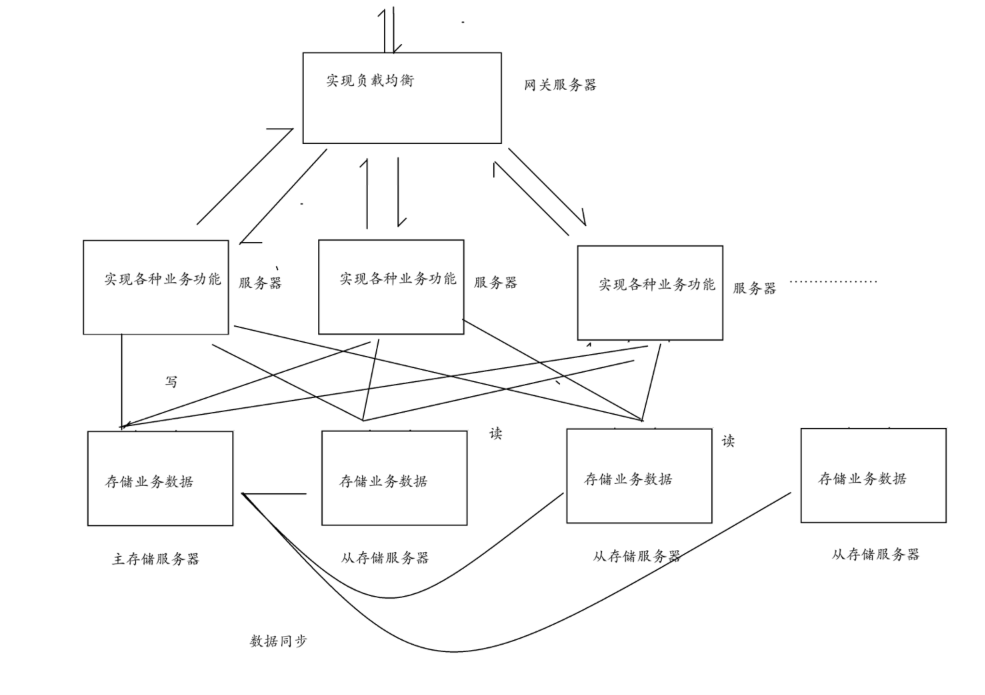
关键点 :读写分离中每个从节点都保存一份完整的数据副本 ,所以它并没有增大系统能存储的总数据量,只是提升了读性能和可用性。主从复制存在延迟,可能带来短暂的数据不一致。
2.6 分库分表
读写分离解决的是"性能/并发"问题,解决不了"单表/单库数据量太大"的容量问题。分库分表用于水平扩展存储容量和吞吐。
读写分离的每个从库都存一份完整数据,只提升并发、不增加总容量 。当单库 / 单表数据量大到单机装不下时,就需要分库分表。切分有两个方向:垂直是竖着切(切业务、切字段),水平是横着切(切数据行)。
一、垂直分库
按业务把一个大库里的不同表拆到不同数据库。比如原来一个库塞了用户、订单、商品所有表,拆成用户库、订单库、商品库,各自独立部署扩容。解决的是业务耦合和单库压力问题。
二、垂直分表
把一张字段太多的宽表 按冷热拆成几张窄表。比如员工表中姓名、工号这种常查的短字段留在主表,简历、合同这种少看又占地方的大字段拆到副表,用 id 关联。切的是列,让常用数据更紧凑。
三、水平分库
把同一张表的数据行 按规则摊到多个结构完全相同的库里,每个库表结构一样、只是存的数据范围不同。比如 user_id % 3,把用户分散到 3 个库,容量和性能成倍扩展。
四、水平分表(分片 Sharding)
一张大表数据行太多(如几十亿订单),按规则切成多张结构相同的小表(order_0、order_1......),规则常用取模或按时间范围。分表还在同一个库里主要解决单表过大;把分表分布到多台机器才是真正的分片,彻底扩展容量。
五、怎么记
-
垂直 切的是业务和字段(列),水平切的是数据行;
-
分库 是搬到不同数据库,分表是把一张表拆成多张表。
分库分表带来的新问题
- 分布式事务:一个操作跨多个库/表,需要分布式事务(2PC、TCC、Saga、最终一致性);
- 跨库 JOIN / 聚合:无法直接 JOIN,需要应用层组装或冗余字段;
- 全局唯一 ID:自增主键在分片后会冲突,需要雪花算法(Snowflake)、号段模式等;
- 跨分片分页、排序:需要各分片返回后归并;
- 扩容与数据迁移:增加分片节点时需要重新分布数据(一致性哈希可减少迁移量)。
2.7 引入 Redis 缓存
在应用层与数据库之间引入独立部署的 Redis 缓存集群,存放热数据,进一步降低数据库读压力。
引入缓存后带来缓存一致性和经典的三大缓存问题:
| 问题 | 描述 | 常见解决方案 |
|---|---|---|
| 缓存穿透 | 查询根本不存在的数据,请求全部打到数据库 | 缓存空值、布隆过滤器 |
| 缓存击穿 | 某个热点 key 过期瞬间,大量并发请求打到数据库 | 互斥锁(只放一个请求去查库)、热点 key 逻辑不过期 |
| 缓存雪崩 | 大量 key 同时过期,或 Redis 宕机 | 过期时间加随机值、Redis 集群高可用、限流降级 |
缓存与数据库一致性常用 Cache Aside Pattern :读时先读缓存、未命中读库并回填;更新时先更新数据库,再删除缓存。
2.8 微服务架构
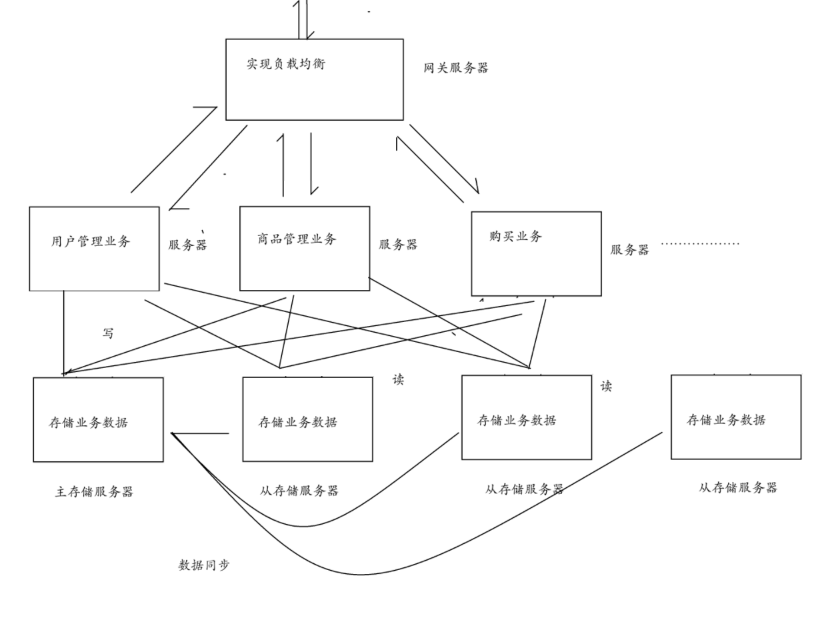
前面的应用集群中,每台应用服务器都运行全部业务(单体应用)。随着业务增长,单体应用代码膨胀、迭代困难、相互影响。
微服务把完整业务按领域拆分成多个独立服务(用户服务、订单服务、商品服务......),每个服务:
- 独立开发、独立部署、独立扩容;
- 通常拥有自己独立的数据库;
- 服务之间通过轻量级协议(HTTP/REST、gRPC、消息队列)通信。
代价:服务拆分后,原本的进程内函数调用变成了跨进程/跨网络调用,通信开销增大、延迟上升,还引入了分布式事务、服务治理等复杂度。
微服务需要配套的服务治理体系:服务注册与发现(Nacos、Consul)、配置中心、网关、熔断限流(Sentinel、Hystrix)、链路追踪(SkyWalking、Zipkin)等。
三、核心名词辨析
3.1 系统 / 应用
为了完成一整套服务的一个程序,或者一组相互配合的程序群。
3.2 模块 / 组件
当应用较复杂时,为分离职责,把其中具有清晰职责、内聚性强的部分抽象成独立概念,便于理解和复用。
3.3 分布式 vs 集群
| 概念 | 核心含义 | 关注点 | 通俗比喻 |
|---|---|---|---|
| 集群(Cluster) | 多台服务器部署同一个业务,每台都能独立完成完整任务,组成一个整体对外服务 | 高可用、负载均衡 (多个人干同一件事) | 餐厅有 3 个厨师,每个都会做全部菜,来客后分配给不同厨师 |
| 分布式(Distributed) | 一个完整业务被拆成多个子模块,分别部署在不同服务器上,分工协作共同完成整体业务 | 职责拆分、横向扩展 (多个人分工干不同的事) | 餐厅分配菜员、主厨、传菜员,各司其职协作出餐 |
关键区别:
-
集群是"复制":每个节点功能相同,挂一个其他节点仍能完整服务(高可用);
-
分布式是"拆分":每个节点只负责一部分功能,节点之间相互依赖、协同工作;
-
两者不是包含关系,而是不同维度 ,实际架构中常常组合使用:例如一个分布式系统(用户服务、订单服务、商品服务)中,每个服务自身又部署成一个集群(用户服务跑 3 个相同实例)。
分布式:按业务拆成不同服务 集群:同一服务部署多个相同实例
┌────────┐ ┌────────┐ ┌────────┐ ┌────────┐
│用户服务 │ │订单服务 │ │商品服务 │ │用户服务×3(集群)│
└────────┘ └────────┘ └────────┘ └────────┘
干不同的事(分布式) 干同一件事(集群)
四、分布式系统的核心挑战
架构从单体走向分布式,在获得扩展性和高可用的同时,也引入了单体系统没有的难题:
| 挑战 | 说明 |
|---|---|
| 数据一致性 | 网络延迟、节点故障导致多副本/多节点数据短暂不一致(CAP 理论:一致性 C、可用性 A、分区容错性 P 不可兼得) |
| 分布式事务 | 跨节点操作的原子性保障(2PC、TCC、Saga、本地消息表 + 最终一致性 / BASE 理论) |
| 网络不可靠 | 网络延迟、丢包、乱序、分区随时可能发生,不能假设调用一定成功 |
| 服务治理 | 注册发现、配置管理、熔断降级、限流、负载均衡、链路追踪 |
| 高可用与故障转移 | 主从切换、哨兵选举、脑裂问题 |
| 全局唯一 ID、分布式锁 | 单机自增 ID 和本地锁失效,需要跨节点方案 |
| 运维复杂度 | 节点数量爆炸,需要容器化(Docker)、编排(K8s)、监控告警体系 |
五、核心总结
Redis
- Redis 是基于内存的 key-value NoSQL ,通过 socket 对外提供服务,优势在于跨进程、跨主机共享数据;单进程内本地变量更快,但多机共享 Redis 更优秀。
- Redis 支持 RDB/AOF 持久化,不是纯内存;命令执行单线程(6.0 后网络 IO 多线程)。
- MySQL + Redis 配合,用"二八原理"缓存热数据;注意缓存穿透、击穿、雪崩和一致性问题。
架构演进脉络
- 单机 (服务+存储一体,资源有上限)→ 垂直拆分 (应用与存储分离,按需特化硬件)→ 应用集群 + 负载均衡 (解决应用层并发)→ 多机房异地多活 (解决机房级瓶颈和容灾)→ 读写分离 (一主多从,提升读性能,不增加容量)→ 分库分表 (水平扩展容量)→ 微服务(按业务拆分,独立迭代)。
- 存储服务器同样需要大内存(Buffer Pool),最看重外存容量和 IO。
- 分库分表四种方式:垂直分库、垂直分表、水平分库、水平分片;会带来分布式事务、跨库 JOIN、全局 ID、扩容迁移等问题。
概念辨析
- 集群 = 多台干同一件事(复制,求高可用/负载均衡);分布式 = 多台分工干不同的事(拆分,求扩展/解耦);两者是不同维度,不是包含关系,实际中常组合使用。
- 微服务以网络通信开销和服务治理复杂度为代价,换取独立部署和快速迭代。
- 分布式的核心代价是 CAP 权衡、数据一致性、网络不可靠和分布式事务。