一、前言:什么是 AI Agent?
最近,AI Agent(人工智能智能体)成为 AI 应用开发领域的重要方向。
很多同学可能已经用过 ChatGPT、DeepSeek 等大模型,但你有没有想过:如果 AI 不仅能回答问题,还能主动调用工具、查询数据、执行任务,甚至根据执行结果调整下一步行动,会怎么样?
这就是 AI Agent 想要实现的能力。
传统的大模型应用通常是:
用户提问 → 大模型生成回答 → 返回结果
而一个具备工具调用能力的 Agent,可以按照下面的流程工作:
用户提出任务 → 大模型分析任务 → 选择合适的工具 → 执行工具 → 获取执行结果 → 生成最终回答
例如,你希望 AI 帮你查询某个城市的天气。普通聊天模型可能只能根据已有知识回答,而接入天气查询工具的 Agent 可以调用真实的天气 API,再根据查询结果组织回答。
需要注意:Agent 并不是一个全新的大模型,而是一种围绕大模型构建的应用系统。它可以包含任务规划、工具调用、状态管理、记忆、执行控制和结果验证等机制。
这篇文章将使用 Python,从零实现一个支持工具调用的简易 AI Agent。
干货分享
⭐为了方便大家学习,我整理了一份零基础大模型智能体学习路线和Agent 企业级项目合集以及大模型精选面试题,还有大模型和人工智能教程,需要的可以看图自取~
二、Agent 的核心架构
一个基础 Agent 通常由以下几个部分组成。
| 核心模块 | 作用 | 示例 |
|---|---|---|
| 大语言模型(LLM) | 理解用户需求,生成回答或工具调用请求 | GPT、DeepSeek 等模型 |
| Prompt | 规定角色、任务和行为约束 | 你是一个 Python 助手 |
| Tools | 提供外部能力 | 计算器、天气查询、文件检索 |
| 执行器 | 执行模型请求的工具调用 | 调用 Python 函数 |
| 状态管理 | 保存当前任务的上下文 | 对话历史、执行结果 |
| 结果验证 | 检查工具执行是否成功 | 参数校验、异常处理 |
2.1 Agent 的执行流程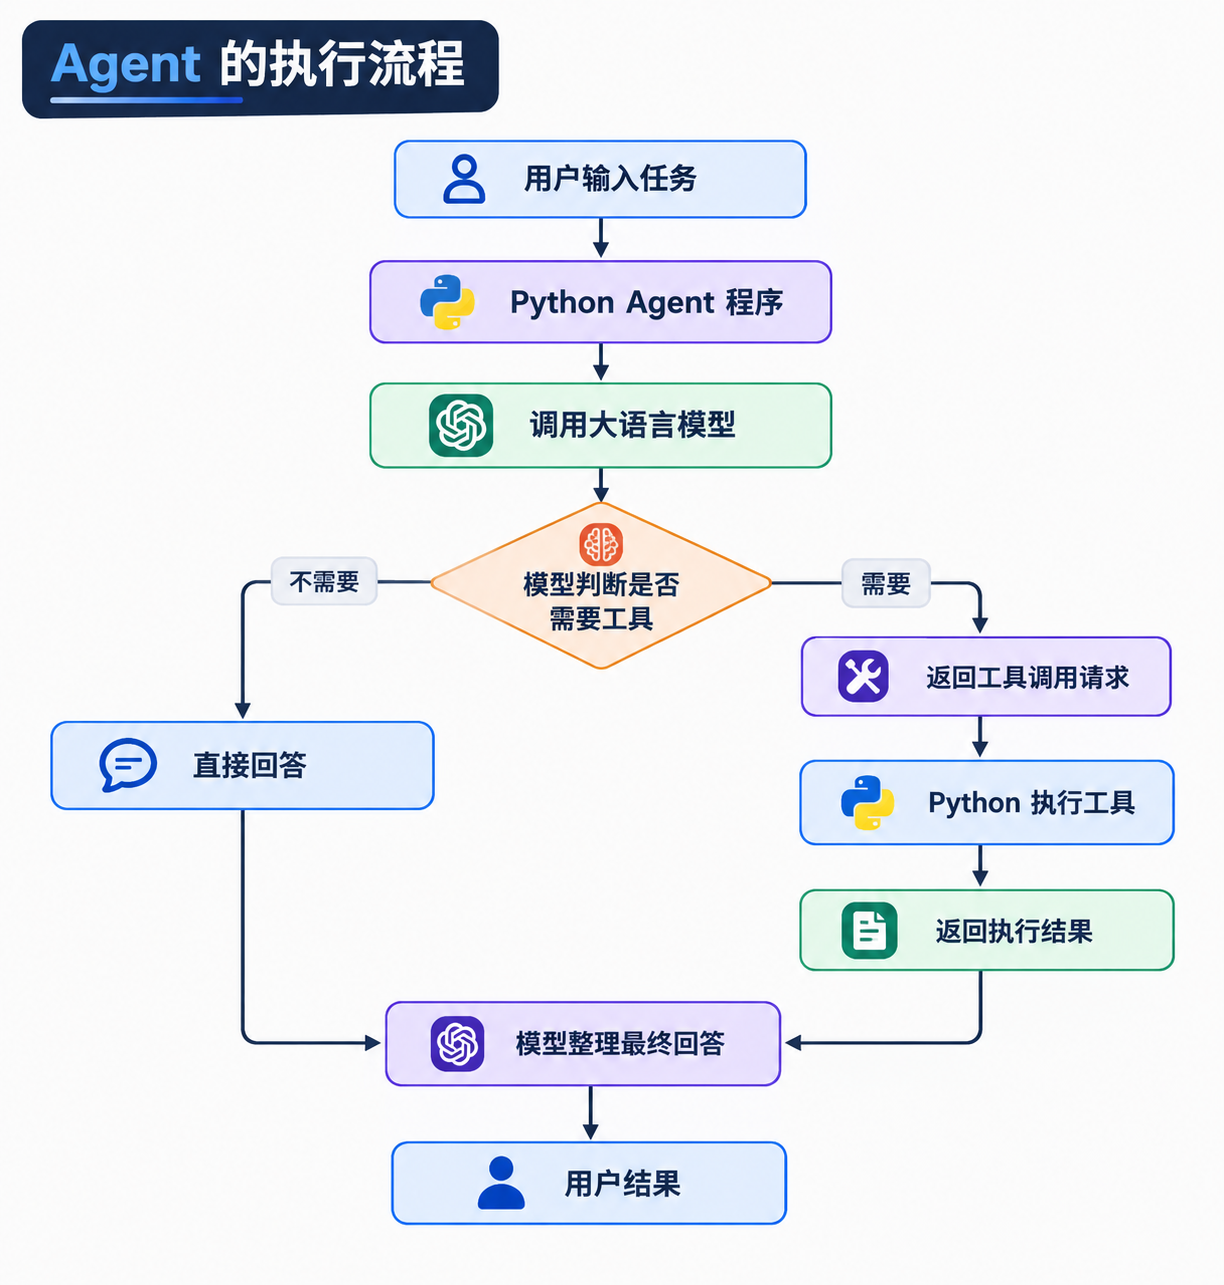
这里有一个非常重要的概念:
大模型负责理解和决策,Python 程序负责实际执行。
例如,大模型可以决定调用计算器,但真正执行加法的是 Python 函数。大模型输出一段文字,并不意味着它已经执行了对应操作。
三、项目实战:搭建一个 Python AI Agent
本次项目的目标是实现一个简易的数学助手 Agent。
它需要具备以下功能:
-
接收用户的自然语言问题。
-
通过大模型判断是否需要调用计算器。
-
如果需要计算,则生成结构化的工具调用请求。
-
Python 执行计算器函数。
-
将执行结果返回给大模型。
-
由大模型生成最终回答。
为了降低入门难度,我们使用支持工具调用的模型 API。下面以 OpenAI Python SDK 的接口形式为例,其他兼容接口的服务需要根据其官方文档调整配置和请求格式。
3.1 环境准备
建议使用 Python 3.10 或更高版本。
首先,创建项目目录:
mkdir python-agent-demo
cd python-agent-demo
创建虚拟环境:
python -m venv .venv激活虚拟环境。
Windows:
.venv\Scripts\activatemacOS / Linux:
source .venv/bin/activate安装依赖:
pip install openai python-dotenv项目目录结构如下:
python-agent-demo/
├── main.py
├── .env
└── requirements.txt
其中:
-
main.py:Agent 的核心实现。 -
.env:保存模型 API 配置。 -
requirements.txt:记录项目依赖。
可以将依赖写入文件:
openai
python-dotenv
安装时执行:
pip install -r requirements.txt3.2 配置大模型 API
在项目目录下创建 .env 文件:
OPENAI_API_KEY=替换为你自己的API密钥
OPENAI_MODEL=gpt-4.1-mini
如果使用其他模型服务,请选择该服务实际支持工具调用的模型,并按照官方接口文档设置 API 地址、密钥和模型名称。
注意:不要把 API 密钥直接写进代码,也不要将包含密钥的 .env****文件提交到公开 GitHub 仓库。
建议创建 .gitignore:
.env
.venv/
__pycache__/
3.3 第一步:实现计算器工具
Agent 并不是凭空获得执行能力的。我们需要先使用 Python 编写一个工具。
在 main.py 中添加:
import json
import os

from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()

client = OpenAI(
    api_key=os.environ["OPENAI_API_KEY"]
)

MODEL = os.getenv(
    "OPENAI_MODEL",
    "gpt-4.1-mini"
)


def calculate(expression: str) -> str:
    """计算简单的数学表达式。"""
    import ast
    import operator

    operators = {
        ast.Add: operator.add,
        ast.Sub: operator.sub,
        ast.Mult: operator.mul,
        ast.Div: operator.truediv,
        ast.USub: operator.neg,
        ast.UAdd: operator.pos,
    }

    def evaluate(node):
        if isinstance(node, ast.Expression):
            return evaluate(node.body)

        if isinstance(node, ast.Constant):
            if type(node.value) in (int, float):
                return node.value
            raise ValueError("只允许数字")

        if isinstance(node, ast.BinOp):
            op = operators.get(type(node.op))
            if op is None:
                raise ValueError("不支持的运算符")
            return op(
                evaluate(node.left),
                evaluate(node.right)
            )

        if isinstance(node, ast.UnaryOp):
            op = operators.get(type(node.op))
            if op is None:
                raise ValueError("不支持的一元运算")
            return op(evaluate(node.operand))

        raise ValueError("不支持的表达式")

    try:
        tree = ast.parse(expression, mode="eval")
        result = evaluate(tree)
        return str(result)
    except Exception as exc:
        return f"计算失败:{exc}"
这里没有使用 eval() 直接执行用户提供的字符串,而是通过 Python 的 ast 模块解析允许的数学表达式,并限制可执行的语法类型。
这种实现比直接使用 eval() 更适合作为入门示例,但正式项目仍需要增加表达式长度、数值范围、执行时间和异常输出等限制。
3.4 第二步:向模型声明工具
大模型需要知道当前 Agent 能够调用哪些工具,以及每个工具接收什么参数。
我们使用 JSON Schema 描述计算器:
TOOLS = [
    {
        "type": "function",
        "name": "calculate",
        "description": "计算简单的数学表达式,例如 (12 + 8) * 3",
        "parameters": {
            "type": "object",
            "properties": {
                "expression": {
                    "type": "string",
                    "description": "需要计算的数学表达式"
                }
            },
            "required": ["expression"],
            "additionalProperties": False
        },
        "strict": True
    }
]
这份工具声明告诉模型:
-
工具名称是
calculate。 -
工具需要一个名为
expression的字符串参数。 -
参数应该符合规定的 JSON 结构。
-
模型可以在适当的时候请求调用该工具。
注意,工具声明只是描述可用能力,并不会自动执行 Python 函数。实际执行仍然需要我们编写代码。
3.5 第三步:实现 Agent 主循环
接下来,将大模型、工具声明和 Python 函数连接起来。
继续在 main.py 中添加:
def run_agent(user_input: str) -> str:
    response = client.responses.create(
        model=MODEL,
        instructions=(
            "你是一个严谨的数学助手。"
            "遇到需要精确计算的数学问题时,"
            "优先调用 calculate 工具。"
            "根据工具返回的真实结果回答用户。"
        ),
        input=user_input,
        tools=TOOLS
    )

    # 限制工具调用轮数,避免无限循环
    for _ in range(5):
        calls = [
            item for item in response.output
            if item.type == "function_call"
        ]

        if not calls:
            return response.output_text

        outputs = []

        for call in calls:
            if call.name != "calculate":
                outputs.append({
                    "type": "function_call_output",
                    "call_id": call.call_id,
                    "output": "错误:不支持的工具"
                })
                continue

            try:
                arguments = json.loads(call.arguments)
                expression = arguments["expression"]

                if not isinstance(expression, str):
                    raise ValueError("expression 必须是字符串")

                result = calculate(expression)

            except Exception as exc:
                result = f"工具调用失败:{exc}"

            outputs.append({
                "type": "function_call_output",
                "call_id": call.call_id,
                "output": result
            })

        response = client.responses.create(
            model=MODEL,
            previous_response_id=response.id,
            input=outputs,
            tools=TOOLS
        )

    return "执行轮数已达到上限,请简化问题后重试。"


if __name__ == "__main__":
    question = input("请输入你的问题:")
    answer = run_agent(question)

    print("\nAgent 回答:")
    print(answer)
这段代码采用 Responses API 的工具调用方式。它会检查模型是否返回 function_call,由 Python 执行对应工具,再将工具结果提交给模型。
对于生产项目,还应验证模型返回的参数、控制并发、设置超时和重试策略,并根据所用模型服务的实际 API 规范调整代码。
四、运行项目,看看 Agent 能做什么
在终端执行:
python main.py输入:
请帮我计算 12345 乘以 678,再加上 9876。预期流程如下:
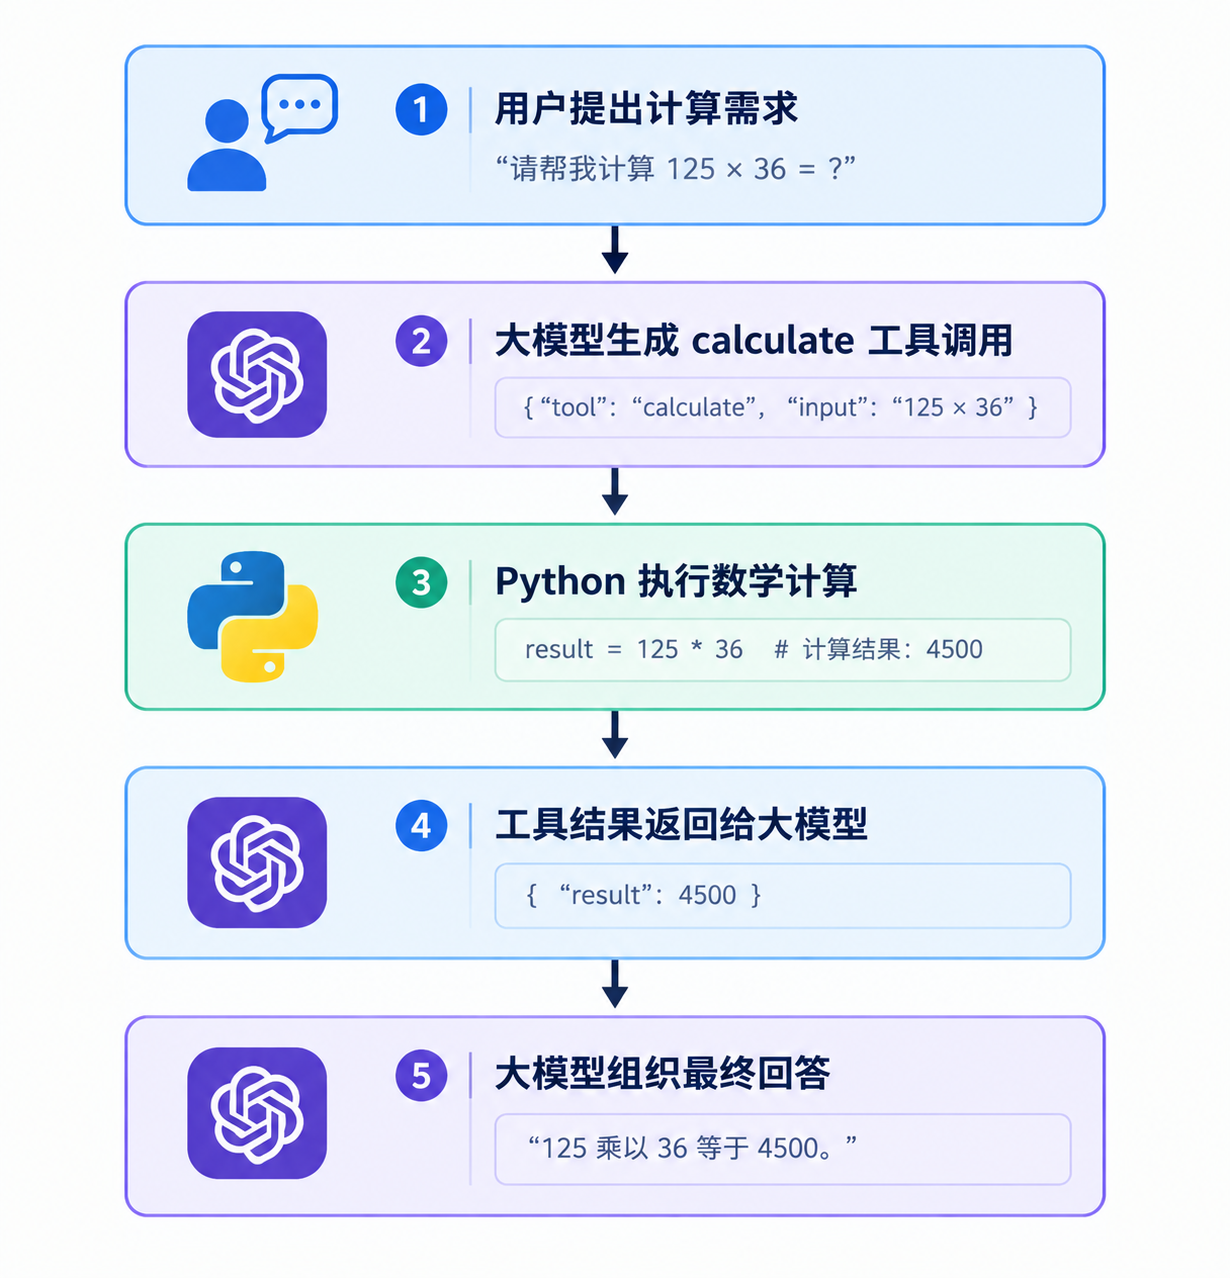
如果模型服务正常、工具调用成功,Agent 就可以返回计算结果,并根据工具结果组织自然语言回答。
需要注意,以上是预期的执行流程示例,不是已经实际运行验证的输出。真实结果以你本地的运行环境、模型服务和 API 响应为准。
五、这段代码到底实现了什么?
通过这个项目,我们已经搭建出了一个具备基础工具调用能力的 Agent。
但它距离真正的生产级 Agent 还有一定差距。
| 能力 | 当前项目 | 进阶版本 |
|---|---|---|
| 大模型调用 | 已实现 | 增加超时、重试、成本控制 |
| 工具调用 | 单个计算器 | 多工具注册与动态路由 |
| 任务规划 | 依赖模型判断 | 增加显式计划和任务状态 |
| 记忆能力 | 无持久化记忆 | 对话历史、外部存储 |
| 知识检索 | 暂无 | RAG、向量数据库 |
| 结果验证 | 基础异常处理 | 结构校验、结果评估 |
| 服务部署 | 命令行程序 | FastAPI、Docker、监控 |
入门时不必一次性实现所有功能。先把单工具调用的执行闭环跑通,再逐步扩展更容易理解 Agent 的真实工作机制。
六、从零学习 Agent 开发,应该按照什么顺序?
如果你的目标不仅是运行一个 Demo,还希望具备独立开发 AI 应用的能力,可以按照下面的顺序学习。
第一阶段:Python 基础
重点掌握:
-
变量、函数、列表、字典。
-
模块导入与异常处理。
-
文件读写、JSON 数据处理。
-
虚拟环境、pip、Git 基础。
目标:能够独立编写简单的 Python 程序。
第二阶段:大模型 API 开发
重点掌握:
-
API、HTTP、JSON。
-
API Key 与环境变量。
-
Prompt Engineering。
-
结构化输出。
-
流式输出与错误处理。
目标:开发一个可以完成文本总结、分类、提取和问答的 AI 应用。
第三阶段:Agent 核心机制
重点掌握:
-
Function Calling。
-
工具注册与执行。
-
多轮调用循环。
-
任务状态与上下文管理。
-
权限控制、执行上限和错误恢复。
目标:开发一个能够调用多个工具完成任务的 Agent。
第四阶段:RAG 与知识库
重点掌握:
-
文档解析与切分。
-
Embedding 与向量检索。
-
检索结果组织。
-
引用溯源与回答评估。
目标:让 Agent 能够结合外部知识库回答问题。
第五阶段:工程化与部署
重点掌握:
-
FastAPI。
-
数据库与缓存。
-
Docker。
-
日志、监控、测试。
-
并发控制、成本与安全管理。
目标:将本地 Demo 转化为可调用、可测试、可部署的应用服务。
七、总结
Agent 开发并不意味着必须从训练大模型开始。
对于希望进入 AI 应用开发领域的同学,更实用的学习路径是:
Python 基础 → 大模型 API → Function Calling → Agent 执行循环 → RAG → 工程化部署。
通过本文的计算器项目,你可以先理解 Agent 最核心的工作方式:模型提出工具调用请求,程序执行工具,再将执行结果交回模型。
下一步,可以把计算器扩展成文件检索、网页信息查询、数据库查询或知识库问答工具,并逐步增加权限控制、结果验证和部署能力。
真正有价值的 Agent 项目,不只是能够调用大模型,而是能够稳定地完成一项明确任务,并且让结果可验证、过程可追踪、系统可维护。