专栏导语 :本专栏系统讲解数学建模的经典方法与 AI 智能方法,并打通两者之间的联系。上一篇我们用 AHP × 熵权 × TOPSIS 完成了评价类模型的收官(熵权法与TOPSIS:数据驱动的客观评价)。从这一篇开始进入预测类模型 ,从最基础也最重要的线性回归 讲起------它不仅是统计建模的地基,更是神经网络在"单层、无激活函数"时的特例。我们会讲清最小二乘、 R 2 R^2 R2、岭回归与 LASSO 正则化,并看看过拟合这条主线是如何一路贯穿到深度学习的。
文章目录
- 一、问题引入:从"评价排序"到"数值预测"
- 二、问题分析:找一条"最贴近"所有样本点的线
- 三、模型假设
- 四、符号说明
- 五、模型建立
-
- [5.1 一元最小二乘:完整推导](#5.1 一元最小二乘:完整推导)
- [5.2 多元情形与正规方程](#5.2 多元情形与正规方程)
- [5.3 拟合优度: R 2 R^2 R2 与 RMSE](#5.3 拟合优度: R 2 R^2 R2 与 RMSE)
- [5.4 过拟合:训练误差为零、测试误差爆炸](#5.4 过拟合:训练误差为零、测试误差爆炸)
- [5.5 岭回归(Ridge,L2 正则化)](#5.5 岭回归(Ridge,L2 正则化))
- [5.6 LASSO(L1 正则化)](#5.6 LASSO(L1 正则化))
- [5.7 L1 vs L2 对比与 λ \lambda λ 的选择](#5.7 L1 vs L2 对比与 λ \lambda λ 的选择)
- [5.8 关键辨析:OLS 不需要 Scaling,正则化必须 Scaling](#5.8 关键辨析:OLS 不需要 Scaling,正则化必须 Scaling)
- [六、Python 实现:房价预测](#六、Python 实现:房价预测)
-
- [6.1 数据设定](#6.1 数据设定)
- [6.2 步骤 1:最小二乘求解(手写正规方程 + sklearn 验证)](#6.2 步骤 1:最小二乘求解(手写正规方程 + sklearn 验证))
- [6.3 步骤 2:过拟合实验------30 个噪声特征摧毁最小二乘](#6.3 步骤 2:过拟合实验——30 个噪声特征摧毁最小二乘)
- [6.4 步骤 3:单位敏感性实验------为什么正则化前必须标准化](#6.4 步骤 3:单位敏感性实验——为什么正则化前必须标准化)
- [6.5 结果可视化](#6.5 结果可视化)
- 七、模型评价、适用场景与常见问题
- [八、AI 视角:损失函数、梯度下降与过拟合------深度学习的原点](#八、AI 视角:损失函数、梯度下降与过拟合——深度学习的原点)
-
- [8.1 最小二乘 = MSE 损失函数](#8.1 最小二乘 = MSE 损失函数)
- [8.2 正规方程 vs 梯度下降](#8.2 正规方程 vs 梯度下降)
- [8.3 L2 正则化 = 权重衰减(Weight Decay)](#8.3 L2 正则化 = 权重衰减(Weight Decay))
- [8.4 回归系数 vs 熵权 vs SHAP:三种"重要性"的完整对照](#8.4 回归系数 vs 熵权 vs SHAP:三种"重要性"的完整对照)
- [8.5 线性回归 = 没有激活函数的神经网络](#8.5 线性回归 = 没有激活函数的神经网络)
- 九、小结
- 个人主页 :蒲公英eric
- 专栏传送门 :《数学建模 × AI:从经典模型到智能方法》
- 学习方向:大数据 / 数学建模 / AI交叉领域
- 人生格言:建模没有终点,只有不断迭代的更优解
📌本文是专栏「数学建模 × AI:从经典模型到智能方法」的第 8 篇文章。
一、问题引入:从"评价排序"到"数值预测"
评价类模型回答的是"谁更好 "------AHP、熵权法、TOPSIS 把多个指标揉成一个分数,然后排序。但数模竞赛里还有一大类问题,它们要回答的是"是多少":
-
已知一套房子的面积、房龄、距地铁距离,预测它能卖多少钱?
-
已知某地区过去 12 个月的销量,预测下个月的销量?
-
已知炉膛温度、原料配比,预测产品强度?
这类问题的共同点是:输出是一个连续的数值,而且手里有一批"输入-输出"都已知的历史数据。这就是**回归(Regression)**问题。
回归里最古老、最基础的模型是线性回归(Linear Regression) :假设输出与输入之间是线性关系。它由高斯和勒让德在 19 世纪初研究天体轨道时提出,距今已有两百多年,却至今活跃在每一篇数据分析论文和每一个神经网络里------你后面会看到,一个不含激活函数的神经元,就是一线性回归模型。
这一篇的主线:
最小二乘求出闭式解 → 发现"特征太多"时会过拟合 → 用岭回归 / LASSO 正则化救回来 → 交叉验证选正则化强度。
这条主线正是现代机器学习"损失函数 + 正则化 + 交叉验证"三板斧的雏形,务必吃透。
二、问题分析:找一条"最贴近"所有样本点的线
以一元情形为例。手里有 n n n 个样本点 ( x 1 , y 1 ) , ... , ( x n , y n ) (x_1,y_1),\dots,(x_n,y_n) (x1,y1),...,(xn,yn),想找一条直线 y = β 0 + β 1 x y=\beta_0+\beta_1 x y=β0+β1x 来概括它们的关系。直线有无数条,哪条最好?
直觉回答:让直线离所有点都尽量近 。数学上把"第 i i i 个点的预测值与真实值之差"叫做残差(residual):
e i = y i − y ^ i = y i − ( β 0 + β 1 x i ) e_i=y_i-\hat{y}_i=y_i-(\beta_0+\beta_1 x_i) ei=yi−y^i=yi−(β0+β1xi)
其中, y ^ i \hat{y}_i y^i 是模型对第 i i i 个样本的预测值, e i e_i ei 衡量"这条线在这个点上偏了多少"。
那"总体贴近"怎么定义?直接把残差加起来 ∑ e i \sum e_i ∑ei 不行------正负会抵消(偏高 100 和偏低 100 加起来是 0,看起来"完美")。于是取残差平方和:
Q ( β 0 , β 1 ) = ∑ i = 1 n ( y i − β 0 − β 1 x i ) 2 Q(\beta_0,\beta_1)=\sum_{i=1}^{n}(y_i-\beta_0-\beta_1 x_i)^2 Q(β0,β1)=i=1∑n(yi−β0−β1xi)2
让 Q Q Q 最小的那条直线,就是最小二乘解。为什么用平方而不是绝对值或四次方?三个原因:
- 不抵消:平方后全为正;
- 处处可导:绝对值在零点不可导,没法用微积分求极值;平方的导数是漂亮的一次式;
- 对应正态噪声:如果噪声服从正态分布,最小二乘等价于最大似然估计(这句记下,AI 视角会回收)。
多元情形完全类似: p p p 个特征、一个超平面 y = β 0 + β 1 x 1 + ⋯ + β p x p y=\beta_0+\beta_1x_1+\cdots+\beta_px_p y=β0+β1x1+⋯+βpxp,还是最小化残差平方和,只是把"解二元方程组"升级成"解线性方程组"------恰好有矩阵闭式解。
三、模型假设
线性回归的根基是一组经典假设(高斯-马尔可夫条件),竞赛中可操作化成 5 条:
- 线性关系 : y y y 与各特征之间存在近似线性关系。若明显非线性,可对特征做变换(取对数、平方项等)后再线性拟合
- 样本独立:各样本之间相互独立(时间序列数据需特别注意,后续 ARIMA 篇详谈)
- 误差性质良好:噪声零均值、方差相同(同方差),且近似服从正态分布
- 无严重多重共线性 :特征之间不能高度相关。否则 β \beta β 估计不稳定------"面积"和"房间数"几乎同步变化时,模型无法分清功劳该给谁
- 特征数小于样本数 ( p < n p<n p<n):否则正规方程里的矩阵不可逆或严重病态
注意假设 4 和 5 :现实数据经常违反它们。怎么办?这正是**正则化(岭回归 / LASSO)**登场的时刻------它可以同时消化共线性和 p ≥ n p\ge n p≥n 两种困境。这是本文后半部分的主角。
四、符号说明
| 符号 | 含义 | 备注 |
|---|---|---|
| n n n | 样本数 | 房源个数 |
| p p p | 特征数 | 不含截距 |
| x i j x_{ij} xij | 第 i i i 个样本的第 j j j 个特征值 | |
| y i y_i yi | 第 i i i 个样本的真实输出 | 房价(万元) |
| β = ( β 0 , β 1 , ... , β p ) T \beta=(\beta_0,\beta_1,\dots,\beta_p)^T β=(β0,β1,...,βp)T | 待估参数 | β 0 \beta_0 β0 为截距 |
| ε i \varepsilon_i εi | 第 i i i 个样本的随机误差 | E ( ε i ) = 0 E(\varepsilon_i)=0 E(εi)=0 |
| y ^ i , e i \hat{y}_i,\ e_i y^i, ei | 预测值、残差 | e i = y i − y ^ i e_i=y_i-\hat{y}_i ei=yi−y^i |
| X X X | 设计矩阵 | n × ( p + 1 ) n\times(p+1) n×(p+1),首列全为 1 |
| Q ( β ) Q(\beta) Q(β) | 残差平方和 | ∣ y − X β ∣ 2 |y-X\beta|^2 ∣y−Xβ∣2 |
| λ \lambda λ | 正则化系数 | λ ≥ 0 \lambda\ge 0 λ≥0,控制惩罚强度 |
| R 2 R^2 R2 | 决定系数 | 拟合优度,越接近 1 越好 |
| α \alpha α | sklearn 中的正则化强度 | 即上文 λ \lambda λ,注意 sklearn 惯例 |
五、模型建立
5.1 一元最小二乘:完整推导
目标函数:
Q ( β 0 , β 1 ) = ∑ i = 1 n ( y i − β 0 − β 1 x i ) 2 Q(\beta_0,\beta_1)=\sum_{i=1}^{n}\left(y_i-\beta_0-\beta_1 x_i\right)^2 Q(β0,β1)=i=1∑n(yi−β0−β1xi)2
分别对 β 0 \beta_0 β0、 β 1 \beta_1 β1 求偏导并令其为零:
∂ Q ∂ β 0 = − 2 ∑ i = 1 n ( y i − β 0 − β 1 x i ) = 0 , ∂ Q ∂ β 1 = − 2 ∑ i = 1 n x i ( y i − β 0 − β 1 x i ) = 0 \frac{\partial Q}{\partial \beta_0}=-2\sum_{i=1}^{n}(y_i-\beta_0-\beta_1 x_i)=0,\qquad \frac{\partial Q}{\partial \beta_1}=-2\sum_{i=1}^{n}x_i(y_i-\beta_0-\beta_1 x_i)=0 ∂β0∂Q=−2i=1∑n(yi−β0−β1xi)=0,∂β1∂Q=−2i=1∑nxi(yi−β0−β1xi)=0
由第一个方程解得 β 0 = y ˉ − β 1 x ˉ \beta_0=\bar{y}-\beta_1\bar{x} β0=yˉ−β1xˉ(其中 x ˉ , y ˉ \bar{x},\bar{y} xˉ,yˉ 为均值),代入第二个方程整理,得闭式解:
β 1 = ∑ i = 1 n ( x i − x ˉ ) ( y i − y ˉ ) ∑ i = 1 n ( x i − x ˉ ) 2 , β 0 = y ˉ − β 1 x ˉ \boxed{\ \beta_1=\frac{\sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y})}{\sum_{i=1}^{n}(x_i-\bar{x})^2},\qquad \beta_0=\bar{y}-\beta_1\bar{x}\ } β1=∑i=1n(xi−xˉ)2∑i=1n(xi−xˉ)(yi−yˉ),β0=yˉ−β1xˉ
其中,分子 S x y = ∑ ( x i − x ˉ ) ( y i − y ˉ ) S_{xy}=\sum(x_i-\bar{x})(y_i-\bar{y}) Sxy=∑(xi−xˉ)(yi−yˉ) 是 x x x 与 y y y 的协方差(未除以 n n n 的形式),度量两者"同步变化"的程度;分母 S x x = ∑ ( x i − x ˉ ) 2 S_{xx}=\sum(x_i-\bar{x})^2 Sxx=∑(xi−xˉ)2 是 x x x 的方差(同样未除以 n n n)。整个式子读作:协方差除以方差 ------ x x x 怎么动、 y y y 跟着怎么动,比值就是斜率。
5.2 多元情形与正规方程
p p p 个特征时,把每个样本补一个常数 1 对应截距,构成设计矩阵:
X = 1 x 11 ⋯ x 1 p 1 x 21 ⋯ x 2 p ⋮ ⋮ ⋱ ⋮ 1 x n 1 ⋯ x n p , y = y 1 y 2 ⋮ y n X=\begin{bmatrix} 1 & x_{11} & \cdots & x_{1p}\\ 1 & x_{21} & \cdots & x_{2p}\\ \vdots & \vdots & \ddots & \vdots\\ 1 & x_{n1} & \cdots & x_{np} \end{bmatrix},\qquad y=\begin{bmatrix}y_1\\ y_2\\ \vdots\\ y_n\end{bmatrix} X= 11⋮1x11x21⋮xn1⋯⋯⋱⋯x1px2p⋮xnp ,y= y1y2⋮yn
残差平方和写成矩阵形式 Q ( β ) = ∥ y − X β ∥ 2 Q(\beta)=\|y-X\beta\|^2 Q(β)=∥y−Xβ∥2。对 β \beta β 求梯度(矩阵求导规则)并令其为零:
∂ Q ∂ β = − 2 X T ( y − X β ) = 0 ⟹ X T X β = X T y \frac{\partial Q}{\partial\beta}=-2X^T(y-X\beta)=0\ \Longrightarrow\ X^TX\beta=X^Ty ∂β∂Q=−2XT(y−Xβ)=0 ⟹ XTXβ=XTy
若 X T X X^TX XTX 可逆,立即得到正规方程(Normal Equation)的闭式解:
β ^ = ( X T X ) − 1 X T y \boxed{\ \hat{\beta}=(X^TX)^{-1}X^Ty\ } β^=(XTX)−1XTy
其中, β ^ \hat\beta β^ 是使残差平方和最小的参数估计。几何上, y ^ = X β ^ \hat{y}=X\hat\beta y^=Xβ^ 是 y y y 在 X X X 列空间上的正交投影------"模型能解释的部分"与"残差"垂直。这个闭式解一步到位、无需迭代,是线性回归最迷人的性质。
5.3 拟合优度: R 2 R^2 R2 与 RMSE
解出 β ^ \hat\beta β^ 之后,"这条线贴得紧不紧"需要一个分数。定义三个平方和:
S S T = ∑ i ( y i − y ˉ ) 2 , S S E = ∑ i ( y i − y ^ i ) 2 , S S R = S S T − S S E SST=\sum_i(y_i-\bar{y})^2,\quad SSE=\sum_i(y_i-\hat{y}_i)^2,\quad SSR=SST-SSE SST=i∑(yi−yˉ)2,SSE=i∑(yi−y^i)2,SSR=SST−SSE
其中, S S T SST SST 是总平方和(数据总波动), S S E SSE SSE 是残差平方和(模型没解释的部分), S S R SSR SSR 是回归平方和(模型解释掉的部分)。于是:
R 2 = 1 − S S E S S T R^2=1-\frac{SSE}{SST} R2=1−SSTSSE
其中, R 2 R^2 R2 读作"模型解释了总波动的百分比"。全均值模型 R 2 = 0 R^2=0 R2=0;完美拟合 R 2 = 1 R^2=1 R2=1;比闭眼猜均值还差时 R 2 < 0 R^2<0 R2<0(记住这个,后面过拟合实验会见到负的)。
预测误差的绝对量级常用 RMSE(均方根误差):
R M S E = 1 n ∑ i = 1 n ( y i − y ^ i ) 2 RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2} RMSE=n1i=1∑n(yi−y^i)2
其中,RMSE 与 y y y 同量纲(房价问题里就是"平均偏了多少万元"),比 R 2 R^2 R2 更直观。
调整 R 2 R^2 R2:往模型里塞无关特征,训练集 R 2 R^2 R2 只会升不会降(哪怕该特征纯噪声),所以训练集 R 2 R^2 R2 会"作弊"。调整版: R ˉ 2 = 1 − ( 1 − R 2 ) n − 1 n − p − 1 \bar{R}^2=1-(1-R^2)\frac{n-1}{n-p-1} Rˉ2=1−(1−R2)n−p−1n−1,对特征数 p p p 施加惩罚, p p p 越大扣得越狠。
5.4 过拟合:训练误差为零、测试误差爆炸
现在问一个致命问题:特征越多,模型越好吗?
把 5.2 的闭式解套上就知道了:当特征数 p p p 逼近样本数 n n n 时, X T X X^TX XTX 越来越接近奇异;当 p + 1 = n p+1=n p+1=n(参数个数 = 样本数)时,模型有足够多的自由度穿过每一个训练样本 ------训练误差精确为 0。但穿过的形状是由噪声指定的,对没见过的样本毫无预测力:训练误差为零、测试误差爆炸 ,这就是过拟合(Overfitting)。
再叠加假设 4 的多重共线性问题( X T X X^TX XTX 病态时 β ^ \hat\beta β^ 方差极大,系数忽正忽负),两个病症一个病根:无约束的最小二乘在"特征多、样本少、共线"时不可靠。
5.5 岭回归(Ridge,L2 正则化)
思路:既然系数乱飞,那就惩罚系数的大小。在残差平方和上加一项:
β ^ r i d g e = arg min β { ∥ y − X β ∥ 2 + λ ∑ j = 1 p β j 2 } \hat{\beta}{ridge}=\arg\min{\beta}\left\{\|y-X\beta\|^2+\lambda\sum_{j=1}^{p}\beta_j^2\right\} β^ridge=argβmin{∥y−Xβ∥2+λj=1∑pβj2}
其中, λ ≥ 0 \lambda\ge 0 λ≥0 是正则化强度, ∑ β j 2 \sum\beta_j^2 ∑βj2 是 L2 惩罚项(注意不含截距 β 0 \beta_0 β0)。
岭回归同样有闭式解:
β ^ r i d g e = ( X T X + λ I ) − 1 X T y \boxed{\ \hat{\beta}_{ridge}=(X^TX+\lambda I)^{-1}X^Ty\ } β^ridge=(XTX+λI)−1XTy
其中, I I I 是单位矩阵。这个小小的 λ I \lambda I λI 一举三得:
- 保证可逆 :对角线加 λ \lambda λ 后矩阵必定正定, p ≥ n p\ge n p≥n、共线性都不再是不可逾越的障碍;
- 收缩系数 : λ \lambda λ 越大,系数被压得越接近 0,方差变小、偏差变大------用一点偏差换大量方差,测试误差通常下降;
- 连续可控 : λ = 0 \lambda=0 λ=0 退化为普通最小二乘, λ → ∞ \lambda\to\infty λ→∞ 时所有系数归零。
5.6 LASSO(L1 正则化)
岭回归能把系数压小,但不会精确压到 0。如果想要模型自己"选特征"(把无用特征彻底踢出局),换用 L1 惩罚:
β ^ l a s s o = arg min β { ∥ y − X β ∥ 2 + λ ∑ j = 1 p ∣ β j ∣ } \hat{\beta}{lasso}=\arg\min{\beta}\left\{\|y-X\beta\|^2+\lambda\sum_{j=1}^{p}|\beta_j|\right\} β^lasso=argβmin{∥y−Xβ∥2+λj=1∑p∣βj∣}
其中, ∑ ∣ β j ∣ \sum|\beta_j| ∑∣βj∣ 是 L1 惩罚项。这就是 LASSO(Least Absolute Shrinkage and Selection Operator,Tibshirani,1996)。
L1 为什么能产生精确的零?几何直觉:把两个约束画在系数平面上,L2 惩罚对应一个圆盘 (边界光滑,最优解几乎不在坐标轴上),L1 惩罚对应一个菱形(四个顶点恰好落在坐标轴上)------最优解落在顶点处时,其他坐标就是精确的 0。
代价:L1 含绝对值,不可导处存在,没有闭式解,需要迭代算法(坐标下降法,sklearn 已封装好)。
5.7 L1 vs L2 对比与 λ \lambda λ 的选择
| 岭回归(Ridge / L2) | LASSO(L1) | |
|---|---|---|
| 惩罚项 | λ ∑ β j 2 \lambda\sum\beta_j^2 λ∑βj2 | λ ∑ ∣ β j ∣ \lambda\sum|\beta_j| λ∑∣βj∣ |
| 闭式解 | 有: ( X T X + λ I ) − 1 X T y (X^TX+\lambda I)^{-1}X^Ty (XTX+λI)−1XTy | 无,坐标下降迭代 |
| 系数命运 | 整体收缩,不为零 | 部分系数精确为零 |
| 功能 | 处理共线性、稳定估计 | 收缩 + 自动特征选择 |
| 适合场景 | 认为多数特征都有用 | 认为只有少数特征重要 |
λ \lambda λ 怎么定?不能拿训练误差选( λ = 0 \lambda=0 λ=0 永远训练误差最小,又回到过拟合)。标准做法是 K 折交叉验证(K-Fold CV) :把训练数据分成 K K K 份,每次留一份当验证集、用其余 K − 1 K-1 K−1 份训练,轮流试一圈,取"验证误差平均最小"的 λ \lambda λ。sklearn 的 RidgeCV、LassoCV 已封装。
5.8 关键辨析:OLS 不需要 Scaling,正则化必须 Scaling
这是初学者最容易漏掉的一步,也是上一篇(6.4 节)标准化辨析的延续。
-
普通最小二乘 :对特征做任何线性换算(米→千米、元→万元), β ^ \hat\beta β^ 会自动跟着换算,预测结果不变------量纲无关,不 Scaling 也能算;
-
岭回归 / LASSO :惩罚项 ∑ β j 2 \sum\beta_j^2 ∑βj2、 ∑ ∣ β j ∣ \sum|\beta_j| ∑∣βj∣ 直接比较不同特征的系数大小 。如果不标准化,"距地铁每 1000 米降 0.6 万"(米制系数 0.0006)和"每千米降 6 万"(千米制系数 6)是同一个业务事实,惩罚力度却差一千万倍------量纲决定命运。
所以正则化之前必须先做特征标准化(Z-score 或 Min-Max,见上一篇 6.4 节的三种变换对照表)。本文实验将用"米 vs 千米"的对照直接展示这种扭曲。sklearn 的 Ridge、Lasso 文档第一条注意事项也是它。
六、Python 实现:房价预测
6.1 数据设定
模拟 50 套房源(模拟示例数据,实际应用请替换为链家/贝壳等真实挂牌数据):
| 特征 | 范围 | 真实效应(万元) |
|---|---|---|
| 面积(㎡) | 55 ~ 145 | 每平米 +1.1 |
| 房龄(年) | 0 ~ 30 | 每年 −1.5 |
| 距地铁(米) | 100 ~ 2000 | 每百米 −0.6(即每米 −0.006) |
| 学区评分(1~10) | 1 ~ 10 | 每分 +20 |
真实关系: y = 1.1 ⋅ 面积 − 1.5 ⋅ 房龄 − 0.006 ⋅ 距地铁 + 20 ⋅ 学区 + 30 + ε y = 1.1\cdot\text{面积} - 1.5\cdot\text{房龄} - 0.006\cdot\text{距地铁} + 20\cdot\text{学区} + 30 + \varepsilon y=1.1⋅面积−1.5⋅房龄−0.006⋅距地铁+20⋅学区+30+ε,噪声 ε ∼ N ( 0 , 12 2 ) \varepsilon\sim N(0,12^2) ε∼N(0,122)。参数 β \beta β 是"上帝视角"才知道的,接下来看模型能不能把它们学回来。
6.2 步骤 1:最小二乘求解(手写正规方程 + sklearn 验证)
python
import numpy as np
np.set_printoptions(suppress=True, precision=4)

rng = np.random.default_rng(42)
n = 50
# 4个特征:面积(㎡) 房龄(年) 距地铁(米) 学区评分(1-10)
area = rng.uniform(55, 145, n)
age = rng.uniform(0, 30, n)
metro = rng.uniform(100, 2000, n)
school = rng.uniform(1, 10, n)
X = np.column_stack([area, age, metro, school])

# 真实关系(模拟设定):
# 总价(万元) = 1.1*面积 - 1.5*房龄 - 0.006*距地铁 + 20*学区 + 30 + 噪声
true_w = np.array([1.1, -1.5, -0.006, 20.0])
b0 = 30.0
y = X @ true_w + b0 + rng.normal(0, 12, n)
print('y 前5个:', np.round(y[:5], 2))

# ---- 手写最小二乘(正规方程)----
X1 = np.column_stack([np.ones(n), X])       # 加一列1对应截距
beta = np.linalg.inv(X1.T @ X1) @ X1.T @ y  # (X'X)^(-1) X'y
print('手写正规方程 [b0, w1..w4] =', beta)

# ---- sklearn 验证 ----
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score, mean_squared_error

model = LinearRegression().fit(X, y)
print('sklearn 截距 b0 = %.4f' % model.intercept_)
print('sklearn 系数 w  =', np.round(model.coef_, 4))
print('真实 w =', true_w, ' 真实 b0 =', b0)

yhat = model.predict(X)
print('训练集 R2 = %.4f' % r2_score(y, yhat))
print('训练集 RMSE = %.4f' % np.sqrt(mean_squared_error(y, yhat)))
运行结果:
y 前5个: [323.62 301.61 181.64 235.74 102.21]
手写正规方程 [b0, w1..w4] = [ 4.3294  1.256  -1.2635 -0.0019 20.051 ]
sklearn 截距 b0 = 4.3294
sklearn 系数 w  = [ 1.256  -1.2635 -0.0019 20.051 ]
真实 w = [ 1.1   -1.5   -0.006 20.   ]  真实 b0 = 30.0
训练集 R2 = 0.9687
训练集 RMSE = 11.0781
解读:
- 手写正规方程与 sklearn 的结果完全一致 ------
LinearRegression内部就是正规方程(更稳定的矩阵分解实现); - 估计系数 1.256 , − 1.264 , − 0.0019 , 20.051 1.256,\\ -1.264,\\ -0.0019,\\ 20.051 1.256, −1.264, −0.0019, 20.051 与真实效应 1.1 , − 1.5 , − 0.006 , 20 1.1,\\ -1.5,\\ -0.006,\\ 20 1.1, −1.5, −0.006, 20 非常接近但不重合------差距就是 50 个样本 + 噪声下的抽样波动;
- R 2 = 0.9687 R^2=0.9687 R2=0.9687:模型解释了约 97% 的房价波动;RMSE≈11.1 万,与真实噪声标准差 12 万相当------模型基本把噪声之外的规律学干净了,这是好拟合的标志(RMSE 不可能长期低于噪声水平)。
6.3 步骤 2:过拟合实验------30 个噪声特征摧毁最小二乘
现在做一件危险的事:往数据里掺 30 列纯随机噪声(与房价毫无关系),看最小二乘会发生什么。
python
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression, Ridge, Lasso, LassoCV, RidgeCV
from sklearn.metrics import mean_squared_error, r2_score
import numpy as np
np.set_printoptions(suppress=True, precision=4)

# ---- 数据段(与 6.2 节完全相同)----
rng = np.random.default_rng(42)
n = 50
area = rng.uniform(55, 145, n)      # 面积(㎡)
age = rng.uniform(0, 30, n)         # 房龄(年)
metro = rng.uniform(100, 2000, n)   # 距地铁(米)
school = rng.uniform(1, 10, n)      # 学区评分(1-10)
X = np.column_stack([area, age, metro, school])
true_w = np.array([1.1, -1.5, -0.006, 20.0])
y = X @ true_w + 30.0 + rng.normal(0, 12, n)
# 以上 X, y 为上文 6.2 节已生成的数据,此处原样放入,保证本段代码可独立运行

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42)

# 加 30 列纯噪声特征(与房价无关),制造"特征数逼近样本数"的过拟合条件
rng2 = np.random.default_rng(0)
noise_tr = rng2.normal(0, 1, (X_tr.shape[0], 30))
noise_te = rng2.normal(0, 1, (X_te.shape[0], 30))
X_tr34 = np.column_stack([X_tr, noise_tr])   # 训练集:35样本 × 34特征
X_te34 = np.column_stack([X_te, noise_te])

def report(name, mdl, Xtr, Xte):
    mse_tr = mean_squared_error(y_tr, mdl.predict(Xtr))
    mse_te = mean_squared_error(y_te, mdl.predict(Xte))
    r2_te = r2_score(y_te, mdl.predict(Xte))
    print(f'{name:22s} 训练MSE={mse_tr:8.2f}  测试MSE={mse_te:9.2f}  测试R2={r2_te:7.3f}')

print('===== 过拟合实验:4特征 vs 34特征(4真实+30噪声) =====')
ols4 = LinearRegression().fit(X_tr, y_tr)
report('OLS(4特征)', ols4, X_tr, X_te)
ols34 = LinearRegression().fit(X_tr34, y_tr)
report('OLS(34特征)', ols34, X_tr34, X_te34)
print('OLS(34特征) 噪声系数绝对值最大 = %.3f' % np.abs(ols34.coef_[4:]).max())

print('\n===== Ridge(34特征,标准化后,不同 alpha) =====')
sc = StandardScaler().fit(X_tr34)               # 正则化前必须标准化(见5.8节)
X_tr34s, X_te34s = sc.transform(X_tr34), sc.transform(X_te34)
for a in [0.1, 1, 10, 100]:
    report(f'Ridge(alpha={a})', Ridge(alpha=a).fit(X_tr34s, y_tr), X_tr34s, X_te34s)
ridge10 = Ridge(alpha=10).fit(X_tr34s, y_tr)
print('Ridge(alpha=10) 噪声系数绝对值之和 = %.3f' % np.abs(ridge10.coef_[4:]).sum())

print('\n===== LASSO 与交叉验证 =====')
las = Lasso(alpha=1.0).fit(X_tr34s, y_tr)
report('Lasso(alpha=1)', las, X_tr34s, X_te34s)
print('Lasso(alpha=1) 非零系数个数 =', np.sum(las.coef_ != 0), '/ 34')
lascv = LassoCV(cv=5, random_state=42).fit(X_tr34s, y_tr)
print('LassoCV 最优 alpha = %.4f' % lascv.alpha_)
report('Lasso(CV选alpha)', lascv, X_tr34s, X_te34s)
print('Lasso(CV) 非零系数个数 =', np.sum(lascv.coef_ != 0), '/ 34')
print('Lasso(CV) 前4系数 [面积 房龄 距地铁 学区] =', np.round(lascv.coef_[:4], 3))

rcv = RidgeCV(alphas=np.logspace(-2, 3, 100)).fit(X_tr34s, y_tr)
print('\nRidgeCV 最优 alpha = %.4f' % rcv.alpha_)
report('Ridge(CV选alpha)', rcv, X_tr34s, X_te34s)
运行结果:
===== 过拟合实验:4特征 vs 34特征(4真实+30噪声) =====
OLS(4特征)                 训练MSE=   89.36  测试MSE=   217.12  测试R2=  0.947
OLS(34特征)                训练MSE=    0.00  测试MSE= 90496.42  测试R2=-21.295
OLS(34特征) 噪声系数绝对值最大 = 88.060

===== Ridge(34特征,标准化后,不同 alpha) =====
Ridge(alpha=0.1)         训练MSE=    5.75  测试MSE=   614.26  测试R2=  0.849
Ridge(alpha=1)           训练MSE=   18.23  测试MSE=   448.34  测试R2=  0.890
Ridge(alpha=10)          训练MSE=  209.75  测试MSE=  1536.16  测试R2=  0.622
Ridge(alpha=100)         训练MSE= 1520.90  测试MSE=  3682.13  测试R2=  0.093
Ridge(alpha=10) 噪声系数绝对值之和 = 77.588

===== LASSO 与交叉验证 =====
Lasso(alpha=1)           训练MSE=   30.68  测试MSE=   235.20  测试R2=  0.942
Lasso(alpha=1) 非零系数个数 = 14 / 34
LassoCV 最优 alpha = 0.8528
Lasso(CV选alpha)          训练MSE=   26.81  测试MSE=   245.84  测试R2=  0.939
Lasso(CV) 非零系数个数 = 16 / 34
Lasso(CV) 前4系数 [面积 房龄 距地铁 学区] = [31.477 -7.599  0.    51.12 ]

RidgeCV 最优 alpha = 0.7391
Ridge(CV选alpha)          训练MSE=   14.46  测试MSE=   410.71  测试R2=  0.899
解读(本篇最重要的一段):
- 过拟合的戏剧性展示 :OLS 用 34 个特征拟合 35 个训练样本,训练 MSE 精确为 0.00(35 个参数完整"吞下"35 个样本),但测试 MSE 高达 90496 、测试 R 2 = − 21.3 R^2=-21.3 R2=−21.3------负的 R 2 R^2 R2 意味着"模型比闭眼猜均值还差 20 倍"。它给纯噪声特征估出的系数最大达 88 万/㎡,纯属胡言乱语;
- 岭回归有效但不彻底 : α = 1 \alpha=1 α=1 时测试 MSE 从 90496 拉回 448,但注意 α = 10 \alpha=10 α=10 时 30 个噪声特征的系数绝对值之和仍有 77.6------L2 只压小、不剔除,每个噪声特征都留一条"小尾巴",30 条尾巴累积起来仍拖累预测(最优的 Ridge CV 版本 411,仍逊于 LASSO);
- LASSO 的稀疏性大显身手 : α = 1 \alpha=1 α=1 时 34 个系数只剩 14 个非零,测试 MSE=235,几乎恢复到干净基线(OLS 4 特征的 217);
- 但稀疏性是把双刃剑 :看 Lasso(CV) 的前 4 个系数 31.5 , − 7.6 , 0 , 51.1 31.5,\\ -7.6,\\ 0,\\ 51.1 31.5, −7.6, 0, 51.1------距地铁被压成了 0!地铁效应本来就弱(每百米才 0.6 万),在 30 个噪声的干扰下被 LASSO"误杀"。这是 L1 的固有风险:强特征保得住,弱特征可能错删;
- 结构匹配决定胜负 :真实模型是"稀疏"的(4 强 + 30 零),LASSO 的假设恰好匹配,所以赢;如果真实效应是"分散在几十个弱特征上",岭回归就会反过来占优。没有免费的午餐,选正则化要看你对结构的 belief。
6.4 步骤 3:单位敏感性实验------为什么正则化前必须标准化
只改一个与业务无关的选择:把"距地铁"从米 换成千米 (数值除以 1000,系数理应乘 1000: − 0.006 → − 6 -0.006\to-6 −0.006→−6),看未标准化的岭回归会发生什么。
python
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge
import numpy as np
np.set_printoptions(suppress=True, precision=4)

# ---- 数据段(与 6.2 节完全相同)----
rng = np.random.default_rng(42)
n = 50
area = rng.uniform(55, 145, n)      # 面积(㎡)
age = rng.uniform(0, 30, n)         # 房龄(年)
metro = rng.uniform(100, 2000, n)   # 距地铁(米)
school = rng.uniform(1, 10, n)      # 学区评分(1-10)
X = np.column_stack([area, age, metro, school])
true_w = np.array([1.1, -1.5, -0.006, 20.0])
y = X @ true_w + 30.0 + rng.normal(0, 12, n)
# 以上 X, y 为上文 6.2 节已生成的数据,此处原样放入,保证本段代码可独立运行

# ---- 数据划分 + 30 列噪声特征(与 6.3 节相同)----
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42)
rng2 = np.random.default_rng(0)
X_tr34 = np.column_stack([X_tr, rng2.normal(0, 1, (X_tr.shape[0], 30))])
X_te34 = np.column_stack([X_te, rng2.normal(0, 1, (X_te.shape[0], 30))])
sc = StandardScaler().fit(X_tr34)   # 标准化器(只用训练集拟合)

# ---- 单位敏感性实验 ----
X_tr34_km, X_te34_km = X_tr34.copy(), X_te34.copy()
X_tr34_km[:, 2] = X_tr34_km[:, 2] / 1000   # 米 -> 千米(系数应变为原来的1000倍)
X_te34_km[:, 2] = X_te34_km[:, 2] / 1000

r_m  = Ridge(alpha=10).fit(X_tr34, y_tr)      # 未标准化
r_km = Ridge(alpha=10).fit(X_tr34_km, y_tr)
print('未标准化 Ridge(alpha=10) 前4系数 [面积 房龄 距地铁 学区]:')
print('  米制:  ', np.round(r_m.coef_[:4], 4))
print('  千米制:', np.round(r_km.coef_[:4], 4))
print('  [真实效应: 1.1 -1.5 -0.006 20],千米制下地铁系数应约为 -6 才等价]')

r_ms  = Ridge(alpha=10).fit(sc.transform(X_tr34), y_tr)                    # 标准化(米)
r_kms = Ridge(alpha=10).fit(StandardScaler().fit_transform(X_tr34_km), y_tr)  # 标准化(千米)
print('\n标准化后 Ridge(alpha=10) 前4系数:')
print('  米制:  ', np.round(r_ms.coef_[:4], 4))
print('  千米制:', np.round(r_kms.coef_[:4], 4))
print('  两者最大差异 = %.1e' % np.abs(r_ms.coef_ - r_kms.coef_).max())
运行结果:
未标准化 Ridge(alpha=10) 前4系数 [面积 房龄 距地铁 学区]:
  米制:   [ 1.256 -1.147  0.004 18.557]
  千米制: [ 1.251 -1.163  1.146 18.619]
  [真实效应: 1.1 -1.5 -0.006 20],千米制下地铁系数应约为 -6 才等价]

标准化后 Ridge(alpha=10) 前4系数:
  米制:   [16.9039 -7.1039  1.9808 31.3478]
  千米制: [16.9039 -7.1039  1.9808 31.3478]
  两者最大差异 = 7.1e-15
解读:
- 未标准化 + 换单位 = 系数被扭曲 :米制下地铁系数 0.004(真实 −0.006,轻微软化);换成千米制后,系数理应是 −6 左右,实际估出 +1.146------连正负号都反了 。惩罚项 λ ∑ β 2 \lambda\sum\beta^2 λ∑β2 对"千米制下天然巨大的系数"下了重手,把真实的地铁效应压没了;
- 标准化后彻底免疫 :米制、千米制的系数一字不差(差异 7.1e-15,纯属浮点噪声)。标准化吸收了单位选择,L2 惩罚比较的变成了"每标准差效应",公平且稳健;
- 这就是 5.8 节的实证:普通最小二乘换算单位相安无事,正则化换算单位天翻地覆。所以任何带惩罚的模型(岭、LASSO、弹性网、神经网络+权重衰减)输入前都必须标准化。Kaggle 的 Scaling 课程教了"怎么做",这里补上了"为什么非做不可"。
6.5 结果可视化
python
import matplotlib.pyplot as plt
import numpy as np
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

fig, axes = plt.subplots(1, 2, figsize=(12.5, 5))

# 左图:Lasso(CV) 测试集预测 vs 真实
yhat = lascv.predict(X_te34s)                # 接步骤2的模型
from sklearn.metrics import r2_score
r2 = r2_score(y_te, yhat)
axes[0].scatter(y_te, yhat, s=55, color='#4C72B0', alpha=0.8)
lims = [min(y_te.min(), yhat.min()) - 20, max(y_te.max(), yhat.max()) + 20]
axes[0].plot(lims, lims, 'r--', lw=1.5, label='y = x(理想预测)')
axes[0].set_xlabel('真实房价(万元)'); axes[0].set_ylabel('预测房价(万元)')
axes[0].set_title(f'LASSO(交叉验证选 α):测试集 R$^2$ = {r2:.3f}')
axes[0].legend()

# 右图:LASSO 系数收缩路径
alphas = np.logspace(-2, 1.5, 40)
coefs = np.array([Lasso(alpha=a, max_iter=100000).fit(X_tr34s, y_tr).coef_
                  for a in alphas])
axes[1].plot(alphas, coefs[:, 4:], color='lightgray', lw=0.8)   # 30条噪声
for j, c in zip(range(4), ['#4C72B0', '#55A868', '#C44E52', '#8172B2']):
    axes[1].plot(alphas, coefs[:, j], color=c, lw=2.2,
                 label=['面积', '房龄', '距地铁', '学区'][j])
axes[1].set_xscale('log')
axes[1].axvline(lascv.alpha_, color='k', ls=':', lw=1.2)
axes[1].text(lascv.alpha_ * 1.15, 55, f'CV最优 α={lascv.alpha_:.2f}', fontsize=9)
axes[1].set_xlabel('α(对数尺度)'); axes[1].set_ylabel('标准化系数')
axes[1].set_title('LASSO 系数收缩路径:灰线=噪声特征被压为 0')
axes[1].legend(loc='upper right', fontsize=9)

plt.tight_layout()
plt.savefig('linear_regression_result.png', dpi=150)
plt.show()
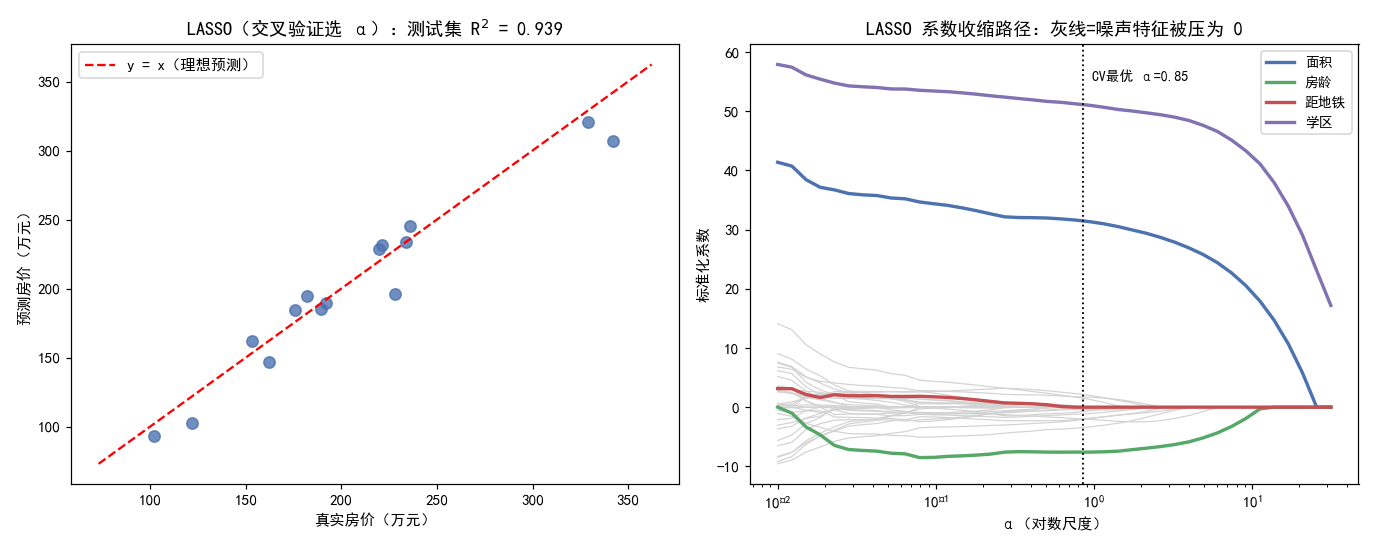
运行得到下图(左:测试集预测-真实散点;右:LASSO 收缩路径):
读图:
-
左图 :15 个测试样本的预测值紧贴 y = x y=x y=x 参考线,测试 R 2 = 0.939 R^2=0.939 R2=0.939------在 34 个特征(30 个是噪声)的恶劣环境下,LASSO 依然给出了可靠预测;
-
右图 (本篇的"封面级"图):横轴是 α \alpha α(从左到右惩罚越来越强)。灰色噪声线在 α \alpha α 很小时就上下乱窜(过拟合区的疯狂), α \alpha α 增大后陆续精确归零 ;四条彩色真实特征(面积、房龄、学区)坚持到最后才被压平,而弱效应的"距地铁"(红线)在中段就被归零------正是步骤 2 发现的"误杀"。黑色竖虚线是交叉验证选中的 α = 0.85 \alpha=0.85 α=0.85。这张图就是 LASSO 自动特征选择的全程录像。
七、模型评价、适用场景与常见问题
优点:
- 闭式解、计算快:正规方程一步到位,几十万样本也只是矩阵运算
- 可解释性强 : β j \beta_j βj 直接读作"控制其他特征后, x j x_j xj 每增 1 单位 y y y 平均变化多少"
- 理论根基深:高斯-马尔可夫定理保证(在假设成立时)OLS 是最优线性无偏估计
- 天然的基线模型:任何复杂模型(随机森林、神经网络)上马前,先跑一遍线性回归,超出它多少才有意义
- 正则化版本功能全 :共线性、 p > n p>n p>n、特征选择三个痛点各有一套解法
局限:
- 线性假设 :真实非线性关系只能靠人工特征变换( ln x \ln x lnx、 x 2 x^2 x2、交互项)缓解,或换非线性模型
- 对异常值敏感:平方放大离群残差,一个极端点能把整条线拽偏(可用 Huber 损失缓解)
- 多重共线性下系数不可靠 :高度相关的特征互相"抢功劳", β \beta β 方差膨胀、符号可能违背常识(诊断可用 VIF);岭回归可缓解但系数解释性随之下降
- 外推无效:只在数据覆盖的特征范围内可信,超出范围(如用 60~145㎡ 的数据预测 300㎡ 别墅)纯属冒险
- 不能直接做分类:输出连续值的框架不适用于"是否违约"类问题------那是下一篇逻辑回归的活
常见问题:
Q1: R 2 R^2 R2 高就代表模型好吗?
不是。本篇实验的 OLS(34特征) 训练 R 2 R^2 R2 名义上"完美",测试 R 2 R^2 R2 却是 −21。 R 2 R^2 R2 只在同分布的新数据上有意义,看模型好坏要盯测试集/交叉验证,并且同时看 RMSE 绝对量级。
Q2:岭回归和 LASSO 到底选哪个?
看你对特征结构的判断:多数特征都该有用 → Ridge;相信只有少数关键特征 → LASSO;两者兼有且怕 LASSO 误杀弱特征(如本文的距地铁)→ 弹性网(ElasticNet,L1+L2 混合,sklearn 一行切换)。拿不准就交叉验证现场比武。
Q3: λ \lambda λ 为什么不能用训练误差来选?
训练误差随 λ \lambda λ 单调上升, λ = 0 \lambda=0 λ=0 永远"最优",等于没正则化。 λ \lambda λ 衡量的是泛化表现,必须用交叉验证或独立验证集来评估------这是"训练误差骗人"的又一案例。
Q4:两个特征相关系数 0.95,能不能一起放进模型?
放进去能预测(预测精度不受共线性影响),但系数解释会失真 :模型不知道功劳该分给谁, β \beta β 可能一个巨大一个为负。如果目的只是预测、不解释系数,问题不大;如果要做因素分析,先删一个或用岭回归。
八、AI 视角:损失函数、梯度下降与过拟合------深度学习的原点
线性回归是"最简单"的模型,却埋着现代 AI 最核心的三条根。这篇的 AI 视角是全专栏最重要的一次伏笔收束前哨。
8.1 最小二乘 = MSE 损失函数
把 5.1 节的目标函数改写一下:
L ( β ) = 1 n ∑ i = 1 n ( y i − f ( x i ; β ) ) 2 L(\beta)=\frac{1}{n}\sum_{i=1}^{n}\left(y_i-f(x_i;\beta)\right)^2 L(β)=n1i=1∑n(yi−f(xi;β))2
这就是神经网络训练里人尽皆知的 MSE 损失函数 。所谓"训练模型",范式的本质就是"定义一个损失函数,找到让它最小的参数 "------高斯在 200 年前做最小二乘时,已经在用这个范式了。区别只是:他的 f f f 是线性函数,而深度学习的 f f f 是几十亿参数的嵌套函数。
8.2 正规方程 vs 梯度下降
5.2 节的闭式解 β ^ = ( X T X ) − 1 X T y \hat\beta=(X^TX)^{-1}X^Ty β^=(XTX)−1XTy 一步到位,但求逆的复杂度是 O ( p 3 ) O(p^3) O(p3)------ p p p 是 1 亿(大模型时代)时彻底不可行。AI 的替代方案是梯度下降:从随机初始点出发,沿负梯度方向小步迭代:
β ← β − η ⋅ ∇ L ( β ) \beta \leftarrow \beta - \eta\cdot\nabla L(\beta) β←β−η⋅∇L(β)
其中, η \eta η 是学习率。深度学习的一切训练(SGD、Momentum、Adam)都是这个式子的变体。为什么线性回归还能用闭式解、神经网络只能用梯度下降?因为后者损失面非凸,没有"一跳到谷底"的公式。 这也预告了算法库的"梯度下降"篇------那里我们会把 η \eta η、批量大小、收敛判据讲透。
8.3 L2 正则化 = 权重衰减(Weight Decay)
岭回归的 L2 惩罚,在深度学习里换了个名字:权重衰减(weight decay) 。对 L = L d a t a + λ ∥ β ∥ 2 L=L_{data}+\lambda\|\beta\|^2 L=Ldata+λ∥β∥2 求梯度,惩罚项贡献 2 λ β 2\lambda\beta 2λβ,代入更新式后每步迭代都相当于先把权重乘以 ( 1 − 小量 ) (1-\text{小量}) (1−小量) 再走一步------"衰减"之名由此而来。大模型训练用的 AdamW 优化器,其中的 W 就是 weight decay。同属正则化家族的还有 Dropout、早停(early stopping)、数据增强------思想完全一致:牺牲一点训练集上的完美,换取对新数据的稳健。本文 6.3 节亲手做的那次"偏差换方差",就是 GPT 训练时每一步都在发生的事。
8.4 回归系数 vs 熵权 vs SHAP:三种"重要性"的完整对照
前两篇埋的伏笔在这里合龙。三种给特征"打重要性"的方法,本质完全不同:
| 回归系数 β j \beta_j βj | 熵权 w j w_j wj(第 6 篇) | SHAP(第 5 篇预告) | |
|---|---|---|---|
| 度量什么 | 控制其他变量后 x j x_j xj 对 y y y 的条件效应 | x j x_j xj 在样本间的区分度 | 模型预测中 x j x_j xj 的边际贡献 |
| 是否用到 y y y | 用 | 不用 | 用(通过模型) |
| 接近的概念 | 因果效应(若无混杂) | 无监督统计量 | 归因解释 |
回归系数是最接近"因果语言"的传统工具("每多 1 ㎡ 贵 1.1 万"),熵权只是数据分布的属性(第 6 篇杭州案例已证明它不等于重要性),SHAP 则把条件贡献的思想推广到任意黑箱模型。做因素分析时用回归系数,做综合评价时用熵权+组合赋权,解释黑箱时用 SHAP------三件工具三种活,别混用。
8.5 线性回归 = 没有激活函数的神经网络
一个神经元的前向计算:
z = w 1 x 1 + w 2 x 2 + ⋯ + w p x p + b z=w_1x_1+w_2x_2+\cdots+w_px_p+b z=w1x1+w2x2+⋯+wpxp+b
与多元线性回归逐字相同 。区别仅在于:线性回归直接输出 z z z,神经元把 z z z 再喂给一个非线性激活函数 σ ( z ) \sigma(z) σ(z)。如果不加激活函数,叠多少层网络都等价于一个线性回归(线性变换的复合还是线性变换)------非线性激活是"深度"的全部理由。顺便预告:把激活函数换成 sigmoid,就是下一篇之后要讲的逻辑回归;把"线性层+激活"堆叠起来,就是后续 AI 子专栏的神经网络。你已经在最简单的模型里见到了它们的骨架。
九、小结
这一篇我们从"预测房价"出发,走完了现代机器学习的完整雏形:
- 最小二乘 :残差平方和最小化,一元有"协方差/方差"闭式解,多元有正规方程 β ^ = ( X T X ) − 1 X T y \hat\beta=(X^TX)^{-1}X^Ty β^=(XTX)−1XTy
- 拟合优度 : R 2 R^2 R2 看解释比例,RMSE 看绝对误差;训练集 R 2 R^2 R2 会作弊,要看测试集
- 过拟合 :特征逼近样本数时,训练误差→0 而测试误差爆炸(实验:训练 MSE 0.00、测试 MSE 90496、 R 2 = − 21 R^2=-21 R2=−21)
- 正则化 :Ridge(L2,收缩不剔除,处理共线性)与 LASSO(L1,精确归零,自动选特征),结构匹配决定选谁; λ \lambda λ 用交叉验证定
- Scaling 铁律:OLS 与量纲无关,正则化对量纲敏感------惩罚模型上马前必须标准化(米 vs 千米实验:系数符号都能被改反)
- AI 三条根:最小二乘=MSE 损失,闭式解→梯度下降,L2 正则=权重衰减------深度学习的训练范式在这里已经完整出现
下一篇进入优化类模型 的第一篇:线性规划------目标函数和约束都是线性时,如何用单纯形法在成千上万个可行解中精确找到最优解。从"拟合数据"到"在约束下做决策",建模的另一半版图即将展开(预测类的 ARIMA、灰色预测会在后续补齐)。
📌 本文是专栏「数学建模 × AI:从经典模型到智能方法」的第 8 篇文章。
- 上一篇回顾 :熵权法与TOPSIS:数据驱动的客观评价
- 下一篇预告 :下一篇线性规划与单纯形法:生产调度的最优解。
👉 点击订阅专栏,第一时间收到更新通知!
如果你在阅读过程中有任何疑问,欢迎在评论区留言交流。😊