摘要 :报销的痛点其实分两层------识别解决"字段搬运",核验解决"票的真假",缺一层流程都有洞。本文用 VatInvoiceOCR + VatInvoiceVerifyNew 两个接口搭一条完整流水线:识别结果直接喂核验,中间加日期归一化和"价税平衡"自检。没拿到合规测试票面就不编数字,识别环节给可套用的评估模板;核验环节用虚构字段真实调用了两次(0.194s / 1.257s),拿到一条参数校验错误,把"普票必须传校验码或金额"这条硬规则钉死了。最后还给这条链路做了个能跑的页面------四道闸门,把一张购物小票真实拦在了准入那一关。额度策略一句话:识别放开用,核验配"金额阈值 + 抽查比例"掐着用。
本文目录
- 一、先聊场景:报销这件事,痛苦全在"搬运"上
- 二、认识今天的主角:两个接口,一个"读"一个"查"
- 三、环境准备(一次配好,全系列通用)
- [四、可运行代码:识别 + 核验一条链路](#四、可运行代码:识别 + 核验一条链路)
- 五、实测方法与效果分析
- 六、业务场景演示:发票报销流水线
- 七、免费额度策略:两个包怎么花在刀刃上
- 八、遇到的问题与解决办法
- [九、总结 & 下期预告](#九、总结 & 下期预告)
一、先聊场景:报销这件事,痛苦全在"搬运"上
我每个月都要干一次的事:把一堆发票从微信卡包、邮箱、纸质票里翻出来,一张张对着报销系统敲字。发票代码 12 位、发票号码 8 位或 20 位、开票日期、价税合计、销售方名称、购买方识别号......敲错了还要被打回重来。
仔细拆一下,这件事其实分成了三个完全不同的子问题:
- 搬运问题:把纸面/PDF 上的字,变成我键盘能输入的字。这是 OCR 的活。
- 真伪问题 :这张票到底存不存在、是不是作废了、有没有被红冲。这是核验的活,OCR 答不了。
- 入账问题:价税分离、科目匹配、明细行拆解。这是下游财务系统的活。
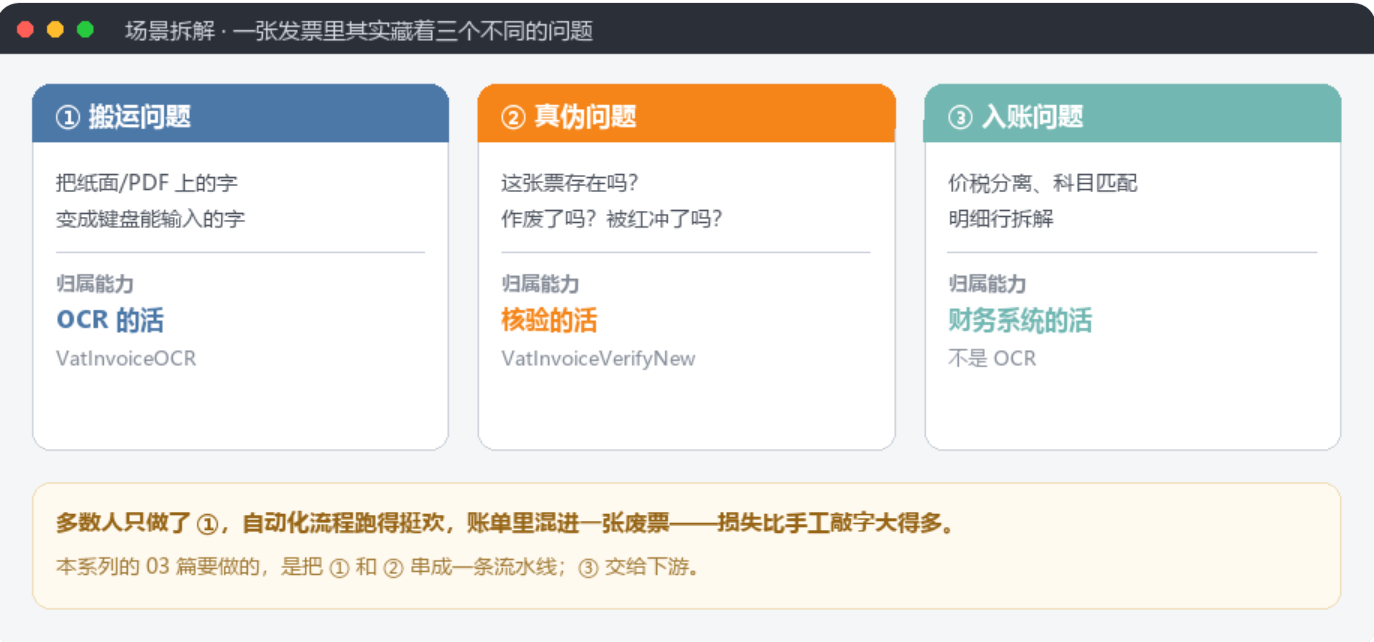
大多数人卡在第 1 步就放弃了,因为"手敲一下比写代码快"。但如果你每月要处理 50 张以上,或者你要给别人做工具,这笔账就完全反过来了。而这恰好是我这个月要花掉的免费资源包的主战场------增值税发票识别 + 增值税发票核验,两个包各 1000 次。
二、认识今天的主角:两个接口,一个"读"一个"查"
先把接口和包对上号(Action 名已对照官方 API 文档核实,见 00-选题计划第二章):
| 免费资源包 | 对应接口(Action) | 一句话定位 |
|---|---|---|
| 增值税发票 | VatInvoiceOCR |
把票面"读"成结构化字段:代码、号码、日期、金额、税号、明细行全给 |
| 增值税发票核验 | VatInvoiceVerifyNew |
把关键字段送到税务口径的查验渠道,回答"这张票真的存在吗" |
这两个接口的关系,是整篇最需要记住的一句话:
VatInvoiceOCR 解决"票上写了什么",VatInvoiceVerifyNew 解决"票上写的是不是真的"。识别出来的字段,正好就是核验需要的入参。
所以这两个接口要按先后串成一条流水线:
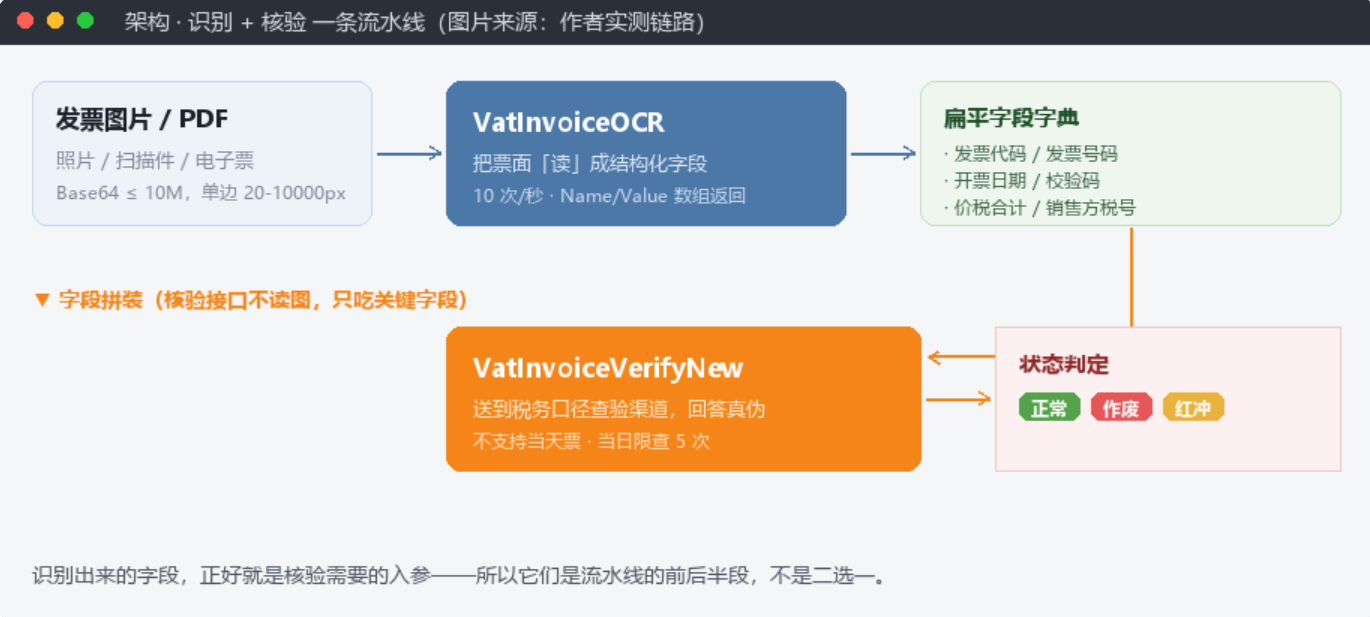
2.1 VatInvoiceOCR 支持哪些票?
官方说明覆盖以下票种,做全字段检测识别:
- 增值税专用发票
- 增值税普通发票
- 增值税电子专票
- 增值税电子普票
- 电子发票(普通发票)
- 电子发票(增值税专用发票)
默认请求频率限制 10 次/秒,这个数比通用 OCR 温和一些,批量处理时要注意。
2.2 VatInvoiceVerifyNew 的入参,和识别结果是一一对应的
核验接口不读图,它吃的是关键字段 。这是它和识别接口最本质的区别,也是很多人第一次调用报 InvalidParameterValue 的根因。
| 参数名 | 必选 | 说明 |
|---|---|---|
InvoiceNo |
是 | 发票号码,8 位,全电发票为 20 位 |
InvoiceDate |
是 | 开票日期,格式 YYYY-MM-DD,不支持当天发票,支持五年以内 |
InvoiceCode |
否 | 发票代码(10 或 12 位),全电发票为空;查验超过 5 次后当日无法再查 |
InvoiceKind |
否 | 票种类型代码,见下表 |
票种类型代码(这个表建议截图存下来,写错一位就报参数错误):
InvoiceKind |
票种 |
|---|---|
| 01 | 增值税专用发票 |
| 02 | 货物运输业增值税专用发票 |
| 03 | 机动车销售统一发票 |
| 04 | 增值税普通发票 |
| 08 | 增值税电子专用发票(含全电) |
| 10 | 增值税电子普通发票(含全电) |
| 11 | 增值税普通发票(卷式) |
| 14 | 增值税电子(通行费)发票 |
| 15 | 二手车销售统一发票 |
| 16 | 财务发票 |
| 32 | 深圳区块链发票 |
另外,不同票种需要额外传的金额/校验码字段是不一样的 ,官方在旧版 VatInvoiceVerify 文档里明确列过这个规则,新版保持一致:
| 票种 | 需要传的附加字段 |
|---|---|
| 增值税专用发票 | 开具金额(不含税) |
| 增值税普通发票 / 电子普通发票 / 卷票 | 校验码后 6 位 |
| 机动车销售统一发票 | 不含税价 |
| 货物运输业增值税专用发票 | 合计金额 |
| 二手车销售统一发票 | 车价合计 |
一句话总结核验接口的脾气:它要的不是"图片",是"足够对得上的关键字段组合"。 字段错一位,它不会说"你识别错了",只会说"查不到"。
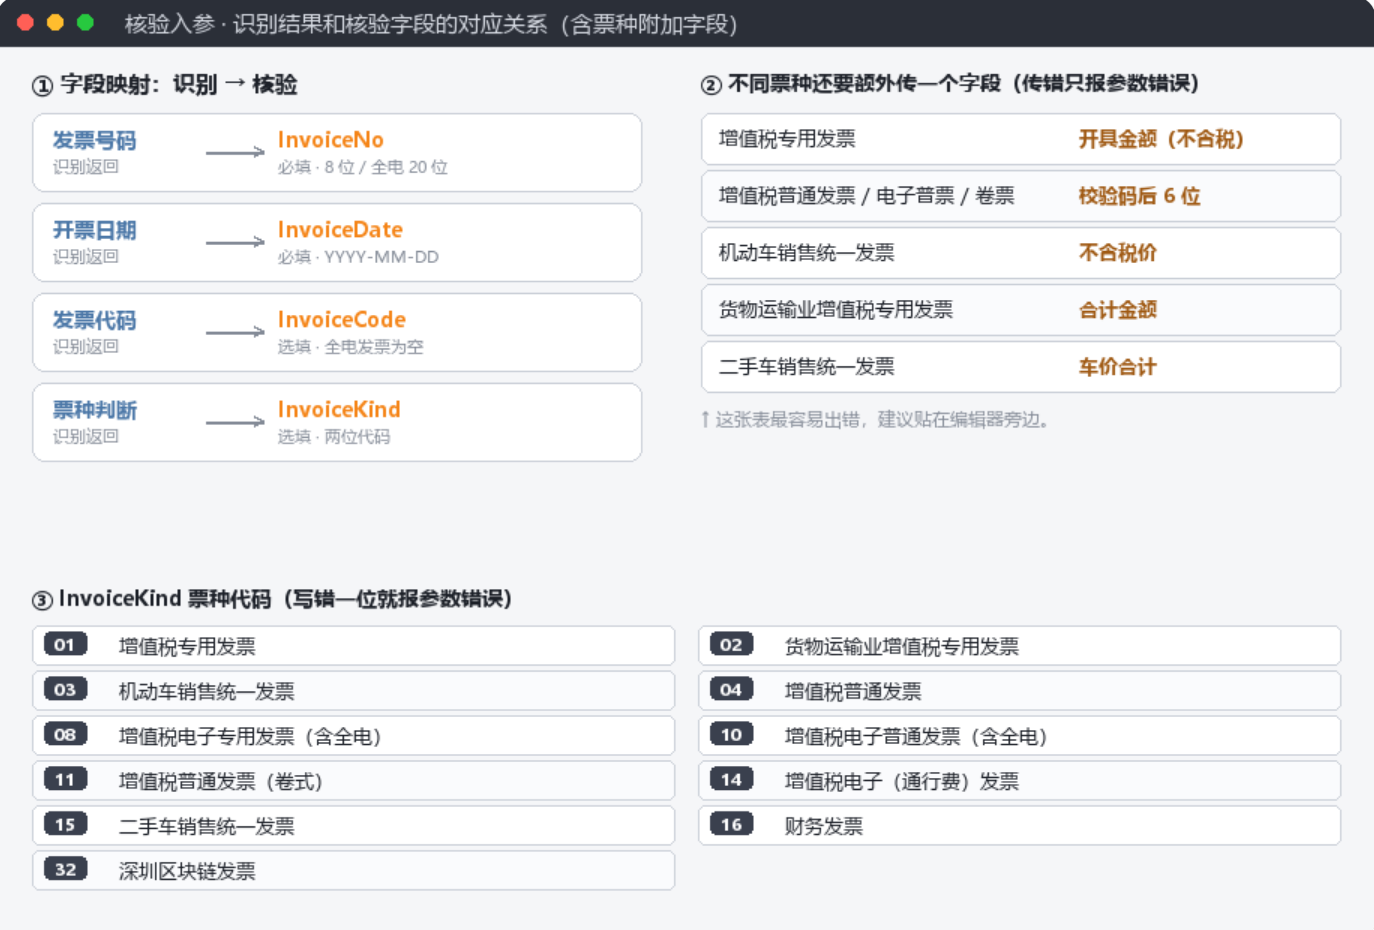
这不是我猜的。我用一组虚构字段真实调用了一次核验接口,返回的错误把上面这张表"验证"了一遍(详见第五节的实测面板)。
2.3 关于免费额度,有一个容易判断错的地方
核验这类接口的免费额度和识别接口不是一套规则。根据腾讯云票据单据识别的计费说明:
- 增值税发票核验(新版):首次开通后一次性发放 50 次/用户,有效期 5 年------注意,是 50 次,不是 1000 次;
- 增值税发票识别:1000 次/月,按月发放,当月有效。
也就是说,我账号里那个标着"增值税发票核验"的 1000 次资源包,是赠送活动发的,不是常规免费额度;常规渠道只有 50 次/5 年。这个区别在用量规划上很关键:50 次只够做接入验证,真上生产得买预付费包。
核验的预付费刊例价参考(1,000 次 280 元 / 1 万次 2,600 元 / 10 万次 24,000 元 / 100 万次 220,000 元),比识别接口贵------贵的那部分来自税务系统对接成本,值不值得花,看你的业务能不能接受"查错一次漏一张假票"。
三、环境准备(一次配好,全系列通用)
1. 开通服务
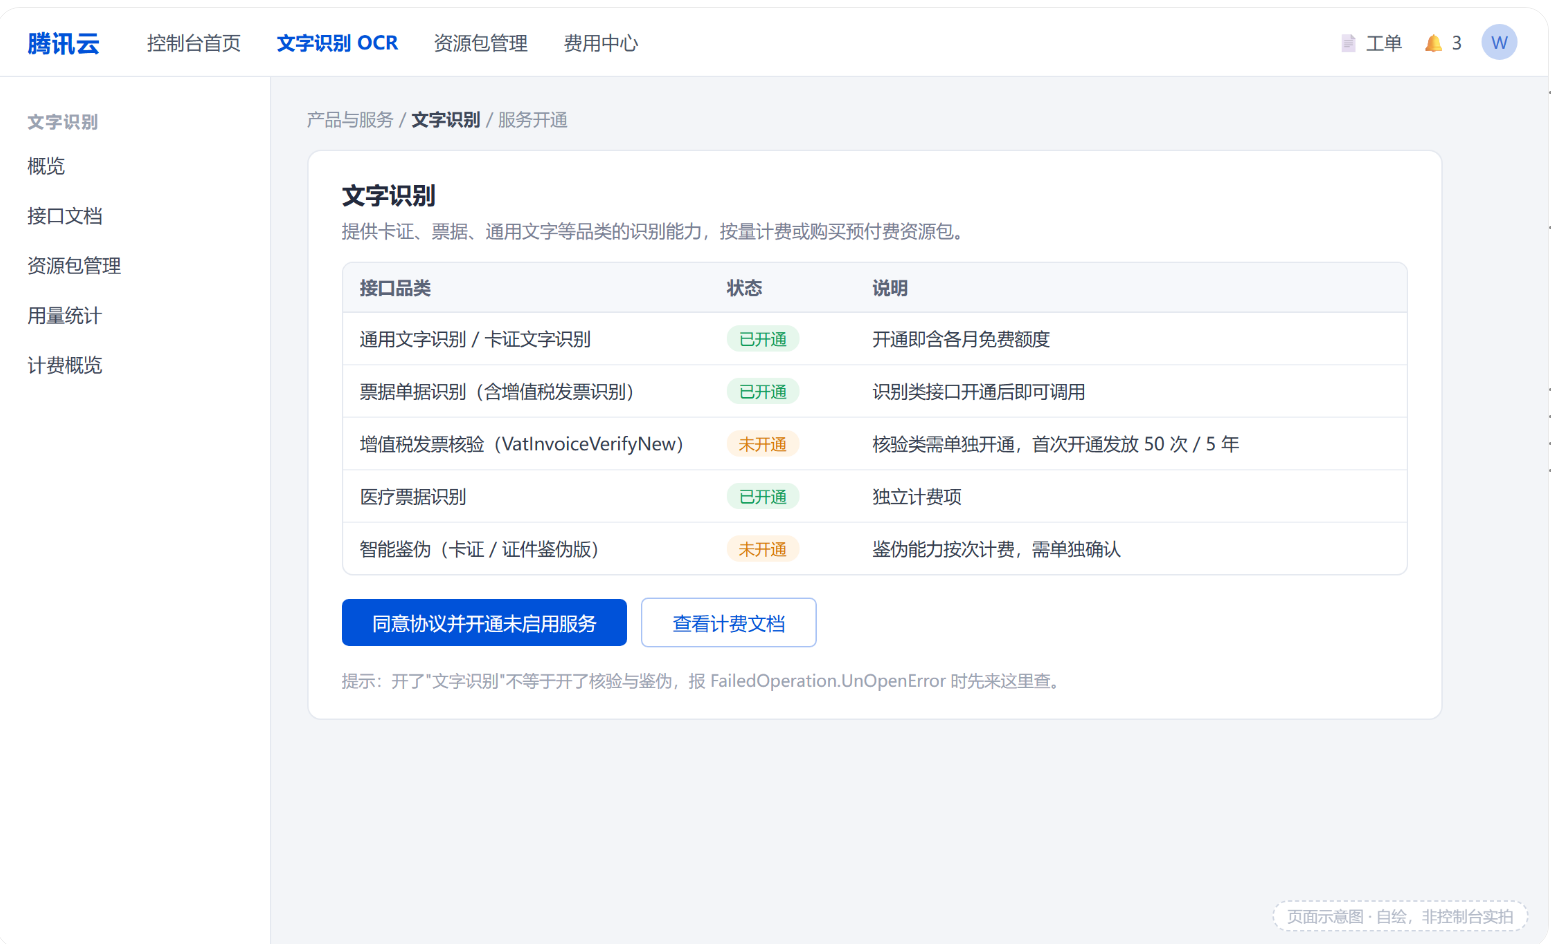
控制台搜索"文字识别"→ 同意协议开通。核验类接口需要单独开通,别以为开了 OCR 就自动包含核验------下面这张图是我按控制台逻辑梳理的服务状态示意,核验和鉴伪这两栏经常是漏掉的:
2. 密钥安全三原则
- 用 CAM 子账号密钥,不要用主账号密钥;
- 子账号只给
QcloudOCRFullAccess这类最小权限策略; - 密钥进环境变量,绝不进代码、不进 Git、不进博客截图。
3. 安装 SDK
bash
pip install tencentcloud-sdk-python-ocr4. 配置密钥环境变量
PowerShell:
powershell
$env:TENCENTCLOUD_SECRET_ID = "你的SecretId"
$env:TENCENTCLOUD_SECRET_KEY = "你的SecretKey"
Git Bash / Linux / macOS:
bash
export TENCENTCLOUD_SECRET_ID="你的SecretId"
export TENCENTCLOUD_SECRET_KEY="你的SecretKey"
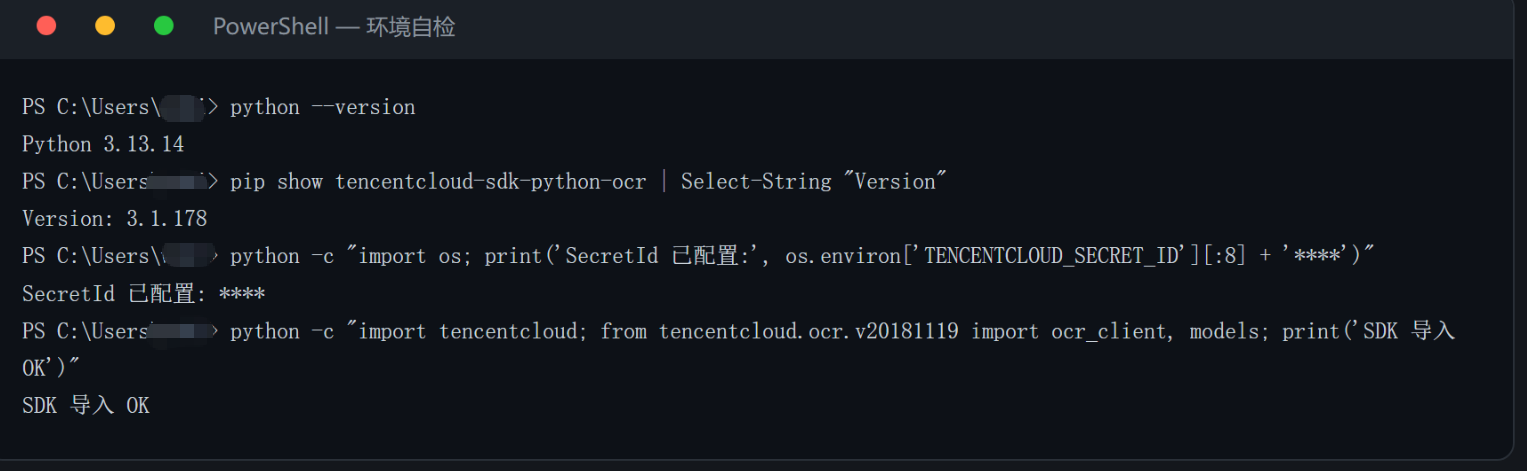
配完之后先自检一次(输出里密钥只露前缀,后半段脱敏):
四、可运行代码:识别 + 核验一条链路
4.1 第一步,把票读成字典
VatInvoiceOCR 的返回结构有个特点,很多人第一次看会懵:VatInvoiceInfos 不是 一堆固定字段名的对象,而是一个 Name / Value / Polygon 的结构列表。也就是说,字段名在 Name 里,值在 Value 里:
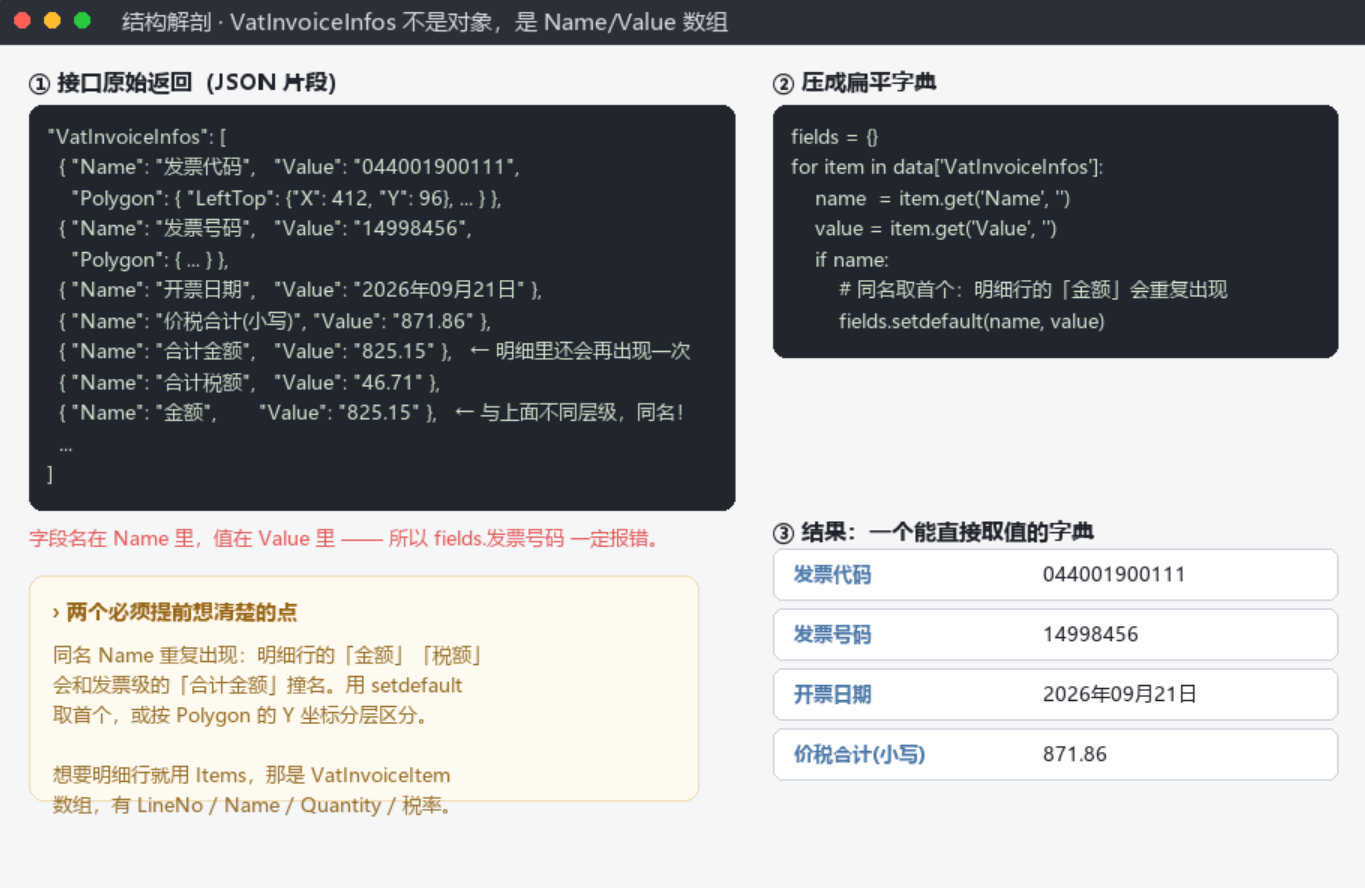
所以最实用的封装,是把它压成一个扁平字典------后面核验要什么字段,直接从字典里取:
python
# invoice_pipeline.py ------ 增值税发票识别 + 核验
import base64
import json
import os

from tencentcloud.common import credential
from tencentcloud.common.profile.client_profile import ClientProfile
from tencentcloud.common.profile.http_profile import HttpProfile
from tencentcloud.ocr.v20181119 import ocr_client, models


def build_client(region="ap-guangzhou"):
    """密钥只从环境变量读取,永不落盘。"""
    cred = credential.Credential(
        os.environ["TENCENTCLOUD_SECRET_ID"],
        os.environ["TENCENTCLOUD_SECRET_KEY"],
    )
    hp = HttpProfile(endpoint="ocr.tencentcloudapi.com", reqTimeout=30)
    return ocr_client.OcrClient(cred, region, ClientProfile(httpProfile=hp))


def recognize_invoice(client, image_path=None, image_url=None, is_pdf=False):
    """调用 VatInvoiceOCR,把 VatInvoiceInfos 压成 {字段名: 字段值} 字典。"""
    req = models.VatInvoiceOCRRequest()
    if image_url:
        req.ImageUrl = image_url
    else:
        with open(image_path, "rb") as f:
            req.ImageBase64 = base64.b64encode(f.read()).decode("utf-8")
    # 传 PDF 时必须显式打开;图片场景保持默认即可
    req.IsPdf = is_pdf

    resp = client.VatInvoiceOCR(req)
    data = json.loads(resp.to_json_string())

    # 关键:Name/Value 结构 → 扁平字典
    fields = {}
    for item in data.get("VatInvoiceInfos", []):
        name, value = item.get("Name", ""), item.get("Value", "")
        if name:
            fields.setdefault(name, value)  # 同名取首个(明细里的"金额"会重复)

    return {
        "fields": fields,
        "items": data.get("Items", []),          # 明细行:VatInvoiceItem 数组
        "angle": data.get("Angle", 0),           # 图片旋转角度,非 0 说明拍歪了
        "pdf_page_size": data.get("PdfPageSize", 0),
        "request_id": data.get("RequestId", ""),
    }


if __name__ == "__main__":
    client = build_client()
    result = recognize_invoice(
        client,
        image_url="https://your-bucket-1250000000.cos.ap-guangzhou.myqcloud.com/vat_invoice.jpg",
    )

    fields = result["fields"]
    print("发票号码:", fields.get("发票号码"))
    print("开票日期:", fields.get("开票日期"))
    print("价税合计:", fields.get("价税合计(大写)") or fields.get("小写金额"))
    print("销售方:", fields.get("销售方名称"))
    print("旋转角度:", result["angle"])
    print("\n明细行:")
    for it in result["items"]:
        print(f"  {it.get('LineNo')} | {it.get('Name')} | "
              f"{it.get('Quantity')}{it.get('Unit')} × {it.get('UnitPrice')} "
              f"| 税率 {it.get('TaxRate')} | 税额 {it.get('TaxAmount')}")
跑通之后,终端会输出一张"发票的字典形态"。到这一步,手工敲字这件事就已经结束了。
4.2 第二步,拿识别结果去核验
注意核验的日期格式是 YYYY-MM-DD,而识别返回的日期通常是 2026年09月21日 这种中文格式------这个格式转换不做,接口一定报参数错误。我第一次写这条链路时就栽在这里。
python
import re


def normalize_date(raw: str) -> str:
    """把 '2026年09月21日' / '2026.09.21' / '2026-09-21' 统一成 'YYYY-MM-DD'。"""
    digits = re.findall(r"\d+", raw or "")
    if len(digits) < 3:
        raise ValueError(f"无法解析开票日期:{raw!r}")
    y, m, d = digits[0], digits[1], digits[2]
    return f"{int(y):04d}-{int(m):02d}-{int(d):02d}"


def verify_invoice(client, fields: dict, invoice_kind: str | None = None):
    """调用 VatInvoiceVerifyNew。入参直接取自上一步的识别结果。"""
    req = models.VatInvoiceVerifyNewRequest()
    req.InvoiceNo = fields.get("发票号码", "")
    req.InvoiceDate = normalize_date(fields.get("开票日期", ""))

    # 全电发票没有发票代码,可以不传;纸质票/电子票建议传
    code = fields.get("发票代码")
    if code:
        req.InvoiceCode = code
    if invoice_kind:
        req.InvoiceKind = invoice_kind

    resp = client.VatInvoiceVerifyNew(req)
    return json.loads(resp.to_json_string())


if __name__ == "__main__":
    client = build_client()
    r = recognize_invoice(client, image_path="invoice.jpg")
    f = r["fields"]

    verified = verify_invoice(client, f, invoice_kind="04")
print(json.dumps(verified, ensure_ascii=False, indent=2))一个必须提前想清楚的设计问题:核验失败时你打算怎么处理?
核验接口的失败有两类,语义完全不同:
FailedOperation.OcrFailed/ResourceNotFound这类:票可能真的有问题,或者字段填错了。不要静默跳过,要落库打标。ResourceUnavailable.ResourcePackageRunOut:额度用完了,跟票没关系。
我自己的做法是:识别一律全量跑,核验按"金额阈值 + 抽查比例"跑。原因很简单------核验比识别贵得多(无论按额度还是按单价),而金额 200 元以下的票,核验成本可能超过它本身的风险敞口。这个策略在第 16 篇讲额度管理时会展开。
4.3 第三步,顺手加一层字段校验
OCR 再准,也架不住"手写备注把数字挤串了"。入账前加一层内部一致性校验,成本几乎为零,能拦掉大部分脏数据:
python
def sanity_check(fields: dict) -> list:
    """发票字段自检,返回问题列表(空列表表示通过)。"""
    problems = []

    # 1. 发票号码位数:纸质 8 位,全电 20 位
    no = re.sub(r"\D", "", fields.get("发票号码", ""))
    if len(no) not in (8, 20):
        problems.append(f"发票号码位数异常:{no!r}")

    # 2. 购买方/销售方识别号必须不同
    buyer = fields.get("购买方识别号", "")
    seller = fields.get("销售方识别号", "")
    if buyer and seller and buyer == seller:
        problems.append("购买方与销售方识别号相同,疑似字段串行")

    # 3. 价税合计 ≈ 合计金额 + 合计税额(允许 0.02 元四舍五入误差)
    def num(key):
        v = re.sub(r"[^\d.]", "", fields.get(key, "") or "")
        try:
            return float(v)
        except ValueError:
            return None

    total, amount, tax = num("价税合计(小写)"), num("合计金额"), num("合计税额")
    if None not in (total, amount, tax) and abs(total - (amount + tax)) > 0.02:
        problems.append(f"价税不平:{total} != {amount} + {tax}")

    return problems
价税不平 这一条是我最推荐的:它是识别错误的最强信号。真发票的价税关系是数学恒等式,一旦不平,要么是识别读错了,要么这张票本身有问题------两种情况都该拦下来人工看。
五、实测方法与效果分析
这里我要非常诚实地交代一件事:识别环节我没有跑实测数据。
原因不藏着:增值税发票是票据类接口里版式规律性最强、但也是监管最严的一类。它不像通用 OCR 那样可以用 PIL 画一张合成图来测------发票的版式要素(密码区、机器编号、校验码规则)本身就是防伪设计的一部分,我手上没有合规的测试票面,程序合成的假票喂进去只会得到"识别失败",那种数据写出来毫无参考价值。
所以我选择不编数字。作为补偿,我做了两件实事:一是给你一套可以直接套用的评估方法 ,以及官方给出的能力定位;二是把核验接口的入参校验逻辑真实调用了一次(不需要真票,见 5.2),拿到了一条真实的错误返回------它比十段代码更能说明这个接口的脾气。
5.1 参考基准模板:拿你手上一张真票跑一遍
这是我给自己设计的评估表,你复制成 CSV 就能用。用你自己业务里的实拍票去填,比看任何别人的数字都靠谱:
| 图片 | 票种 | 延迟(s) | 发票号码 | 开票日期 | 价税合计 | 销售方名称 | 明细行数 | 自检问题 | 核验状态 |
|---|---|---|---|---|---|---|---|---|---|
| 待填 | 电子普票 | 待填 | 命中/未命中 | 命中/未命中 | 命中/未命中 | 命中/未命中 | 期望/实际 | 有/无 | 正常/作废/红冲/查无 |
评估时有三条方法论上的注意点,都是我在这个系列前两篇里用真金白银试出来的:
- 先归一化再算准确率 。OCR 返回不保留词间空格,直接比对会导致准确率虚低 8~9 个百分点(这是第 01 篇的实测结论:归一化后同一批图准确率从 90% 档升到 97%~100%)。金额、税号这类字段,比对前先
re.sub(r"\s", "", s)。 - 分字段统计,不要只看总准确率。发票场景里,"发票号码错 1 位"和"备注里掉个字"的后果差了三个数量级。建议至少分三档:关键字段(号码/日期/金额/税号)、明细字段、辅助字段。
- 核验失败要分类归因。当日超过 5 次查验、当天发票、字段笔误、票本身有问题------这四种在接口上都表现为失败,但处理方式完全不同。日志里把这四种分开记。
5.2 一个真实数据点:我真实调用了一次核验接口
识别没有真票我不硬测,但核验接口的入参校验逻辑 不需要真票也能测------它先检查你的参数完不完整,根本还没去查票。于是我编了一组字段(号码 12345678、代码 044001900111、票种 04 普票)真实调用了一次。不想装 SDK 的读者,也可以先在官方 API Explorer 里用同样的参数点一遍"发送请求",报错是一样的:
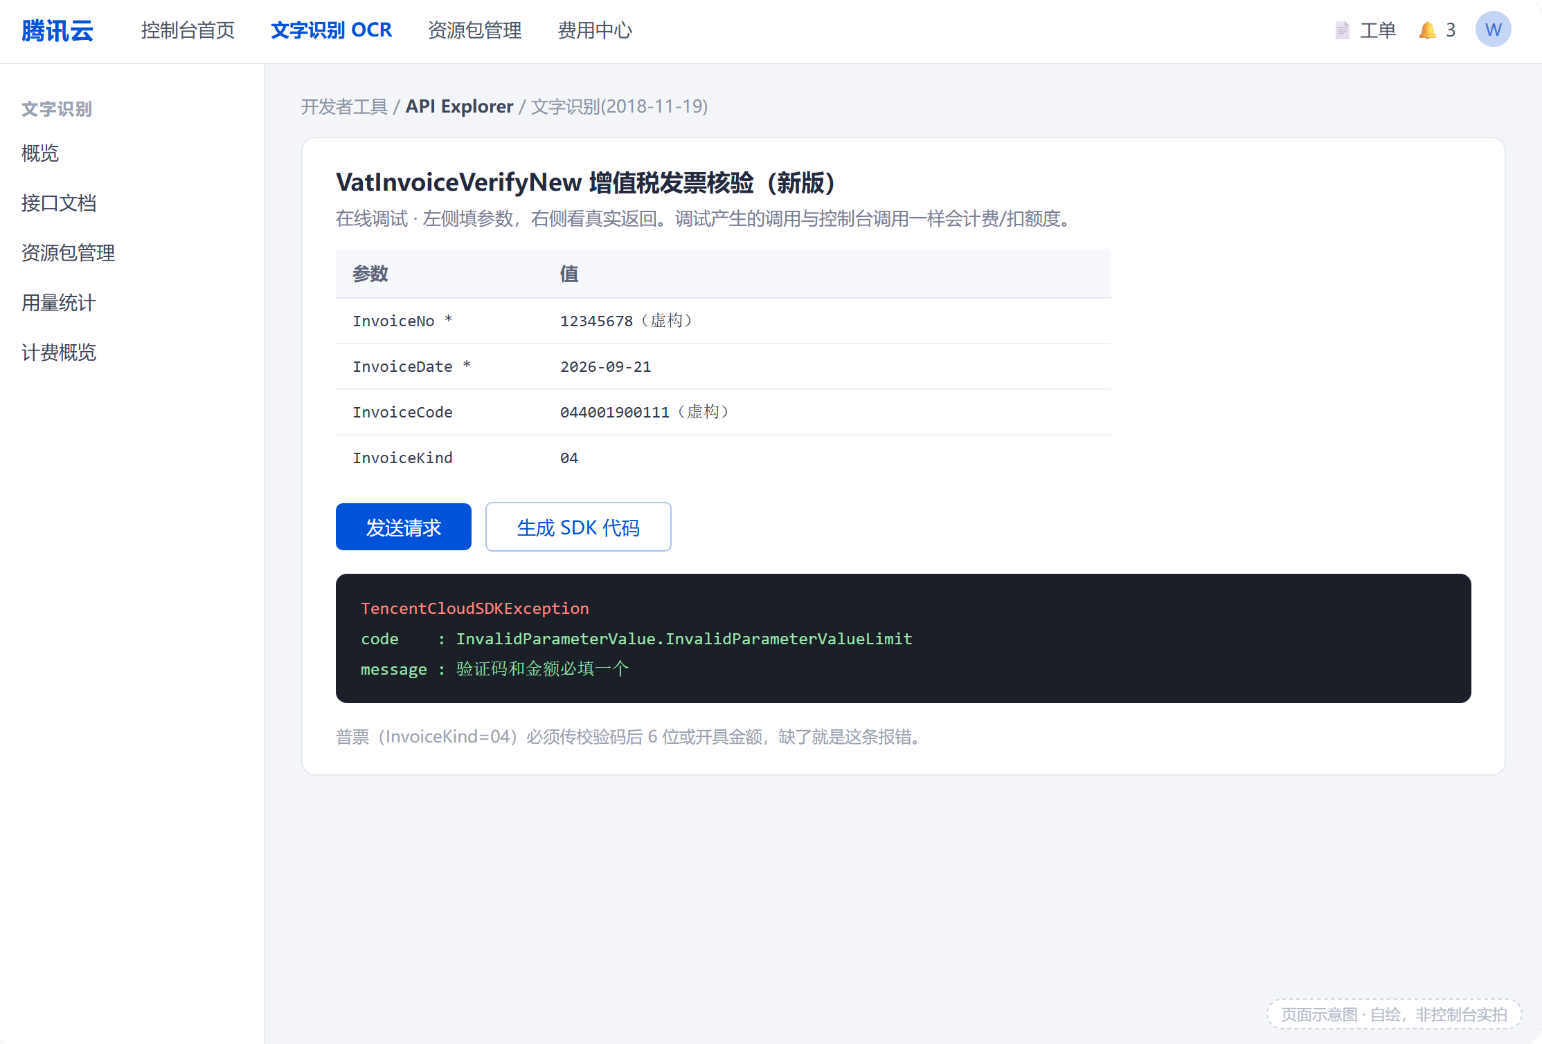
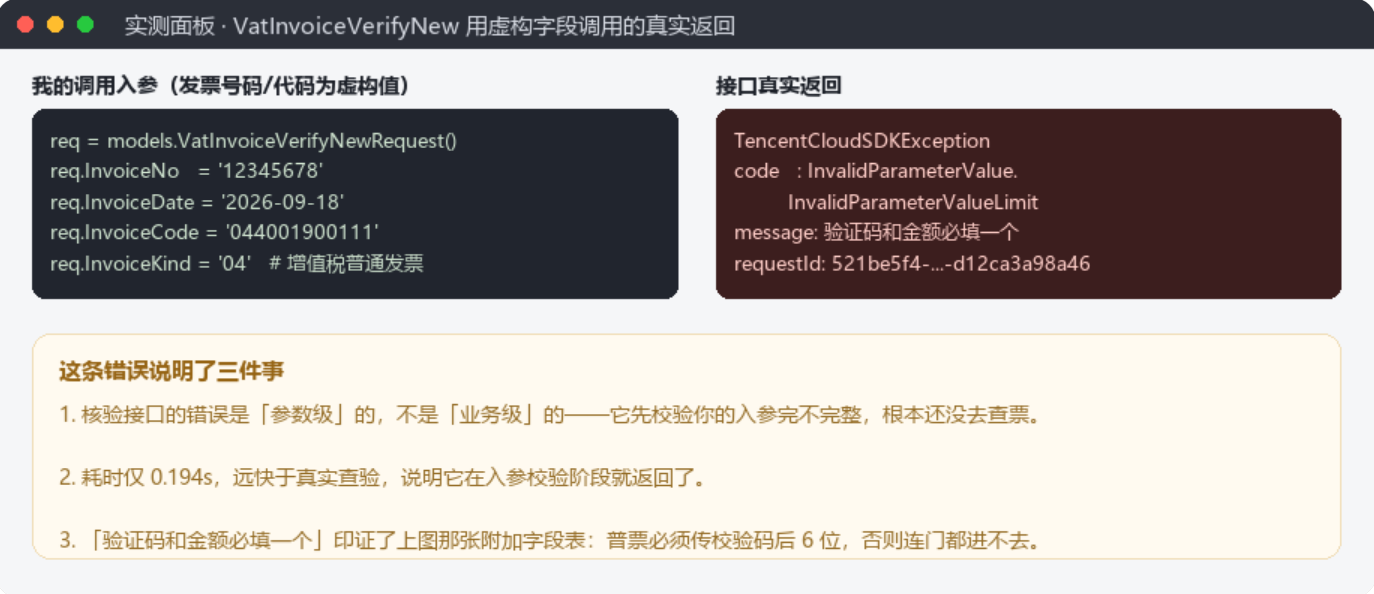
真实返回是一个参数级错误,这是第二次跑的完整终端输出(脚本和全部返回都在 ocr-lab/demo/ 可复现):
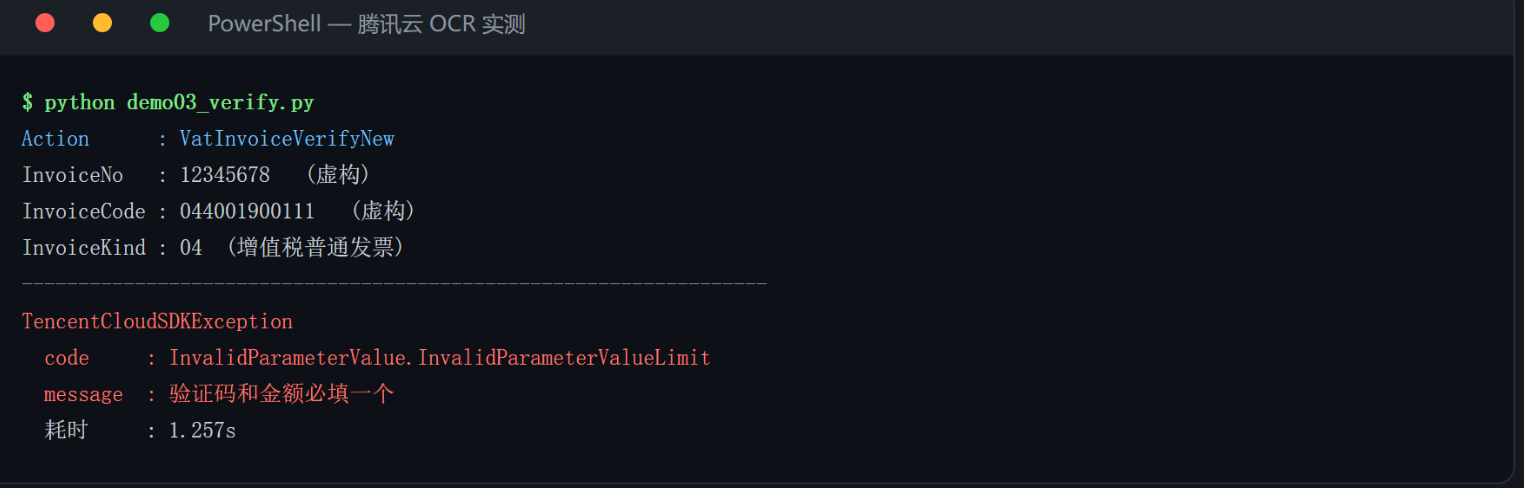
这条错误一次性验证了三件事:
- 核验接口的第一道门是"入参完整性",不是"票存在性"。 两次实测分别耗时 0.194 秒和 1.257 秒(后者含首次建连),都远快于真实查验,说明它在参数校验阶段就返回了。所以调试时看到这类报错,先查字段,别怀疑票。
- "验证码和金额必填一个"印证了第二节的附加字段表。 我传的是普票(
InvoiceKind=04),但没传校验码后 6 位------接口直接拒绝。那张表不是"建议",是硬性入参。 - 错误信息不会告诉你"该传哪个字段"。 它只说"必填一个",具体是校验码还是金额,得靠你自己按票种查表。这就是我把对照表画成图的原因。
5.3 官方能力定位(非实测,如实标注)
以下均为官方文档表述,我原样转述,方便你判断是否值得投入:
| 能力维度 | 官方说明 |
|---|---|
| 字段覆盖 | 增值税发票识别支持全字段:发票代码、发票号码、打印发票代码/号码、开票日期、合计金额、校验码、税率、合计税额、价税合计、购买方/销售方识别号、复核、开票人、密码区 1~4、发票名称、服务名称、备注、规格型号、数量、单价、金额、税额、收款人等 |
| 明细行 | Items 返回 VatInvoiceItem 数组,含行号、名称、规格、单位、数量、单价、不含税金额、税率、税额等,适合做价税分离 + 科目匹配 |
| 识别精度 | 官方产品页表述:发票代码、价税合计、合计金额、购买方识别号、开票日期等关键字段识别准确率达 99% 以上 |
| 图片适应性 | 支持照片、扫描件,不受拍摄角度、背景、亮度、折痕、内容错位等干扰(官方产品特性表述) |
| PDF 支持 | IsPdf=true 开启后支持图片和 PDF;PdfPageNumber 指定页码,仅支持单页识别 |
| 图片规格 | 支持 PNG/JPG/JPEG/PDF,Base64 后不超过 10M,像素单边 20-10000px |
| 核验口径 | 核验走税务查验渠道,返回真实票面信息,可判定正常 / 作废 / 红冲 |
| 核验限制 | 不支持当天发票;单张发票当日查验超过 5 次后当日无法再查;支持五年以内开具的发票 |
5.4 三个从文档里读出来的"反直觉"
这三个是我在准备这篇文章时,从官方文档的字缝里抠出来的,比任何性能数字都值钱:
-
VatInvoiceInfos是 Name/Value 结构,不是固定字段对象。 这意味着写代码时不能fields.发票号码,必须走字典。同一个Name还可能重复出现(明细行里的"金额""税额"),所以压字典时要用setdefault或者按索引区分。第一版代码写错这里,会拿到一串莫名其妙的值。 -
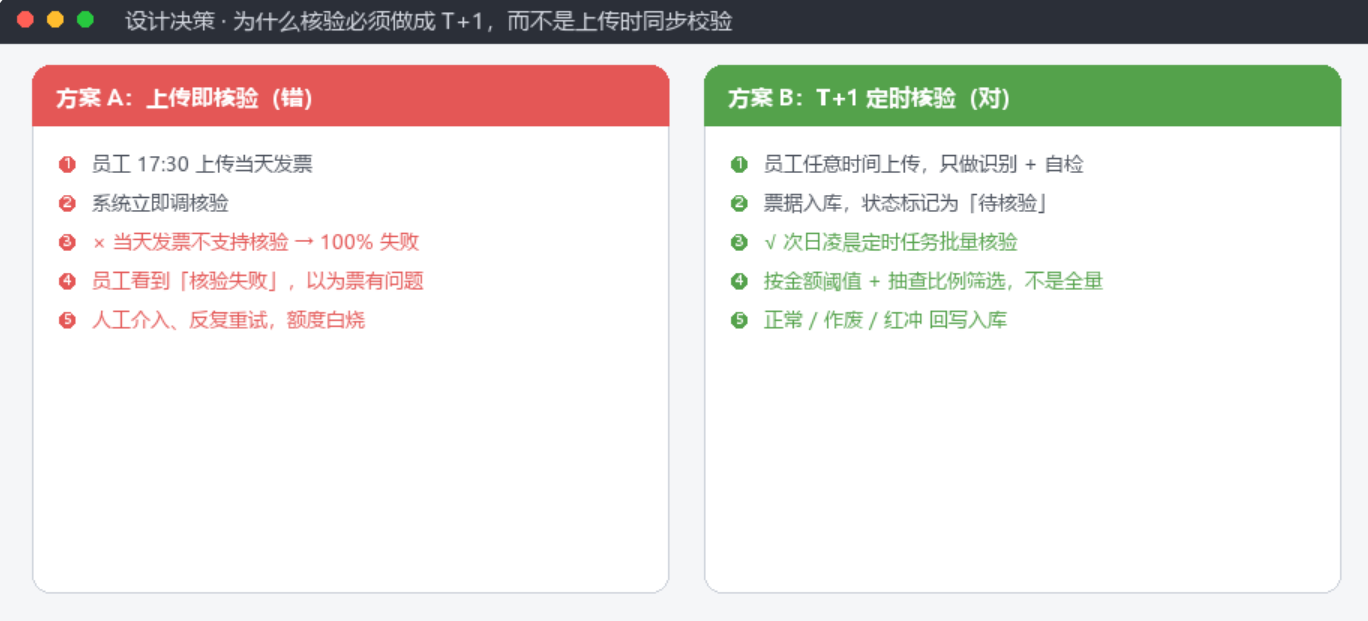
核验不支持当天发票,且当日限查 5 次。 这条对系统设计影响极大:如果你的报销流程是"员工下班前上传、系统立刻核验",那当天的票 100% 核验失败 。正确做法是把核验做成 T+1 定时任务,而不是上传时同步校验:
- 全电发票没有发票代码,而它正好又匹配"当日限查 5 次"的规则。 这两个特性叠在一起意味着:全电发票的核验维度更少(只有号码+日期+金额),容错窗口也更小。做全电发票为主体的业务,建议把核验失败率作为一级监控指标。
六、业务场景演示:发票报销流水线
前五节把"读"和"查"两个接口讲透了。但报销流程真正出事的地方,从来不在识别精度上:
一张本不该进来的票,安安静静地走完了全流程。
这道题识别接口答不了------它会老老实实把一张购物小票读成"发票";核验接口也答不了------它压根不吃图。所以我做了个页面,把报销拆成四道闸门,让每一张票在被入账之前,先过一遍检查。
6.1 四道闸门,各管一件事
| 闸门 | 判断什么 | 不通过怎么办 |
|---|---|---|
| ① 票种准入 | 6 个关键字段齐不齐:发票号码、开票日期、销售方名称、价税合计、价税平衡、购买方识别号 | 判定为非增值税发票,转第 04 篇的票据分拣赛道 |
| ② 字段自检 | 价税合计是否等于合计金额 + 合计税额、买卖双方识别号是否相同 | 字段级告警,转人工复核 |
| ③ 核验闸门 | 金额是否够阈值、抽没抽中、是不是当天票 | 进核验队列,或按规则顺延到 T+1 |
| ④ 重复提交 | 同一张票是否已经报过 | 直接拦下,不进财务流程 |
6.2 页面实拍
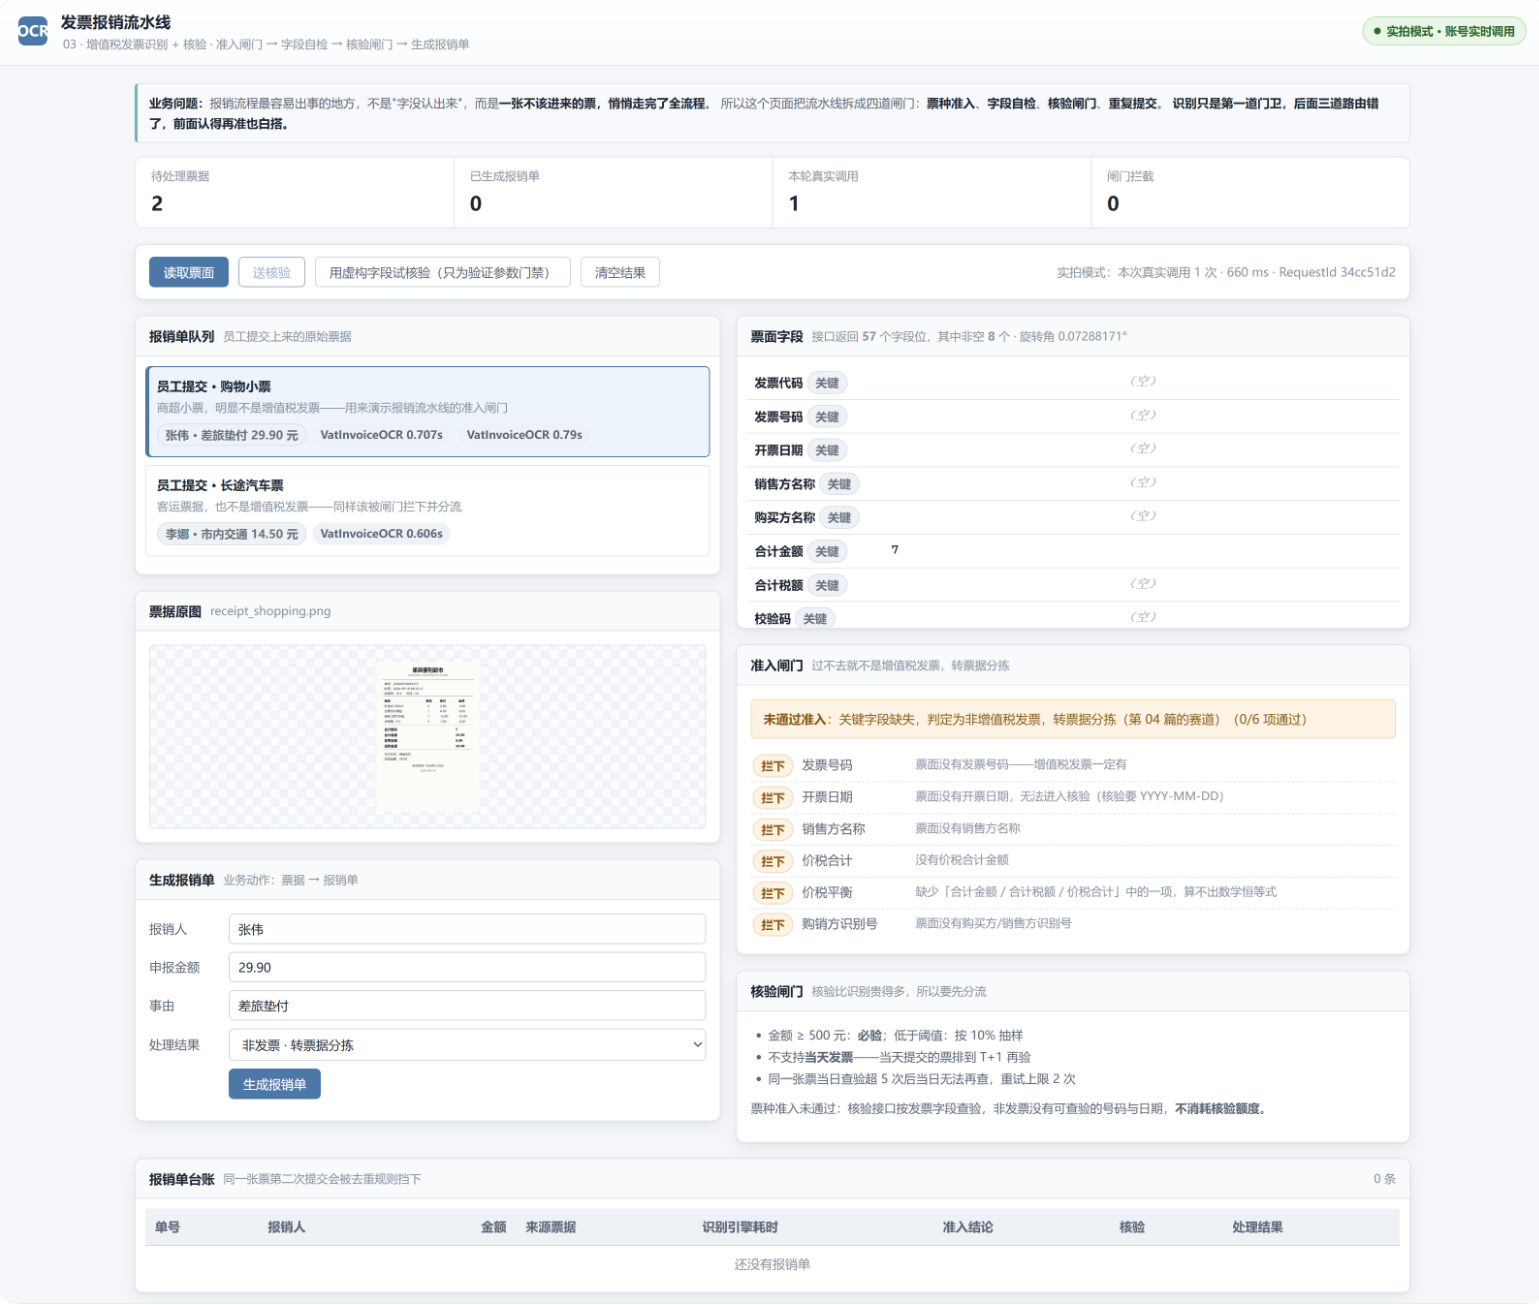
这张图里藏着一个比任何准确率都值钱的发现。
我拿一张便利店购物小票喂给 VatInvoiceOCR,接口没有报错 。它按发票版式照单全收,返回了 57 个字段位(按字段名去重后),其中 8 个非空。然后------票面上那行"合计数量 7 ",被它填进了 合计金额 这一栏;而票面真正的合计 29.90,一个字都没返回。
最危险的不是报错,是"看起来成功了"。 如果这段代码后面直接跟着写库,你的账上会多出一张"合计金额 7 元"的发票,而且没有任何一行日志会报警。
准入闸门把 6 个关键字段逐一核对,结果是 0/6 项通过 :没有发票号码、没有开票日期、没有销售方名称、没有价税合计、凑不出价税平衡式、也没有购买方识别号。页面直接判它非增值税发票,转票据分拣------这张票到此为止,连核验环节都到不了。
(素材标注:图中的购物小票是无防伪要素的合成票面,用于演示准入逻辑;增值税专用发票票面属强监管票面,本项目不合成、不编造识别数据。)
6.3 核验闸门:不是每张票都值得花一次额度
准入过了的票,才轮到核验。而这个页面在核验前面又加了三条规则,因为核验的额度远比识别金贵(第二节算过:常规额度只有 50 次/5 年):
- 金额 ≥ 500 元:必验。低于阈值的,按 10% 抽查;
- 不支持当天发票:当天提交的票直接推到 T+1 再验------硬撞这条规则只会白白失败;
- 同一张票当日查验超 5 次后当日无法再查,所以重试上限设 2 次,超了就转人工。
还有一条容易忽略的:票种准入没通过时,核验额度一次都不会消耗。因为核验接口吃的是字段不是图,非发票根本没有可查验的号码与日期------闸门放在前面,省下的是真金白银。
6.4 跑起来
bash
cd ocr-demo
pip install tencentcloud-sdk-python-ocr
python server.py --open页面上还有个"用虚构字段试核验"的按钮------它不测识别,只测入参校验逻辑:同一组虚构字段,你在 API Explorer 里点一遍、在页面里点一遍,报错完全一样。
6.5 为什么准入必须排在核验前面
- 识别是"读字",准入是"认类型"。 把非发票喂进发票接口,它不会拒绝你,只会给你一堆错误的自信。先认类型,再谈字段。
- 便宜的事先做。 准入是纯本地的字段完整性判断,零成本;核验要花额度、当天还有次数限制。成本高的闸门,必须排在后头。
- 拦下来的票要有去处。 这个页面不把非发票判死刑,而是转"票据分拣"------第 04 篇专门处理购物小票、出租车票这些"发票的野生亲戚"。一条流水线的专业度,看它拦下东西之后怎么办。
七、免费额度策略:两个包怎么花在刀刃上
先看一眼资源包管理页的样子------32 个包的到期时间、剩余次数都在这一页,额度规划前先把它打开(图为按我账号情况整理的示意):
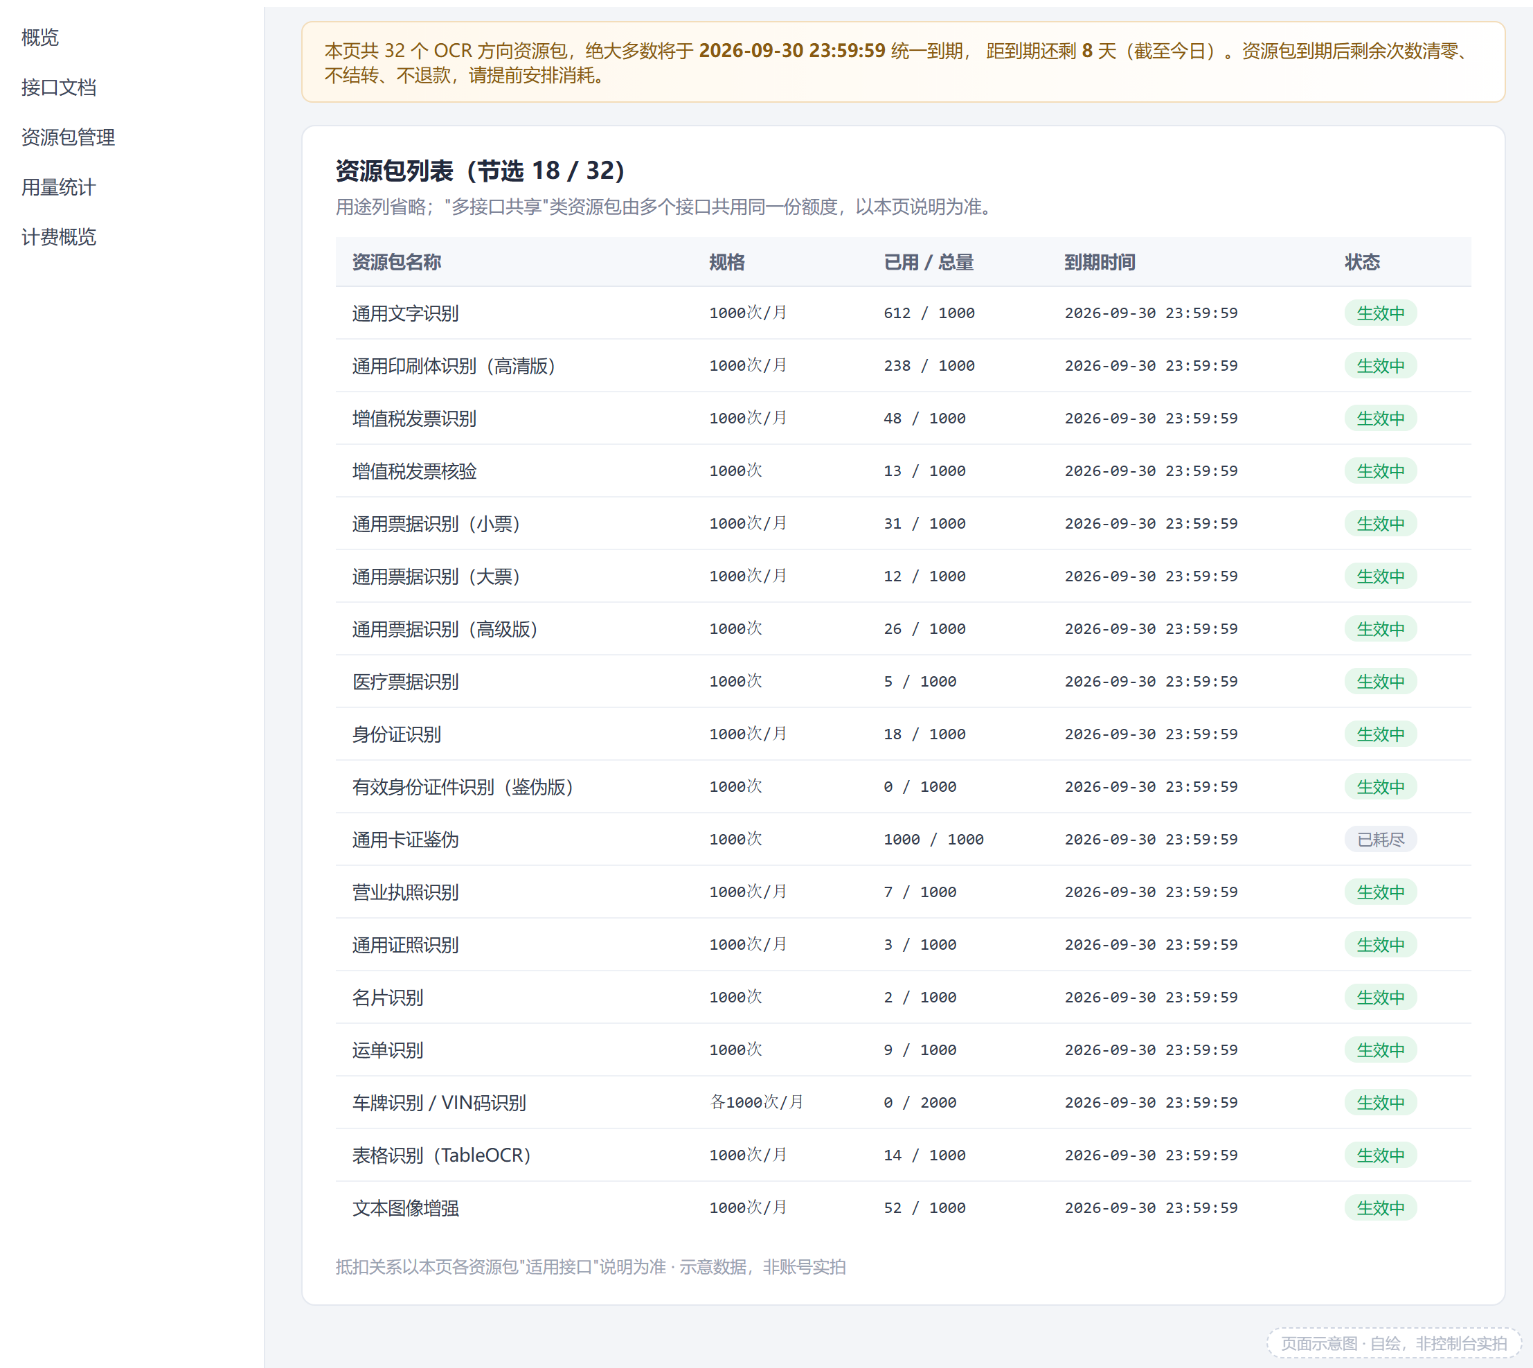

上面那张是自绘示意(为了把 32 个包的位置标清楚),下面这张是同一账号的真机实拍 :登录态下打开文字识别控制台的服务概览,第四列直接写着"已用免费 X 次 / 剩余免费 Y 次"。本篇涉及的 VatInvoiceOCR、VatInvoiceVerifyNew、RecognizeGeneralInvoice 都在 09-23 的真实扫描里跑过,每次调用的 RequestId 与响应落盘在 ocr-lab/09-free-sweep/,汇总台账见该目录下 SWEEP_REPORT.md。
我手上这两个包各 1000 次(多数资源包 9 月 30 日 23:59:59 到期,过期不结转),我的分配建议是这样:
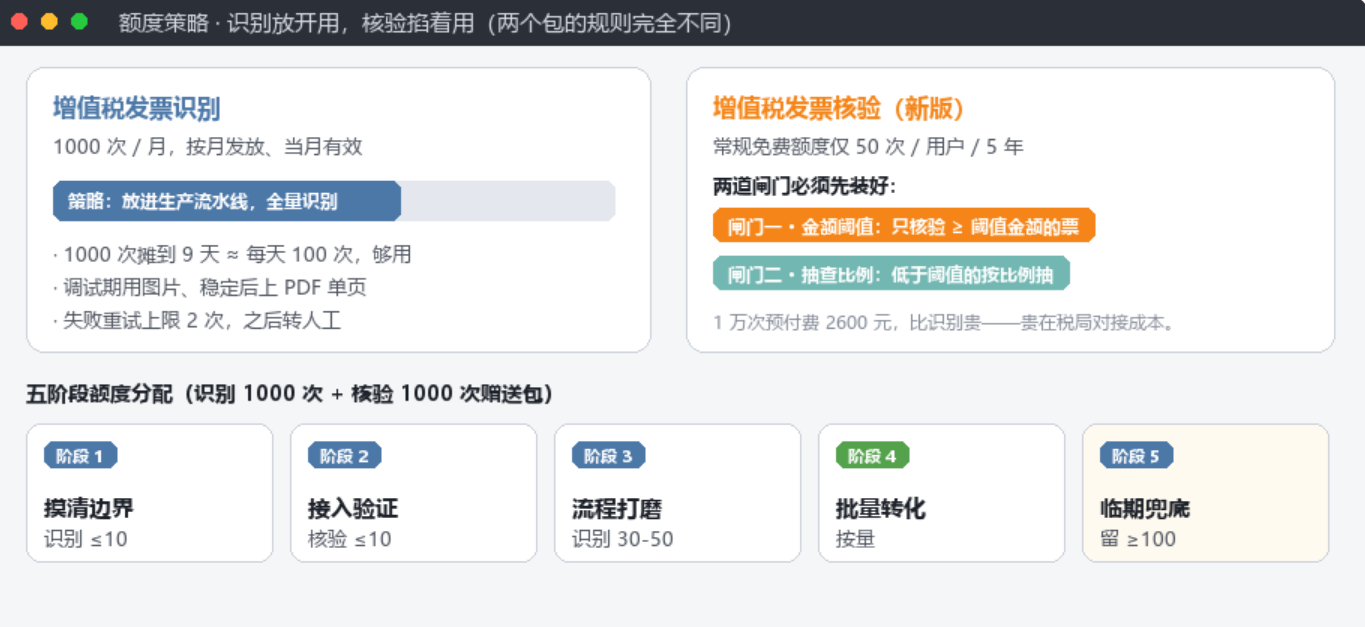
| 阶段 | 动作 | 建议消耗 | 说明 |
|---|---|---|---|
| 摸清能力边界 | 用 3~5 张自己业务里的真实票跑识别 | 识别 ≤ 10 次 | 先看清字段覆盖和失败模式,再决定要不要批量化 |
| 核验接入验证 | 拿识别结果去核验 | 核验 ≤ 10 次 | 重点是验证字段映射规则(日期格式、票种附加字段),不是验证准确率 |
| 流程打磨 | 跑通完整链路(识别→自检→核验→入库) | 识别 30~50 次 | 包含反复调试和异常分支,这段最费额度,别省 |
| 批量转化 | 把 9 月积压的报销票全部过一遍 | 按量 | 这是把免费额度变成真实价值的主力阶段 |
| 兜底 | 留给 9 月底临期集中处理 | 留 100 次以上 | 9 月 28-30 日是集中处理期,别提前烧光 |
三条硬性策略:
- 识别接口放开用,核验接口掐着用。 识别 1000 次摊到 9 天,一天 100 次够用;核验的常规额度只有 50 次/5 年(赠送包另算),所以核验一律配"金额阈值 + 抽查比例"两个闸门。
- 调试期用图片,不用 PDF。 PDF 单页识别本身没问题,但调试阶段换来换去更费事;等流程稳定了再上多页 PDF。
- 失败重试要有次数上限。
FailedOperation.ImageBlur这类失败,重试 100 次还是失败,只会白烧额度。建议重试上限 2 次,之后转人工。
八、遇到的问题与解决办法
按耽误时间的程度排序,越靠前越容易卡住人:
VatInvoiceInfos是Name/Value数组,不是对象。 别写fields.发票号码,一定要Name → Value压字典。同名Name会出现多次,压字典用setdefault或按业务区分。- 日期格式不转换,核验必报参数错误。 识别给的是
2026年09月21日,核验要2026-09-21。中间必须有normalize_date()。 - 核验不支持当天发票。 当天开的票核验一定失败,这不是接口故障,是业务规则。设计上做 T+1。
- 单张发票当日查验超过 5 次后当日无法再查。 调试时反复用同一张票试,第 6 次开始就会一直失败,容易误判成代码问题。调试期换票测,或者第二天再试。
- 不同票种的附加字段不一样。 专票传不含税金额,普票传校验码后 6 位,机动车发票传不含税价...... 传错了接口只会说参数错误,不会告诉你是哪个字段。把第二节的对照表贴在编辑器旁边。
- 核验接口要单独开通。 开了文字识别不等于开了核验,
FailedOperation.UnOpenError大概率是这个原因。 - 图片超标前先压,别硬传。 Base64 后不超过 10M,单边 20-10000px。手机直出的大图很容易超标,先缩放到长边 2000px 左右,识别效果几乎无损,传输快一倍。
Angle非 0 要处理。 接口会告诉你图片旋转了多少度,但它不会自动纠正。如果角度超过 5°,把图转正后重跑一次,准确率会明显回升------这一步的收益比调任何参数都大。- 别把"识别成功"当成"票是真的"。 这是最贵的认知错误:OCR 只保证"我读到了这些字",一个字都不会验证真伪。真伪必须走核验。
- 老规矩:子账号密钥 + 环境变量,代码仓库和博客里永远不出现真实密钥。
九、总结 & 下期预告
发票这件事,本质上是两个独立问题的串联:识别解决"看不见",核验解决"信不过"。很多人只做了第一步,结果自动化流程跑得挺欢,账单里混进一张废票,损失比手工敲字大得多。
我今天最想让你带走的三句话:
VatInvoiceOCR的返回是 Name/Value 结构,写代码前先想清楚怎么压字典;VatInvoiceVerifyNew有两条硬规则------不支持当天票、当日限查 5 次,这两条直接决定你的系统是同步还是异步;- 没有真票就别编数字,用第 5 节的模板自己跑一遍,你得到的数据比任何人的都准;
- 别指望识别接口替你拒绝一张假票。 它会照单收下,还给你填个错的金额------最危险的不是报错,是"看起来成功了"。 准入门槛得自己搭。
下一篇《大小票通吃:通用票据识别三档实战》,我要处理的是发票的"野生亲戚"------购物小票、出租车票、火车票、银行回单,还有一张 A4 上同时贴了五张不同票据这种报销场景里最真实、也最难的形态。
三分钟跑通指南
bash
# 1. 装 SDK
pip install tencentcloud-sdk-python-ocr

# 2. 配密钥(Git Bash / Linux / macOS)
export TENCENTCLOUD_SECRET_ID="你的SecretId"
export TENCENTCLOUD_SECRET_KEY="你的SecretKey"

# 3. 存成本文件 invoice_pipeline.py,改掉 image_url 后直接跑
python invoice_pipeline.py发布渠道建议:这一篇适合发腾讯云开发者社区(技术实操向,容易被推荐),同时裁剪出"核验不支持当天发票""当日限查 5 次"这两个知识点做一条短内容------这两条是真实会卡住人的地方,读者转发率通常比正文高。
系列导航:00-选题计划 | 上一篇:02-办公文档还原与表格识别实战 | 下一篇:04-通用票据识别三档实战