《Agentic Design Patterns》第 17 章导读:推理技术
本文是对开源书籍《Agentic Design Patterns》第 17 章的解读与导读,内容忠实呈现原文,并附个人思考。
原书在线阅读:https://adp.xindoo.xyz/ | 翻译项目代码仓库:https://github.com/xindoo/agentic-design-patterns
前面我们聊了规划、多智能体协作、记忆管理、学习适应......这些都是智能体的"外在能力"。但支撑这些能力的底层引擎是什么?答案是:推理(Reasoning)。
第 17 章深入探讨智能体的高级推理方法,重点是多步骤逻辑推理和复杂问题解决。这些技术让智能体的内部思考过程变得透明可见------它不再是一个"黑盒",而是能把复杂问题拆成小问题、走一步想一步、甚至自己纠正自己。
本章内容非常丰富,我们逐一来看。
一、为什么需要高级推理?
先想一个问题:为什么 ChatGPT 刚出来时大家觉得"哇好厉害",但用久了又发现"经常一本正经地胡说八道"?
原因很简单:单次前向传播(one-pass)的生成方式,对付简单问题绰绰有余,但遇到需要多步逻辑、需要计算、需要查证的复杂问题时,就力不从心了。
高级推理技术的核心原则是:在推理过程中分配更多的计算资源。不是用更大的模型,而是给模型更多的"思考时间"或"推理步骤"------让它迭代改进、探索多种方案、利用外部工具。
这就像人做数学题:你扫一眼直接报答案,和你打草稿、一步步算、算完再检查,正确率完全不在一个档次。
实际应用场景包括:
- 复杂问答:需要整合多源数据、进行多跳逻辑推理
- 数学问题解决:分解问题、逐步求解、用代码精确计算
- 代码调试和生成:解释理由、识别问题、迭代改进(自我纠正)
- 战略规划:推理选项和后果、根据反馈调整策略
- 医疗诊断:评估症状和病史、阐明推理过程、检索外部数据
- 法律分析:分析文件和先例、构建论点、确保逻辑一致
二、核心推理技术全景
书中介绍了 7 种核心推理技术,我们逐一拆解。
1. 思维链(Chain-of-Thought, CoT)
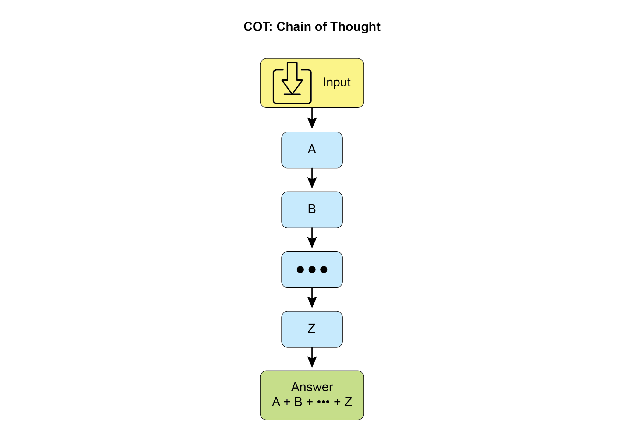
CoT 是最基础也是最重要的推理技术。它的思路很简单:不要让模型直接给答案,而是引导它生成一系列中间推理步骤。
就像老师教学生做数学题------"你先说说你是怎么想的?第一步是什么?第二步呢?"把复杂问题拆成一系列小步骤,每一步都想清楚了,最终答案自然就出来了。
CoT 的实现方式有两种:
- 少样本示例:给几个展示逐步推理的例子
- 零样本触发:简单地加上一句"请逐步思考"(Let's think step by step)
CoT 的价值不止于提高准确率,更重要的是透明性------你能看到模型的推理过程,方便调试和审计。这对于自主智能体来说至关重要。
2. 思维树(Tree-of-Thought, ToT)
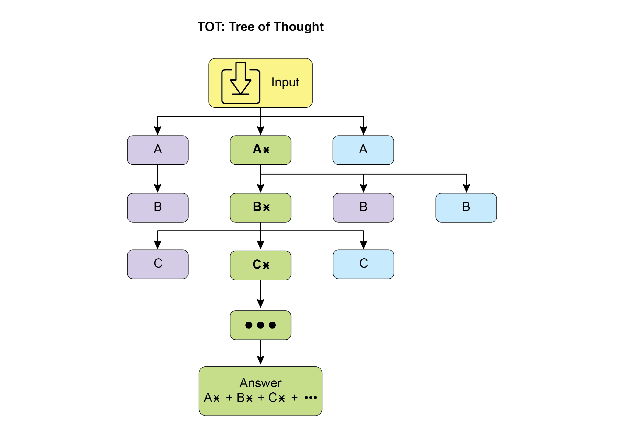
CoT 是线性的,一条路走到黑。但很多复杂问题需要探索多个方向 ,走不通了还得回溯。
思维树(ToT)就是解决这个问题的:它允许 LLM 分支到不同的中间步骤,形成树状结构。每条路径是一个可能的解法,模型可以评估各条路径的质量,选择最优的那条。
这就像下象棋:你不会只看一步,而是会想"如果我走马,对方可能走炮;如果我走车,对方可能......",评估多个变化后选择最优策略。
3. 自我纠正(Self-Correction)
自我纠正,也叫自我精炼,是智能体推理过程的关键一环。它涉及智能体对自己生成的内容和中间思考过程进行内部评估------哪里有歧义?哪里信息不足?哪里不准确?
通过"审查→改进"的迭代循环,智能体可以调整方法、提升响应质量、确保准确性和完整性。
书中给了一个很形象的例子:让 AI 写一篇社交媒体帖子,初稿可能很平庸,但经过自我纠正------检查是否有吸引力、是否突出了环保卖点、号召性用语够不够有力------最终产出会好很多。
4. 程序辅助语言模型(PALMs)
PALM 的思路是:LLM 擅长理解和生成,但不擅长精确计算;程序擅长精确计算,但不理解自然语言。把它们结合起来,强强联合。
具体来说,PALM 让 LLM 生成代码(比如 Python),然后执行代码,再把结果转换成自然语言。这样,复杂的计算、逻辑操作、数据处理就交给确定性的编程环境来做,LLM 专注于它擅长的理解和生成。
书中给了一个 Google ADK 的例子,用专门的 CodeAgent 配合 BuiltInCodeExecutor 来处理代码执行任务:
python
from google.adk.agents import Agent
from google.adk.tools import google_search
from google.adk.code_executors import BuiltInCodeExecutor

coding_agent = Agent(
    model='gemini-2.0-flash',
    name='CodeAgent',
    instruction="您是代码执行专家",
    code_executor=[BuiltInCodeExecutor],
)
5. 可验证奖励强化学习(RLVR)
标准的 CoT 提示词是一种相对基础的推理方法------它生成单一的、预定的思路,无法适应问题的复杂性。
为了突破这个限制,业界开发了一类专门的"推理模型"(比如 OpenAI 的 o1、DeepMind 的 AlphaGeometry)。这些模型在给出答案之前,会花费可变量的"思考"时间,生成长达数千 token 的推理轨迹。
训练这些推理模型的关键创新就是 RLVR(Reinforcement Learning with Verifiable Rewards):在有已知正确答案的问题上(比如数学、代码)训练模型,让它通过试错学习生成有效的长篇推理。不需要人类监督,模型自己就能知道推理对不对------因为答案是可验证的。
6. ReAct(推理与行动)
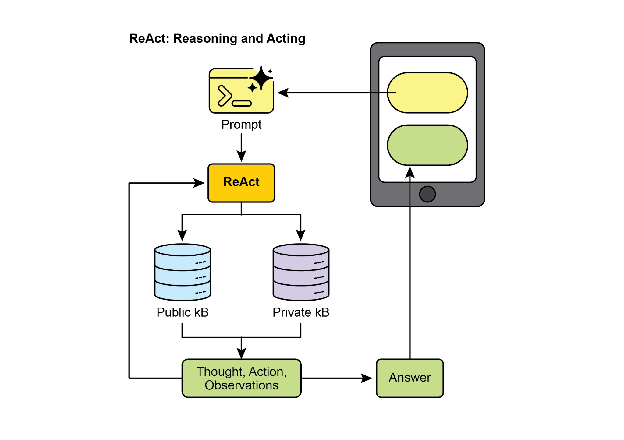
ReAct 是把 CoT 和工具使用 结合起来的范式。它的核心循环是:思考 → 行动 → 观察 → 思考 → ......
- 思考(Thought):像 CoT 一样,智能体先推理下一步该做什么
- 行动(Action):调用工具或执行操作(查数据库、算计算、调 API)
- 观察(Observation):从环境中获得反馈
这个循环不断重复,直到达到目标。和线性 CoT 相比,ReAct 强大得多------因为智能体能够响应实时反馈,动态调整计划。
这也是我们之前讲的"工具使用模式"的底层逻辑------智能体不是瞎调用工具,而是先想清楚为什么要调用、期望得到什么结果,然后再行动。
7. 辩论链(CoD)与辩论图(GoD)
辩论链(Chain of Debates) 是微软提出的框架:多个不同的模型协作和争论来解决问题。就像一个 AI 委员会------不同模型提出初步想法,批评彼此的推理,交换反驳论点。最终目标是通过集体智慧提高准确性、减少偏见。
辩论图(Graph of Debates, GoD) 是更高级的版本:它把讨论重新构想为动态的、非线性的网络。论点是节点,"支持"或"反驳"等关系是边,反映真实辩论的多线程性质。结论不是在序列末尾达成,而是通过识别整个图中最稳健、得到最好支持的论点集群来达成。
"得到良好支持"包括三个来源:
- 基本事实(本质正确、广泛接受)
- 搜索验证的事实证据(针对外部来源验证)
- 多模型共识(多个模型一致同意)
三、MASS:多智能体系统搜索框架
多智能体系统的设计空间非常庞大------每个智能体的提示词怎么写?智能体之间怎么交互?用什么拓扑结构?手动调优几乎不可能。
MASS(Multi-Agent System Search)框架就是用来自动化和优化多智能体系统设计的。它采用三阶段优化策略:
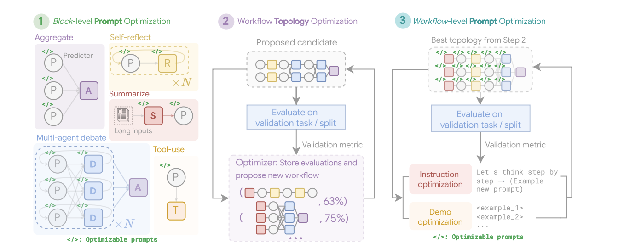
阶段 1:块级提示词优化
先单独优化每个智能体的提示词,确保每个组件在集成之前就能有效执行其角色。比如"辩论者"智能体的提示词被优化为"主要出版物的专家事实核查员"。
阶段 2:工作流拓扑优化
从可自定义的设计空间中选择和安排不同的智能体交互。采用"影响加权"方法------测量每个拓扑相对于基线的性能增益,用这些分数引导搜索朝向更有前途的组合。
阶段 3:工作流级提示词优化
找到最佳拓扑后,对整个系统的提示词做全局微调,确保智能体之间的相互依赖性被优化。
研究得出的三个关键设计原则:
- 在组合智能体之前,先用高质量提示词优化各个智能体
- 通过组合有影响力的拓扑来构建多智能体系统,而不是漫无目的地搜索
- 通过最终的工作流级联合优化来建模和优化智能体的相互依赖性
四、深度研究与推理扩展定律
Deep Research(深度研究)
"Deep Research" 描述了一类 AI 智能体工具------它们充当不知疲倦、有条不紊的研究助手。代表平台包括 Perplexity AI、Google Gemini 研究能力、OpenAI ChatGPT 高级功能。
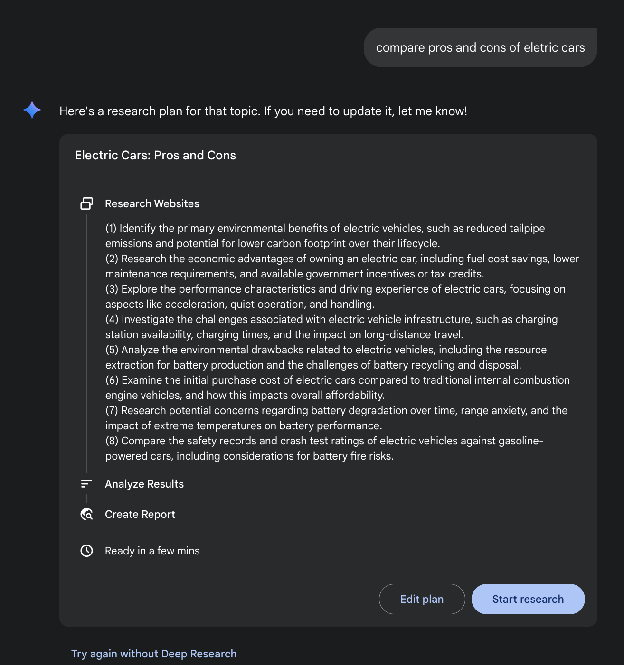
和标准搜索的区别:标准搜索给你即时链接,综合工作留给你自己。Deep Research 则是你给它一个复杂查询和一个"时间预算"(通常几分钟),它会自主执行一系列复杂步骤:
- 初始探索:根据查询运行多个有针对性的搜索
- 推理和改进:分析结果、综合发现、识别差距和矛盾
- 后续查询:基于内部推理,进行更细致的搜索来填补空白
- 最终综合:经过几轮迭代后,编译成连贯的结构化报告
推理扩展定律
这是一个非常重要的原则:LLM 的性能可预测地随着推理阶段分配的计算资源的增加而提高。
注意,这和"训练扩展定律"不一样------训练扩展定律说的是模型质量随训练数据和计算力增加而提高;推理扩展定律说的是在推理时多花计算资源,也能提高性能。
更有意思的是:给小模型更多的推理时间,有时候能超越用简单方法的大模型。 比如,让一个 7B 模型生成 10 个候选答案然后选最好的,可能比让一个 70B 模型直接给一个答案效果更好。
这对智能体部署的意义很大------它挑战了"越大越好"的直觉。你需要平衡三个因素:
- 模型大小:小模型内存和存储要求低
- 响应延迟:更多推理时间可能增加延迟
- 运营成本:大模型持续运营成本更高
理解推理扩展定律,可以帮你做出更经济、更高效的智能体设计决策。
五、实践:用 LangGraph 构建 DeepSearch
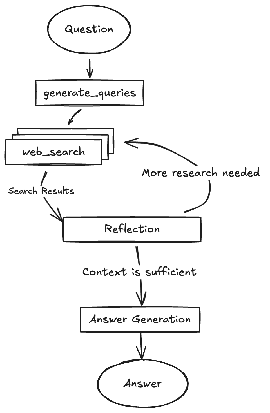
书中给了一个基于 Gemini 2.5 和 LangGraph 的 DeepSearch 实现示例。核心是一个状态图(StateGraph),包含四个节点:
python
builder = StateGraph(OverallState, config_schema=Configuration)

## 定义节点
builder.add_node("generate_query", generate_query)
builder.add_node("web_research", web_research)
builder.add_node("reflection", reflection)
builder.add_node("finalize_answer", finalize_answer)

## 入口点
builder.add_edge(START, "generate_query")

## 生成查询后进行网络研究
builder.add_conditional_edges(
    "generate_query", continue_to_web_research, ["web_research"]
)

## 网络研究后进行反思
builder.add_edge("web_research", "reflection")

## 反思后评估:继续研究 or 输出答案
builder.add_conditional_edges(
    "reflection", evaluate_research, ["web_research", "finalize_answer"]
)

builder.add_edge("finalize_answer", END)
graph = builder.compile(name="pro-search-agent")
整个流程是:生成查询 → 网络研究 → 反思 → 评估(知识缺口是否已填补?)→ 不够就继续研究,够了就输出最终答案。
这就是一个典型的 ReAct 循环的工程化实现。
六、速览:推理设计模式
| 维度 | 说明 |
|---|---|
| 问题背景 | 复杂问题解决需要多步逻辑推理和战略规划,单轮生成难以应对 |
| 解决方案 | 一套结构化推理技术:CoT、ToT、自我纠正、ReAct、PALM 等,让智能体的思考过程透明可审计 |
| 实践建议 | 当问题过于复杂、需要分解/多步逻辑/外部工具交互/战略规划时使用 |
七、关键要点总结
- 推理透明化:通过使推理明确,智能体可以制定透明的多步骤计划,这是自主行动和用户信任的基础
- ReAct 是核心循环:思考→行动→观察的循环,让智能体超越单纯推理,能够动态适应环境
- 推理扩展定律:性能不只关乎模型大小,更关乎分配的"思考时间"------更多计算 = 更审慎 = 更高质量
- CoT 是基础:思维链作为智能体的内部独白,提供了将复杂目标分解为可管理行动的结构化方法
- ToT 和自我纠正:赋予智能体审议能力------评估多个策略、从错误中回溯、在执行前改进计划
- 协作推理:CoD/GoD 等框架标志着从单独智能体到多智能体系统的转变,团队共同推理以减少个体偏见
- Deep Research 是集大成者:展示了推理技术如何在智能体中达到高潮------完全自主地执行复杂的长期任务
- MASS 自动化优化:自动优化智能体的指令和交互方式,确保整个多智能体系统最优执行
我的思考
推理技术是智能体 AI 的"内功"。没有好的推理能力,规划、协作、工具使用都是空中楼阁。
这一章让我印象最深的是推理扩展定律------它打破了"模型越大越好"的迷思。很多时候,给模型更多的思考时间、更好的推理策略,比盲目上大模型更划算。这对于实际工程部署非常有指导意义。
另外,从 CoT 到 ToT 到 ReAct 到 CoD/GoD,我们能看到一条清晰的演进路径:从线性思考 → 树状探索 → 结合行动 → 群体辩论。推理的复杂度在不断提升,解决问题的能力也在不断增强。
下一章我们将聊第 19 章------评估和监控。智能体推理再强,如果不知道它表现好不好、有没有跑偏,也不敢在生产环境用。敬请关注!