目录
[一、LSTM 解决什么问题?](#一、LSTM 解决什么问题?)
[二、LSTM 的结构与原理](#二、LSTM 的结构与原理)
[三、LSTM API 介绍](#三、LSTM API 介绍)
[五、LSTM 优点与缺点](#五、LSTM 优点与缺点)
摘要
基础 RNN 在处理长句子时,随着序列不断向后递推,早期的信息会慢慢丢失,发生梯度消失,无法记住远距离上下文。GRU 通过双门机制改善了这个问题,而 LSTM(Long Short-Term Memory,长短期记忆网络)进一步优化记忆保存机制,新增细胞状态专门用来长期存储信息,对长序列信息的保留能力更强。
LSTM 同样沿用 RNN 逐时间步读取序列、参数共享的基础框架,依靠三组门控,精细控制信息流入、流出细胞状态,解决长文本信息遗忘的问题。
**一、**LSTM 解决什么问题?
回顾基础 RNN 的痛点:当句子很长,前面的信息经过一次次传递,不断被覆盖,读到句子末尾时,很容易忘记句子开头的内容。
|---------------------------------------------------------------|
| "今天天气很好,阳光明媚,微风不燥,适合出门去公园散步,公园里花开了,五颜六色非常好看,我打算带上相机记录这美好的景色。" |
基础 RNN 读到最后 "记录这美好的景色" 时,很容易丢失开头「今天天气很好」的关键信息。GRU 有一定改善,但 LSTM 设计了独立的记忆通道,能把重要信息跨很多时间步传递下去,减少信息丢失。
LSTM 依靠输入门、遗忘门、输出门三个门控,搭配独立细胞状态,精细控制记忆的留存与丢弃。
**二、**LSTM 的结构与原理
LSTM 引入两条状态:
- 隐藏状态
 :对外输出的短时记忆,用于当前时间步的预测;
- 细胞状态
 :长记忆传送带,负责长期保存上下文信息,信息传递过程改动很小。
三个门控作用:
- 遗忘门( Forget Gate ) :决定丢弃细胞状态里哪些旧记忆;
- 输入门( Input Gate ) :决定哪些新信息存入细胞状态;
- 输出门( Output Gate ) :决定细胞状态里哪些信息输出到隐藏状态。
**1.**逐时间步计算公式
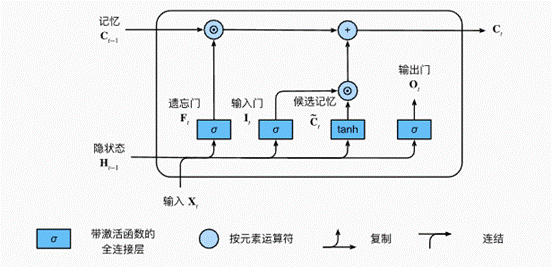
输入:当前时间步词嵌入  ,上一步隐藏状态
 ,上一步细胞状态
 。
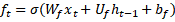 遗忘门
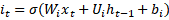 输入门
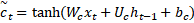 候选细胞状态
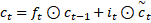 更新细胞状态
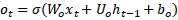 输出门
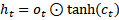 当前隐藏状态
 :sigmoid 激活,输出 0~1,1 代表开门保留信息,0 代表关门丢弃信息;
 :哈达玛积,对应元素相乘。
门含义通俗解释
1. 遗忘门 
控制旧记忆保留多少。ft  接近 0,丢弃上一步细胞状态里的信息;ft
 接近 1,保留原有记忆。比如句子语义切换,就可以通过遗忘门清空过时信息。
2. 输入门 
控制当前新信息多大程度写入细胞状态。it  接近 1,把候选状态 c ~t
 的新内容存入长记忆。
3. 输出门 
控制细胞状态的内容有多少输出到隐藏状态 ht  ,决定这一步对外暴露哪些记忆。
|---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| 核心特性:所有时间步共享同一套权重 。权重是学习到的记忆控制规则;细胞状态 ct  、隐藏状态 ht
 共同存储句子上下文。 |
2.**初始化  、**

和 RNN、GRU 保持一致:每个新句子都要单独初始化 h0  、 c0
 (零向量),不同句子记忆互相隔离,互不干扰。
句子全部读取完成后,最后时间步隐藏状态 hT  压缩整句上下文信息,可以送入 MLP 完成分类任务。
**三、**LSTM API 介绍
完整构造签名:
python
torch.nn.LSTM(input_size, hidden_size, num_layers=1, bias=True,
              batch_first=False, dropout=0.0, bidirectional=False)
|-------------------------|-------------------------------------------------|-------------------------|
| 参数 | 含义 | 文档例子取值 |
| input_size(embed_dim) | 每个时间步输入向量维度,词嵌入维度 | 8:单个词为 8 维向量 |
| hidden_size(hidden_dim) | 隐藏状态维度,记忆容量 | 16 |
| batch_first=True | 批量放第一维,输入 shape 变为 (batch, seq_len, input_size) | True,和 Embedding 输出直接对接 |
|-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| 输出说明: * output:(batch, seq_len, hidden_dim),保存每一个时间步的隐状态 * (h_n, c_n):元组,hn  是最后一层最后时间步隐藏状态,cn
 是最后一层最后时间步细胞状态 |
每个时间步隐藏状态维度固定 = hidden_dim=16;输入词嵌入 xt  依旧是 8 维。
四、代码Demo
python
import torch
import torch.nn as nn

class LSTMClassifier(nn.Module):
    def __init__(self, vocab_size, embed_dim, hidden_dim, num_classes):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embed_dim)
        # LSTM 层
        self.lstm = nn.LSTM(embed_dim, hidden_dim, batch_first=True)
        self.fc = nn.Linear(hidden_dim, num_classes)

    def forward(self, x):
        # x: (batch, seq_len) 词索引
        emb = self.embedding(x)                # (batch, seq_len, embed_dim)
        output, (h_n, c_n) = self.lstm(emb)    # output: (batch, seq_len, hidden_dim)
        h_last = h_n[-1]                       # 取最后一层隐状态 (batch, hidden_dim)
        logits = self.fc(h_last)               # (batch, num_classes)
        return logits

# 测试
vocab_size, embed_dim, hidden_dim, num_classes = 20, 8, 16, 2
model = LSTMClassifier(vocab_size, embed_dim, hidden_dim, num_classes)
x = torch.tensor([[1, 2, 3, 4],
                  [5, 6, 7, 8]])
logits = model(x)
print(logits.shape)  # torch.Size([2, 2])
五、LSTM 优点与缺点
优点:
- 独立细胞状态作为长期记忆通道,大幅缓解基础 RNN 梯度消失问题,长序列场景保留远距离上下文的能力强很多;
- 三组门控精细管理记忆,信息的保留、丢弃、输出分开控制,记忆管理更灵活;
- 保留 RNN 核心特性:所有时间步参数共享,支持变长序列输入;
- 训练稳定性优于基础 RNN,长句子训练时梯度衰减更缓慢。
缺点:
- 和基础 RNN 一样,逐时间步串行计算,序列不能并行处理;
- 相比基础 RNN,门控数量更多,参数量更大,内存占用更高;
- 单时间步运算逻辑更复杂,前向计算耗时高于基础 RNN;
- 极长序列场景下,远距离信息仍会缓慢衰减,无法永久保存全部历史信息。
|-------------------------------------------------------------------|
| 对比小结:基础 RNN 最简单、参数量最小;LSTM 增加细胞状态与三组门控,以更高计算开销为代价,显著提升长距离上下文记忆能力。 |
**六、**LSTM 和基础 RNN 简单对比
|--------|--------------------------|----------|----------|-----|
| 模型 | 核心机制 | 长距离依赖 | 训练难度 | 参数量 |
| 基础 RNN | 直接递推更新隐状态 | 差,容易梯度消失 | 难,长序列不稳定 | 少 |
| LSTM | 遗忘门 + 输入门 + 输出门,细胞状态长期记忆 | 大幅改善 | 更稳定 | 较多 |
**七、**LSTM 和 GRU 的区别
|-----------------------------------------------|
| 两者都是带门控的循环模型,都解决基础 RNN 梯度消失问题,核心差异在记忆结构和门控设计。 |
**1.**记忆状态
- LSTM :两套状态,细胞状态
 (长期记忆传送带)+ 隐藏状态
 (对外短时输出)。长期记忆单独一条通道,改动很小,远距离信息更容易保留。
- GRU :只有一套隐藏状态
 ,把 LSTM 的细胞状态合并进隐状态,不再单独维护长记忆通道。
**2.**门控数量与作用
- LSTM:3 个门 ------ 遗忘门、输入门、输出门。遗忘门控制丢弃旧记忆,输入门控制写入新记忆,输出门控制记忆对外输出,记忆的删、写、读分开控制。
- GRU:2 个门 ------ 重置门、更新门。更新门同时承担 LSTM 遗忘门 + 输入门的功能;重置门控制计算新候选状态时参考多少历史信息,没有单独的输出门。
**3.**参数量与计算
- GRU 门更少、状态向量更少,参数量更少,训练速度更快,内存开销更小。
- LSTM 门控更多、权重矩阵更多,参数量更大,单步计算更慢,但信息管控更精细。
**4.**效果与适用场景
- 普通长度文本任务:两者效果很接近。
- 很长的序列任务:LSTM 独立细胞状态的优势体现,更容易保留远距离上下文信息。
- 算力有限、需要快速训练:优先 GRU,以更小开销拿到接近的效果。