前言#
在 .NET 里写查询的时候,很多场景下数据其实早就都在内存里了:不是数据库连接,也不是某个远程服务的结果,而就是一个数组或者 List<T>。我只是想过滤一下、投影一下。这时候,通常有几种选择:
- 写一个
foreach循环 ------ 性能好、可控,但代码稍微有点啰嗦; - 用 LINQ ------ 写起来舒服,看起来也优雅,就是有迭代器、委托带来的那点开销;
- 要么干脆极端一点:把数据塞进数据库,再写真正的 SQL(这听起来就有点反直觉......)
但是我想尝试一条完全不同的思路:如果我们把 C# 的类型系统本身,当成查询计划会怎样?
也就是说,不是像平时那样:
- 在运行时构建一棵表达式树,
- 再拿着这棵树去解释执行整个查询;
而是:写一段 SQL 风格的字符串,把它编译成一个类型,这个类型从头到尾描述了整个查询管道,然后所有实际运行时的逻辑都走静态方法。
这个想法最终促成了 TypedSql ------ 一个用 C# 类型系统实现的内存内 SQL 查询引擎。
把查询变成嵌套的泛型类型#
TypedSql 的核心想法看上去非常简单:一个查询,其实可以是一串嵌套的泛型类型,比如 WhereSelect<TRow, ..., Stop<...>> 这样。
顺着这个想法,再往下推几步,会自然落到一套具体的设计上。
把执行计划塞进类型系统#
在 TypedSql 里,每一个编译好的查询,最终都会变成一个封闭的泛型管道类型 。
这个管道是由一些基础节点拼出来的,比如:
Where<TRow, TPredicate, TNext, TResult, TRoot>Select<TRow, TProjection, TNext, TMiddle, TResult, TRoot>WhereSelect<TRow, TPredicate, TProjection, TNext, TMiddle, TResult, TRoot>Stop<TResult, TRoot>
每个节点都实现了同一个接口:
Copy
internal interface IQueryNode<TRow, TResult, TRoot> { static abstract void Run(ReadOnlySpan<TRow> rows, scoped ref QueryRuntime<TResult> runtime); static abstract void Process(in TRow row, scoped ref QueryRuntime<TResult> runtime); }
这里可以简单理解成:
Run是外面那一圈大循环(整体遍历);Process是对单行执行的逻辑。
比如 Where 节点大概长这样:
Copy
internal readonly struct Where<TRow, TPredicate, TNext, TResult, TRoot> : IQueryNode<TRow, TResult, TRoot> where TPredicate : IFilter<TRow> where TNext : IQueryNode<TRow, TResult, TRoot> { public static void Run(ReadOnlySpan<TRow> rows, scoped ref QueryRuntime<TResult> runtime) { for (var i = 0; i < rows.Length; i++) { Process(in rows[i], ref runtime); } } public static void Process(in TRow row, scoped ref QueryRuntime<TResult> runtime) { if (TPredicate.Evaluate(in row)) { TNext.Process(in row, ref runtime); } } }
关键点在于:
- 管道的形状,完全藏在这些类型参数里面;
- 每个节点是一个只有静态方法的
struct------ 不需要创建实例,没有虚调用。
对 JIT 来说,一旦这些泛型类型参数都被代入,这就是一张普通的静态调用图而已。
列和投影#
查询总得运行在某种行类型 TRow 上,这通常是你自己定义的一个 record/class/struct。
每一列会实现这样一个接口:
Copy
internal interface IColumn<TRow, TValue> { static abstract string Identifier { get; } static abstract TValue Get(in TRow row); }
举个简单的例子:
Copy
internal readonly struct PersonNameColumn : IColumn<Person, string> { public static string Identifier => "Name"; public static string Get(in Person row) => row.Name; }
而投影(SELECT 后面那部分)则实现:
Copy
internal interface IProjection<TRow, TResult> { static abstract TResult Project(in TRow row); }
将选出某一列本身做成一个投影,可以这么写:
Copy
internal readonly struct ColumnProjection<TColumn, TRow, TValue> : IProjection<TRow, TValue> where TColumn : IColumn<TRow, TValue> { public static TValue Project(in TRow row) => TColumn.Get(row); }
多列选择时,TypedSql 会构造专门的投影,把结果拼成 ValueTuple:
Copy
internal readonly struct ValueTupleProjection<TRow, TColumn1, TValue1> : IProjection<TRow, ValueTuple<TValue1>> where TColumn1 : IColumn<TRow, TValue1> { public static ValueTuple<TValue1> Project(in TRow row) => new(TColumn1.Get(row)); } // ... 一直到 7 列,然后通过一个"Rest"再递归挂一个 IProjection
还是同样的模式:全是 struct,全是静态方法。
过滤器#
过滤器的接口长这样:
Copy
internal interface IFilter<TRow> { static abstract bool Evaluate(in TRow row); }
一个最常用的比较过滤器形式,是列 + 字面量:
Copy
internal readonly struct EqualsFilter<TRow, TColumn, TLiteral, TValue> : IFilter<TRow> where TColumn : IColumn<TRow, TValue> where TLiteral : ILiteral<TValue> where TValue : IEquatable<TValue>, IComparable<TValue> { [MethodImpl(MethodImplOptions.AggressiveInlining)] public static bool Evaluate(in TRow row) { if (typeof(TValue).IsValueType) { return TColumn.Get(row).Equals(TLiteral.Value); } else { var left = TColumn.Get(row); var right = TLiteral.Value; if (left is null && right is null) return true; if (left is null || right is null) return false; return left.Equals(right); } } }
这里我们通过判断 TValue 是值类型还是引用类型,来分别处理 null 的情况。.NET 的 JIT 能够识别这种模式,并且为值类型和引用类型分别特化并生成不同的代码路径,从而实际上并不存在任何的分支开销。
GreaterThanFilter、LessThanFilter、GreaterOrEqualFilter、LessOrEqualFilter、NotEqualFilter 等等,都是同样的套路。
逻辑运算也是在类型层面组合的:
Copy
internal readonly struct AndFilter<TRow, TLeft, TRight> : IFilter<TRow> where TLeft : IFilter<TRow> where TRight : IFilter<TRow> { public static bool Evaluate(in TRow row) => TLeft.Evaluate(in row) && TRight.Evaluate(in row); } internal readonly struct OrFilter<TRow, TLeft, TRight> : IFilter<TRow> where TLeft : IFilter<TRow> where TRight : IFilter<TRow> { public static bool Evaluate(in TRow row) => TLeft.Evaluate(in row) || TRight.Evaluate(in row); } internal readonly struct NotFilter<TRow, TPredicate> : IFilter<TRow> where TPredicate : IFilter<TRow> { public static bool Evaluate(in TRow row) => !TPredicate.Evaluate(in row); }
所以,一条 WHERE 子句,最终就会变成一棵泛型过滤器类型树 ,每个节点只有一个静态 Evaluate 方法。
值类型特化版字符串:ValueString#
在 .NET 里,string 是一个引用类型 ,这给 TypedSql 带来了一些麻烦:.NET 会对引用类型采用共享泛型在运行时做分发,而不是为 string 泛型实例化一个具体类型,这使得运行时会产生类型字典查找的开销。虽然这点开销不大,但是 TypedSql 追求的是媲美手写循环的性能,所以我想尽量把热路径里涉及的类型都做成值类型。
于是我选择把字符串包在一个小的值类型里:
Copy
internal readonly struct ValueString(string? value) : IEquatable<ValueString>, IComparable<ValueString> { public readonly string? Value = value; public int CompareTo(ValueString other) => string.Compare(Value, other.Value, StringComparison.Ordinal); public bool Equals(ValueString other) { return string.Equals(Value, other.Value, StringComparison.Ordinal); } public override string? ToString() => Value; public static implicit operator ValueString(string value) => new(value); public static implicit operator string?(ValueString value) => value.Value; }
再配一个适配器,把原来的 string 列变成 ValueString 列:
Copy
internal readonly struct ValueStringColumn<TColumn, TRow> : IColumn<TRow, ValueString> where TColumn : IColumn<TRow, string> { public static string Identifier => TColumn.Identifier; public static ValueString Get(in TRow row) => new(TColumn.Get(in row)); }
在内部,所有字符串列都统一成 ValueString,有几个好处:
- 热路径里尽量是值类型,少一点引用类型的干扰;
- 避开了泛型共享带来的类型字典查找开销。
对使用者来说,你照样写 string,而我的 TypedSql 会在内部自动在边缘位置做封装/解封装,所以完全透明。
实现一个 SQL 子集#
TypedSql 并不打算做成一个大而全的 SQL 引擎,而是针对单表、内存内查询,设计了一个很小的 SQL 方言:
支持这些语句:
SELECT * FROM $SELECT col FROM $SELECT col1, col2, ... FROM $WHERE支持:- 比较:
=,!=,>,<,>=,<= - 布尔:
AND,OR,NOT - 括号
- 比较:
- 字面量支持:
- 整数(如
42) - 浮点数(如
123.45) - 布尔(
true/false) - 单引号字符串(
'Seattle',内部用''转义) null
- 整数(如
- 列名大小写不敏感
$代表当前行来源
整体解析流程很简单:
- 先把 SQL 字符串切成 token;
- 再构建一棵小 AST,包含:
ParsedQuery:整体查询Selection:SelectAll或者列名列表WhereExpression:筛选表达式ComparisonExpression:比较AndExpression:与OrExpression:或NotExpression:非
LiteralValue:字面量LiteralKind.Integer+IntValueLiteralKind.Float+FloatValueLiteralKind.Boolean+BoolValueLiteralKind.String+StringValue(string?)LiteralKind.Null
在这个阶段,整个系统其实完全不知道 C# 里面的类型是什么样的,列又是什么,只是单纯看作 SQL 结构。
类型检查、以及这个字面量能不能用在那一列上之类的问题,会留到后面的编译阶段去做。
把字面量变成类型 ------ 包括字符串#
在这里,我想针对每一个 SQL 语句都生成一份独特的类型,因此作为查询条件中的字面量,也必须变成类型参数的一部分。
于是,在 TypeSql 中,所有的字面量类型都实现同一个接口:
Copy
internal interface ILiteral<T> { static abstract T Value { get; } }
适用范围包括:
- 整数(
int) - 浮点数(
float) - 字符(
char) - 布尔(
bool) - 字符串(这里是
ValueString,内部包string?) - ......未来还可以扩展更多
数值字面量#
数值字面量的编码方式很直接:用 16 进制和位运算拼出来。
先来一组 IHex 接口和 Hex0--HexF struct:
Copy
internal interface IHex { static abstract int Value { get; } } internal readonly struct Hex0 : IHex { public static int Value => 0; } // ... internal readonly struct HexF : IHex { public static int Value => 15; }
然后,一个整型字面量长这样:
Copy
internal readonly struct Int<H7, H6, H5, H4, H3, H2, H1, H0> : ILiteral<int> where H7 : IHex // ... where H0 : IHex { public static int Value => (H7.Value << 28) | (H6.Value << 24) | (H5.Value << 20) | (H4.Value << 16) | (H3.Value << 12) | (H2.Value << 8) | (H1.Value << 4) | H0.Value; }
浮点数也是一样的 8 个十六进制数位,只不过最后用 Unsafe.BitCast<int, float> 转回 float:
Copy
internal readonly struct Float<H7, H6, H5, H4, H3, H2, H1, H0> : ILiteral<float> where H7 : IHex // ... { public static float Value => Unsafe.BitCast<int, float>( (H7.Value << 28) | (H6.Value << 24) | (H5.Value << 20) | (H4.Value << 16) | (H3.Value << 12) | (H2.Value << 8) | (H1.Value << 4) | H0.Value); }
字符则是 4 个十六进制数位:
Copy
internal readonly struct Char<H3, H2, H1, H0> : ILiteral<char> where H3 : IHex // ... { public static char Value => (char)((H3.Value << 12) | (H2.Value << 8) | (H1.Value << 4) | H0.Value); }
字符串字面量:类型的链表!#
字符串字面量就比较有趣了。
这里我选择在类型层面构建一条字符链表 ,用接口 IStringNode 来描述:
Copy
internal interface IStringNode { static abstract int Length { get; } static abstract void Write(Span<char> destination, int index); }
有三个实现:
StringEnd:字符串的结尾(长度 0);StringNull:表示 null 字符串(长度 -1);StringNode<TChar, TNext>:当前一个字符 + 剩余部分。
Copy
internal readonly struct StringEnd : IStringNode { public static int Length => 0; public static void Write(Span<char> destination, int index) { } } internal readonly struct StringNull : IStringNode { public static int Length => -1; public static void Write(Span<char> destination, int index) { } } internal readonly struct StringNode<TChar, TNext> : IStringNode where TChar : ILiteral<char> where TNext : IStringNode { public static int Length => 1 + TNext.Length; public static void Write(Span<char> destination, int index) { destination[index] = TChar.Value; TNext.Write(destination, index + 1); } }
有了这样的类型链表,我们就可以基于某个 IStringNode,构造出真正的 ValueString:
Copy
internal readonly struct StringLiteral<TString> : ILiteral<ValueString> where TString : IStringNode { public static ValueString Value => Cache.Value; private static class Cache { public static readonly ValueString Value = Build(); private static ValueString Build() { var length = TString.Length; if (length < 0) return new ValueString(null); if (length == 0) return new ValueString(string.Empty); var chars = new char[length]; TString.Write(chars.AsSpan(), 0); return new string(chars, 0, length); } } }
StringLiteral<TString> 就是一个 ILiteral<ValueString>,它的 Value 在类型初始化时算好并缓存下来,所以只需要计算一次,后续访问都是直接读静态字段,非常高效。
把字符串塞进类型#
LiteralTypeFactory.CreateStringLiteral 负责把字符串字面量转换成这样一个类型:
Copy
public static Type CreateStringLiteral(string? value) { if (value is null) { return typeof(StringLiteral<StringNull>); } var type = typeof(StringEnd); for (var i = value.Length - 1; i >= 0; i--) { var charType = CreateCharType(value[i]); // Char<...> type = typeof(StringNode<,>).MakeGenericType(charType, type); } return typeof(StringLiteral<>).MakeGenericType(type); }
比如我们有一个字面量 'Seattle',整个流程大致是:
-
解析阶段读到
'Seattle',生成一个LiteralValue:Kind == LiteralKind.StringStringValue == "Seattle"
-
编译阶段根据列的类型判断:这是个字符串列,于是对应的运行时类型是
ValueString。 -
调用
CreateStringLiteral("Seattle"):-
初始
type = typeof(StringEnd); -
从右到左遍历每个字符:
'e'→ 得到一个Char<...>类型(4 个十六进制数位对应 Unicode)type = StringNode<Char<'e'>, StringEnd>
'l'再往前:type = StringNode<Char<'l'>, StringNode<Char<'e'>, StringEnd>>
- 一直重复:
't'、't'、'a'、'e'、'S'......
-
最终得到类似这样一个类型:
Copy
StringNode<Char<'S'>, StringNode<Char<'e'>, StringNode<Char<'a'>, StringNode<Char<'t'>, StringNode<Char<'t'>, StringNode<Char<'l'>, StringNode<Char<'e'>, StringEnd>>>>>>>>
-
-
最后再用
StringLiteral<>把它包起来:Copy
StringLiteral< StringNode<Char<'S'>, StringNode<Char<'e'>, ... > > >
这一整个封闭泛型类型,就是字面量 'Seattle' 的类型版本。
而过滤器在需要值的时候,只是简单地访问 TLiteral.Value,再通过 TString.Length 和 TString.Write 复原出一个 ValueString("Seattle"),其中复原通过静态类型的缓存完成,借助类型系统的力量,每一个独立的字面量都会产生一个单独的类型实例,我们的字面量就缓存在那个类型的静态字段里,从而避免了一切运行时的计算开销。
null 字符串字面量#
null 的处理稍微特殊一点:
- 写类似
WHERE Team != null这种代码时,解析器会把它识别为LiteralKind.Null; - 对字符串列来说,
CreateStringLiteral(null)会返回typeof(StringLiteral<StringNull>); StringNull.Length == -1,于是StringLiteral<StringNull>.Value直接返回new ValueString(null)。
这样一来,null 和 "" 在类型层面和运行时都可以被区分开。
字面量工厂#
上面这些编码最后都归到一个工厂类里统一封装:
Copy
internal static class LiteralTypeFactory { public static Type CreateIntLiteral(int value) { ... } public static Type CreateFloatLiteral(float value) { ... } public static Type CreateBoolLiteral(bool value) { ... } public static Type CreateStringLiteral(string? value) { ... } }
SQL 编译阶段会根据两方面信息来调用它:
- 列的运行时类型(
int、float、bool、ValueString); - 字面量的种类(
Integer、Float、Boolean、String、Null)。
最终的效果就是:WHERE 子句里每一个字面量,都会变成一个具体的 ILiteral<T> 类型,值直接嵌在类型参数里。
搭好整个管道类型#
到目前为止,我们已经有了:
- 一棵解析出来的查询(
SELECT+WHERE); - 一份 schema,把列名映射到具体的
IColumn<TRow, TValue>实现; - 一套机制,把字面量变成
ILiteral<T>类型。
SQL 编译器接下来要做的就是,把这些东西变成:
- 一个封闭的管道类型
TPipeline,它实现IQueryNode<TRow, TRuntimeResult, TRoot>; - 一个运行时结果类型
TRuntimeResult; - 一个对外公开的结果类型
TPublicResult。
编译 SELECT#
先看选择部分。
SELECT *#
最简单的情况就是:SELECT * FROM $。
这时候:
- 运行时结果类型 = 行类型本身:
TRuntimeResult = TRow; - 公共结果类型也是
TRow; - 管道尾部就是一个
Stop<TRow, TRow>节点。
大致逻辑如下:
Copy
TRuntimeResult = typeof(TRow); TPublicResult = typeof(TRow); TPipelineTail = typeof(Stop<,>).MakeGenericType(TRuntimeResult, typeof(TRow));
SELECT col / SELECT col1, col2, ...#
当有明确列投影时,步骤稍微多一点:
-
SELECT col:- 根据列名解析出对应的
ColumnMetadata; - 决定它的运行时值类型:
- 如果列类型本身不是
string,运行时类型就跟它一致; - 如果是
string,运行时类型改为ValueString;
- 如果列类型本身不是
- 构建一个
ColumnProjection<TRuntimeColumn, TRow, TRuntimeValue>。
- 根据列名解析出对应的
-
SELECT col1, col2, ...:- 分别解析每一列;
- 构造一个
ValueTupleProjection,返回一个ValueTuple<...>,里面放运行时类型; - 同时记录一份公共
ValueTuple<...>类型,用声明的 CLR 类型(如string)。
最后,无论是一列还是多列,都会在 Stop 前面再加一个 Select 节点:
Copy
Select<TRow, TProjection, Stop<...>, TMiddle, TRuntimeResult, TRoot> → Stop<...>
这个节点内部会调用投影的静态 Project 方法,再把结果转交给 Stop.Process 处理。
编译 WHERE#
WHERE 子句以递归方式编译成类型。
布尔结构#
给定一个解析后的 WhereExpression 树:
A AND B→AndFilter<TRow, TA, TB>;A OR B→OrFilter<TRow, TA, TB>;NOT A→NotFilter<TRow, TA>。
编译器做的事情,大概是对这棵树一层层往下调自己的方法:
Copy
Type BuildPredicate<TRow>(WhereExpression expr) { return expr switch { ComparisonExpression cmpExpr => BuildComparisonPredicate<TRow>(cmpExpr), AndExpression andExpr => typeof(AndFilter<,,>).MakeGenericType(typeof(TRow), BuildPredicate<TRow>(andExpr.Left), BuildPredicate<TRow>(andExpr.Right)), OrExpression orExpr => typeof(OrFilter<,,>).MakeGenericType(typeof(TRow), BuildPredicate<TRow>(orExpr.Left), BuildPredicate<TRow>(orExpr.Right)), NotExpression notExpr => typeof(NotFilter<,>).MakeGenericType(typeof(TRow), BuildPredicate<TRow>(notExpr.Expression)), _ => throw ... }; }
比较表达式#
每一个叶子比较表达式,比如:
Copy
City = 'Seattle' Salary >= 180000 Team != null
都会变成一个具体的过滤器类型:
Copy
Type BuildComparisonPredicate<TRow>(ComparisonExpression comparison) { var rowType = typeof(TRow); var column = SchemaRegistry<TRow>.ResolveColumn(comparison.ColumnIdentifier); var runtimeColumnType = column.GetRuntimeColumnType(rowType); var runtimeColumnValueType = column.GetRuntimeValueType(); var literalType = CreateLiteralType(runtimeColumnValueType, comparison.Literal); var filterDefinition = comparison.Operator switch { ComparisonOperator.Equals => typeof(EqualsFilter<,,,>), ComparisonOperator.GreaterThan => typeof(GreaterThanFilter<,,,>), ComparisonOperator.LessThan => typeof(LessThanFilter<,,,>), ComparisonOperator.GreaterOrEqual=> typeof(GreaterOrEqualFilter<,,,>), ComparisonOperator.LessOrEqual => typeof(LessOrEqualFilter<,,,>), ComparisonOperator.NotEqual => typeof(NotEqualFilter<,,,>), _ => throw ... }; return filterDefinition.MakeGenericType( rowType, runtimeColumnType, literalType, runtimeColumnValueType); }
以 City = 'Seattle' 为例,如果那一列是字符串列,那么:
- 运行时列类型是:
ValueStringColumn<PersonCityColumn, Person>; - 运行时值类型是:
ValueString; - 字面量类型,则是通过
CreateStringLiteral("Seattle")得到的某个StringLiteral<SomeStringNode<...>>。
最后组合出一个过滤器类型:
Copy
EqualsFilter<Person, ValueStringColumn<PersonCityColumn, Person>, StringLiteral<...>, ValueString>
到这一步,我们就可以把一个 Where 节点挂到管道上了:
Copy
Where<TRow, TPredicate, TNext, TRuntimeResult, TRoot> → ...
把 Where 和 Select 融合起来#
直接这么拼出来的管道是正确的,但在性能上还能再优化一点:
Where 和 Select 其实可以合并成一步。
TypedSql 里有一个很小的优化器,会去找这样的模式:
Where<TRow, TPredicate, Select<TRow, TProjection, TNext, TMiddle, TResult, TRoot>, TResult, TRoot>
一旦发现,就把它替换成:
Copy
WhereSelect<TRow, TPredicate, TProjection, TNext, TMiddle, TResult, TRoot>
这个融合节点的实现如下:
Copy
internal readonly struct WhereSelect<TRow, TPredicate, TProjection, TNext, TMiddle, TResult, TRoot> : IQueryNode<TRow, TResult, TRoot> where TPredicate : IFilter<TRow> where TProjection : IProjection<TRow, TMiddle> where TNext : IQueryNode<TMiddle, TResult, TRoot> { public static void Run(ReadOnlySpan<TRow> rows, scoped ref QueryRuntime<TResult> runtime) { for (var i = 0; i < rows.Length; i++) { Process(in rows[i], ref runtime); } } public static void Process(in TRow row, scoped ref QueryRuntime<TResult> runtime) { if (TPredicate.Evaluate(in row)) { var projected = TProjection.Project(in row); TNext.Process(in projected, ref runtime); } } }
于是像下面这种常见的查询:
Copy
SELECT Name FROM $ WHERE City = 'Seattle'
最终就会是:
Copy
WhereSelect<...> → Stop<...>
也就是说:一个循环里完成过滤和投影 ,不需要再分两趟。并且,我们的优化器还能识别更复杂的嵌套结构,尽可能地把 Where 和 Select 融合在一起,减少中间步骤,提升性能。而这并不需要复杂的优化算法,只需要简单地把泛型参数取出来重新带入到新的融合类型即可,实现起来非常简单。
结果转换#
管道把所有行跑完之后,最后还得把结果以某种形式"交出去"。
一个查询的入口长这样:
Copy
internal static class QueryProgram<TRow, TPipeline, TRuntimeResult, TPublicResult> where TPipeline : IQueryNode<TRow, TRuntimeResult, TRow> { public static IReadOnlyList<TPublicResult> Execute(ReadOnlySpan<TRow> rows) { var runtime = new QueryRuntime<TRuntimeResult>(rows.Length); TPipeline.Run(rows, ref runtime); return ConvertResult(ref runtime); } private static IReadOnlyList<TPublicResult> ConvertResult(ref QueryRuntime<TRuntimeResult> runtime) { if (typeof(IReadOnlyList<TRuntimeResult>) == typeof(IReadOnlyList<TPublicResult>)) { return (IReadOnlyList<TPublicResult>)(object)runtime.Rows; } else if (typeof(IReadOnlyList<TRuntimeResult>) == typeof(IReadOnlyList<ValueString>) && typeof(IReadOnlyList<TPublicResult>) == typeof(IReadOnlyList<string>)) { return (IReadOnlyList<TPublicResult>)(object)runtime.AsStringRows(); } else if (RuntimeFeature.IsDynamicCodeSupported && typeof(TRuntimeResult).IsGenericType && typeof(TPublicResult).IsGenericType) { return runtime.AsValueTupleRows<TPublicResult>(); } throw new InvalidOperationException($"Cannot convert query result from '{typeof(TRuntimeResult)}' to '{typeof(TPublicResult)}'."); } }
可以看到主要有三种情况:
-
运行时结果类型和公共结果类型一模一样
→ 直接把
Rows返回就行。 -
运行时内部用的是
ValueString,外面希望看到string→ 调用
AsStringRows,它会把内部的ValueString[]包装一下,对外返回string?(靠隐式转换)。 -
两边都是某种
ValueTuple形状→ 用
AsValueTupleRows<TPublicResult>(),底层交给ValueTupleConvertHelper去做拷贝和字段转换。
ValueTupleConvertHelper:用动态 IL 在元组之间搬运字段#
ValueTupleConvertHelper<TPublicResult, TRuntimeResult> 的职责是:
- 在两个兼容形状的
ValueTuple之间搬运字段; - 识别并处理
string↔ValueString的转换; - 如果
ValueTuple有Rest(嵌套元组),要递归下去做同样的事情。
它在类型初始化时,会生成一个 DynamicMethod 来做拷贝:
Copy
internal static class ValueTupleConvertHelper<TPublicResult, TRuntimeResult> { private delegate void CopyDelegate(ref TPublicResult dest, ref readonly TRuntimeResult source); private static readonly CopyDelegate _helper = default!; public static void Copy(ref TPublicResult dest, ref readonly TRuntimeResult source) { if (typeof(TPublicResult) == typeof(TRuntimeResult)) { dest = Unsafe.As<TRuntimeResult, TPublicResult>(ref Unsafe.AsRef(in source)); } else { _helper.Invoke(ref dest, in source); } } static ValueTupleConvertHelper() { // 构造 DynamicMethod 和 IL,按字段复制, // 若发现 string <-> ValueString,就做对应转换, // 遇到 Rest 字段时递归。 } }
这样,运行时内部可以用一个对自己更舒服的元组类型,比如 (ValueString, int, ValueString, ...),而外面看到的则是 (string, int, string, ...),两者之间通过这一层帮助类桥接,成本也很低。这使得查询过程可以最大化利用值类型的泛型特化优势,同时对外还不需要暴露这些内部细节,达到了性能和易用性的平衡。
不过需要注意的是,这一块用到了动态代码生成,所以在一些受限环境(比如 AOT)下可能无法使用,因此 TypedSql 会在编译阶段检查这一点,确保只有在支持动态代码的环境下,才允许使用这种元组转换。否则的话,就只能退回到直接让运行时结果类型和公共结果类型一致的方式。
整体流程:编译并执行查询#
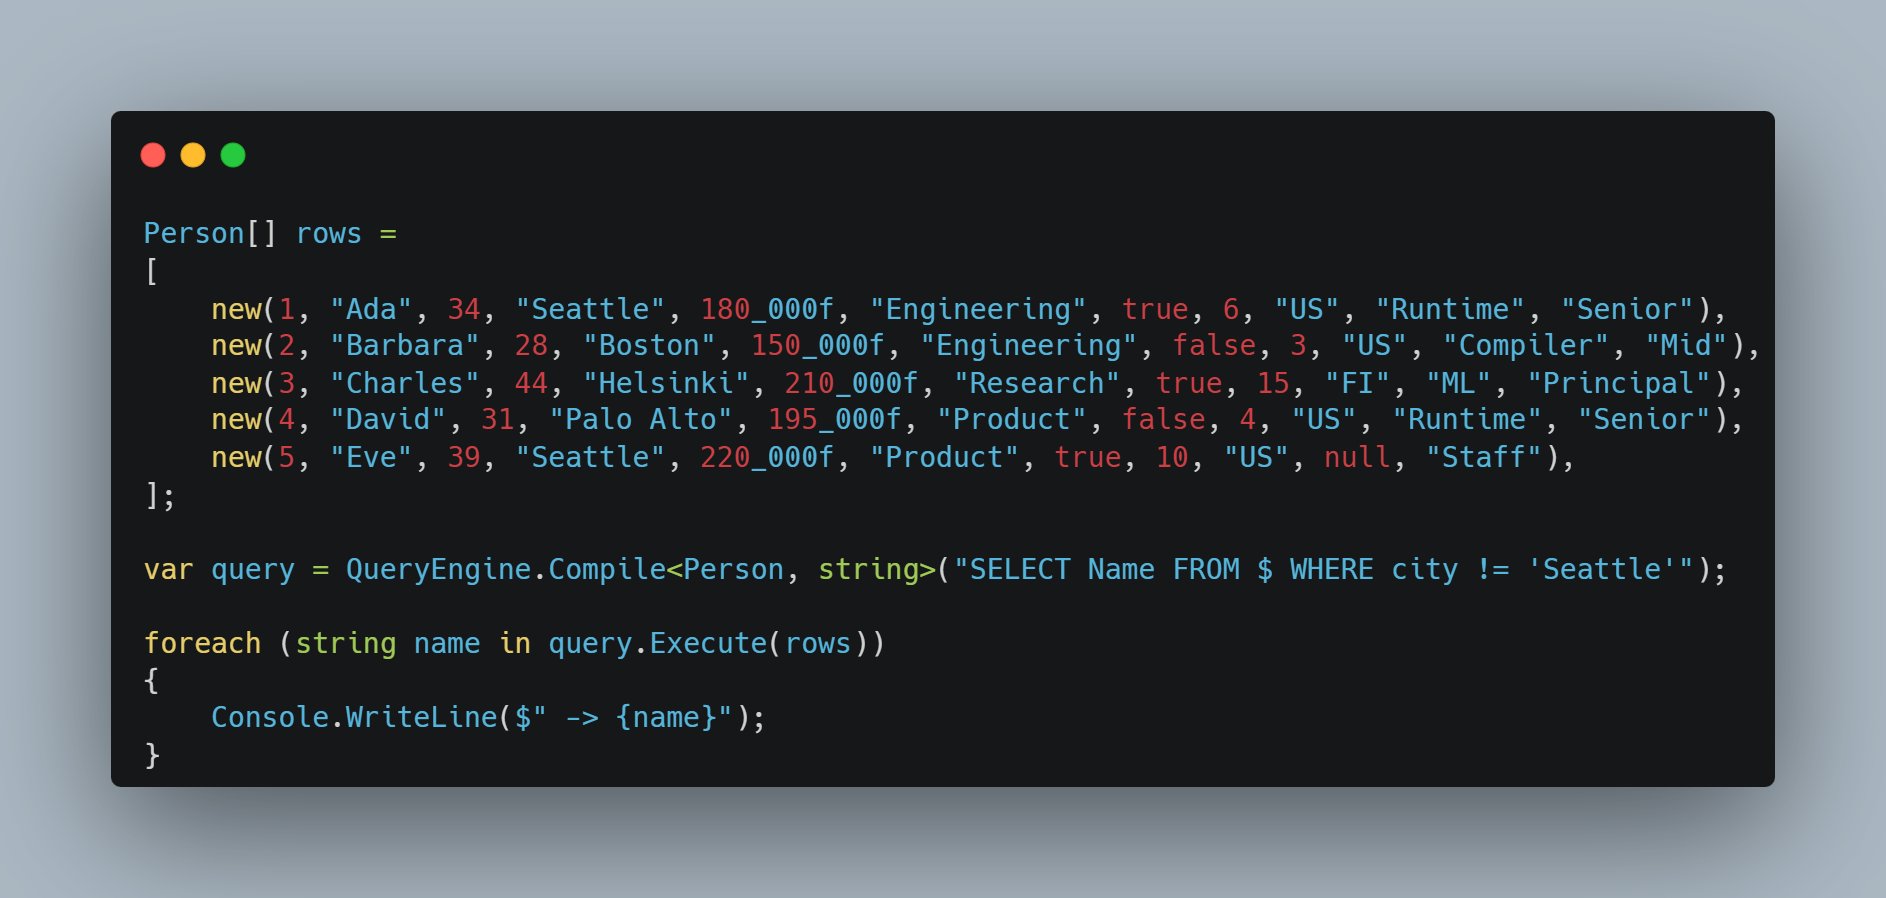
站在使用者的角度,入口一般会是这样的:
Copy
var compiled = QueryEngine.Compile<Person, string>( "SELECT Name FROM $ WHERE City != 'Seattle'");
Compile<TRow, TResult> 在内部会做这么几件事:
- 解析 SQL,生成
ParsedQuery; - 把 SQL 编译成:
- 管道类型
TPipeline; TRuntimeResult;TPublicResult;
- 管道类型
- 检查
TPublicResult是否和你指定的TResult一致; - 构造
QueryProgram<TRow, TPipeline, TRuntimeResult, TPublicResult>这个类型; - 找到它的静态方法
Execute(ReadOnlySpan<TRow>); - 把它变成一个委托,塞进
CompiledQuery<TRow, TResult>。
CompiledQuery<TRow, TResult> 本身只是包了一个委托:
Copy
private readonly Func<ReadOnlySpan<TRow>, IReadOnlyList<TResult>> _entryPoint = executeMethod.CreateDelegate<Func<ReadOnlySpan<TRow>, IReadOnlyList<TResult>>>();
然后对外暴露:
Copy
public IReadOnlyList<TResult> Execute(ReadOnlySpan<TRow> rows) => _entryPoint(rows);
得益于 .NET 10 对委托的逃逸分析、去虚拟化和内联等优化,这一层委托调用可以说几乎没有任何开销。
在 JIT 看来,一旦 Compile 做完这些准备工作,以后每次 Execute 就只是:
- 一次直接的静态调用;
- 调入一个所有类型参数已经封死的泛型方法;
- 这个方法里面再调用一串全是
struct和静态方法组成的管道。
最终编译出来的类型,你既可以直接拿去执行,也可以把它输出到代码里然后通过 NativeAOT 编译成原生二进制文件,一套代码同时支持 JIT 和 AOT!
使用和性能测试#
快速上手#
和很多轻量级查询库类似,TypedSql 的打开方法是:
-
定义你的行类型,例如:
Copy
public sealed record Person( int Id, string Name, int Age, string City, float Salary, string Department, bool IsManager, int YearsAtCompany, string Country, string? Team, string Level); -
为每一列实现一个
IColumn<Person, TValue>; -
把这些列注册到
Person对应的 schema 里; -
然后就可以编译并运行查询,例如:
Copy
// 编译一次 var wellPaidManagers = QueryEngine.Compile<Person, Person>( """ SELECT * FROM $ WHERE Department = 'Engineering' AND IsManager = true AND YearsAtCompany >= 5 AND Salary > 170000 AND Country = 'US' """); // 针对不同数据集多次执行 var result = wellPaidManagers.Execute(allPeople.AsSpan());
要是你只需要一部分列,也可以返回元组:
Copy
var seniorTitles = QueryEngine.Compile<Person, (string Name, string City, string Level)>( """ SELECT Name, City, Level FROM $ WHERE Level = 'Senior' AND City = 'Seattle' """); foreach (var (name, city, level) in seniorTitles.Execute(allPeople.AsSpan())) { Console.WriteLine($"{name} in {city} [{level}]"); }
所有重活------解析 SQL、字面量编码、在类型系统里搭管道------都发生在编译查询这一步。
之后每次 .Execute,都只是跑一遍已经专门化好的静态管道,没有任何的运行时分发,没有任何的虚拟调用,不存在任何的反射和装箱,完全是 JIT 能看懂的强类型、零分配代码,从而实现极高的性能。
简单性能对比#
TypedSql 的目标并不是炫技用类型,而是想试试看:在保持 SQL 风格外壳的情况下,我们能让生成的代码离一个手写循环有多近。
一个非常简单的 benchmark 就是拿三个方案做对比:
- 一条 TypedSql 查询;
- 一条等价的 LINQ 查询;
- 一段手写的
foreach循环。
任务内容:
- 过滤出
City == "Seattle"的行; - 返回它们的
Id。
TypedSql 编译出来的类型大概是这样:
Copy
QueryProgram< Person, WhereSelect< Person, EqualsFilter< Person, ValueStringColumn<PersonCityColumn, Person>, 'Seattle', ValueString >, ColumnProjection<PersonIdColumn, Person, Int32>, Stop<Int32, Person>, Int32, Int32, Person>, Int32, Int32 >
让我们来看看 RyuJIT 为我们的查询方案生成了什么样的机器码:
Copy
G_M000_IG01: ; prologue push r15 push r14 push rdi push rsi push rbp push rbx sub rsp, 40 mov rbx, rcx G_M000_IG02: ; 分配结果数组 mov esi, dword ptr [rbx+0x08] mov edx, esi mov rcx, 0x7FFE71F29558 call CORINFO_HELP_NEWARR_1_VC mov rdi, rax xor ebp, ebp mov rbx, bword ptr [rbx] test esi, esi jle SHORT G_M000_IG06 G_M000_IG03: ; 初始化循环变量 xor r14d, r14d G_M000_IG04: ; 循环体 lea r15, bword ptr [rbx+r14] mov rcx, gword ptr [r15+0x08] mov rdx, 0x16EB0400D30 mov rdx, gword ptr [rdx] mov rdx, gword ptr [rdx+0x08] cmp rcx, rdx je G_M000_IG12 test rcx, rcx je SHORT G_M000_IG05 test rdx, rdx je SHORT G_M000_IG05 mov r8d, dword ptr [rcx+0x08] cmp r8d, dword ptr [rdx+0x08] je SHORT G_M000_IG08 G_M000_IG05: ; 更新循环计数器 add r14, 72 dec esi jne SHORT G_M000_IG04 G_M000_IG06: ; 产生结果对象 mov rcx, 0x7FFE72227600 call CORINFO_HELP_NEWSFAST mov rbx, rax lea rcx, bword ptr [rbx+0x08] mov rdx, rdi call CORINFO_HELP_ASSIGN_REF mov dword ptr [rbx+0x10], ebp mov rax, rbx G_M000_IG07: ; epilogue add rsp, 40 pop rbx pop rbp pop rsi pop rdi pop r14 pop r15 ret G_M000_IG08: ; 字符串长度比较 lea rax, bword ptr [rcx+0x0C] add rdx, 12 mov ecx, dword ptr [rcx+0x08] add ecx, ecx mov r8d, ecx cmp r8, 10 je SHORT G_M000_IG10 G_M000_IG09: ; 字符串内容慢速比较 mov rcx, rax call [System.SpanHelpers:SequenceEqual(byref,byref,nuint):bool] jmp SHORT G_M000_IG11 G_M000_IG10: ; 字符串内容快速比较 mov rcx, qword ptr [rax] mov rax, qword ptr [rax+0x02] mov r8, qword ptr [rdx] xor rcx, r8 xor rax, qword ptr [rdx+0x02] or rcx, rax sete al movzx rax, al G_M000_IG11: ; 处理比较结果 test eax, eax je SHORT G_M000_IG05 G_M000_IG12: ; 把匹配的 Id 写入结果数组 mov ecx, dword ptr [r15+0x30] lea rax, bword ptr [rdi+0x10] lea edx, [rbp+0x01] mov r15d, edx movsxd rdx, ebp mov dword ptr [rax+4*rdx], ecx mov ebp, r15d jmp G_M000_IG05
注意看 G_M000_IG08 的 r8, 10,这里的 10 就是字符串字面量 'Seattle' 的长度,JIT 直接把我们的字符串字面量的长度常量嵌进了机器码里;进一步当长度匹配时,JIT 又生成了代码跳转到 G_M000_IG10,这段代码专门处理长度为 10 的字符串的快速比较路径。也就是说,JIT 不仅把字面量的值嵌进去了,还根据它生成了专门的代码路径!
再注意看循环计数器的更新部分,G_M000_IG05 里的 add r14, 72,这里的 72 就是 sizeof(Person),JIT 直接把行类型的大小常量也嵌进去了,避免了运行时的计算;而 dec esi 更是直接把递增的循环优化成了递减,减少了一次比较指令。
上述代码的逻辑等价于:
Copy
int length = elements.Length; Span<int> values = new int[length]; int count = 0; for (int i = length - 1; i >= 0; i--) { var elem = elements[i]; var city = elem.City; if (city == null) continue; if (city.Length == 10 && city == "Seattle") { values[length - 1 - count] = elem.Id; count++; } } return values[..count];
看到了吗?跟你手写的循环几乎一模一样!我们的抽象完全被 JIT 优化的一干二净!
上个跑分结果:
| Method | Mean | Error | StdDev | Gen0 | Code Size | Allocated |
|---|---|---|---|---|---|---|
| TypedSql | 10.953 ns | 0.0250 ns | 0.0195 ns | 0.0051 | 111 B | 80 B |
| Linq | 27.030 ns | 0.1277 ns | 0.1067 ns | 0.0148 | 3,943 B | 232 B |
| Foreach | 9.429 ns | 0.0417 ns | 0.0326 ns | 0.0046 | 407 B | 72 B |
可以看到:TypedSql 在时间和分配上无限逼近 foreach,远远超过即使是在 .NET 10 中已经被高度优化后的 LINQ 的性能。
这也符合我们对它内部结构的预期:
- 查询管道是类型层级的,结构在编译期就定死
- 列、投影、过滤全是值类型 + 静态方法
- 字符串统一走
ValueString热路径 - 字面量则通过
ILiteral<T>嵌在类型参数里 - 所有这些都让 JIT 能够把代码特化、展开、内联,最终生成和手写循环几乎一样的机器码
尾声#
TypedSql 只是一个简单的内存查询引擎实验。它只是围绕一个很具体的问题:C# 的类型系统到底能让我们把多少查询逻辑搬过去,.NET 又能针对这些类型生成多快的代码?
于是,在 TypeSql 中,我们实现了:
- 把列、投影、过滤全都表示成带静态方法的
struct,并通过接口的静态抽象成员来约束它们的行为 - 把它们组合成一串嵌套的泛型管道节点(
Where、Select、WhereSelect、Stop) - 把数字和字符串字面量都编码成类型(
ILiteral<T>)
最后得到的是一个小小的、看起来很像 SQL 的内存查询引擎;而在 JIT 眼里,它其实就是一套可以进行高度优化的、类型特化后的循环。
感兴趣的同学可以扫描下方二维码一起讨论哦!
