目录
[Open WebUI是什么](#Open WebUI是什么)
[Open WebUI安装并使用](#Open WebUI安装并使用)
背景
Mac M1芯片,16G 内存
llama3 8B的部署参考Llama(一):Mac M1芯片运行Llama3-CSDN博客在Mac M1 16G内存环境中,部署并使用Llama3 8Bhttps://blog.csdn.net/hugo_lei/article/details/139330252
【Open WebUI是什么】
Open WebUI是一个可扩展、功能丰富、用户友好的自托管WebUI,旨在完全离线操作。它支持各种LLM运行程序,包括Ollama和OpenAI兼容的API。
Open WebUI的关键特性
【工程能力特性】
🚀 轻松安装:
- 使用Docker或Kubernetes(kubectl、kustoize或helm)无缝安装。
- 也提供了集成ollama的镜像,集成cuda的镜像。
🔐 基于角色的访问控制(RBAC):
- 确保使用受限权限进行安全访问;
- 只有经过授权的个人才能访问您的Ollama,并且为管理员保留专属的模型创建/提取权限。
🧩 Pipelines,Open WebUI插件支持:
- 使用Pipelines插件框架将自定义逻辑和Python库无缝集成到Open WebUI中。
- 启动你的Pipelines实例,将OpenAI URL设置为Pipelines URL,探索无尽的可能性。示例包括函数调用、控制访问的用户速率限制、使用Langfuse等工具进行使用监控、使用LibreTranslate进行多语言支持的实时翻译、有毒消息过滤等等。(扩展性通过plugin解决)
【产品功能特性】
🤝 Ollama/OpenAI API集成:
- 兼容OpenAI API。
- 不仅支持Ollama模型,也支持LMStudio、GroqCloud、Mistral、OpenRouter等。(模型兼容OpenAI API即可)
✒️🔢 全面Markdown和LaTeX支持:通过全面的Markdown和LaTeX功能提升您的LLM体验,丰富互动。
🛠️ Model Builder:通过Web UI轻松创建Ollama模型。通过Open WebUI社区集成,轻松创建和添加自定义角色/代理、自定义聊天元素和导入模型。(它自己还搞了一个模型社区,类似HuggingFace)
📚 本地RAG集成:通过突破性的检索增强生成(RAG)支持,深入聊天交互的未来。此功能将文档交互无缝集成到您的聊天体验中。您可以直接将文档加载到聊天室中,或将文件添加到文档库中,在查询前使用#命令轻松访问它们。(RAG是核心功能)
🔍 RAG的网络搜索:使用SearXNG、Google PSE、Brave Search、serpstack和serper等提供商进行网络搜索,并将结果直接注入您的聊天体验。
🌐 网络浏览功能:使用#命令和URL将网站无缝集成到您的聊天体验中。此功能允许您将网络内容直接融入对话中,增强互动的丰富性和深度。(这个比较有特色,可以直接提供一个URL让它自己分析)
🎨 图像生成集成:使用AUTOMATIC111 API或ComfyUI(本地)和OpenAI的DALL-E(外部)等选项无缝集成图像生成功能,通过动态视觉内容丰富您的聊天体验。(锦上添花)
⚙️ 多模型对话:轻松地同时与各种模型互动,利用它们的独特优势做出最佳反应。通过并行利用一组不同的模型来增强您的体验。(比较有特色,在模型评测时更方便)
【用户体验特性】
🌐🌍 多语言支持:通过我们的国际化(i18n)支持,体验您喜欢的语言的开放式WebUI。目前支持了30+语言。
📱 响应式设计:在台式电脑、笔记本电脑和移动设备上享受无缝体验。(用大白话说就是BS架构,前端交互用浏览器,好吧,学了一个新词:响应式设计)
📱 Progressive Web App(PWA)for Mobile:使用我们的PWA,在的移动设备上享受本机应用程序般的体验,提供本地主机上的离线访问和无缝用户界面。(用web技术开发的移动APP,或者叫多端统一,对于一些交互简单的产品可以这么干,但复杂产品肯定还是Native App的体验更好)
【Open WebUI安装并使用】
推荐docker安装
-
若是使用本地llama模型,建议先启动模型ollama run llama3
-
确定一个本地文件夹,用户容器持久化数据,以防丢失
-
运行docker 镜像
docker run -d -p 3000:8080 -e WEBUI_AUTH=False --add-host=host.docker.internal:host-gateway -v open-webui:你的本地文件夹 --name open-webui --restart always ghcr.io/open-webui/open-webui:main
-e WEBUI_AUTH=False 本地使用,不需要鉴权登录啥的
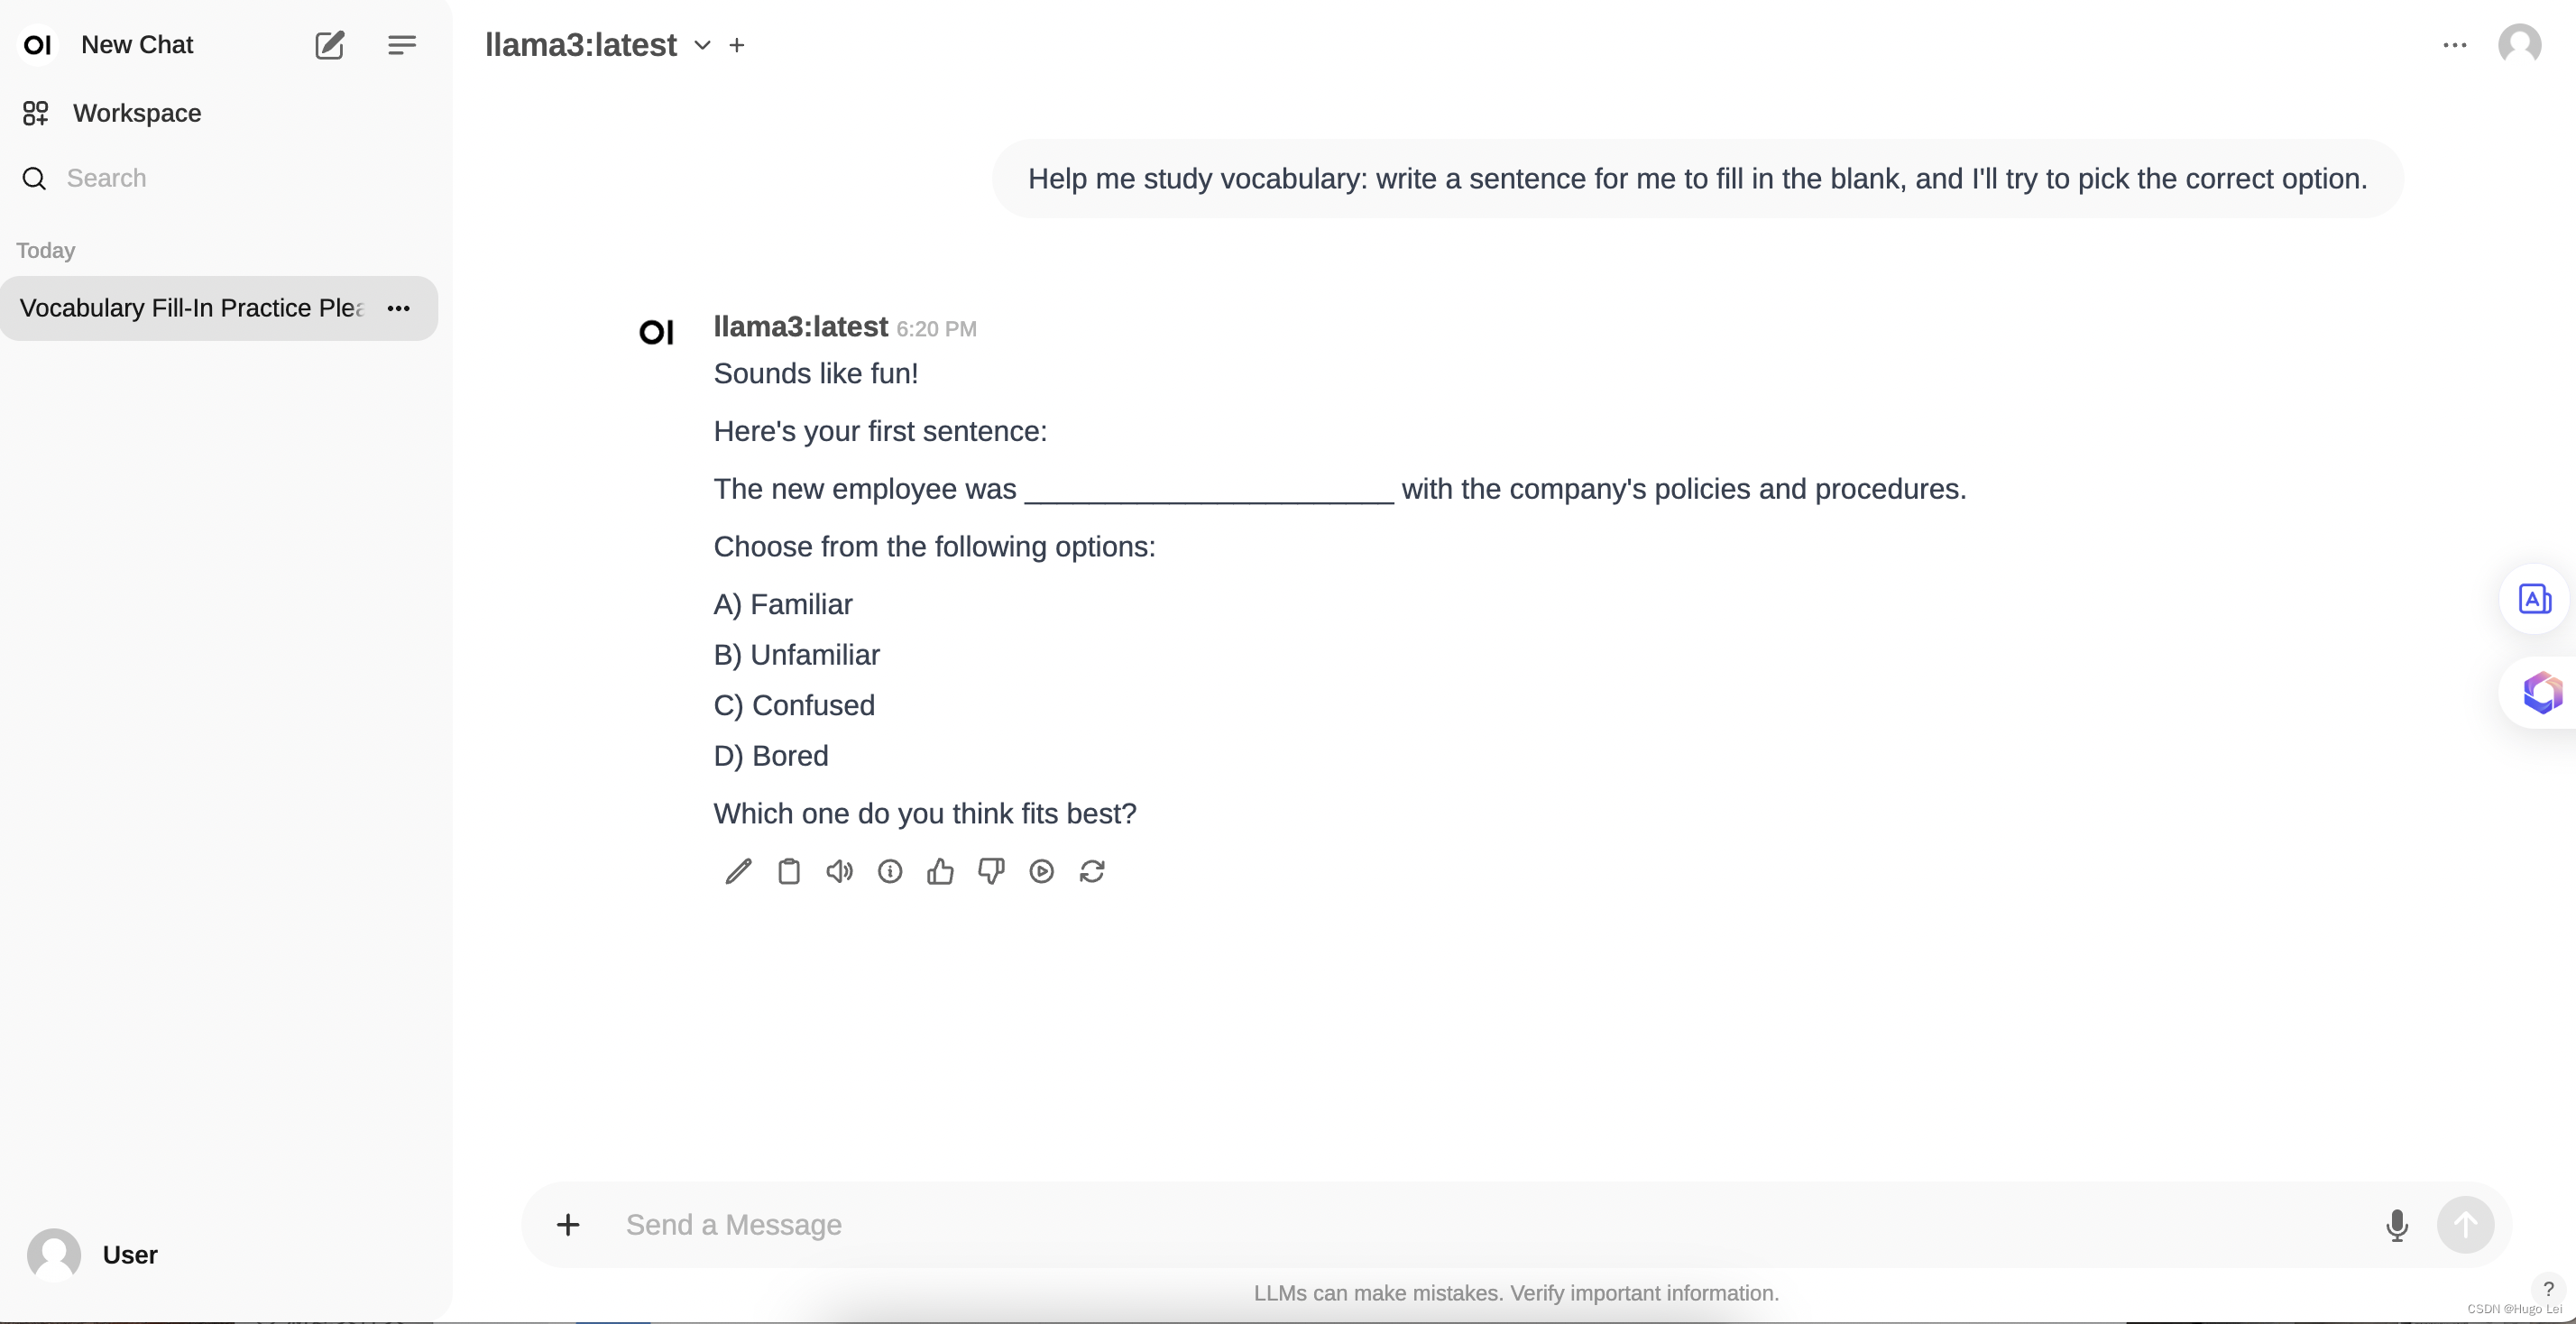
选择一个模型,使用本地ollama run llama3,Open WebUI会自动识别到本地启动的llama3模型。
Enjoy。