字符串处理是数据清洗与分析中必不可少的一环。R语言中的stringr包提供了强大且易用的字符串处理函数,而正则表达式则使得字符串的匹配与替换更为灵活和高效。本文将详细介绍如何使用stringr和正则表达式来处理字符串,并提供相应的示例代码。
一、Stringr 包
1. 创建与查看
-
查看:
rlibrary(stringr) str_view("Hello World", "World")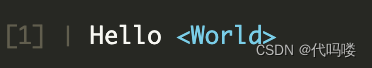
使用
str_view可以直观地查看匹配结果,base::writeLines可以显示字符串内容。 -
转义符 :使用
\\进行转义,例如:r# cat()函数:Concatenate and Print(连接和打印) cat("This is a backslash: \\")This is a backslash: \ -
原始字符串:可以避免频繁的转义,例如:
rraw_string <- r"(\d{3}-\d{2}-\d{4})"
2. 长度与子集
-
字符串长度:
rstr_length("Hello")[1] 5 -
按位置提取子集:
rstr_sub("Hello World", 1, 5)[1] "Hello" -
填充字符串:
rstr_pad("Hello", width = 10, side = "both", pad = "-")[1] "--Hello---"
3. 检测匹配
-
检测匹配:返回逻辑值,注意是向量运算;可以与sum()等统计函数合用。
rstr_detect(c("apple", "banana", "pear"), "a")[1] TRUE TRUE TRUE -
选择匹配的子集 :对于字符串向量,选出符合匹配的子集,注意与
str_sub区分开。rstr_subset(c("apple", "banana", "pear"), "a")[1] "apple" "banana" "pear" -
统计匹配次数:
rstr_count(c("apple", "banana", "pear"), "a")[1] 1 3 1 -
查看匹配:
rstr_view(c("apple", "banana", "pear"), "a")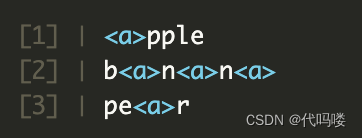
4. 提取匹配
-
提取第一个匹配项:如果没有匹配则返回NA
rstr_extract("The price is $123", "\\$\\d+")[1] "$123" -
提取所有匹配项:
rstr_extract_all("The price is $123 or $456", "\\$\\d+")[1] "$123" "$456" -
分组匹配:
rstr_match("The price is $123", "(\\$\\d+)")
5. 修改字符串
-
按位置替换子集:
rtext <- "Hello, world!" str_sub(text, 1, 5) <- "Hi" -
转换为小写:
rstr_to_lower("Hello") -
替换匹配项:
rstr_replace("The price is $123", "\\$\\d+", "$456")
6. 连接和分割
-
合并字符串:
rstr_c("Hello", "World", sep = " ") -
分割字符串:
rstr_split("apples,oranges,pears", ",")
7. 排序与定位字符串
-
排序字符向量:
rstr_sort(c("banana", "apple", "pear")) -
返回排序序号:
rstr_order(c("banana", "apple", "pear")) -
定位匹配项:
rstr_locate("The price is $123", "\\$\\d+")
二、正则表达式
1. 基础/精确匹配
最简单的正则表达式是匹配一个精确的字符串,如apple。
2. 条件
-
"或"匹配:
rstr_detect(c("apple", "banana", "pear"), "apple|banana") -
"之一"匹配:
rstr_detect(c("apple", "banana", "pear"), "[aeiou]")
3. 锚点 (始于权力^(power),终于金钱$)
-
开始匹配:
rstr_detect("apple", "^a") -
结尾匹配:
rstr_detect("apple", "e$")
4. 量词
-
出现0次或1次:
rstr_detect(c("color", "colour"), "colou?r") -
出现1次或更多:
rstr_detect(c("apple", "aple"), "ap+le")
5. 特殊字符集合
-
匹配任何数字(digit):
rstr_detect("123abc", "\\d") -
匹配空白字符(space):
rstr_detect("a b", "\\s")
6. 分组与回溯引用
-
分组匹配:
rstr_match("The price is $123", "(\\$\\d+)") -
回溯引用:
rstr_replace("abab", "(ab)\\1", "cd")