EXCEL数据导入HIVE

引言

本文将论述如何将Windows本地的excel表数据,导入到虚拟机Linux系统中的Hadoop生态中的Hive数据仓库中。

实验准备

DBeaver

Hive3.1(Hadoop3.1)

excel数据表

实验步骤

一、首先打开虚拟机,启动Hadoop,启动hive,启动hiveserver2,连接DBeaver,成功连接展示如下:

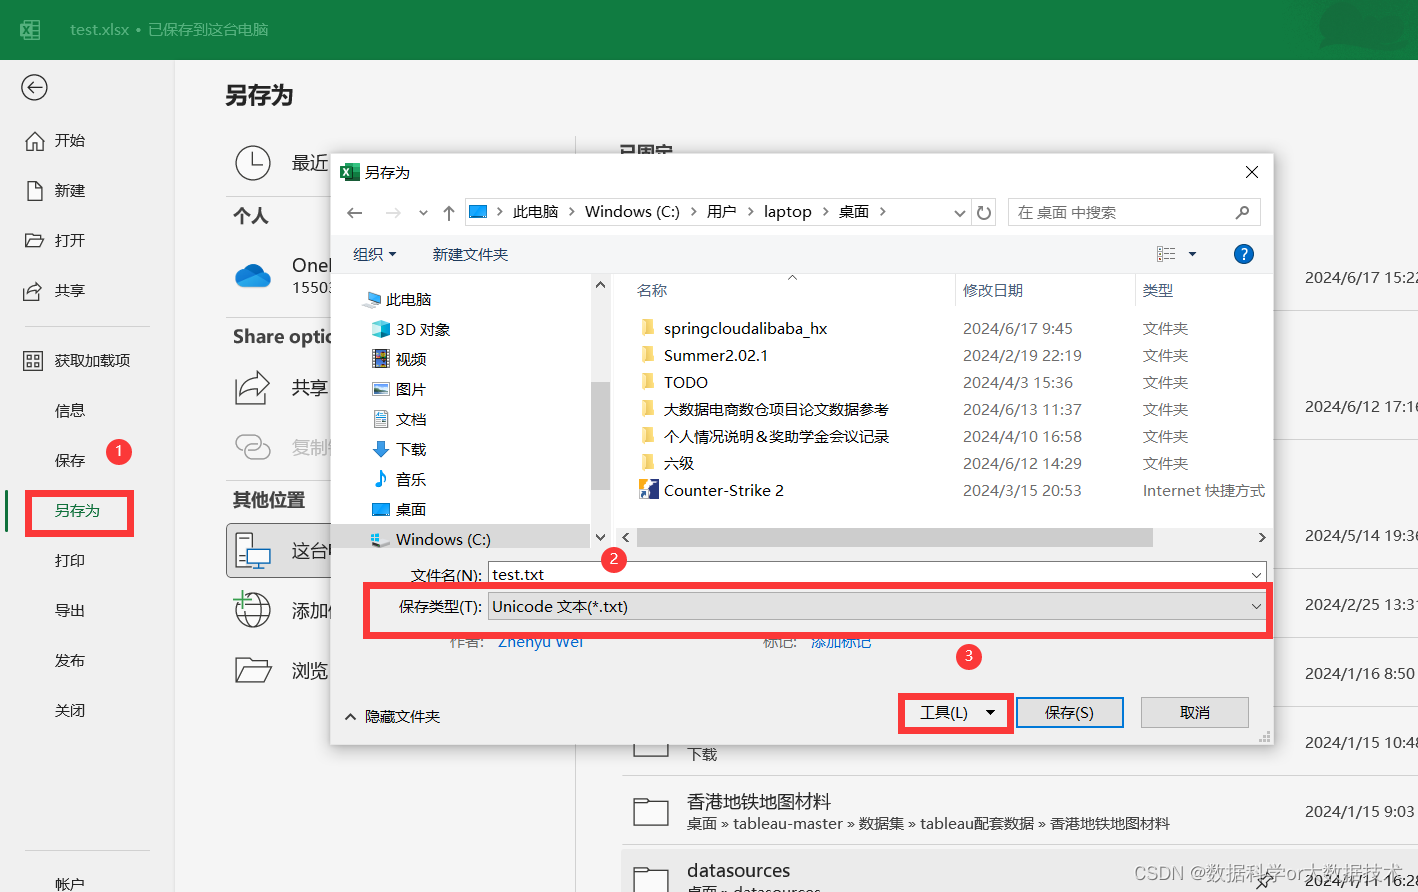
二、将清洗后的excel表的数据另存为txt格式,并将文本转换为UTF-8:

首先点击文件:

点击另存为,转换保存格式为txt,同时在工具中的Web选项中选择编码UTF-8:
三、源excel表数据文件成功转换为test.txt文本文件,并删除第一行的字段(建表时已经建立英文名称字段了)截图如下:

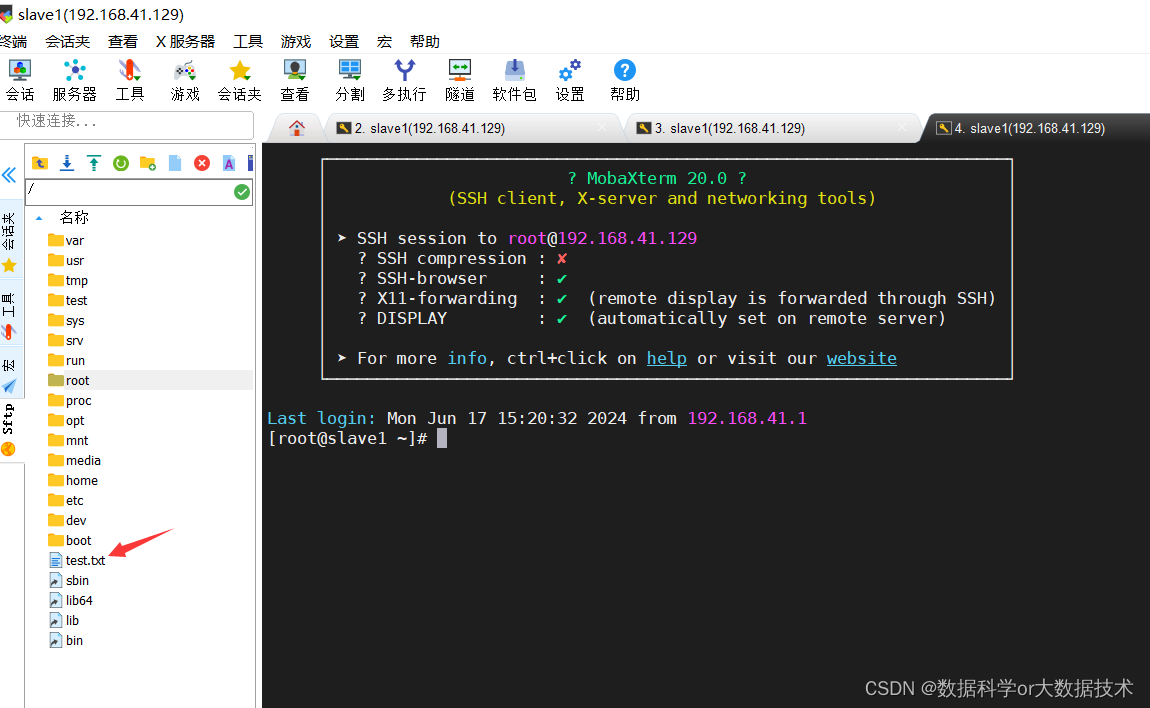
四、将test.txt文件上传至虚拟机的Linux环境中,同时在hive里新建Test数据表(已经建库),输入建表语句的时候务必注意对应字段的类型必须相同。
建立test数据表的语句如下(后面row...部分是以\t为分隔符,必须加上,否则会将整个数据全放在第一列中):

复制代码
create table test(Name String,Age String,ID String) row format delimited fields terminated by '\t' STORED AS TEXTFILE;

成功建表如下截图如下:

在DBeaver中查看截图如下:

五、接着输入HQL语句:

复制代码
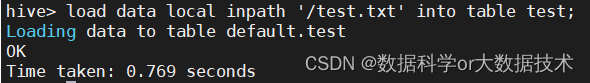
load data local inpath '/test.txt' into table test;

成功上传test.txt的文件截图如下:

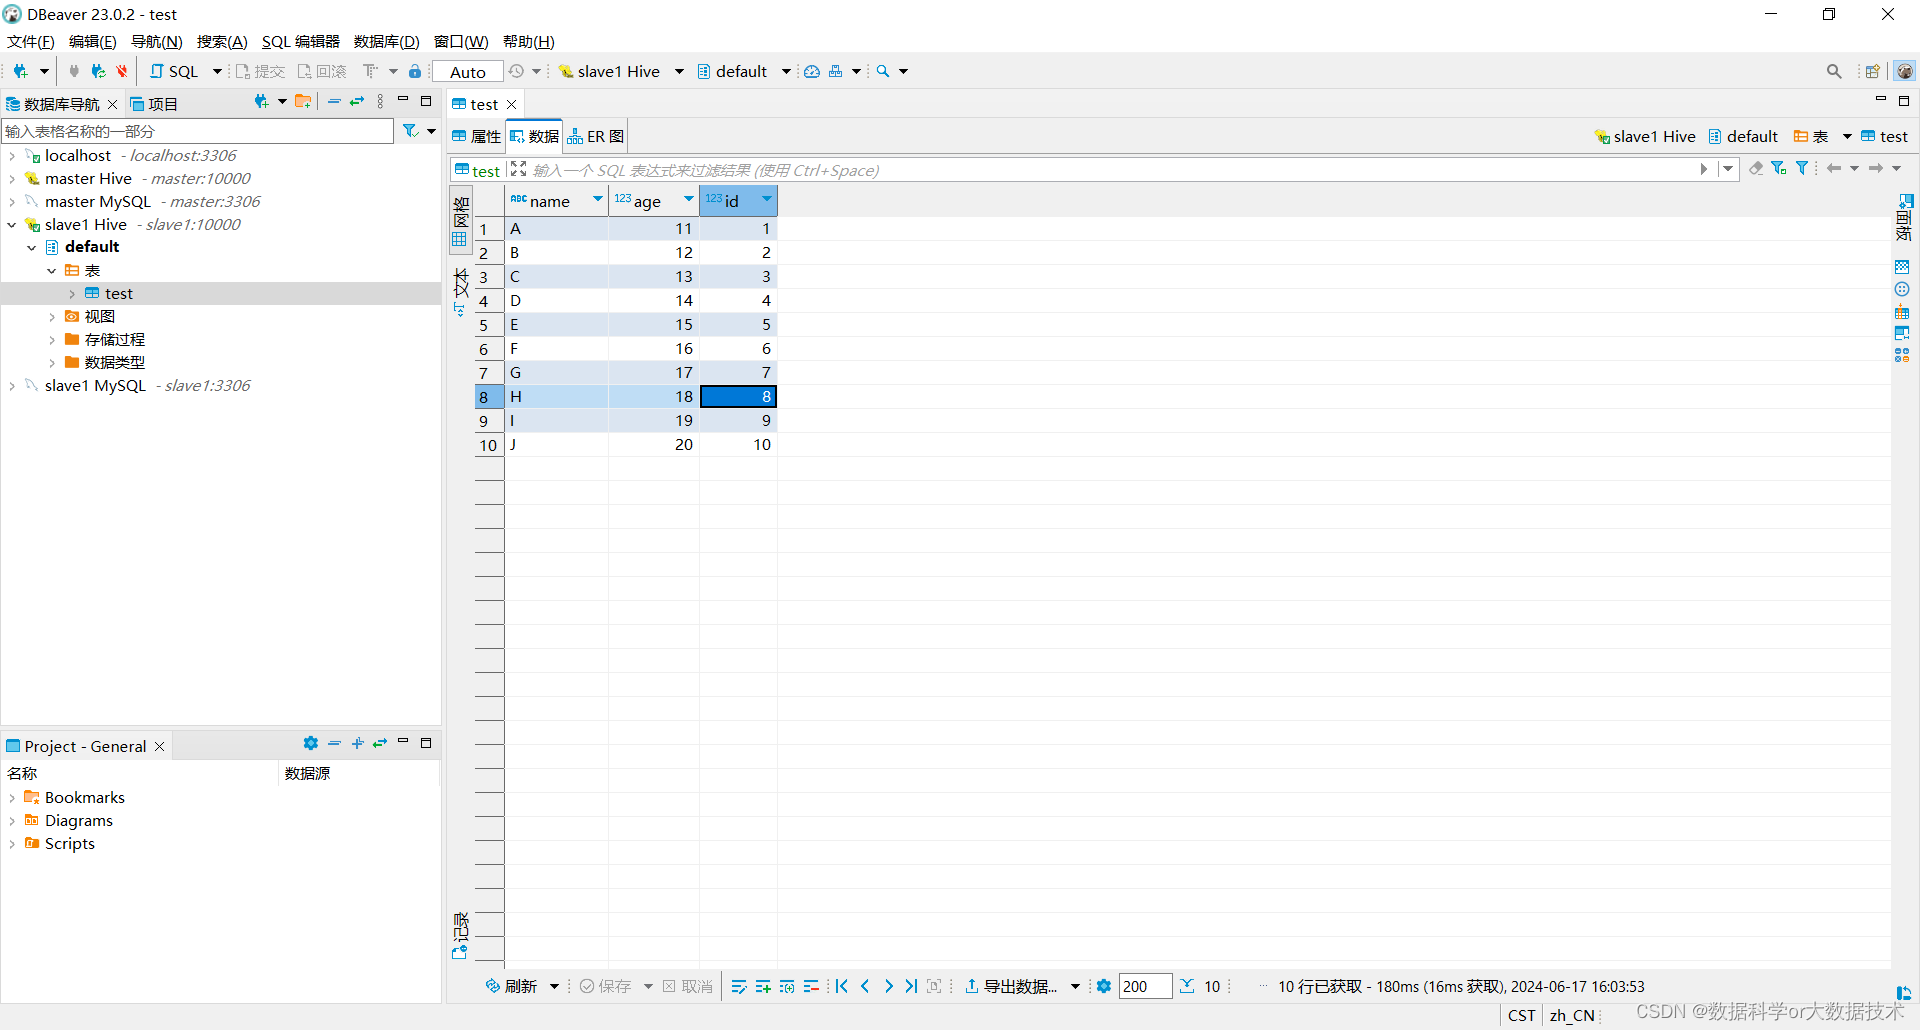
在DBeaver中查看截图如下:

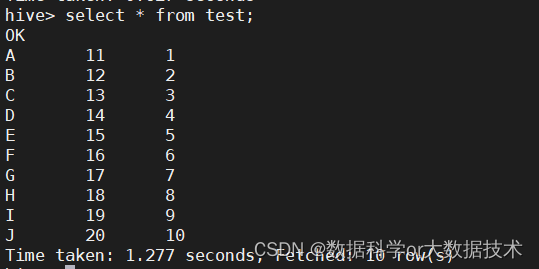
也可以在hive中输入HQL语句查看

复制代码
select * from test;

截图如下:

至此,完成excel表数据传入Hive的所有操作。

相关推荐
Ahtacca1 天前
hadoop部署前置准备
hadoop
tianhuo0031 天前
从MySQL到Apache Doris:生鲜供应链数仓的ETL流水线与SARIMA需求预测全实
数据仓库·数据中台·零售行业供应链数字化
计算机源码社1 天前
基于K-Means聚类的新生儿败血症临床分型与可视化分析系统 基于数据挖掘的新生儿败血症生命体征时序走势与关联性可视化研究
大数据·hadoop·python·数据挖掘·数据分析·spark·毕业设计
SendTomo1 天前
.ico透明图标在线生成下载平台深度解析
大数据·数据结构·数据库·数据仓库·个人开发
计算机源码社1 天前
基于大数据的全球温室气体排放燃料结构与碳强度评估研究-基于Spark的全球温室气体排放多维度检测与评估分析
大数据·hadoop·python·数据挖掘·数据分析·spark·毕业设计
qingwufeiyang_5302 天前
IceBerg学习笔记2
数据仓库·数据湖
Q26433650232 天前
【有i源码】基于大数据的城市交通流量与出行特征可视化分析平台-基于Hadoop的城市交通拥堵关联规则与异常检测研究
大数据·hadoop·机器学习·数据挖掘·数据分析·spark·数据可视化
kaoa0002 天前
Linux入门攻坚——90、Hadoop-2-MapReduce计算框架及Hadoop生态系统概览
linux·hadoop·mapreduce
Gl�ria2 天前
Hadoop 集群高可用节点分布
hadoop
计算机源码社2 天前
基于Hadoop+Spark的商家优惠券营销效果数据分析与可视化-基于Python的商家优惠券营销效果检测与评估分析系统
大数据·hadoop·python·数据挖掘·spark·毕业设计·数据可视化