Repetition Improves Language Model Embeddings论文阅读笔记

  • 文章提出了一种提高decoder-only LLM的embedding能力的方法,叫echo embeddings
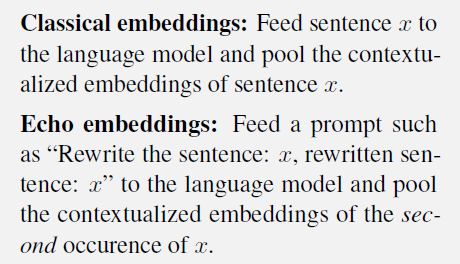
  • last-token pooling(即直接选最后一个token作为句子的embedding)和直接mean pooling都不如文章提出的echo embedding,做法是把句子重复两次,然后取第二次的token是的mean pooling。mean pooling的缺点是太强调句子的前面部分,last-token pooling是太强调句子的后面部分,而重复两次后,第二次的句子的起始token也包含了完整句子的语义,从而不会出现直接mean pooling的问题。
  • 另外一点是,输入要添加一些instruction以鼓励第二次的句子编码包含完整句子信息,如下:
相关推荐
ljt27249606618 小时前
Python笔记(九)--asyncio
笔记·python
AI棒棒牛8 小时前
基于 IDEAL 思想的 YOLO26 双分支适配:差异证据与不确定性门控,RGB+IR双分支创新!
人工智能·深度学习·yolo·目标检测·yolo26
hss123456788 小时前
装修想省心,到底该从哪一步开始选
笔记
深圳老胡8 小时前
STM32 工程在 VSCode 中用 AI 搭建软件骨架架构:从零到可运行的分层实践
笔记·stm32·单片机·代码规范
WenGyyyL8 小时前
从零理解强化学习:为什么 AI 需要 Advantage,而不只是 Reward?
人工智能·python·深度学习·机器学习·nlp
Joecien8 小时前
qwen-mt-uni 多模态翻译实战:从接入到四类输入的完整步骤
人工智能·自然语言处理·机器翻译
半生过往9 小时前
uni-app多端项目工作笔记
笔记·uni-app
鬼手点金9 小时前
带工具调用的多轮交互:Agent 的核心循环
服务器·人工智能·windows·深度学习·microsoft·机器学习·交互
Dawson Zhu9 小时前
【CUDA编程入门②】CUDA性能优化基础:内存访问、Warp Shuffle与Occupancy调优
人工智能·语言模型·架构·aigc·agi