11天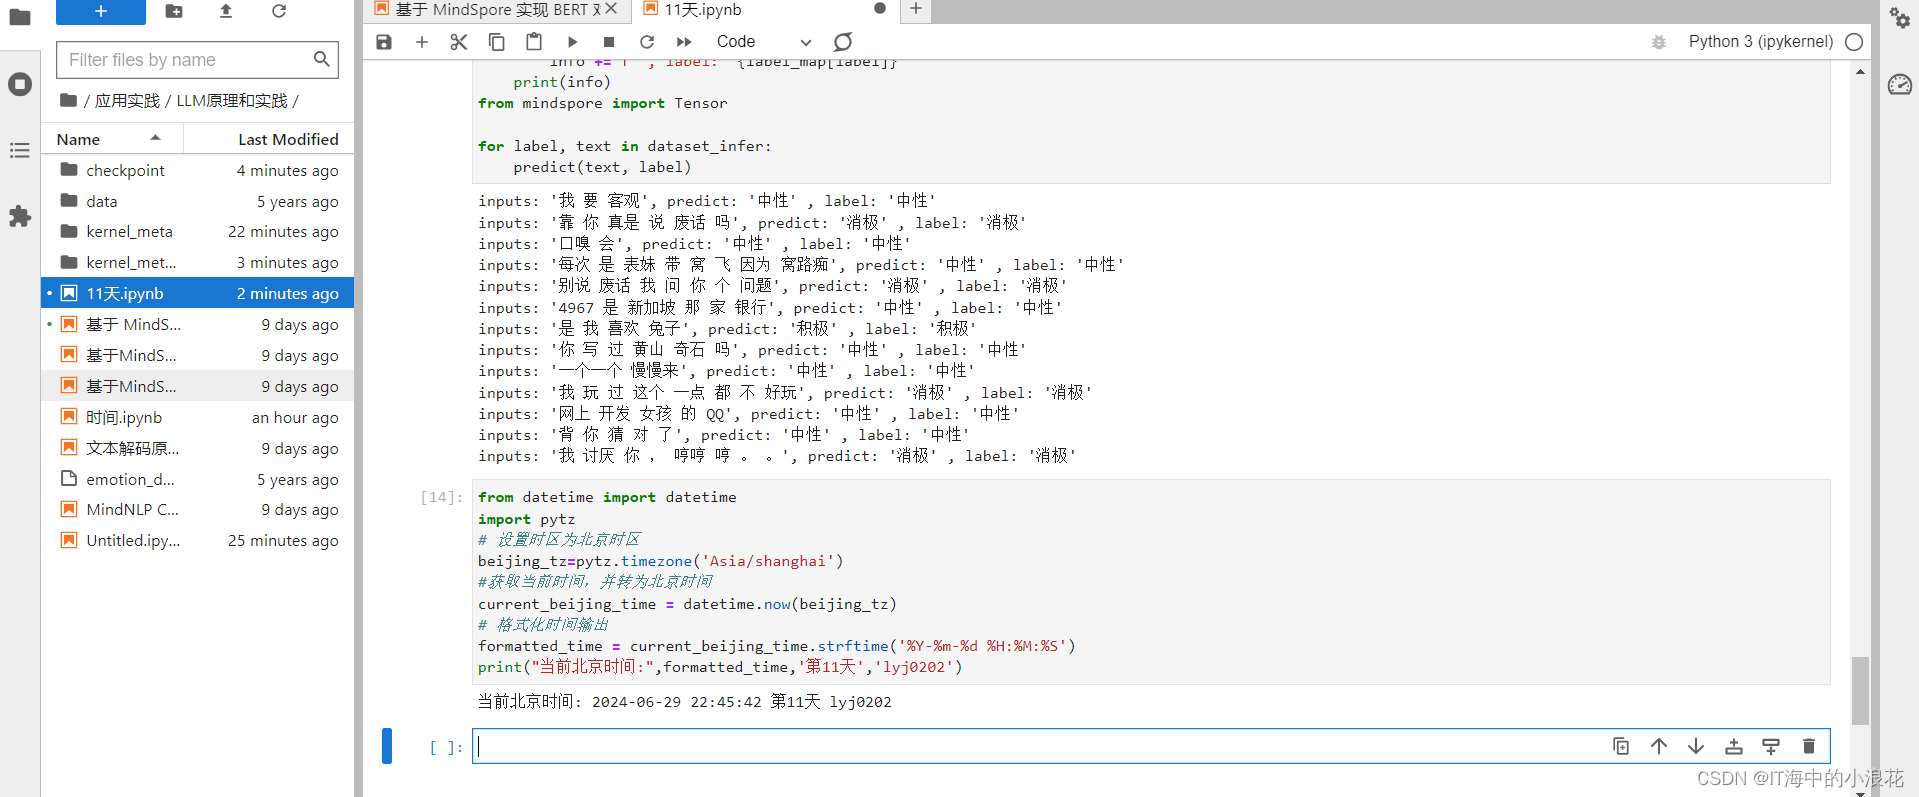 本节学习到BERT全称是来自变换器的双向编码器表征量,它是Google于2018年末开发并发布的一种新型语言模型。BERT模型的主要创新点都在pre-train方法上,即用了Masked Language Model和Next Sentence Prediction两种方法分别捕捉词语和句子级别的representation。通过一个文本情感分类任务为例子来学习了BERT模型的整个应用过程。
《昇思25天学习打卡营第11天 | 昇思MindSpore基于 MindSpore 实现 BERT 对话情绪识别》
IT海中的小浪花2024-07-03 14:11
相关推荐
Csvn3 小时前
第 28 章 案例四 多智能体协作系统IT_陈寒3 小时前
Java中equals方法比了个寂寞?原来这才是正确的重写姿势吴佳浩3 小时前
Agent 怎么做自动化评测?构建端到端的 Agent Evaluation 体系火山引擎开发者社区3 小时前
火山引擎云数据库 TiDB 版公测开启,MySQL 架构升级的一站式选择代码方舟3 小时前
Java数据工程:利用天远全网运营商三要素优化线上实名认证合规体验Csvn3 小时前
第 27 章 案例三 自动化工作流 Agent知几蜗牛3 小时前
AI眼镜把记忆放上云,怎样证明云端也看不见?知几蜗牛3 小时前
训练数据越多越好吗?用LeRobot讲清数据质量与版本化知几蜗牛3 小时前
PR合并慢,别再只看平均时长:GitHub把等待拆成了三段知几蜗牛3 小时前
AI账单失控前,团队真正缺的不是更便宜的模型