paper:CoAtNet: Marrying Convolution and Attention for All Data Sizes
third-party implementation:https://github.com/huggingface/pytorch-image-models/blob/main/timm/models/maxxvit.py
背景
自AlexNet以来,ConvNets一直是计算机视觉领域的主流模型。 Transformers在自然语言处理取得成功后,许多研究尝试将其引入计算机视觉领域。尽管Vision Transformer (ViT) 取得了一些成果,但其在小数据集上的表现仍不如ConvNets。
作者认为,Transformers可能缺乏卷积网络所拥有的某些理想的归纳偏差(inductive bias),这导致它们需要大量的数据和计算资源来补偿。因此本文主要讨论了如何将卷积神经网络(ConvNets)和自注意力机制(Transformers)结合在一起,以实现更好的图像分类性能。
创新点
该研究旨在解决以下问题:
- 如何在一个基本计算模块内结合卷积和自注意力机制。
- 如何垂直堆叠不同类型的计算模块,形成一个完整的网络。
创新点包括:
- 提出了深度卷积(depthwise Convolution)和自注意力(self-Attention)可以通过简单的相对注意力(relative attention)实现统一。
- 通过合理的方式垂直堆叠卷积层和注意力层,可以显著提高模型的泛化能力和容量。
- 提出了 CoAtNet 架构,它结合了 ConvNets 和 Transformers 的优点。
效果
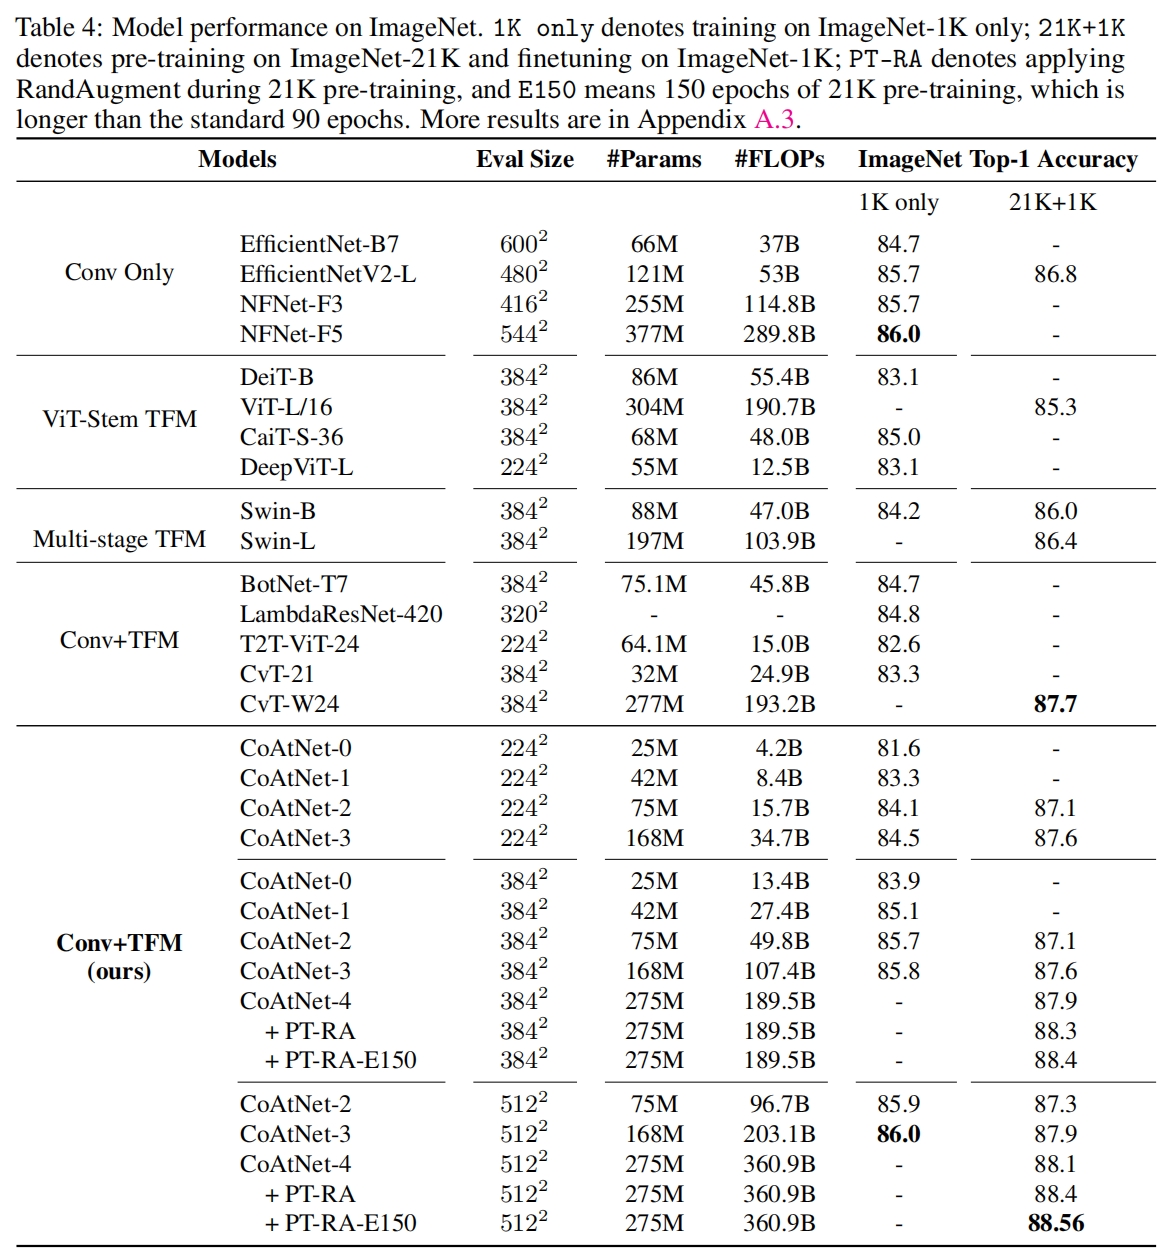
- 未使用额外数据时,CoAtNet达到了86.0%的ImageNet top-1准确率。
- 在ImageNet-21K数据集(1300万张图像)上进行预训练后,CoAtNet达到了88.56%的top-1准确率,与使用300M张图像进行预训练的ViT-Huge相当,但数据量减少了23倍。
- 在JFT-3B数据集上进行预训练后,CoAtNet达到了90.88%的top-1准确率,创下了新的记录。
方法介绍
Merging Convolution and Self-Attention
对于卷积作者主要关注MBConv block,它使用深度卷积来捕获空间相互作用。选择它的原始是Transforme中的FFN和MBConv block一样都采用了"inverted bottleneck"的设计。
深度卷积和self-attention都可以表示为一个在预先定义的感受野内进行每个维度值的加权求和过程。具体来说,卷积依赖一个固定的kernel从一个局部感受野内收集信息
y_i=\\sum_{j \\in \\mathcal{L}(i)} w_{i-j} \\odot x_j \\quad \\text { (depthwise convolution), } \\qquad \\tag1
其中 \(x_i,y_x\in \mathbb{R}^D\) 分别是位置 \(i\) 处的输入和输出,\(\mathcal{L}(i)\) 表示 \(i\) 的一个局部邻域,比如中心点为 \(i\) 的一个3x3方格。
相比之下self-attention的感受野为全部空间位置
y_i=\\sum_{j \\in \\mathcal{G}} \\underbrace{\\frac{\\exp \\left(x_i\^{\\top} x_j\\right)}{\\sum_{k \\in \\mathcal{G}} \\exp \\left(x_i\^{\\top} x_k\\right)}}_{A_{i, j}} x_j \\quad \\text{ (self-attention)}, \\qquad \\tag2
其中 \(\mathcal{G}\) 表示全局位置空间。
在讨论如何更好地组合它们之前,我们先比较一下它们的相对优势和劣势,这有助于找到我们希望保留的特性。
-
首先深度卷积核 \(w_{i-j}\) 是一个不依赖于输入的静态参数,而attention权重 \(A_{i,j}\) 则动态地依赖输入表示。因此self-attention更容易捕获不同空间位置之间复杂的交互关系,但这种灵活性也更容易过拟合,特别是在数据有限的情况下。
-
其次给定任意一对位置 \((i,j)\),对应的卷积权重 \(w_{i-j}\) 只关心它们之间的相对位移即 \(i-j\) 而不关心 \(i,j\) 的具体值。这就是我们常说的平移不变性,这一特性可以提高有限数据下模型的泛化性。由于使用了绝对位置编码ViT缺乏这一特性,这也解释了为什么在数据量有限时ConvNets的效果比Transformers要好。
-
相比于卷积的局部感受野,Transformer具有全局感受野,更大的感受野提供了更多的上下文信息,提高了模型的容量,同时也需要更多的计算量。

根据上面的分析,一个理想的模型应该同时具备表1中的三点特性。根据式(1)和式(2),一个直接的想法是将一个全局静态卷积核和一个动态注意力矩阵相加,在softmax函数之前或之后都可以,如下
y_i\^{\\text {post }}=\\sum_{j \\in \\mathcal{G}}\\left(\\frac{\\exp \\left(x_i\^{\\top} x_j\\right)}{\\sum_{k \\in \\mathcal{G}} \\exp \\left(x_i\^{\\top} x_k\\right)}+w_{i-j}\\right) x_j \\quad or \\quad y_i\^{\\mathrm{pre}}=\\sum_{j \\in \\mathcal{G}} \\frac{\\exp \\left(x_i\^{\\top} x_j+w_{i-j}\\right)}{\\sum_{k \\in \\mathcal{G}} \\exp \\left(x_i\^{\\top} x_k+w_{i-k}\\right)} x_j \\tag3
本文采用 \(y_i^{pre}\),其实这就是一种relative self-attention,和swin-transformer中的relative position bias是一模一样。
Vertical Layout Design
在找到了如何将卷积和注意力结合起来后,作者研究了如何stack layers来构建网络。
由于attention的计算量和输入分辨率是二次方关系,直接将式(3)应用于原始输入会导致计算量过大。因此作者采用了对原始输入进行降采样,在分辨率到了一个可控水平后再应用global relative attention的方式。对于降采样有两种方式,一是像原始的ViT那样直接采用一个大步长stride=16的卷积进行降采样,二是像ConvNets那样多个stage逐步降采样。
作者首先给出了5种设计选项,然后通过实验来比较效果。第一种是应用ViT stem,然后堆叠 \(L\) 个relative attention的Transformer block,将其表示为 \(\mathbf{ViT}_{REL}\)。
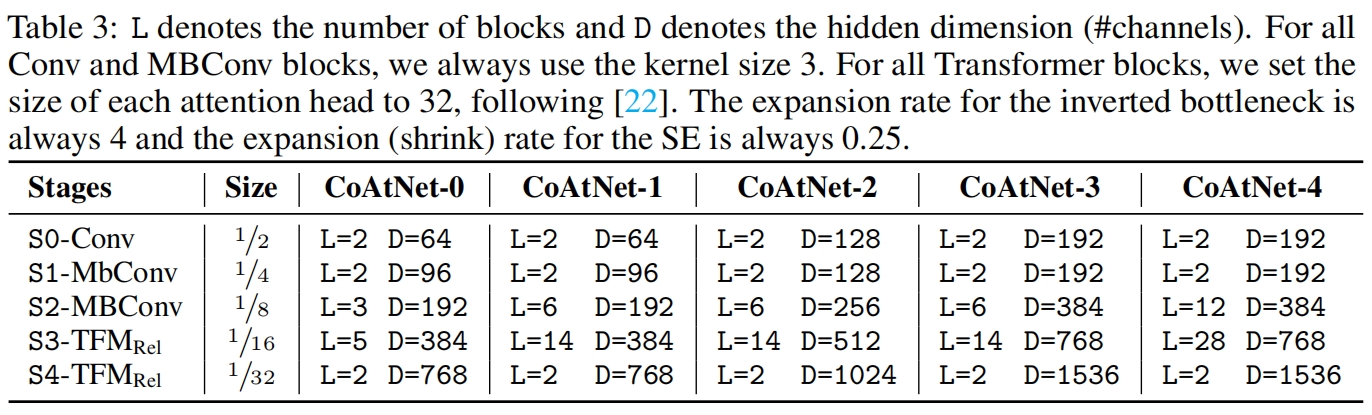
然后是multi-stage的方式,一共包含5个stage(S0, S1, S2, S3, S4),在每个stage的开始进行2x的降采样。S0是一个2层卷积的stem,S1是一个带有SE的MBConv block,前两个stage的设计是固定的。然后S2到S4我们使用MBConv或Transformer block,其中保证卷积stage一定在Transformer stage前面,这样我们就得到了四种不同的变体,C-C-C-C、C-C-C-T、C-C-T-T、C-T-T-T,其中C和T分别表示卷积和Transformer。
作者在ImageNet-1K和JFT数据集上进行了模型容量和泛化性能的比较,结果如图1所示

泛化性能表现
\\mathrm{C}-\\mathrm{C}-\\mathrm{C}-\\mathrm{C} \\approx \\mathrm{C}-\\mathrm{C}-\\mathrm{C}-\\mathrm{T} \\geq \\mathrm{C}-\\mathrm{C}-\\mathrm{T}-\\mathrm{T}\>\\mathrm{C}-\\mathrm{T}-\\mathrm{T}-\\mathrm{T} \\gg \\mathrm{VIT}_{\\mathrm{REL}}
模型容量对比
\\mathrm{C}-\\mathrm{C}-\\mathrm{T}-\\mathrm{T} \\approx \\mathrm{C}-\\mathrm{T}-\\mathrm{T}-\\mathrm{T}\>\\mathrm{VIT}_{\\mathrm{REL}}\>\\mathrm{C}-\\mathrm{C}-\\mathrm{C}-\\mathrm{T}\>\\mathrm{C}-\\mathrm{C}-\\mathrm{C}-\\mathrm{C}
最后在C-C-T-T和C-T-T-T之间选择,作者又做了一个迁移性测试,两个在JFT上预训练的模型在ImageNet-1K上微调30个epoch,然后比较它们的性能,结果如表2所示

可以看到C-C-T-T的迁移性明显更好,最终CoAtNet选择了C-C-T-T multi-stage的设计。
实验结果
不同大小的CoAtNet的配置如下
在ImageNet-1k上和其它模型的对比如下
代码解析
代码没什么好讲的,其中式(3)的 \(y_i^{pre}\) 就是swin transformer中的relative position bias,代码都是一样的,可以参考Swin Transformer(ICCV 2021)论文与代码解析-CSDN博客。