机器学习Day10:聚类

概念

聚类是按照某个特定标准把一个数据集分割成不同的类或簇,使得同一个簇内的数据对象的相似性尽可能大,同时不在同一个簇中的数据对象的差异性尽可能大

聚类的过程

  1. 数据准备:特征标准化和降维
  2. 特征选择:从最初的特征中选择最有效的特征,并将其存储在向量中
  3. 特征提取:通过对选择的特征进行转换形成新的突出特征
  4. 聚类:基于某种距离函数 进行相似度度量,获取簇
  5. 聚类结果评估:分析聚类结果,如距离误差和等

聚类方法

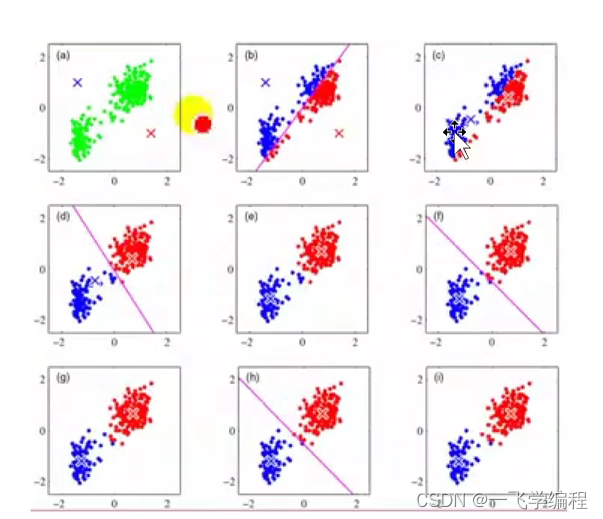
1.划分类聚类方法

代表:k-means算法

基本思想:对于给定的类别数据k首先给出初始划分 ,通过迭代 改变样本和簇的隶属关系,使得每一次改进后的划分方法都比前一次更好

优点:简单快速;当簇近似于高斯分布时效果好

缺点:在簇的平均值 可被定义时才能使用;对初值敏感
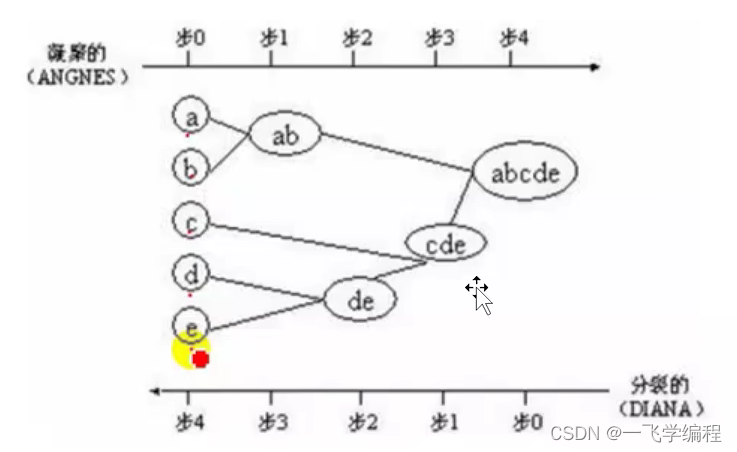
2.层次聚类方法 :对给定的数据集进行层次的分解 ,直到满足某种条件为止

如下图所示,由于a、b某特征有相似之处,将他们聚类一类,以此类推

特征:对噪声敏感
3.基于密度的聚类方法
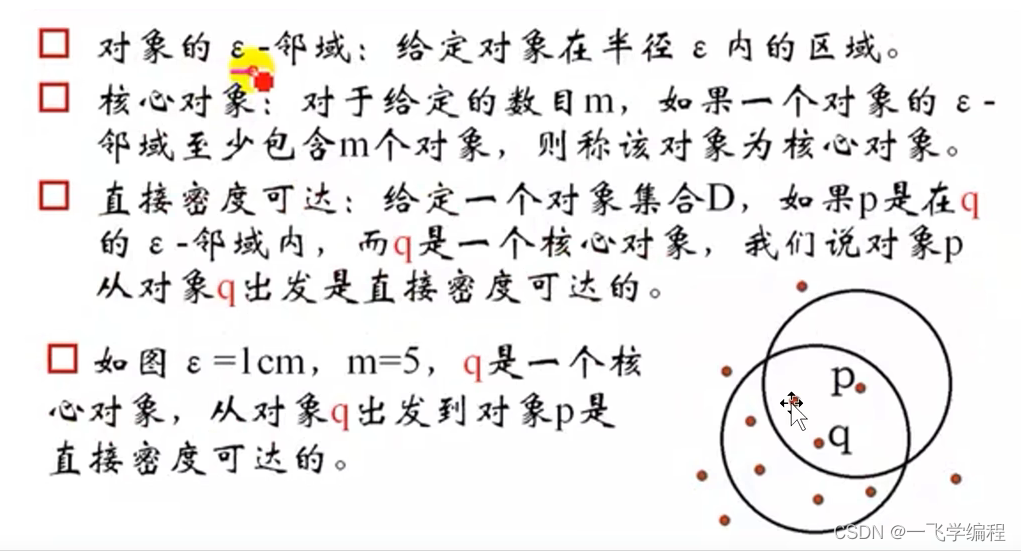
典型算法:DBSCAN算法
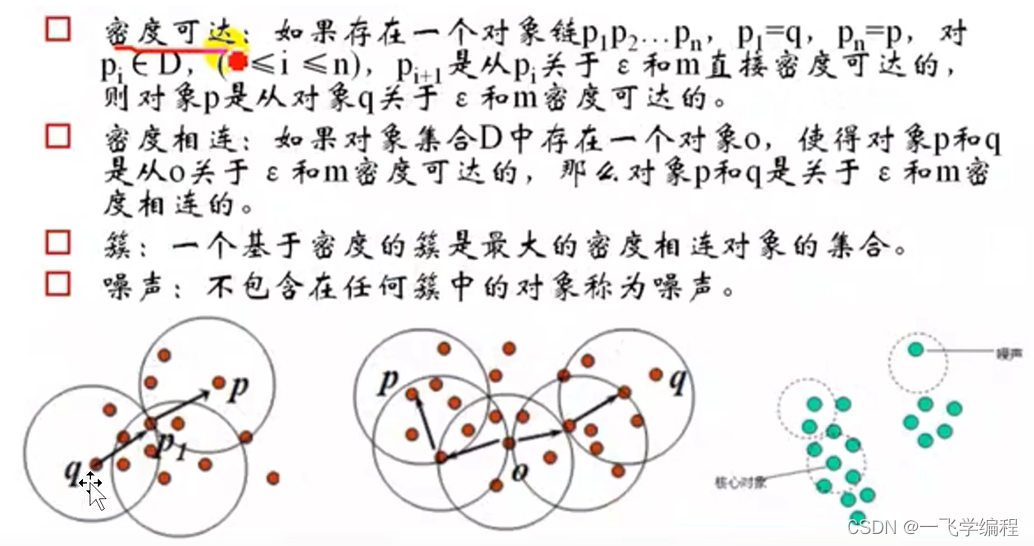
特点:抗噪效果好;性能一般

聚类算法效果评判

  1. 均一性:聚类结果的一致性或者稳定性
  2. 完整性:聚类结果 与真实类别或标签之间的一致性
  3. V-measure:综合考虑了均一性 和完整性
  4. ARI:比较了聚类结果与真实类别之间的一致性,考虑了分类中的随机性因素
  5. AMI:聚类结果与真实类别之间的一致性,同时考虑了类别分布的随机性
  6. 轮廓系数:结合了聚类的紧密度(密度 )和分离度(分散度)
相关推荐
Csvn18 小时前
同一个问题问 100 遍,钱就扣 100 次?精确缓存让它只扣一次(C02)
人工智能·aigc·agent
罗西的思考18 小时前
【轻量化复刻大模型 / KIMI K3】Multi-Token Prediction(MTP / EAGLE-3)(2)
人工智能·算法·机器学习
罗西的思考18 小时前
【轻量化复刻大模型 / KIMI K3】Multi-Token Prediction(MTP / EAGLE-3)(1)
人工智能·算法·机器学习
汤姆宝库19 小时前
BPE分词器的完整实现:字节对合并与词表构建
开发语言·人工智能·c#
岁月宁静19 小时前
从零拆解 AI 语音模拟面试系统
人工智能·python·agent
武子康19 小时前
H3-World 接入 Game Agent:谁来判断门真的打开了?
人工智能·算法·机器学习
可乐ea20 小时前
MCP 和 CLI 差 42 倍:一次 GitHub 任务的上下文成本实测
人工智能·github·工具调用·ai智能体·openrouter·mcp协议·上下文优化
kyriewen20 小时前
编辑弹窗点了取消,列表里的数据怎么还是变了?
前端·javascript·人工智能
泯泷21 小时前
Multica 真正打动我的,不是更多 Agent,而是一种新的团队协作方式
人工智能·llm·agent
电科_银尘21 小时前
【深度学习项目实战·22】灰度图像着色:用小型U-Net学习从灰度到RGB
人工智能·深度学习·学习