一、Hive中的分桶表
1. 分桶表的概念
分桶表是Hive中一种用于提升查询效率的表类型。分桶指的是根据指定列的哈希值将数据划分到不同的文件(桶)中。
2. 分桶表的原理
- 哈希分桶:根据分桶列计算哈希值,对哈希值取模,将数据分配到相应的桶中。
- 分区/分桶:分区是基于存储路径的划分,而分桶是基于数据文件的划分。
假设按以下规则分桶
- 分桶列 :
id - 分桶数量:4
分桶计算过程
- 计算哈希值 :对每个
id计算其哈希值。 - 取模运算:对哈希值进行取模运算,模数为分桶数量(4)。
- 分配到桶:根据取模结果,将数据分配到相应的桶。
示例
假设有以下id数据:101, 102, 103, 104, 105
-
id = 101:- 哈希值:假设为
hash(101) = 1111 - 取模:
1111 % 4 = 3 - 分配到桶3
- 哈希值:假设为
-
id = 102:- 哈希值:假设为
hash(102) = 2222 - 取模:
2222 % 4 = 2 - 分配到桶2
- 哈希值:假设为
-
id = 103:- 哈希值:假设为
hash(103) = 3333 - 取模:
3333 % 4 = 1 - 分配到桶1
- 哈希值:假设为
-
id = 104:- 哈希值:假设为
hash(104) = 4444 - 取模:
4444 % 4 = 0 - 分配到桶0
- 哈希值:假设为
-
id = 105:- 哈希值:假设为
hash(105) = 5555 - 取模:
5555 % 4 = 3 - 分配到桶3
- 哈希值:假设为
3. 分桶表的用途
- 加快表连接速度:当两个表的连接字段作为分桶字段时,且分桶数量相等或成倍数关系时,能够加快连接速度。
- 支持抽样查询:可以快速获取数据的样本。
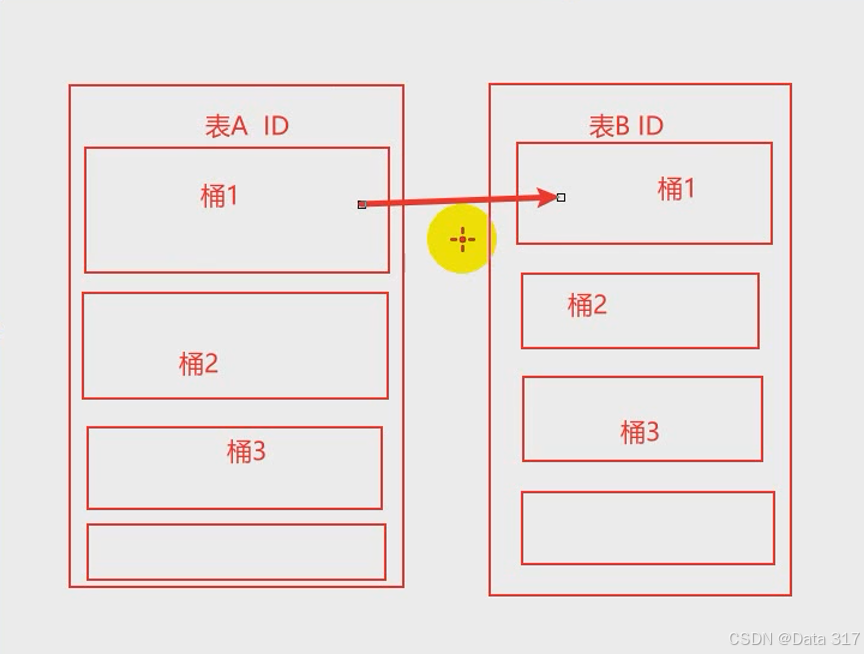
加速原理
- 分桶数量相同:每个对应的桶只需要在各自的桶中进行连接。
- 倍数关系:较大的分桶表的桶可以映射到较小分桶表的桶。比如,一个表有8个桶,另一个表有4个桶,每2个小桶可以对应到1个大桶。
表连接查询
分桶表在连接查询时,可以利用表的分桶特性加速查询,尤其是在两个表分桶字段相同时:
sql
SELECT a.*, b.*
FROM stu_info_c AS a
JOIN another_bucketed_table AS b
ON a.id = b.id;
4. 分桶表的创建
假设有以下数据:
1001,lilei,男,18
1002,lucy,女,16
...
创建分桶表
sql
CREATE TABLE stu_info_c (
  id INT,
  name STRING,
  sex STRING,
  age INT
)
CLUSTERED BY (id) INTO 4 BUCKETS
ROW FORMAT DELIMITED FIELDS TERMINATED BY ',';-
CLUSTERED BY (id) : 指定用于分桶的字段,这里是
id。数据在分区内会根据id的哈希值进行分桶。 -
INTO 4 BUCKETS: 指定将数据划分为 4 个桶。每个桶包含一部分数据,以便在查询时可以并行处理,提高性能。
加载数据到分桶表
- 创建临时表并加载数据:
-
创建临时表:
sqlCREATE TABLE stu_info_c_tmp ( id INT, name STRING, score DECIMAL(5, 2) ) ROW FORMAT DELIMITED FIELDS TERMINATED BY ','; -
加载数据:
sqlLOAD DATA INPATH '/bc/stu.txt' INTO TABLE stu_info_c_tmp;
-
将数据导入分桶表:
sqlINSERT OVERWRITE TABLE stu_info_c SELECT * FROM stu_info_c_tmp;
5. 分桶表的查询
查询整张表
sql
SELECT * FROM stu_info_c;抽样查询
sql
SELECT * FROM stu_info_c TABLESAMPLE(BUCKET 3 OUT OF 8);TABLESAMPLE(BUCKET x OUT OF y) 用于从分桶表中抽样数据
-
y值:决定抽样比例,必须是表总桶数的倍数或因子。 -
x值:表示从哪个桶开始抽取。 -
例如,如果表总共分为 4 个桶,
TABLESAMPLE(BUCKET 2 OUT OF 2)将返回 2 个桶的数据,而TABLESAMPLE(BUCKET 1 OUT OF 2)将返回第 1 个桶和第 3 个桶的数据。
6. 分桶与分区的区别
-
字段来源:
- 分区使用
creat以外的新字段。 - 分桶使用
creat之后的已有字段。
- 分区使用
-
划分方式:
- 分区:指定规则(静态、动态)。
- 分桶:基于哈希算法。
-
存储方式:
- 分区:创建子目录存储数据。
- 分桶:将表拆分为多个小文件。
-
使用场景:
- 分区:加速分区字段查询。
- 分桶:加速表连接。
| 特性 | 分区 | 分桶 |
|---|---|---|
| 字段来源 | 新字段(不在原表中) | 原表中已有字段 |
| 划分方式 | 指定规则(静态、动态) | 基于哈希算法 |
| 存储方式 | 创建子目录存储数据 | 将表拆分为多个小文件 |
| 使用场景 | 加速分区字段查询 | 加速表连接 |
语法
sql
CREATE TABLE bucketed_sales (
  id INT,
  product STRING,
  amount DECIMAL(10, 2),
  date STRING
)
PARTITIONED BY (year INT)
CLUSTERED BY (id) INTO 4 BUCKETS
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ',';
感谢您访问本博文,另外,在今天这个举国欢庆的日子里,愿大家享受美好的时光,放下工作的繁忙,陪伴家人和朋友,共度温馨的国庆假期。愿祖国繁荣昌盛,国泰民安!祝大家国庆快乐,幸福安康!